Dominando la calidad de datos de IA para el monitoreo empresarial en 2026
|
7
minuto de lectura

La mañana del lunes comienza con un dolor familiar. Un panel de control que debería haber estado calmado parpadea en rojo, los números no cuadran y nadie se pone de acuerdo sobre si el problema es real o simplemente otra fuente de datos desactualizada. Para cuando alguien lo rastrea hasta un archivo retrasado, un lote duplicado o un cambio de esquema silencioso, el daño ya está hecho en las notas de la reunión, en los resultados del modelo o en el informe de la junta.
Este es el estado actual de la calidad de los datos de IA en 2026. Ya no es una tarea ordenada de solucionar nulos y eliminar filas duplicadas, porque las canalizaciones modernas se mueven demasiado rápido para que las comprobaciones estáticas capten cada cambio significativo. Especialmente en Europa, la conversación ha pasado de "¿están limpios los datos?" a "¿podemos confiar en los datos, demostrarlo y gobernarlos a lo largo de todo su ciclo de vida?". Es por eso que la Observability, la auditabilidad y el linaje se sitúan ahora junto a la precisión como preocupaciones de primer nivel, especialmente para la IA de alto riesgo y los entornos regulados. Un buen punto de partida es la perspectiva práctica de Observability en digna's data observability overview.
Más allá de los datos limpios: El nuevo imperativo
Un equipo de finanzas puede convivir con un gráfico roto durante una hora. Un motor de precios no puede. Cuando el suministro de datos se retrasa sutilmente, o cuando la distribución entrante cambia lo justo para mantenerse dentro de una regla rígida, el negocio sigue sufriendo el impacto. Las comprobaciones manuales detectan lo obvio, pero pasan por alto los fallos silenciosos que llegan grupo de registros a grupo de registros.
Por eso, la calidad de los datos de IA ha superado la antigua mentalidad de "limpiarlo más tarde". Las investigaciones centradas en la UE abordan ahora los controles de calidad de los datos como parte de un Data Governance más amplio, especialmente cuando se trata de IA de alto riesgo y los conjuntos de datos deben ser pertinentes, representativos, libres de errores y completos (European Journal of Information Law analysis of Article 10). El enfoque de governance es importante porque un conjunto de datos defectuoso no es solo una molestia de modelado, es una prueba de que la canalización aún no es confiable.
El cambio de la limpieza al control
El modelo antiguo era sencillo. Un ingeniero de datos escribía una regla, un panel de control disparaba una alerta y alguien investigaba después de que el daño se hubiera propagado. Eso funciona cuando el problema es literal y repetido. Se desmorona cuando el fallo es de comportamiento, como un suministro que llega a tiempo pero con una distribución modificada, o un segmento de clientes que desaparece sin activar una comprobación de nulos.
Ese es el sentido de la Observability moderna. No solo se pregunta si la columna existe; pregunta si los datos se siguen comportando como esperabas. Para los equipos en España o en toda la UE, esto es más que una comodidad: se alinea con la visión centrada en los derechos de que una IA confiable comienza con controles confiables. Una perspectiva práctica útil es la que utilizan las plataformas creadas para este problema, como data quality dimensions and how to measure them, porque las dimensiones importan tanto como las herramientas.
Regla práctica: si un problema de datos solo puede ser detectado por una persona que abre una hoja de cálculo al final de la semana, ya es demasiado tarde para la IA operativa.
La pregunta clave es si el sistema puede detectar derivaciones, retrasos, duplicaciones y problemas de validez antes de que los usuarios empresariales vean los síntomas. Esa es la norma crítica actual, y es un listón tanto de governance como técnico.
Qué significa realmente la calidad de los datos de IA
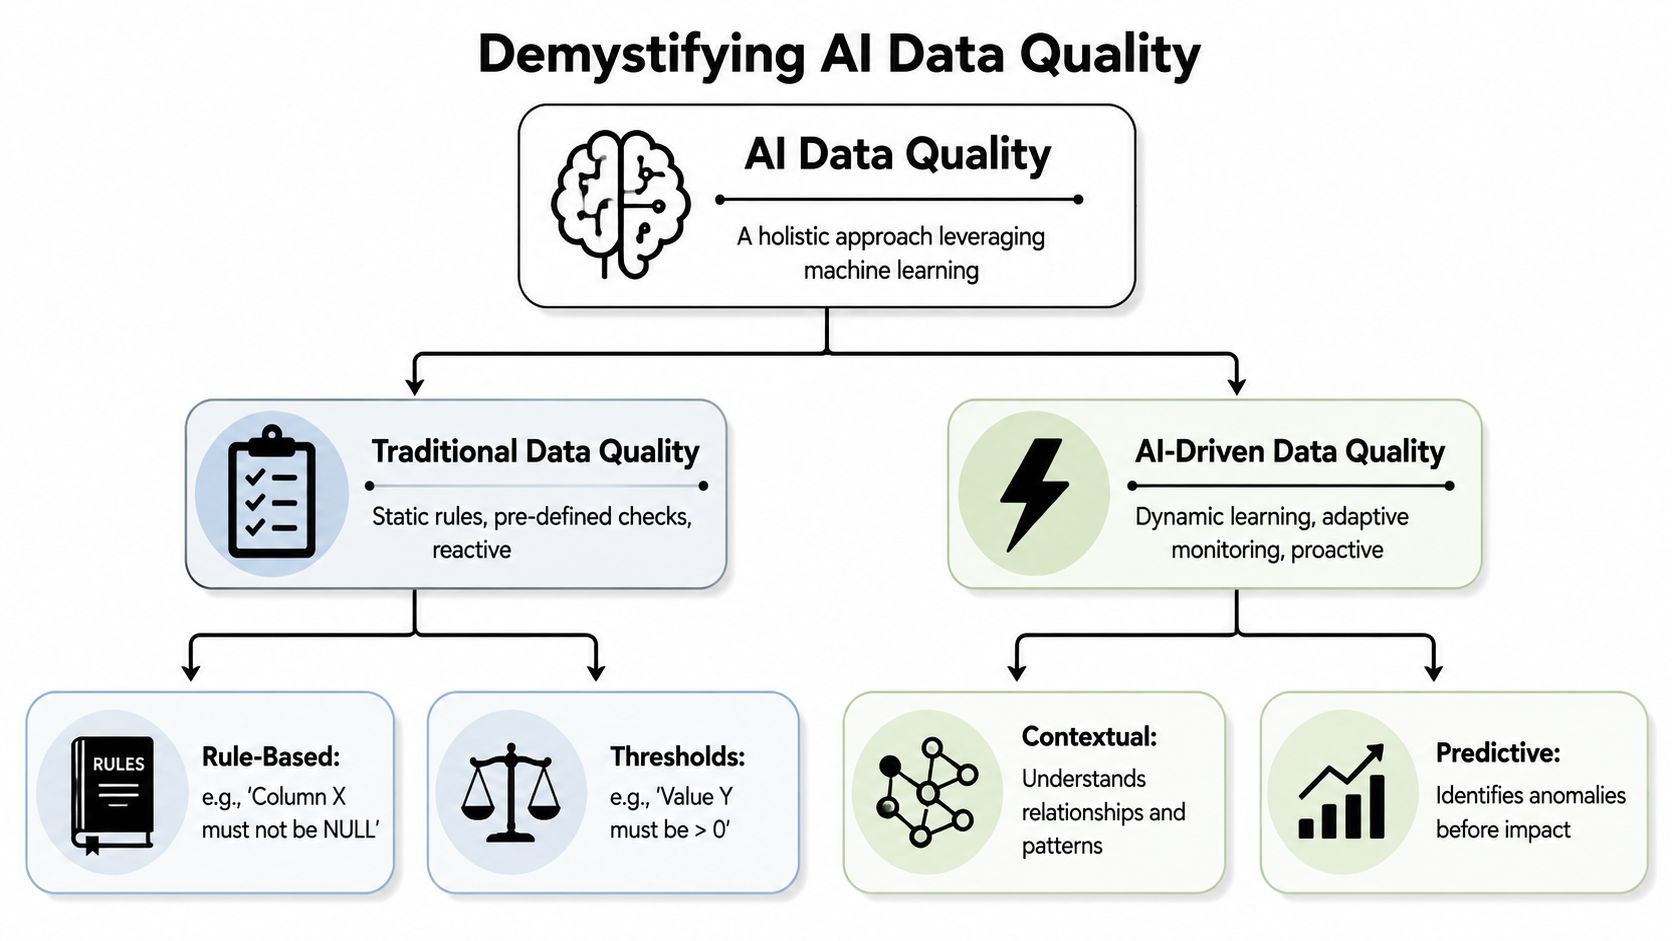
Las comprobaciones de datos tradicionales son como la alarma de un coche que tiene una sola función: gritar cuando se abre una ventana. Útil, pero rudimentario. Un sistema de seguridad inteligente para el hogar observa los patrones de movimiento, las horas de paso por las puertas, los accesos inusuales y el contexto de lo que es normal para esa casa. La calidad de los datos de IA funciona más bien como el segundo modelo, porque aprende el pulso de una canalización en lugar de esperar a que se rompa una única regla.
La definición de la FRA es un buen punto de referencia aquí. Afirma que la calidad de los datos para la IA incluye completitud, precisión, consistencia, puntualidad, duplicación, validez, disponibilidad y procedencia (FRA report). Esto es importante porque amplía el enfoque. Un conjunto de datos puede ser preciso en un sentido estricto y seguir siendo inútil si llega tarde, carece de procedencia o ha variado lo suficiente como para que las decisiones derivadas no sean confiables.
Reglas estáticas frente a comportamiento aprendido
La supervisión basada en reglas se pregunta cosas como "¿La columna X es nula?" o "¿El valor Y es superior a cero?". Esas comprobaciones siguen siendo útiles y nadie con criterio debería descartarlas. Pero solo detectan las condiciones que ya se pensó en codificar.
El monitoreo impulsado por IA aprende patrones normales a lo largo del tiempo, volumen, distribución, estacionalidad y relaciones entre campos. Puede alertar sobre un cambio incluso cuando los valores brutos siguen superando un umbral fijo. Esa es la diferencia clave, y por eso los equipos modernos utilizan la IA para complementar, no para reemplazar, las reglas estrictas.
Las dimensiones que realmente importan
El marco de la FRA también ayuda a los equipos a evitar un error común: tratar la "calidad de los datos" como una puntuación única y vaga. No lo es. Las dimensiones se dividen en diferentes preguntas operativas.
La completitud pregunta si los datos están ahí.
La puntualidad pregunta si llegaron cuando se esperaba.
La consistencia pregunta si los registros siguen coincidiendo entre sí.
La procedencia pregunta de dónde provienen y cómo cambiaron.
La validez pregunta si los registros siguen teniendo sentido frente a la forma esperada del negocio.
Esa definición más amplia se alinea bien con la Observability operativa. Un sistema que supervisa tendencias, cambios de esquema, llegadas tardías y validez a nivel de registro está haciendo un trabajo real de calidad de datos, no solo de mantenimiento.
Cómo mejora activamente la IA el monitoreo de datos
La práctica de las estadísticas oficiales europeas ya demuestra cómo funciona esto en la práctica. La IA se está utilizando para apoyar la ingesta, clasificación, edición, detección de anomalías y sugerencias de imputación de datos, mientras que la supervisión humana se mantiene en el proceso para proteger la calidad (EU official statistics webinar). Este es un modelo útil también para los equipos empresariales, porque mantiene a la máquina enfocada en la detección de patrones y al experto enfocado en el criterio.
La mayor ventaja no es que la IA sea mágica. Es que escala el tipo de vigilancia que a los humanos nos cuesta mantener de forma manual. Una plataforma puede aprender que un flujo de datos suele llegar a la misma hora los días laborables, o que una métrica sube de forma natural tras un evento empresarial específico, y luego señalar la excepción sin que nadie tenga que escribir una regla personalizada para cada caso. Para una visión más a nivel de producto, el flujo de trabajo descrito en how AI detects data anomalies in pipelines se adapta perfectamente a la forma en que los equipos priorizan los incidentes.
Líneas de base que se mueven con los datos
Los umbrales estáticos son frágiles porque la normalidad cambia con el tiempo. Un negocio estacional no tiene un único patrón fijo, y tampoco lo tiene un almacén moderno. El aprendizaje de líneas de base por IA se adapta al comportamiento recurrente, de modo que la alerta se activa ante el cambio inesperado en lugar de ante el ciclo previsto.
Eso marca una diferencia real en la respuesta a incidentes. En lugar de discutir si un pico es "malo", los equipos pueden ver si se desvía del patrón aprendido. La señal mejora y el ruido disminuye.
La puntualidad es un problema de calidad, no una molestia de calendario
La gestión de datos europea trata la puntualidad como una calidad formal, no como una preocupación operativa menor. El marco EUROCAT DQI incluye la puntualidad en la transmisión de datos junto con la completitud y la precisión (EUROCAT DQI list). Es un recordatorio contundente de que una entrega tardía puede ser tan perjudicial como un valor erróneo.
Un flujo de datos que llega con dos horas de retraso puede ser más peligroso que uno con un error visible, porque el panel de control sigue pareciendo correcto mientras el negocio opera con números desactualizados.
Reglas tradicionales frente a monitoreo impulsado por IA
Aspecto | Enfoque tradicional basado en reglas | Enfoque impulsado por IA |
|---|---|---|
Estilo de detección | Umbrales fijos y comprobaciones manuales | Aprende el comportamiento y vigila las desviaciones |
Momento de respuesta | A menudo reactivo | Proactivo y continuo |
Cobertura | Limitado a modos de fallo conocidos | Mejor para encontrar anomalías desconocidas |
Mantenimiento | Las reglas requieren mantenimiento constante | Los modelos se adaptan a medida que evolucionan las canalizaciones |
Puntualidad | Normalmente independiente de otras comprobaciones | Supervisado como parte del comportamiento normal |
Para los equipos que gestionan canalizaciones complejas, este cambio convierte el monitoreo de una alarma de incendios a un sistema de alerta temprana.
Los beneficios reales y los riesgos ocultos
El mejor argumento a favor de la calidad de los datos de IA es sencillo. Reduce el tiempo que los equipos dedican a escribir y mantener pruebas frágiles, y detecta problemas que nadie había pensado codificar de antemano. Esto es importante cuando las canalizaciones cambian a menudo y los modos de fallo siguen evolucionando. También mejora la confianza, porque los analistas y los usuarios empresariales dejan de ver las comprobaciones de calidad como un ritual administrativo y empiezan a verlas como parte del producto.
También hay un beneficio más profundo en las industrias reguladas. La investigación de profesionales alineada con las regulaciones de la UE descubrió que la pérdida de datos era el principal problema de calidad, mientras que los problemas de privacidad (37%) eran una gran preocupación (EU-aligned practitioner research). Eso nos recuerda que el trabajo de calidad en finanzas, sanidad y telecomunicaciones debe realizarse dentro de entornos controlados, no después de que los datos sensibles se hayan enviado a otra parte para su inspección.
Qué mejora con rapidez
Generalmente, los equipos notan tres ventajas prácticas primero. La primera es la reducción del triaje manual, porque el sistema filtra el ruido obvio antes de que intervenga una persona. La segunda es una alerta más temprana sobre problemas desconocidos, lo que importa más que la clasificación perfecta de cada incidente. La tercera es una mayor confianza en los informes derivados, lo que hace que la gente sea menos propensa a construir sus propias comprobaciones paralelas.
Sin embargo, esa confianza es frágil. Si la propia capa de monitoreo se vuelve opaca, o si cada caso atípico desencadena una alerta ruidosa, la adopción se frena. La fatiga por alertas puede acabar con un buen sistema más rápido que un mal modelado.
El dilema de la privacidad que la mayoría de los artículos ignoran
Un proveedor que copia datos confidenciales fuera de un entorno controlado crea un problema nuevo mientras intenta resolver el antiguo. Para los equipos regulados, el patrón más seguro suele ser el monitoreo en la base de datos o en las instalaciones (on-prem), donde el análisis se ejecuta junto a los datos en lugar de mover los datos para el análisis. Esa arquitectura se alinea con los sectores que necesitan privacidad por defecto, y es una de las razones por las que la elección de la plataforma importa más que las listas de características.
La misma tensión entre privacidad y governance se manifiesta también en las pruebas médicas. Un paralelismo útil es mastering clinical test accuracy, porque ayuda a estructurar por qué la sensibilidad, la especificidad y el contexto importan tanto cuando el coste de una señal errónea es alto.
Por qué la arquitectura forma parte de la historia de la calidad
digna se ejecuta dentro del entorno del cliente, ya sea en local o en una nube privada, y sus documentos indican que nunca se ofrece como SaaS, sin acceso del proveedor a los datos del cliente (digna docs in Spanish). Esa elección de diseño no es un adorno de marketing. Aborda directamente la barrera práctica al que se enfrentan muchos equipos europeos, que consiste en cómo mejorar la calidad sin debilitar el control.
También es importante para las pruebas de governance. Si el sistema que comprueba la calidad funciona dentro de un entorno protegido, el historial de auditoría es más limpio y la revisión de seguridad suele ser menos compleja.
Adopción de la calidad de datos de IA en la empresa
La implementación empresarial suele fracasar por una de dos razones. O bien el equipo compra una herramienta llamativa antes de definir el problema operativo, o bien la acoplan a un flujo de trabajo que nadie asume como propio. El camino correcto es más estrecho y menos vistoso. Elija una canalización crítica, un consumidor de negocio y un conjunto de problemas de calidad que ya estén causando dificultades.
A partir de ahí, los criterios de evaluación resultan más claros. Una plataforma real debe integrarse con la tecnología actual, aprender patrones sin necesidad de redactar infinitas reglas manuales, ofrecer explicaciones suficientes para que ingenieros y analistas confíen en el resultado, y funcionar bajo el modelo de seguridad que su organización ya utiliza. Si no puede hacer esas cosas, se convertirá en un software en desuso con un panel de control decorativo.
Qué buscar antes de implementar cualquier solución
Profundidad de integración: Debe funcionar con su almacén, lago de datos y canalizaciones sin obligar a usar una infraestructura paralela.
Transparencia del modelo: Los equipos necesitan entender por qué se señaló un problema, no solo saber que se ha señalado.
Adecuación al governance: Debe generar evidencias que admitan la validación, las pruebas y la revisión.
Control de despliegue: Para cargas de trabajo sensibles, busque la ejecución en nube privada o local.
Usabilidad para múltiples usuarios: Ingenieros, analistas y responsables de governance necesitan diferentes vistas de un mismo problema.
Este último punto a menudo se subestima. Si solo un especialista puede usar la herramienta, el proceso no escala.
La presión regulatoria cambia la decisión de compra
Bajo la Ley de IA de la UE, los conjuntos de datos para sistemas de IA de alto riesgo deben ser gobernados a lo largo de su ciclo de vida para que sigan siendo pertinentes, representativos, libres de errores y completos (EU AI Act analysis). Eso significa que la detección de anomalías, las comprobaciones de sesgos y la gestión de datos ausentes no son extras opcionales. Son parte del plano de control.
Una plataforma con ejecución en la base de datos puede ayudar porque mantiene el análisis cerca de los datos y preserva el rastro de evidencias. Esto es especialmente útil cuando los equipos de governance necesitan demostrar cómo se supervisó un conjunto de datos, en lugar de simplemente afirmar que fue "limpiado".
Un enfoque práctico consiste en empezar con un flujo de datos que ya sea importante para los ingresos, el Compliance o la experiencia del cliente. Demuestre que el sistema puede detectar llegadas tardías, cambios de esquema o variaciones de volatilidad antes de que sean visibles para el negocio, y luego expándase a partir de ahí. Eso supera a un despliegue generalizado en todos los casos.
Próximos pasos hacia un monitoreo inteligente de datos
El cambio principal ya está claro. La calidad de los datos de IA no es una capa decorativa sobre las reglas antiguas, es el modelo operativo para los datos que cambian demasiado rápido como para supervisarlos a mano. Las organizaciones que lo hacen bien dejan de discutir si cada fila es perfecta y empiezan a centrarse en si la canalización es confiable, explicable y está lista para auditar.
Si quiere avanzar en esto la próxima semana, simplifique el proceso.
Elija una canalización de alto valor y detalle los fallos de calidad que afectan a las decisiones.
Pruebe cómo gestionan sus herramientas actuales las anomalías desconocidas, no solo los incumplimientos de reglas conocidos.
Lleve la Observability a la conversación sobre governance para que las áreas de cumplimiento, ingeniería y analítica evalúen las mismas evidencias.
Para un punto de partida práctico, revise digna's data quality monitoring tools y compárelas con sus patrones de incidentes actuales, sus limitaciones de despliegue y sus necesidades de auditoría. Luego, lleve esa selección a su próxima revisión de plataforma de datos con una pregunta clara: ¿Puede esta configuración proteger la confianza en los datos sin ralentizar el negocio?
Un llamado a la acción para digna.
Para ver cómo las líneas base aprendidas, Timeliness y la monitorización de esquemas se combinan dentro del entorno del cliente y no en la nube de un proveedor, consulte digna para la observabilidad de plataformas de datos.
Preguntas frecuentes
¿Qué es la calidad de datos con IA?
La calidad de datos con IA es una monitorización que aprende los patrones normales de un pipeline en tiempo, volumen, distribución, estacionalidad y relaciones entre campos, y señala desviaciones aunque los valores superen umbrales fijos. El artículo la compara con un sistema de seguridad doméstico inteligente, frente a las comprobaciones tradicionales, similares a una alarma de coche con una sola función.
¿Qué dimensiones definen la calidad de datos para la IA?
Según la definición de la FRA citada en el artículo, la calidad de datos para la IA abarca completitud, exactitud, coherencia, puntualidad, duplicación, validez, disponibilidad y procedencia. Esto amplía la perspectiva: un conjunto de datos puede ser exacto en sentido estricto y aun así inútil si llega tarde, carece de procedencia o se ha desplazado.
¿Sustituye la IA a las comprobaciones de calidad basadas en reglas?
No, la IA complementa las reglas fijas en lugar de sustituirlas. Comprobaciones como «¿Es nula la columna X?» o «¿Es el valor Y mayor que cero?» siguen siendo útiles, pero solo detectan condiciones ya codificadas. La monitorización aprendida añade cobertura para anomalías desconocidas, como un feed puntual con una distribución alterada.
¿Qué exige el Reglamento de IA de la UE sobre la calidad de los datos de entrenamiento?
Según el Reglamento de IA de la UE, los conjuntos de datos de sistemas de IA de alto riesgo deben gobernarse durante todo su ciclo de vida para que sigan siendo pertinentes, representativos, libres de errores y completos. El artículo concluye que la detección de anomalías, los controles de sesgo y el tratamiento de datos ausentes pasan a formar parte del plano de control.
¿Cómo debe empezar una empresa a adoptar la calidad de datos con IA?
Empiece de forma acotada: elija un pipeline crítico, un consumidor de negocio y un conjunto de preguntas de calidad que ya causen problemas. Demuestre que el sistema detecta llegadas tardías, cambios de esquema o variaciones de volatilidad antes que el negocio y luego amplíe, evaluando integración, transparencia del modelo, encaje con la gobernanza, control del despliegue y usabilidad para distintos perfiles.



