Análisis de Datos de Calidad: una Guía Práctica para Equipos Modernos
|
8
minuto de lectura

Abres un panel de control un lunes y el número en la esquina superior derecha no coincide con lo que finanzas esperaba. Nadie sabe decir si el problema empezó anoche, la semana pasada o hace dos cambios en la canalización. Ese es el momento en que el Data Analytics de calidad deja de ser una buena práctica abstracta para convertirse en una habilidad de supervivencia práctica, porque el trabajo no consiste solo en limpiar los datos después de que se dañen. Consiste en visibilizar a tiempo los problemas de datos silenciosos, medirlos con disciplina estadística y evitar, en primer lugar, que afecten a las decisiones.
Tabla de contenidos
Las dimensiones clave que hacen que los datos sean confiables
Cómo aplican las distintas industrias el Data Analytics de calidad
Errores comunes y los ángulos que la mayoría de las guías pasan por alto
Cuando tu panel de control deja de decir la verdad
Un panel de control roto no suele parecer roto. Sigue cargando, los gráficos se siguen mostrando y los nombres de los KPI siguen sonando familiares. El problema es más profundo: los registros subyacentes pueden estar desactualizados, duplicados, incompletos o ser inconsistentes, por lo que el informe se convierte en una versión pulida de la historia equivocada.
Es por eso que el Data Analytics de calidad importa. La mala calidad de los datos no es un problema estético, es un riesgo operativo que puede distorsionar las decisiones antes de que nadie note que el gráfico se ve mal. Las estimaciones reportadas por Gartner citadas en 2023 sitúan el coste anual medio de la mala calidad de los datos en 12,9 millones de dólares por organización, y el trabajo sobre el coste de la mala calidad de los datos de IBM de 2022 reveló que la inexactitud puede provocar alrededor del 25% de la pérdida de ingresos para las grandes empresas debido a la toma de decisiones defectuosa. Esas cifras cambiaron la conversación de "por favor, limpia los datos" a "esto necesita observación y control continuos" (Estadísticas de calidad de datos de Gitnux).
Muchos equipos todavía tratan la calidad de los datos como una tarea de limpieza de última hora. Realizan un trabajo de limpieza antes de que se publique un informe y luego esperan que el problema no vuelva a ocurrir. Ese modelo falla porque el fallo suele comenzar antes, en la ingesta, las transformaciones, la deriva del esquema o las alimentaciones retrasadas, mucho antes de que nadie vea el gráfico. Una regla a nivel de campo en un formulario, como las comprobaciones que se muestran en la guía de validación de formularios de Formcarry, solo detecta una capa del problema. La disciplina más amplia observa cómo se comportan esas entradas después de ingresar a la canalización, de la misma manera que un mecánico escucha un ruido nuevo después de que el motor ya está en marcha.
Regla práctica: si una métrica puede cambiar sin un error visible, necesita un monitoreo continuo, no una auditoría única.
La disciplina moderna combina la estadística descriptiva clásica con la detección automatizada de anomalías y el aprendizaje de la línea de base, de modo que los equipos puedan detectar comportamientos inusuales en grandes conjuntos de datos de forma continua en lugar de depender de revisiones manuales periódicas. También funciona mejor cuando las comprobaciones se mantienen cerca de los datos, por ejemplo, con un perfilado en la base de datos que evita mover tablas masivas a una herramienta separada. Esa es la promesa aquí: convertir el fallo invisible en una deriva medible, luego en acción, y vigilar de cerca los flujos de datos sensibles a la equidad con un marco práctico como el que se describe en esta guía sobre dimensiones de calidad de datos.
Definir el Data Analytics de calidad sin tecnicismos
Una buena analogía es la seguridad alimentaria. Una cocina no se gana la confianza de la gente porque pasó una inspección una vez. Se la gana porque la temperatura, el origen, la higiene y la frescura se comprueban una y otra vez, de modo que la comida sigue siendo segura incluso cuando el personal cambia o el volumen aumenta.
El Data Analytics de calidad funciona de la misma manera. No es una única auditoría y no es una lista de verificación de limpieza. Es el proceso continuo de medir si los datos siguen mereciendo confianza a medida que se mueven por los sistemas, cambian de forma y alimentan las decisiones.
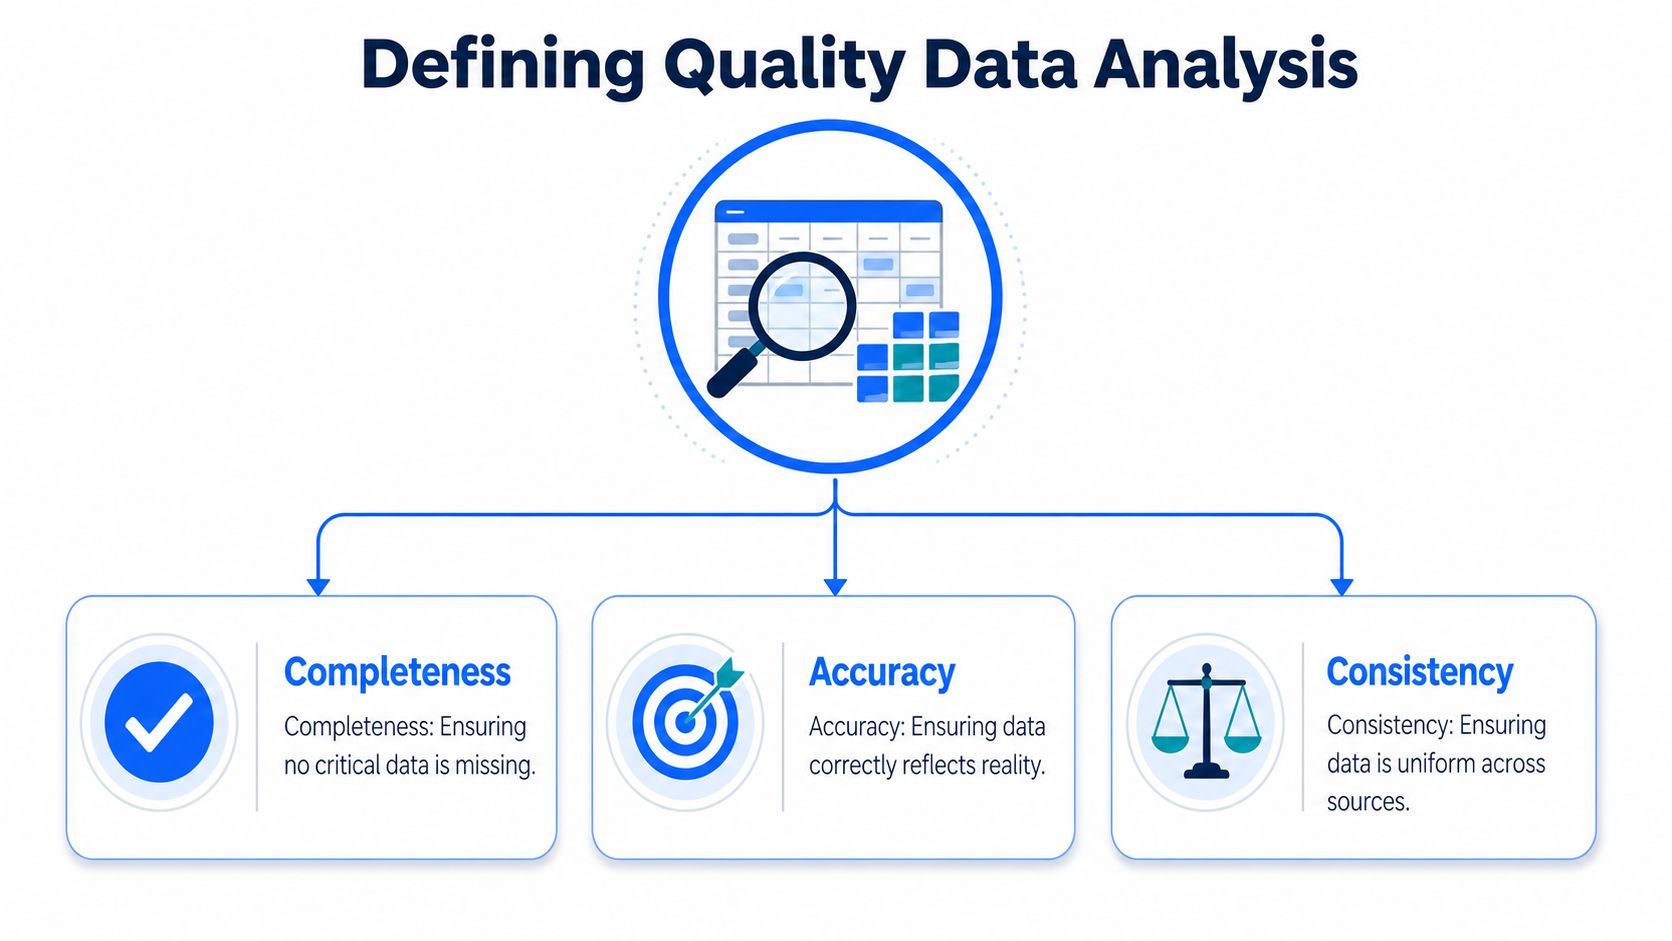
El aspecto formal de esto es más amplio de lo que muchos esperan. El marco de calidad estadística del FMI identifica seis dimensiones: relevancia, precisión, Timeliness, accesibilidad, interpretabilidad y coherencia (Marco de calidad estadística del FMI). La definición operativa de IBM amplía el panorama con precisión, completitud, validez, consistencia, unicidad, Timeliness y adecuación para el propósito (Calidad de datos de IBM). La idea clave es simple: un conjunto de datos puede estar técnicamente presente y aun así no ser adecuado para la pregunta que te estás planteando.
Lo que no es
No es solo limpieza de datos, porque la limpieza elimina los defectos conocidos pero no te dice cuándo está cambiando la tasa de defectos. No es un panel de control, porque los paneles resumen el estado pero no explican si la entrada es confiable. No es una única "puntuación de calidad", porque una sola puntuación puede ocultar muchos modos de fallo diferentes.
Piensa en una tabla que no tiene valores nulos, pero sus marcas de tiempo tienen tres días de retraso. O un conjunto de datos que está actualizado, pero una unidad de negocio utiliza un código de categoría diferente al del resto de la empresa. En ambos casos, los números pueden parecer ordenados, pero el análisis sigue sin ser confiable.
El flujo de trabajo de análisis de datos de Coursera ubica la limpieza, la revisión de valores atípicos y la interpretación dentro del proceso de análisis general, no como algo secundario (Guía de análisis de datos de Coursera). Ese orden importa, porque los controles de calidad pertenecen al lugar donde se recopilan, transforman e interpretan los datos, no solo donde se muestran.
Las dimensiones clave que hacen que los datos sean confiables
Las dimensiones son más fáciles de recordar si las vinculas con modos de fallo concretos. Cada una responde a una pregunta diferente y cada una puede fallar mientras las demás parecen correctas. Por eso, un único porcentaje de completitud no cuenta la historia completa.
Una comparación práctica
Dimensión | Qué significa | Ejemplo de fallo | Métrica a monitorear |
|---|---|---|---|
Precisión | Los valores coinciden con la realidad | El estado de un cliente se marca como activo después de la cancelación | Tasa de error frente a una referencia de confianza |
Completitud | Los datos esperados están presentes | Los campos de dirección requeridos están vacíos | Tasa de nulos o tasa de campos faltantes |
Consistencia | El mismo hecho coincide entre tablas | Los ingresos difieren entre los modelos de finanzas y de BI | Tasa de discrepancia entre tablas |
Unicidad | Los registros no están duplicados | El mismo pedido aparece dos veces después de volver a procesarlo | Tasa de duplicados |
Validez | Los valores siguen reglas y formatos | Un campo de fecha contiene texto | Tasa de infracción de reglas |
Timeliness | Los datos llegan cuando se necesitan | Una alimentación diaria llega después del cierre del informe | Retraso en la ingesta u horas desde la actualización |
Adecuación para el propósito | Los datos responden a la pregunta de negocio | El conjunto de datos omite la región que el equipo necesita | Cobertura frente al alcance de la decisión |
La precisión es lo más fácil de explicar, pero a menudo lo más difícil de verificar. Un número puede tener el formato correcto y aun así ser incorrecto en el sentido de negocio. Es por eso que los equipos de calidad comparan con sistemas de origen, tablas de referencia o lógica de conciliación en lugar de asumir que la validez sintáctica equivale a la verdad.
La completitud es la que destaca de inmediato, pero puede ser engañosa por sí sola. Una tabla sin nulos aún podría excluir a todo un segmento de clientes si la lógica de carga eliminó una columna o filtró una región. La Timeliness tiene la misma trampa, porque los datos actualizados aún pueden ser inútiles si llegaron con el contenido incorrecto.
La consistencia y la unicidad suelen aparecer cuando se unen sistemas. Si un almacén de finanzas y un data mart de informes no coinciden, alguien tiene que decidir qué fuente es la autoritativa. Si los duplicados se infiltran, el gráfico puede seguir pareciendo fluido mientras los totales se desvían hacia arriba sin ningún error obvio.
La validez es donde importan las reglas de negocio. La guía de validación de campos de Formcarry es un ejemplo externo útil de cómo los sistemas pueden imponer formatos y entradas requeridos antes de que los registros defectuosos se extiendan analítica abajo. En analítica, se aplica la misma lógica a los códigos postales, los valores de estado, los rangos y las restricciones de fecha.
Un hábito útil: monitorea la dimensión que más importa para la decisión y luego mantén las demás en el radar para no optimizar un tipo de confianza mientras destruyes otro.
La adecuación para el propósito es la comprobación final, y es la que muchos equipos pasan por alto. Un conjunto de datos puede ser preciso, completo y consistente, y aun así fallar si no contiene la sección de negocio de la que depende la pregunta. Ahí es donde el marco interno en la descripción general de las dimensiones de calidad de datos de digna encaja bien con el pensamiento de governance.
Métodos y flujos de trabajo para realizar el análisis
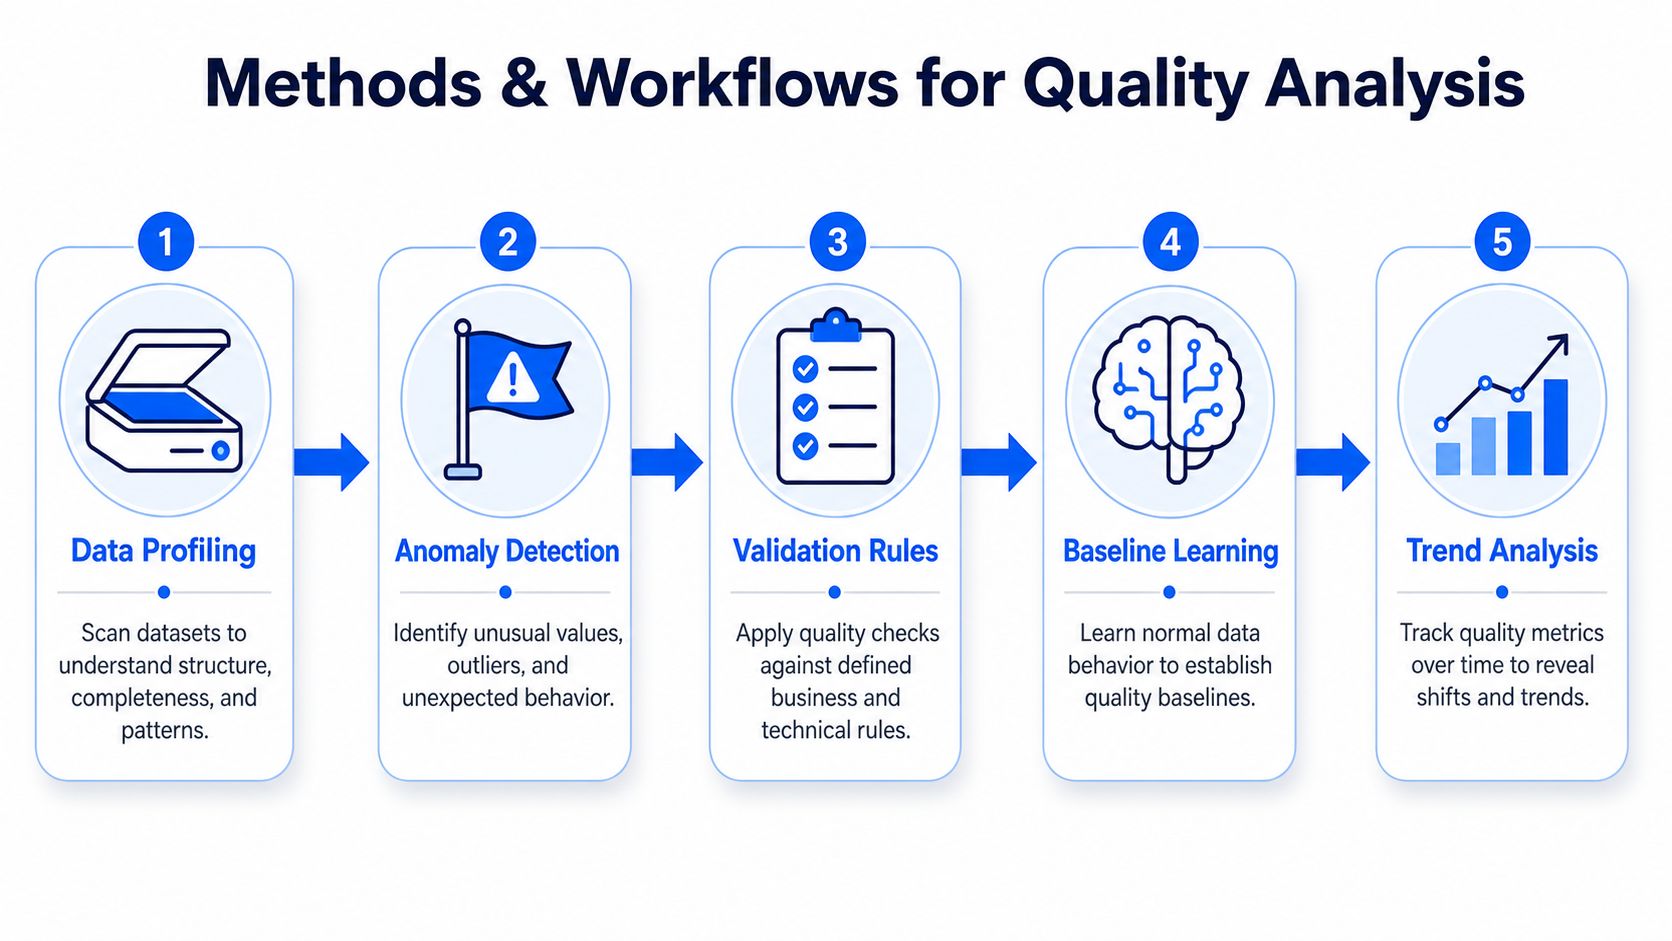
Una revisión de calidad suele comenzar en el momento en que llegan los datos, no después de que el panel de control se rompa. Un método detecta la falta de datos, otro detecta la deriva y un tercero detecta valores que aprueban una regla pero que aún se ven incorrectos en su contexto. El trabajo se parece más a un triaje médico que a una limpieza única, porque cada comprobación responde a una pregunta diferente sobre el mismo conjunto de datos.
Comienza con el perfilado
El perfilado responde a una pregunta simple: ¿cómo se ve lo normal aquí? Los equipos utilizan la media, la mediana, la moda, la desviación estándar, la varianza y el rango para resumir las distribuciones, detectar sesgos y comprender la dispersión, lo que les brinda una línea de base antes de decidir qué merece atención. Un buen punto de partida son las técnicas de perfilado de datos, porque el objetivo es conocer la forma de los datos antes de plasmar suposiciones en las comprobaciones.
Un nuevo compañero de equipo a menudo espera que el perfilado sea un informe único. Funciona más bien como revisar el panel de instrumentos antes de cada turno. Si los valores de los pedidos han sido estables durante semanas y de repente una columna se llena de ceros, ese cambio merece una revisión incluso cuando ninguna regla explícita haya fallado.
Añade detección de anomalías y reglas
La detección de anomalías funciona mejor cuando compara los registros actuales con el propio historial del conjunto de datos. Las reglas de puntuación Z y del rango intercuartílico ayudan a marcar valores que se encuentran muy fuera del intervalo normal, lo cual es útil para valores atípicos, picos inusuales y registros que merecen una revisión manual.
La validación determinista juega un papel diferente. Comprueba la lógica a nivel de fila, como los campos obligatorios, los valores permitidos y las dependencias entre campos. Si se infringe la regla, el registro falla y la decisión es inmediata.
La guía de análisis de calidad también recomienda emparejar el análisis de tendencias con la validación para que los equipos puedan detectar campos faltantes, valores fuera de rango y retrasos en la entrega al principio de la canalización (Análisis de calidad de Skymes). Esa combinación importa porque un defecto que se repite lentamente puede superar reglas estrictas mientras sigue cambiando la forma de los datos. Una tabla de informes puede seguir siendo técnicamente válida mientras se desvía constantemente de los valores que la gente cree estar leyendo.
Aprende la línea de base y luego observa la tendencia
El aprendizaje de la línea de base reemplaza los umbrales estáticos con modelos de comportamiento que se adaptan a cada conjunto de datos. En lugar de preguntar si un conteo se sitúa por encima de una línea arbitraria, el sistema pregunta si el comportamiento de hoy se aparta del patrón normal de esa tabla. Esto se adapta bien a los datos operativos, porque una alimentación puede oscilar de forma natural mientras otra se mantiene estrecha y predecible.
El análisis de tendencias detecta lo que una sola alerta pasa por alto. Es posible que un campo nunca cruce un límite estricto, pero si la falta de datos aumenta durante una semana, el panel de control posterior seguirá desviándose. El análisis de tendencias históricas es también una parte central del módulo de Data Analytics de digna, que calcula estadísticas de nivel superior como la tendencia y la volatilidad a partir de métricas de datos centrales, para que los equipos puedan seguir monitoreando dentro de su propio entorno sin tener que mover los datos a otra parte.
Patrones de implementación que escalan
La primera pregunta de despliegue suele ser sobre la ubicación. ¿Dónde deberían ejecutarse las comprobaciones y cuántos datos deberían moverse para que se ejecuten? Esa elección afecta a la latencia, el governance, el coste y la rapidez con la que un equipo puede reaccionar cuando algo cambia. También determina si el Data Analytics de calidad se mantiene como un control activo dentro de la canalización o se convierte en una tarea independiente que la gente inspecciona demasiado tarde.
Cuatro patrones que usan los equipos
El análisis en la base de datos ejecuta las comprobaciones donde ya viven los datos. Eso mantiene el movimiento bajo y se adapta a los requisitos de seguridad, porque los datos permanecen en su lugar mientras se computan las métricas. También funciona bien para el perfilado estadístico, donde se desea medir las distribuciones, la falta de datos y la deriva con respecto a la tabla real en lugar de una muestra copiada.
Los servicios de escaneo externo copian o transmiten muestras a un entorno separado. Eso puede ser útil para una inspección rápida, pero añade movimiento, duplicación y otro lugar al que pueden viajar los datos sensibles. Una muestra copiada puede ayudar a un equipo a detectar problemas obvios, pero también puede ocultar cambios sutiles que solo se muestran en el origen.
Las comprobaciones nativas de la canalización viven dentro del código de ETL o de transformación. Son fáciles de adjuntar a un trabajo específico, lo que hace que la ruta de fallo sea clara, pero pueden volverse frágiles si cada equipo escribe sus propias reglas sin líneas de base compartidas. En la práctica, este patrón funciona mejor cuando las comprobaciones son pequeñas, explícitas y están vinculadas a la transformación exacta que protegen.
Las plataformas de Observability combinan validación, detección de anomalías, seguimiento de esquemas y alertas en una sola capa. Son la opción más adecuada para el monitoreo continuo porque unen reglas, líneas de base y gestión de incidentes. Para los equipos que construyen ese camino, el enfoque de implementación descrito en la guía de implementación de calidad de datos de digna muestra cómo esas piezas pueden permanecer dentro del entorno del cliente en lugar de dispersarse en herramientas separadas.
Cómo elegir
Si tu prioridad es la baja latencia y un governance estricto, la ejecución en la base de datos suele ganar. Si tu equipo necesita una inspección ligera para una pequeña porción de datos, el escaneo externo puede ser suficiente. Si deseas aplicar controles cerca de la lógica de transformación, las comprobaciones nativas de la canalización tienen sentido. Si necesitas un único lugar para ver incidentes, tendencias y estados en muchos conjuntos de datos, una plataforma de Observability es más fácil de operar.
Consejo operativo: elige primero el patrón que responda a tu mayor limitación, no el que parezca más fácil en una demostración.
Las alertas también importan. Los vigilantes de cambios de esquema deben marcar las columnas agregadas o eliminadas, las alertas de deriva de la línea de base deben mostrar movimientos inusuales y las rutas de escalada deben definir quién soluciona qué. Las pruebas listas para auditoría se vuelven mucho más fáciles de producir cuando el sistema registra el tiempo de detección, el tiempo de resolución y la regla o anomalía exacta que desencadenó el incidente. Ese registro también ayuda a los equipos a revisar si el problema fue un ruido aleatorio, un fallo recurrente de la canalización o un cambio más amplio que necesita un umbral diferente.
digna es un ejemplo de plataforma construida en torno a esas ideas, con ejecución en la base de datos, aprendizaje de la línea de base impulsado por IA, seguimiento de esquemas y monitoreo de Timeliness dentro del propio entorno del cliente. Esa configuración se adapta a los equipos que desean comprobaciones continuas sin tener que mover los datos de producción a una capa de escaneo separada.
Cómo aplican las distintas industrias el Data Analytics de calidad
La misma mecánica se desarrolla de manera diferente según lo que esté en juego. Un equipo de finanzas se preocupa por las alimentaciones regulatorias rotas y la integridad de las transacciones. Un equipo de atención médica se preocupa por la estructura de las reclamaciones, los registros clínicos y la Timeliness. Un equipo de telecomunicaciones necesita proteger las alimentaciones operativas de alto volumen sin ahogarse en el ruido. Un equipo del sector público necesita trazabilidad y evidencia que pueda sobrevivir a una auditoría.
Qué cambia según la industria
Los servicios financieros suelen monitorear primero los datos de riesgo, los datos transaccionales y los datos regulatorios. La prioridad práctica es detectar fuentes tardías, totales no coincidentes y cambios de esquema antes de que los informes o los controles posteriores dependan de ellos. El tiempo de detección y el tiempo de resolución se convierten en KPI centrales porque un retraso puede afectar a múltiples procesos a la vez.
La atención médica se apoya firmemente en la completitud, la frescura y la estabilidad estructural en los flujos de trabajo clínicos y operativos. Un cambio de esquema en los datos de reclamaciones o una carga faltante en la alimentación de un paciente pueden distorsionar tanto el análisis de la atención como los informes de cumplimiento, por lo que los equipos tienden a vigilar de cerca las tasas de infracción de reglas y los tiempos de entrega.
Las telecomunicaciones manejan grandes flujos operativos donde el problema a menudo no es una fila incorrecta, sino un cambio sutil en el volumen o el formato. Las infracciones de umbral en los registros de detalles de llamadas y los cambios inesperados en los campos son el tipo de problemas que se escapan si el monitoreo es demasiado estático.
El sector público necesita consistencia, trazabilidad y evidencia lista para auditorías más que cualquier otra cosa. Un informe puede ser técnicamente correcto, pero si no se puede mostrar el linaje de los datos o el historial de validación, el trabajo sigue sin cumplir con las expectativas de confianza pública.
El Comité Federal de Metodología Estadística define la calidad de los datos como “el grado en que los datos capturan la información deseada utilizando una metodología adecuada de manera que se mantenga la confianza pública” (Marco FCSM). Esa formulación se adapta a cada uno de estos sectores, porque el objetivo no es solo la precisión, es el uso confiable en su contexto.
En todas esas industrias, sigue apareciendo el mismo conjunto de controles: comprobaciones de frescura, validación a nivel de registro, seguimiento de esquemas y detección de anomalías. La pregunta de negocio cambia, pero la disciplina no.
Errores comunes y los ángulos que la mayoría de las guías pasan por alto
Una sola puntuación de calidad global suena ordenada, pero oculta demasiado. Un grupo puede tener datos limpios y recientes mientras que otro grupo carece de registros, está subrepresentado o se ve afectado por un cambio de esquema silencioso. El promedio parece correcto y, aun así, la decisión resulta inequitativa.
Por qué importan las comprobaciones de subgrupos
Las directrices de salud pública y políticas enfatizan las comprobaciones de datos faltantes subgrupo por subgrupo, la imputación separada cuando la falta de datos difiere entre grupos y la documentación explícita de quién no puede ser representado con precisión con los datos disponibles (Guía de análisis de equidad de ASPE). Ese es un recordatorio contundente de que la completitud de todo el conjunto de datos puede ocultar la exclusión. Si una región tiene pocos datos, o si un grupo históricamente excluido es sistemáticamente más pequeño en los datos, el modelo aún puede estar sesgado incluso cuando la tabla esté "casi completa".
Por qué los sistemas de IA son frágiles aquí
El otro ángulo que se pasa por alto es la IA y el monitoreo casi en tiempo real. El trabajo de calidad tradicional a menudo se detiene en el perfilado periódico, pero las directrices estadísticas recientes enfatizan la revisión continua del volumen de registros, la falta de datos en campos críticos, la viabilidad de los valores y las tendencias fuera de rango para detectar problemas en las canalizaciones de manera temprana (Informe técnico de NISS). Eso importa porque la deriva del esquema, las cargas faltantes y los cambios en la distribución pueden romper los modelos posteriores sin producir un fallo ruidoso.
Un modelo no necesita una interrupción dramática para fallar. Si un campo anterior cambia de tipo, si una alimentación llega tarde o si la distribución cambia sutilmente con el tiempo, la entrada del modelo puede degradarse mucho antes de que nadie note la salida. Es por eso que la Observability continua supera a las auditorías periódicas en entornos operativos.
Las comprobaciones continuas no solo protegen los paneles de control, sino que protegen las suposiciones de las que depende el panel de control.
Un enfoque de plataforma ayuda aquí cuando combina el aprendizaje de la línea de base, la validación a nivel de registro, el monitoreo de Timeliness y el seguimiento continuo del esquema dentro del propio entorno del cliente. Eso mantiene el análisis cerca de los datos, que es donde estos problemas son más fáciles de detectar.
Poniendo todo en práctica en tu próximo conjunto de datos
La forma más rápida de juzgar un conjunto de datos es hacerse tres preguntas. Primero, ¿qué significa bueno para esta pregunta de negocio? Segundo, ¿qué métodos expondrán los fallos que más importan? Tercero, ¿dónde deberían ejecutarse esas comprobaciones para que no agreguen fricción o riesgo?
Si la respuesta a la primera pregunta es difusa, comienza con las dimensiones, no con la herramienta. Precisión, completitud, consistencia, unicidad, validez, Timeliness y adecuación para el propósito te brindan un vocabulario compartido para decidir qué es aceptable. Si la respuesta a la segunda pregunta incluye la deriva, no solo los defectos, incorpora el perfilado, el aprendizaje de la línea de base y el análisis de tendencias. Si la respuesta a la tercera pregunta involucra datos sensibles o un alto volumen, la ejecución en la base de datos generalmente merece una consideración seria.
Un modelo mental simple ayuda aquí. Trata el Data Analytics de calidad como un bucle: define los criterios de confianza, mide el comportamiento, alerta sobre las desviaciones y mantén las comprobaciones donde viven los datos. Ese bucle es más fuerte cuando es continuo, estadístico y está alineado con el caso de uso de negocio en lugar de ser una lista de verificación de higiene genérica.
Las dos brechas que la mayoría de los equipos aún dejan abiertas son la equidad y la preparación para la IA. Si omites las comprobaciones de subgrupos, puedes pasar por alto a quién dejan fuera los datos. Si omites la Observability continua, puedes perderte los cambios lentos que rompen la analítica y las entradas de los modelos.
Si deseas poner en práctica esta disciplina, digna proporciona monitoreo en la base de datos para anomalías, Timeliness, validación y cambios de esquema dentro del propio entorno del cliente. Visítalo para ver cómo el Data Analytics de calidad continuo puede mantenerse cerca del almacén de datos, la canalización y las decisiones que dependen de ellos.


