Ajuste del rendimiento de bases de datos: domine su sistema
|
8
minuto de lectura
Su dashboard no falló de golpe. Se fue volviendo un poco más lento cada semana. Un informe financiero que antes se cargaba al instante ahora se bloquea en las horas punta. Una actualización de BI empieza a no cumplir su ventana. Un pipeline de features de ML sigue ejecutándose, pero el perfil de datos que hay detrás ha cambiado lo justo para que los planes de consulta ya no se comporten como lo hacían la última vez que ajustó el sistema.
Ahí es donde se encuentran muchos equipos en este momento. Abordan el ajuste del rendimiento de bases de datos como un ejercicio de consultas lentas, cuando el problema real es el drift. No solo el drift de la carga de trabajo, sino el drift de los datos. Los recuentos de filas cambian, las distribuciones se sesgan, un campo que admite nulos empieza a llegar con patrones nuevos, una actualización de esquema pasa desapercibida y la baseline en la que confiaba deja de describir la realidad.
El ajuste tradicional sigue siendo importante. Sigue necesitando planes de ejecución, revisiones de índices, configuración de memoria y un rollback disciplinado. Pero el ajuste estático es incompleto en sistemas en los que la forma de los datos cambia cada día.
Índice
Más allá de las consultas lentas: el verdadero origen de los problemas de rendimiento
Establezca una baseline: cómo medir y diagnosticar problemas
Priorice los puntos críticos para obtener las mayores mejoras
Más allá de las consultas lentas: el verdadero origen de los problemas de rendimiento
La mayoría de los incidentes de rendimiento no empiezan con una única consulta claramente defectuosa. Empiezan con un sistema que se vuelve menos predecible. Un dashboard es rápido por la mañana y errático a mediodía. Un job del data warehouse que cabía holgadamente en su ventana de procesamiento por lotes empieza a chocar con otras cargas de trabajo. Nadie cambió el SQL ayer y, aun así, los usuarios siguen notando la degradación.
El manual clásico dice que hay que encontrar la consulta más lenta y ajustarla. Eso sigue teniendo valor, pero pasa por alto un tipo de problemas cada vez más frecuente en el que el SQL es solo el síntoma. Análisis recientes muestran que el 68 % de la degradación del rendimiento de las bases de datos en 2024–2025 no se debe a la ineficiencia de las consultas, sino a problemas de calidad de datos upstream que alteran de forma inesperada los patrones de acceso; sin embargo, solo el 12 % del contenido sobre ajuste relaciona las métricas de observabilidad con el ajuste del rendimiento, según el análisis de Last9 sobre el ajuste del rendimiento de bases de datos.
Por qué los sistemas estables se vuelven inestables
Una consulta puede ser perfectamente razonable para la forma que tenían los datos el mes pasado y poco adecuada para la de hoy. PostgreSQL es un buen ejemplo. Una tabla puede acumular cambios, autovacuum se queda atrás, el bloat crece y lo que parecía un escaneo modesto se convierte en un comportamiento de I/O pésimo. Los equipos de SQL Server observan un drift similar en torno a la contención de tempdb y la selección de planes cuando cambian los patrones de carga. Los entornos Teradata pueden parecer sanos a nivel de sistema mientras una clase de carga de trabajo cambia de forma sutil lo suficiente como para distorsionar las colas y el tiempo de respuesta.
El ajuste estático da por hecho que los datos se mantienen similares. Los sistemas en producción rara vez respetan esa suposición.
Por eso el ajuste del rendimiento de bases de datos necesita una perspectiva más amplia. No solo gestiona el texto de las consultas y la configuración del motor. Gestiona las condiciones sobre las que se ejecutan esas consultas.
Una forma práctica de verlo es esta:
Un SQL lento suele indicar rutas de acceso deficientes, joins mal planteados, estadísticas desactualizadas o lecturas excesivas.
El drift de rendimiento suele indicar que la carga de trabajo cambió porque cambiaron los datos.
El impacto en el negocio aparece primero en informes desactualizados, dashboards con retraso y resultados de modelos menos fiables.
Los equipos que trabajan en el rendimiento full-stack para desarrolladores ya saben que la latencia suele abarcar varias capas. El trabajo con bases de datos no es diferente. Si una carga upstream introduce registros duplicados, altera la cardinalidad o cambia el patrón de llegada de los datos nuevos, su plan de consulta puede degradarse aunque el código de la aplicación no se haya tocado.
El fallo oculto en la mayoría de los flujos de ajuste
Las baselines tradicionales suelen ser instantáneas. Capturan un periodo bueno, quizá uno malo, y luego comparan ambos. Es útil, pero no indica cuándo la propia baseline ha dejado de ser fiable porque el esquema, el volumen, la actualidad o la distribución de los datos han cambiado.
En esa brecha es donde se producen muchos incidentes recurrentes. La base de datos no empeoró de repente. Cambió el entorno que la rodea, y el equipo siguió ajustando con una imagen desactualizada.
Establezca una baseline: cómo medir y diagnosticar problemas
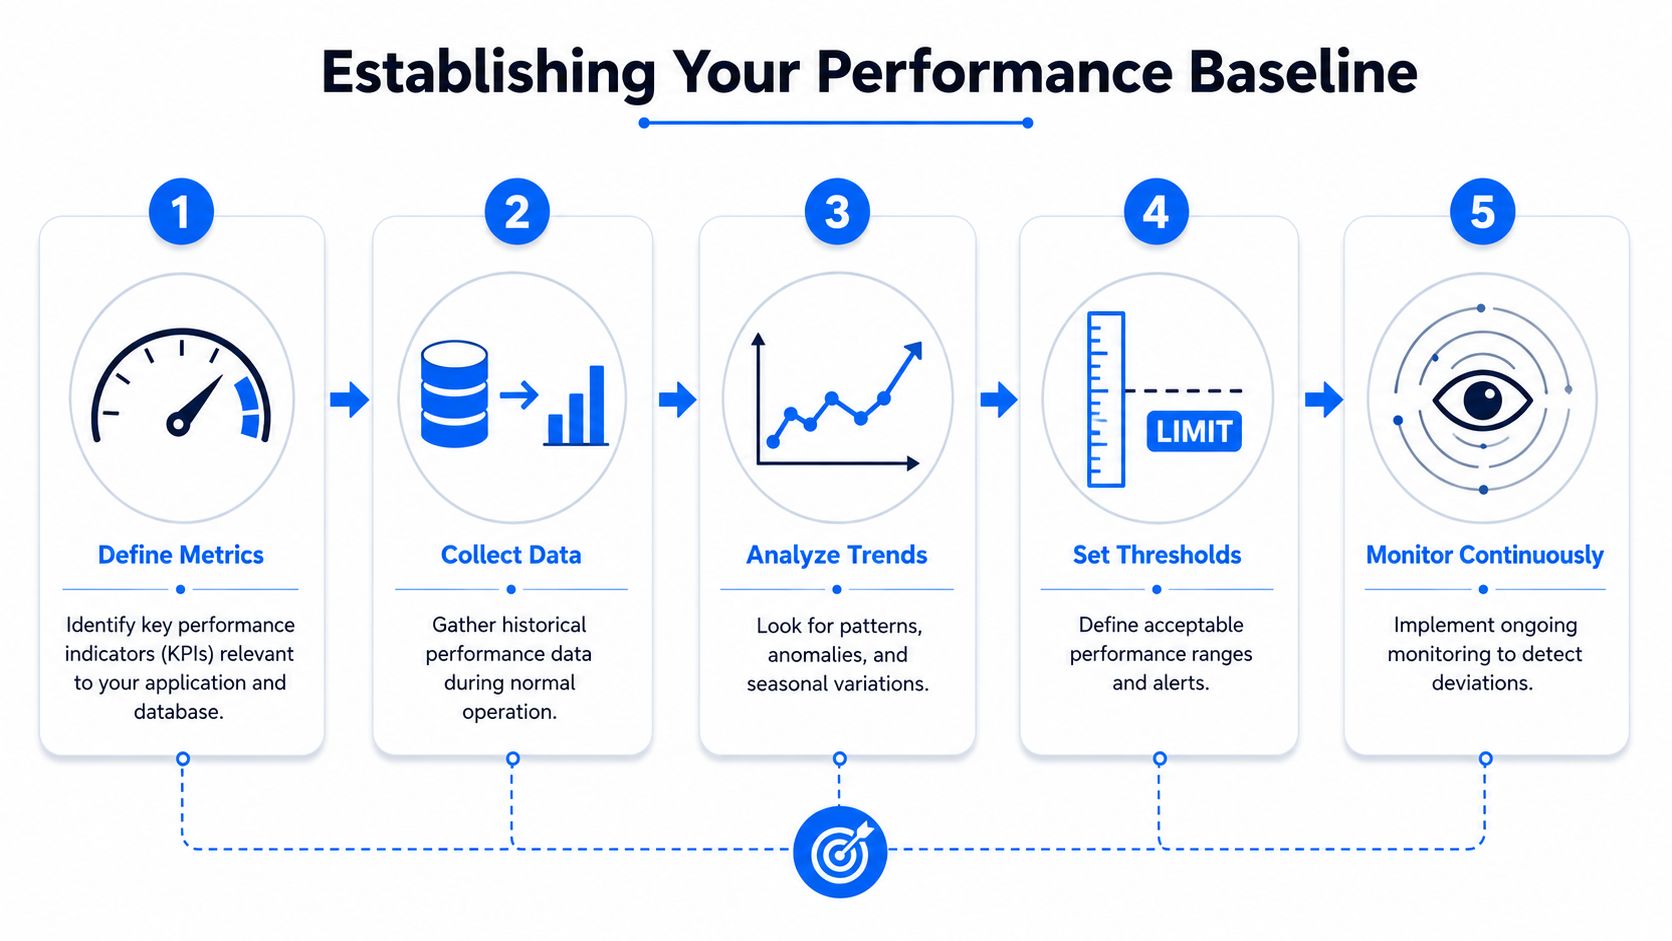
El ajuste del rendimiento de bases de datos empieza por la evidencia. Si no puede describir el estado normal del sistema, no puede saber si un cambio ha mejorado algo o simplemente ha trasladado el problema a otro lugar.
El flujo de trabajo básico no ha cambiado porque funciona. El ciclo de vida "medir, analizar, optimizar, validar" es el estándar universal y exige capturar la latencia, el throughput y el uso de recursos antes de cualquier optimización, para garantizar que los cambios se validen frente a una baseline, tal como se describe en esta visión general del ciclo de vida del ajuste del rendimiento.
Primero mida y después toque el sistema
Aquí los buenos equipos se impacientan. Es comprensible. Los usuarios están esperando y hay presión para “simplemente añadir un índice” o “darle más memoria”. Resista esa tentación hasta haber capturado una baseline tanto de periodos sanos como problemáticos.
Las directrices de ajuste de Oracle siguen siendo útiles en este punto, porque insisten en recopilar estadísticas completas del sistema operativo, la base de datos y la aplicación tanto en estados buenos como malos. Esa disciplina es importante. La falta de estadísticas no es un problema burocrático. Convierte el análisis de la causa raíz en conjeturas.
Regla práctica: si no registró el estado anterior, no puede demostrar que el estado posterior sea mejor.
La recopilación de la baseline debe incluir el rango operativo de la carga de trabajo, no solo una única sentencia lenta. Eso implica medir lo que hace el sistema por módulo, ventana temporal y tipo de recurso.
Para los equipos que quieren reforzar sus prácticas de monitorización, merece la pena revisar estas técnicas de monitorización y auditoría de bases de datos junto con las herramientas nativas del motor.
Qué capturar en la baseline
Las herramientas concretas varían según la plataforma, pero las categorías son las mismas. Query Store en SQL Server y Azure SQL, pg_stat_statements en PostgreSQL, las vistas de rendimiento de Oracle y las tablas de sistema de Teradata ayudan a sacar a la luz los mismos tipos de evidencia.
Señal | Qué buscar | Qué suele indicar |
|---|---|---|
Latencia | Aumento de la latencia de cola y tiempos de respuesta inestables | Cambios de plan, presión de I/O, bloqueos, fallos de caché |
Throughput | Menos trabajo completado por módulo o ventana de job | Contención, colas, amplificación de escritura |
CPU y memoria | Saturación, cambios bruscos, mal comportamiento de la caché | Planes deficientes, sobresuscripción, cachés infradimensionadas |
I/O y esperas | Picos de lectura, volcados a disco, presión sobre el almacenamiento, eventos de espera | Índices ausentes, presión de ordenación, bloat, trabajo temporal |
Errores y reintentos | Timeouts, rotación de conexiones, actualizaciones fallidas | Agotamiento de recursos, pools mal dimensionados, cadenas de bloqueos |
Capture estas métricas bajo una carga reproducible siempre que sea posible. Si solo toma muestras durante una caída del servicio, no sabrá si el problema es excepcional o forma parte de una tendencia.
Una baseline sólida suele responder a cuatro preguntas operativas:
Qué era lento. No una anécdota, sino las clases de consultas, los jobs y los recorridos de usuario afectados.
Dónde estaba la presión. CPU, memoria, almacenamiento, espacio temporal o concurrencia.
Cuándo cambió. Después de un despliegue, tras la llegada de datos, durante una ventana de generación de informes o durante tareas de mantenimiento en segundo plano.
Si el negocio lo notó. Retrasos en dashboards, analítica desactualizada, SLA incumplidos o scoring de modelos con retraso.
Las baselines necesitan contexto, no solo métricas
Una baseline demasiado limitada puede inducir a error. Supongamos que una consulta del data warehouse se ralentizó después de que un cambio de esquema añadiera una nueva columna y el ETL downstream empezara a rellenarla con patrones de nulos inesperados. El plan de consulta puede seguir siendo el mecanismo inmediato, pero el diagnóstico no está completo hasta que relaciona el cambio en el rendimiento con el cambio en la forma de los datos.
Por eso un ajuste del rendimiento de bases de datos maduro no se queda en “recopilar métricas”. Vincula las métricas del sistema con el calendario de la carga de trabajo, el estado del esquema y el comportamiento de llegada de los datos. De lo contrario, su baseline es precisa pero incompleta.
Priorice los puntos críticos para obtener las mayores mejoras
Una vez medido el sistema, la siguiente trampa es el ajuste aleatorio. Los equipos se ahogan en gráficos y luego pasan una semana puliendo consultas de bajo impacto mientras el verdadero cuello de botella sigue consumiendo CPU o saturando la I/O.
La forma más rápida de salir de ahí es priorizar por impacto. No por qué consulta parece peor. No por qué alerta saltó primero. Sino por qué punto crítico consume los recursos más relevantes o causa el problema más amplio a los usuarios.
Clasifique por impacto, no por molestia
Una consulta que se ejecuta constantemente y desperdicia recursos moderados puede importar más que un informe puntual espectacular. SQL Server Query Store, las visualizaciones de Azure SQL, las vistas de carga de trabajo de Oracle, pg_stat_statements de PostgreSQL y las métricas de carga de trabajo de Teradata ayudan a responder a la misma pregunta: ¿qué es lo bastante costoso de forma repetida como para condicionar el comportamiento del sistema?
Empiece con un modelo de clasificación sencillo:
La frecuencia importa. Una pequeña ineficiencia ejecutada durante todo el día puede dominar la carga total.
El alcance importa. Las consultas vinculadas a dashboards compartidos o a API centrales merecen más atención que los jobs de administración de nicho.
El tipo de recurso importa. Los puntos críticos intensivos en CPU y los intensivos en I/O requieren vías de corrección diferentes.
El momento importa. Un job que coincide con la generación de informes de la mañana puede ser más urgente que una tarea más lenta que se ejecuta por la noche.
No optimice primero la consulta que más ruido hace. Optimice la que más distorsiona la plataforma.
Los planes de ejecución son el lugar donde esto se vuelve concreto. Busque escaneos completos sobre relaciones grandes, joins costosos con malas estimaciones de filas, volcados al almacenamiento temporal o key lookups repetidos que inflan las lecturas. En PostgreSQL, compruebe si la presión de los checkpoints o el retraso de autovacuum coinciden con la ralentización. En SQL Server, examine el comportamiento de tempdb y los patrones de concesión de memoria. En Teradata, analice qué clases de carga de trabajo están en cola y si una familia de consultas está monopolizando los recursos.
Cómo es un punto crítico real
Un punto crítico real suele adoptar una de estas formas:
Una consulta de informes que funcionaba bien sobre una tabla moderada, pero que ahora escanea muchos más datos porque la distribución cambió.
Una sentencia transaccional que se ejecuta con frecuencia y que perdió una ruta de acceso eficiente después de que las estadísticas se desviaran.
Una transformación del data warehouse cuyo volumen de ordenación intermedio creció hasta que empezó a volcarse a disco.
Un join amplio de BI que era aceptable antes de que el schema drift introdujera claves duplicadas o huérfanas upstream.
Piense en términos de esfuerzo frente a impacto antes de empezar a modificar objetos. Algunas mejoras son sencillas. Actualizar las estadísticas, eliminar un índice claramente no utilizado que añade coste de escritura o corregir un predicado que impide el uso de un índice. Otras requieren más cuidado porque modifican el comportamiento de la aplicación o el diseño del almacenamiento.
No se trata de crear un backlog perfecto. Se trata de identificar los pocos cambios que devolverán la plataforma a informes estables, ventanas de procesamiento por lotes predecibles y consumidores downstream fiables.
Optimice el núcleo con el ajuste de consultas y esquemas
Una vez clasificados los puntos críticos, ajuste primero la ruta principal. Eso suele implicar patrones de consulta, índices, estadísticas y, solo después, cambios de esquema más profundos. La mayoría de los sistemas todavía tienen un margen sorprendente de mejoras de bajo riesgo antes de que nadie tenga que hablar de reparticionar o de un rediseño importante.
Empiece por cambios de bajo riesgo
Un flujo de trabajo disciplinado empieza por lo pequeño. Actualice las estadísticas si están desactualizadas. Revise los planes de ejecución. Añada o ajuste índices solo cuando el plan y el patrón de acceso lo justifiquen. Las pequeñas reescrituras de SQL, las correcciones del pool de conexiones y la validación de planes suelen ir antes que un rediseño estructural.
Hay un error práctico que aparece en todas partes: los equipos siguen añadiendo índices sin comprobar si los existentes ya se solapan o si la ruta de escritura puede asumir más coste de mantenimiento. Las recomendaciones resumidas en esta visión general del ajuste del rendimiento de bases de datos van en la dirección correcta en este punto. Eliminar índices no utilizados o redundantes puede reducir la sobrecarga de escritura y el coste de almacenamiento, mientras que añadir más a ciegas puede empujar al optimizador hacia malas decisiones o aumentar la carga de mantenimiento.
Algunas acciones de ajuste dan resultado de forma sistemática:
Ponga orden en la proliferación de índices. Los índices redundantes aumentan el coste de escritura y pueden dificultar la resolución de problemas.
Prefiera índices cortos y con un propósito claro. Los campos grandes de tipo texto no suelen ser buenos candidatos para un índice, porque inflan el tamaño de la estructura y el coste computacional.
Compruebe el comportamiento de la caché tras cambiar consultas. Los buffer pools deben contener el conjunto de trabajo sin consumir toda la memoria del sistema.
Audite con regularidad. La revisión de índices y la higiene de la configuración evitan el lento deterioro que se cuela en los sistemas maduros.
Utilice con cuidado las reescrituras con IA
La reescritura de consultas con IA resulta atractiva porque promete mejoras rápidas. A veces ayuda. Puede sugerir simplificaciones de joins, limpieza de predicados o formulaciones alternativas que las personas podrían pasar por alto bajo presión de tiempo.
Pero la IA tiene un filo peligroso en las bases de datos de producción. Una encuesta del sector de 2025 reveló que el 44 % de las optimizaciones de consultas generadas por IA introdujeron errores sutiles en conjuntos de datos financieros y sanitarios debido a una interpretación errónea del tratamiento de los nulos o de la semántica de los rangos de fechas, según este resumen de una encuesta del sector sobre el ajuste basado en IA.
Ese resultado coincide con lo que los ingenieros experimentados ya saben. La velocidad de una consulta no es lo mismo que su corrección.
Utilice las sugerencias de la IA como el borrador de un revisor junior:
Compruebe el cambio en el plan de ejecución.
Valide la semántica a nivel de registro.
Compare los conjuntos de resultados en casos límite representativos.
Vigile de cerca el tratamiento de los nulos, los límites de fechas y el comportamiento de los duplicados.
Un SQL más rápido que devuelve las filas equivocadas es un defecto de producción, no una optimización.
Esto es todavía más importante en los sistemas de analítica y ML. Un error semántico sutil en una consulta de informes puede convertirse en un KPI desactualizado o engañoso. Una mala reescritura en un pipeline de features puede cambiar las entradas del modelo mientras hace que el data warehouse parezca “más rápido”.
Sepa cuándo merecen la pena los cambios de esquema
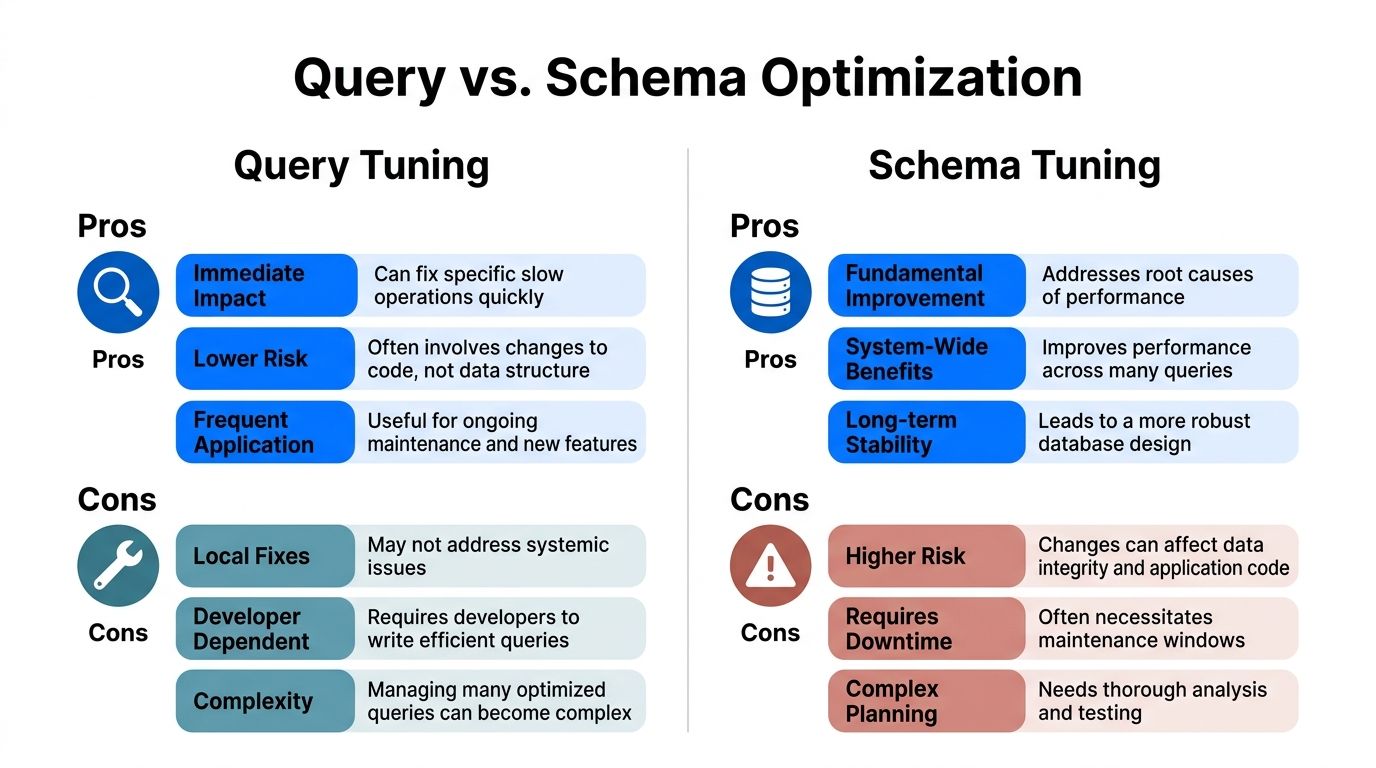
El ajuste de consultas es local. El ajuste de esquemas es sistémico. Por eso los cambios de esquema pueden aportar beneficios amplios, pero también conllevan más riesgo.
Recurra a los cambios de esquema cuando el problema sea estructural, no estético. Algunos ejemplos son tablas que claramente han superado su diseño actual, rutas de join que dependen repetidamente de estructuras de claves poco adecuadas o cargas de trabajo que necesitan particionado y gestión del ciclo de vida en lugar de otra ronda de parches en las consultas.
Una forma útil de plantear la elección:
Opción | Mejor cuando | Principal contrapartida |
|---|---|---|
Ajuste de consultas | Un pequeño conjunto de sentencias origina el problema | Es posible que solo corrija síntomas locales |
Ajuste de índices | Las rutas de acceso son incorrectas o incompletas | Las escrituras se encarecen |
Ajuste de esquemas | Muchas consultas sufren la misma restricción de diseño | Mayor riesgo de cambio y más coordinación |
El orden importa. Empiece por la opción menos disruptiva que pueda resolver el problema de forma plausible. Si no se nota ninguna mejora, revierta limpiamente y pase a la siguiente capa.
Esa mentalidad evita que el ajuste del rendimiento de bases de datos se convierta en un rediseño accidental.
Ajuste el motor con cambios de configuración y de recursos
Una vez en marcha el trabajo sobre consultas y esquemas, centre la atención en el propio motor, una fase en la que muchos equipos se exceden o se quedan cortos. O bien tocan todos los parámetros que encuentran, o bien dejan sin resolver problemas de recursos evidentes porque suponen que “tiene que ser el SQL”.
Ambas cosas son errores.
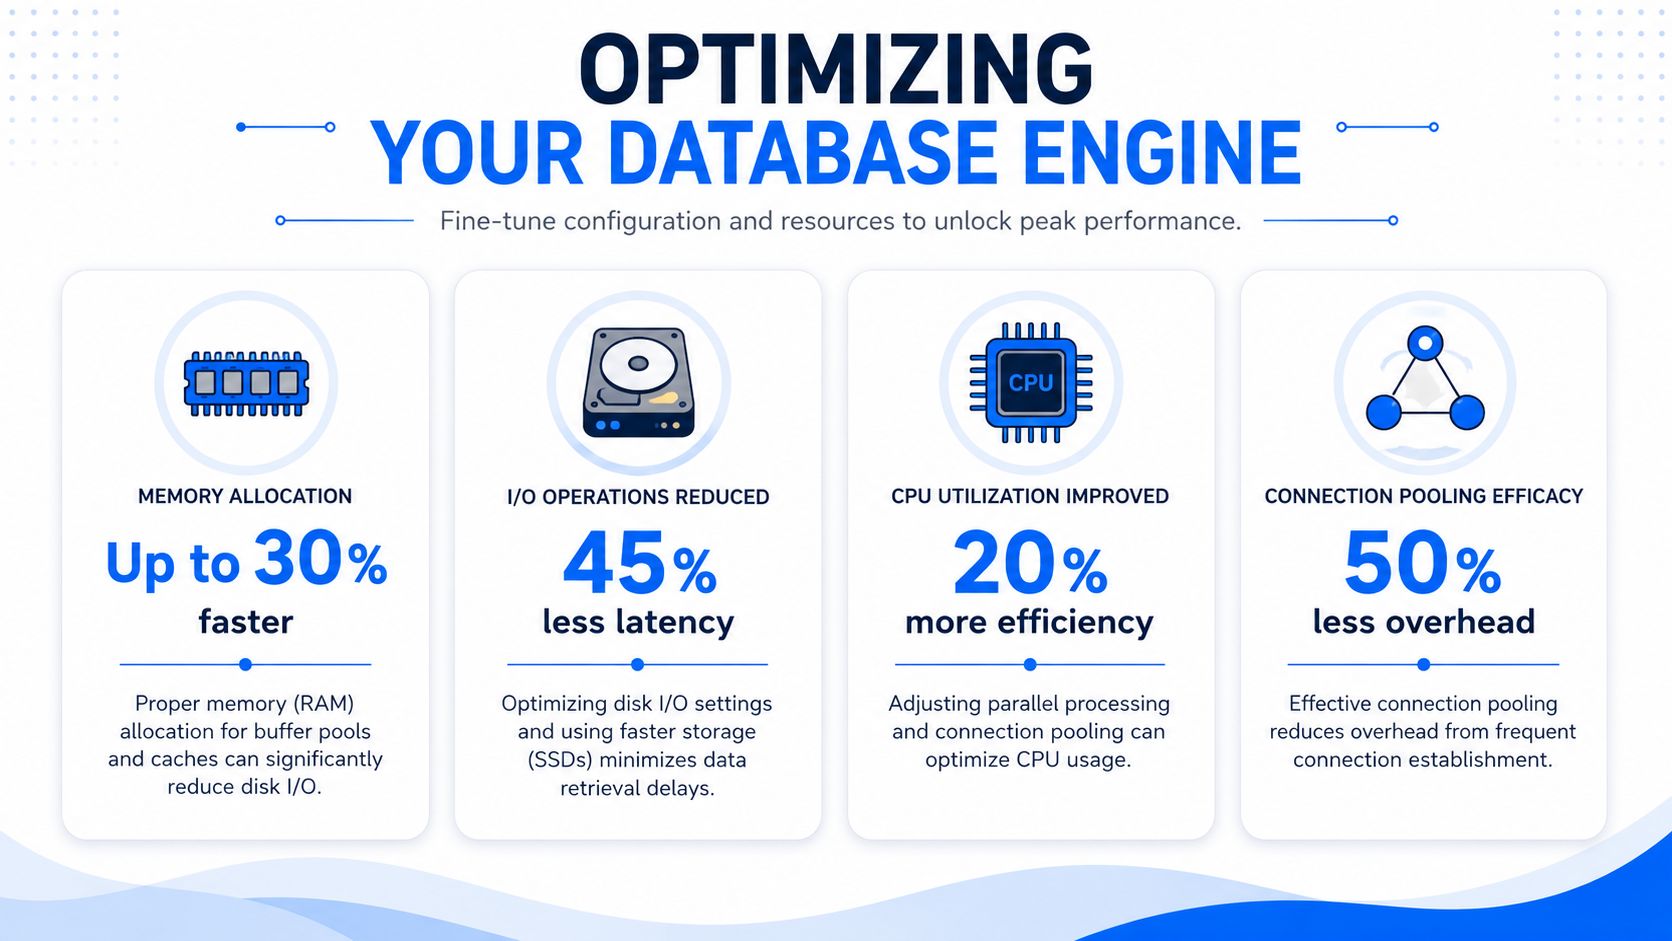
Trate la configuración como un experimento
El ajuste de la configuración solo funciona cuando sigue un método estricto de un solo cambio cada vez. La metodología de ajuste de Oracle es explícita en este punto en sus directrices sobre un método de ajuste paso a paso. Cambie un parámetro u objeto cada vez, registre las métricas de antes y después, y no declare el éxito a menos que la relación causal esté clara.
Esto se aplica a la configuración de memoria, los pools de conexiones, el paralelismo, la ubicación del almacenamiento y las herramientas de diagnóstico. También se aplica al pequeño pero habitual error de dejar activos en producción el tracing o las sesiones de Extended Events tras una investigación. Esas herramientas pueden pasar a formar parte del perfil de latencia si nadie las desactiva.
Un orden de operaciones útil es el siguiente:
Primero, la memoria. Compruebe si el buffer pool o los shared buffers pueden contener el conjunto de trabajo sin dejar sin recursos al resto del host.
Después, el comportamiento de las conexiones. Demasiadas sesiones activas pueden generar contención artificial y presión sobre el planificador.
A continuación, la ruta de I/O. Busque patrones de volcado temporal, profundidad de cola o una ubicación deficiente de los archivos críticos.
Solo entonces, ajuste parámetros más profundos. El paralelismo, la configuración de workers y el comportamiento avanzado del motor requieren evidencias más sólidas.
Comprobaciones específicas de cada plataforma que importan
Los detalles de cada motor son distintos, pero algunas comprobaciones son demasiado importantes como para omitirlas.
Oracle y su interacción con el sistema operativo
Una regla histórica fundamental de Oracle sigue vigente: si el uso del kernel del sistema operativo supera el 40 %, la causa probable es una contención a nivel del sistema operativo, como paginación, swapping, sobrecarga de transferencia de red o thrashing de procesos, y no solo defectos del SQL, tal como se documenta en la guía de ajuste del rendimiento de Oracle. Cuando se alcanza ese umbral, deje de suponer que el problema se limita a una consulta.
SQL Server y tempdb
Si tempdb está mal ubicada o infradimensionada para la carga de trabajo, el resto del debate sobre el ajuste se llena rápidamente de ruido. Los volcados a disco, la presión del versionado y la actividad temporal concurrente hacen que los síntomas de “consulta lenta” sean peores de lo que parecen.
PostgreSQL y el comportamiento del mantenimiento
Vigile de cerca los checkpoints y autovacuum. Si autovacuum se queda atrás, el bloat de las tablas puede convertir lecturas normales en I/O costosa. Si la configuración de los checkpoints no se ajusta al patrón de escritura, la latencia se vuelve irregular.
Teradata y las clases de carga de trabajo
En Teradata, los promedios del sistema pueden ocultar los problemas. La vista útil es el comportamiento a nivel de carga de trabajo, las colas y cuántos recursos consume una clase de actividad durante las ventanas críticas.
El ajuste del motor es donde la disciplina importa más. Un cambio, un ciclo de medición, una vía de rollback.
Sin ese rigor, el ajuste del rendimiento de bases de datos se convierte en superstición. No sabrá si el cambio de memoria ayudó, si el cambio del pool perjudicó la concurrencia o si una corrección del almacenamiento ocultó un problema de plan durante una semana.
Del ajuste reactivo a la observabilidad continua
Las sesiones de ajuste puntuales siguen siendo necesarias. Simplemente ya no son suficientes.
La razón es sencilla. Su plataforma de datos sigue cambiando después de que termine la sesión de ajuste. Las tablas crecen. Los jobs upstream llegan tarde. Los esquemas cambian. Las distribuciones de los registros se desplazan. Una baseline capturada durante un periodo sin incidencias deja poco a poco de representar la realidad de producción.
Las baselines estáticas se degradan
Si solo revisa el rendimiento cuando los usuarios se quejan, siempre irá a remolque. Para entonces, el problema ya se habrá propagado a informes desactualizados, dashboards rotos, analítica con retraso o features de IA poco fiables.
La observabilidad continua cierra esa brecha. El cambio importante consiste en vigilar no solo las métricas del motor, sino también las condiciones de los datos que invalidan las suposiciones de rendimiento:
Anomalías de volumen que modifican los patrones de acceso
Cambios de esquema, como columnas añadidas, campos eliminados o cambios de tipo
Drift de puntualidad, cuando los datos esperados llegan tarde o no llegan
Problemas de calidad a nivel de registro, como duplicados, anomalías de nulos y relaciones rotas
La IA puede ayudar en este caso cuando se aplica a la detección de anomalías y no a la reescritura de consultas a ciegas. La detección de anomalías basada en IA puede reducir hasta en un 90 % la carga de mantenimiento manual de reglas cuando métodos no supervisados aprenden el comportamiento normal y establecen umbrales adaptativos automáticamente, según la descripción de la plataforma de datos empresarial de digna. Esto es importante porque los umbrales mantenidos a mano envejecen mal en data warehouses dinámicos.
Qué cambia la observabilidad continua
La pieza arquitectónica que hace esto viable es el análisis dentro de la base de datos. El cálculo de métricas dentro de la base de datos elimina los costes de movimiento de datos al ejecutar la inspección directamente en las bases de datos de origen, lo que permite la monitorización en tiempo real y el aprendizaje de baselines, al tiempo que garantiza que los datos del cliente permanezcan privados en su propio entorno, tal como se describe en esta visión general del análisis de cargas de trabajo dentro de la base de datos.
Ese modelo es especialmente útil en entornos de nube privada y on-premises, donde los equipos necesitan visibilidad sin exportar datos de producción sensibles. También se ajusta a la forma de trabajar de los ingenieros de datos. Si la observabilidad puede ejecutarse cerca de las tablas de carga de trabajo de Teradata, las estadísticas de sistema de PostgreSQL o la lógica de validación residente en el data warehouse, podrá detectar el drift antes de que se convierta en un incidente visible para los usuarios.
Un modelo operativo más sólido combina:
telemetría de consultas y del motor,
seguimiento de esquemas,
monitorización de la actualidad de los datos,
detección de anomalías en la forma de los datos,
y validación a nivel de registro vinculada a reglas de negocio.
Si desea una introducción más amplia a ese modelo operativo, esta visión general de la observabilidad de datos en la práctica es un buen punto de partida.
El ajuste del rendimiento de bases de datos funciona mejor cuando evoluciona de una actividad de rescate a un ciclo de control continuo. Así es como se protege no solo la latencia de las consultas, sino también la confianza en los resultados que ofrece su base de datos.
Si su equipo intenta conectar el rendimiento de la base de datos con el drift de datos, los cambios de esquema, la puntualidad y la validación a nivel de registro en un único modelo operativo, digna está diseñado para ello. Ejecuta los análisis dentro de su entorno, ayuda a sacar a la luz las anomalías antes de que se conviertan en informes desactualizados o en entradas de IA poco fiables, y ofrece a los ingenieros una forma de mantener fieles las baselines de rendimiento a medida que cambian los datos.
Para vigilar las condiciones de los datos que invalidan silenciosamente una baseline de ajuste, como los cambios de volumen, los cambios de esquema y las cargas tardías, descubra cómo aborda digna la observabilidad de la plataforma de datos dentro de su propia base de datos.
Preguntas frecuentes
¿Qué hace que el rendimiento de una base de datos se degrade con el tiempo?
A menudo, los datos y no el SQL. El análisis de Last9 citado en el artículo atribuye el 68 % de la degradación del rendimiento de las bases de datos en 2024-2025 a problemas de calidad de datos upstream que alteran los patrones de acceso, como cambios en los recuentos de filas, distribuciones sesgadas, nuevos patrones de nulos o actualizaciones de esquema inadvertidas que dejan obsoleta una baseline anterior.
¿Qué debe incluir una baseline de rendimiento de una base de datos?
Una baseline útil captura la latencia, el throughput, la CPU y la memoria, la I/O y los eventos de espera, además de los errores y reintentos, medidos tanto en periodos sanos como problemáticos. Debe responder a cuatro preguntas: qué era lento, dónde estaba la presión, cuándo cambió y si el negocio lo notó a través de dashboards con retraso o SLA incumplidos.
¿Cómo decido qué consultas lentas ajustar primero?
Clasifique los puntos críticos por impacto, no por qué consulta parece peor o cuál generó una alerta primero. Tenga en cuenta la frecuencia, el alcance, el tipo de recurso y el momento: una pequeña ineficiencia ejecutada todo el día puede dominar la carga total, y un job que coincide con los informes de la mañana puede importar más que una tarea nocturna más lenta. Query Store y pg_stat_statements ayudan.
¿Es seguro utilizar IA para reescribir consultas SQL?
Solo con una revisión cuidadosa. Una encuesta del sector de 2025 citada en el artículo reveló que el 44 % de las optimizaciones de consultas generadas por IA introdujeron errores sutiles en conjuntos de datos financieros y sanitarios, principalmente en el tratamiento de los nulos y los rangos de fechas. Trate las sugerencias como el borrador de un junior: compruebe el plan, compare los conjuntos de resultados y pruebe los casos límite.
¿Cómo deben probarse los cambios de configuración de una base de datos?
Cambie un parámetro cada vez, registre las métricas de antes y después, y mantenga una vía de rollback, siguiendo el método paso a paso de Oracle. Trabaje en orden: primero la memoria, después el comportamiento de las conexiones, luego la ruta de I/O y, solo entonces, el paralelismo o la configuración de workers. Oracle también señala que un uso del kernel del sistema operativo superior al 40 % indica contención a nivel del sistema operativo.


