Was ist Data Observability
|
6
min. Lesezeit
Ein Dashboard kann technisch verfügbar sein und dennoch operativ nutzlos.
In dieser Situation befinden sich derzeit viele Teams. Die Pipeline lief. Das Warehouse steht. BI lädt fehlerfrei. Dann bemerkt jemand, dass der Umsatz am Mittag stagniert, die Bestellungen von gestern fehlen oder eine wichtige Spalte über Nacht den Typ geändert hat, was unerwartet ein nachgelagertes Modell beschädigt hat. Nichts sah nach Ausfall aus, und dennoch traf das Unternehmen bereits Entscheidungen auf der Grundlage fehlerhafter Daten.
Diese Lücke zwischen Systemlaufzeit und Datenvertrauen ist der Punkt, an dem Data Observability eine Rolle spielt. Wenn Ihr Unternehmen Daten verwendet, um Budgets zuzuweisen, den Betrieb zu steuern, die Compliance zu unterstützen oder KI-Systeme zu speisen, ist Observability keine nette technische Zusatzleistung mehr. Sie wird Teil der Business Continuity.
Inhaltsverzeichnis
Warum das Datenvertrauen fragiler ist denn je
Stille Fehler bergen Risiken für die Business Continuity
Reaktives Beheben ist nicht skalierbar
Was genau ist Data Observability
Monitoring erfasst bekannte Fehler
Observability hilft bei der Beantwortung des Warums
Die fünf Säulen der Data Observability
Aktualität und Timeliness
Volumen
Schema
Verteilung
Lineage
Data Observability vs. Datenqualität: Eine entscheidende Unterscheidung
Warum Teams sie verwechseln
Wo die jeweilige Methode hingehört
Wie moderne Data-Observability-Architekturen funktionieren
Das T-förmige Modell in der Praxis
Warum KI operativ wichtig ist
Die Theorie mit einer Plattform in die Praxis umsetzen
Wie sich Funktionen den täglichen Fehlerszenarien zuordnen lassen
Was beim Rollout meist schiefgeht
Ihre Checkliste für die Implementierung von Data Observability
Eine praktische Startsequenz
Warum das Datenvertrauen fragiler ist denn je
Ein typisches Fehlermuster sieht so aus: Die Finanzabteilung öffnet vor einer Vorstandssitzung das Executive Dashboard und sieht Zahlen, die nicht mit dem Abschlussbericht übereinstimmen. Das Marketing sagt, die Kampagnenausgaben sähen normal aus. Der Vertrieb meldet einen Einbruch der Pipeline. Die Datentechnik prüft die Orchestrierungsprotokolle und sieht erfolgreiche Jobs. Niemand weiß, ob das Problem an einer verspäteten Ladung, einer fehlerhaften Transformation, einer Schemaänderung oder einem duplizierten Feed liegt.
Deshalb sind Vorfälle mit schlechten Daten so störend. Sie sind nicht laut wie Infrastrukturausfälle. Sie sind still. Berichte werden weiterhin geladen, Diagramme aktualisiert, und die Menschen nutzen sie weiter, bis jemand per Zufall die Inkonsistenz bemerkt.
Für Teams, die versuchen, Daten als Vermögenswert zu behandeln, ist Vertrauen nicht abstrakt. Es beeinflusst Planung, Compliance, Prognosen und Modellergebnisse. Wenn Sie an diesem umfassenderen geschäftlichen Rahmen arbeiten, ist dieser Experten-Leitfaden für den ROI von Daten-Assets nützlich, da er technische Zuverlässigkeit mit dem Wert für die Führungsebene verbindet, was oft das fehlende Bindeglied im Gespräch ist.
Stille Fehler bergen Risiken für die Business Continuity
Das Problem ist nicht nur die Korrektheit. Es ist das Timing.
Ein veraltetes Dashboard eine Stunde vor einer Preisentscheidung ist ein Kontinuitätsproblem. Eine fehlende Charge im Workflow für Schadensfälle ist ein Kontinuitätsproblem. Eine unbemerkte Verschiebung der Modelleingabedaten ist ein Kontinuitätsproblem. In jedem Fall bewegt sich das Geschäft weiter, aber es bewegt sich mit beeinträchtigten Informationen.
Datenteams werden selten dafür verantwortlich gemacht, dass eine Pipeline sichtlich ausgefallen ist. Sie werden beschuldigt, wenn alles normal aussah und die Zahlen dennoch falsch waren.
Dieser Druck erklärt, warum diese Kategorie so schnell wächst. Laut Marktprognosen zum Wachstum von Data Observability soll der globale Markt für Data Observability bis 2033 ein Volumen von 7,01 Milliarden USD erreichen, ausgehend von 2.3 Milliarden USD im Jahr 2023 bei einer durchschnittlichen jährlichen Wachstumsrate (CAGR) von 11,8 %. Dieselbe Prognose verknüpft dieses Wachstum mit der Notwendigkeit, Anomalien zu erkennen, Ursachen zu identifizieren und Störungen zu verhindern, bevor sie sich auf die Geschäftsergebnisse auswirken.
Reaktives Beheben ist nicht skalierbar
Viele Teams beginnen mit manuellen Prüfungen, SQL-Assertions und einigen wenigen hoch prioritären Warnmeldungen. Das funktioniert eine Weile.
Dann wird die Plattform erweitert. Mehr Quellen kommen hinzu. Die Zuständigkeiten verteilen sich. BI und ML nutzen dieselben vorgelagerten Tabellen. Ein Dashboard-Problem kann nun seinen Ursprung fünf Transformationen zuvor haben, und bis es jemand bemerkt, sind bereits mehrere nachgelagerte Produkte betroffen.
An diesem Punkt wird reaktives Debugging teuer, da jeder Vorfall zu einer Suchaktion wird. Sie reparieren nicht nur schlechte Daten. Sie rekonstruieren die Kette von Ereignissen, die dazu geführt haben.
Was genau ist Data Observability
Data Observability ist die Praxis, den Zustand von Datensystemen zu verstehen, indem kontinuierlich die Signale überprüft werden, die Daten und Pipelines erzeugen. Praktisch gesehen zeigt sie Ihnen, ob Daten pünktlich, in der erwarteten Form, mit dem erwarteten Verhalten und mit genügend Kontext ankommen, um Probleme bis zur Quelle zurückzuverfolgen.
Eine nützliche Analogie stammt aus dem Softwarebetrieb. Das Application Performance Monitoring zeigt Entwicklern, dass eine App langsam ist, abstürzt oder sich abnormal verhält. Data Observability wendet dieselbe Denkweise auf Datenplattformen an. Sie gibt sich nicht mit „Der Job war erfolgreich“ zufrieden. Sie fragt, ob das Ergebnis vertrauenswürdig ist.
Monitoring erfasst bekannte Fehler
Traditionelles Monitoring ist nützlich, aber enger gefasst.
Es funktioniert am besten, wenn Sie das Fehlerszenario bereits kennen. Wenn eine Pipeline ausfällt, Alarm. Wenn die Latenz einen Schwellenwert überschreitet, Alarm. Wenn eine Tabelle bis zu einer festgelegten Zeit nicht aktualisiert wurde, Alarm. Diese Prüfungen sind notwendig, setzen aber voraus, dass das Problem vorhergesehen und codiert wurde.
Observability deckt die Fälle ab, die Ihre statischen Prüfungen nicht vorhergesagt haben. Eine Pipeline wird möglicherweise erfolgreich abgeschlossen, erzeugt aber nur die Hälfte der erwarteten Zeilen. Ein Join läuft vielleicht immer noch, führt aber zu einer Verteilungsverschiebung bei einer kritischen Metrik. Eine Spalte ist zwar weiterhin vorhanden, ändert aber durch die vorgelagerte Logik ihre Bedeutung.
Observability hilft bei der Beantwortung des Warums
Das ist der wesentliche Unterschied in der Formulierung Was ist Data Observability. Es ist nicht nur eine Monitoring-Ebene mit mehr Alarmen. Es ist ein Weg, um von der reaktiven Symptombekämpfung zur Diagnose auf Systemebene überzugehen.
Eine solide Observability-Praxis leistet meist vier Dinge gleichzeitig:
Erkennt versteckte Anomalien: Sie meldet unerwartetes Verhalten, selbst wenn Jobs erfolgreich waren.
Liefert Kontext: Sie zeigt, was sich wann geändert hat und was davon abhängt.
Beschleunigt die Triage: Sie hilft, Vorfälle schneller dem richtigen Verantwortlichen zuzuweisen.
Unterstützt die Prävention: Sie legt Muster offen, mit denen Teams wiederkehrende Ursachen beseitigen können, statt nur die Auswirkungen zu bereinigen.
Praktische Regel: Wenn Ihr aktuelles Setup Ihnen mitteilt, dass eine Pipeline lief, aber nicht sagen kann, ob die resultierenden Daten brauchbar sind, betreiben Sie Monitoring. Sie haben noch keine Observability.
Der Unterschied ist wichtig, denn den Geschäftsanwendern ist es egal, ob Airflow, dbt oder das Warehouse eine Aufgabe abgeschlossen haben. Sie wollen wissen, ob dem Dashboard, dem Bericht oder dem Modell im Moment vertraut werden kann.
Die fünf Säulen der Data Observability
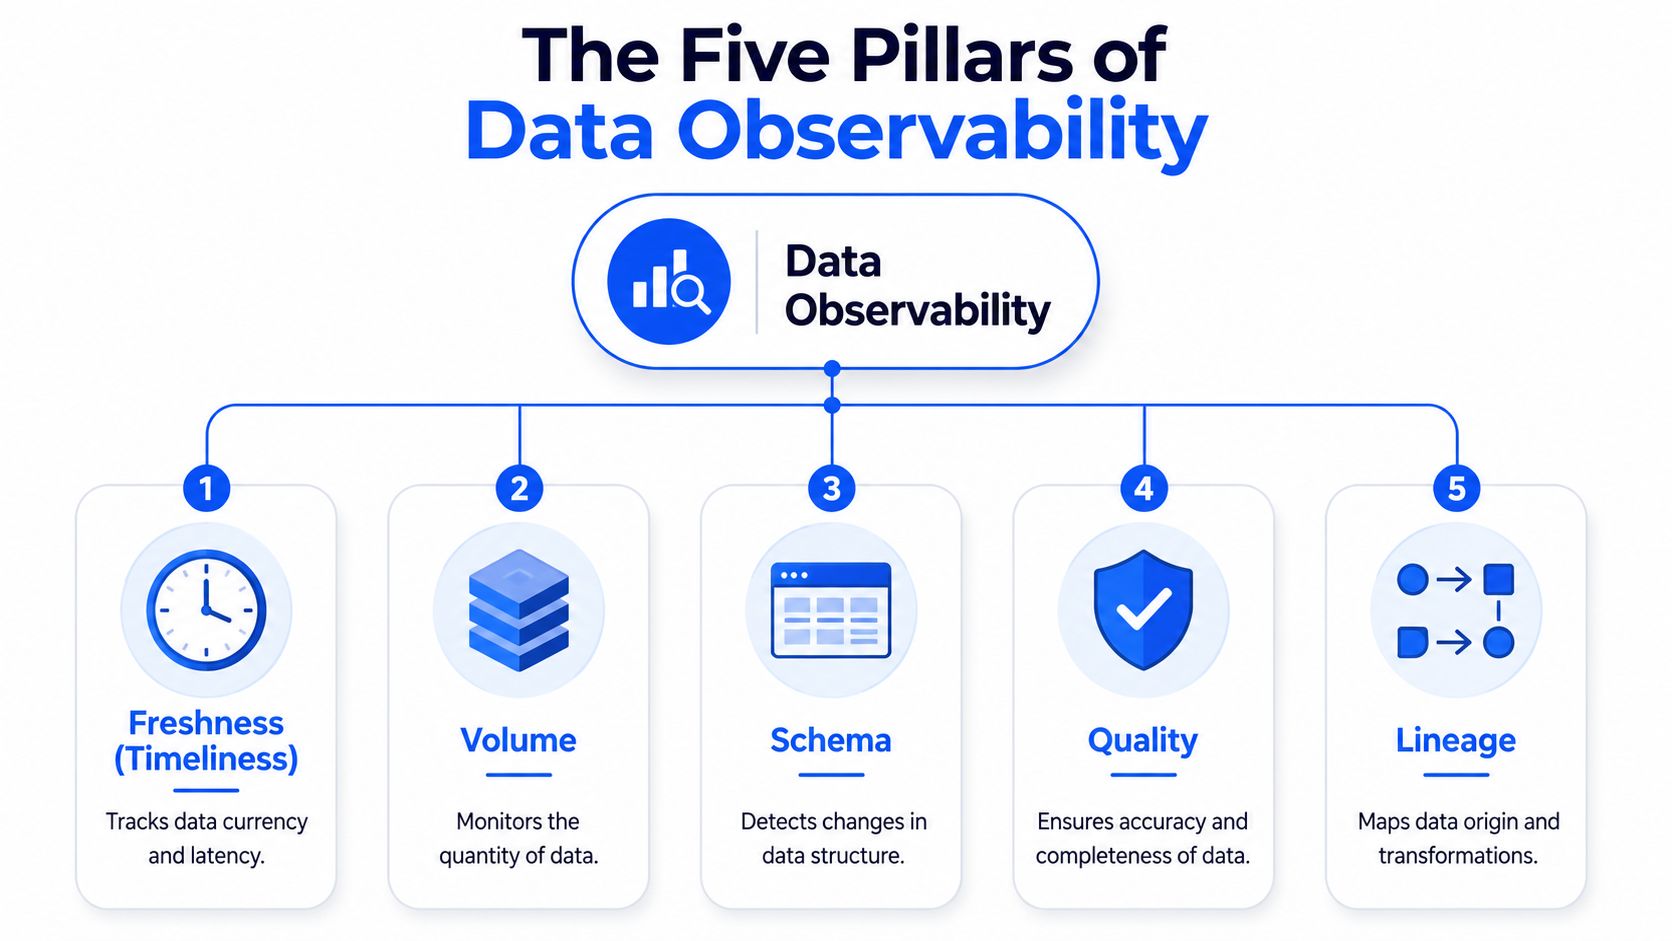
Die Operationalisierung von Data Observability wird einfacher, wenn man sie in Signale zerlegt. Branchenuntersuchungen zeigen, dass die durchschnittliche Zeit zur Erkennung und Behebung von Datenqualitätsproblemen ohne effektive Observability-Praktiken etwa 4 bis 9 Stunden beträgt, und dass ein kontinuierliches Monitoring von Freshness, Volume, Schema, Distribution und Lineage Teams hilft, die Auswirkungen dieser Probleme zu reduzieren, wie in dieser Übersicht über die fünf Säulen der Data Observability beschrieben.
Aktualität und Timeliness
Die Aktualität stellt eine grundlegende operative Frage. Kamen die Daten an, als das Unternehmen sie erwartete?
Das klingt einfach, ist aber eine der wichtigsten Prüfungen in der Produktion. Ein Bericht, der strukturell korrekt, aber sechs Stunden zu spät ist, kann dennoch Fehlentscheidungen auslösen.
Nutzen Sie Timeliness-Monitoring für:
Geplante Feeds: Tägliche oder stündliche Ladungen, die pünktlich eintreffen müssen.
Operative Dashboards: Kennzahlen im Zusammenhang mit Personalbesetzung, Inventar, Betrugsprüfung oder Handelsfenstern.
Zeitkritische KI-Eingaben: Features, die irreführend werden, wenn sie verzögert sind.
Wenn Ihr Team ein konkretes Beispiel für diese Signalkategorie sucht, zeigt Timeliness-Monitoring in der Praxis, wie Zeitplanbewusstsein und die Verfolgung der erwarteten Lieferung in die Observability passen.
Ein praktisches Beispiel ist eine tägliche Bestelltabelle, die normalerweise vor Beginn der Geschäftszeiten aktualisiert wird. Wenn sie nicht eingetroffen ist, schauen Finanzabteilung und Betrieb möglicherweise auf veraltete Zahlen, ohne es zu merken.
Bevor wir tiefer einsteigen, bietet dieses kurze Video einen guten visuellen Überblick über das Konzept.
Volumen
Das Volumen überwacht, ob die Datenmenge innerhalb eines erwarteten Bereichs liegt.
Dies fängt grobe Fehler schnell ab. Wenn die Zeilenzahlen plötzlich einbrechen, ist wahrscheinlich im vorgeschalteten Bereich etwas kaputtgegangen. Wenn die Zahlen unerwartet in die Höhe schnellen, liegt möglicherweise eine Duplizierung oder Wiederholung vor.
Ein nützliches mentales Modell ist der Wareneingang. Wenn normalerweise zehn Lastwagen ankommen und nur zwei auftauchen, brauchen Sie keine perfekte Ursachenanalyse, um zu wissen, dass der Betrieb gefährdet ist.
Schema
Schema-Observability überwacht die Struktur. Hinzugefügte, entfernte, umbenannte oder im Typ geänderte Spalten können die nachgelagerte Logik beschädigen, selbst wenn Ingestions- und Transformationsjobs weiterhin Erfolg melden.
Deshalb sind Schema-Vorfälle so frustrierend. Die Pipeline ist oft technisch nicht „down“. Sie liefert nur ein Ergebnis, das nachgelagerte Konsumenten nicht mehr korrekt interpretieren können.
Typische Beispiele sind:
Typänderungen: Integer zu String oder Änderungen im Zeitstempelformat.
Entfernte Spalten: Ein Feld verschwindet aus einer Quell-API oder einem Transformationsmodell.
Änderungen der Nullbarkeit: Ein zuvor erforderliches Feld kommt plötzlich teilweise leer an.
Verteilung
Die Verteilung geht über Zeilenanzahl und Struktur hinaus. Sie betrachtet das Verhalten von Werten.
Wenn sich die Konversionsrate, die Null-Rate, der Kategoriemix oder die durchschnittliche Warenkorbgröße plötzlich außerhalb der normalen Muster bewegen, machen Verteilungsprüfungen dies sichtbar. Observability fängt dann feine geschäftliche Probleme ab, die starre Schwellenwerte oft übersehen.
Ein fehlerhafter Join ist das klassische Beispiel. Die Zeilenanzahl sieht vielleicht gut aus und das Schema ist unverändert, aber wichtige Werte können dennoch so abweichen, dass Berichte und Modelle beschädigt werden.
Lineage
Lineage beantwortet die Frage, die jeder Vorfallsverantwortliche zuerst stellt. Wo hat das angefangen und was ist noch davon betroffen?
Lineage ist wichtig, weil sich Datenfehler ausbreiten. Eine einzige vorgelagerte Transformation kann sich auf mehrere Data Marts, Dashboards, Reverse-ETL-Ausgaben und Feature-Pipelines auswirken. Ohne Lineage verbringen Teams zu viel Zeit damit, zu raten, wo sie suchen und wen sie benachrichtigen müssen.
Wenn Sie eine Kennzahl nicht bis zu ihrer Quelle zurückverfolgen und bis zu ihren Konsumenten weiterverfolgen können, werden Sie Vorfälle durch Befragungen von Personen statt durch Inspektion von Systemen debuggen.
Zusammengenommen bilden diese Säulen eine praktische Checkliste. Wenn eine Plattform oder ein Prozess nur ein oder zwei davon abdeckt, haben Teams meist eine lückenhafte Sichtbarkeit und eine langsamere Behebung.
Data Observability vs. Datenqualität: Eine entscheidende Unterscheidung
Teams verwenden diese Begriffe oft synonym, was bei der Tool-Auswahl und den Betriebsmodellen zu Verwirrung führt. Sie hängen zusammen, sind aber nicht dasselbe.
Eine einfache Analogie hilft: Ein Arzt, der Puls, Sauerstoffgehalt und Temperatur misst, beobachtet den Zustand des Patienten. Ein Arzt, der einen spezifischen Test auf eine bekannte Krankheit anordnet, prüft auf eine definierte Regel. Data Observability gleicht dem Ersteren. Datenqualität gleicht dem Letzteren.
Warum Teams sie verwechseln
Die Verwirrung entsteht, weil beide Disziplinen darauf abzielen, vertrauenswürdige Daten bereitzustellen.
Die Datenqualität konzentriert sich darauf, ob die Daten den definierten geschäftlichen Erwartungen entsprechen. Ist eine E-Mail gültig? Ist eine Konto-ID eindeutig? Ist ein Pflichtfeld ausgefüllt? Dies sind explizite Regeln, die oft an Compliance, Verträge oder operative Standards gebunden sind.
Data Observability konzentriert sich darauf, ob sich das Datensystem normal verhält und ob Anomalien auftreten. Sie beobachtet Muster, Bewegungen, Abhängigkeiten und Veränderungen im Zeitverlauf. Wenn Sie eine produktorientiertere Aufschlüsselung wünschen, ist diese Erklärung zu Data Observability vs. Datenqualität eine hilfreiche Ergänzung.
Wo die jeweilige Methode hingehört
Hier ist die praktische Unterscheidung:
Dimension | Datenqualität | Data Observability |
|---|---|---|
Hauptfokus | Dateninhalt und Einhaltung von Regeln | Datenzustand, Verhalten und Systemkontext |
Typische Methode | Validierungsregeln und Assertions | Anomalieerkennung, Monitoring und Lineage-Analyse |
Am besten geeignet für | Bekannte Probleme | Unbekannte oder neu auftretende Probleme |
Beispielfrage | Ist | Warum stiegen die Null-Raten bei |
Zeitorientierung | Korrektheit zu einem bestimmten Zeitpunkt | Kontinuierliches operatives Bewusstsein |
Wichtigstes Ergebnis | Einhaltung von Regeln | Frühzeitige Erkennung und schnellere Diagnose |
Eine ausgereifte Plattform benötigt beides.
Datenqualität ohne Observability wird fehleranfällig, da Teams nur abfangen können, was sie vorhergesehen haben. Observability ohne Qualität lässt Lücken, wo explizite Geschäftsregeln zwingend erforderlich sind. Regulierte Workflows, Audit-Anforderungen und vertragliche Datenstandards benötigen weiterhin deterministische Prüfungen.
Gute Datenqualität sagt Ihnen, ob ein Datensatz die Prüfung besteht. Gute Observability sagt Ihnen, ob das System, das den Datensatz erzeugt hat, sich in Richtung eines Ausfalls bewegt.
Das stärkste Betriebsmodell behandelt Qualität und Observability als komplementäre Ebenen, nicht als konkurrierende Kategorien.
Wie moderne Data-Observability-Architekturen funktionieren
Eine Pipeline fällt um 02:00 Uhr nachts aus. Der Dashboard-Fehler ist nur das sichtbare Symptom. Bis die Finanzabteilung, der Betrieb oder ein kundenorientiertes Modell fehlerhafte Zahlen anzeigt, hat das Unternehmen bereits die ersten Kosten für den Datenausfall verbucht: verzögerte Entscheidungen, Vertrauensverlust und Ingenieure, die mit manueller Triage beschäftigt sind.
Die Architektur bestimmt, ob Observability diesen Vorfall verkürzt oder über den ganzen Tag hinweg ausdehnt.
Ein modernes Design überwacht den gesamten Produktionsweg, einschließlich Ingestion, Transformationsschichten, Bereitstellungstabellen, BI-Assets und ML-Konsumenten. Probleme beginnen selten am finalen Dashboard. Sie beginnen früher, bei einer vorgelagerten Schemaänderung, einer verzögerten Abhängigkeit, einer fehlerhaften Transformation oder einem Abweichungsmuster, das niemand explizit modelliert hat. Ohne Lineage über diese Schichten hinweg wird die Reaktion auf Vorfälle zu einem teuren Ratespiel.
Aus diesem Grund ist das Ausführungsmodell ebenso wichtig wie die Feature-Liste. Wenn eine Plattform nur nachgelagerte Tabellen überwacht, erkennen Teams Fehler erst, wenn sich die geschäftlichen Auswirkungen zeigen. Wenn Daten in eine Anbieterumgebung exportiert werden müssen, können Sicherheitsüberprüfungen, Latenzzeiten und zusätzliche Kosten die Einführung verlangsamen. Wenn die Abdeckung der Überwachung von manuell erstellten Prüfungen für jedes wichtige Asset abhängt, wird das System zu einer weiteren Wartungslast anstatt zu einer operativen Ebene.
Das T-förmige Modell in der Praxis
Ein Architekturmuster bewährt sich in großen Landschaften besonders gut: das T-förmige Monitoring-Modell.
Die horizontale Ebene wendet ein leichtgewichtiges Monitoring über das gesamte Warehouse an. Das umfasst in der Regel Aktualität, Volumenverschiebungen, fehlgeschlagene Läufe, Lineage-Lücken und andere allgemeine Signale, die darauf hinweisen, dass sich etwas geändert hat. Die vertikale Schicht geht tiefer in die Assets, die mit der Umsatzberichterstattung, den Dashboards für die Führungsebene, den Compliance-Workflows und der Produktions-ML verknüpft sind. DataHub beschreibt diesen Ansatz in seiner Erklärung des T-förmigen Monitorings.
Dies ist eine Entscheidung zur Business Continuity, nicht nur eine Vorliebe beim Monitoring. Eine gleiche Abdeckung überall klingt diszipliniert, erzeugt aber oft Alarmrauschen und verschwendet Entwicklungszeit für weniger wichtige Assets. Wenn man sich nur auf eine kleine Gruppe kritischer Tabellen konzentriert, entstehen im vorgeschalteten Bereich Blind Spots, in denen viele Vorfälle ihren Anfang nehmen. Die T-Form gleicht beide Kompromisse aus. Breites Bewusstsein über die gesamte Landschaft hinweg. Tiefere Inspektion dort, wo Ausfallzeiten am meisten kosten.
In der Praxis erweitern starke Teams dieses Modell auch mit Nutzungs- und Verhaltenskontext. Das Monitoring wird nützlicher, wenn Architekten technische Signale mit Konsummustern, Eigentumsrechten und nachgelagerten Geschäftsprozessen verknüpfen können. Das ist der Zweck der Erweiterung der Data Observability durch Analytics. Es hilft Teams zu entscheiden, welche Anomalien operatives Rauschen sind und welche einen Quartalsabschlussprozess, eine wichtige KPI für die Führungsebene oder einen Kunden-Workflow bedrohen.
Warum KI operativ wichtig ist
Statische Schwellenwerte versagen in Live-Systemen.
Datenmuster ändern sich mit Saisonalität, Produkteinführungen, Preisaktualisierungen, Akquisitionen und sich änderndem Nutzerverhalten. Eine Regel, die vor drei Monaten funktionierte, kann heute einen echten Vorfall übersehen oder bei normalen Abweichungen ständig Alarm schlagen. Teams verbringen dann ihre Zeit mit der Feinabstimmung von Monitoren, anstatt die Pipeline-Zuverlässigkeit zu verbessern.
KI-gestützte Observability löst dieses Problem, indem sie historisches Verhalten erlernt und Anomalien im Kontext bewertet. Sie eignet sich besser zum Erkennen von Drift, ungewöhnlichen Joins, sich ändernden Verteilungen und zeitlichen Verschiebungen, die sich nicht sauber in einer festen Regel abbilden lassen. Das reduziert Fehlalarme und verkürzt die Zeit bis zur Ursachenanalyse, insbesondere in Umgebungen mit Hunderten oder Tausenden von Assets.
Die stärkste Architektur ist hybrid. Nutzen Sie gelernte Baselines, um unbekannte Fehlerszenarien abzufangen. Behalten Sie deterministische Prüfungen für vertragliche SLAs, regulierte Felder und Geschäftsregeln bei, die eine explizite Pass- oder Fail-Logik erfordern. Diese Kombination macht Observability von der reaktiven Bereinigung zu einem Frühwarnsystem für das Geschäft, auf das man sich jeden Tag verlässt.
Die Theorie mit einer Plattform in die Praxis umsetzen
Die Theorie ist nur dann von Bedeutung, wenn sie den täglichen Betrieb verändert. In der Praxis benötigen Teams eine Ebene für die Anomalieerkennung, eine weitere für die deterministische Validierung und genügend historischen Kontext, um zu entscheiden, ob ein Alarm nur Rauschen oder der Beginn eines Vorfalls ist.
Ein erhebliches operatives Hindernis ist die Instandhaltung fehleranfälliger Monitore. Ein Accenture-Bericht aus dem Jahr 2025 zur Produktivität im Data Engineering zeigt, dass 40–60 % der Zeit von Datenteams für die präventive Wartung schwellenwertbasierter Regeln aufgewendet wird – ein Kostenfaktor, der in der Diskussion von Databricks über die versteckte Wartungslast in der Data Observability hervorgehoben wird. Das ist ein Grund, warum Teams verstärkt auf KI-gestützte Erkennung setzen, die Fehlalarme reduzieren und die Ursachenanalyse verkürzen kann.
Wie sich Funktionen den täglichen Fehlerszenarien zuordnen lassen
Eine praktische Plattform lässt sich direkt den Vorfallsmustern zuordnen, die Datenteams bereits kennen:
Verspätete oder fehlende Ladungen: Timeliness-Monitoring erkennt verzögerte Eingänge, bevor ein Vorstands-Dashboard oder ein SLA-gesteuerter Workflow betroffen ist.
Stille Metrik-Abweichung: Anomalieerkennung macht unerwartete Änderungen im Volumen- oder Wertverhalten sichtbar, ohne darauf zu warten, dass ein Mensch es bemerkt.
Schädliche Strukturänderungen: Schema-Tracking markiert hinzugefügte, entfernte oder geänderte Felder, bevor nachgelagerte Transformationen fehlschlagen.
Richtlinienbedarf auf Datensatzebene: Validierungsregeln sind weiterhin dort wichtig, wo Geschäftslogik, Audits oder Compliance explizite Pass-Fail-Prüfungen erfordern.
Musterprüfung im Zeitverlauf: Historische Analysen helfen Teams zu erkennen, ob ein Alarm ein isolierter Ausschlag oder Teil einer wiederkehrenden operativen Schwachstelle ist.
Ein Beispiel ist die Analytics-Erweiterung von digna für Observability, die Anomalieerkennung und Timeliness-Monitoring mit historischer Trendanalyse, Schema-Tracking und Validierung auf Datensatzebene in kundenkontrollierten Umgebungen verbindet. Diese Kombination spiegelt eine praktische Realität wider: Observability und Qualität lassen sich am einfachsten betreiben, wenn sie nicht über unzusammenhängende Tools verteilt sind.
Was beim Rollout meist schiefgeht
Der häufigste Fehler beim Rollout besteht darin, zu versuchen, jede Tabelle vom ersten Tag an in der gleichen Tiefe zu instrumentieren.
Dies führt zu zu vielen Alarmen, unklaren Zuständigkeiten und Skepsis bei den Geschäftsanwendern. Eine bessere Sequenz ist enger gefasst. Beginnen Sie mit Assets, die mit Umsatz, Finanzen, Kundenberichten, regulierten Prozessen oder Modelleingaben verknüpft sind. Versehen Sie diese zuerst mit Freshness, Volume, Schema und Lineage. Erweitern Sie den Kreis danach.
Ein weiterer Fehler ist es, Observability als rein technisches Anliegen zu betrachten. Betrieb, Analytics, governance und ML-Verantwortliche benötigen alle Sichtbarkeit, da sie unterschiedliche Symptome desselben vorgeschalteten Fehlers wahrnehmen.
Ihre Checkliste für die Implementierung von Data Observability
Ein Rollout beginnt meist auf dieselbe Weise: Die Finanzabteilung fragt, warum sich die gestrige Vorstandskennzahl geändert hat. Der Betrieb sieht einen fehlerhaften SLA-Bericht. Das Datenteam beginnt, Jobs zurückzuverfolgen, dbt-Läufe zu prüfen und Zeilenzahlen manuell zu vergleichen. Bis die Ursache feststeht, hat das Unternehmen bereits mit fehlerhaften Informationen gearbeitet.
Deshalb sollte die Implementierung als eine Übung zur Business Continuity und nicht als reines Monitoring-Projekt behandelt werden. Beginnen Sie dort, wo schlechte Daten Entscheidungen, Berichterstattung, Umsatz, Compliance oder die Modellleistung unterbrechen würden. Erweitern Sie die Abdeckung dann so, dass Ihr Team sie bewältigen kann.

Eine praktische Startsequenz
Die Abdeckung sollte dem Weg der geschäftlichen Auswirkungen folgen. Wenn eine KPI in einem Dashboard fehlerhaft ist, liegt die Ursache oft mehrere Schritte vorgeschaltet bei der Ingestion, Transformation oder einer Schemaänderung, die die Berichtsseite nie erreicht hat. Teams benötigen genügend Lineage- und Monitoring-Tiefe, um diesen Weg schnell zurückzuverfolgen, ohne zu versuchen, am ersten Tag jede Tabelle zu instrumentieren.
Nutzen Sie diese Checkliste als Startsequenz:
Kritische Daten-Assets definieren
Listen Sie die Dashboards, Berichte, Modelle und operativen Tabellen auf, ohne die das Unternehmen nicht sicher arbeiten kann. Priorisieren Sie nach den Auswirkungen, nicht nach der Anzahl der Tabellen.Mit Freshness und Volume starten
Diese Signale fangen viele operative Fehler frühzeitig ab und sind meist am schnellsten einzurichten. Sie bilden zudem eine klare erste Baseline für Alarmierungen.Einen hoch prioritären Lineage-Pfad abbilden
Verfolgen Sie eine wichtige Kennzahl von der Quelle bis zum nachgelagerten Konsum in BI oder ML. Dies deckt meist Zuständigkeitslücken, undokumentierte Abhängigkeiten und fehleranfällige Transformationen schneller auf als eine breite, aber flache Abdeckung.Erkennung von Schemaänderungen hinzufügen
Strukturelle Abweichungen verursachen stille Fehler. Spalten werden umbenannt, Typen ändern sich, Nullable-Felder sind plötzlich nicht mehr nullbar, und Stunden später bricht die nachgelagerte Logik zusammen.Verteilungsprüfungen für hoch prioritäre Datensätze integrieren
Frische Daten können dennoch falsch sein. Verteilungsprüfungen helfen dabei, Join-Fehler, Regressionen in der Geschäftslogik, Schieflagen und Drift zu erkennen, bevor Benutzer sie in einem Bericht oder einer Modellausgabe bemerken.Eine Plattform wählen, die die manuelle Pflege von Regeln begrenzt
Wenn jeder Monitor eine ständige Feinabstimmung der Schwellenwerte erfordert, wird Observability zu einem weiteren Backlog. KI-gestützte Baselining- und Triage-Funktionen helfen Teams, mehr Zeit mit der Behebung echter Probleme und weniger Zeit mit der Verwaltung von Alarmen zu verbringen.
Der Test ist unkompliziert: Kann Ihr Betriebsmodell den Bereichen Finanzen, Betrieb, Produkt und Analytics sagen, ob die Datenprodukte, von denen sie abhängen, im Moment fehlerfrei sind, und kann es das tun, bevor ein Defekt zu einem geschäftlichen Ausfall führt?
Wenn Ihr Team von der reaktiven Fehlersuche zur proaktiven Kontrolle übergehen möchte, bietet digna Funktionen für Data Observability und Datenqualität wie Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking, Validierung und In-Database-Ausführung für kundenkontrollierte Umgebungen.
Häufig gestellte Fragen
Was ist Data Observability?
Data Observability bezeichnet die Praxis, den Zustand von Datensystemen zu verstehen, indem die Signale von Daten und Pipelines kontinuierlich geprüft werden. Sie zeigt, ob Daten pünktlich, in der erwarteten Form und mit dem erwarteten Verhalten ankommen und ob genug Kontext vorhanden ist, um Probleme bis zur Quelle zurückzuverfolgen.
Was sind die fünf Säulen der Data Observability?
Die fünf Säulen sind Freshness, Volumen, Schema, Verteilung und Lineage. Freshness prüft, ob Daten pünktlich ankamen, Volumen, ob Zeilenzahlen im erwarteten Bereich liegen, Schema, ob sich die Struktur geändert hat, Verteilung, ob sich Werte normal verhalten, und Lineage, wo ein Problem begann und was es nachgelagert betraf.
Was ist der Unterschied zwischen Data Observability und Datenqualität?
Datenqualität prüft, ob Daten definierte Regeln erfüllen, etwa ob customer_id eindeutig ist. Observability fragt, warum die Null-Rate in customer_id plötzlich gestiegen ist. Qualität erkennt bekannte Probleme zu einem Zeitpunkt, Observability bietet laufenden Überblick über unbekannte oder neu entstehende Probleme. Eine ausgereifte Plattform braucht beides.
Wie unterscheidet sich Data Observability vom Monitoring?
Monitoring funktioniert am besten, wenn der Fehlerfall bereits bekannt ist, etwa ein fehlgeschlagener Job oder eine Tabelle, die ihre Aktualisierungszeit verpasst. Observability deckt Fälle ab, die statische Prüfungen nicht vorhergesehen haben, zum Beispiel eine erfolgreiche Pipeline mit nur der Hälfte der erwarteten Zeilen oder einen Join, der eine kritische Kennzahl verschiebt.
Womit sollte die Einführung von Data Observability beginnen?
Definieren Sie zuerst kritische Datenbestände wie Umsatz-Dashboards, Finanzberichte und Modell-Inputs und ergänzen Sie dann Freshness- und Volumen-Monitoring, da diese am schnellsten einzurichten sind. Bilden Sie anschließend einen wichtigen Lineage-Pfad ab, fügen Sie die Erkennung von Schemaänderungen hinzu und ergänzen Sie Verteilungsprüfungen für kritische Datensätze.


