Historische Snowflake-Daten: Time Travel, Fail-Safe
|
9
min. Lesezeit

Um 3 Uhr morgens schneidet ein automatisierter Job eine Kundentabelle ab, anstatt die nächste Partition zu laden. Bis das Team eintrifft, sind die Dashboards leer, nachgelagerte Modelle schlagen fehl, und niemand kann sich einigen, ob der Schaden beim Laden, bei der Transformation oder durch ein Bereinigungsskript begonnen hat. Historische Snowflake-Daten können diesen Vorfall in eine kontrollierte Wiederherstellung verwandeln, aber nur, wenn das Team weiß, welche Historie noch existiert, welche Objekte geschützt sind und ob die verfügbare Kopie abfragbar oder nur zur Wiederherstellung gedacht ist.
Die gefährlichste Annahme ist, dass jede Snowflake-Tabelle automatisch das beworbene 90-Tage-Time-Travel-Fenster hat. Permanente Objekte können in der richtigen Edition für diese Dauer konfiguriert werden, aber temporäre und transiente Objekte haben viel engere Grenzen. Historische Daten sind daher mehr als ein SQL-Feature. Es ist eine Designentscheidung, die Wiederherstellung, Observability, Audit-Nachweise, Speicher und den Lebenszyklus von Objekten betrifft.
Inhaltsverzeichnis
Wenn historische Daten Ihre Produktionsumgebung retten
Um 2 Uhr morgens ersetzt ein fehlgeschlagener Ladevorgang gültige Kundendatensätze durch Nullwerte. Der diensthabende Ingenieur stoppt den Writer, prüft, ob die Tabelle noch über eine nutzbare Historie verfügt, und erfasst den Vorfall, bevor ein erneuter Versuch die Beweise verändert. Eine historische Abfrage kann den letzten bekannten guten Zustand zeigen, während ein Klon dem Team eine separate Wiederherstellungsfläche bietet. Die Produktion bleibt verfügbar, während der Fehler untersucht wird.
Dieses Ergebnis hängt von der Vorbereitung ab. Snowflake Time Travel bewahrt frühere Tabellenzustände und unterstützt historische SELECT-, Klon- und UNDROP-Operationen innerhalb des konfigurierten Aufbewahrungsfensters. Der Standardzeitraum beträgt 1 Tag, während permanente Datenbanken, Schemata und Tabellen gemäß der Time Travel-Dokumentation von Snowflake von 0 bis zu 90 Tagen konfiguriert werden können. Der beworbene Zeitraum von 90 Tagen gilt nur dort, wo der Objekttyp, die Edition und die Einstellungen dies zulassen.
Das Vorfallsmuster, das Teams unterschätzen
Eine permanente Produktionstabelle behält möglicherweise den erforderlichen Zustand bei, während die transiente Staging-Tabelle, die sie gespeist hat, ihre nutzbare Historie bereits verloren hat. Diese Lücke schränkt die Untersuchung ein. Das Team kann zwar wiederherstellen, wie das Ziel aussah, ohne jedoch beweisen zu können, welche vorgeschaltete Änderung die fehlerhaften Werte eingeführt hat.
Erfassen Sie die Zeitleiste des Vorfalls mit einer ausführbaren Abfrage, bevor Sie etwas wiederherstellen:
Die Ansicht zur Kontonutzung weist eine Latenz auf. Kombinieren Sie sie daher mit Orchestrierungsprotokollen und dem Aufgabenverlauf, wenn der Vorfall noch aktiv ist. Erfassen Sie die betroffenen Objekte, beobachteten Symptome und die Abfrage-IDs, die die Produktion verändert haben.
Betriebsregel: Behandeln Sie die Aufbewahrung als Kontrolle auf Objektebene, nicht als plattformweites Versprechen.
Verwenden Sie eine konservative Wiederherstellungssequenz:
Stoppen Sie den Writer: Pausieren Sie die fehlschlagende Aufgabe, Pipeline oder Bereitstellung.
Vor der Wiederherstellung prüfen: Vergleichen Sie historische und aktuelle Zeilen, Schlüssel, Null-Verhalten und Gesamtsummen der Geschäftsdaten.
In Isolation wiederherstellen: Erstellen Sie einen Klon oder eine separate Tabelle, solange der Fehlermechanismus ungewiss bleibt.
Den Ersatz validieren: Testen Sie Abhängigkeiten und Berechtigungen vor der Bereitstellung.
Teams, die eine umfassendere Zuverlässigkeitspraxis aufbauen, können diesen Workflow mit Database Reliability Engineering verknüpfen. Historische Daten unterstützen dann die Observability und die Überprüfung von Audits, nicht nur die Notfallwiederherstellung. Die Aufbewahrung sollte zusammen mit Zuständigkeiten, Lineage, Überwachung und Wiederherstellungszielen überprüft werden.
Das Wachstum von Snowflake hat auch zu gemischteren Objektlebenszyklen geführt. Mit der Erweiterung von Bereitstellungen erben Teams permanente, transiente und temporäre Datensätze mit unterschiedlichem Wiederherstellungsverhalten. Die praktische Frage ist nicht, ob Snowflake 90 Tage anbietet. Sie lautet, welche Objekte Beweise lange genug aufbewahren, um einen Produktionsfehler wiederherzustellen und zu erklären.
Querying Past States with Time Travel
Time Travel funktioniert am besten, wenn der Ingenieur drei Aufgaben trennt: einen früheren Zustand untersuchen, die genaue Änderungsgrenze identifizieren und eine isolierte Kopie erstellen. Die Syntax unterstützt jeden Ansatz, aber die Wahl beeinflusst, wie präzise Sie den Vorfall reproduzieren können.
Verwenden von Zeitstempeln für ein bekanntes Vorfallsfenster
Wenn die Überwachung zeigt, dass ein destruktiver Ladevorgang zu einer bekannten Zeit begann, fragen Sie die Tabelle so ab, wie sie vor diesem Ereignis existierte:
AT ist nützlich, wenn die Zeitleiste des Vorfalls aus Orchestrierungsprotokollen, Bereitstellungsaufzeichnungen oder dem Abfrageverlauf stammt. Es fragt Snowflake nach dem Objektzustand zu einem bestimmten Zeitpunkt ab, was sich gut für den Vergleich einer bekannten guten Version mit der aktuellen Tabelle eignet.
Sie können diesen historischen Zustand auch klonen:
Der Klon bietet dem Team eine Arbeitsfläche für Untersuchungen, ohne die Quelle zu überschreiben. Bevor Sie sich auf das Ergebnis verlassen, überprüfen Sie, ob der angeforderte Zeitstempel innerhalb des aktuellen Aufbewahrungsfensters des Objekts liegt.
Verwenden von Offsets für relative Untersuchungen
Wenn der Vorfall vor Kurzem aufgetreten ist, aber der genaue Zeitstempel weniger wichtig ist, bewegt sich OFFSET um eine Anzahl von Sekunden zurück:
Dies ist bei einem aktiven Vorfall praktisch, da es einen relativen Zeitpunkt ausdrückt. Für ein formelles Auditprotokoll ist es weniger geeignet, es sei denn, Sie erfassen auch die Ausführungszeit und den aufgelösten Zeitstempel, da „vor einer Stunde“ im Nachhinein unklar werden kann.
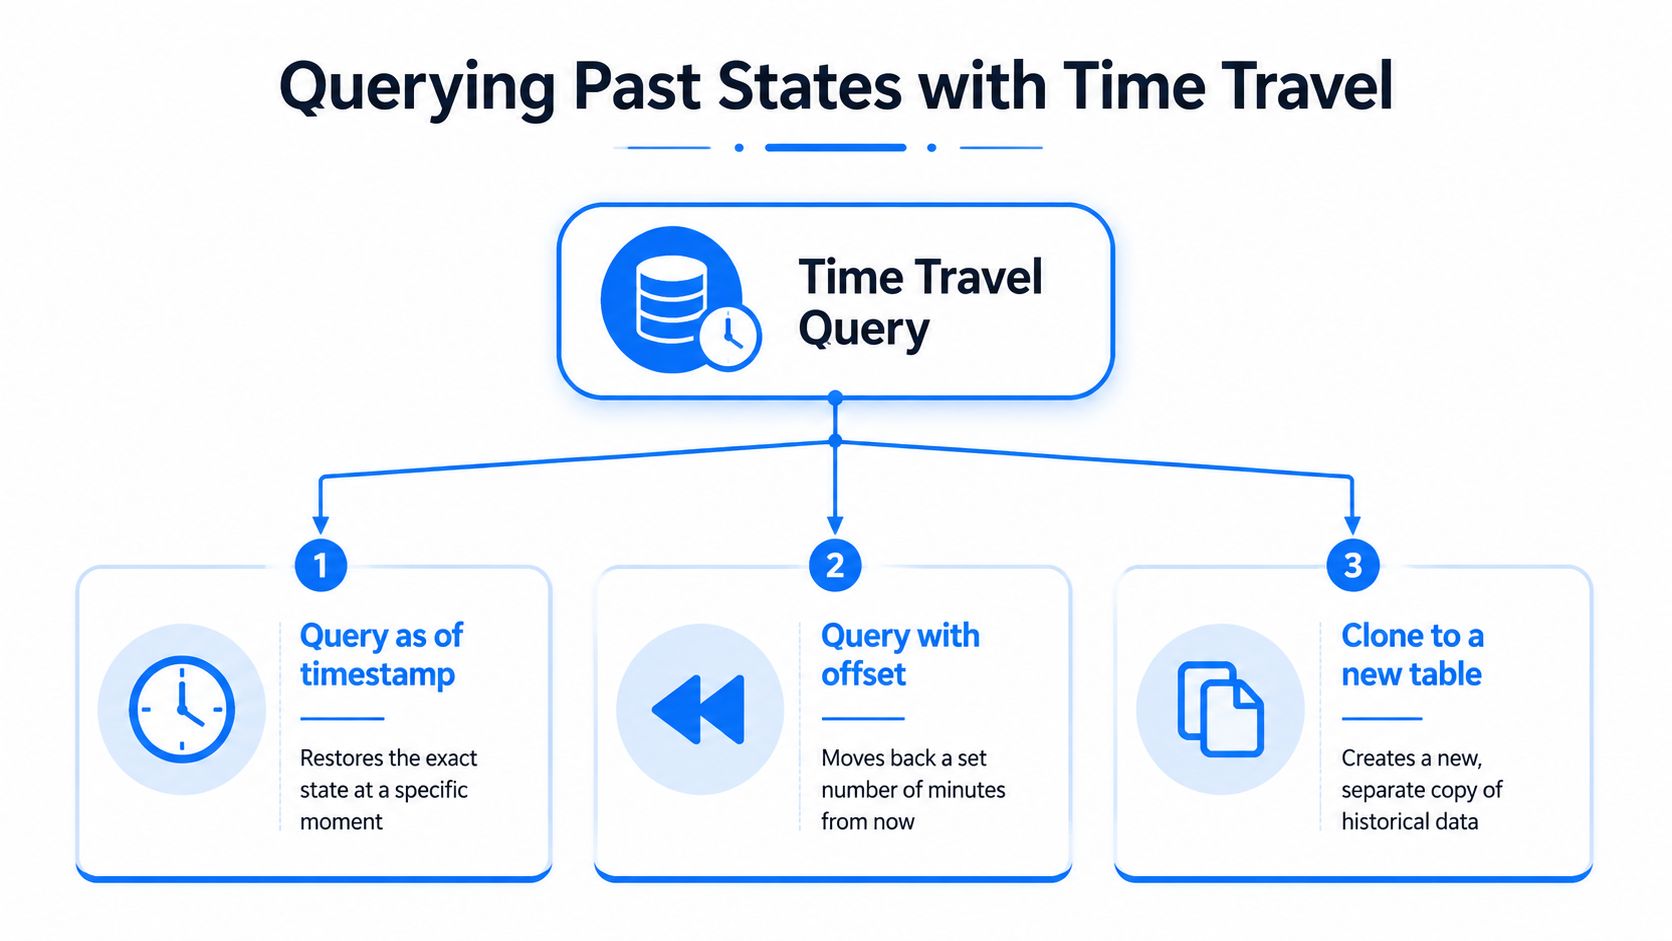
Verwenden von Transaktionsgrenzen, wenn die Änderung identifizierbar ist
Wenn der Abfrageverlauf oder die Bereitstellungstools Ihnen eine Transaktions-ID liefern, können Sie mit BEFORE den Tabellenzustand vor dieser Transaktion untersuchen:
Der genaue Bezeichner muss in Ihren Betriebsaufzeichnungen verfügbar sein. Raten Sie ihn nicht. Eine Zeitstempelabfrage ist normalerweise sicherer, wenn das Team nur eine ungefähre Vorfallszeit hat.
Die Validierung der Aufbewahrung gehört vor die Wiederherstellungs-SQL, nicht nach einer fehlgeschlagenen Abfrage:
Überprüfen Sie die zurückgegebene retention_time und bestätigen Sie dann die Edition und den Objekttyp der Tabelle. Snowflake dokumentiert eine Standard-Aufbewahrungsfrist von 1 Tag und eine konfigurierbare Aufbewahrung von 0 bis 90 Tagen für permanente Datenbanken, Schemata und Tabellen in den entsprechenden Editionen, wie in den Richtlinien zur Datenverfügbarkeit beschrieben.
Time Travel ist auch kein herkömmliches Backup-Archiv. Es bewahrt abfragbare historische Zustände für einen definierten Zeitraum auf, erfüllt jedoch nicht automatisch die Anforderungen an eine langfristige Aufbewahrung, unveränderliche Kopien oder die Wiederherstellung in unabhängigen Konten. Verwenden Sie es für schnelle betriebliche Untersuchungen und Point-in-Time-Wiederherstellungen und prüfen Sie dann, ob eine weitere Schutzebene erforderlich ist.
Verstehen von Aufbewahrungsfristen und Objekttypen
Die 90-Tage-Frist gilt für eine Funktion, nicht für jedes Objekt in einem Konto. Permanente Objekte können eine konfigurierbare Time Travel-Dauer von 0 bis 90 Tagen haben, während temporäre und transiente Objekte gemäß der Dokumentation zu Speicherkosten und Aufbewahrung von Snowflake auf 0 oder 1 Tag beschränkt sind. Die Staging-Tabelle, die Ihre Pipeline während einer Bereitstellung neu erstellt hat, verfügt möglicherweise nicht über denselben Schutz wie die Produktionstabelle, die sie speist.
Aufbewahrung historischer Snowflake-Daten nach Objekttyp
Objekttyp | Time Travel (Standard) | Time Travel (Enterprise+) | Fail-safe |
|---|---|---|---|
Permanente Datenbank, Schema oder Tabelle | Standardmäßig 1 Tag | 0 bis 90 Tage | 7 Tage nach Time Travel für permanente Objekte |
Transiente Tabelle | 0 oder 1 Tag | 0 oder 1 Tag | Nicht verfügbar |
Temporäre Tabelle | 0 oder 1 Tag | 0 oder 1 Tag | Nicht verfügbar |
Die Tabelle spiegelt das dokumentierte Aufbewahrungsmodell wider. Fail-safe ist keine vom Benutzer abfragbare Erweiterung von Time Travel. Nach Ablauf der historischen Daten können permanente Objekte in eine 7-tägige Fail-safe-Phase übergehen. Diese Daten sind jedoch für die Wiederherstellungsunterstützung gedacht und nicht für die normale SELECT-Analyse. Wenn Fail-safe als Audit-Abfrageebene behandelt wird, führt dies zu einer falschen Sicherheit bei einem Vorfall.
Überprüfen der Einstellungen vor einem Fehler
Beginnen Sie mit dem Objekt selbst:
Überprüfen Sie retention_time, die Objektart und die Edition, die für das Konto gilt. Klassifizieren Sie dann Tabellen nach ihrer Rolle. Permanente Geschäftstabellen verdienen in der Regel eine andere Richtlinie als temporäre Landing-Tabellen, aber diese Unterscheidung muss explizit und dokumentiert sein.
Der Speicherplatz ist der Kompromiss. Eine längere Aufbewahrung bedeutet, dass Snowflake mehr historische Daten vorhält. Teams sollten daher die Auswirkungen für Tabellen mit hoher Fluktuation abschätzen, anstatt überall die maximale Aufbewahrung zu aktivieren. Die von Snowflake dokumentierten Wartungsfenster für historische Daten betragen 7 bis 97 Tage für permanente Objekte in der Enterprise Edition, verglichen mit 0 bis 1 Tag für transiente Objekte. Daher ist die Objektklassifizierung von zentraler Bedeutung für die Kostenplanung und das Wiederherstellungsdesign.
Praktische Regel: Eine Aufbewahrungsrichtlinie sollte drei Fragen beantworten: Was muss wiederherstellbar sein, was muss prüfbar sein und was kann aus einer verbindlichen Quelle neu erstellt werden?
Regulatorische Anforderungen stellen eine weitere Einschränkung dar. Ein Unternehmen muss Beweise möglicherweise über einen Zeitraum aufbewahren, der nicht mit Time Travel übereinstimmt, oder es benötigt einen dokumentierten Löschplan anstelle einer unbefristeten Aufbewahrung. Für diese Richtlinienarbeit bieten die Empfehlungen zu DSGVO-Aufbewahrungsfristen nützliche Hinweise zur Abstimmung der Aufbewahrung mit dem Zweck, den gesetzlichen Anforderungen und der kontrollierten Entsorgung.
Teams, die langlebige Datensätze entwerfen, sollten auch die Archivierung von der Vorfallswiederherstellung trennen. Die Hinweise zur Meisterung der Datenarchivierung sind relevant, da ein Archiv absichtlich, kontrolliert und auffindbar sein sollte. Time Travel schützt ein veränderliches Objekt für ein begrenztes Zeitfenster. Es ersetzt keinen Archivkatalog oder einen Verantwortlichen für die Aufbewahrung.
Wiederherstellen gelöschter Objekte mit Klonen und UNDROP
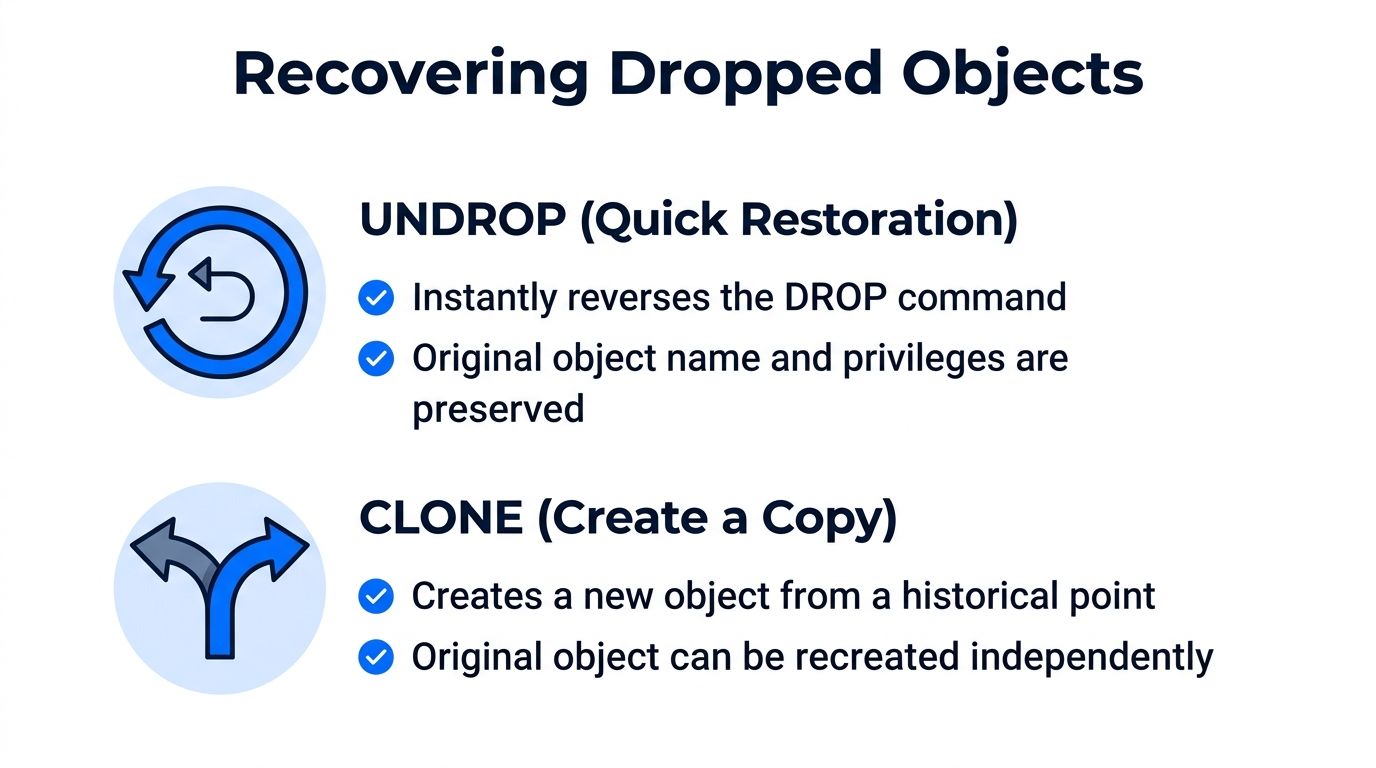
Eine gelöschte Tabelle stellt ein anderes Wiederherstellungsproblem dar als ein fehlerhaftes Update. Das Objekt selbst kann aus dem aktiven Namensraum verschwinden, sodass der Ingenieur entscheiden muss, ob er das ursprüngliche Objekt wiederherstellt oder eine unabhängige Kopie für die Untersuchung erstellt.
UNDROP ist der direkte Weg, wenn das Objekt innerhalb seines verfügbaren Wiederherstellungszeitraums gelöscht wurde:
Verwenden Sie für ein gelöschtes Schema oder eine gelöschte Datenbank den entsprechenden Befehl auf Objektebene:
Der Befehl ist während eines Ausfalls attraktiv, da er das Löschen rückgängig macht, anstatt einen Datenverschiebungs-Workflow zu erfordern. Dennoch sollte die Wiederherstellung nicht als Beweis dafür gewertet werden, dass das Objekt korrekt ist. Überprüfen Sie die Existenz des Objekts, Berechtigungen, Abhängigkeiten und das von der Anwendung erwartete Schema, bevor Sie die Verbraucher wieder verbinden.
Zuerst klonen, wenn der Fehler unklar ist
Ein Klon ist sicherer, wenn das Team eine historische Version überprüfen muss, ohne den Produktions-Wiederherstellungspfad zu ändern:
Dieser Ansatz schont die Quelle, während Ingenieure Datensätze vergleichen, Transformationen testen und die Anweisung identifizieren, die den Schaden verursacht hat. Er unterstützt auch einen kontrollierten Bereitstellungsprozess: Validieren Sie den Klon, dokumentieren Sie die Beweise und entscheiden Sie dann, ob das Produktionsobjekt ersetzt oder repariert werden soll.
Objektnamen können UNDROP erschweren. Wenn ein neues Objekt bereits den ursprünglichen Namen erhalten hat, erfordert der Wiederherstellungsvorgang möglicherweise zuerst das Umbenennen oder Entfernen des kollidierenden Objekts. Improvisieren Sie diesen Schritt nicht in der Produktion. Erfassen Sie die aktuellen Objekt-Metadaten, bewahren Sie das kollidierende Objekt auf, falls es Beweise enthalten könnte, und verwenden Sie nach Möglichkeit ein dafür vorgesehenes Wiederherstellungsschema.
Validieren vor der Bereitstellung
Eine Wiederherstellungs-Checkliste sollte Folgendes umfassen:
Bestätigen Sie die Fehlergrenze: Stellen Sie fest, ob das Löschen, Aktualisieren oder Ersetzen eine Tabelle, ein Schema oder eine Datenbank betroffen hat.
Prüfen Sie die Berechtigung zur Aufbewahrung: Stellen Sie sicher, dass der historische Zustand des Objekts noch verfügbar und abfragbar ist.
Erstellen Sie eine isolierte Kopie: Bevorzugen Sie einen Klon, wenn noch Untersuchungen oder Vergleiche erforderlich sind.
Vergleichen Sie kritische Werte: Überprüfen Sie Schlüssel, Ausnahmen auf Zeilenebene, Aggregate und nachgelagerte Erwartungen.
Berechtigungen überprüfen: Bestätigen Sie, dass Eigentumsrechte und Freigaben mit dem beabsichtigten Zugriffsmodell übereinstimmen.
Gezielt bereitstellen: Ändern Sie Verbraucher erst, nachdem das wiederhergestellte Objekt die Validierung bestanden hat.
Die Micro-Partition-Architektur von Snowflake bedeutet, dass ein Klon kein manuell zusammengestelltes Backup ist. Historische Zustände bleiben an das Aufbewahrungs- und Speicherverhalten der Plattform gebunden, sodass der Wiederherstellungsplan weiterhin eine unabhängige Strategie für Daten benötigt, die über diesen Lebenszyklus hinaus bestehen müssen.
Teams, die diese Verfahren formalisieren, können sich an den Best Practices für Data Warehouses orientieren. Das praktische Ziel ist die Wiederholbarkeit. Um 2 Uhr morgens sollte ein Ingenieur einem bekannten Entscheidungspfad folgen, anstatt nach undokumentierten Annahmen über Objektnamen und Aufbewahrung zu suchen.
Verwenden historischer Daten für Observability und Audits
Ein historischer Tabellenzustand beantwortet die Frage: „Was enthielt dieses Objekt damals?“ Observability stellt eine umfassendere Frage: „Wie haben sich die Daten im Laufe der Zeit verhalten, und wann wurde dieses Verhalten anormal?“ Diese Fragen greifen ineinander, sind aber nicht austauschbar.
Eine sinnvolle Untersuchung beginnt mit einem beobachteten Symptom. Eine Metrik fällt ab, ein Ladevorgang kommt zu spät an, eine Spalte ändert ihren Typ oder ein Gesamtwert weicht von seinem normalen Muster ab. Time Travel kann die zugrunde liegende Tabelle an einem relevanten Punkt untersuchen, während ein Observability-Protokoll zeigen kann, ob die Änderung isoliert war, sich wiederholte oder Teil eines größeren Pipeline-Problems war.
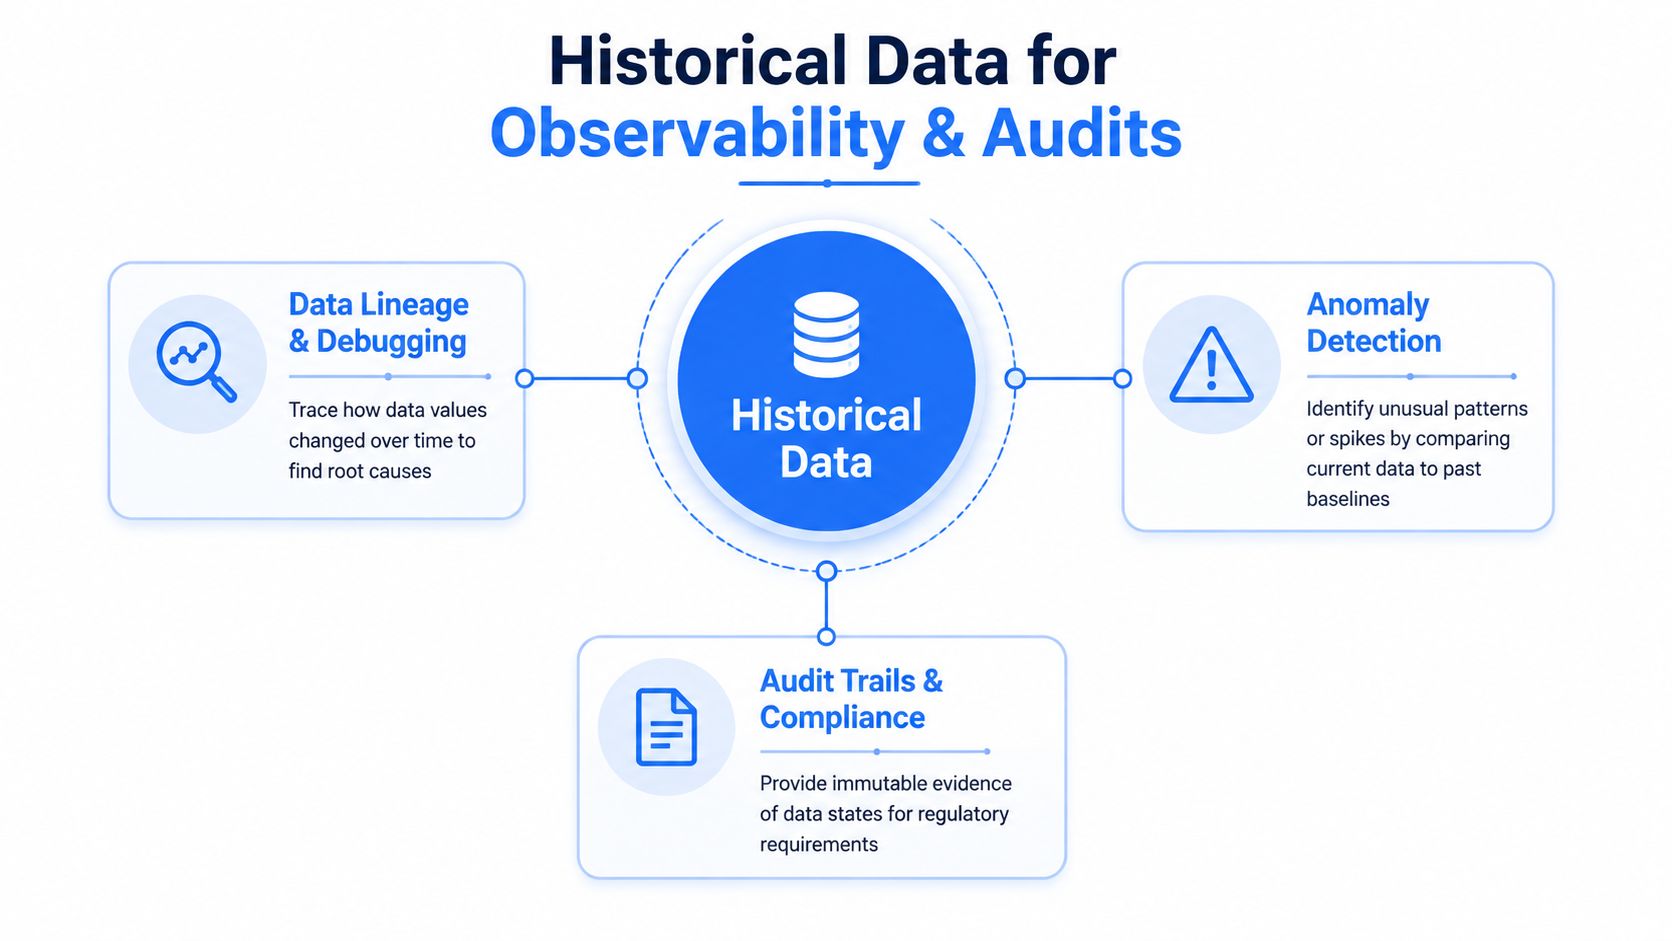
Kombinieren von Point-in-Time-Nachweisen mit kontinuierlichen Signalen
Der Workflow ist unkompliziert:
Erkennen: Ein Monitor meldet anomales Volumen, Verzögerungen (Timeliness), ungewöhnliche Schemata oder auffälliges Geschäftsverhalten.
Lokalisieren: Ingenieure identifizieren die betroffene Tabelle, Aufgabe, Anweisung und das ungefähre Änderungsfenster.
Vergleichen: Eine Time-Travel-Abfrage stellt den aktuellen Zustand einem historischen Zustand gegenüber.
Erklären: Lineage und Pipeline-Protokolle verknüpfen die Datenänderung mit einer vorgeschalteten Aktion.
Bewahren: Das Team speichert den Vorfallskontext und die Validierungsergebnisse in einem prüfsicheren Protokoll.
Snowflake stellt Clustering-Informationen über CLUSTERING_INFORMATION bereit, einschließlich average_overlaps, average_depth und partition_depth_histogram. Diese Metriken können Ingenieuren dabei helfen, festzustellen, ob ein schlechtes Pruning zu einer langsamen historischen Analyse beiträgt, aber ein Re-Clustering verursacht Kosten. Ein solider Workflow vergleicht die gescannten Partitionen mit den Gesamtpartitionen, ermittelt eine Baseline für die representative Abfragelaufzeit und prüft den Credit-Verbrauch in AUTOMATIC_CLUSTERING_HISTORY, bevor ein Clustering-Schlüssel beibehalten wird.
Auch der Abfrageverlauf hat seine eigenen Aufbewahrungsgrenzen. Die Kontonutzungsansicht QUERY_HISTORY bewahrt Datensätze für 1 Jahr oder 365 Tage auf, während entsprechende Information-Schema-Ansichten und Tabellenfunktionen kürzere Aufbewahrungsfristen von 7 Tagen bis zu 6 Monaten haben, wie in dieser Übersicht zu Snowflake Time Travel und Abfrageverlauf zusammengefasst. Dieser Unterschied ist bei Audits wichtig. Eine Tabelle kann historische Zeilen behalten, während die betrieblichen Beweise, die die Änderung erklären, bereits veraltet sind.
Eine Plattform für Data Observability kann Time Travel ergänzen, indem sie den Metrikverlauf bewahrt, erwartetes Verhalten erlernt, die Pünktlichkeit (Timeliness) verfolgt, Datensätze validiert und Schemaänderungen erkennt. Die Architektur sollte Beweise in der Kundenumgebung aufbewahren und rohe historische Zustände von abgeleiteten Überwachungssignalen unterscheiden. Diese Trennung bietet Auditoren sowohl den zugrunde liegenden Datenkontext als auch die betriebliche Geschichte darum herum.
Wann Time Travel im Vergleich zu externen Backups verwendet werden sollte
Time Travel is das richtige Werkzeug für die schnelle, lokale Wiederherstellung nach neueren Fehlern. Es ist in der Regel ein schlechter Ersatz für eine langfristige Backup-Richtlinie, insbesondere wenn das Unternehmen eine Historie über das konfigurierte Fenster hinaus, eine unabhängige Wiederherstellung oder Beweise benötigt, die Benutzer durch normale Warehouse-Operationen nicht ändern können.
Entscheidungsfaktor | Time Travel | Externes Backup |
|---|---|---|
Hauptzweck | Betriebliche Wiederherstellung und Analyse | Katastrophenwiederherstellung und langfristige Aufbewahrung |
Wiederherstellungsziel | Ein Tabellen-, Schema- oder Datenbankzustand | Eine separat gepflegte Kopie oder eine umfassendere Umgebung |
Historische Präzision | Point-in-Time-Zustand innerhalb der Aufbewahrung | Hängt vom Snapshot- oder Exportplan ab |
Betriebsgeschwindigkeit | Schnell für berechtigte Objekte | Kann Wiederherstellungs-, Übertragungs- und Validierungsarbeit erfordern |
Hauptbeschränkung | Aufbewahrung, Objekttyp und Plattformabhängigkeit | Speicher-, Orchestrierungs-, Test- und Verwaltungsaufwand |
Verwenden Sie Time Travel, wenn der Vorfall neu ist, das betroffene Objekt dafür infrage kommt und der Wiederherstellungsumfang eng begrenzt ist. Ein Klon reicht oft für Untersuchungen aus, während sich UNDROP für eine eindeutig versehentliche Löschung eignet, die schnell rückgängig gemacht werden muss.
Wählen Sie eine andere Schutzebene, wenn die Anforderungen über das Aufbewahrungsmodell von Snowflake hinausgehen. Dazu gehören die langfristige regulatorische Aufbewahrung, unveränderliche Beweise, umgebungsübergreifende Wiederherstellung oder der Schutz vor betrieblichen Fehlern auf Kontoebene. Permanente Objekte können nach Ablauf von Time Travel 7 Tage Fail-safe erhalten, transiente und temporäre Objekte erhalten diesen Schutz jedoch nicht, und Fail-safe ist für Benutzer nicht abfragbar. Der Wiederherstellungsplan muss diese Grenzen berücksichtigen, anstatt sie als gleichwertig mit einer externen Kopie zu behandeln.
Treffen Sie die Entscheidung anhand der Geschäftsanforderungen
Fragen Sie den Verantwortlichen für jeden kritischen Datensatz:
Wie weit muss die Wiederherstellung zurückreichen?
Muss die Kopie unabhängig kontrolliert werden?
Kann das Unternehmen eine Rekonstruktion aus Quellsystemen tolerieren?
Müssen Auditoren historische Aufzeichnungen direkt einsehen?
Welche Wiederherstellungsgeschwindigkeit ist für kundenorientierte Workflows erforderlich?
Native Replikation, verwaltete Exporte und Backup-Tools von Drittanbietern können jeweils unterschiedliche Lücken füllen. Das richtige Design kombiniert möglicherweise Time Travel mit kurzem Fenster für die sofortige Reparatur mit einem separat verwalteten Archiv für eine längere Aufbewahrung. Die Kosten liegen nicht nur im Speicherplatz. Sie umfassen betriebliche Tests, Zugriffskontrollen, Katalogisierung und die Zeit, die erforderlich ist, um nachzuweisen, dass eine Wiederherstellungskopie funktioniert.
Teams, die den umfassenderen Kontinuitätsplan verfeinern, können diesen praktischen Leitfaden zu DR für moderne Teams konsultieren. Für die Snowflake-Seite des Designs helfen Best Practices für die Datenverfügbarkeit, Verfügbarkeit als betriebliche Disziplin und nicht nur als einzelnen Wiederherstellungsbefehl zu verstehen.
digna hilft Datenteams, das Datenverhalten in Snowflake durch Anomalieerkennung, Timeliness-Überwachung, Datensatzvalidierung, Schema-Tracking und historische Analysen zu überwachen, während die Ausführung innerhalb der Kundenumgebung verbleibt. Besuchen Sie digna, um die Aufbewahrungs- und Wiederherstellungsplanung vor dem nächsten Produktionsvorfall mit kontinuierlicher Observability zu verbinden.
Häufig gestellte Fragen
Wie lange bewahrt Snowflake historische Daten auf?
Kürzer, als die meisten Teams annehmen. Der Standardzeitraum für Time Travel beträgt 1 Tag, während permanente Datenbanken, Schemata und Tabellen von 0 bis 90 Tagen konfiguriert werden können. Die 90 Tage sind ein konfigurierbares Maximum und nichts, was jede Tabelle automatisch hat.
Warum zerstört eine transiente Tabelle eine Wiederherstellung?
Weil Retention eine Kontrolle auf Objektebene ist und kein plattformweites Versprechen. Eine permanente Produktionstabelle kann den benötigten Zustand noch halten, während die transiente Staging-Tabelle, die sie speiste, ihre nutzbare Historie bereits verloren hat.
Was erfasst man vor jeder Wiederherstellung?
Die Vorfall-Zeitachse. Fragen Sie SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY für das betreffende Fenster ab, gefiltert auf query_start_time, und lesen Sie query_id, user_name, query_type, query_text und execution_status. Diese Sicht hat Latenz, kombinieren Sie sie also mit Orchestrierungs-Logs und Task-Historie.
Wie lautet die sichere Wiederherstellungsreihenfolge?
Zuerst den Schreiber stoppen: Pausieren Sie den fehlerhaften Task, die Pipeline oder das Deployment, bevor Sie etwas zurückspielen. Eine Wiederherstellung, während der schadenverursachende Job weiterläuft, erzeugt einen zweiten Vorfall über dem ersten.
Was fügt Fail-safe zu Time Travel hinzu?
Eine letzte Rückfallebene und keine zweite abfragbare Retention-Stufe. Time Travel ist das Fenster, das Ihr Team kontrolliert und direkt nutzt, deshalb hat ein Wiederherstellungsplan, der auf Fail-safe baut, den Bereich testbarer Kontrollen bereits verlassen.