Datensatz erstellen
|
8
min. Lesezeit

Sie können einen Datensatz bereitstellen, der in der Staging-Umgebung sauber aussieht, jeden Unit-Test besteht und dennoch zwei Wochen später das Geschäft lahmlegt. Ich habe das erlebt, als eine unbemerkt durchgeführte Zeitzonennormalisierung die Umsatzsummen in einem Dashboard veränderte und ein Marketing-Job weiterhin Null-Benutzer-IDs erfasste, weil beim Build-Prozess dieses Feld von nichts als kritisch eingestuft wurde. Das Schmerzhafte daran ist, dass das Team den Datensatz bereits als „fertig“ deklariert hatte.
Das ist der Fehler, den die meisten Anleitungen unberührt lassen. Die Arbeit am Create data set ist kein Meilenstein der Bereitstellung, sondern der erste Schritt in einem fortlaufenden Kontrollprozess. Genauso definiert das National Institute of Standards and Technology Datenqualität als eine Fähigkeit, die durch Zugänglichkeit, Relevanz, Timeliness, Metadaten, Dokumentation, Benutzerfähigkeiten, Kontext und Kosten geprägt ist, wobei Erstellung, Bewertung und Verbesserung eher einen Kreislauf als eine Ziellinie bilden (NIST-Perspektivpapier). In der Produktion ist der Datensatz erst dann real, wenn jemand die Verantwortung dafür übernimmt, ihn überwacht, versioniert und weiß, was zu tun ist, wenn er abweicht.
Inhaltsverzeichnis
Wenn ein fertiger Datensatz erst der Anfang ist
Das Team dachte, der Datensatz zu den Kundenereignissen sei solide. Er hatte typisierte Spalten, einen sauberen Build und die üblichen Null-Prüfungen, also veröffentlichten sie ihn und machten weiter. Zwei Wochen später bemerkte die Finanzabteilung Abweichungen bei den Umsatzsummen, und das Marketing stellte fest, dass ein Segmentierungsjob Datensätze mit fehlenden Benutzer-IDs akzeptiert hatte.
Die Ursache war nicht spektakulär. Eine Zeitzonennormalisierungsregel wurde upstream geändert, und niemand behandelte dies als eine bahnbrechende Änderung, da sich das Schema nicht geändert hatte. Gleichzeitig ließ der Datensatz Nullwerte in einem Feld zu, von dem nachgelagerte Konsumenten annahmen, es sei ein Pflichtfeld. So flossen die fehlerhaften Datensätze durch, bis ein Kampagnensegment größer aussah, als es hätte sein sollen. Das ist die Falle: Ein Datensatz kann syntaktisch korrekt und dennoch betrieblich falsch sein.
Das eigentliche Versagen lag in der Kontrolle, nicht in der Erstellung
Ein produktiver Datensatz benötigt mehr als einen erfolgreichen Build. Er benötigt Akzeptanzschwellenwerte, Drifterkennung, Eigenverantwortung und einen Rollback-Pfad, denn die Definition von „gut“ ändert sich, sobald echte Konsumenten davon abhängen. Diese Idee deckt sich mit der Realität in Unternehmen, dass schlechte Datenqualität teuer ist und laut weithin zitierter Branchenforschung nur ein kleiner Teil der Unternehmensdaten grundlegenden Qualitätsstandards entspricht (Gartner-Grafik und zugehörige Zusammenfassung).
Praktische Regel: Wenn ein nachgelagertes Dashboard, Modell oder Workflow unbemerkt fehlschlagen kann, ist der Datensatz noch nicht fertig.
Der Rest der Arbeit besteht darin, genau die Art von Fehlern zu verhindern, die nach dem Start auftreten. Eine Schutzmaßnahme hätte die Zeitzonenänderung abgefangen. Eine andere hätte die Null-Benutzer-IDs markiert, bevor das Marketing-Team sich darauf verließ. Der Rest dieses Artikels ist das Handbuch zur Vorbeugung.
Das Schema entwerfen, bevor Sie eine einzige Abfrage schreiben
Schemafehler sind teuer, weil sie sich schnell verfestigen. Sobald Teams anfangen, Daten um eine Tabelle herum zu laden und zu modellieren, wird die Änderung der Granularität oder die Neuinterpretation einer Spalte zu einem Migrationsprojekt und nicht zu einem einfachen Refactoring. Der sicherste Schritt ist, die Struktur vor dem ersten Extrakt festzulegen und die Entscheidungen dann zu dokumentieren, damit später niemand die Absicht rekonstruieren muss.
Starten Sie mit Granularität, Schlüsseln und Zeitsemantik
Wählen Sie die Granularität explizit. Wenn eine Zeile ein Benutzerereignis darstellt, geben Sie dies im Entwurfsdokument und in der Tabellenbeschreibung an, da diese Entscheidung die Deduplizierung, Aggregation und nachgelagerte Joins beeinflusst. Verwenden Sie Ersatzschlüssel, wo stabile natürliche Identifikatoren nicht garantiert sind, und legen Sie Zeitstempel auf UTC mit einem dokumentierten Quell-Offset fest, damit spätere Konsumenten die lokale Zeit ohne Raten rekonstruieren können.
Eine unsaubere user_events-Tabelle zeigt ihre Probleme meist in den Spaltennamen. Man sieht gemischte Groß-/Kleinschreibung, mehrdeutige Booleans wie is_active, Freitext-Werte für event_type, die in Fast-Duplikate abdriften, und Zeitstempel, deren Bedeutung sich ändert, je nachdem, wer sie geladen hat. Eine disziplinierte Version sieht auf die beste Art langweilig aus, mit Enums oder kontrollierten Kategorien für Ereignistypen, Nullable-Flags mit expliziter Bedeutung und stabilen IDs, die nicht davon abhängen, was die Upstream-App in dieser Woche gerade ausgegeben hat.
Verwenden Sie Namen, die dem realen Betrieb standhalten
Die Namensgebung im Warehouse und Lake sollte den Benutzern zeigen, wo sich eine Tabelle in der Pipeline befindet. Präfixe wie raw_, stg_ und dim_ machen das sichtbar. Das ist wichtig, wenn jemand verstehen möchte, ob eine Tabelle bereit für die Erfassung, Transformation oder den Konsum ist. Wenn Sie eine tiefere Taxonomie der strukturellen Optionen wünschen, ist der interne Leitfaden zu Schema-Typen ein nützlicher Referenzpunkt.
Dokumentieren Sie jede Spalte, bevor die erste Zeile eingespielt wird. Eine schema.yml-Datei oder Kommentare in information_schema zwingen das Team dazu, Typ, Bedeutung, zulässige Werte und die Eigenverantwortung anzugeben, solange der Entwurf noch leicht zu ändern ist.
Entscheidungsbereich | Anti-Pattern | Bereit für die Produktion |
|---|---|---|
Granularität | Implizit, später abgeleitet | Vor dem Build explizit deklariert |
Primärer Identifikator | Zusammengesetzter natürlicher Schlüssel aus instabilen Quellen | Ersatzschlüssel oder stabiler, dauerhafter ID |
Zeitstempel | Gemischte lokale Zeiten, kein Offset-Hinweis | UTC mit dokumentiertem Quell-Offset |
Booleans |
| Nullable-Flag mit schriftlich fixierter Semantik |
Ereignistypen | Freitext-Strings | Kontrollierte Kategorien oder Enum-ähnliche Werte |
Dokumentation | Nach dem Start hinzugefügt | Vor dem ersten Laden geschrieben |
Datenquellen erschließen, ohne die Provenienz zu verlieren
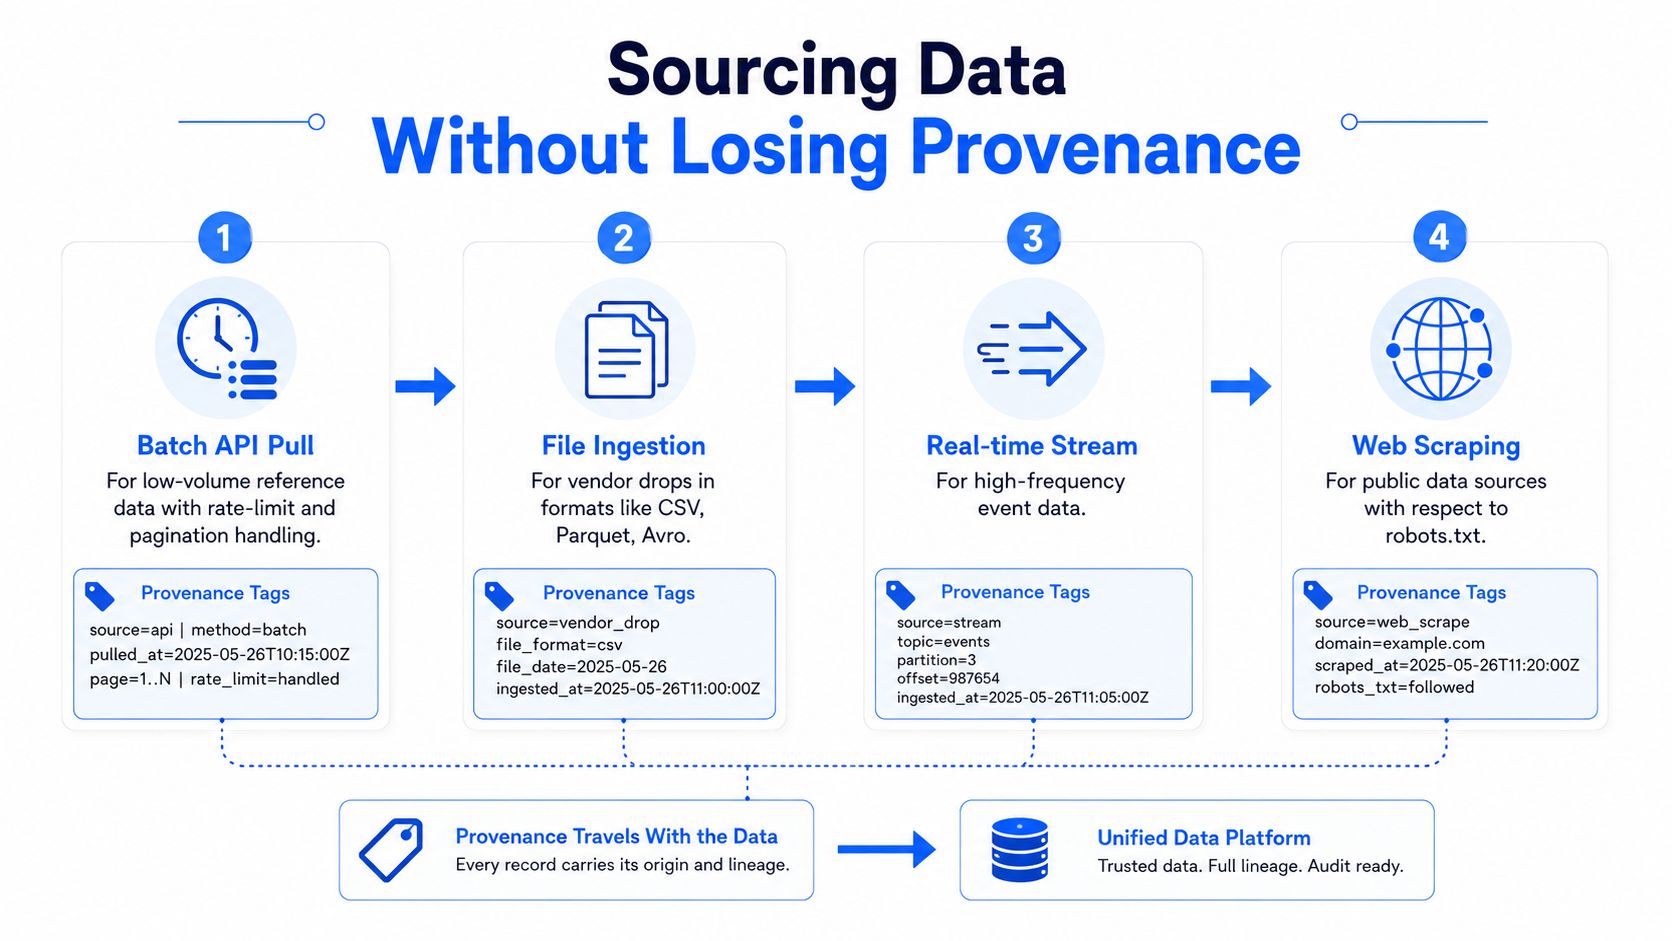
Die Quelle ist ebenso wichtig wie die Struktur. Ein Batch-API-Abruf, eine Dateiablage, CDC und synthetische Daten lösen jeweils ein anderes Problem und scheitern auf unterschiedliche Weise. Wenn Sie das falsche Quellen-Muster wählen, verbringen Sie Monate damit, fehlende Datenherkunft auszugleichen, anstatt den Datensatz zu verbessern.
Passen Sie die Erfassungsmethode an den Anwendungsfall an
Verwenden Sie Batch-API-Abrufe für Referenzdaten mit geringem Volumen, bei denen Paginierung und Ratenbegrenzungen die Haupteinschränkungen sind. Verwenden Sie die Dateierfassung für Lieferanten-Dateien in den Formaten CSV, Parquet oder Avro, wenn Schema-Verträge am wichtigsten sind, da Dateien die Versionierung und Wiedergabe leichter nachvollziehbar machen. Verwenden Sie Change Data Capture, wenn Sie nahezu in Echtzeit Warehouse-Ladungen aus operativen Datenbanken benötigen, und verwenden Sie synthetische Daten, wenn Sie Pipelines testen müssen, bevor Produktions-Feeds existieren.
Der wesentliche Teil ist die Provenienz. Erfassen Sie source_system, source_loaded_at, source_record_hash und ingestion_run_id zum Zeitpunkt des Einlesens, nicht erst später in der Transformationsschicht. Eine nachgelagerte Datenherkunft ist immer eine Rekonstruktion, und bei der Rekonstruktion fangen Teams an, eine Gewissheit zu erfinden, die sie nie hatten.
Schreiben Sie die Provenienz direkt beim Einlesen. Alles andere wird unter Druck zu einer Vermutung.
Für öffentliche Webquellen oder Scraping-Workflows gilt dieselbe Regel. Die Erfassungsmethode sollte erst gewählt werden, wenn Sie die Einschränkungen und Fehlermodi der vorgelagerten Systeme geprüft haben. Eine praktische Einführung in worauf man bei APIs achten sollte ist eine gute Erinnerung daran, dass Verfügbarkeit, Paginierung und das Verhalten von Verträgen den Datensatz ebenso prägen wie die Zeilen selbst. Wenn Sie die begriffliche Unterscheidung zwischen Herkunft und Provenienz wünschen, lohnt es sich, die interne Erklärung zu Datenprovenienz vs. Datenherkunft griffbereit zu haben.
Versionieren Sie den Vertrag, nicht nur die Daten
Externe APIs und Lieferanten-Feeds sollten wie Abhängigkeiten behandelt werden. Legen Sie die Vertragsversion fest, dokumentieren Sie, welche Felder erforderlich sind, und sorgen Sie dafür, dass eine Schemaänderung als sichtbarer Pull-Request erscheint, anstatt als unbemerktes Problem. Auf diese Weise sieht das Team die Abweichung, bevor die Pipeline sie aufnimmt, wenn ein Anbieter einen Feldnamen oder -typ ändert.
Validierungsprüfungen, die echte Probleme aufdecken
Ein Datensatz kann vollständig aussehen und dennoch in dem Moment scheitern, in dem ihn jemand verwendet. Null-Prüfungen erfassen nur eine Kategorie von Problemen. Fehlerhafte Verweise, Werte außerhalb des zulässigen Bereichs, verspätet eintreffende Zeilen und inkonsistente Schlüssel können dazu führen, dass eine Tabelle zwar technisch gefüllt, aber operativ unbrauchbar ist.
Validieren Sie zuerst auf Datensatzebene
Beginnen Sie mit den Prüfungen, die nachgelagerte Annahmen schützen. Nutzen Sie Eindeutigkeit bei natürlichen Identifikatoren, wo Duplikate Datensätze doppelt zählen würden, referenzielle Integrität zwischen Dimensions- und Faktschlüsseln, freigegebene Wertelisten für kategoriale Felder und Präzisionsregeln für Währungsspalten. Wenn ein Umsatzfeld immer zwei Dezimalstellen aufweisen muss, schreiben Sie das in die Regel, anstatt darauf zu vertrauen, dass jedes Quellsystem dies einhält.
Wiederverwendbare Sätze zulässiger Werte helfen hier, insbesondere für Länder, Bundesstaaten und Statuscodes. Wenn Sie eine Regelbibliothek aufbauen, folgt der Ansatz des Data-Validation-Moduls in digna diesem Muster, wobei die Prüfungen je nach Bedarf auf die Tabelle oder eine gefilterte Teilmenge angewendet werden. Der entscheidende Punkt ist nicht das Werkzeug, sondern die explizite Formulierung gängiger Regeln, anstatt sie in einmaligen Notebooks vergraben zu lassen.
Der Teil, den Sie nicht auslassen dürfen, ist die Provenienz. Erfassen Sie source_system, source_loaded_at, source_record_hash und ingestion_run_id direkt beim Einlesen, nicht erst später in der Transformationsschicht. Wenn diese Felder erst nach der Erfassung hinzugefügt werden, sind sie keine Fakten mehr, sondern werden unter Druck zu Vermutungen.
Fügen Sie Verteilungs- und Timeliness-Prüfungen hinzu
Sobald die Regeln auf Zeilenebene stabil sind, überwachen Sie die Tabelle als Ganzes. Zeilenanzahlen, die zu stark vom jüngsten Basiswert abweichen, Null-Raten, die in kritischen Feldern nach oben klettern, und eine schleichende Veränderung der kategorialen Kardinalität deuten auf Probleme hin, die eine Regel auf Zeilenebene übersehen würde. Setzen Sie für die Timeliness ein klares, an den Zweck der Tabelle gekoppeltes Service-Level-Ziel fest, wie etwa ein kurzes Verzögerungsfenster für Echtzeit-Feeds und ein längeres für Batch-Verarbeitungen.
Der schwierige Teil ist die Feinabstimmung. Anomalie-Basiswerte benötigen eine Aufwärmphase, bevor sie eine Aussagekraft haben, da ein brandneuer Datensatz noch keine stabile Struktur besitzt. Trennen Sie harte Fehler von weichen Warnungen, leiten Sie Warnungen zur Sichtung weiter und stellen Sie sicher, dass jede Prüfung einen Verantwortlichen, ein Runbook und einen Bypass-Pfad hat. Unbetreute Prüfungen verkommen zu Rauschen, und verrauschte Prüfungen werden nicht mehr gelesen.
Behandeln Sie Akzeptanzschwellenwerte als eine governance-Entscheidung, nicht als technisches Detail. Wenn ein Feed eine kleine Menge fehlender optionaler Daten tolerieren kann, aber keine fehlerhaften Schlüssel erlaubt, formulieren Sie das klar in den Prüfungen und im Freigabeprozess. Das verhindert, dass das Team über jede Warnung diskutiert, als ob alle Fehler das gleiche Gewicht hätten.
Validierungsebene | Beispielhafte Prüfung | Vorgeschlagener Schwellenwert | Verantwortlicher + Eskalation |
|---|---|---|---|
Datensatzintegrität | Eindeutigkeit des natürlichen Schlüssels | Keine Duplikate erlaubt | Data Engineering, Benachrichtigung bei Verletzung |
Beziehungsintegrität | Faktschlüssel entsprechen Dimensionsschlüsseln | Keine verwaisten Zeilen | Pipeline-Inhaber, fehlerhaften Batch unter Quarantäne stellen |
Wertebereich | Land, Status oder Enum-Liste | Nur freigegebene Werte | Domain-Inhaber, Sichtungswarteschlange |
Numerische Präzision | Währungspräzision | Erforderliche Dezimalpräzision | Analytics Engineer, Veröffentlichung blockieren |
Volumentrend | Drift der Zeilenanzahl | Innerhalb des normalen Basiswerts | Bereitschafts-Data-Engineer, Untersuchung einleiten |
Null-Stabilität | Null-Rate kritischer Spalten | Niedrig und stabil für die Tabelle | Datensatz-Inhaber, zuerst weiche Warnung |
Timeliness | Verzögerung zwischen Ereignis und Laden | Entspricht dem SLA des Feeds | Plattform-Inhaber, Benachrichtigung bei Überschreitung |
Für eine genauere Betrachtung, wie Prüfungen im Lebenszyklus eines Datensatzes zusammenpassen, siehe data validation rules, checks, and continuous data quality.
Partitioning, Versioning, und Schema Drift
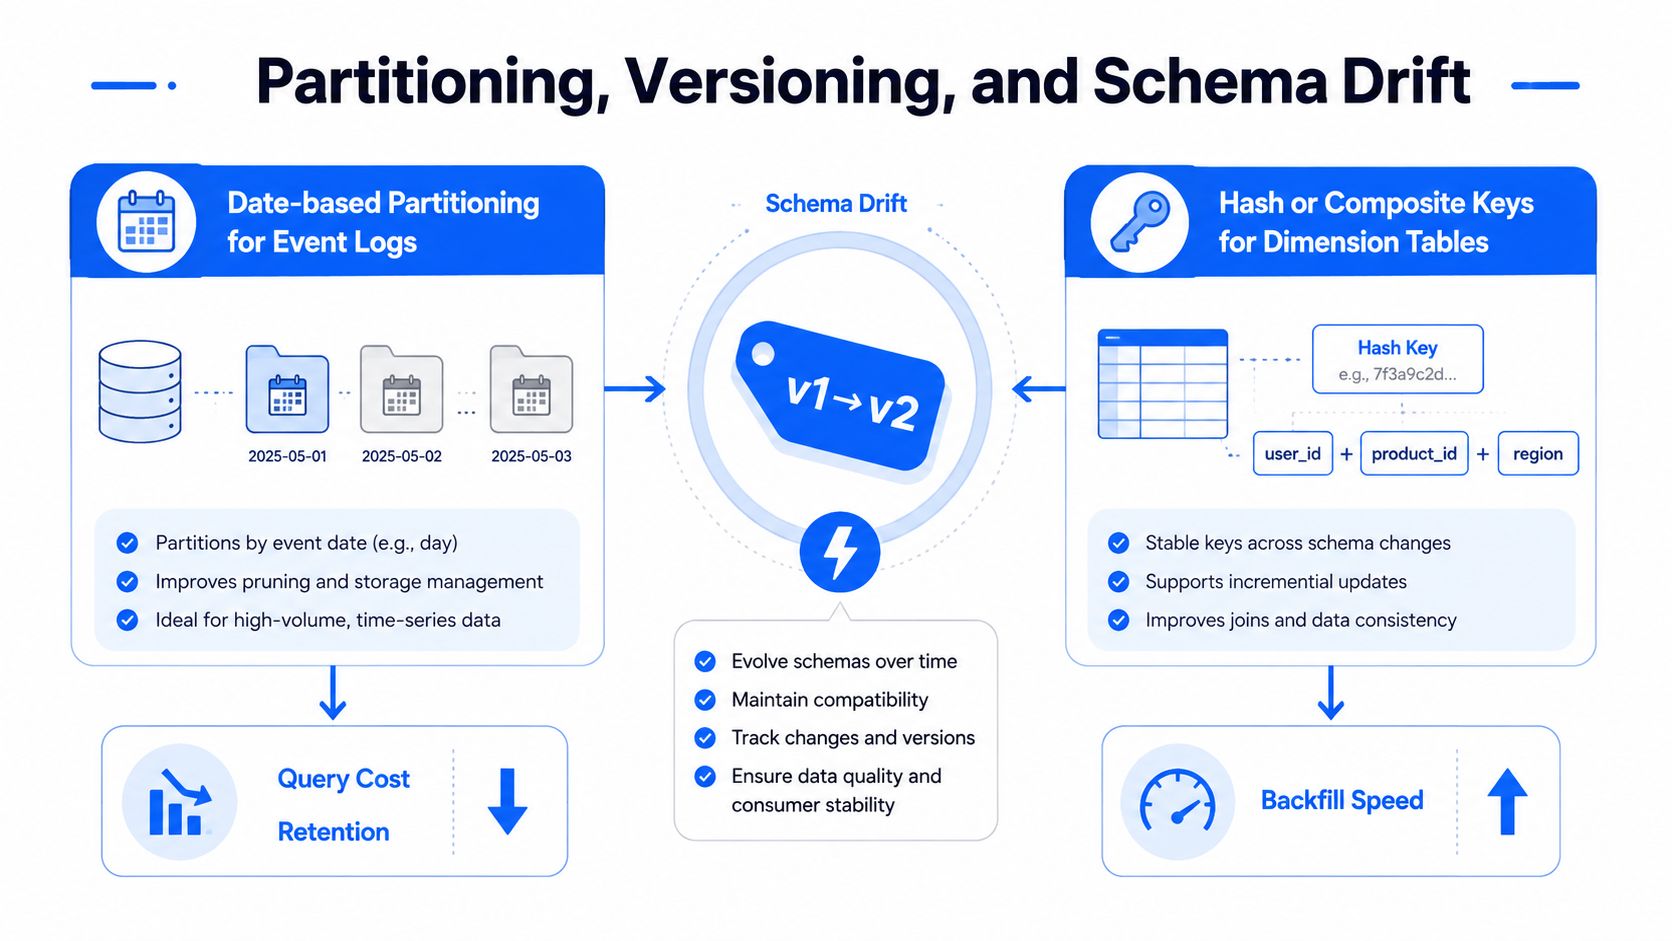
Die Partitionierung entscheidet über mehr als nur das Speicherlayout. Sie beeinflusst die Abfragekosten, die Geschwindigkeit von Backfills und wie leicht Aufbewahrungsregeln durchgesetzt werden können. Teams wählen oft ein Partitionierungsschema, um ein einzelnes Dashboard schneller zu machen, und stellen später fest, dass es die Wiederaufbereitung komplizierter macht oder historische Daten verbirgt, die sie noch benötigen.
Wählen Sie das Layout basierend auf der Tabellennutzung
Verwenden Sie eine datumsbasierte Partitionierung für Ereignisprotokolle und faktenreiche Tabellen, an die hauptsächlich Daten angehängt werden. Das gibt Ihnen eine saubere Einheit für die Aufbewahrung, inkrementelle Backfills und zeitlich begrenzte Abfragen. Für Dimensions-Snapshots oder sich langsam ändernde Strukturen können Hash- oder zusammengesetzte Schlüssel Suchvorgänge und Neuerstellungen vorhersagbarer machen, insbesondere wenn die Tabelle nicht von Natur aus nach Zeit organisiert ist. In Systemen wie BigQuery, Snowflake und Apache Iceberg unterscheidet sich die genaue Syntax, das operative Prinzip bleibt jedoch gleich.
Behandeln Sie den Datensatz vom ersten Tag an als versioniert. Semantische Versionen in den Metadaten, unveränderliche Tags pro Release und ein Deprecations-Fenster für alte Konsumenten verhindern, dass das Team so tut, als sei jedes Release austauschbar. Wenn sich eine Version ändert, sollte die alte verfügbar bleiben, bis die Konsumenten migriert sind, denn der schlechteste Zeitpunkt, eine Tabelle zu entfernen, ist, wenn ein Bericht noch darauf angewiesen ist.
Machen Sie Drift zu einem Pipeline-Fehler, nicht zu einer Überraschung
Schema Drift ist der stille Killer. Neue Spalten tauchen auf, erforderliche Spalten verschwinden und Datentypbreiten verringern sich gerade so weit, dass ein nachgelagerter Join oder Cast fehlschlägt. Das sauberste Muster ist eine tolerante Erfassung in der Landing-Zone, gefolgt von Profiling, strenger Validierung an der nächsten Grenze und Staging-Tests, die die Pipeline fehlschlagen lassen, wenn sich das Schema auf inkompatible Weise geändert hat.
Diese Logik gehört in den Code, nicht in einen Review-Kommentar in einem Notebook. Wenn eine Transformationsschicht die Schemaabweichung erkennen kann, kann sie den Rollout stoppen, bevor die Konsumenten überrascht werden. Eine versionierte Dokumentation und ein Änderungsprotokoll schließen den Kreis, indem sie dem nächsten Analysten erklären, warum die aktuelle Tabelle so aussieht, wie sie aussieht.
Ein praktischer Leitfaden zur Versionskontrolle für Compliance-Teams von DPP Grid ist hier nützlich, weil er Versionierung als ein governance-Problem darstellt und nicht nur als eine Gewohnheit bei der Datenspeicherung. Wenn Sie in der Produktion bereits mit Schema Drift zu tun haben, hilft die interne Erklärung zu Schema-Drift und strukturellen Änderungen, die Datenpipelines unterbrechen, die Fehlermodi konkret zu verstehen.
Governance und Auffindbarkeit vom ersten Tag an
Governance wird meist als abschließender Prüfungsschritt behandelt, aber eigentlich ist es ein Auffindbarkeitsproblem, an das Compliance gekoppelt ist. Wenn Personen nicht erkennen können, wofür ein Datensatz gedacht ist, wer ihn besitzt und welche Daten er enthält, werden sie ihn entweder falsch verwenden oder meiden. Beide Ergebnisse sind teuer.
Schreiben Sie die minimalen Metadaten vor der Veröffentlichung
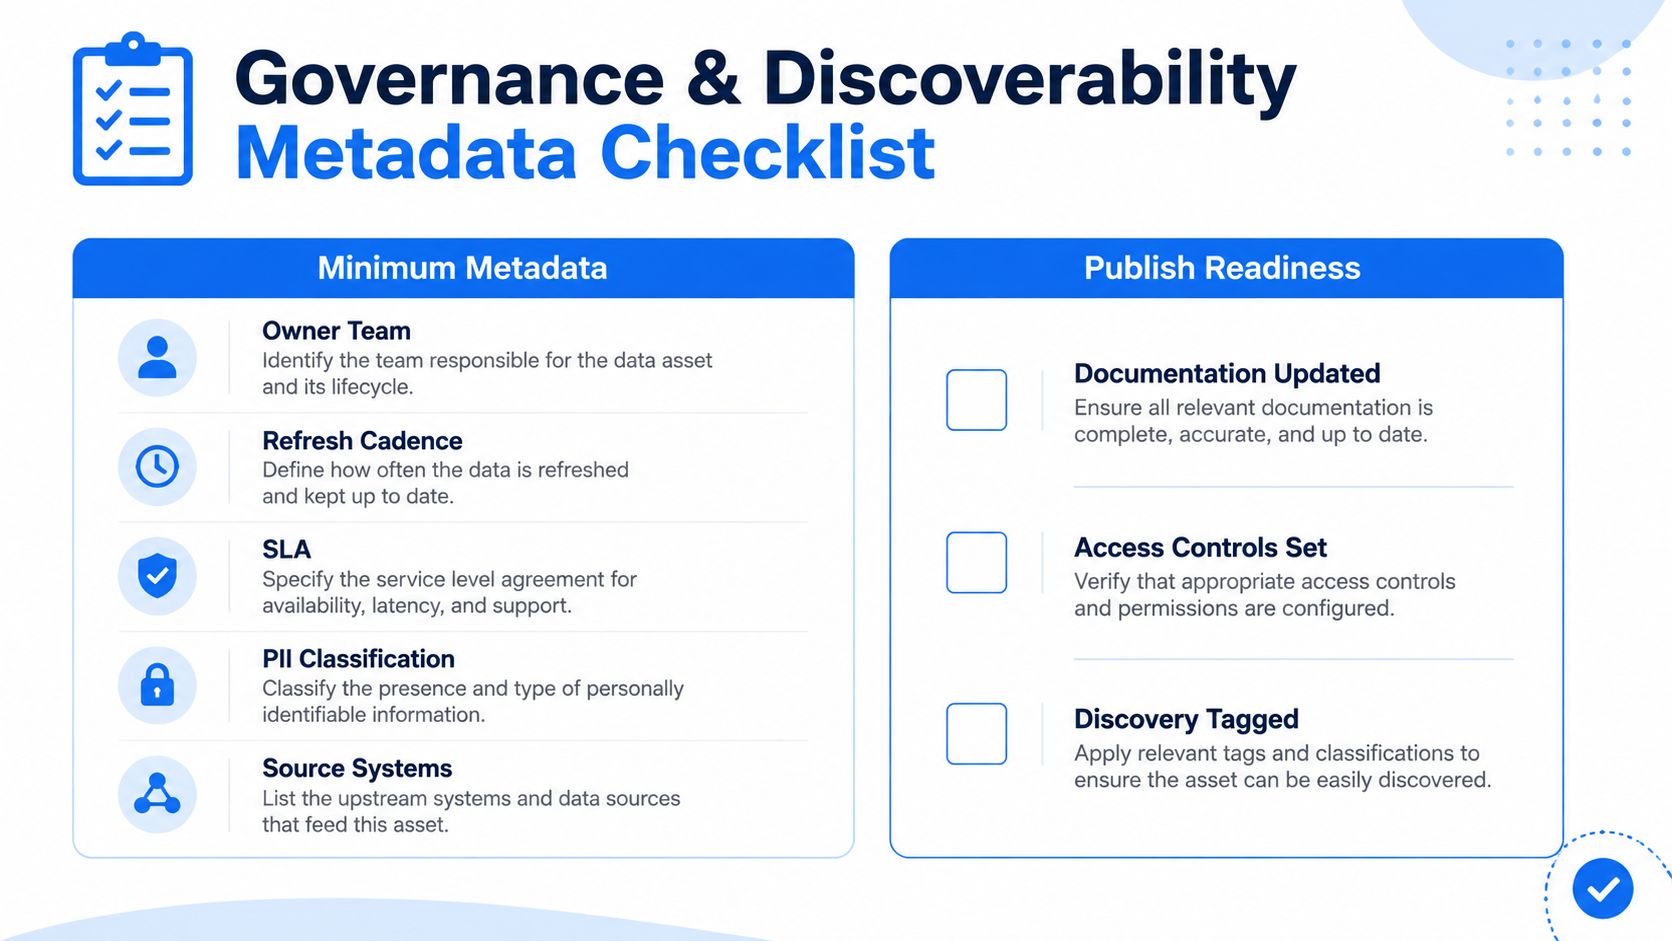
Jeder Datensatz sollte mit einem Inhaber-Team, einer Aktualisierungsfrequenz, einem SLA, einer PII-Klassifizierung, den Quellsystemen und einer kurzen Beschreibung des Verwendungszwecks ausgeliefert werden, die auch angibt, wofür der Datensatz nicht gedacht ist. Diese sechs Felder klingen simpel, weil sie es sind. Und diese Einfachheit sorgt dafür, dass die Tabelle nutzbar bleibt, wenn Audits, Übergaben und neue Konsumenten hinzukommen.
Verknüpfen Sie die Zugriffskontrollen mit der Klassifizierung. Maskieren Sie eingeschränkte PII, wenden Sie Richtlinien auf Zeilenebene an, wo regionale Regeln wichtig sind, und halten Sie Produktions- und Sandbox-Rollen getrennt, damit explorativer Zugriff nicht in die operative Nutzung einfließt. Wenn der Datensatz personenbezogene Daten enthält, wahren Sie die Einwilligungshistorie, indem Sie auf die Rechtsgrundlage und den Aufbewahrungsplan verweisen, der die Daten regelt.
Der Katalog ist der Ort, an dem all dies sichtbar wird. Die interne Übersicht darüber, was ein Datenkatalog ist, ist eine gute Erinnerung daran, dass Auffindbarkeit nur funktioniert, wenn Metadaten und Zugriffsrichtlinien aufeinander abgestimmt sind.
Machen Sie die Wiederverwendung sicher, nicht zufällig
Ein Datensatz, der leicht zu finden, aber schwer zu vertrauen ist, verursacht mehr Arbeit, nicht weniger. Das Ziel ist es, den Veröffentlichungsschritt erst dann als abgeschlossen zu betrachten, wenn der Datensatz getaggt, dokumentiert und der Richtlinien-Engine zugeordnet ist, die den Zugriff steuert. Auf diese Weise driften Klassifizierung und Berechtigungen im Laufe der Zeit nicht auseinander.
Wenn der Katalogeintrag vage ist, wird der Datensatz fehlerhaft wiederverwendet.
Deshalb ist die praktische Checkliste kurz: Inhaber, Klassifizierung, SLA, Verwendungszweck, Aktualisierung und Kontakt. Füllen Sie diese bei der Erstellung aus und Sie sparen sich später wochenlange Abstimmungen bei Audits.
Wann Ihr Datensatz gut genug ist
„Gut genug“ ist kein Gefühl, es ist ein Vertrag. Der Fehler besteht darin, auf eine perfekte Abdeckung zu warten, bevor der Datensatz in die Produktion gelassen wird, da dieser Reflex meist zu einer unendlichen Verzögerung führt. Es ist besser, die Hürde zu definieren und den Daten dann zu erlauben, sich ihren Weg hindurch zu verdienen.
Nutzen Sie an die Entscheidung gekoppelte Akzeptanzkriterien
Ein nützliches erstes Kriterium ist die Vollständigkeit. Wenn ein erforderliches Feld eine hohe Null-Rate aufweist, ist der Datensatz für die Entscheidung, die er unterstützen soll, nicht geeignet. Ein zweites Kriterium ist die Aktualität, da veraltete Daten zwar sauber, aber für den operativen Einsatz dennoch falsch sein können. Ein drittes Kriterium ist die Repräsentativität, die prüft, ob Schlüsselsegmente so stark verzerrt sind, dass sie ein nachgelagertes Modell oder einen Bericht verfälschen.
Prüfungen auf Verzerrungen (Bias Checks) gehören in dieses dritte Kriterium. Achten Sie auf Klassenungleichgewichte, geografische Lücken, demografische Lücken und das Überlebenden-Dilemma (Survivorship Bias) in zusammengeführten Quellen und entscheiden Sie dann, wie mit dem Ergebnis umgegangen wird. Einige Datensätze sollten so akzeptiert werden, wie sie sind, andere sollten überrepräsentiert oder ergänzt werden, manche sollten bestimmte Verwendungen ausschließen und wieder andere sollten von vornherein als unvollständig dokumentiert werden.
Akzeptanzkriterium | Metrik | Beispiel für Schwellenwert | Entscheidung bei Fehlschlag |
|---|---|---|---|
Vollständigkeit | Null-Rate bei erforderlichen Feldern | Niedrig genug für den Anwendungsfall | Veröffentlichung blockieren oder Backfill durchführen |
Aktualität | Aktualität im Vergleich zur Entscheidungslatenz | Innerhalb des zulässigen Zeitfensters | Anhalten bis zur Aktualisierung |
Repräsentativität | Segmentabdeckung über Schlüsselgruppen hinweg | Keine kritische Verzerrung | Überrepräsentieren, ausschließen oder dokumentieren |
Stabilität | Wiederholte Qualitätsergebnisse im Zeitverlauf | Besteht über mehrere Zyklen hinweg | Im Shadow-Modus belassen |
Fördern Sie in Phasen, nicht in einem einzigen Sprung
Der sauberste Rollout erfolgt schrittweise. Richten Sie zuerst Qualitätsmetriken ein, vergleichen Sie diese als Nächstes mit einem Kontroll-Datensatz und machen Sie den neuen Datensatz erst dann zum Standard, wenn er sich über mehrere Zyklen hinweg bewährt hat. Das hält das Team ehrlich in Bezug auf die Frage, ob die Daten wirklich bereit oder nur frisch erstellt sind.
Gut genug bedeutet, dass der Datensatz die Entscheidung unterstützt, ohne an anderer Stelle versteckte Ausgleichsmaßnahmen zu erzwingen.
Bei der Diskussion über das Erstellen eines Datensatzes geht es in Wirklichkeit um Kontrolle, nicht um das Sammeln. Wenn Sie eine Plattform suchen, die Validierung, Timeliness, Schemaänderungen und Anomalieverhalten innerhalb Ihrer Umgebung überwacht, übernimmt digna dies für Warehouse- und Pipeline-Daten, ohne die Daten an einen anderen Ort zu verschieben. Besuchen Sie digna, um zu sehen, wie sich das in einen Datensatz-Lebenszyklus einfügt, der Eigenverantwortung, Schwellenwerte und kontinuierliche Prüfungen erfordert – und nicht nur einen weiteren einmaligen Build.
Häufig gestellte Fragen
Wann ist ein Datensatz wirklich fertig?
Nicht dann, wenn er erfolgreich gebaut wurde. Wenn ein nachgelagertes Dashboard, Modell oder Workflow still scheitern kann, ist der Datensatz noch nicht fertig. Ein produktiver Datensatz braucht Kontrolle nach dem Start, nicht nur Konstruktion davor.
Was sollte man vor der ersten Abfrage entscheiden?
Granularität, Schlüssel und Zeitsemantik, denn Schemafehler verhärten schnell und werden teuer. Legen Sie die Granularität explizit fest, statt sie entstehen zu lassen, und wählen Sie Namen, die den Betrieb überstehen, denn eine nachlässige Event-Tabelle zeigt ihre Probleme meist zuerst in den Spaltennamen.
Warum brechen Datensätze Wochen nach dem Start?
Weil die Ursache meist Kontrolle und nicht Konstruktion ist. Der Build bestand jeden Unit-Test und wirkte im Staging sauber, und danach passierte nichts Dramatisches; es fehlte schlicht ein Weg zu bemerken, dass sich die Daten nicht mehr so verhalten, wie das Schema nahelegt.
Welche Kontrollen gehören von Tag eins an dazu?
Validierung, Partitionierungsdisziplin und Governance-Kontext, dazu Monitoring für die Fehlermodi, die leise bleiben. Sie nach einem Vorfall zu ergänzen ist stets teurer als sie einzuplanen, denn dann treffen bereits Konsumenten Entscheidungen auf dieser Basis.
Wie viele Unternehmensdaten erfüllen tatsächlich Qualitätsstandards?
Nur ein kleiner Anteil, so vielzitierte Branchenforschung, neben Gartners Schätzungen zu den Kosten mangelhafter Datenqualität. Die praktische Lesart ist nicht, dass die meisten Daten unbrauchbar sind, sondern dass die meisten nie an einem ausgesprochenen Standard gemessen wurden.



