Datenqualitätsaudit: ein verlässliches Audit durchführen
|
9
min. Lesezeit

Um ein Datenaudit werden Sie meist nicht gebeten, wenn alles ruhig ist.
Es beginnt, wenn ein Dashboard nicht mehr zur Buchhaltung passt, eine Aufsichtsbehörde fragt, wie eine Zahl entstanden ist, oder ein Modell sich nach einer undokumentierten Änderung im Quellsystem seltsam verhält. Dann merken Teams, dass sie Stichproben gemacht haben und kein Datenqualitätsaudit. Sie können sagen, eine Tabelle habe „letzte Woche gut ausgesehen“, aber nicht zeigen, welche Kriterien galten, welche Nachweise gesammelt wurden, wer das Ergebnis geprüft hat oder ob dieselbe Kontrolle nächsten Monat zum selben Schluss käme.
Diese Lücke wiegt schwerer, als viele erwarten. Eine einmalige Abfrage kann einen Fehler finden. Ein Audit muss standhalten, wenn jemand einen Nachweis verlangt.
Inhaltsverzeichnis
Warum Datenqualitätsaudits zählen, bevor Sie den ersten Datensatz prüfen
Was Teams tatsächlich von einem Audit brauchen
Was ein vollständiges Audit liefert
Den Prüfumfang festlegen und inventarisieren, was wirklich geprüft werden muss
Beginnen Sie bei der Eignung für den Verwendungszweck
Bauen Sie das Inventar vom Ergebnis rückwärts auf
Setzen Sie Grenzen, bevor jemand etwas testet
Dokumentieren Sie Lineage, solange das System noch frisch im Gedächtnis ist
Die richtigen Prüfungen wählen und entscheiden, wie getestet wird
Beginnen Sie mit Dimensionen und machen Sie daraus Kontrollen
Stichprobe, Vollscan und kontinuierliche Überwachung haben jeweils ihren Platz
Pilotieren Sie die Prüfungen, bevor Sie sie als Nachweis behandeln
Das Audit durchführen und belastbare Nachweise sichern
Führen Sie so nah wie möglich an den Daten aus
Behandeln Sie Lineage und Nachvollziehbarkeit als Nachweis, nicht als Dekoration
Erfassen Sie auch Beinahe-Fehler und Quelländerungen
Aus Feststellungen Korrekturen machen, mit klarer Verantwortung und Nachverfolgung
Der Bericht muss mehr leisten, als Mängel zusammenzufassen
Verantwortung nach Kontrollpunkt zuweisen, nicht nach Schuld
Bis zum Abschluss verfolgen, mit Verifikation statt bloßem Status
Audits wiederholbar und bereit für kontinuierliche Überwachung machen
Halten Sie den Auditzyklus klein und nachweisreich
Achten Sie auf die Fehlermuster, die Audits immer wieder aufdecken
Skalieren Sie durch Standardisierung des Kontrollmodells
Warum Datenqualitätsaudits zählen, bevor Sie den ersten Datensatz prüfen
Der Druckmoment ist vertraut. Eine Stakeholderin will wissen, ob ein Bericht vertrauenswürdig ist, und der Reflex ist, sofort in Zeilenzahlen, Null-Prüfungen und Dubletten zu springen. Das ist nützlich, aber noch kein Audit. Wenn Sie die Kriterien nicht vorher festlegen, bleibt technische Betriebsamkeit ohne belastbaren Schluss.
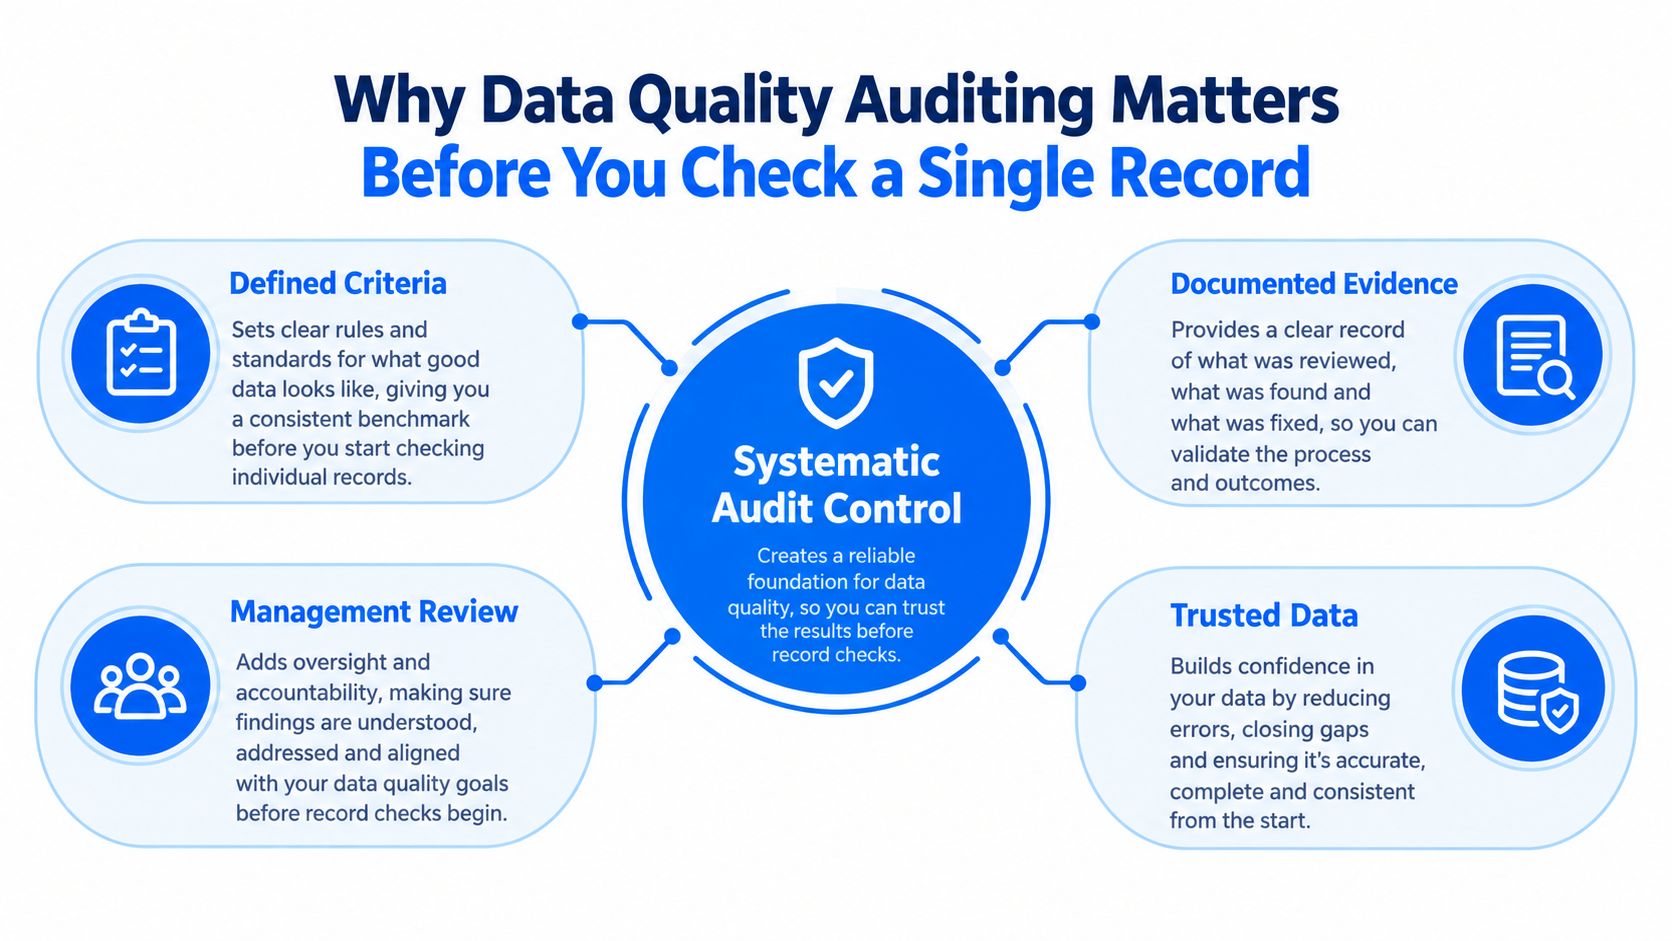
Dafür gibt es einen tragfähigen Standard. ISO definiert ein Audit als „systematischen, unabhängigen und dokumentierten Prozess“, um Nachweise zu erlangen und sie gegen Kriterien zu bewerten, was die Grundlage wiederholbarer Datenqualitätsaudits über Branchen und Verwaltungen hinweg bildet, wie im Handbuch von UN und Eurostat zu Methoden und Werkzeugen der Datenqualitätsbewertung zusammengefasst. Diese Definition ist praktischer, als sie klingt. Sie sagt Ihnen, was ein echtes Audit belegen muss:
Systematisch heißt, die Prüfungen sind nicht improvisiert.
Unabhängig heißt, die Feststellungen halten einer Prüfung außerhalb des liefernden Teams stand.
Dokumentiert heißt, jemand anderes kann die Nachweise später einsehen und zum selben Schluss kommen.
Was Teams tatsächlich von einem Audit brauchen
In der Praxis ist der erste Gewinn eine gemeinsame Sprache. Auditprogramme im öffentlichen Sektor ordnen Feststellungen üblicherweise nach Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit. Diese Dimensionen sind nicht akademisch. Sie beenden den üblichen Streit, in dem Engineering sagt „die Pipeline lief erfolgreich“, die Finanzabteilung sagt „der Bericht ist falsch“ und Compliance sagt „die Daten kamen zu spät“.
Ein Team, das nach Dimensionen prüft, kann unterschiedliche Fehlermuster trennen:
Genauigkeit fragt, ob der Wert die Sache abbildet.
Vollständigkeit fragt, ob erwartete Datensätze oder Felder fehlen.
Timeliness fragt, ob die Daten rechtzeitig für die Entscheidung eintrafen.
Konsistenz fragt, ob derselbe Sachverhalt über Systeme hinweg übereinstimmt.
Gültigkeit fragt, ob Werte Regel und Format entsprechen.
Eindeutigkeit fragt, ob eine Entität genau einmal auftaucht, wenn sie es soll.
Wenn Ihre Organisation diese noch als abstrakte Qualitätsetiketten behandelt, hilft es, sie damit zu verbinden, warum Datenqualität für eine Organisation wichtig ist. Jede Vertrauensfrage der Geschäftsleitung landet am Ende bei einer dieser Dimensionen.
Was ein vollständiges Audit liefert
Ein vollständiges Audit endet nicht mit „wir haben schlechte Zeilen gefunden“. Dasselbe Handbuch von UN und Eurostat betont, dass Auditschlüsse in einem Bericht zusammengefasst, vom Management geprüft und in einen Maßnahmenplan überführt werden sollten. Genau diese Regelschleife überspringen viele Teams.
Praktische Regel: Wenn das Ergebnis der Arbeit nur eine Tabelle mit Mängeln ist, haben Sie eine Inspektion durchgeführt. Wenn das Ergebnis Nachweise, Schlüsse, Prüfung und Korrekturmaßnahmen sind, haben Sie ein Audit durchgeführt.
Diese Unterscheidung erklärt, warum Datenqualitätsaudits zählen, bevor jemand den ersten Datensatz prüft. Der Auditrahmen bestimmt, was als Nachweis gilt, was Scheitern bedeutet, wer abzeichnet und was danach passiert. Ohne ihn liefern selbst gute technische Prüfungen keine vertrauenswürdigen Ergebnisse.
Den Prüfumfang festlegen und inventarisieren, was wirklich geprüft werden muss
Ein schwaches Audit scheitert meist, bevor das Testen beginnt. Der Umfang ist vage, die Verantwortlichen sind unklar, und die Hälfte der Daten im Bericht steht nicht einmal im Inventar. Teams verschwenden dann Zeit mit Spalten, die nicht zählen, und übersehen genau die Transformation, die die Entscheidung trägt, um die es allen geht.
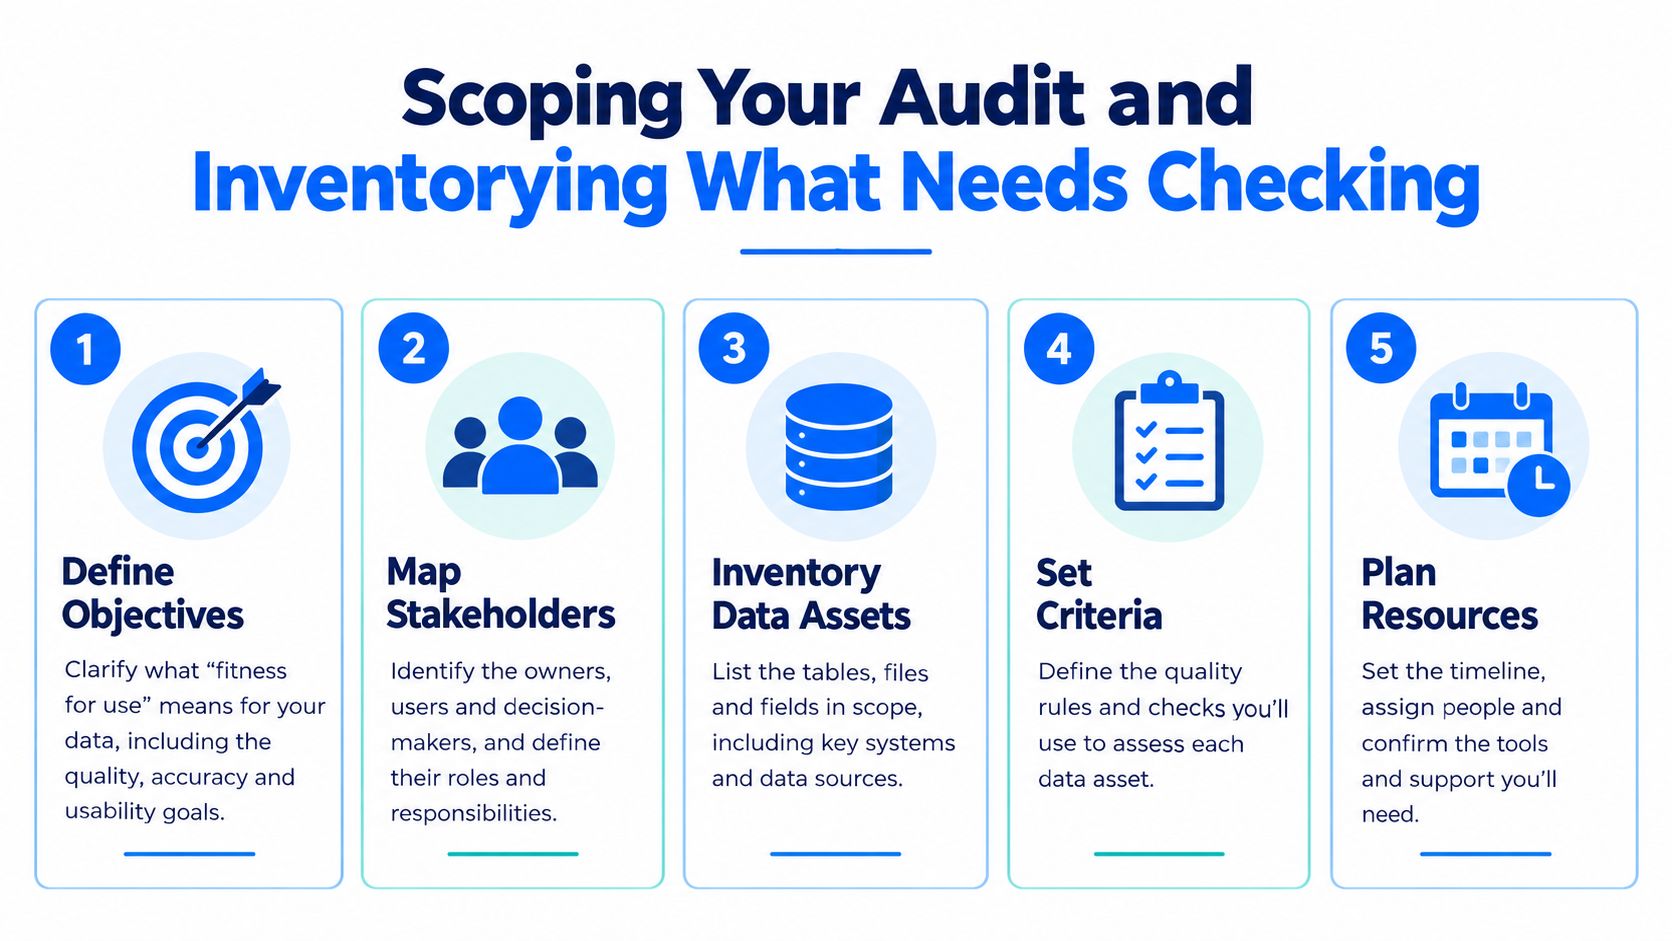
Die erste Disziplin ist einfach. Legen Sie den Prüfumfang um den beabsichtigten Verwendungszweck herum fest und nicht um die Tabellen, die am leichtesten zugänglich sind.
Beginnen Sie bei der Eignung für den Verwendungszweck
Die Datenqualitätsarbeit des NIST betont, dass Qualität kontextabhängig ist und am beabsichtigten Zweck gemessen werden sollte, nicht an einer abstrakten Universalnote, wobei Qualität als Eignung für den Verwendungszweck definiert und an Geschäftsanforderungen gebunden wird, wie in der NIST-orientierten Diskussion zu Kontext und Bewertung von Datenqualität. Das heißt: Ein Datensatz kann ein Audit bestehen und ein anderes nicht bestehen, wenn sich der Entscheidungskontext ändert.
Eine regulatorische Meldung etwa braucht andere Kriterien für Vollständigkeit und Nachvollziehbarkeit als ein internes Leistungs-Dashboard. Ein Trainingsdatensatz für ein Modell verträgt womöglich etwas Verzögerung, aber keine falsch etikettierten Klassen. Ein operativer Kundenfeed braucht vielleicht strikte Frische, selbst wenn einige Anreicherungsfelder optional sind.
Bevor Sie Assets auflisten, halten Sie drei Dinge fest:
Die Geschäftsentscheidung oder Pflicht, die die Daten stützen.
Das konkrete Ergebnis, dem vertraut oder das angezweifelt wird.
Die Folge des Scheiterns, wenn die Daten zu spät, falsch, unvollständig oder strukturell verändert sind.
Bauen Sie das Inventar vom Ergebnis rückwärts auf
Beginnen Sie nicht mit dem Warehouse-Katalog und hoffen, dass Relevanz auftaucht. Beginnen Sie mit dem Bericht, dem Dashboard, dem Feature-Set eines Modells oder dem Meldeartefakt und verfolgen Sie dann rückwärts zu Quelltabellen, Joins, Transformationen, Referenzdaten und Lieferjobs.
Ein brauchbares Inventar enthält mehr als Tabellennamen:
Kritische Ergebnisse wie Berichte, Modelle, Alarme oder externe Meldungen.
Vorgelagerte Assets einschließlich Quelltabellen, Staging-Schichten, Transformationslogik und fachlicher Referenztabellen.
Operative Abhängigkeiten wie Zeitpläne, Lieferzusagen und nachgelagerte Konsumenten.
Benannte Verantwortliche für Quelldaten, Transformationslogik und fachliche Abnahme.
Für Teams, die das formalisieren wollen, ist eine definierte Liste kritischer Datenelemente meist der schnellste Weg, Scope Creep zu stoppen. Nicht jeder Datensatz verdient dieselbe Prüftiefe. Jene, die regulierte Berichterstattung, Kundenentscheidungen, Finanzbuchungen oder produktive KI tragen, verdienen sie in der Regel.
Setzen Sie Grenzen, bevor jemand etwas testet
Die meiste Reibung im Audit entsteht durch Grenzfehler. Ein Team sagt, die „Kundenumsatz-Pipeline“ sei im Umfang, doch niemand sagt, ob das Extrakte aus Quellsystemen, Anreicherungslogik, langsam veränderliche Dimensionen, manuelle Übersteuerungen oder Ausnahmebehandlung einschließt.
Nutzen Sie ausdrückliche Grenzen wie diese:
Bereich | Was zu definieren ist |
|---|---|
Fachliche Grenze | Welche Entscheidung, welcher Bericht, welche Meldung oder welches Modell abgedeckt ist |
Datengrenze | Welche Datensätze, Felder und Zeiträume einbezogen sind |
Prozessgrenze | Welche Transformationen, Zeitpläne und Übergaben einbezogen sind |
Verantwortungsgrenze | Wer Regeln genehmigt, wer behebt, wer abzeichnet |
Der Prüfumfang sollte eng genug sein, um ihn zu bewältigen, und breit genug, um die Zahl am Ende zu erklären.
Dokumentieren Sie Lineage, solange das System noch frisch im Gedächtnis ist
Lineage-Dokumentation wird aufgeschoben, weil Teams annehmen, sie später rekonstruieren zu können. Meist geht das nicht. Die Person, die weiß, warum ein Fallback-Join existiert, geht, oder die Notlösung von vor sechs Monaten wird zum unsichtbaren Normalverhalten.
Erfassen Sie beim Inventarisieren:
woher jedes kritische Feld stammt
welche Transformation es erzeugt oder verändert
ob eine manuelle Anpassung existiert
welcher Zeitplan oder welches Ereignis es liefert
wer bemerken soll, wenn es ausbleibt
Dieses Inventarniveau wirkt nur bis zur ersten Prüfbesprechung schwerfällig. Dann ist es der Unterschied zwischen einer kurzen Untersuchung und einer Woche Rätselraten.
Die richtigen Prüfungen wählen und entscheiden, wie getestet wird
Sobald der Umfang steht, ist der nächste Fehler, Prüfungen aus Gewohnheit zu wählen. Teams greifen oft zu Null-Anteilen, Dublettenzahlen und ein paar Regex-Regeln, weil sich das leicht skripten lässt. Für Grundhygiene ist das in Ordnung. Für ein belastbares Audit reicht es nicht.
Sie brauchen Prüfungen, die zum Auditziel passen, und einen Testansatz, der zu Risiko, Volumen und Änderungsrate der Daten passt.
Beginnen Sie mit Dimensionen und machen Sie daraus Kontrollen
Das in der Unternehmens-Governance verbreitete DAMA-Rahmenwerk für Datenqualität benennt sechs Kerndimensionen: Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Eindeutigkeit und Gültigkeit; dasselbe Material definiert Timeliness operativ als die Frage, ob Daten frisch genug für die Nutzung sind, mit Beispielprüfungen als messbaren Schwellen wie einer Zeit seit der letzten Aktualisierung unterhalb eines gewählten Limits, etwa weniger als eine Stunde seit der Ingestion, wie in dieser Übersicht zu Datenqualitätsdimensionen und operativen Prüfungen beschrieben.
Das zählt, weil es unscharfe Erwartungen in prüfbare Kontrollen verwandelt. „Daten sollen aktuell sein“ ist nicht auditierbar. „Diese Tabelle muss sich innerhalb der vereinbarten Frischeschwelle für den Berichtslauf aktualisieren“ ist es.
Hier ein kompakter Weg zur Auswahl.
Auditziel | Empfohlene Prüfungen | Testansatz |
|---|---|---|
Regulatorisches oder Management-Reporting | Vollständigkeit, Genauigkeit, Timeliness, Abstimmungsprüfungen | Vollscans für Schlüsselfelder und -datensätze, dazu geplante Timeliness-Überwachung |
Kunden- oder Entitätsstammdaten | Eindeutigkeit, Gültigkeit, systemübergreifende Konsistenz | Vollständige Dublettenerkennung für Kernidentifikatoren, gezielte Regelprüfungen auf kritischen Attributen |
Schnelllebige operative Dashboards | Timeliness, Schemastabilität, Anomalien im Satzvolumen | Kontinuierliche Überwachung mit Schwellen- und Driftprüfungen |
Modell-Features oder KI-Eingabedatensätze | Gültigkeit, Vollständigkeit, Konsistenz von Labels oder Attributen | Kontinuierliche Prüfungen kritischer Felder, periodisch tiefere Durchsicht repräsentativer Ausschnitte |
Neu angebundene Quellsysteme | Formatgültigkeit, Null-Muster, referenzielle Konsistenz | Zuerst Pilottests, dann breitere Ausführung, sobald sich Muster stabilisieren |
Stichprobe, Vollscan und kontinuierliche Überwachung haben jeweils ihren Platz
Stichproben funktionieren weiterhin, wenn Datenmengen groß und der Prozess stabil ist, doch sie versagen, wenn Schemata sich häufig ändern oder ein seltener Fehler große Wirkung hat. Vollscans sind stärker für deterministische Regeln auf kritischen Daten, besonders in modernen Warehouses, wo die Ausführung in der Datenbank praktikabel ist. Kontinuierliche Überwachung ist die richtige Wahl, wenn späte Ladevorgänge, struktureller Drift oder operative Änderungen zwischen formalen Auditzyklen Vertrauen zerstören können.
Auch unabhängige Auditrahmenwerke stützen den Gedanken, dass die Methodenwahl zählt. Die in der FAO-Systematik zusammengefasste neuere Literatur beschreibt vier übergeordnete Ansätze und 15 unterschiedliche Methoden, was daran erinnert, dass reifes Auditieren Methodenauswahl ist und keine feste Checkliste, wie im FAO-Material zu Methoden der Datenqualitätsbewertung dargelegt.
Einige Abwägungen tauchen immer wieder auf:
Stichproben sind leichter, wenn Datensätze manuell teuer zu prüfen sind, doch sie fangen nicht jeden Sonderfall.
Vollscans sind stärker für Vollständigkeit, Gültigkeit, Eindeutigkeit und deterministische Geschäftsregeln.
Kontinuierliche Kontrollen sind nötig, wenn Frische und Schemaänderungen nachgelagerte Ergebnisse zwischen geplanten Prüfungen entwerten können.
Pilotieren Sie die Prüfungen, bevor Sie sie als Nachweis behandeln
Einer der häufigsten Fehler in Audits ist schlechtes Testdesign. Leitlinien für klinische Audits benennen unvollständige oder unrichtige Aufzeichnungen als wiederkehrende Falle und empfehlen Pilottests vor der Erhebung, das Bereinigen von Daten beim Eintreffen, das Erkennen von Verzerrungsmustern wie systematisch ausgeschlossenen Datensätzen und das Überarbeiten von Formularen oder Protokollen, wenn sich Fehler wiederholen, wie in derselben FAO-Auditreferenz zusammengefasst.
Das ist auch guter Engineering-Rat. Pilotieren Sie Ihre Prüfungen auf einem kleineren, aber repräsentativen Ausschnitt, bevor Sie sie im großen Maßstab laufen lassen. Sie entdecken falsche Annahmen schnell:
eine Gültigkeitsregel, die bei alten, aber akzeptierten Werten scheitert
eine Dublettenregel, die Historientabellen mit Bestandstabellen verwechselt
eine Timeliness-Regel, die bekannte Geschäftskalender ignoriert
ein Vollständigkeitstest, der absichtlich dünn besetzte Felder für Mängel hält
Für praktische Beispiele zu Regelentwurf und dauerhafter Durchsetzung ist dieser Leitfaden zu Validierungsregeln, Prüfungen und kontinuierlicher Datenqualität nützlich, weil er nah an der Umsetzung bleibt statt an der Theorie.
Eine Prüfung ist nicht gut, weil sie läuft. Sie ist gut, weil eine Prüferin sehen kann, warum es sie gibt, was Scheitern bedeutet und ob die Schwelle zum fachlichen Zweck passt.
Das Audit durchführen und belastbare Nachweise sichern
Bei der Durchführung werden viele Audits brüchig. Die Prüfungen laufen, Feststellungen erscheinen, und dann kann niemand die Grundfragen der Durchsicht beantworten: Welche Version der Regel lief? Gegen welchen Datenzustand? Kam die Quelle zu spät? Hat sich das Schema vor dem Fehler geändert? War das ein Einzelfehler oder Folge einer bekannten vorgelagerten Änderung?
Deshalb zählt der Entwurf der Nachweise genauso wie der Testentwurf.
Führen Sie so nah wie möglich an den Daten aus
Für die meisten Warehouse- und Lake-Umgebungen ist das sauberste Muster, Prüfungen in der Datenbank auszuführen. Das reduziert Bewegung, wahrt Sicherheitsgrenzen und vermeidet das Nebenproblem, für die Auditarbeit noch eine Kopie sensibler Daten anzulegen.
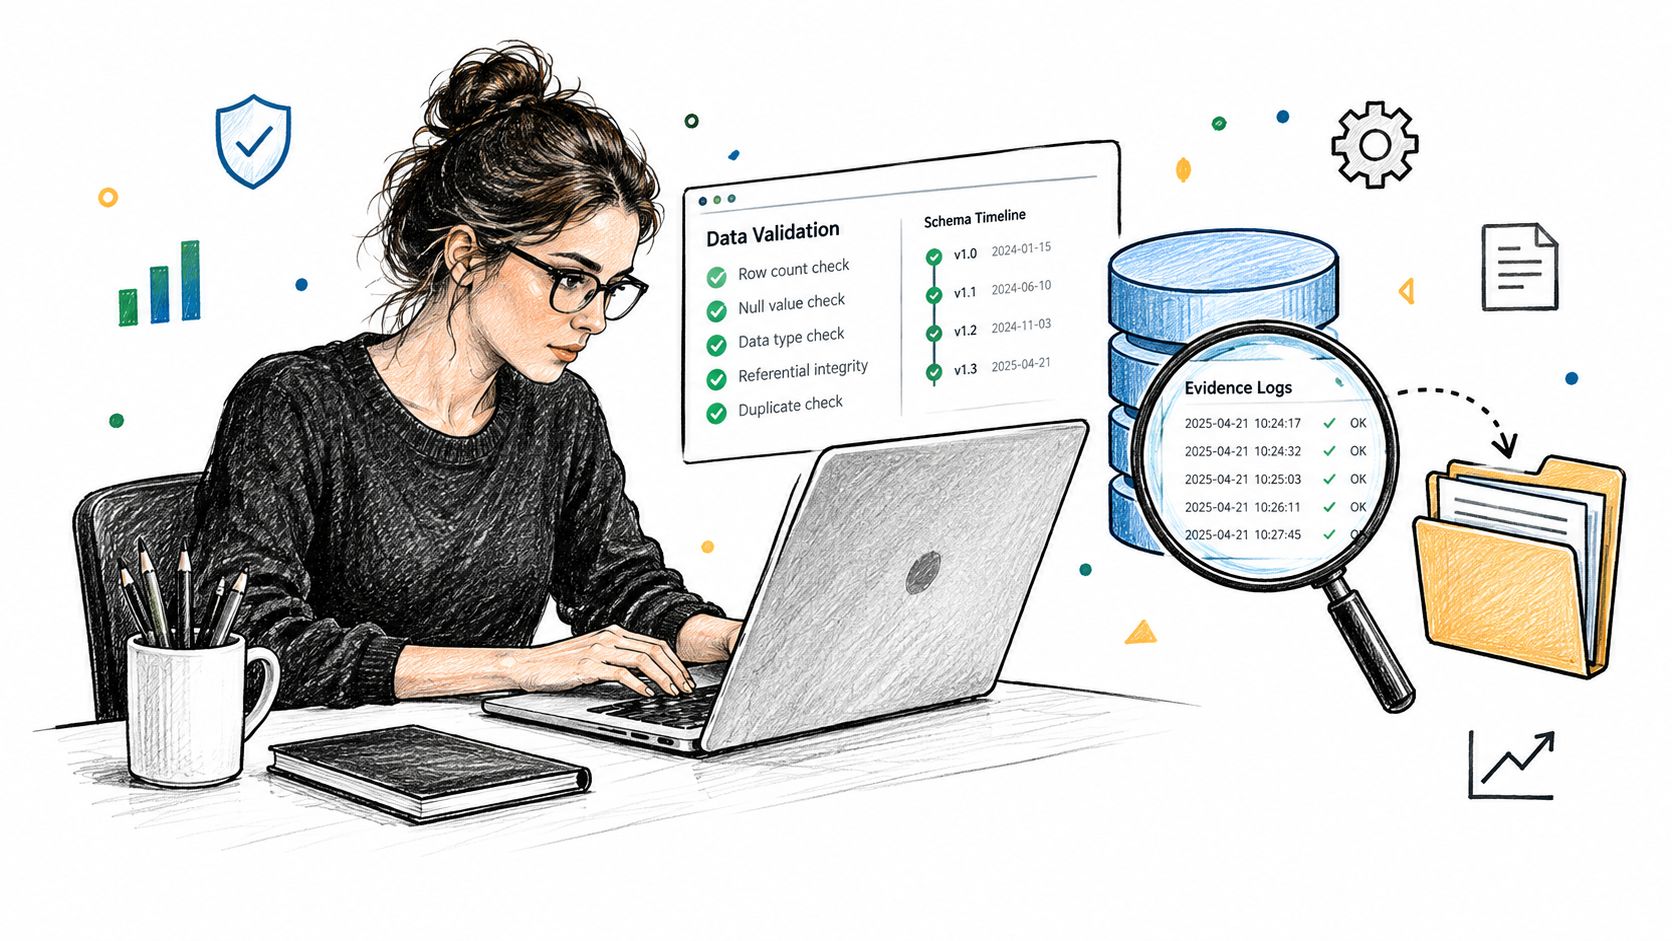
Erfassen Sie bei der Ausführung mehr als bestanden oder nicht bestanden:
Datenkontext wie Umgebung, Schema, Tabelle und Partition oder Zeitfenster
Regelkontext einschließlich Logikversion, Schwelle und Freigabestatus
Ausführungskontext wie Laufzeit, Lieferstatus der Quelle und etwaige Abhängigkeitswarnungen
Ergebniskontext einschließlich betroffener Anzahlen, Beispiele und Schwereeinstufung
Wenn Sie einen Plattformansatz nutzen, ist eine Nennung angebracht: digna läuft innerhalb der Kundenumgebung, führt Überwachung und Validierung in der Datenbank aus und zeigt Vorfälle, Trends, Timeliness-Probleme und Schemaänderungen in einer gemeinsamen Oberfläche. Dieses Bereitstellungsmodell passt gut zu Audits, weil Nachweise nah an den geprüften Systemen bleiben, statt extern neu aufgebaut zu werden.
Behandeln Sie Lineage und Nachvollziehbarkeit als Nachweis, nicht als Dekoration
Die Fachliteratur zur betrieblichen Datenqualitätspraxis behandelt Nachvollziehbarkeit und Lineage als Kernmechanik des Audits und nicht als optionale Metadaten. Von DAMA abgeleitete Dimensionslisten führen Nachvollziehbarkeit unter den häufig genannten Qualitätsdimensionen, und Governance-Quellen beschreiben Lineage als wesentlich, um zu verstehen, wie Daten transformiert werden, woher sie stammen und wie sie durch Systeme fließen, wie in dieser Arbeit zur Auswahl der richtigen Datenqualitätsdimensionen erörtert.
Ohne Lineage sagt Ihnen eine fehlgeschlagene Feldprüfung, dass es raucht. Sie sagt Ihnen nicht, wo das Feuer begann.
Ein solider Nachweisdatensatz sollte einer Prüferin erlauben, diese Fragen schnell zu beantworten:
Prüffrage | Benötigter Nachweis |
|---|---|
Woher kam dieses Feld | Quelltabelle, Quellfeld, Ingestionspfad |
Was änderte sich, bevor das Problem auftrat | Schemahistorie, Deployment-Log, Hinweis zum Quellprozess |
Wie wurde das Feld transformiert | Transformationslogik, Job- oder Modellreferenz |
Wer verantwortet die Behebung | Quellverantwortliche, Pipeline-Verantwortliche, fachliche Freigabe |
Für Teams, die eine praktische Disziplin rund um die Nachweisqualität brauchen, lohnt sich der Beitrag von Rivul AI dazu, wie man unbelegte Aussagen vor der Einreichung prüft. Es geht dort um Aussagen statt um Pipelines, doch die Kerngewohnheit ist dieselbe: Binden Sie jeden Schluss an überprüfbare Belege, bevor jemand abzeichnet.
Erfassen Sie auch Beinahe-Fehler und Quelländerungen
Viele schädliche Vorfälle beginnen als Beinahe-Fehler. Eine Quelle liefert spät, landet aber noch vor der Berichtsfrist. Ein nullable Feld wird plötzlich dünn befüllt. Eine Nachschlagetabelle ändert ihre Semantik, ohne das Schema zu brechen. Wenn Sie nur harte Fehlschläge festhalten, verpassen Sie das Muster, das den nächsten Fehler vorhersehbar gemacht hätte.
Die stärksten Nachweissammlungen enthalten deshalb:
harte Fehlschläge
Warnungen und Beinahe-Fehler
Hinweise auf Änderungen im Quellprozess
Schemaänderungen
Verletzungen der Frische
Behebungsstatus, zurückverknüpft mit der ursprünglichen Feststellung
Für Umsetzungsmuster rund um regelbasierte Prüfungen und Prüfpfade kann ein dedizierter Data Integrity Checker helfen, die Nachweise an tatsächliche Datensätze und Ausführungshistorie zu binden statt an Analystennotizen, die über Tickets und Chats verstreut sind.
Aus Feststellungen Korrekturen machen, mit klarer Verantwortung und Nachverfolgung
Ein fertiges Audit ohne Verantwortungsmodell ist nur gut organisierter Frust. Teams erledigen oft den schweren Teil, erkennen echte Mängel, weisen die Wirkung nach und schlagen sogar Lösungen vor. Dann bleiben die Feststellungen liegen, weil die Verantwortung zwischen Quellsystemteams, Data Engineering, Analytik und Fachbereich zersplittert ist.
Diese Kontrolllücke ist verbreitet. 44 % der Befragten gaben an, die Verantwortung für Datenqualität sei über mehrere Teams verteilt, 61 % verlassen sich weiterhin auf manuelle Prüfungen oder SQL-basierte Validierung, und nur 14 % setzen SLAs organisationsweit durch, so Thomson Reuters in seiner Betrachtung der Validierungslücke beim Vertrauen in Auditdaten. Geteilte Verantwortung ist nicht schlecht, unzugewiesene Freigabe schon.
Der Bericht muss mehr leisten, als Mängel zusammenzufassen
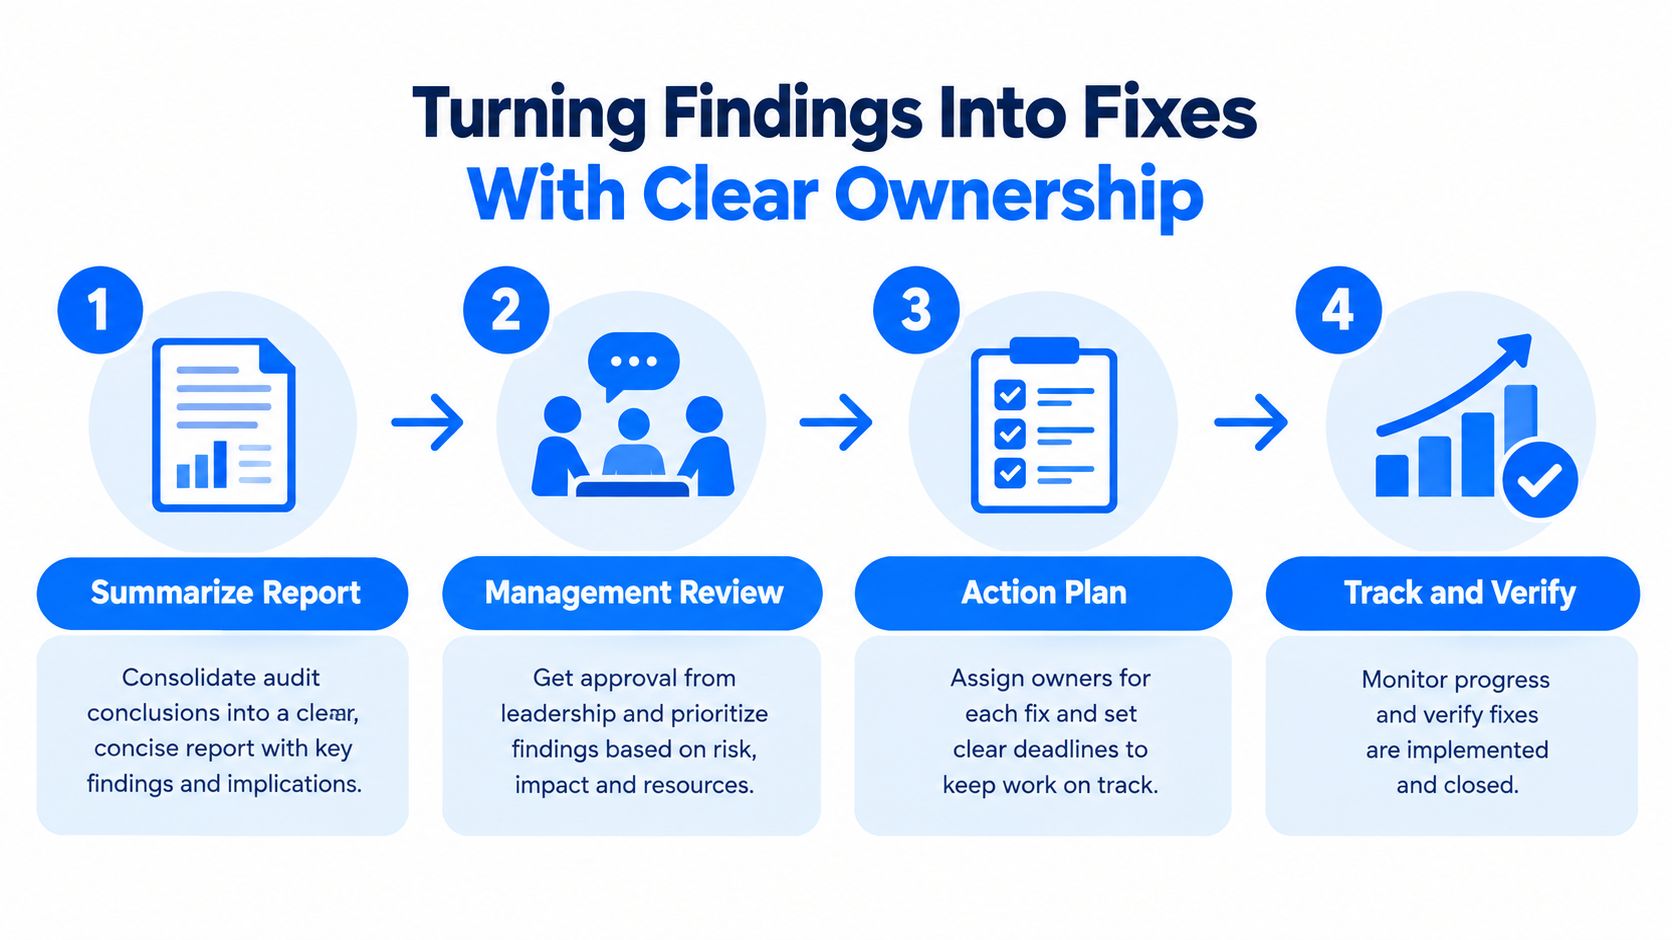
Das Audithandbuch von UN und Eurostat macht einen wichtigen operativen Punkt: Auditschlüsse sollten in einem Bericht zusammengefasst, vom Management geprüft und in einen Maßnahmenplan überführt werden. Diese Abfolge zählt, weil sie Feststellungen in gesteuerte Veränderung verwandelt statt in informelle Aufräumarbeit.
Ein brauchbarer Feststellungsbericht sollte beantworten:
was gescheitert ist
warum es für die Entscheidung oder Pflicht zählt
ob es sich um intrinsische Datenqualität oder Systemverhalten handelt
welche vorläufige Abhilfe besteht
wer die dauerhafte Behebung verantwortet
wie der Abschluss verifiziert wird
Verantwortung nach Kontrollpunkt zuweisen, nicht nach Schuld
Der schnellste Weg, Schwung zu verlieren, ist die Frage „Wessen Schuld ist das?“. Die bessere Frage: „Welcher Kontrollpunkt kann eine Wiederholung verhindern?“
Nutzen Sie den Fehlertyp, um Maßnahmen zuzuweisen:
Erfassungsproblem an der Quelle. Verantwortlich ist meist der vorgelagerte Prozess oder die Formularverantwortung.
Transformationsfehler. Die Verantwortung für Pipeline oder Analytics Engineering übernimmt die Behebung.
Abweichende Definition. Fachliche Governance oder die Kennzahlenverantwortung muss es klären.
Liefer- oder Frischefehler. Die Plattform- oder Jobverantwortung übernimmt die operative Kontrolle.
Wiederholte manuelle Übersteuerung. Die Kontrolle selbst braucht einen neuen Entwurf, keine weitere Ausnahmenotiz.
Operativer Rat: Jede Feststellung braucht eine verantwortliche Person für die Behebung und eine für die Freigabe. Das können unterschiedliche Personen sein. Ein Gremium sollten sie nicht sein.
Wenn wiederholt Fehler in demselben Formular, Extrakt oder Protokoll auftauchen, überarbeiten Sie das Formular oder den Prozess. Reinigen Sie nicht bloß erneut das Ergebnis. Das ist eines der klarsten Muster in klinischen wie in operativen Audits.
Bis zum Abschluss verfolgen, mit Verifikation statt bloßem Status
Ein Ticket mit dem Status „erledigt“ ist kein Auditabschluss. Abschluss heißt, der Mangel wurde behoben, die Kontrolle bei Bedarf angepasst, und die Prüfung besteht nun unter denselben Kriterien, die die ursprüngliche Feststellung hervorgebracht haben.
Rollenklarheit zahlt sich aus. Ein dokumentierter Rahmen für Rollen und Verantwortlichkeiten in der Datenqualität hilft Teams, Stewards, Engineers, Domänenverantwortliche und Freigebende zu trennen, damit Feststellungen nicht in Sammelpostfächern verschwinden.
Das verlässlichste Nachverfolgungsmodell ist einfach:
Nachverfolgungselement | Was es zeigen sollte |
|---|---|
Kennung der Feststellung | Stabiler Verweis zurück auf den Nachweis |
Zugewiesene Verantwortung | Benannte Person, die für die Behebung einsteht |
Freigabeverantwortung | Benannte Prüferin, die den Abschluss annimmt |
Fälligkeit oder SLA | Erwarteter Zeitpunkt der Behebung |
Verifikationsmethode | Welcher erneute Test oder Nachweis den Abschluss bestätigt |
So werden aus Feststellungen Korrekturen statt Legenden.
Audits wiederholbar und bereit für kontinuierliche Überwachung machen
Die Bewährungsprobe für Datenqualitätsaudits ist nicht, ob Sie unter Druck eine starke Prüfung hinbekommen. Sie ist, ob dieselben Kontrollen sechs Monate später noch greifen, wenn sich das Schema verschoben hat, ein Quellsystemteam das Feldverhalten geändert hat und niemand daran dachte, die Dokumentation nachzuziehen.
Wiederholbarkeit entsteht, wenn Auditlogik zum Betriebsrhythmus wird.
Halten Sie den Auditzyklus klein und nachweisreich
Ein praktisches Muster ist, den formalen Prüfumfang fokussiert zu halten und darum herum kontinuierlich leichtere Kontrollen laufen zu lassen. Periodische Tiefenprüfung bleibt wichtig, besonders für regulierte Ergebnisse und Datensätze mit großer Wirkung. Doch die tägliche Verlässlichkeitsarbeit sollte auf jene Änderungen achten, die zwischen Prüfzyklen Vertrauen brechen: späte Ankünfte, fehlende Datensätze, struktureller Drift und wiederholte Beinahe-Fehler.
Viele Teams bauen zu groß. Sie entwerfen riesige Quartalsübungen, die polierte Präsentationen und wenig operatives Lernen hervorbringen. Kleinere, nachweisreiche Zyklen halten besser, weil Teams sie aufrechterhalten können.
Achten Sie auf die Fehlermuster, die Audits immer wieder aufdecken
Traditionelle Auditmethoden geraten unter modernen Volumina und Änderungsraten an ihre Grenzen. Neuere Zusammenfassungen halten fest, dass manuelle Stichproben und Tabellenkalkulationsmethoden sich schwertun, große Auditdatenmengen zu prüfen, und dass die Einführung dedizierter Observability und SLA-Durchsetzung noch am Anfang steht, wie in dieser Übersicht zu Lücken im Datenqualitätsaudit und Herausforderungen kontinuierlicher Überwachung beschrieben. Das deckt sich mit der Praxis: Die Kontrollen scheitern nicht, weil die Idee falsch war, sondern weil die Methode nicht Schritt hält.
Ein wiederholbarer Überwachungsrhythmus umfasst meist:
Frischekontrollen für kritische Lieferungen und nachgelagerte Abhängigkeiten
Schemaüberwachung, damit strukturelle Änderungen sichtbar werden, bevor Konsumenten scheitern
Historie der Regelausführung, um zu zeigen, ob die Qualität steigt oder sinkt
Ausnahmedurchsicht, damit Warnungen und Beinahe-Fehler nicht ignoriert werden
Geplante Revalidierung nach Änderungen an vorgelagerten Prozessen
Gute Audits werden mit der Zeit leichter, weil Teams Kriterien, Nachweismuster und Verantwortungswege wiederverwenden. Schlechte Audits werden schwerer, weil jeder Zyklus bei null beginnt.
Skalieren Sie durch Standardisierung des Kontrollmodells
Sie brauchen nicht in jeder Domäne identische Regeln. Sie brauchen in jeder Domäne dasselbe Kontrollmodell: ausdrückliche Kriterien, dokumentierte Nachweise, benannte Verantwortung, gesteuerte Ausnahmen und Verifikation nach der Behebung.
Diese Standardisierung erlaubt einer Organisation, Finanzfeeds, klinische Aufzeichnungen, Telekommunikationsbetriebsdaten oder öffentliche Berichtsdatensätze zu prüfen, ohne die Methode jedes Mal neu zu erfinden. Die Prüfungen unterscheiden sich. Das Kontrollsystem nicht.
Ein wiederholbares Auditprogramm ist der Punkt, an dem Qualitätsarbeit aufhört, reaktives Aufräumen zu sein, und beginnt, sich wie Infrastruktur zu verhalten.
Wenn Sie dieses Kontrollsystem in Ihrer eigenen Umgebung brauchen, bietet digna Validierung in der Datenbank, Timeliness-Überwachung, Schema-Tracking, Anomalieerkennung und auditfähige Nachweise über Warehouses, Lakes und Pipelines hinweg. Es ist für Teams gebaut, die wiederholbare Datenqualitätsaudits brauchen, ohne Produktionsdaten aus ihrem Stack zu bewegen. Besuchen Sie digna, um zu sehen, wie die Plattform kontinuierliche, belastbare Auditkontrollen unterstützt.
Ein Audit ist eine Momentaufnahme; dieselben Kontrollen zwischen Audits weiterlaufen zu lassen, ist der Schritt zur kontinuierlichen Überwachung der Datenqualität.
Häufig gestellte Fragen
Was unterscheidet ein Datenqualitätsaudit von einer Inspektion?
Das Ergebnis. Ist das Resultat nur eine Tabelle mit Mängeln, war es eine Inspektion; ein Audit liefert Nachweise, Schlüsse, Managementprüfung und Korrekturmaßnahmen. ISO fasst ein Audit als systematischen, unabhängigen und dokumentierten Prozess, der gegen Kriterien bewertet wird.
Was verlangen systematisch, unabhängig und dokumentiert jeweils?
Systematisch heißt, die Prüfungen sind nicht improvisiert. Unabhängig heißt, die Feststellungen halten einer Prüfung außerhalb des liefernden Teams stand. Dokumentiert heißt, jemand anderes kann die Nachweise später einsehen und zum selben Schluss kommen.
Wie sollte der Prüfumfang festgelegt werden?
Von der Eignung für den Verwendungszweck her, nicht von einer abstrakten Note. Die Datenqualitätsarbeit des NIST bindet Qualität an den beabsichtigten Zweck und an Geschäftsanforderungen, halten Sie also fest, welche Entscheidung oder Pflicht die Daten stützen, welches konkrete Ergebnis Vertrauen genießt und welche Folge eintritt, wenn es zu spät, falsch oder unvollständig ist.
Was gehört ins Auditinventar?
Bauen Sie es vom Ergebnis rückwärts: kritische Berichte, Modelle, Alarme oder Meldungen; vorgelagerte Quelltabellen, Staging-Schichten, Transformationslogik und Referenztabellen; operative Abhängigkeiten wie Zeitpläne und nachgelagerte Konsumenten; und benannte Verantwortliche für Quelle, Logik und fachliche Abnahme.
Welche Grenzen verhindern Reibung im Audit?
Vier. Die fachliche Grenze benennt die abgedeckte Entscheidung oder Meldung, die Datengrenze die Datensätze, Felder und Zeiträume, die Prozessgrenze die Transformationen und Übergaben, und die Verantwortungsgrenze, wer Regeln genehmigt, wer behebt und wer abzeichnet.



