Datenbank-Integritätstests: Ein praktischer Leitfaden für 2026
|
7
min. Lesezeit

Man kann eine Pipeline haben, die technisch grün ist, und trotzdem ein Finanz-Dashboard erstellen, dem niemand vertraut. Die Jobs werden abgeschlossen, die Tests sind erfolgreich und die Zeilen sind vorhanden, aber das Hauptbuch stimmt nicht mit der Umsatzzahl auf dem Bildschirm überein. In dieser Lücke verdient die Datenbank-Integritätsprüfung ihren Lebensunterhalt, denn sie prüft, ob die Daten nach Speicherung, Joins, Migrationen, Transformationen und im Laufe der Zeit noch korrekt sind.
Inhaltsverzeichnis
Die fünf Dimensionen, die jede Integritätsprüfung abdecken sollte
Von Punkt-zu-Punkt-Tests zu kontinuierlicher Integritäts-Observability
Alles zu einem vertrauenswürdigen Daten-Stack zusammenführen
Wenn grüne Tests immer noch fehlerhafte Daten ausliefern
Die Warnung kam von der Finanzabteilung, nicht von der Softwareentwicklung. Ein Dashboard zeigte eine Umsatzzahl, die nicht mit dem Hauptbuch übereinstimmte, aber jede Pipeline-Prüfung war erfolgreich gewesen und das Data Warehouse sah auf dem Papier fehlerfrei aus. Ein Analytics-Engineer verfolgte den Fluss über Staging, Transformationen und Berichtsebenen zurück und fand die unangenehme Wahrheit: Die Datenbank wies keine offensichtliche Integritätsverletzung auf, und dennoch war die geschäftliche Antwort falsch.
Das ist die Falle bei gewöhnlichen Prüfungen. Zeilenanzahlen können in Ordnung sein, ein DAG kann grün werden und ein grundlegender Aktualitätstest kann erfolgreich sein, während eine Fremdschlüsselbeziehung fehlerhaft ist, bei einem Backfill ein doppelter Schlüssel eingeführt wurde oder eine Transformation die historischen Gesamtsummen verändert hat. In der Praxis hängt die Integrität von der Validierungsstrategie ab, mit der die Datenbank umgeben ist, und nicht von der Existenz der Datenbank selbst. Mutationstests haben gezeigt, wie groß diese Lücke sein kann: Die schwächsten Abdeckungskriterien eliminierten in einer Analyse von 2015 nur 12 % der Mutanten, während die stärksten bis zu 96 % eliminierten (McMinn 2015).
Eine klarere Art, das Problem zu formulieren, ist die Unterscheidung zwischen Datenqualität und Datenintegrität, die das Team von digna als verwandte, aber nicht identische Anliegen behandelt.
Warum dies eine eigene Disziplin verdient
Die Datenbank-Integritätsprüfung steht neben der allgemeinen Datenqualitätsarbeit. Sie prüft, ob Datensätze korrekt, konsistent, gültig und unbeschädigt bleiben, während sie sich durch die Speicherung bewegen und verändern, und sie benötigt negative Tests, die versuchen, Regeln zu verletzen, anstatt nur den Standardpfad (Happy Path) zu bestätigen. Das ist wichtig, da ein System immer noch befüllt, abfragbar und dennoch falsch sein kann.
Branchenrichtlinien definieren Integrität heute anhand von fünf Kerndimensionen: Genauigkeit, Vollständigkeit, Konsistenz, Rechtzeitigkeit und Gültigkeit (Matillion). Derselbe Punkt wird in IBMs Leitfaden zur Datenintegritätsprüfung hervorgehoben, der betont, dass geprüft werden muss, ob die Datenbank die von Ihnen erwarteten Regeln bei der Speicherung und dem Abruf durchsetzt. Dieses Modell ist nützlich, weil es Teams weg von einer einfachen Bestanden-oder-Nicht-Bestanden-Denkweise und hin zu mehrschichtigen Kontrollen führt, die der Art und Weise entsprechen, wie moderne Warehouses, Lakes und Pipelines versagen.
Was Datenbank-Integritätsprüfung wirklich bedeutet

Eine Datenbank kann an der Oberfläche gesund aussehen und dennoch fehlerhafte Datensätze enthalten. Die Datenbank-Integritätsprüfung prüft, ob Daten korrekt und unbeschädigt bleiben, während sie gespeichert, abgerufen, repliziert und transformiert werden, und ob die Datenbank die Regeln durchsetzt, von denen das System abhängt. Sie befindet sich an der Grenze zwischen Schema-Durchsetzung und Laufzeitverhalten, daher muss die Testfläche beides abdecken.
Ein einfaches Kunden- und Bestellsystem verdeutlicht dies schnell. Jede Bestellung sollte auf einen realen Kunden verweisen, jede Kundenkennung sollte eindeutig bleiben und Felder wie Bestellstatus oder Menge sollten innerhalb der zulässigen Werte liegen. Wenn eines dieser Versprechen bricht, akzeptiert die Datenbank die Zeile möglicherweise trotzdem, es sei denn, die Regel wurde codiert und getestet.
Die klassischen Integritätsarten
Entitätsintegrität bedeutet, dass jede Zeile eine eindeutige Kennung besitzt und diese Kennung nicht Null ist. Ein Primärschlüssel muss seine Aufgabe erfüllen, andernfalls verschwimmen Datensätze und nachgelagerte Joins werden unzuverlässig.
Referenzielle Integrität bedeutet, dass untergeordnete Zeilen (Child Rows) auf reale übergeordnete Zeilen (Parent Rows) verweisen. Wenn eine Bestellung auf einen Kunden verweist, der nicht existiert, entsteht eine verwaiste Zeile, und das Berichtswesen kann anfangen, Datensätze falsch zu zählen oder falsch zu klassifizieren.
Domänenintegrität hält Werte innerhalb des zulässigen Bereichs, Typs oder der Liste. Das kann eine CHECK-Einschränkung, ein Datentyp oder eine Regel sein, die ungültige Statuscodes blockiert, bevor sie sich verbreiten.
Semantische Integrität ist die Geschäftsebene, die ein Schema allein nicht ausdrücken kann. Ein updated_at-Wert sollte nicht älter als created_at sein, und eine Bestellung sollte nicht als bezahlt markiert werden, wenn die Zahlungstabelle keine Transaktion aufweist.
Praktische Regel: Wenn eine Schema-Einschränkung die Regel ausdrücken kann, testen Sie die Einschränkung direkt. Wenn die Geschäftslogik die Regel besitzt, testen Sie das Verhalten, das sie beweist.
Diese Aufteilung zwischen strukturellen Prüfungen und umfassenderen Qualitätskontrollen ist der Punkt, an dem die Unterscheidung Datenqualität vs. Datenintegrität nützlich wird, da sie klarstellt, welche Fehler der Datenbank selbst zuzuordnen sind und welche zur umgebenden Pipeline oder Anwendungslogik gehören.
Die Fünf Dimensionen, die jede Integritätsprüfung abdecken sollte

Eine Tabelle kann ihre grundlegenden Einschränkungen erfüllen und dennoch zu falschen Entscheidungen führen. Die Zeile existiert, der Typ ist korrekt und der Join funktioniert, aber die Zahl ist möglicherweise veraltet, unvollständig oder steht im Widerspruch zu einem anderen System. Aus diesem Grund muss die Integritätsprüfung mehr als nur Primärschlüssel und Fremdschlüssel abdecken. Sie muss die spezifischen Wege prüfen, auf denen Daten valide aussehen können, obwohl sie unzuverlässig sind.
Das Fünf-Dimensionen-Modell hilft Teams, eine Überanpassung auf ein einzelnes Fehlerszenario zu vermeiden. Jede kritische Tabelle sollte der Dimension zugeordnet werden, die dort am wahrscheinlichsten bricht, da der richtige Test für einen Kundenschlüssel nicht der richtige Test für einen Umsatz-Snapshot ist. Klassische Einschränkungen fangen strukturelle Verletzungen ab, während kontinuierliche Prüfungen Änderungen im Verhalten, der Aktualität und der systemübergreifenden Übereinstimmung erfassen. Informationen zu Schemaänderungen, die diese Regeln verändern, finden Sie unter Schema Drift und warum strukturelle Änderungen Pipelines unterbrechen.
Was jede Dimension abfängt
Genauigkeit fragt, ob der Wert stimmt. Eine Umsatzsumme kann immer noch falsch sein, selbst wenn die Zeile vorhanden ist und der Typ stimmt. Daher muss der Test die Ausgabe mit der erwarteten Berechnung oder der Source of Truth vergleichen.
Vollständigkeit fragt, ob die erwarteten Datensätze oder Felder vorhanden sind. Ein fehlender Transaktionsmonat ist ein anderer Fehler als ein falscher Wert, und er erfordert in der Regel Anzahlprüfungen, Vorhandenseinsprüfungen oder Prüfungen auf Partitionsebene. Wenn ein Ingestion-Job einen Teil der Daten auslässt, ist die Vollständigkeit der erste Ort, an dem sich diese Lücke zeigen sollte.
Konsistenz sucht nach Widersprüchen zwischen Systemen oder Ebenen. Ein Kunde, der in einer Tabelle als aktiv und in einer anderen als geschlossen markiert ist, ist ein Zeichen dafür, dass das Modell abgewichen ist, und diese Diskrepanz zeigt sich möglicherweise erst, wenn zwei Tabellen direkt miteinander verglichen werden.
Rechtzeitigkeit prüft die Aktualität. Ein Ladevorgang, der um 23:55 Uhr eintrifft, aber um 9:00 Uhr als aktuell behandelt wird, sollte eine Rechtzeitigkeitsregel verletzen, selbst wenn jede Zeile gültig ist. Aktualität ist wichtig, da verzögerte Daten zwar korrekt sein können, aber dennoch jeden in die Irre führen, der sie als aktuell interpretiert.
Gültigkeit fragt, ob die Daten dem zulässigen Format oder Regelsatz entsprechen. Fehlerhafte E-Mail-Zeichenfolgen, unmögliche Statuswerte und ungültige Daten gehören hierher, ebenso wie jedes Feld, das die mit seinem Typ verknüpften Geschäftsregeln verletzt.
Eine gute Testgewohnheit ist es, für das Fehlerszenario zu schreiben und nicht für die SQL-Bequemlichkeit. Wenn eine Tabelle Daten, Anzahlen, Kundenkennungen und Geschäftsstatus speichert, bestätigt eine Abfrage vielleicht einen Teil des Bildes, beweist aber selten alle fünf Dimensionen auf einmal. Der sauberere Ansatz besteht darin, zu entscheiden, was fehlschlagen kann, und dann die Prüfung auszuwählen, die diesen Fehler am direktesten aufdecken würde.
Operative Erkenntnis: Eine grüne Testsuite, die nur die Vollständigkeit prüft, kann dennoch eine falsche Umsatzberechnung, einen veralteten Batch oder einen Datensatz übersehen, der für sich genommen gültig, aber inkonsistent mit dem Rest des Modells ist.
Aus diesem Grund sind die fünf Dimensionen zu einer Baseline für die Enterprise-Governance in regulierten Umgebungen geworden, insbesondere dort, wo Auditierbarkeit und Aktualität ebenso wichtig sind wie Richtigkeit.
Entwurf von Integritätstestfällen, die Fehler provozieren
Die besten Integritätstests feiern nicht den Standardpfad, sie versuchen, das Modell zum Scheitern zu bringen. Wenn eine Regel real ist, sollte der Test in der Lage sein, sie absichtlich zu verletzen und zu beweisen, dass die Datenbank die fehlerhafte Eingabe ablehnt oder das fehlerhafte Verhalten aufzeigt. So finden Sie Fälle, in denen eine Migration eine Einschränkung verworfen hat oder ein ETL-Refactoring die Logik nicht mehr durchsetzt.
Negative Fälle, die schwache Kontrollen aufdecken
Ein doppelter Primärschlüssel-Insert sollte sofort fehlschlagen, wenn die Entitätsintegrität real ist. Eine verwaiste untergeordnete Zeile sollte fehlschlagen, wenn die referenzielle Integrität erzwungen wird. Ein ungültiger Enum-Wert, ein vor seinem übergeordneten Element eingefügtes untergeordnetes Element oder eine negative Menge in einer Tabelle, die niemals eine solche akzeptieren sollte, zeigen Ihnen, ob die Regel in der Datenbank existiert oder nur in der Dokumentation.
Derselbe Ansatz funktioniert für semantische Prüfungen. Eine bezahlte Bestellung mit null Zahlungstransaktionen sollte bei einer Validierungsabfrage fehlschlagen. Ebenso eine Zeile, in der updated_at vor created_at liegt. Dies sind die Arten von Tests, die stille Probleme nach einem Release aufdecken, insbesondere wenn die Datenbank immer noch „gut aussieht“.
Häufige Integritätstestfälle und was sie abfangen
Testfall | Integritätsart | Was er abfängt | Beispiel-Assertion |
|---|---|---|---|
Insert eines doppelten Primärschlüssels | Entität | Fehlende Durchsetzung der Eindeutigkeit | Schlägt fehl, wenn ein doppelter Schlüssel akzeptiert wird |
Verwaiste untergeordnete Zeile | Referenziell | Fehlerhafte Parent-Child-Beziehung | Schlägt fehl, wenn die untergeordnete Zeile kein übergeordnetes Element hat |
Ungültiges Enum oder ungültiger Status | Domäne | Schwache Werteinschränkungen | Schlägt fehl, wenn ein unzulässiger Wert gespeichert wird |
Insert einer untergeordneten Zeile vor der übergeordneten Zeile | Referenziell | Fehlende Sequenzierungskontrolle | Schlägt fehl, wenn die FK-Regel umgangen wird |
Bezahlte Bestellung ohne Zahlungszeile | Semantisch | Fehlerhafter Geschäftsprozess | Schlägt fehl, wenn der Zahlungsstatus inkonsistent ist |
Negative Menge | Domäne | Unmögliche Geschäftswerte | Schlägt fehl, wenn ein negativer Wert gespeichert wird |
| Semantisch | Fehlerhafte Lebenszyklus-Logik | Schlägt fehl, wenn Zeitstempel die Reihenfolge verletzen |
Für eine Sicht auf Schema-Ebene darüber, wie diese Fehler oft beginnen, ist die interne Notiz über Schema Drift erklärt ein nützlicher Begleiter. Struktureller Drift kann Einschränkungen schwächen, und das Symptom tritt möglicherweise erst auf, wenn eine nachgelagerte Prüfung schließlich das erwartete Verhalten mit dem abgleicht, was die Datenbank tatsächlich tut.
Die Sprache der Assertions sollte direkt sein. „Doppelte Kunden-ID wurde akzeptiert“, „verwaiste Bestellposition gefunden“ und „Zahlungsstatus stimmt nicht mit Transaktionsdatensätzen überein“ sind besser als vage Bestanden-oder-Nicht-Bestanden-Meldungen, weil sie dem nächsten Entwickler genau sagen, was fehlerhaft war.
Ein nützliches Muster besteht darin, diese punktuellen Fehler mit denselben Regeln zu verknüpfen, die im Laufe der Zeit in der Datenbank überwacht werden. Der statische Test beweist, dass die Einschränkung existiert. Die fortlaufende Observability zeigt, ob reale Daten weiterhin die relevanten Grenzfälle verletzen, wie z. B. die wiederholte Erstellung verwaister Zeilen nach einem Deployment oder ein Statusfeld, das von der erlaubten Menge abweicht. Diese Kombination bietet Ihnen sowohl die Schutzplanke als auch das Warnsignal.
Wenn Sie eine Plattform suchen, um diese Prüfungen innerhalb der Datenbank auszudrücken, anstatt Daten zur Validierung nach außen zu senden, ist digna eine Option unter anderen. Die regelbasierte Validierung und das In-Database-Ausführungsmodell passen zu dieser Art des Testens, bei der es darum geht, fehlerhafte Beziehungen dort abzufangen, wo die Daten bereits liegen.
Einbettung von Integritätstests in CI/CD und Migrationen
Eine Schemaänderung, die ohne erneutes Ausführen von Integritätsprüfungen ausgeliefert wird, schafft einen blinden Fleck, und genau dort gelangen meist fehlerhafte Daten hindurch. Ein verlässlicher Release-Prozess hält Migrationen und Integritäts-Assertions zusammen, sodass die Regeln, die Schlüssel, Beziehungen und zulässige Werte schützen, mit dem Code reisen, der sie ändert.
Wie der Release-Flow aussehen sollte
Beginnen Sie mit der Versionskontrolle. Ein Entwickler ändert das Schema, die Transformationslogik oder die Geschäftsregel, und die CI-Pipeline führt Unit-Tests sowie Integritätstests auf einer geklonten Datenbank aus. Die Migration sollte an zwei Stellen angewendet werden: in einer neuen Datenbank und in einer mit Daten befüllten, da eine Änderung, die auf leeren Tabellen funktioniert, immer noch fehlschlagen kann, sobald echte Zeilen, Fremdschlüssel und Grenzfälle vorhanden sind.
Führen Sie nach dem Deployment dieselben Assertions erneut aus. Dieser zweite Durchlauf ist wichtig, da eine Migration zwar sauber angewendet werden kann, aber dennoch das Verhalten von Einschränkungen, Abfragepläne oder Validierungsergebnisse verändern kann. Teams müssen außerdem im Vorfeld entscheiden, ob die Migration umkehrbar ist oder formell als unumkehrbar akzeptiert wird, anstatt diese Frage nach dem Release offen zu lassen (bug0).
Wo die Tools hineinpassen
Frameworks wie pgTAP für PostgreSQL und tSQLt für SQL Server ermöglichen es Teams, Integritätsprüfungen als Code auszudrücken, was die Prüfungen überprüfbar und wiederholbar macht. Validierungen auf Abfrageebene gehören in denselben Workflow, insbesondere für kritische Pfade, und EXPLAIN ANALYZE kann Performance-Regressionen aufdecken, bevor eine Änderung die nachgelagerte Berichterstattung oder Analytik erreicht. Dieselbe Disziplin zeigt sich auch bei der Enterprise-Datenvalidierung in der Datenbank, wo die Prüfungen nah an den Tabellen bleiben, die sie schützen.
Produktions-Snapshots sind ein weiteres starkes Muster. Sie ermöglichen es Ihnen zu überprüfen, ob sich eine Änderung auf produktionsnahen Daten genauso verhält, ohne das Live-System selbst zu berühren. Das ist wichtig, wenn eine Tabelle groß, geschäftskritisch oder reguliert ist, da das Verhalten bei Tests mit leeren Daten Probleme verbergen kann, die erst bei großer Skalierung oder mit historischen Datensätzen auftreten.
Genauso wie die Anomalieerkennung für Händler auf ungewöhnliche Verhaltensänderungen im Laufe der Zeit achtet, achtet die datenbankinterne Integritätsprüfung auf Regeln, die auf dem Papier immer noch erfolgreich sind, aber bei realen Datenbewegungen fehlschlagen. Statische Assertions fangen die verletzte Einschränkung ab. Prüfungen während und nach dem Release zeigen, ob die Migration die Datenbank konsistent hält, sobald der neue Code aktiv ist.
Von Punkt-zu-Punkt-Tests zu kontinuierlicher Integritäts-Observability
Eine Testsuite kann erfolgreich sein und das Dashboard trotzdem fehlerhaft. Das passiert meistens dann, wenn das Problem keine verletzte Einschränkung ist, sondern ein Drift im Laufe der Zeit, eine verzögerte Bereitstellung, eine Schemaänderung oder eine Transformation, die die Historie verändert hat, ohne einen harten Fehler auszulösen. Kontinuierliche Integritäts-Observability schließt die Lücke, die durch punktuelle Validierungen entsteht.
Warum statische Tests nicht ausreichen
Traditionelle Integritätstests sind gut darin, explizite Verletzungen wie verwaiste Zeilen oder ungültige Werte abzufangen. Sie sind schwächer, wenn sich die Pipeline langsam verändert, da das korrekte Ergebnis von gestern ohne ein einzelnes Fehlerereignis zur falschen Antwort von heute werden kann. Datenaufbereitungen, Backfills und Refactorings sind häufige Quellen für diese Art von leisem Datenverlust, und öffentliche Leitfäden behandeln dies zunehmend als separates operatives Problem und nicht als reines Datenbankproblem (Soda).
Aus diesem Grund ergänzen Teams deterministische Prüfungen um Anomalieerkennung, Nachverfolgung von Schemaänderungen und Überwachung von Bereitstellungsmustern. Diese Signale helfen Ihnen, die Form der Daten zu sehen, und nicht nur, ob sie eine Regel verletzen. Wenn eine Tabelle normalerweise zu einer bestimmten Zeit eintrifft und sich zu verspäten beginnt, oder wenn sich eine Metrik in einer Weise verschiebt, die nicht dem vorherigen Verhalten entspricht, möchten Sie die Warnung erhalten, bevor ein geschäftlicher Nutzer das Dashboard öffnet.
Wie Observability die Integrität erweitert
Ein effektives Setup überwacht drei Dinge zusammen. Erstens beweist die Validierung auf Datensatzebene, dass die harten Regeln weiterhin gelten. Zweitens signalisiert die Aktualitätsüberwachung verspätete oder fehlende Ladungen basierend auf erwarteten Bereitstellungsmustern. Drittens fängt die Schema-Nachverfolgung strukturelle Änderungen ab, bevor nachgelagerte Jobs an einer überraschenden Spaltenumbenennung oder Typänderung scheitern.
Eine nützliche Referenz ist die Anomalieerkennung für Händler, da sie zeigt, wie eine auf Baselines basierende Erkennung ungewöhnliches Verhalten aufdecken kann, ohne dass jedes Team eine Regel für jeden Grenzfall manuell schreiben muss.
Praktische Regel: Wenn eine Prüfung Ihnen nur sagt, dass schlechte Daten angekommen sind, fügen Sie ein Observability-Signal hinzu, das Ihnen sagt, wann das System begonnen hat, in Richtung schlechter Daten abzuweichen.
Kontinuierliche Observability ersetzt keine Integritätstests. Sie fängt die Fehler ab, für die Tests nicht geplant werden können, insbesondere in Pipelines, die historische Daten neu verarbeiten oder von Upstream-Systemen abhängen, die Sie nicht kontrollieren.
Messung von Abdeckung, SLAs und echtem ROI
Mehr Tests bedeuten nicht automatisch mehr Schutz. Eine lange Liste von Prüfungen kann beeindruckend aussehen und dennoch die Tabellen übersehen, auf die es am meisten ankommt. Die bessere Frage ist, ob die Testsuite die Daten abdeckt, die dem Unternehmen schaden können, wenn sie fehlerhaft sind.
Die Abdeckung sollte dem Risiko folgen
Kritische Tabellen verdienen eine tiefere Abdeckung als Referenzdaten, und änderungssensible Pipelines verdienen mehr Aufmerksamkeit als stabile. Nachgelagerte Modelle, regulatorische Datensätze und KPI-Tabellen stehen ganz oben auf der Liste, da fehlende Zeilen, verspätete Ladungen oder fehlerhafte Joins die Berichterstattung und Compliance-Nachweise verfälschen können. Viele öffentliche Leitfäden diskutieren Dokumentation und Audits, definieren aber selten, was „gute Abdeckung“ in einer gemischten Warehouse-, Lake- und Pipeline-Umgebung bedeutet (VirtuosoQA).
Legen Sie SLAs fest, die der Rolle der Daten entsprechen. Wenn ein Datensatz die morgendliche Berichterstattung steuert, benötigt das Team eine Aktualitätserwartung, die strenger ist als bei einem Batch-Archiv. Wenn sich ein Schema häufig ändert, ist die entscheidende Kontrolle nicht, wie viele Prüfungen existieren, sondern ob die Änderung erfasst wurde, bevor die Benutzer die Auswirkungen bemerkten.
Eine risikominimierende Denkweise
Integritätsprüfung ist ein Risikominimierungsprogramm, keine reine Statistik zur Anzahl der Tests.
Diese Formulierung macht es einfacher, Investitionen in regulierten Umgebungen zu rechtfertigen, in denen die Kosten für eine fehlende Zeile, eine verspätete Ladung oder einen beschädigten KPI zu Reibungsverlusten beim Audit, falschen Entscheidungen oder Nacharbeiten in der Analytik und im Betrieb führen können. Der ROI ergibt sich aus der Vermeidung dieser Fehler, nicht aus dem Streben nach einer lückenlosen Validierung jeder Tabelle.
Ein praktischer Weg für den Einstieg besteht darin, Datensätze nach ihren geschäftlichen Auswirkungen zu ordnen und die Überwachungstiefe entsprechend zuzuweisen. Das bietet Ihnen eine bessere Balance, als zu versuchen, alles gleichermaßen zu testen.
Alles zu einem vertrauenswürdigen Daten-Stack zusammenführen
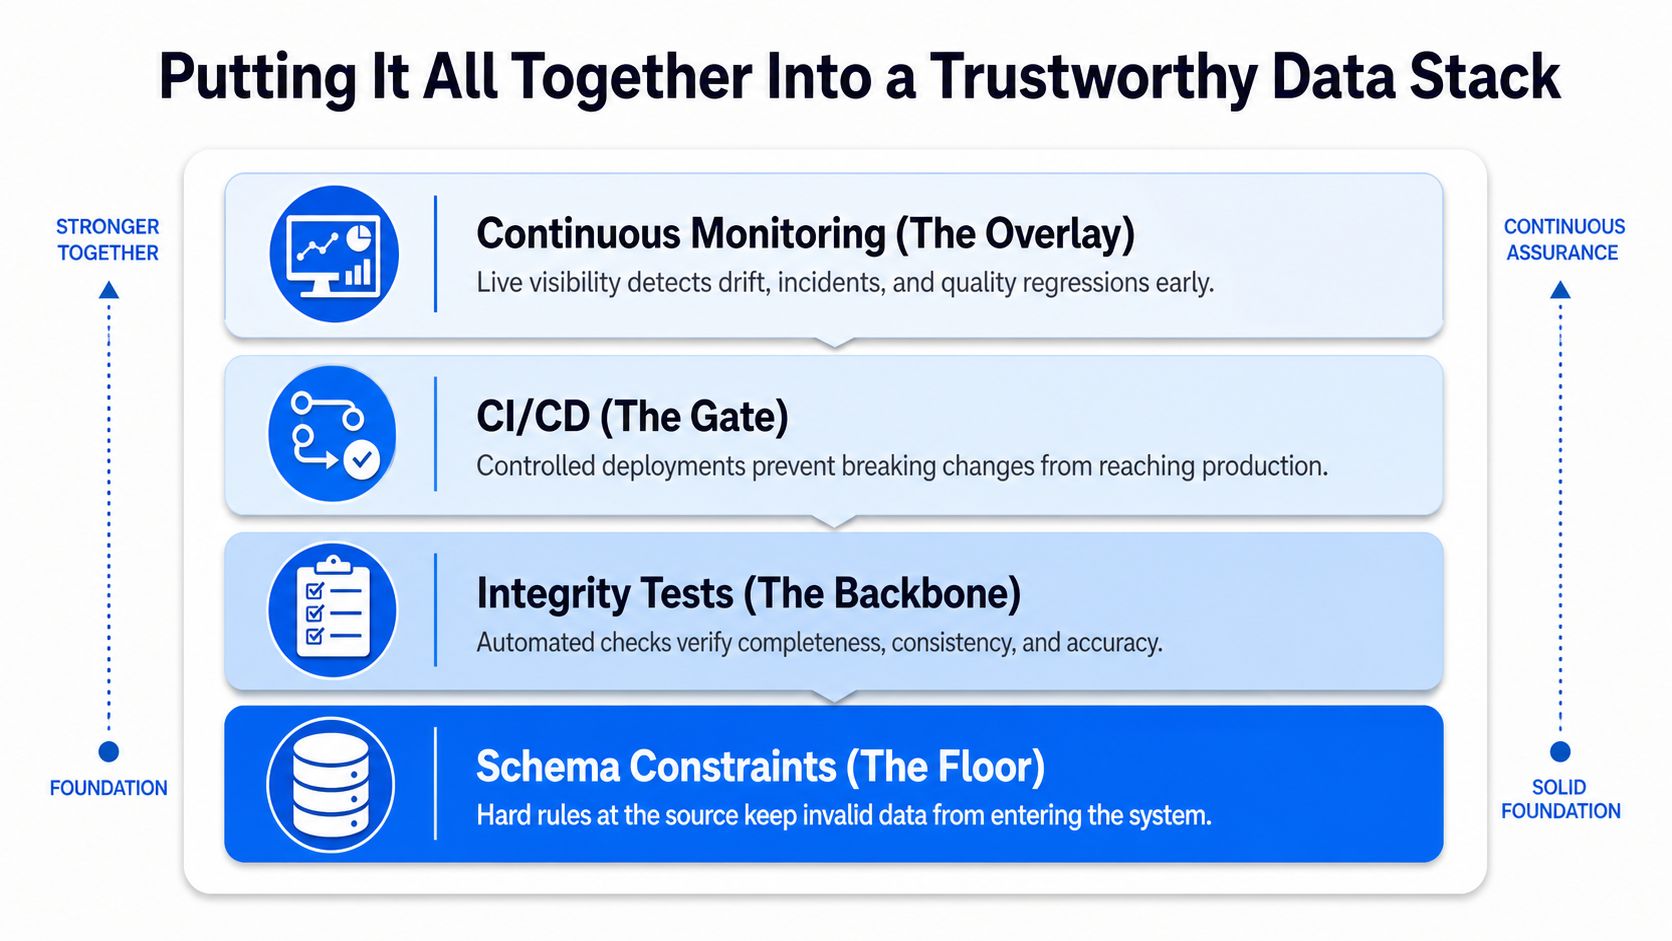
Ein vertrauenswürdiger Stack besteht aus Schichten, und jede Schicht löst eine andere Art von Fehler. Schema-Einschränkungen bilden das Fundament; sie verhindern offensichtliche Verletzungen an der Datenbankgrenze. Integritätstests sind das Rückgrat; sie beweisen, dass die Regeln nach Codeänderungen, Ladevorgängen und Migrationen weiterhin funktionieren. CI/CD ist das Freigabe-Gate; es blockiert Änderungen, die diese Regeln verletzen würden. Kontinuierliches Monitoring ist die Überlagerung; es wacht nach dem Deployment über Abweichungen, Verzögerungen und strukturelle Änderungen.
Ein einfaches Betriebsmodell
An der Warehouse- oder Lake-Grenze halten Einschränkungen ungültige Datensätze fern. Innerhalb der Pipeline prüfen Testfälle die Entitäts-, referenzielle, Domänen- und semantische Integrität, bevor die Daten die Konsumenten erreichen. Im Release-Management bewegen sich Migrationen und Assertions zusammen, sodass das Team nachweisen kann, dass eine Änderung das Verhalten nicht beeinflusst hat. Nach dem Release überwacht die Observability das Live-System auf verspätete Zugänge, Schema-Drift und statistische Anomalien.
Dieser mehrschichtige Ansatz passt auch zur Governance. Das Ausführen von Prüfungen direkt in der Datenbank belässt die Daten an Ort und Stelle, was die Sicherheit erhöht und unnötige Datenbewegungen reduziert. Die Kombination aus deterministischer Validierung und Verhaltensüberwachung ermöglicht es Teams, sowohl harte Verletzungen als auch leise Abweichungen zu erfassen.
Ein erfahrenes Datenteam kann das Modell in einem Satz zusammenfassen: Datenbank-Integritätsprüfung ist kein einzelnes Tool, sondern ein mehrschichtiges Programm, das klassische Datenbankdisziplin mit moderner Observability verbindet, damit nachgelagerte Konsumenten den Daten vertrauen können.
Wenn Sie Hilfe beim Aufbau dieses mehrschichtigen Modells in Ihrer eigenen Umgebung benötigen, bietet digna datenbankinterne Validierung, Schema-Nachverfolgung, Aktualitätsüberwachung und Anomalieerkennung über Warehouses, Lakes und Pipelines hinweg. Besuchen Sie digna, um zu sehen, wie diese Kontrollen in Ihren Daten-Stack passen und die Integritätsprüfungen unterstützen können, die Ihr Team benötigt.



