Data Analytics-Events erklärt von der Erfassung bis zum Vertrauen
|
7
min. Lesezeit

Sie haben ein Dashboard, das ruhig aussieht, das Team liefert weiterhin Code aus, und dennoch stimmen die Zahlen eines Morgens nicht ganz mit dem überein, was Vertrieb, Produkt und Support sehen. Das ist die stille Gefahr von Data Analytics-Events. Der Code wird vielleicht immer noch ausgeführt, aber wenn sich die Bedeutung des Events verschiebt, kann das Dashboard weiterhin eine Geschichte erzählen, die nicht mehr der Realität entspricht.
Deshalb sind zuverlässige Events nicht nur ein Tracking-Problem. Sie sind ein Data Contract-Problem, und dieser Vertrag muss zwischen Engineers, Analysten und dem Business Bestand haben. Wenn das Event-Modell vage ist, erbt jeder nachgelagerte Trichter, jedes Attributionsmodell und jede Feature-Pipeline diese Ambiguität. Wenn das Modell klar ist, lässt sich dem Rest des Stacks leichter vertrauen. Siehe auch die verwandte Idee von reliable data as valid data für das größere Qualitätsbewusstsein hinter diesem Vertrauen.
Kernidee: Ein Event ist nur dann nützlich, wenn seine Bedeutung stabil genug bleibt, damit sich Menschen und Systeme darauf verlassen können.
Der praktische Weg ist einfach, auch wenn die Details Disziplin erfordern. Verstehen Sie zunächst, was ein Event wirklich ist. Entwerfen Sie dann das Modell so, dass es mit Produktänderungen skaliert. Beseitigen Sie danach die häufigsten Fehlermuster, die Daten korrumpieren. Und schließlich validieren Sie den Stream kontinuierlich als lebendigen Vertrag, nicht als einmalige Checkliste.
Inhaltsverzeichnis
Einführung: Warum Analytics-Events über Vertrauen entscheiden
Was Data Analytics-Events wirklich sind und wie sie funktionieren
Die drei Teile, auf die es ankommt
Vom rohen Event zur Analytics-Pipeline
Ein Event-Modell entwerfen, das mit Ihrem Produkt skaliert
Mit Kategorien beginnen, dann das Event sauber benennen
Entscheiden, welche Felder erforderlich sind
Häufige Fallstricke, die Event-Daten korrumpieren, und wie man sie vermeidet
Gesunde versus ungesunde Muster
Achten Sie auf Timing- und Zeitzonenfehler
Event-Qualität mit Verträgen und beobachtbaren Signalen validieren
Fünf Signale, die verschiedene Arten von Problemen aufdecken
Baselines schlagen feste Schwellenwerte bei unregelmäßigem Traffic
Event-Observability in die Praxis umsetzen mit digna
Zuverlässige Analytics-Events für die Zukunft aufbauen
Einführung: Warum Analytics-Events über Vertrauen entscheiden
Ein Dashboard kann gesund aussehen, während der darunter liegende Event-Stream bereits zu driften begonnen hat. Ein Produktmanager sieht die Grafik für Neuanmeldungen. Ein Analyst sieht dieselbe Grafik. Ein Data Engineer überprüft die Pipeline und stellt fest, dass nichts fehlerhaft ist. Die Falle besteht darin, dass das System technisch „aktiv“ sein kann, während sich die Event-Bedeutung gerade so weit verschoben hat, dass Entscheidungen verfälscht werden.
Deshalb stehen Data Analytics-Events an der Basis fast jeder Metrik, die für Menschen von Bedeutung ist. Sie speisen Trichter, Retention-Ansichten, Experimentergebnisse, Marketing-Attribution, betriebliche Warnmeldungen und ML-Features. Wenn die Event-Definition ungenau ist, füllt jedes Team die Lücken anders aus, und diese Unterschiede fallen oft erst auf, wenn jemand fragt, warum zwei Berichte voneinander abweichen.
Das Fachgebiet selbst hat tiefe Wurzeln. Die IEEE International Conference on Data Science and Advanced Analytics (IEEE DSAA) beschreibt sich selbst als das führende Data-Science-Forum mit gemeinsamer Unterstützung von IEEE, ACM, ASA und CCF, wie im Überblick über das Ökosystem der Analytics-Events beschrieben. Diese Art von institutioneller Unterstützung ist ein starkes Signal dafür, dass Analytics-Events kein Nebenthema sind, sondern Teil der zentralen professionellen Infrastruktur des Fachgebiets.
Die andere Veränderung ist praktischer Natur. Die Teilnahmequoten bei geschäftlichen Veranstaltungen zeigen auch, wie oft die tatsächliche Teilnahme von der Zahl auf der Registrierungsliste abweicht. In einem Benchmark von 2026 konvertieren Präsenzveranstaltungen typischerweise etwa 60 % bis 70 % der RSVPs in tatsächliche Teilnehmer, virtuelle Live-Events konvertieren etwa 40 % bis 50 % der Registrierungen in Teilnahmen, und bei wissenschaftlichen und geschäftlichen Konferenzen vor Ort gibt es oft eine No-Show-Rate von 30 % bis 40 % Quelle. Dasselbe Muster spielt auch bei der Analytics-Arbeit eine Rolle, da Teams den Drop-off zwischen Absicht und tatsächlichem Datenverhalten einplanen müssen.
Was Data Analytics-Events wirklich sind und wie sie funktionieren
Ein nützlicher Weg, über ein Event nachzudenken, ist der als Beleg für eine Aktion. Ein Beleg besagt, was passiert ist, wann es passiert ist, und bietet genügend Kontext, um es später zu verstehen. Ohne diesen Kontext ist ein Beleg nur ein Zettel. In der Analytik wird ein roher Klick, ein Seitenaufruf, ein Absenden oder ein Fehler erst dann nützlich, wenn er in strukturierte Event-Daten umgewandelt wird.
Die drei Teile, auf die es ankommt
Jedes solide Event benötigt drei Zutaten. Die Aktion sagt Ihnen, was passiert ist, wie ein Seitenaufruf, ein Klick auf eine Schaltfläche oder das Absenden eines Formulars. Der Kontext sagt Ihnen, wo und wie es passiert ist, wie Seite, Gerät, User-ID oder App-Version. Die Zeit sagt Ihnen, wann es passiert ist, was wichtig ist, da das Timing oft die Bedeutung des Events verändert.
Praktische Regel: Wenn Sie die Aktion, den Kontext und die Zeit nicht in einfacher Sprache erklären können, ist das Event noch zu ungenau, um ihm zu vertrauen.
Diese Struktur ist der Grund, warum eventgesteuerte Analysen in Produkt, Marketing und Betrieb funktionieren. Ein Marketer kann sich den Kampagnen-Traffic ansehen. Ein Produktanalyst kann einen Trichter untersuchen. Ein Engineer kann einen Fehlerpfad zurückverfolgen. Sie stellen nicht dieselbe Frage, aber sie lesen alle dasselbe zugrunde liegende Signal.
Vom rohen Event zur Analytics-Pipeline
Die Reise beginnt in der Regel mit einer rohen Interaktion in einer App oder einem Dienst. Diese Interaktion wird als Event erfasst, über eine Streaming- oder Erfassungsschicht gesendet und landet dann in einem Data Warehouse oder Lakehouse, wo Analysten und Modelle sie nutzen können. Der wichtige Teil ist nicht nur die Bewegung, sondern die Konsistenz der Bedeutung bei jedem Schritt.
Häufig werden Events mit Entitäten oder Sitzungen verwechselt. Eine Entität ist das Objekt, um das es Ihnen geht, wie ein Benutzer oder ein Konto. Eine Sitzung ist ein begrenzter Aktivitätszeitraum. Ein Event ist eine einzelne beobachtete Tatsache. Wenn diese verschwimmen, fangen Teams an, Felder zu überladen, und das Modell lässt sich nur schwer erweitern.
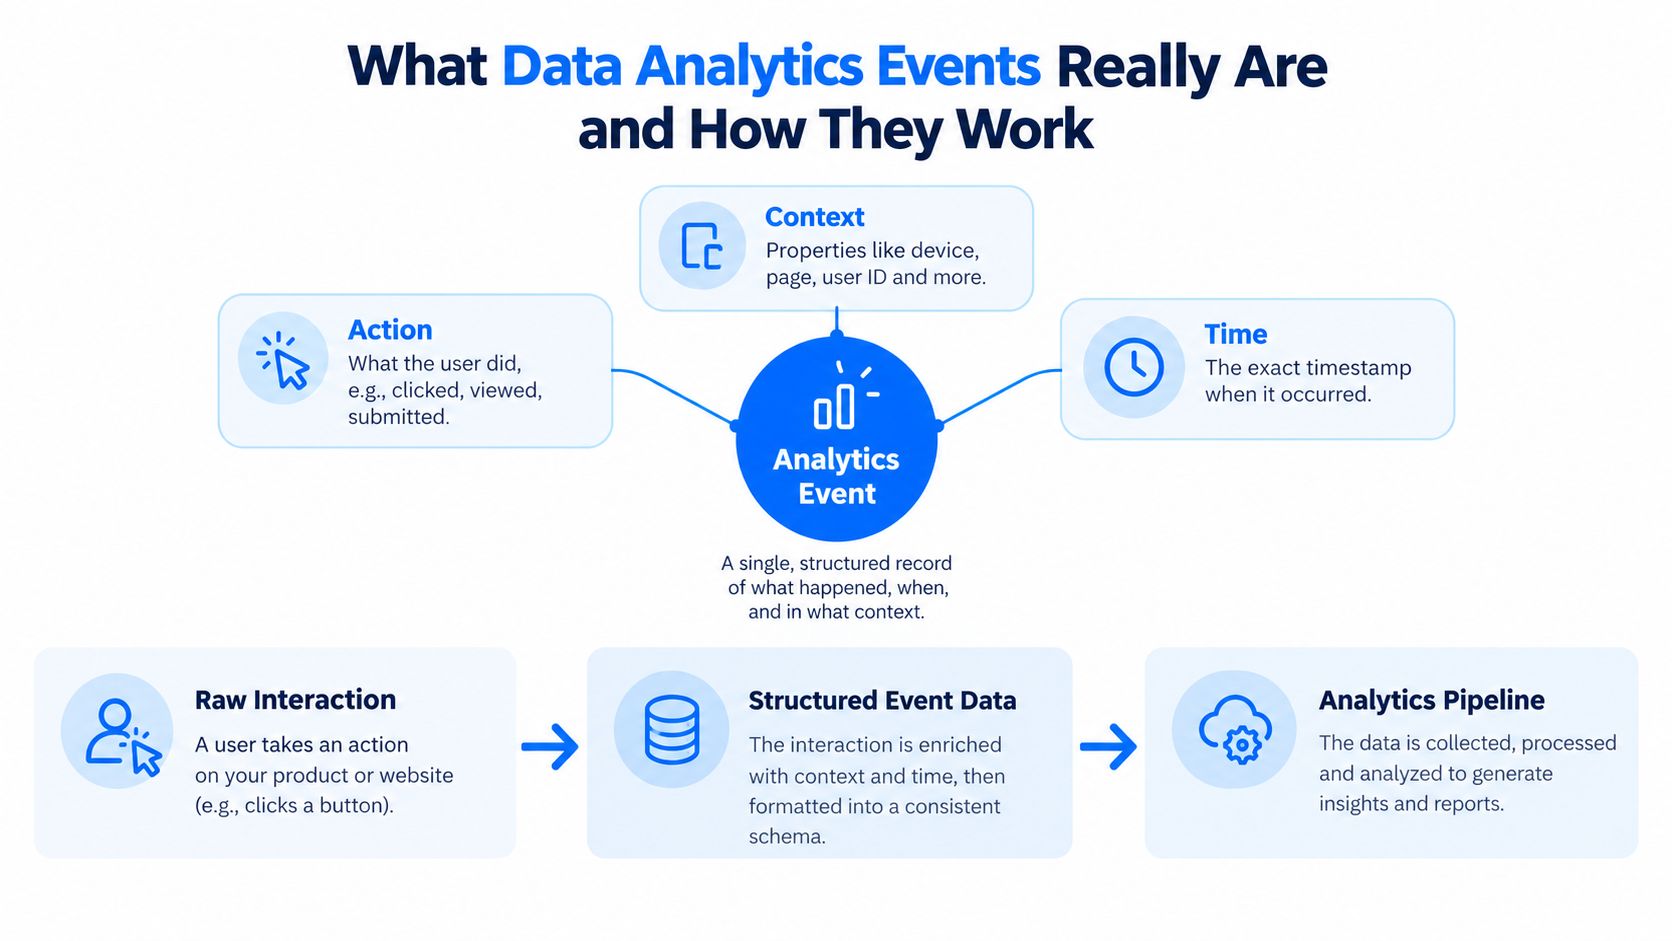
Wenn die Semantik stabil bleibt, wird die nachgelagerte Arbeit einfacher. Event-Daten können Dashboards, Experimente, Empfehlungsfunktionen und das operative Monitoring unterstützen, ohne dass jedes Team seine eigene Version der Wahrheit erfinden muss.
Ein Event-Modell entwerfen, das mit Ihrem Produkt skaliert
Ein skalierbares Event-Modell beginnt mit Zurückhaltung. Teams wollen oft alles auf einmal instrumentieren und enden dann mit einem überfüllten Katalog von fast identischen Events, die sechs Monate später niemand mehr erklären kann. Ein besseres Modell hält die Taxonomie klein, benennt die Dinge klar und trennt das, was passiert ist, von den Details drumherum.
Mit Kategorien beginnen, dann das Event sauber benennen
Eine dauerhafte Taxonomie beginnt meist mit breiten Kategorien wie Benutzeraktionen und System-Events. Von dort aus sollte die Namenskonvention konsistent bleiben, oft in einem Verb-Nomen-Stil wie user_signed_up oder invoice_failed. Dieses Muster hilft sowohl Menschen als auch Maschinen, das Event zu lesen, ohne raten zu müssen, welcher Teil die Aktion und welcher das Subjekt ist.
Die nächste Entscheidung ist, ob ein Detail in ein neues Event oder in ein Property gehört. Wenn die Kernaktion dieselbe ist, sich aber nur ein Attribut ändert, behalten Sie es als Property bei. Wenn sich die Bedeutung der Aktion selbst ändert, erstellen Sie ein neues Event. Diese Trennung verhindert, dass das Modell zu einer langen Liste von Sonderfällen wird.
Entscheiden, welche Felder erforderlich sind
Jedes Event sollte eine kurze Liste von erforderlichen Feldern haben, die den Datensatz nutzbar machen. Identität, Zeitstempel und der Kernkontext gehören meist hierher. Optionale Properties können Details hinzufügen, sollten aber für die grundlegende Interpretation nicht zwingend erforderlich sein, da dies die Instrumentierung fragil macht.
Auch die Identitätsauflösung erfordert gezielte Überlegungen. Ein Benutzer kann zuerst anonym erscheinen und sich später authentifizieren. Wenn das Modell diese Zustände nicht sauber verbinden kann, werden Trichteranalysen und Lifecycle-Reports ungenau. Dasselbe Event kann technisch gesehen immer noch gültig sein, während es analytisch unvollständig ist.
Für Teams, die eine Warehouse-First-Struktur anstreben, knüpft diese Idee eng an die Disziplin von Fakten- und Dimensionstabellen an. Events fungieren als Fakten, während die Kontextfelder den Analysten helfen, diese auf stabile Weise zu segmentieren.

Gute Event-Modelle machen zukünftige Fragen einfacher zu beantworten, nicht schwerer zu stellen.
Dokumentation ist ebenso wichtig wie die Benennung. Engineers benötigen die Implementierungsdetails, und Analysten brauchen Definitionen in einfachem Deutsch. Wenn beide Gruppen denselben Vertrag lesen können, führen Produktänderungen nicht mehr zu überraschenden Interpretationen.
Häufige Fallstricke, die Event-Daten korrumpieren, und wie man sie vermeidet
Die meisten Event-Probleme sehen anfangs nicht dramatisch aus. Die Pipeline läuft weiter. Das Dashboard aktualisiert sich weiterhin. Das Problem ist, dass die Daten mit der Zeit ungenauer werden, und die Korruption zeigt sich meist in Analysen, bevor sie in Warnmeldungen auftaucht.
Gesunde versus ungesunde Muster
Ungesundes Muster | Warum es schadet | Gesünderes Muster |
|---|---|---|
Inkonsistente Benennung | Geteilte Metriken, fehlerhafte Joins, verwirrte Leser | Standardisierte Benennung über Teams hinweg |
Fehlende Properties | Analysten verlieren den Kontext und greifen auf Vermutungen zurück | Erforderliche Felder für kritischen Kontext |
Überladene Properties | Ein Feld bedeutet zu viele Dinge | Single-Purpose-Events und klare Properties |
Doppeltes Auslösen | Trichter zählen zu viel, Attribution wird ungenau | Deduplizierung bei Erfassung oder Ingestion |
Implizite Standardwerte | Stillschweigende Ersetzung verbirgt echtes Verhalten | Explizite Werte und dokumentierte Regeln |
Das schwierigste Problem ist meist nicht böse Absicht, sondern Drift. Ein Producer ändert einen Feldnamen, entfernt ein Property oder sendet ein anderes Format, ohne das nachgelagerte Team zu informieren. Das ist der Grund, warum Schema-Drift so oft Datenpipelines unterbricht und warum der Event-Katalog eine aktive Governance benötigt.
Achten Sie auf Timing- und Zeitzonenfehler
Timing-Fehler sind leicht zu übersehen, da das Event immer noch ankommt. Es kommt nur im falschen Topf, am falschen Tag oder mit der falschen Zeitzonenannahme an. Bei operativen Metriken und Kohortenanalysen kann dies die Geschichte verfälschen, ohne dass die Abfrage fehlschlägt.
Doppelte Events verursachen eine andere Art von Schaden. Ein Benutzer klickt einmal, aber die Plattform zeichnet es zweimal auf. Ein Trichter-Schritt sieht erfolgreicher aus, als er ist. Ein Model-Feature wird künstlich aufgebläht. Die Lösung sind meist nicht mehr Dashboards, sondern klarere Erfassungsregeln und Validierungslogik.
Praktische Regel: Wenn ein Feld zwei verschiedene Dinge bedeuten kann, teilen Sie es auf, bevor sich die Ambiguität ausbreitet.
Die sicherste Gewohnheit zur Überprüfung besteht darin, jedes Event vom Producer bis zum Dashboard zu verfolgen und bei jedem Schritt eine Frage zu stellen: „Bedeutet das immer noch dasselbe?“ Wenn sich die Antwort ändert, muss der Vertrag überarbeitet werden, bevor sich weitere Konsumenten darauf verlassen.
Event-Qualität mit Verträgen und beobachtbaren Signalen validieren
Ein Data Analytics-Event sollte sich wie ein lebendiger Vertrag verhalten. Die Vereinbarung wird getroffen, bevor Code live geht, und die Pipeline prüft kontinuierlich, ob die realen Events in der Produktion immer noch dazu passen. Genau um diese Denkweise von Verträgen dreht sich der Leitfaden für Data Contracts.
Fünf Signale, die verschiedene Arten von Problemen aufdecken
Moderne Observability verfolgt in der Regel Freshness, Qualität, Volumen, Schema und Lineage, wie im Observability-Modell skizziert. Freshness fragt, ob die Daten wie erwartet eingetroffen sind. Qualität fragt, ob Werte und Typen immer noch Sinn ergeben. Volumen prüft, ob die Anzahl normal aussieht. Schema prüft, ob sich die Struktur geändert hat. Lineage zeigt, woher die Daten kamen und wie sie sich bewegt haben.
Jedes Signal deutet auf ein anderes Fehlermuster hin. Freshness fängt verspätete oder fehlende Lieferungen ab, bevor Dashboards driften. Deshalb sollten die Lieferfenster zur geschäftlichen Nutzung der Daten passen, wie in den Richtlinien zur Timeliness beschrieben. Das Schema-Monitoring fängt hinzugefügte, entfernte oder umbenannte Felder sowie Typänderungen ab – genau das, was das Monitoring von Schema-Drift aufdecken soll, wie im Überblick zum Schema-Monitoring dargestellt.
Baselines schlagen feste Schwellenwerte bei unregelmäßigem Traffic
Der Event-Traffic bleibt selten konstant. Launches, Kampagnen und Geschäftszyklen verändern die Form des Streams. Rollierende, saisonal bereinigte Baselines funktionieren bei vielen Event-Streams besser als feste Schwellenwerte, da sie das aktuelle Verhalten mit einem vergleichbaren Zeitraum abgleichen, anstatt davon auszugehen, dass jeder Tag identisch aussehen sollte, wie in den Praktiken zur Erkennung von Event-Drift empfohlen.
Die Vertragsvalidierung sollte so früh wie möglich erfolgen, idealerweise bei der Ingestion. Additive Änderungen können sicher sein, wenn sie die Abwärtskompatibilität wahren. Breaking Changes sollten isoliert werden. Rohe Felder sollten verfügbar bleiben, wenn eine automatische Anpassung die Bedeutung auslöschen würde. Diese Disziplin reduziert stillschweigende Fehler und verhindert, dass sich Fehlalarm-Rauschen im Team ausbreitet, wie in den Richtlinien für Event-Stream-Verträge beschrieben.
Signal | Was es beantwortet | Welchen Fehler es aufdecken kann |
|---|---|---|
Freshness | Kam es pünktlich an? | Verspätete Ladungen, verpasste Lieferungen |
Qualität | Sind die Daten valide? | Falsche Typen, ungültige Werte |
Volumen | Entspricht die Anzahl den Erwartungen? | Fehlende Batches, Flut doppelter Events |
Schema | Hat sich die Struktur geändert? | Hinzugefügte, entfernte, umbenannte Felder |
Lineage | Woher kam es? | Unklare Quelle, versteckte Transformation |
Das Ziel sind nicht mehr Regeln. Es geht darum, das Event-Verhalten so transparent zu machen, dass Analysten und Engineers den Daten vertrauen können, ohne jede Log-Zeile lesen zu müssen.
Event-Observability in die Praxis umsetzen mit digna
Die Operationalisierung der Event-Qualität bedeutet, die Pipeline wie ein Live-System zu behandeln, nicht wie ein statisches Asset. Teams brauchen eine Möglichkeit, die Lieferzeiten zu überwachen, strukturelle Änderungen zu erkennen und ungewöhnliches Verhalten aufzudecken, ohne für jedes Dataset eine eigene Regel definieren zu müssen.
digna tut dies, indem es in der eigenen Umgebung des Kunden läuft und Prüfungen direkt in der Datenbank berechnet, sodass die Daten an Ort und Stelle bleiben. Sein Modulsatz umfasst Timeliness, Schema-Tracking, Data Validation und Data Anomalies mit einem gemeinsamen Dashboard für Engineers, Analysten und Governance-Verantwortliche. Dieses Setup ist wichtig, da derselbe Event-Stream oft gleichzeitig für das Reporting, Alerting und als Modell-Input dienen muss.
Für Teams, die eine breitere operative Referenz suchen, zeigt der Überblick über Data Observability, wie diese Teile in Produktionsumgebungen zusammenpassen. Die Kernidee ist einfach. Timeliness-Prüfungen verifizieren die erwarteten Lieferfenster. Das Schema-Tracking fängt hinzugefügte oder entfernte Felder sowie Typänderungen ab. Die Anomalieerkennung kann normales Verhalten erlernen und Abweichungen ohne manuell erstellte Regeln aufzeigen.
Diese Mischung ist besonders nützlich, wenn Produktteams häufig Deployments durchführen. Eine Änderung, die in einem Pull-Request harmlos aussieht, kann dennoch das Event-Format verschieben, einen Feed verzögern oder nachgelagerte Zahlen verändern. Das Monitoring fängt die Auswirkungen dort ab, wo es darauf ankommt: auf dem tatsächlichen Datenpfad.
Wenn Sie operative Tools für event-intensive Systeme vergleichen, ist die Referenz zu Vorhersagemarkt-Tools ein nützlicher Vergleich dafür, wie sich Observability-Konzepte in anderen ereignisgesteuerten Workflows widerspiegeln. Die allgemeine Lektion lässt sich nahtlos übertragen, denn Event-Daten werden dann vertrauenswürdig, wenn die Qualität kontinuierlich gemessen und nicht erst nach dem Deployment vorausgesetzt wird.
Zuverlässige Analytics-Events für die Zukunft aufbauen
Zuverlässige Events entstehen nicht zufällig. Sie resultieren aus einer Kette von Entscheidungen, von der ersten Definition einer Aktion bis hin zu den Prüfungen, die diese Definition im Laufe der Zeit aufrechterhalten. Wenn ein Glied schwach ist, spürt das der gesamte Analytics-Stack.
Der einfachste Weg zur Priorisierung besteht darin, drei Fragen zu stellen. Welche Events treiben die wichtigsten Entscheidungen an? Welche neigen am ehesten zu Drift, wenn sich das Produkt ändert? Bei welchen fehlt ein klarer Owner? Beheben Sie diese zuerst, da dies die Events sind, die am ehesten stillen analytischen Schaden anrichten.
Die Ownership ist ebenso wichtig wie die Tools. Engineers müssen wissen, wer Schema-Änderungen freigibt. Analysten müssen wissen, welche Definitionen stabil sind. Governance-Teams benötigen Transparenz darüber, was sich wann geändert hat. Wenn diese Rollen klar sind, ist Event-Qualität nicht mehr das Problem aller, sondern ein gemanagter Prozess.
Der langfristige Gewinn sind nicht nur sauberere Dashboards. Es sind schnellere Analysen, weniger Nacharbeit und mehr Vertrauen, wenn Teams Analysen zur Steuerung von Produkten und KI-Systemen nutzen. Wenn sich Ihr Event-Katalog immer noch fragil anfühlt, überprüfen Sie die Definitionen, straffen Sie die Verträge und rücken Sie Observability auf den kritischen Pfad, bevor der nächste stille Drift in der Produktion landet.
Wenn Sie nach einem praktischen Weg suchen, um das Vertrauen in Event-Daten zu stärken, besuchen Sie digna und sehen Sie sich an, wie sich die In-Database-Validierung, das Schema-Tracking, das Timeliness-Monitoring und die Anomalieerkennung in einen einzigen operativen Workflow integrieren lassen. Es ist für Teams konzipiert, die darauf angewiesen sind, dass zuverlässige Analytics-Events auch bei ständigen Änderungen an Produkten, Pipelines und Konsumenten zuverlässig bleiben.
Häufig gestellte Fragen
Was ist ein Data-Analytics-Event?
Eine Quittung für eine Handlung. Jedes belastbare Event braucht drei Zutaten: die Handlung, den Kontext und die Zeit. Wer diese drei nicht in klarer Sprache erklären kann, hat ein Event, das noch zu unscharf ist, um ihm zu vertrauen, egal was der Tracking-Plan sagt.
Wie unterscheidet sich ein Event von einer Entität oder Session?
Ein Event hält fest, dass zu einem Zeitpunkt etwas geschah, eine Entität beschreibt ein fortbestehendes Ding, und eine Session bündelt Aktivität in einem Zeitfenster. Die drei zu vermischen ist ein häufiger Modellierungsfehler und der Grund, warum nachgelagerte Kennzahlen nicht mehr zueinander passen.
Wie benennt und strukturiert man Events?
Beginnen Sie mit Zurückhaltung. Bauen Sie eine haltbare Taxonomie aus breiten Kategorien wie Nutzeraktionen und Systemereignissen und entscheiden Sie dann bewusst, ob ein neues Detail ein eigenes Event oder eine Eigenschaft wird. Jedes Event braucht zudem eine kurze Liste von Pflichtfeldern, die den Datensatz nutzbar machen.
Warum driften Eventdaten?
Weil sich Bedeutung schneller ändert als Tracking-Code. Ein Event bleibt technisch vorhanden, während sich seine Semantik darunter verschiebt, sodass Dashboards ruhig wirken, während die Zahlen nicht mehr zu dem passen, was Vertrieb, Produkt und Support sehen. Ein Event nützt nur, solange seine Bedeutung stabil genug bleibt.
Warum verlangt Identity Resolution bewusste Entscheidungen?
Weil sie bestimmt, ob Events über dieselbe Person tatsächlich zusammenfinden. Legen Sie die nötigen Identitätsfelder beim Entwurf des Modells fest statt sie später nachzurüsten, und dokumentieren Sie die Entscheidung, denn Dokumentation zählt hier genauso viel wie die Benennung.



