8 Data Governance KPIs, die Sie 2026 messen sollten
|
8
min. Lesezeit

Die meisten Governance-Programme scheitern nicht daran, dass niemand Richtlinien verfasst hat. Sie scheitern, weil Teams nicht nachweisen können, dass diese Richtlinien das Geschehen in der Produktion verändern. Ein Enterprise-Governance-Benchmark für 2025 ergab, dass 71 % der Organisationen ein formelles Data Governance-Programm betreiben, im Vergleich zu 60 % zwei Jahre zuvor (2025 enterprise governance benchmark). Die formelle Einführung nimmt zu, doch derselbe Benchmark identifizierte die Datenqualität mit 56 % als das größte geschäftliche Problem, dicht gefolgt von Governance mit 54 %. Die Schlussfolgerung ist eindeutig: Das Dokumentieren von Eigentümerschaft und das Veröffentlichen von Standards reicht nicht aus. Führungskräfte benötigen den Nachweis, dass Kontrollen funktionieren, Daten zuverlässig ankommen, Vorfälle eingegrenzt werden und Entscheidungen sicherer werden.
Die folgenden acht Data Governance-KPIs bilden ein zusammenhängendes Messsystem. Die Abdeckung zeigt, wo Governance existiert, die Durchsetzung zeigt, ob Kontrollen funktionieren, Qualität und Timeliness zeigen den Zustand der Daten, und Vorfall-, Schema- und Geschäftskennzahlen zeigen, ob Governance Entscheidungen schützt. Jeder KPI umfasst Berechnungslogik, Implementierungsoptionen und Abwägungen.
Bevor Sie irgendetwas berechnen, definieren Sie den Anlagenbestand, den Eigentümer, das Messfenster, die Kritikalitätsstufe, den Zielschwellenwert und die Erwartung an die Reaktion auf Warnmeldungen. Ein Wert ohne benannten Eigentümer ist ein Bericht. Ein Wert, der an einen Behebungspfad gebunden ist, ist eine Kontrolle.
Inhaltsverzeichnis
7. Adoptions- und Durchsetzungsrate von Data Governance-Richtlinien
Verwandeln Sie acht Kennzahlen in einen operativen Governance-Rhythmus
1. Datenqualitätswert
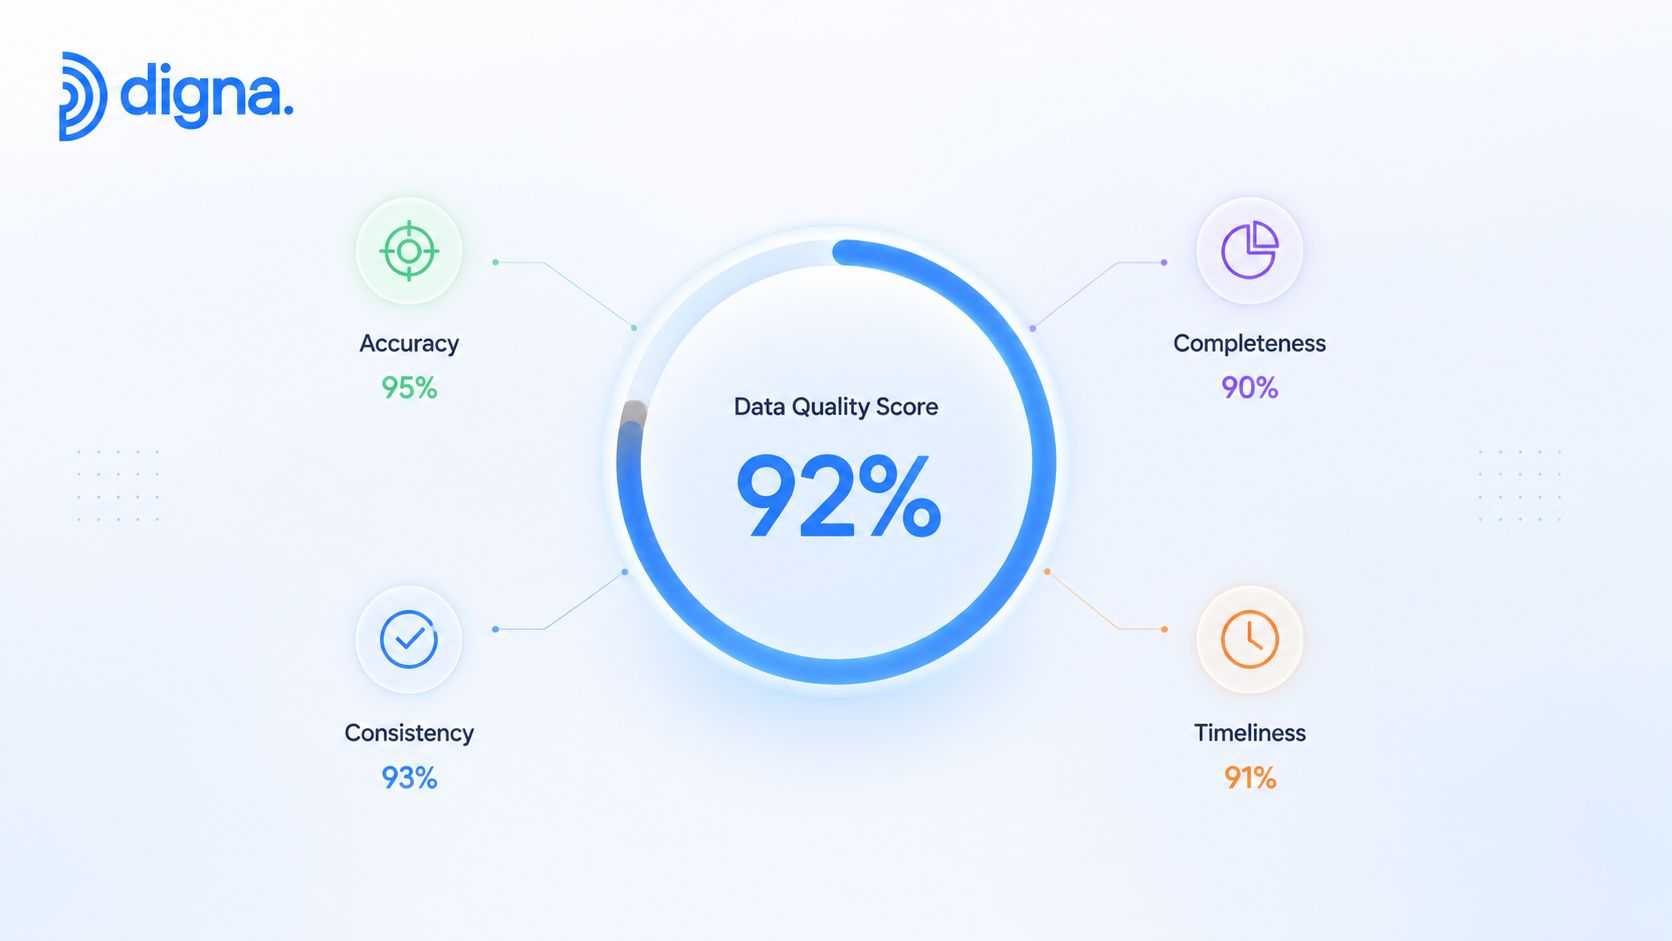
Ein Datenqualitätswert ist das Zustandssignal im Messsystem aus acht KPIs. Die Abdeckung zeigt, wo Governance existiert, die Durchsetzung zeigt, ob Kontrollen funktionieren, während dieser Wert zeigt, ob kritische Daten für Berichterstattung, Betrieb, Compliance oder KI-Workflows geeignet sind. Zu den gängigen Dimensionen gehören Genauigkeit, Vollständigkeit, Konsistenz, Timeliness und Eindeutigkeit. Teams können den Leitfaden für Datenqualitätsmetriken nutzen, um diese Dimensionen zu definieren und zu kombinieren, ohne das Gesamtergebnis als Diagnose zu betrachten.
Eine einfache Berechnung lautet:
Datenqualitätswert = Summe der Dimensionswerte multipliziert mit ihren zugewiesenen Gewichtungen
Die Gewichtungen sollten der Verwendung des jeweiligen Datensatzes entsprechen. Ein regulatorischer Bericht kann Gültigkeit und Vollständigkeit stärker gewichten, während ein operatives Dashboard in Fast-Echtzeit der Aktualität Priorität einräumen kann. Ein gemeinsamer Unternehmenswert verbessert die Vergleichbarkeit, aber datensatzspezifische Werte bewahren den Kontext, der erforderlich ist, um Eigentümer und Behebungsmaßnahmen zu identifizieren.
Bauen Sie den Wert um kritische Assets herum auf
Beginnen Sie mit einer definierten Gruppe kritischer Datensätze, anstatt den gesamten Bestand zu bewerten. Dokumentieren Sie für jedes Asset die gemessenen Dimensionen, Validierungsregeln, die Anomalie-Baseline, die Timeliness-Erwartung, den Eigentümer und den Eskalationspfad. Priorisieren Sie Daten, die mit Berichterstattung, Compliance, Kundenbetrieb oder KI-Workflows verknüpft sind, und erweitern Sie die Abdeckung, sobald der Messprozess stabil ist.
Der Wert sollte operative Risiken offenlegen, nicht verbergen. Ein schlechteres Ergebnis bei der Vollständigkeit kann auf eine geplante Quellsystemänderung, einen fehlerhaften Pipeline-Prozess ohne Eigentümer oder einen wiederkehrenden vorgelagerten Fehler zurückzuführen sein. Diese Ursachen erfordern unterschiedliche Reaktionen. Verknüpfen Sie daher den Vorfallskontext und die Ergebnisse auf Dimensionsebene mit der Management-Ansicht.
Praktische Regel: Ein Gesamtwert sollte Untersuchungen auslösen, sie aber nicht ersetzen.
Die Anleitung von digna ist relevant, wenn Teams Validierungsergebnisse, Anomaliesignale und Timeliness-Beobachtungen kombinieren und die Berechnung gleichzeitig in ihrer eigenen Umgebung belassen. Die Ausführung in der Datenbank kann zudem die Notwendigkeit verringern, sensible Daten aus der genehmigten Infrastruktur herauszubewegen.
2. Data Validation-Erfolgsquote
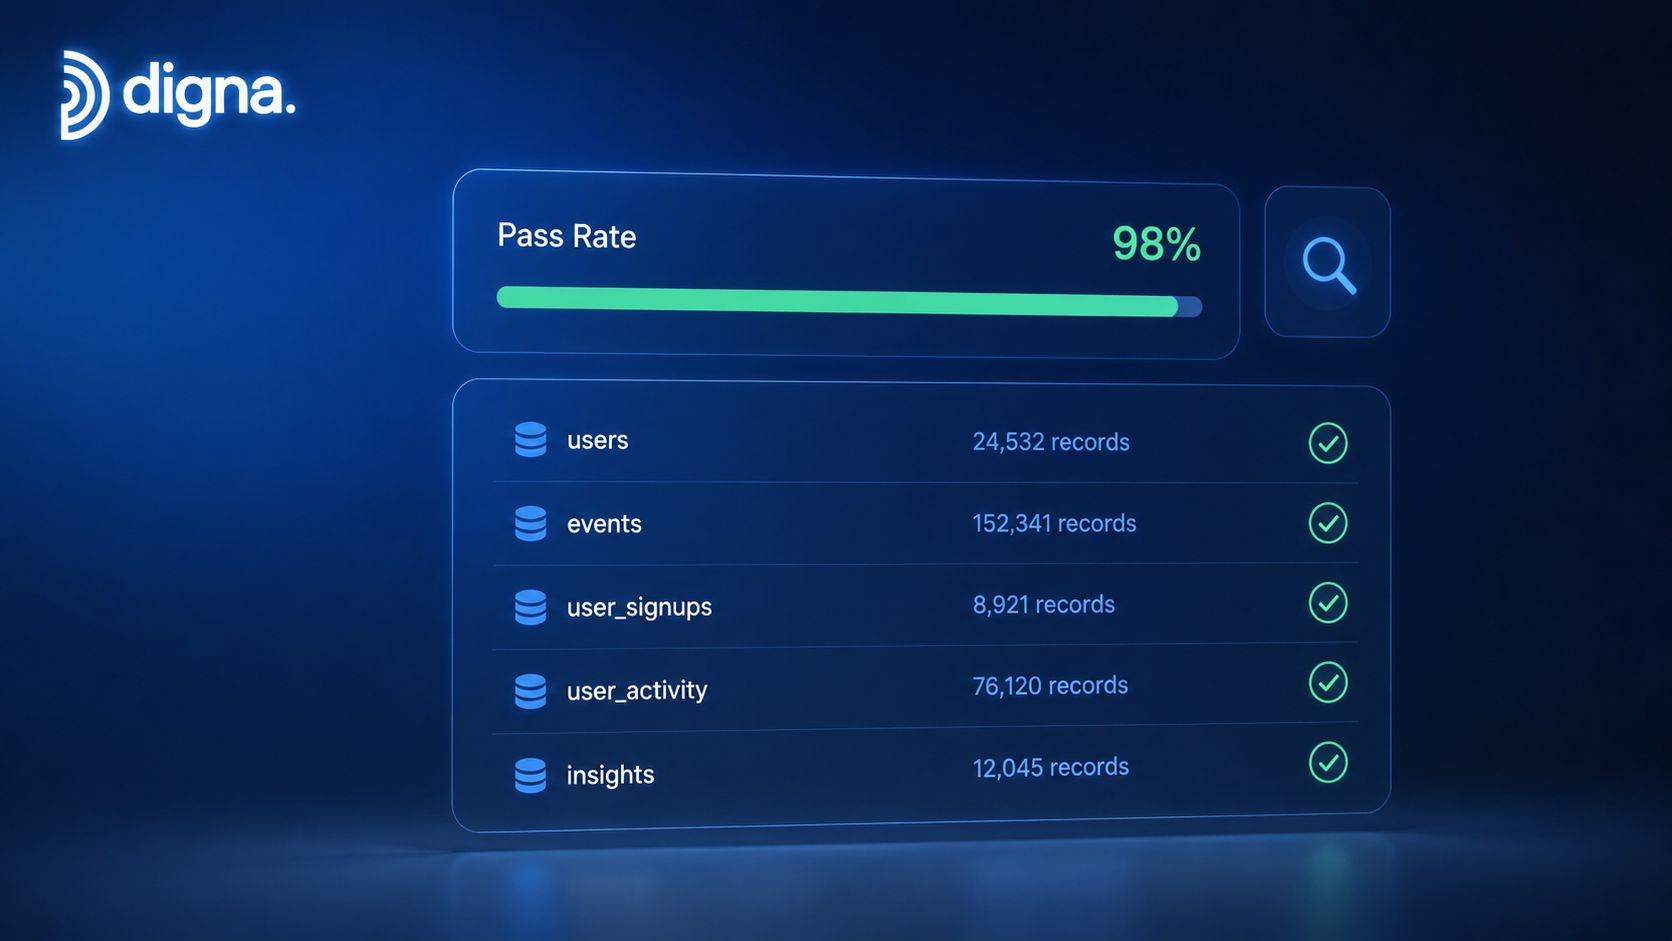
Eine Data Validation-Erfolgsquote zeigt, ob geregelte Vorgaben auf tatsächlichen Datensätzen angewendet werden. Sie misst den Anteil der Datensätze, die definierte geschäftliche und strukturelle Prüfungen in einem bestimmten Zeitraum bestehen, und verbindet so Richtlinienvorgaben mit der Leistung von Kontrollen.
Data Validation-Erfolgsquote = Datensätze, die alle anwendbaren Prüfungen bestehen, geteilt durch die Gesamtzahl der bewerteten Datensätze, multipliziert mit 100
Berechnen Sie den KPI auf Regel-, Datensatz- und Domänenbene. Die aggregierte Quote zeigt die allgemeine Durchsetzung, während Ergebnisse auf Regelebene Fehler bei Adressen, Identifikatoren, Datumsangaben, finanziellen Beziehungen oder anderen Feldern aufzeigen. Da ein einzelner Datensatz mehrere Prüfungen nicht bestehen kann, weisen Sie betroffene Datensätze getrennt von den gesamten Regelfehlern aus. Diese Unterscheidung verhindert, dass wiederholte Fehler in einer kleinen Datensatzgruppe das operative Gesamtbild verzerren.
Machen Sie Fehler nachvollziehbar
Priorisieren Sie Regeln, die mit Berichterstattung, Compliance, KI-Eingaben oder der Dienstleistungserbringung verknüpft sind. Deterministische Prüfungen unterstützen einen konsistenten Vergleich, aber aggregierte Zahlen reichen nicht aus. Überprüfen Sie Stichproben fehlerhafter Datensätze und klassifizieren Sie die Ursache, wie etwa einen vorgelagerten Konfigurationsfehler, eine geänderte Quelldefinition oder einen Prozess, der ungültige Werte zulässt.
Das Risiko des Anwendungsfalls sollte die Toleranz bestimmen. Kontrollen für die Finanzberichterstattung erfordern im Allgemeinen engere Grenzen als explorative Analysen. Die Schema-Validierung kann berechnet werden als Datensätze, die Schema-Prüfungen bestehen, geteilt durch die Gesamtzahl der Datensätze. Veröffentlichte Benchmarks für Data Governance-KPIs beschreiben Zielwerte von über 99,5 % und betrachten Ergebnisse unter 98 % als Warnsignal. Diese Schwellenwerte müssen jedoch an die Kritikalität der Daten und den Regelbereich angepasst werden.
Die Regeln und Prüfungen zur Data Validation von digna unterstützen Tests auf Datensatzebene anhand von Geschäftslogik und Audit-Anforderungen. Kombinieren Sie die Erfolgsquote mit der Regeleignerschaft, der Anzahl fehlerhafter Datensätze und der Behebungszeit. Eine hohe Quote ohne Überprüfung von Fehlern kann eher auf schwache Kontrollen als auf fehlerfreie Daten hindeuten.
3. Data Timeliness SLA-Einhaltung
Verspätete Daten können eine ansonsten korrekte Entscheidung unbrauchbar machen. Die Data Timeliness SLA-Einhaltung misst, ob erwartete Lieferungen innerhalb des vereinbarten Zeitfensters eintreffen, und verbindet so die Zuverlässigkeit der Pipelines mit der Aktualität von Dashboards, operativen Workflows und der Entscheidungslatenz. Sie bildet die Zustandsebene des KPI-Systems: Die Abdeckung zeigt, wo Governance existiert, die Durchsetzung zeigt, ob Kontrollen funktionieren, und die Timeliness zeigt, ob regulierte Daten nutzbar sind, wenn Entscheidungen sie erfordern.
Timeliness SLA-Einhaltung = rechtzeitig verfügbare Datenlieferungen geteilt durch die Gesamtzahl der erwarteten Lieferungen, multipliziert mit 100
Berechnen Sie den Zähler anhand von zeitgestempelten Lieferprotokollen. Berücksichtigen Sie jede erwartete Lieferung im Nenner, auch fehlende Ladevorgänge. Das Ausschließen fehlender Daten lässt die Leistung genau dann besser erscheinen, wenn die Pipeline ausfällt.
Richten Sie den Zeitplan nach den geschäftlichen Anforderungen aus
Legen Sie das SLA auf Basis der nachgelagerten Anforderungen fest, nicht anhand der aktuellen Pipeline-Leistung. Ein klinisches Ergebnis, das für einen Entlassungs-Workflow benötigt wird, hat eine andere Dringlichkeit als ein monatlicher Planungs-Extrakt. Berücksichtigen Sie Monatsenden, Quartalsenden, Feiertage, Wartungsfenster und andere Kalenderabweichungen, bevor Sie eine Verzögerung eskalieren.
Ein veröffentlichter Benchmark empfiehlt eine Einhaltung der Timeliness von mindestens 98 % für kritische operative Daten (timeliness KPI definition and formula). Eine separate Governance-Referenz setzt die Einhaltung des Aktualitäts-SLAs bei über 99 % an und betrachtet Werte unter 95 % als Warnsignal. Diese Zahlen sind Richtwerte, keine universellen Ziele. Der angemessene Schwellenwert hängt von den geschäftlichen Konsequenzen, der Lieferfrequenz und den Kosten verspäteter Daten ab.
Der Ansatz zur Überwachung der Data Timeliness von digna nutzt erwartete Liefermuster, um Verzögerungen, fehlende Lieferungen und vorzeitige Eingänge zu identifizieren. Setzen Sie verfehlte SLAs in Beziehung zur Job-Laufzeit, Warteschlangentiefe, Quellenverfügbarkeit und zu Infrastrukturereignissen. Diese Analyse unterscheidet einen Pipeline-Fehler von einer Einschränkung der Betriebsumgebung und bietet den Eigentümern einen klareren Weg zur Behebung.
4. Erkennungsrate kritischer Datenvorfälle
Ein Governance-Programm kann keine Vorfälle reduzieren, die es nicht erkennt. Die Erkennungsrate kritischer Datenvorfälle misst, wie viele relevante Anomalien, Qualitätsmängel und Schemaänderungen die Überwachung innerhalb eines definierten Reaktionsfensters aufdeckt.
Die Grundformel lautet:
Erkennungsrate = kritische Vorfälle, die innerhalb des Zielfensters erkannt wurden, geteilt durch kritische Vorfälle, die durch alle verfügbaren Nachweise identifiziert wurden, multipliziert mit 100
Der schwierige Teil ist der Nenner. Teams können Vorfälle durch Überwachung, Benutzerbeschwerden, fehlerhafte Berichte, Audit-Prüfungen oder nachgelagerte Abgleiche entdecken. Diese Erkennungskanäle sollten abgeglichen werden, damit das KPI-System ein Überwachungssystem nicht dafür belohnt, dass es nur seine eigenen Warnungen meldet.
Messen Sie das Signal, nicht das Warnungsvolumen
Beginnen Sie mit Datensätzen, die eine hohe Auswirkung haben, und definieren Sie, was als kritisch gilt. Eine plötzliche Verschiebung der Verteilung in einem regulatorischen Datensatz erfordert unter Umständen eine sofortige Eskalation, während eine saisonale Schwankung in einer explorativen Tabelle dies eventuell nicht erfordert. Verfolgen Sie die Erkennungslatenz, Fehlalarme und den Weg von der Warnung zum Ticket. Eine Erkennung ohne Nachweis einer Reaktion bietet nur unvollständigen Schutz.
Die Anomalieerkennungsfunktionen von digna kombinieren das Erlernen von Baselines mit Validierung und Schemaverfolgung. Diese Kombination ist wichtig, da ein geschäftlich sichtbarer Vorfall in einer Werteverteilung, einer Regelverletzung oder einer strukturellen Änderung seinen Ursprung haben kann.
Ein Überwachungsteam sollte sich bei jedem Vorfall zwei Fragen stellen: „Haben wir ihn früh genug erkannt?“ und „Hat der richtige Eigentümer gehandelt?“
Überprüfen Sie regelmäßig Muster von Fehlalarmen. Bekannte saisonale Ereignisse, geplante Migrationen und wiederkehrendes Batch-Verhalten sollten in die Feinabstimmung der Baseline einfließen. Das Ziel besteht nicht darin, die Anzahl der Warnmeldungen zu maximieren. Es geht darum, folgenschwere Fehler früh genug aufzudecken, um fehlerhafte Berichte, fehlerhafte Modelle oder unzuverlässige regulatorische Ergebnisse zu verhindern.
5. Erkennungs- und Behebungszeit von Schemaänderungen
Schemaänderungen können Fehler verursachen, die herkömmliche Qualitätsprüfungen übersehen. Eine entfernte Spalte oder ein inkompatibler Typ kann eine Pipeline stoppen, während eine Änderung eines optionalen Feldes die nachgelagerte Logik durchlaufen und verändern kann, ohne dass dies sofort bemerkt wird. Die Erkennungs- und Behebungszeit von Schemaänderungen misst die verstrichene Zeit von der Erkennung der Strukturänderung bis zur bestätigten Anpassung durch nachgelagerte Verbraucher.
Behebungszeit = Zeitstempel der bestätigten nachgelagerten Anpassung minus Zeitstempel der Erkennung der Änderung
Verfolgen Sie die durchschnittliche, die mittlere und die im schlimmsten Fall aufgetretene Behebungszeit separat. Der Durchschnitt fasst die Gesamtleistung zusammen, der Median zeigt die typische Betriebsgeschwindigkeit und das Maximum verdeutlicht das Eskalationsrisiko. Stoppen Sie die Uhr erst nach der Bestätigung der nachgelagerten Anpassung, nicht schon, wenn jemand eine Warnung zur Kenntnis nimmt oder ein Ticket erstellt.
Klassifizieren Sie Änderungen, bevor sie eintreffen
Ein Runbook sollte dringende Änderungen von solchen trennen, die für eine geplante Überprüfung geeignet sind. Das Entfernen von Spalten, inkompatible Typänderungen und geänderte Schlüsselsemantiken erfordern im Allgemeinen eine schnelle Eskalation. Neue optionale Spalten können in eine Überprüfungswarteschlange aufgenommen werden, wenn sie nachgelagerte Verträge nicht beeinträchtigen.
Eigentümerschaft und Lineage verkürzen die Untersuchung, da Ingenieure betroffene Verbraucher identifizieren können, ohne während eines Vorfalls Abhängigkeiten rekonstruieren zu müssen. Dokumentieren Sie die Bedeutung von Spalten, die Quelleneignerschaft, die Transformationslogik und die nachgelagerte Nutzung. Koordinieren Sie geplante Änderungen mit der Versionskontrolle für SQL-, dbt- und Python-Transformationen.
Der Leitfaden zur Erkennung und Überwachung von Schema-Drift von digna deckt die Verfolgung von hinzugefügten oder entfernten Spalten sowie von Datentypänderungen ab. Der KPI sollte daher mehr als nur die Erkennungsabdeckung testen. Er sollte zeigen, ob jede wesentliche Änderung den richtigen Eigentümer erreicht hat und sicher angepasst wurde, wodurch die Durchsetzung der Governance mit der Zuverlässigkeit von Pipelines und dem Entscheidungsrisiko verknüpft wird.

6. Effektivität der Anomalieerkennung bei Geschäfts-KPIs
Technische Qualitätswerte schützen Entscheidungen nur dann, wenn sie aufzeigen, ob geschäftliche Kennzahlen vertrauenswürdig bleiben. Die Effektivität der Anomalieerkennung bei Geschäfts-KPIs misst den Anteil an bedeutsamen Änderungen bei wichtigen Kennzahlen, die innerhalb einer akzeptablen Latenzzeit erkannt, erklärt und eskaliert werden.
Effektivität = erkannte und korrekt eskalierte bedeutsame geschäftliche Änderungen geteilt durch die durch Überprüfung bestätigten bedeutsamen Änderungen, multipliziert mit 100
Der Nenner erfordert einen dokumentierten Überprüfungsprozess. Klassifizieren Sie jede überprüfte Warnung als echte geschäftliche Veränderung, als Datenqualitätsproblem, als Pipeline-Problem oder als Fehlalarm. Diese Kennzeichnungen verbinden Geschäftsergebnisse mit den zugrunde liegenden Datenqualitätsmetriken und liefern Analysten gleichzeitig Anhaltspunkte zur Feinabstimmung von Schwellenwerten und zur Reduzierung vermeidbarer Untersuchungen.
Definieren Sie „bedeutsam“ gemeinsam mit Entscheidungsträgern
Führungskräfte priorisieren möglicherweise Umsatz, Kundenaktivität, Transaktionsvolumen oder operative Effizienz. Datenteams überwachen eventuell die Quelltabellen und Transformationen, die diese Kennzahlen erzeugen. Die Kontrolle ist nur dann effektiv, wenn beide Ansichten miteinander verknüpft sind: Eine Warnung sollte die Kennzahl, den historischen Kontext, zugehörige Datenänderungen und den Verantwortlichen für die Untersuchung identifizieren.
Die Business-Monitoring-Funktion von digna unterstützt die Analyse von geschäftlichen und operativen Kennzahlen. Das Modul Data Analytics kann Teams dabei helfen, historische Volatilität und Saisonalität zu untersuchen, bevor sie Empfindlichkeitsstufen festlegen. Dies ist wichtig für Kennzahlen, die durch Kalendermuster, Werbezyklen oder Meldeschlüsse beeinflusst werden, bei denen ein fester Schwellenwert wiederholt Fehlalarme auslösen kann.
Die beste Warnung vor einer geschäftlichen Anomalie hilft einem Entscheidungsträger festzustellen, ob sich das Geschäft oder die Daten geändert haben.
Überprüfen Sie die Ergebnisse regelmäßig. Vergleichen Sie Erkennungs- und Eskalationsergebnisse nach Kennzahl, Geschäftsbereich und Ursachenkategorie. Ein sinkender Wert kann auf eine schwache Überwachungsabdeckung hindeuten, während ein hohes Warnungsvolumen mit wenigen bestätigten Anomalien auf unzureichende Schwellenwerte hindeuten kann. Die Verknüpfung von Kennzeichnungen mit Quellvorfällen, Schemaereignissen und Validierungsfehlern macht diesen KPI von einer bloßen Warnungszählung zu einem Nachweis dafür, dass Governance operative Entscheidungen schützt.
7. Adoptions- und Durchsetzungsrate von Data Governance-Richtlinien
Eine dokumentierte Richtlinie hat nur begrenzten Wert, solange sie nicht durch eine Kontrolle getestet wird und jemand auf Ausnahmen reagiert. Dieser KPI misst, wie umfassend genehmigte Richtlinien durch Überwachung, Validierung, Zugriffskontrollen, Timeliness-Prüfungen, Schemakontrollen oder andere Mechanismen implementiert sind.
Durchsetzungsrate = Richtlinien mit aktiven, getesteten Kontrollen geteilt durch die Gesamtzahl der definierten Richtlinien, multipliziert mit 100
Definieren Sie den Nenner, bevor Sie den Fortschritt messen. Berücksichtigen Sie formelle Standards und dokumentierte Betriebsregeln, und trennen Sie genehmigte Richtlinien von angestrebten Leitlinien. Andernfalls kann das Hinzufügen von Richtlinien die Rate senken, selbst wenn sich die Abdeckung durch Kontrollen verbessert.
Messen Sie den Reifegrad der Automatisierung
Ein Benchmark ergab, dass 61 % der Organisationen Richtlinien eingeführt hatten, aber nur 38 % über eine automatisierte Durchsetzung verfügten (governance maturity benchmark). Diese Kluft macht reine Richtlinienstatistiken zu einem schwachen Nachweis. Eine Richtlinie kann in einem Dokument existieren, ohne dass eine Systemprüfung, ein verantwortlicher Eigentümer oder ein handlungsrelevanter Pfad für Ausnahmen vorhanden ist.
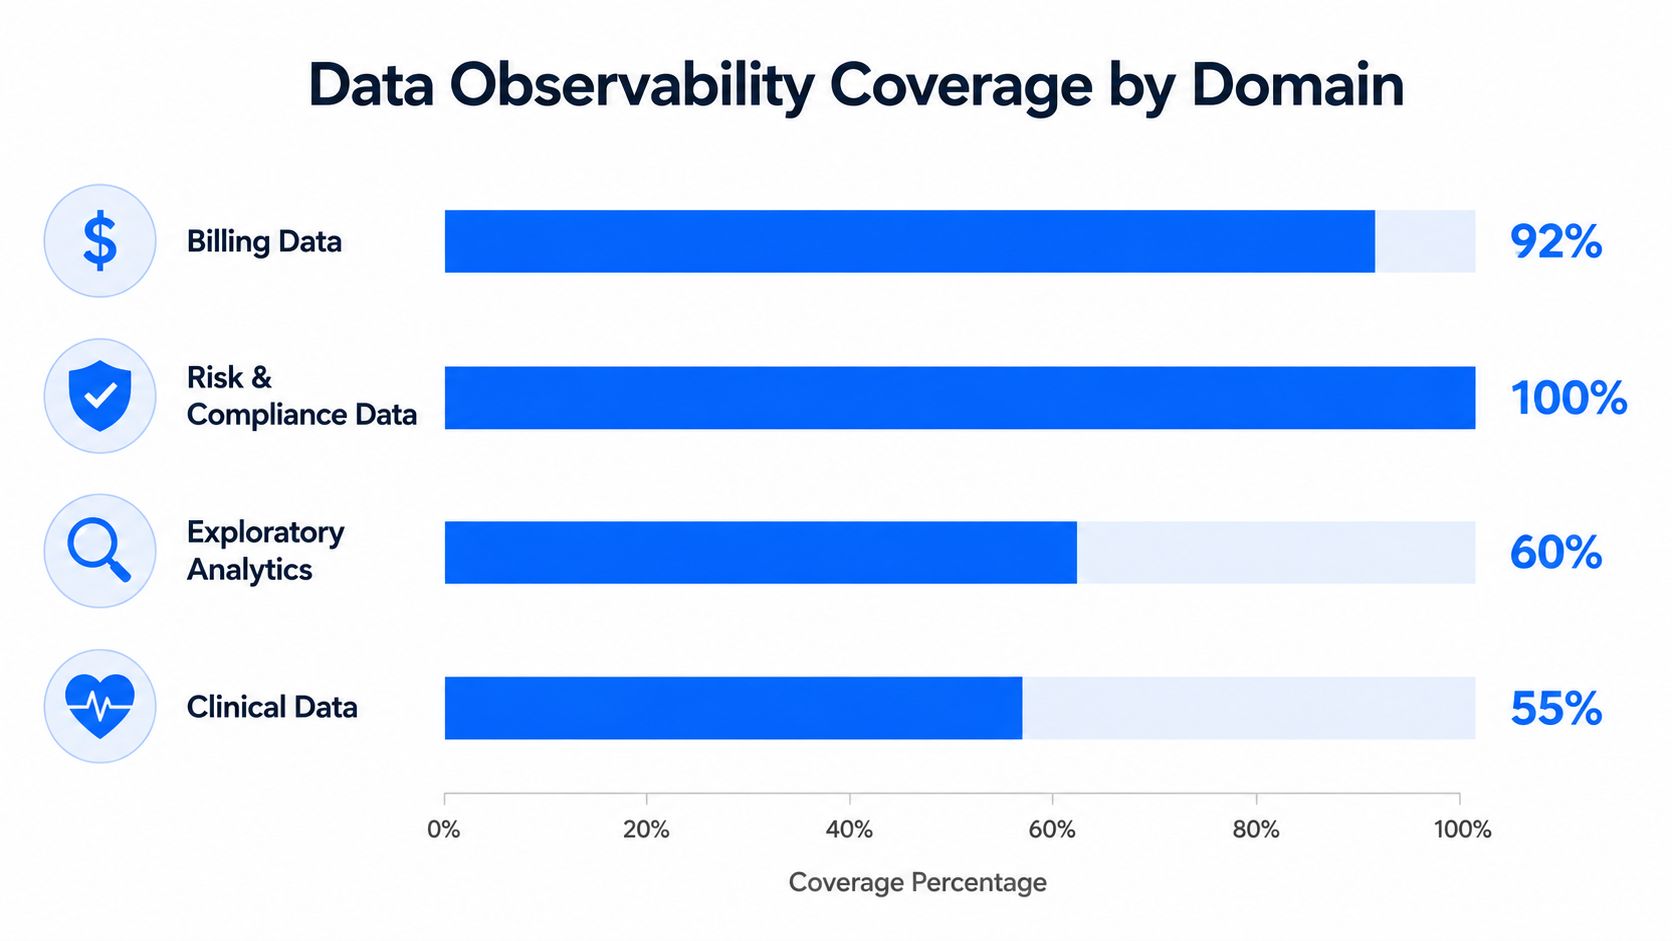
Ordnen Sie jede Richtlinie ihrer Kontrolle, dem Datensatzbereich, dem Eigentümer, der Testfrequenz, dem Ausnahmeverfahren und dem Speicherort der Nachweise zu. Melden Sie die Ergebnisse nach Domäne und Risikostufe, nicht nur als Unternehmensdurchschnitt. Eine Organisation im Gesundheitswesen stellt beispielsweise fest, dass Abrechnungskontrollen automatisch ablaufen, während klinische Kontrollen weiterhin manuell durchgeführt werden.
Die Überwachung der Timeliness liefert ebenfalls Belege für die Durchsetzung. Die Verfolgung, ob Daten die vereinbarten Service-Levels erfüllen, hilft zu überprüfen, ob eine Richtlinie in der Produktion aktiv ist und nicht nur in der Dokumentation existiert. Siehe den Leitfaden zu Definitionen, Metriken und Überwachung der Data Timeliness.
Die Adoption umfasst auch das Verhalten nach einer Erkennung. Verfolgen Sie die Bestätigung von Warnmeldungen, die Behebung von Ausnahmen und die Einhaltung von Workflows. Eine automatisierte Kontrolle, deren Ergebnisse routinemäßig ignoriert werden, wird nur unvollständig durchgesetzt. Kombinieren Sie diesen KPI daher mit Vorfallsergebnissen und Kennzahlen zur geschäftlichen Auswirkung.
8. Data Observability-Abdeckung und Überwachungstiefe
Die Abdeckung zeigt, wo Governance existiert, während die Überwachungstiefe zeigt, ob sie Entscheidungen schützen kann. Messen Sie den Anteil der kritischen Tabellen, Pipelines und Geschäftskennzahlen unter aktiver Überwachung.
Observability-Abdeckung = überwachte kritische Assets geteilt durch die Gesamtzahl der kritischen Assets, multipliziert mit 100
Ein Prozentsatz der Abdeckung kann einen schwachen Schutz verbergen. Die Überwachung einer Tabelle auf Vollständigkeit bietet weniger Kontrolle als die Überwachung einer anderen auf Vollständigkeit, Timeliness, Anomalien und Schemaänderungen. Melden Sie sowohl den Anteil der überwachten Assets als auch die Anzahl und Art der aktiven Kontrollen pro Asset.
Trennen Sie Breite von Schutz
Erfassen Sie das Data Warehouse, den Lake, die Pipelines und die Geschäftskennzahlen. Klassifizieren Sie jedes Asset nach seiner Verbindung zu Entscheidungen, Compliance-Verpflichtungen, Service-Level-Agreements und dem operativen Risiko. Priorisieren Sie Lücken, bei denen ein Ausfall die Berichterstattung, die regulatorische Arbeit oder den Betrieb stören könnte.
Zu den Richtwerten für ein ausgereiftes Programm gehören etwa 90 % Katalogabdeckung und 95 % Lineage- oder Richtlinienabdeckung sowie eine 100-prozentige Einhaltung von Überprüfungen der Zugriffsrechte. Diese Zahlen dienen der Orientierung bei der Planung und stellen keine universellen Anforderungen dar. Ein regulierter Risikodatensatz rechtfertigt unter Umständen eine lückenlose Überwachung, während ein exploratives Asset mit geringem Risiko weniger Tiefe benötigt.
Nutzen Sie die Vorfallshistorie, Compliance-Verpflichtungen und geschäftliche Prioritäten, um die Überwachungstiefe festzulegen. Ein hoher Abdeckungswert mit oberflächlichen Prüfungen kann eine falsche Sicherheit vortäuschen, während tiefere Kontrollen auf den wichtigsten Assets das Entscheidungsrisiko effektiver reduzieren können als eine einheitliche Überwachung.
Die Data-Platform-Observability-Lösung von digna überwacht Data Workloads, Verbrauch, Verfügbarkeit, leistungsbezogene Kennzahlen und Änderungen. Ihr datenbankinternes Ausführungsmodell kann Teams dabei helfen, die Überwachung auszuweiten, ohne Produktionsdaten aus ihrer Umgebung zu bewegen.
8-Punkte-Vergleich der Data Governance-KPIs
Kennzahl | Komplexität der Implementierung 🔄 | Ressourcenanforderungen ⚡ | Erwartete Ergebnisse 📊 | Ideale Anwendungsfälle 💡 | Wichtigste Vorteile ⭐ |
|---|---|---|---|---|---|
Datenqualitätswert | 🔄 Mittel, erfordert Gewichtungslogik und Aggregation über Dimensionen hinweg | ⚡ Moderat, Validierungsregeln, Anomalieerkennung, historische Speicherung | 📊 Einheitlicher Datenzustandswert für Benchmarking und Trendverfolgung | 💡 Executive Reporting, SLA-Verfolgung, bereichsübergreifende Vergleiche | ⭐ Vereinfacht das Reporting; priorisiert Behebungsmaßnahmen |
Data Validation-Erfolgsquote | 🔄 Mittel, erfordert sorgfältiges Regeldesign und Feinabstimmung | ⚡ Hoch, Prüfungen auf Datensatzebene und kontinuierliche Regelpflege | 📊 Präzise Durchsetzungskennzahl mit detaillierten Fehlerberichten | 💡 Compliance-Audits, vorgelagerte Validierung, gezielte Fehlerbehebungen | ⭐ Audit-bereite, verwertbare Belege bei Fehlern |
Data Timeliness SLA-Einhaltung | 🔄 Niedrig–Mittel, erfordert Baseline-Lernen und Integration von Zeitplänen | ⚡ Moderat, Überwachung von Pipelines und Warnsystemen | 📊 % pünktlicher Lieferungen; Frühwarnung bei verspäteten/fehlenden Ladungen | 💡 Überwachung von Pipeline-SLAs, Dashboard-Aktualität, operative SLAs | ⭐ Automatisiert die SLA-Verfolgung; quantifiziert die Pipeline-Zuverlässigkeit |
Erkennungsrate kritischer Datenvorfälle | 🔄 Hoch, KI-Baselining + Integration in Vorfallssysteme | ⚡ Hoch, kontinuierliche Anomalieerkennung und Alarmierung | 📊 Schnellere Erkennung (geringere MTTD); deckt bekannte und unbekannte Probleme auf | 💡 Produktionsanalysen, Modellüberwachung, risikoreiche Datendomänen | ⭐ Frühzeitige Erkennung von Anomalien; reduziert die Auswirkungen von Ausfällen |
Erkennungs- & Behebungszeit von Schemaänderungen | 🔄 Niedrig–Mittel, kontinuierliche Verfolgung + Runbooks für Reaktionen | ⚡ Niedrig–Moderat, Tools zur Schemaüberwachung und Auswirkungsanalyse | 📊 Kennzahl für die Behebungszeit; verhindert unbemerkte nachgelagerte Fehler | 💡 Umgebungen mit häufigem Schema-Drift oder vielen Integrationen | ⭐ Sofortige Erkennung; Sichtbarkeit von Auswirkungen und Audit Trail |
Effektivität der Anomalieerkennung bei Geschäfts-KPIs | 🔄 Hoch, erfordert präzise KPI-Definitionen und Feinabstimmung | ⚡ Hoch, KI-Baselines, mehrdimensionale Analyse, Hinweise auf die Ursache | 📊 % erkannter und kontextualisierter bedeutsamer geschäftlicher Änderungen | 💡 Executive Dashboards, Umsatz-/Volumenüberwachung, operative Warnungen | ⭐ Geschäftsorientierte Warnmeldungen mit kontextbezogenen Hinweisen auf die Ursache |
Adoptions- & Durchsetzungsrate von Richtlinien | 🔄 Mittel, Zuordnung von Richtlinie zu Überwachung und Ausnahme-Workflows | ⚡ Moderat, Richtlinienmanagement, Audit-Protokollierung, Genehmigungen | 📊 % operationalisierter Richtlinien; Indikator für den Governance-Reifegrad | 💡 Governance-Programme, Compliance-Reporting, Risikomanagement | ⭐ Zeigt die operative Kontrolle; priorisiert Lücken bei der Durchsetzung |
Observability-Abdeckung & Überwachungstiefe | 🔄 Hoch, automatisierte Erkennung und mehrschichtige Überwachung | ⚡ Hoch, Inventarisierung, Baselining, Dashboards über alle Schichten hinweg | 📊 Abdeckungsquote und Tiefenkennzahlen zur Identifizierung blinder Flecken | 💡 Große Datenplattformen, Reifegradplanung für Observability | ⭐ Quantifiziert den Überwachungsreifegrad; steuert Investitionen in die Abdeckung |
Verwandeln Sie acht Kennzahlen in einen operativen Governance-Rhythmus
Diese acht KPIs funktionieren am besten als System, nicht als eine Ansammlung unzusammenhängender Zahlen. Die Abdeckung zeigt Ihnen, ob kritische Assets sichtbar sind. Die Durchsetzung von Richtlinien zeigt Ihnen, ob geschriebene Standards in Live-Workflows funktionieren. Qualität und Validierung zeigen, ob Datensätze für die Verwendung geeignet sind. Die Timeliness zeigt, ob Daten dann eintreffen, wenn Entscheidungen sie erfordern. Vorfallserkennung und Schemabehebung zeigen, wie schnell die Organisation auf Veränderungen reagiert. Die Effektivität bei geschäftlichen Anomalien verbindet die technische Überwachung mit den Ergebnissen, die Führungskräfte steuern.
Beginnen Sie damit, eine Baseline für kritische Assets zu etablieren. Erfassen Sie die aktuellen Qualitätsdimensionen, Validierungsergebnisse, Lieferleistungen, die Überwachungsabdeckung, Richtlinienkontrollen, Vorfallspfade und die Ergebnisse von Warnmeldungen zu Geschäftskennzahlen. Vermeiden Sie es, das Ziel zu ändern, während Sie die Messmethode anpassen. Ein Trend ist nur dann nützlich, wenn die Grundgesamtheit, die Formel und das Beobachtungsfenster nachvollziehbar bleiben.
Weisen Sie jedem KPI und jedem kritischen Asset einen Eigentümer zu. Der Eigentümer sollte die Befugnis haben, Untersuchungen durchzuführen, Ausnahmen zu genehmigen, Behebungsmaßnahmen zu koordinieren und den Abschluss zu bestätigen. Dies löst ein zentrales Governance-Problem, das in einer Umfrage aus dem Jahr 2025 identifiziert wurde, bei der 47 % der Befragten unklare Eigentumsverhältnisse und Zuständigkeiten als Haupthindernis für die Skalierung der Governance nannten (2025 data governance survey). Ein Dashboard kann ein Problem aufzeigen, aber nur verantwortliche Personen können es lösen.
Legen Sie Schwellenwerte basierend auf der geschäftlichen Auswirkung fest. Nutzen Sie strengere Kontrollen für Daten, die regulatorische Berichte, den Patientenbetrieb, finanzielle Risiken oder folgenschwere Kundenentscheidungen unterstützen. Als Referenz enthalten veröffentlichte Frameworks Ziele wie eine Katalogabdeckung von mindestens 90 %, eine Richtlinienabdeckung von mindestens 95 %, eine MTTR von unter vier Stunden und eine 100-prozentige Einhaltung vierteljährlicher Zugriffskontrollen (data governance metrics framework). Betrachten Sie diese als Planungsvorgaben und validieren Sie sie anschließend anhand des tatsächlichen Servicebedarfs und der Reaktionskapazitäten.
Überprüfen Sie verschiedene Signale in unterschiedlichen Abständen. Ingenieure und Stewards benötigen häufige Ansichten über fehlgeschlagene Validierungen, verpasste Lieferungen, offene Vorfälle, Fehlalarme und Schemaänderungen. Governance-Verantwortliche benötigen Trends bei Abdeckung, Durchsetzung, Qualität und Behebung. Führungskräfte benötigen eine prägnante Verknüpfung von Datenkontrollen und Geschäftsergebnissen. Diese Unterscheidung ist wichtig, da 39 % der Datenverantwortlichen angaben, Schwierigkeiten zu haben, der Führungsebene die Wirkung von Governance zu demonstrieren, während 85 % der leitenden Angestellten im Bereich Daten und Analysen Verbesserungen der Governance priorisierten, um sich auf KI vorzubereiten (2025 state of enterprise data governance report).
Kein einzelner KPI beweist den Zustand der Governance. Ein hoher Qualitätswert kann neben blinden Flecken existieren. Eine breite Abdeckung kann neben einer schwachen Durchsetzung existieren. Eine schnelle Erkennung kann neben einer langsamen Behebung existieren. Bauen Sie die Scorecard so auf, dass jede Kennzahl eine andere operative Frage beantwortet, und verknüpfen Sie jede Warnung mit Belegen für Eigentumsverhältnisse, Maßnahmen und bestätigte Behebungen.
digna ist eine Option für Teams, die eine Überwachung über Qualität, Timeliness, Anomalien, Validierung, Schemaänderungen, Geschäftskennzahlen und Platform Observability hinweg benötigen. Die modulare Plattform läuft in der Umgebung des Kunden und unterstützt die datenbankinterne Ausführung, sodass Teams ihre Daten an Ort und Stelle belassen können, während sie das Governance-Messsystem erweitern.
Nutzen Sie digna, um kritische Signale zu Datenqualität, Timeliness, Validierung, Anomalien, Schema und Observability in Ihrer eigenen Umgebung zu überwachen. Besuchen Sie digna, um diese Kontrollen mit verantwortlichen Eigentümern, operativen Warnmeldungen und dem Nachweis zu verbinden, dass Governance in der Produktion funktioniert.
Häufig gestellte Fragen
Was definiert man vor der Berechnung eines Governance-KPI?
Sechs Dinge: die Asset-Population, die Verantwortung, das Messfenster, die Kritikalitätsstufe, den Zielschwellenwert und die erwartete Alert-Reaktion. Ohne sie liefert dieselbe Formel bei jedem Lauf eine andere Zahl.
Wie berechnet man einen Data Quality Score?
Als Summe der Dimensionswerte multipliziert mit ihren zugewiesenen Gewichten, wobei die Gewichte widerspiegeln, wie jeder Datensatz tatsächlich genutzt wird. Beginnen Sie mit einer definierten Gruppe kritischer Datensätze statt mit der gesamten Landschaft, damit der Wert operatives Risiko zeigt statt es wegzumitteln.
Ersetzt ein zusammengesetzter Wert die Untersuchung?
Nein. Ein zusammengesetzter Wert sollte eine Untersuchung auslösen und sie nicht ersetzen. Seine Aufgabe ist der Hinweis, dass sich in einer gewichteten Menge von Dimensionen etwas bewegt hat, und erst die Detailansicht je Dimension zeigt, wo man hinsehen muss.
Wie verbreitet ist formale Governance tatsächlich?
Ein Governance-Benchmark von 2025 fand, dass 71 % der Organisationen ein formales Data-Governance-Programm betreiben, nach 60 % zwei Jahre zuvor. Dieses Wachstum erklärt, warum Messung inzwischen die schwerere Frage ist als Einführung.
Warum acht KPIs statt eines?
Weil sie ein zusammenhängendes Messsystem für Qualität, Timeliness, Abdeckung und Kontrolle bilden. Eine einzelne Leitzahl kann eine Abdeckungslücke nicht von einem Zustandsproblem unterscheiden, und beide verlangen völlig unterschiedliche Reaktionen.



