Bedeutung veralteter Daten: Verhindern Sie Analyse- und KI-Katastrophen
|
7
min. Lesezeit

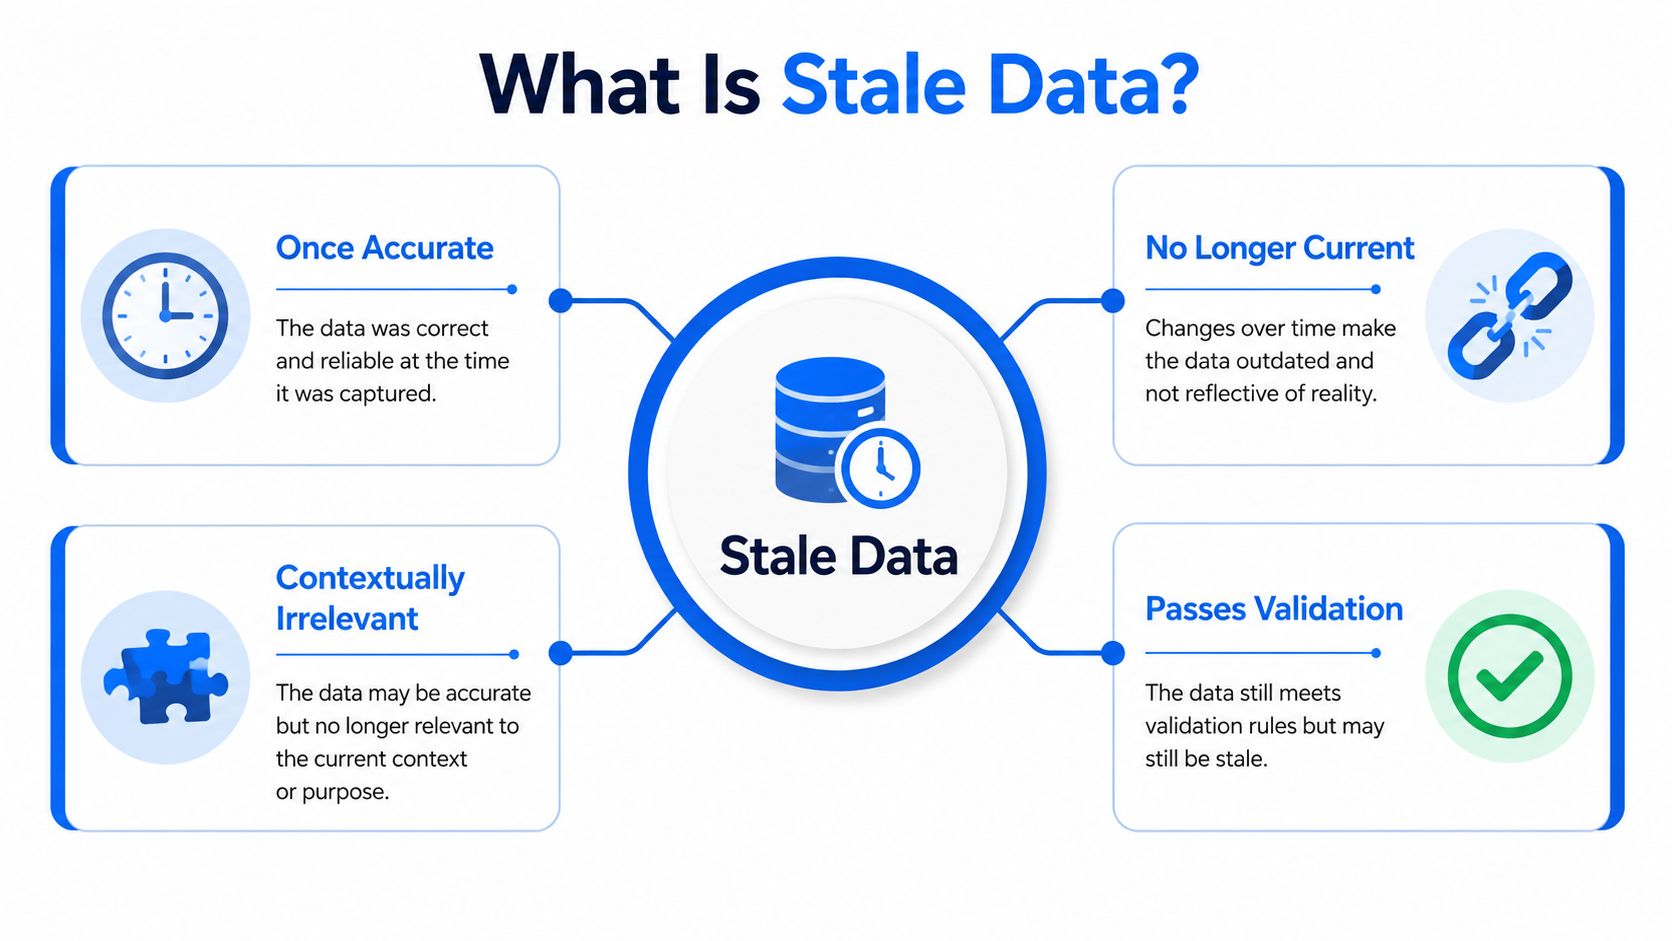
Veraltete Daten bedeuten, dass die Daten technisch gesehen zwar noch gültig, aber für die von ihnen geforderte Aufgabe bereits zu alt sind. Sie spiegeln die aktuelle Realität nicht wider, weil der Ingestionsprozess gestoppt, verlangsamt oder ins Hintertreffen geraten ist. Diese Art von leisem Altern kann Entscheidungen verfälschen, ohne offensichtliche Fehler zu verursachen.
Meist bemerkt man das Problem erst, wenn der Schaden bereits entstanden ist. Ein Dashboard sieht völlig normal aus. Ein Modell liefert weiterhin Vorhersagen. Ein Bericht erreicht die Führungsebene pünktlich. Dann fragt jemand, warum die Kampagne die falsche Zielgruppe angesprochen hat, warum der Lagerbestand als verfügbar angezeigt wurde, obwohl er es nicht war, oder warum ein automatisierter Workflow auf Basis von Informationen agiert hat, die sich vorgelagert bereits geändert hatten.
Deshalb ist die Bedeutung veralteter Daten weit über eine reine Wörterbuchdefinition hinaus wichtig. Veraltete Daten sind keine fehlerhaften Daten. Es sind alte Daten, die immer noch fehlerfrei aussehen. In der Praxis macht sie das gefährlicher als viele offensichtliche Datenqualitätsfehler. Teams erkennen Null-Wert-Spitzen, Schema-Abweichungen oder fehlgeschlagene Jobs oft schnell. Das Altern von Daten übersehen sie, weil die Tabelle weiterhin existiert, die Abfrage läuft und die Werte die grundlegenden Prüfungen bestehen.
Die Behebung hängt zudem davon ab, das Problem richtig zu diagnostizieren. Nicht jeder Vorfall mit schlechten Daten ist ein Problem der Aktualität. Einige Datensätze sind beschädigt. Einige Datensätze werden nicht genutzt. Einige Pipelines sind verspätet. Wenn man all das als „veraltete Daten“ behandelt, verschwendet man Zeit mit der falschen Behebung und lässt das tatsächliche Risiko bestehen.
Inhaltsverzeichnis
Das versteckte Risiko in Ihrem letzten Bericht
Was veraltete Daten wirklich sind
Warum veraltete Daten schwer zu erkennen sind
Veraltet vs. verdorben vs. dunkel
Veraltete Daten vs. Latenz vs. Data Drift
Ein praktischer Vergleich
Warum Teams sie verwechseln
Die geschäftlichen Auswirkungen veralteter Daten
Wo sich der Schaden zuerst zeigt
Warum KI den Einsatz erhöht
Wie man veraltete Daten erkennt und überwacht
Beginnen Sie mit Aktualitätsprüfungen
Fügen Sie Monitoring hinzu, das den tatsächlichen Betrieb widerspiegelt
Vermeidung veralteter Daten mit moderner Observability
Wie Prävention in der Praxis aussieht
Wo Observability-Plattformen helfen
Nachhaltiges Vertrauen in Ihre Daten aufbauen
h2 id="29">Das versteckte Risiko in Ihrem letzten Bericht
Ein VP öffnet am Montagmorgen ein Segmentierungs-Dashboard und gibt eine Kampagne frei. Die Zielgruppenlogik sieht richtig aus. Das Diagramm lädt. Niemand sieht einen Fehler. Später erfährt das Team, dass die Kundendaten hinter diesem Dashboard seit Tagen nicht aktualisiert worden waren.
Das ist ein klassischer Fehler durch veraltete Daten. Die Daten waren nicht fehlerhaft formatiert. Sie fehlten nicht. Sie passten nur nicht mehr zum aktuellen Zustand des Unternehmens.
Aus diesem Grund sollten veraltete Daten in erster Linie als geschäftliches Risiko und erst in zweiter Linie als Pipeline-Problem behandelt werden. Wenn ein Datensatz aufhört, sich zu aktualisieren, erbt jedes nachgelagerte Artefakt dasselbe Problem. Dashboards werden zu historischen Momentaufnahmen, die vorgeben, aktuell zu sein. Reverse-ETL-Jobs schieben die Annahmen von gestern in operative Systeme. ML-Features altern, bis Vorhersagen an Relevanz verlieren.
Veraltete Daten sind gerade deshalb so gefährlich, weil sie immer noch nutzbar aussehen.
Neuere Teams erwarten oft, dass fehlerhafte Pipelines lautstark fehlschlagen. In der Realität tun das viele nicht. Ein geplanter Job kann weiterhin erfolgreich sein, während die vorgelagerte Extraktion ins Stocken geraten ist. Eine Data-Warehouse-Tabelle kann abfragbar bleiben, während sie durch Replikationslatenz hinter der Realität zurückbleibt. Eine Cache-Ebene kann strukturell korrekte Datensätze zurückgeben, die jedoch nicht mehr aktuell sind.
Einige praktische Konsequenzen zeigen sich schnell:
Entscheidungsträger treffen zeitkritische Entscheidungen auf Basis veralteter Kontexte. Marketing, Preisgestaltung, Support und Betrieb hängen alle vom Timing ab, nicht nur von der Richtigkeit.
Das Vertrauen schwindet ungleichmäßig. Benutzer wenden sich vielleicht nicht von der gesamten Dateninfrastruktur ab. Aber sie beginnen, genau jene Berichte zu hinterfragen, mit denen sie bereits schlechte Erfahrungen gemacht haben.
Teams erstellen manuelle Workarounds. Sobald das Vertrauen sinkt, exportieren Mitarbeiter CSV-Dateien, pflegen eigene Tabellenkalkulationen oder bitten die IT-Abteilung um manuelle Validierungen.
Bei diesem letzten Schritt explodieren die Kosten. Data Engineers arbeiten nicht mehr an der Verbesserung von Systemen, sondern beweisen ständig, ob der neueste Wert aktuell genug für die Verwendung ist. Sobald das passiert, sind veraltete Daten kein isolierter Vorfall mehr. Sie sind ein Problem des Betriebsmodells.
Was veraltete Daten wirklich sind
Auf technischer Ebene sind veraltete Daten Informationen, deren Alter die maximale Verzögerung überschreitet, die für ihre beabsichtigte Verwendung tolerierbar ist. Tacnode definiert sie als Daten, deren Alter den akzeptablen Schwellenwert für die operative Nutzung überschritten hat – oft verursacht durch Latenzzeiten bei Batch-Pipelines, Verzögerungen bei der Cache-Synchronisierung oder Replikationsverzögerungen – und stellt fest, dass sie in KI-Systemen einen schleichenden Data Drift ohne die üblichen Fehlermeldungen verursachen können (Tacnode's Erklärung zu veralteten Daten).
Diese Definition ist wichtig, weil sie zwischen Gültigkeit und Pünktlichkeit unterscheidet. Eine Zeile kann Typprüfungen, Eindeutigkeitsprüfungen und die Validierung von Geschäftsregeln bestehen und dennoch für die anstehende Entscheidung falsch sein, weil sich die Welt nach der Erfassung geändert hat.
Warum veraltete Daten schwer zu erkennen sind
Unternehmen erfahren die Bedeutung veralteter Daten oft erst durch Fehler. Ein Bericht „funktioniert“, bis ihn jemand mit einem Quellsystem abgleicht und die Zeitstempellücke sieht. Das liegt daran, dass veraltete Daten in der Regel nicht gegen die Regeln verstoßen, die Sie bereits überwachen.
Eine Tabelle mit alten Kundenstatus enthält immer noch gültige IDs. Alte Kontostände sehen immer noch wie Kontostände aus. Historische Geräteereignisse lassen sich weiterhin korrekt deserialisieren. Wenn sich Ihre Prüfungen nur auf das Schema, Nullwerte, Bereiche oder Zeilenzahlen konzentrieren, können veraltete Daten unbemerkt durchschlüpfen.
Ein besseres mentales Modell ist dieses:
Der Datensatz war einmal korrekt
Der Datensatz sieht strukturell immer noch richtig aus
Der Datensatz spiegelt nicht mehr den aktuellen Zustand wider, der für eine Aktion erforderlich ist
Wenn Sie einen umfassenderen Rahmen dafür suchen, wie Aktualität in die Datenzuverlässigkeit passt, ist dieser Leitfaden über Datenaktualität und geschäftliche Entscheidungen eine nützliche Ergänzung.
Veraltet vs. verdorben vs. dunkel
Bei dieser Unterscheidung machen viele Teams Fehler. Proofpoint trennt explizit zwischen veralteten Daten, verdorbenen Daten und dunklen Daten. Dabei werden veraltete Daten als überholt, ungenutzt oder irrelevant definiert; verdorbene Daten als ungenau oder fehlerhaft; und dunkle Daten als nicht analysierte Informationen, die ungenutzt in Systemen liegen (Proofpoints Definitionen von veralteten, verdorbenen und dunklen Daten).
Diese Kategorien erfordern unterschiedliche Reaktionen.
Datenzustand | Bedeutung | Typisches Symptom | Richtige Reaktion |
|---|---|---|---|
Veraltete Daten | Überholt, aber immer noch gültig | Werte sehen gut aus, aber das Timing stimmt nicht | Pipeline aktualisieren, Aktualitätsprüfungen erzwingen |
Verdorbene Daten | Ungenau oder beschädigt | Ungültige Werte, fehlerhafte Logik, Fehler auf Datensatzebene | Datensätze validieren, Transformationen korrigieren, Quellqualität reparieren |
Dunkle Daten | Gespeichert, aber nicht analysiert | Daten sammeln sich ohne Eigentümer oder Nutzung an | Zugriff regeln, klassifizieren, archivieren oder aktivieren |
Praktische Regel: Wenn eine Aktualisierung der Zeitstempel das Problem lösen würde, handelt es sich wahrscheinlich um veraltete Daten. Wenn die Werte selbst falsch sind, ist das nicht der Fall.
Dies ist in KI- und ML-Systemen noch wichtiger. Ein veralteter Feature Store kann ein Modell mit Eingabedaten füttern, die zwar einmal korrekt waren, es aber nicht mehr sind. Ein verdorbener Feature-Satz führt zu einem anderen Fehlermodus, da die Werte zum Zeitpunkt der Inferenz ungültig sind. Ein dunkler Datensatz wiederum wirft ganz andere Probleme auf, da das Unternehmen Informationen speichert, ohne sie zu nutzen oder ordnungsgemäß zu verwalten.
Alle drei als eine einzige Kategorie zu behandeln, führt zu pauschalen Lösungen wie „überall Zeitstempel überwachen“. Das hilft gegen das Altern von Daten. Es repariert jedoch keine beschädigten Datensätze. Und es sagt Ihnen nicht, ob ungenutzte Daten aufbewahrt, analysiert oder gelöscht werden sollten. Präzision bei der Diagnose ist das, was eine Behebung erst effektiv macht.
Veraltete Daten vs. Latenz vs. Data Drift
Diese Begriffe werden bei der Überprüfung von Vorfällen oft zusammengeworfen, beschreiben jedoch unterschiedliche Fehlermodi. Wenn man sie vermischt, wird die Ursachenanalyse unübersichtlich und Teams fangen an, Symptome statt Systeme zu reparieren.
Ein praktischer Vergleich
Attribut | Veraltete Daten | Datenlatenz | Data Drift |
|---|---|---|---|
Kernproblem | Daten sind zu alt für den Anwendungsfall | Daten kommen später an als erwartet | Datenmuster ändern sich im Laufe der Zeit |
Hauptfrage | Ist dieser Datensatz noch aktuell genug für die Verwendung? | Wie lange dauert es, bis ein Ereignis nachgelagert erscheint? | Hat sich das zugrunde liegende Verhalten geändert? |
Typische Ursache | Fehlerhafte Updates, verzögerte Aktualisierung, vernachlässigte Pipelines | Langsame Ingestion, wartende Verarbeitung, Netzwerk- oder Systemverzögerung | Veränderungen des realen Verhaltens, wechselnde Zielgruppen, sich entwickelnde Inputs |
Was Nutzer sehen | Berichte sehen normal aus, spiegeln aber die Vergangenheit wider | Dashboards hinken den Live-Ereignissen hinterher | Modellausgaben werden schwächer oder verlieren an Relevanz |
Beste erste Prüfung | Zeitstempel der letzten Aktualisierung | Zeitspanne vom Ereignis bis zur Verfügbarkeit | Verteilung und Feature-Verhalten im Laufe der Zeit |
Bei der Latenz geht es um die Transportverzögerung. Bei der Veraltung geht es um die Nutzbarkeit im Verhältnis zu einem Schwellenwert. Bei Drift geht es um die Veränderung des datengenerierenden Prozesses selbst.
Ein gutes Beispiel ist der Lagerbestand. Wenn ein Verkauf stattfindet und das Update später als erwartet im Warehouse erscheint, ist das Latenz. Wenn die Tabelle im Warehouse so lange nicht aktualisiert wurde, dass mit den Bestandszahlen nicht mehr gearbeitet werden kann, sind das veraltete Daten. Wenn sich die Nachfragemuster der Kunden verschieben und Ihre Nachfrageprognose nicht mehr mit der Realität übereinstimmt, ist das Data Drift.
Warum Teams sie verwechseln
Die Verwirrung entsteht, weil diese Probleme miteinander verkettet sein können.
Die Batch-Verarbeitung bringt konstruktionsbedingt Latenz mit sich. Zu viel Latenz kann bei einem zeitkritischen Workflow zu veralteten Daten führen. Veraltete Modelleingaben können dann zu einer schleichenden Leistungsverschlechterung beitragen, die aus geschäftlicher Sicht wie Drift aussieht.
Diese Kette ist besonders in ML-Systemen häufig. Teams überwachen oft nur, ob das Modell „aktiv“ ist und ob Inferenzanfragen erfolgreich beantwortet werden. Sie überwachen nicht immer, ob die Feature-Werte den aktuellen Zustand widerspiegeln, den das Modell benötigt. Das System läuft weiter, aber nicht mit dem aktuellen Kontext.
Ein einfacher Weg, diese Probleme bei der Fehleranalyse zu trennen, besteht darin, nacheinander drei Fragen zu stellen:
Wann fand das Quellereignis statt?
Wann hat das nachgelagerte System es empfangen oder bereitgestellt?
Ist es trotz erfolgreicher Übertragung noch frisch genug für die Entscheidung?
Diese Fragen trennen das Problem sauber auf. Zuerst das Timing der Datenbewegung. Dann das Alter bei der Nutzung. Und schließlich die Verhaltensänderung im Laufe der Zeit.
Die geschäftlichen Auswirkungen veralteter Daten
Ein Bericht kann technisch einwandfrei und trotzdem falsch für die anstehende Entscheidung sein.
Genau so richten veraltete Daten geschäftlichen Schaden an. Die Zahlen stimmen überein. Das Dashboard lädt. Das Modell liefert eine Vorhersage. Aber der zugrunde liegende Zustand hat sich bereits geändert, sodass Teams auf Basis einer Version des Unternehmens agieren, die so gar nicht mehr existiert.
Wo sich der Schaden zuerst zeigt
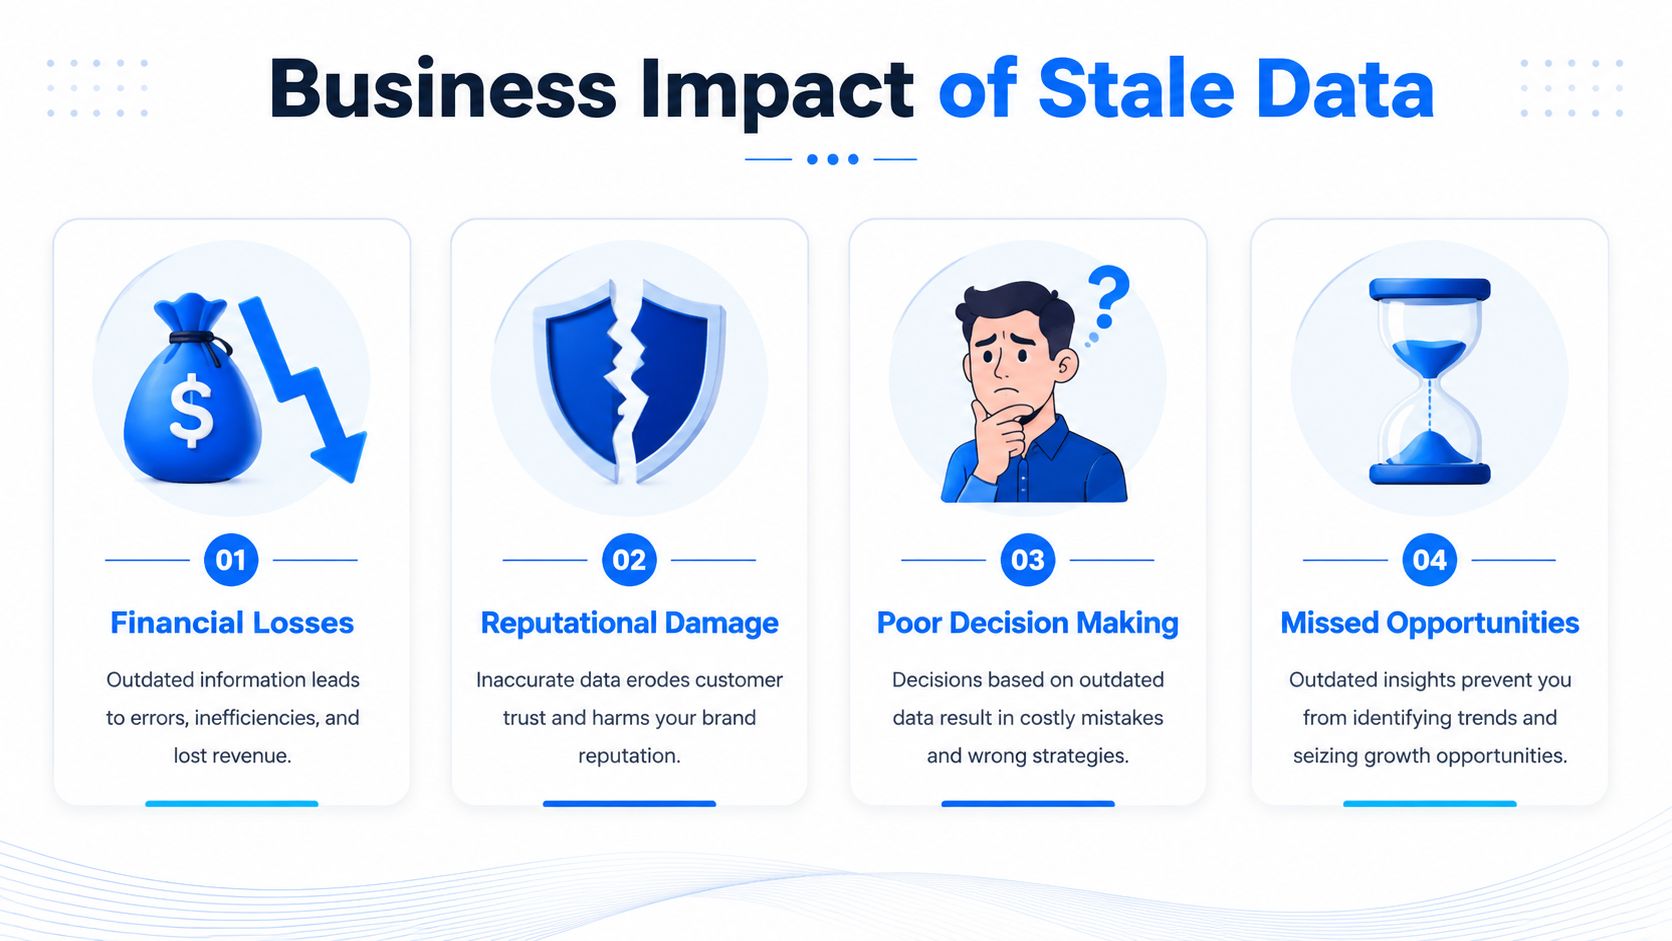
Die ersten Auswirkungen sind meist operativer Natur. Der Vertrieb bearbeitet die falschen Accounts, weil sich der Account-Status nach der letzten Synchronisierung geändert hat. Support-Mitarbeiter antworten ohne die neuesten Informationen zur Produktnutzung oder Abrechnung. Die Finanzabteilung schließt die Woche mit Berichten ab, die einen älteren Stand von Bestellungen, Rückerstattungen oder Cashflows widerspiegeln. Jedes Team trifft aus seiner lokalen Sicht eine vernünftige Entscheidung, aber das gemeinsame Bild ist veraltet.
Die Kosten bestehen nicht nur in einer Fehlentscheidung. Es ist der Aufwand für die Nacharbeit.
Teams verbringen Zeit damit, Systeme abzugleichen, Analysen neu zu berechnen und zu erklären, warum Maßnahmen auf Basis „aktueller“ Daten rückgängig gemacht werden mussten. Wenn das ein paar Mal vorkommt, schwindet das Vertrauen schnell. Geschäftsanwender betrachten Dashboards nicht mehr als verlässliche Entscheidungsgrundlage, sondern nur noch als grobe Orientierung. Analysten werden in die manuelle Validierung hineingezogen, Behelfstabellen kehren zurück und Entscheidungszyklen verlangsamen sich.
Der Effekt unterscheidet sich je nach Bereich. Im Einzelhandel und Marketing führen veraltete Segmentierungs- oder Bestandsdaten zu falsch ausgerichteten Kampagnen, ineffektiven Werbeaktionen und vermeidbaren Out-of-Stock-Problemen. Im Gesundheitswesen kann ein veralteter operativer oder klinischer Kontext das Personal zu einer unsicheren Priorisierung verleiten. Im Finanzwesen laufen Regelwerke und nachgelagerte Automatisierungen einfach weiter, wenn sie nicht explizit gestoppt werden, sodass alte Inputs die falschen Sperren, Genehmigungen oder Eskalationen auslösen können.
Hier ist auch die Unterscheidung zwischen veralteten, verdorbenen und dunklen Daten von Bedeutung. Veraltete Daten können strukturell immer noch gültig und relevant sein, aber sie sind zu alt für die Entscheidung. Verdorbene Daten sind minderwertige Daten, die falsch, beschädigt, dupliziert oder unvollständig sind. Dunkle Daten sind Daten, die das Unternehmen speichert, aber nicht aktiv nutzt oder verwaltet. Diese Kategorien erfordern unterschiedliche Reaktionen. Veraltete Daten benötigen Aktualitätskontrollen und SLAs. Verdorbene Daten erfordern eine Qualitätsbereinigung. Dunkle Daten erfordern Entscheidungen über Inventarisierung, Eigentümerschaft und Aufbewahrung. Wenn ein Team alle drei als dasselbe Problem behandelt, wählt es meist den falschen Lösungsansatz und lässt das geschäftliche Risiko bestehen.
Ein nützlicher Ansatz zur Einordnung des Problems ist die Timeliness von Daten. Das akzeptable Alter eines Datensatzes hängt von der Entscheidung ab, die er unterstützt, und nicht davon, ob die Pipeline erfolgreich abgeschlossen wurde. Dieser praktische Leitfaden zur Timeliness von Daten in operativen Systemen ist eine gute Referenz, wenn Ihr Team diese Schwellenwerte klarer definieren muss.
Ein kurzes Erklärvideo lohnt sich, wenn Sie vor dem Aufbau von Kontrollmechanismen eine einfache visuelle Einordnung wünschen:
Warum KI den Einsatz erhöht
IBM stellt fest, dass Aktualitäts-SLAs in automatisierten Entscheidungssystemen und Echtzeit-Datenumgebungen besonders wichtig sind, da selbst geringe Verzögerungen die Ergebnisse verschlechtern können. Zudem wird hervorgehoben, dass agentenbasierte KI-Systeme neue Fehlermodi schaffen, da sie automatisierte Aktionen auf der Grundlage veralteter Daten auslösen können. Daher müssen SLAs an die Latenz der Aktion und nicht nur an das Datenalter gekoppelt werden (IBM über veraltete Daten und Aktualitäts-SLAs).
In der Praxis verzeihen KI-Systeme weniger als menschliche Arbeitsabläufe. Ein Dashboard-Nutzer bemerkt vielleicht, dass die Zahlen von gestern nicht stimmen, und stellt Fragen, bevor er handelt. Ein Empfehlungsdienst, ein Konsument von Feature Stores oder ein agentenbasierter Workflow wartet diese Prüfung in der Regel nicht ab. Sie konsumieren, was verfügbar ist, und arbeiten so, als ob der Kontext aktuell wäre.
Dadurch verschiebt sich der Fehlermodus von einer falschen Erkenntnis hin zu einer falschen Aktion. Ein Preisgestaltungsmodell kann abgelaufene Nachfragesignale nutzen. Ein Betrugserkennungssystem kann eine Transaktion auf Basis eines alten Kontostatus bewerten. Ein Kundenservice-Copilot kann Ratschläge auf der Grundlage veralteter Abonnement- oder Produktdaten generieren. Das System erscheint einwandfrei, da die Anfragen erfolgreich sind, aber die Qualität der Ergebnisse sinkt auf eine Weise, die teuer und schwer nachvollziehbar ist.
Die Aktualitätsrichtlinie sollte sich nach den geschäftlichen Auswirkungen richten. Ein wöchentlicher Planungsdatensatz verträgt mehr Alter als eine Feature-Tabelle, die für Echtzeit-Entscheidungen genutzt wird. Wenn man sie gleich behandelt, werden aus einer Unannehmlichkeit im Berichtswesen schnell operative Risiken.
Wie man veraltete Daten erkennt und überwacht
Die Erkennung beginnt mit einer grundlegenden Idee: Sie müssen wissen, wie alt die Daten genau in diesem Moment sind, und nicht, wann die Pipeline zuletzt als fehlerfrei eingestuft wurde.
DQOps beschreibt die primäre Erkennungsmethode sehr klar: Überwachen Sie die Timeliness, indem Sie die seit der letzten Aktualisierung verstrichene Zeit berechnen – typischerweise anhand einer Datums- oder Zeitstempelspalte – und stellen Sie diese Aktualitätsmetriken in Dashboards dar, damit Teams sehen können, welche Tabellen die ältesten Daten enthalten (DQOps zur Erkennung veralteter Daten mit Zeitstempeln und Dashboards).
Beginnen Sie mit Aktualitätsprüfungen
Wenn Sie dies von Grund auf neu aufbauen, beginnen Sie mit einer Auswahlliste kritischer Datensätze und stellen Sie für jeden eine einfache Frage: Welcher Zeitstempel repräsentiert die jüngste vertrauenswürdige Aktualisierung am besten?
Für einige Tabellen ist das ein Ingestions-Zeitstempel. Für andere ist es ein Ereignis-Zeitstempel oder ein geschäftlich wirksames Datum. Wählen Sie das Feld, das die tatsächliche Aktualität für den Anwendungsfall widerspiegelt, und nicht nur die Lademechanik.
Implementieren Sie dann einige konkrete Prüfungen:
Überwachen Sie das maximale Alter des Zeitstempels. Vergleichen Sie die Zeit des jüngsten Datensatzes mit der aktuellen Uhrzeit.
Trennen Sie die Aktualität der Quelle von der des Data Warehouse. Ein erfolgreicher Ladevorgang bedeutet nicht automatisch, dass die vorgelagerten Daten aktuell waren.
Visualisieren Sie die ältesten Tabellen zuerst. Teams benötigen eine Ansicht, die vernachlässigte Datensätze sofort sichtbar macht.
Wenn Sie über Aktualität als Teil einer umfassenderen Zuverlässigkeitspraxis nachdenken, zeigt diese Seite über die Überwachung der Daten-Timeliness, wie Teams Timeliness operativ handhaben.
Fügen Sie Monitoring hinzu, das den tatsächlichen Betrieb widerspiegelt
Zeitstempelprüfungen fangen offensichtliche Stillstände ab. Ein gutes Monitoring geht weiter und spiegelt das normale Verhalten der Pipeline wider.
Ein praktisches Setup umfasst in der Regel:
Erwartete Zeitfenster für das Eintreffen
Wenn eine Tabelle normalerweise nach einem festen Zeitplan aktualisiert wird, überwachen Sie, ob das Update innerhalb des normalen Zeitfensters eingetroffen ist. Dies fängt verspätete, aber noch nicht völlig fehlgeschlagene Jobs ab.Prüfungen von Volumen und Mustern
Eine Tabelle wird möglicherweise immer noch aktualisiert, jedoch mit verdächtig geringem Volumen, unvollständigen Partitionen oder fehlenden Datensegmenten. Das signalisiert oft den Beginn eines Aktualitätsproblems.Erkennung von Schemaänderungen
Vorgelagerte Spaltenänderungen, umbenannte Felder oder Typänderungen führen oft zu Fehlern in der Aktualisierungslogik, noch bevor jemand bemerkt, dass das Alter der nachgelagerten Daten zunimmt.Auswirkungsspezifische Alarmierung
Die Weiterleitung von Alarmen sollte widerspiegeln, wer für das Problem verantwortlich ist und welche nachgelagerten Verbraucher betroffen sind. Ein Aktualitätsalarm ohne klare Zuständigkeit erzeugt nur Rauschen.
Überwachen Sie die Aktualität nicht nur als Eigenschaft von Tabellen. Überwachen Sie sie als Eigenschaft von Entscheidungen, die von diesen Tabellen abhängen.
Dieser Ansatz verändert die Definition von „gut genug“. Eine Dimensionstabelle, die für Berichte mit geringer Dynamik genutzt wird, verträgt einen großzügigeren Schwellenwert. Eine Feature-Tabelle, die automatisierte Aktionen füttert, hingegen meist nicht.
Vermeidung veralteter Daten mit moderner Observability
Ein Vorfall mit veralteten Daten beginnt meist lange bevor er als solcher wahrgenommen wird. Das Dashboard lädt noch. Die Pipeline leuchtet grün. Das Modell liefert Werte. Aber ein vorgelagerter Feed ist vor sechs Stunden gestoppt, ein Replikationsjob hinkt hinterher oder eine Schemaänderung hat dazu geführt, dass ein Teil der Aktualisierung fehlgeschlagen ist. Bis ein Geschäftsanwender das bemerkt, arbeitet das Team bereits mit Daten, die zwar gültig aussehen, es aber nicht mehr sind.
Prävention bedeutet, diese Fehlermodi von Anfang an einzuplanen, anstatt Aktualität als einmalige Prüfung zu behandeln.
Wie Prävention in der Praxis aussieht
Die besten Kontrollen sind operativer Natur. Sie definieren, wer reagiert, was „frisch genug“ bedeutet und wie das Team Probleme erkennt, bevor veraltete Daten an einem Entscheidungspunkt ankommen.
Weisen Sie klare Verantwortlichkeiten zu. Jeder geschäftskritische Datensatz benötigt einen festen Eigentümer für die Aktualität. Ohne diesen liegen veraltete Daten in der Lücke zwischen Plattform-, Analyse- und Anwendungsteams.
Definieren Sie Aktualitätsanforderungen anhand der Entscheidung, nicht der Tabelle. Eine Finanz-Momentaufnahme für den Monatsabschluss verträgt andere Verzögerungen als eine Feature-Tabelle für automatisierte Empfehlungen. Hier ist auch die Unterscheidung zwischen veralteten, verdorbenen und dunklen Daten wichtig. Veraltete Daten können für einige risikoarme Berichte noch nutzbar sein. Verdorbene Daten sind falsch oder beschädigt und erfordern eine andere Reaktion. Dunkle Daten liegen ungenutzt herum und sollten eher verwaltet oder gelöscht als aktualisiert werden.
Nutzen Sie Zeitstempel und Versionierung. Jeder Ladevorgang sollte dokumentieren, wann er lief, welche Quell-Momentaufnahme genutzt wurde und ob nachgelagerte Tabellen aus den richtigen Inputs neu aufgebaut wurden. Das beschleunigt Rollbacks, Fehleranalysen und die Ursachenforschung erheblich.
Reduzieren Sie manuelle Prüfungen. Stichproben helfen bei der Fehlersuche, sind aber nicht über Dutzende Pipelines, replizierte Speicher und Modelleingaben hinweg skalierbar.
Teams müssen sich zudem entscheiden, wo sie ihre Ressourcen investieren. Das Streamen jeder einzelnen Quelle ist nicht immer gerechtfertigt. Häufigere Aktualisierungen erhöhen die Infrastrukturkosten, die Last auf den Quellsystemen und das Alarmvolumen. Das richtige Ziel ist das kostengünstigste Setup, das die Daten innerhalb der Toleranzgrenzen des unterstützten Geschäftsprozesses hält.
Wo Observability-Plattformen helfen
Observability funktioniert am besten, wenn sie den gesamten Weg von der Quelle bis zum Verbraucher verfolgt. Ein Job-Scheduler kann Ihnen mitteilen, dass eine Aufgabe abgeschlossen wurde. Er kann Ihnen jedoch nicht sagen, ob die Quelldaten bereits veraltet waren, ob nur ein Teil einer Partition angekommen ist oder ob eine nachgelagerte Feature-Tabelle nun außerhalb ihres Service-Levels liegt.
Ein nützlicher Leitfaden zur Data Observability für modernes Datenmanagement erklärt, warum Teams Transparenz auf Pipeline-Ebene anstelle isolierter Prüfungen benötigen. In der Praxis bedeutet dies die Überwachung von erwarteten Eintreffen-Zeitfenstern, Anomalien bei Zeilenzahlen und Partitionen, Schemaänderungen, Datenherkunft (Lineage) und nachgelagerten Abhängigkeiten an einem zentralen Ort.
Das gilt umso mehr für KI- und ML-Systeme. Ein Reporting-Dashboard mit veralteten Daten führt vielleicht zu einem unangenehmen Meeting. Ein Modell, das mit veralteten Features trainiert oder bewertet wird, kann jedoch so lange falsche Entscheidungen treffen, bis jemand eingreift. Die Lösung lautet selten „alles schneller aktualisieren“. Es geht darum, Aktualitätserwartungen für jedes Feature-Set festzulegen, auf vorgelagerte Änderungen zu achten, die diese Erwartungen verletzen, und automatisierte Aktionen zu stoppen, wenn die Daten außerhalb der Toleranzgrenzen liegen.
Für Teams, die Plattformen evaluieren, ist digna ein Beispiel, das Timeliness-Monitoring, Anomalieerkennung, Validierung auf Datensatzebene und Schema-Tracking kombiniert und Analysen direkt in der Kundenumgebung ausführt. Diese Kombination ist nützlich, da Probleme mit veralteten Daten oft zusammen mit anderen Signalen auftreten, wie etwa einem verzögerten Ladevorgang, einer Typänderung und einem unerwarteten Volumenabfall aus derselben vorgelagerten Quelle.
Dieselbe Disziplin zeigt sich auch außerhalb der internen Analytik. In Handelsumgebungen bewegen sich Produkt-, Bestands- und Kundendaten oft über Apps, Caches und Exporte hinweg, bevor sie genutzt werden. Diese Einblicke in die Datengenauigkeit im E-Commerce sind eine gute Erinnerung daran, dass Prävention davon abhängt, operative Daten für die jeweilige Aktion aktuell genug zu halten, und nicht nur davon, Pipelines im grünen Bereich zu halten.
Universelle Aktualitätsschwellenwerte scheitern, weil Geschäftsprozesse unterschiedliche Toleranzen für Verzögerungen haben. Effektive Prävention resultiert aus einer nutzungsbasierten Observability, einer an Reaktionen gekoppelten Eigentümerschaft und Kontrollen, die veraltete Daten von anderen Datenqualitätsproblemen unterscheiden, die eine andere Lösung erfordern.
Nachhaltiges Vertrauen in Ihre Daten aufbauen
Die wahre Bedeutung veralteter Daten ist nicht einfach „alte Daten“. Es sind Daten, die für eine bestimmte Entscheidung ungeeignet geworden sind, während sie optisch immer noch fehlerfrei wirken. Genau deshalb richten sie mehr Schaden an als viele offensichtliche Fehler.
Teams, die dies erfolgreich meistern, tun drei Dinge konsequent: Sie unterscheiden veraltete Daten von verdorbenen und dunklen Daten. Sie überwachen die Aktualität als operative Anforderung und nicht als gelegentliche Prüfung. Und sie verknüpfen die Fehlerbehebung mit den geschäftlichen Auswirkungen – insbesondere dort, wo Modelle und automatisierte Workflows schneller agieren, als Menschen prüfen können.
Diese Disziplin ist auch außerhalb der Analytik wichtig. Wenn Sie mit Handels- oder Kundendaten arbeiten, bieten diese Einblicke in die Datengenauigkeit im E-Commerce eine nützliche Perspektive darauf, warum saubere, aktuelle Informationen die tägliche Ausführung ebenso beeinflussen wie das Management-Reporting.
Vertrauen in Daten entsteht nicht durch ein einzelnes Dashboard oder einen erfolgreichen Pipeline-Durchlauf. Es resultiert aus dem wiederholbaren Nachweis, dass die Daten aktuell genug, genau genug und ausreichend verwaltet sind für die Aktion, die sie steuern.
Wenn veraltete Berichte, verzögerte Ladevorgänge oder unbemerkte Schemaänderungen Ihr Team immer wieder in die reaktive Brandbekämpfung zwingen, ist digna eine Evaluation wert. Die Plattform konzentriert sich auf Timeliness, Anomalien, Validierung und Schema-Tracking, damit Datenteams Aktualitätsprobleme abfangen können, bevor sie Dashboards, Modelle und operative Entscheidungen erreichen.
Häufig gestellte Fragen
Was bedeutet veraltete Daten?
Veraltete Daten sind technisch noch gültig, aber zu alt für die Aufgabe, die Sie ihnen stellen. Sie bilden die aktuelle Realität nicht mehr ab, weil der Ingest stoppte, sich verlangsamte oder zurückfiel, doch jeder Wert würde eine Format- oder Bereichsprüfung bestehen.
Warum sind veraltete Daten schwer zu erkennen?
Weil nichts kaputt aussieht. Die Zeilen sind wohlgeformt, das Schema intakt, der Bericht rendert normal. Ohne explizite Aktualitätserwartung ist eine Tabelle mit gestrigen Zahlen nicht von einer mit heutigen zu unterscheiden.
Was unterscheidet Veraltung, Latenz und Drift?
Latenz ist die normale, erwartete Verzögerung zwischen Ereignis und Verfügbarkeit. Veraltung ist Latenz, die den vom Use Case tolerierten Rahmen überschreitet. Drift ist eine Veränderung des statistischen Charakters der Daten und kann auch bei perfekter Aktualität auftreten.
Wie erkennt man veraltete Daten?
Beginnen Sie mit Aktualitätsprüfungen, die den jüngsten Zeitstempel gegen einen aus dem Konsumentenbedarf abgeleiteten Schwellenwert vergleichen. Ergänzen Sie das Monitoring des tatsächlichen Ankunftsmusters, denn ein stündlicher Feed, der plötzlich täglich landet, ist längst veraltet.
Warum wiegt Veraltung bei KI schwerer?
Weil Modelle automatisch und in großem Umfang auf Eingaben reagieren, ohne dass jemand merkt, dass eine Zahl alt aussieht. Ein veraltetes Feature verschlechtert Vorhersagen leise über jede Entscheidung hinweg, und der Schaden kumuliert, bevor jemand einen Bericht abgleicht.



