Die 9 Arten von Datenpipelines: So wählen Sie 2026 die beste
|
10
min. Lesezeit

Mehr als ETL: Die richtige Architektur für Datenpipelines wählen
Ihre Dashboards sind veraltet. Ihre ML-Modelle driften. Ihre Stakeholder verlieren das Vertrauen in die Daten. Das sind typische Symptome einer unpassenden Architektur – einer Datenpipeline, die mit den Anforderungen des Unternehmens nicht mehr Schritt halten kann. Die Wahl der richtigen Pipeline ist nicht nur eine technische Entscheidung. Sie ist eine strategische Entscheidung, die Aktualität, Zuverlässigkeit, Betriebsaufwand und das Vertrauen beeinflusst, das Menschen in jede Kennzahl setzen, mit der sie arbeiten.
Pipelines scheitern selten an einer ungeeigneten Werkzeugwahl. Das Scheitern entsteht vielmehr, wenn die falsche Architektur mit der Aufgabe kombiniert wird. Ein nächtlicher Warehouse-Load kann keine Betrugsprävention leisten. Ein Streaming-Stack ist für den wöchentlichen Finanzabgleich überdimensioniert. Dieser Leitfaden konzentriert sich auf die betriebliche Realität hinter den wichtigsten Arten von Datenpipelines – darauf, wo jedes Muster an seine Grenzen stößt, was Teams üblicherweise unterschätzen und wie Sie jedes Muster vom ersten Tag an beobachtbar machen.
Wenn Sie parallel zur Klärung dieser Architektur Ihr Team aufbauen, bietet dieser Leitfaden zu Data-Engineer-Rollen in LATAM hilfreichen Kontext zu den Fähigkeiten, die solche Systeme erfordern.
Inhaltsverzeichnis
1. Batch-Processing-Pipelines
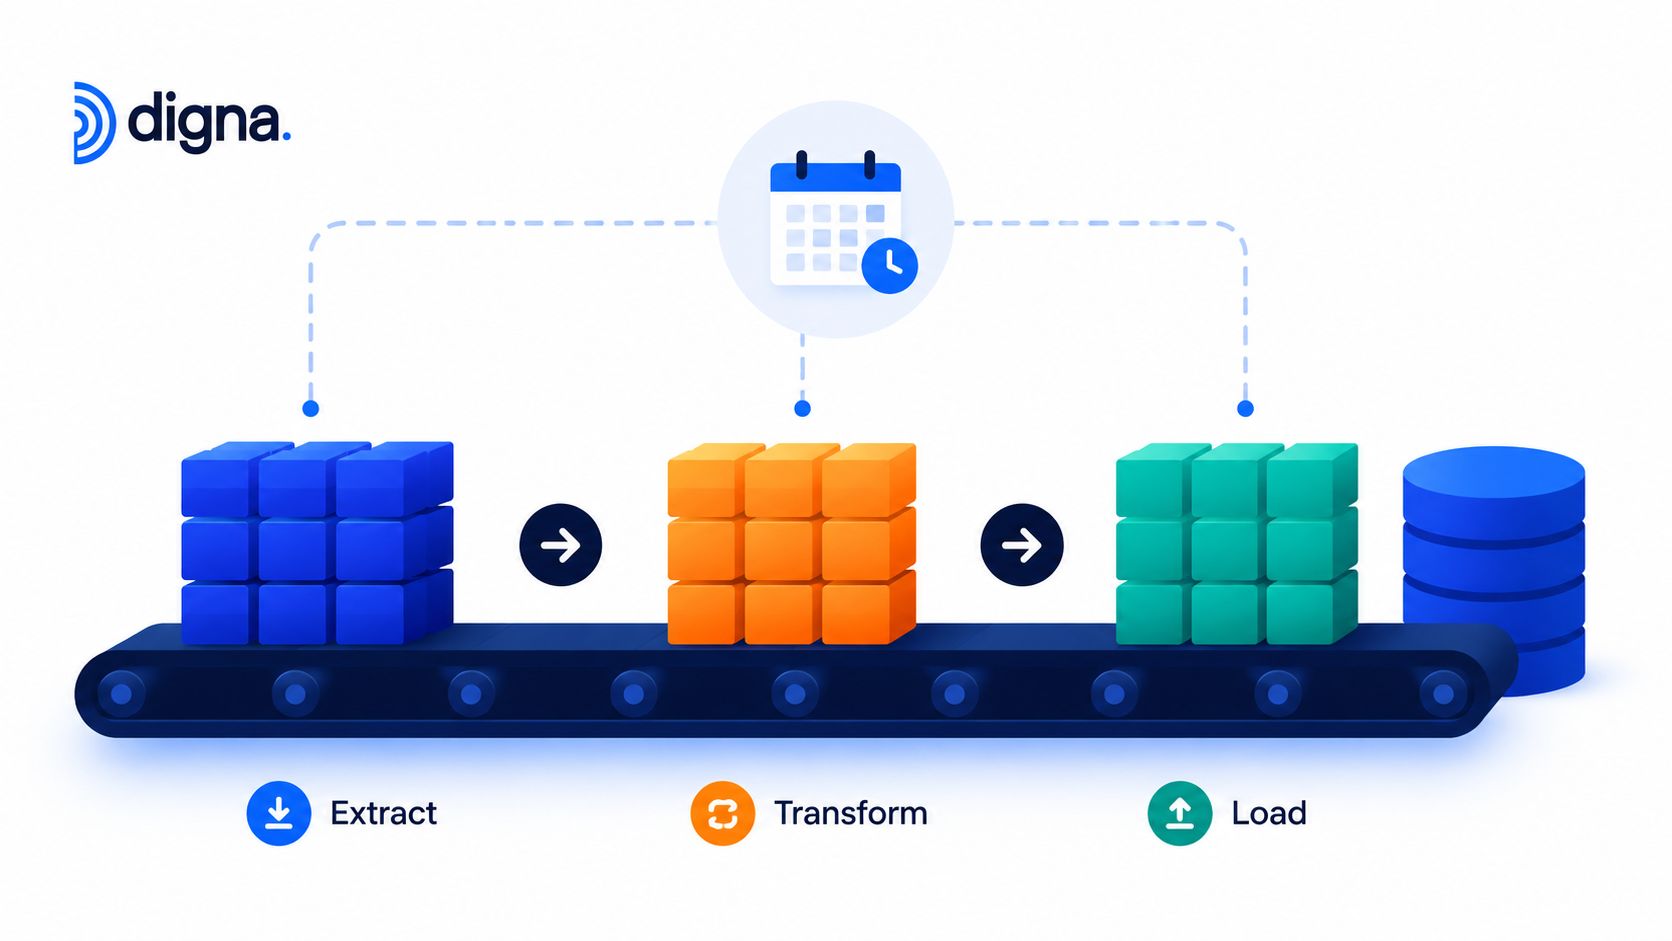
Batch-Pipelines sind nach wie vor das Rückgrat der Unternehmensanalytik. IBM stellt fest, dass Batch-Processing-Pipelines weiterhin die vorherrschende Architektur für klassische Analysen und historisch fundierte Entscheidungen sind. Sie verarbeiten Daten nach festen Zeitplänen, etwa stündlich, täglich oder wöchentlich, und bedienen Reporting, Abrechnung und groß angelegte historische Analysen über bewährte ETL-Muster in Enterprise-Warehouses und Data Marts (IBM zu Datenpipeline-Architekturen).
Das deckt sich mit gängigen Beobachtungen aus dem Produktivbetrieb. Nächtliche Snowflake-Warehouse-Loads, die tägliche Kundensegmentierung in Marketingsystemen, der wöchentliche Bestandsabgleich im Einzelhandel und das Finanzreporting zum Tagesabschluss passen gut zu Batch. Wenn die geschäftliche Entscheidung morgen früh fällt und nicht in den nächsten Sekunden, ist Batch oft das einfachere und günstigere Design.
Für Teams, die das Fundament entwerfen, hilft eine klare Referenz zur Datenpipeline-Architektur von digna dabei einzuordnen, wo Batch hingehört und wo nicht.
Wo Batch weiterhin überlegen ist
Batch liefert klare Checkpoints. Sie wissen, wann ein Lauf beginnt, wann er endet und welche Partition oder welche Dateien er verarbeitet hat. Diese Struktur macht Backfills, Abgleiche und Audit-Gespräche deutlich einfacher als bei permanent laufenden Systemen.
Batch eignet sich außerdem gut, wenn umfangreiche Geschäftsregeln im Spiel sind. Wenn Sie Finanzdaten über mehrere Hauptbücher hinweg normalisieren oder dimensionale Modelle in Warehouse-Qualität berechnen, ist es oft besser, einen vollständigen Ausschnitt zu verarbeiten, als Event für Event nach Korrektheit zu streben.
Praxisregel: Wenn der Konsument verlässliche historische Vollständigkeit statt sofortiger Reaktion verlangt, ist Batch in der Regel die bessere Standardwahl.
Was typischerweise schiefgeht
Der häufigste Fehlermodus ist nicht, dass Batch veraltet wäre. Sondern dass Teams die Infrastruktur überwachen statt der Daten. Der Airflow-DAG kann erfolgreich durchlaufen, während eine Quelltabelle verspätet eintrifft, eine Datei leer ankommt oder eine neue Spalte ein nachgelagertes Modell unbemerkt beschädigt.
Nutzen Sie digna Timeliness, um verspätete oder fehlende Batches zu erkennen, bevor ein Dashboard veraltet. Nutzen Sie digna Data Validation, um Geschäftsregeln auf Datensatzebene während der Loads durchzusetzen, und Schema Tracker, um Spalten- oder Typänderungen abzufangen, bevor sie sich zu BI-Ausfällen auswachsen. Ich empfehle außerdem, Batches nach fachlicher Domäne zu segmentieren, damit ein fehlerhafter Marketing-Extrakt nicht die Wiederherstellung von Gehaltsabrechnung oder Finanzen blockiert.
2. Echtzeit-Streaming-Pipelines
Zu Streaming greifen Teams, wenn die Aktualität der Daten das Handeln beeinflusst und nicht nur die Analyse. Hevo beschreibt Streaming-Pipelines als Systeme zur kontinuierlichen Datenaufnahme, die Kennzahlen, Berichte und zusammenfassende Statistiken innerhalb von Sekunden oder sogar Millisekunden aktualisieren. Damit sind sie entscheidend für Betrugserkennung, Live-Dashboards, Empfehlungssysteme und andere zeitkritische Workloads in Branchen wie Finanzwesen und Telekommunikation (Hevo zu Batch- vs. Streaming-Pipeline-Typen).
Das klingt attraktiv, doch die entscheidende Frage ist, ob Sie diese Geschwindigkeit dringend genug benötigen, um den Preis der Komplexität zu zahlen. Zahlungsüberwachung, IoT-Alarme, Live-Bestandstransparenz und clickstreambasierte Produktempfehlungen rechtfertigen dies in der Regel. Ein wöchentlicher KPI-Bericht für den Vertrieb nicht.
Was Streaming Ihnen tatsächlich bringt
Streaming verkürzt die Zeitspanne zwischen der Entstehung eines Events und der Entscheidung. Zahlungsprüfungen nach Stripe-Vorbild, über Kinesis gespeiste Logistik-Updates oder Kafka-basierte operative Dashboards hängen alle von dieser Eigenschaft ab.
Die Architektur verändert auch das Verhalten im Unternehmen. Operative Teams warten nicht mehr auf die Zusammenfassung von gestern, sondern reagieren auf das, was gerade jetzt passiert.
Die betrieblichen Schwachstellen
Streaming-Systeme scheitern anders als Batch-Systeme. Sie erhalten nicht einfach die Meldung „Job fehlgeschlagen“. Sie bekommen nachhinkende Consumer, Events in falscher Reihenfolge, Duplikate, verspätet eintreffende Datensätze und Schema-Drift in einem Topic, von dem viele nachgelagerte Services abhängen.
Ein praxistaugliches Setup mit digna sieht so aus:
Ratenverschiebungen früh erkennen: digna Data Anomalies kann das normale Event-Verhalten erlernen und unerwartete Einbrüche oder Spitzen aufdecken, ohne dass Schwellenwerte ständig nachjustiert werden müssen.
Aktualität kontinuierlich überwachen: Die In-Database-Metrikberechnung von digna eignet sich, um Verzögerungs- und Aktualitätssignale zu verfolgen, die Betreiber jeden Tag benötigen.
Vor Topic-Änderungen schützen: digna Schema Tracker hilft, Änderungen am Event-Schema abzufangen, bevor sie Stream-Transformationen oder Serving-Schichten beschädigen.
Streaming-Systeme scheitern meist nicht zuerst laut. Sie verschlechtern sich still, bis jemand bemerkt, dass das Dashboard nicht mehr mit der Realität übereinstimmt.
Wenn Ihr Stream sensible operative Events enthält, spielt das Deployment in einer Private Cloud eine wichtige Rolle. Teams in Finanzwesen, Gesundheitswesen und Telekommunikation benötigen Observability häufig innerhalb ihrer eigenen Umgebung und nicht als Datenkopie, die anderswohin gesendet wird.
3. Lambda-Architektur
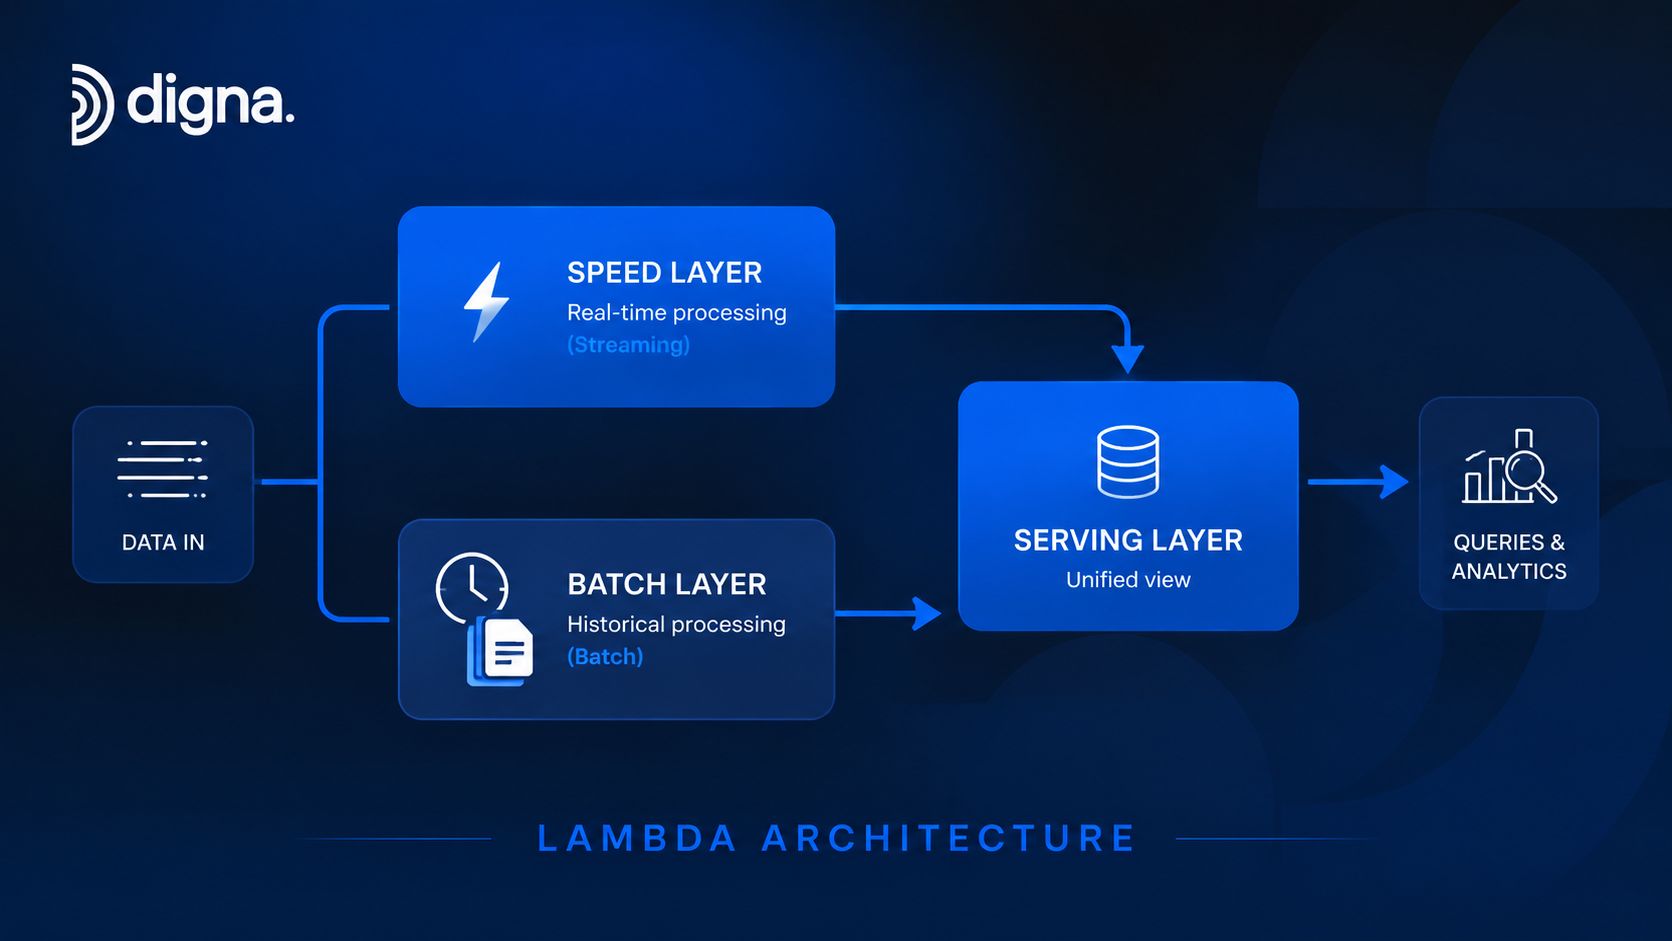
Die Lambda-Architektur existiert, weil manche Organisationen zwei Dinge gleichzeitig benötigen: schnelle Antworten jetzt und präzise Antworten später. Deshalb kombinieren sie eine Streaming-Speed-Layer mit einer Batch-Layer, die die vollständige Wahrheit neu berechnet, und führen beide in einer Serving-Layer zusammen.
Dieses Muster findet sich weiterhin in der Risikoanalyse, in Empfehlungssystemen und auf großen Analyseplattformen, bei denen Intraday-Zahlen näherungsweise sein dürfen, Tagesendzahlen aber korrigiert werden müssen. Der Reiz liegt auf der Hand: Sie müssen sich nicht zwischen Latenz und Vollständigkeit entscheiden.
Warum Teams sich für Lambda entscheiden
Lambda ist nützlich, wenn das Unternehmen eine vorübergehende Näherung tolerieren kann, aber keine dauerhafte Inkonsistenz akzeptiert. Ein Risk Desk benötigt möglicherweise sofort Intraday-Schätzungen des Exposures und stützt sich für das offizielle Reporting dann auf eine vollständigere Batch-Neuberechnung. Ein E-Commerce-Team kann Verhaltensdaten live einspielen und gleichzeitig umfassendere Empfehlungssignale im Batch neu trainieren oder neu berechnen.
Diese Aufteilung kann den Druck auf jede einzelne Engine verringern. Der Streaming-Pfad sorgt für Unmittelbarkeit. Der Batch-Pfad trägt die schwere historische Wahrheit.
Wo Lambda teuer wird
Die versteckten Kosten liegen in doppelter Logik. Teams implementieren ähnliche Geschäftsregeln oft zweimal und stellen dann fest, dass „nah genug“ in der Speed-Layer nicht mit „korrekt“ in der Batch-Layer übereinstimmt. Sobald diese Ergebnisse auseinanderlaufen, schwindet das Vertrauen schnell.
Nutzen Sie digna, um die Ergebnisse beider Pfade zu vergleichen – und nicht nur zu prüfen, ob jeder Pfad für sich genommen grün ist. Schema Tracker sollte beide Layer überwachen, da Drift in einer davon subtile Abweichungen erzeugt. Auch Data Validation gehört in beide Flows, damit zentrale Regeln zu Währungen, Identifikatoren, Statuswerten oder Hauptbuchsemantik im Lauf der Zeit nicht auseinanderdriften.
Ein gutes Lambda-Setup behandelt Abweichungen als vollwertiges Signal. digna Data Analytics ist hier nützlich, weil es Betreibern hilft zu untersuchen, wo Streaming-Näherungen dauerhaft von späteren Batch-Korrekturen abweichen.
4. Kappa-Architektur
Kappa reduziert Lambda auf ein einziges Verarbeitungsmodell. Alles ist ein Stream. Neue Events durchlaufen denselben Stream-Prozessor, und wenn Sie historische Daten erneut verarbeiten müssen, spielen Sie das Log mit derselben Logik erneut ab, statt eine separate Batch-Layer zu pflegen.
Engineers schätzen das, weil der Codepfad einfacher ist. Kafka mit Kafka Streams oder Flink ist die übliche Ausprägung. Mobile Telemetrie, eventgesteuerte SaaS-Plattformen und IoT-Systeme passen oft gut dazu, wenn das Event-Log dauerhaft gespeichert wird und ein Replay realistisch ist.
Warum Engineers Kappa schätzen
Der größte Vorteil ist Konsistenz. Ein einziger Transformationspfad bedeutet weniger Gelegenheiten, bei denen die Geschäftslogik auseinanderdriftet. Wenn Sie Ihrem Event-Log vertrauen, wird das Replay zu Ihrer Strategie für Wiederherstellung und Backfill.
Das funktioniert besonders gut in Organisationen, die bereits in Events denken. Produktanalysen, Streams von Nutzerinteraktionen und Aktivitäts-Feeds von Microservices lassen sich in einem Kappa-Modell oft leichter verwalten als in einem geteilten Design aus Batch plus Streaming.
Was replaybasierte Systeme zum Scheitern bringen kann
Replay klingt sauber, bis Sie auf die betriebliche Realität treffen. Historische Events passen möglicherweise nicht mehr zum aktuellen Schema. Nachgelagerte Consumer sind möglicherweise nicht idempotent. Die erneute Verarbeitung kann Systeme überfluten, die nur für den Live-Traffic dimensioniert wurden.
digna hilft am meisten, wenn Sie Replay als beobachtbaren Betriebsmodus behandeln und nicht als seltenen Notfall. Legen Sie Timeliness-Baselines sowohl für den Live-Fluss als auch für Replay-Zeitfenster fest. Setzen Sie Schema Tracker auf das Event-Log an, bevor ein Versionswechsel die historische Neuverarbeitung in eine Fehlerkaskade verwandelt. Wenden Sie auf wiederholt abgespielte Events dieselben Data-Validation-Regeln an wie auf Live-Events – sonst zertifizieren Sie einen Pfad und schwächen unbeabsichtigt den anderen.
Neuverarbeitung ist nicht einfach „noch einmal ausführen“. Sie ist ein eigenes Zuverlässigkeitsszenario mit eigenen Erwartungen.
5. Change-Data-Capture-Pipelines
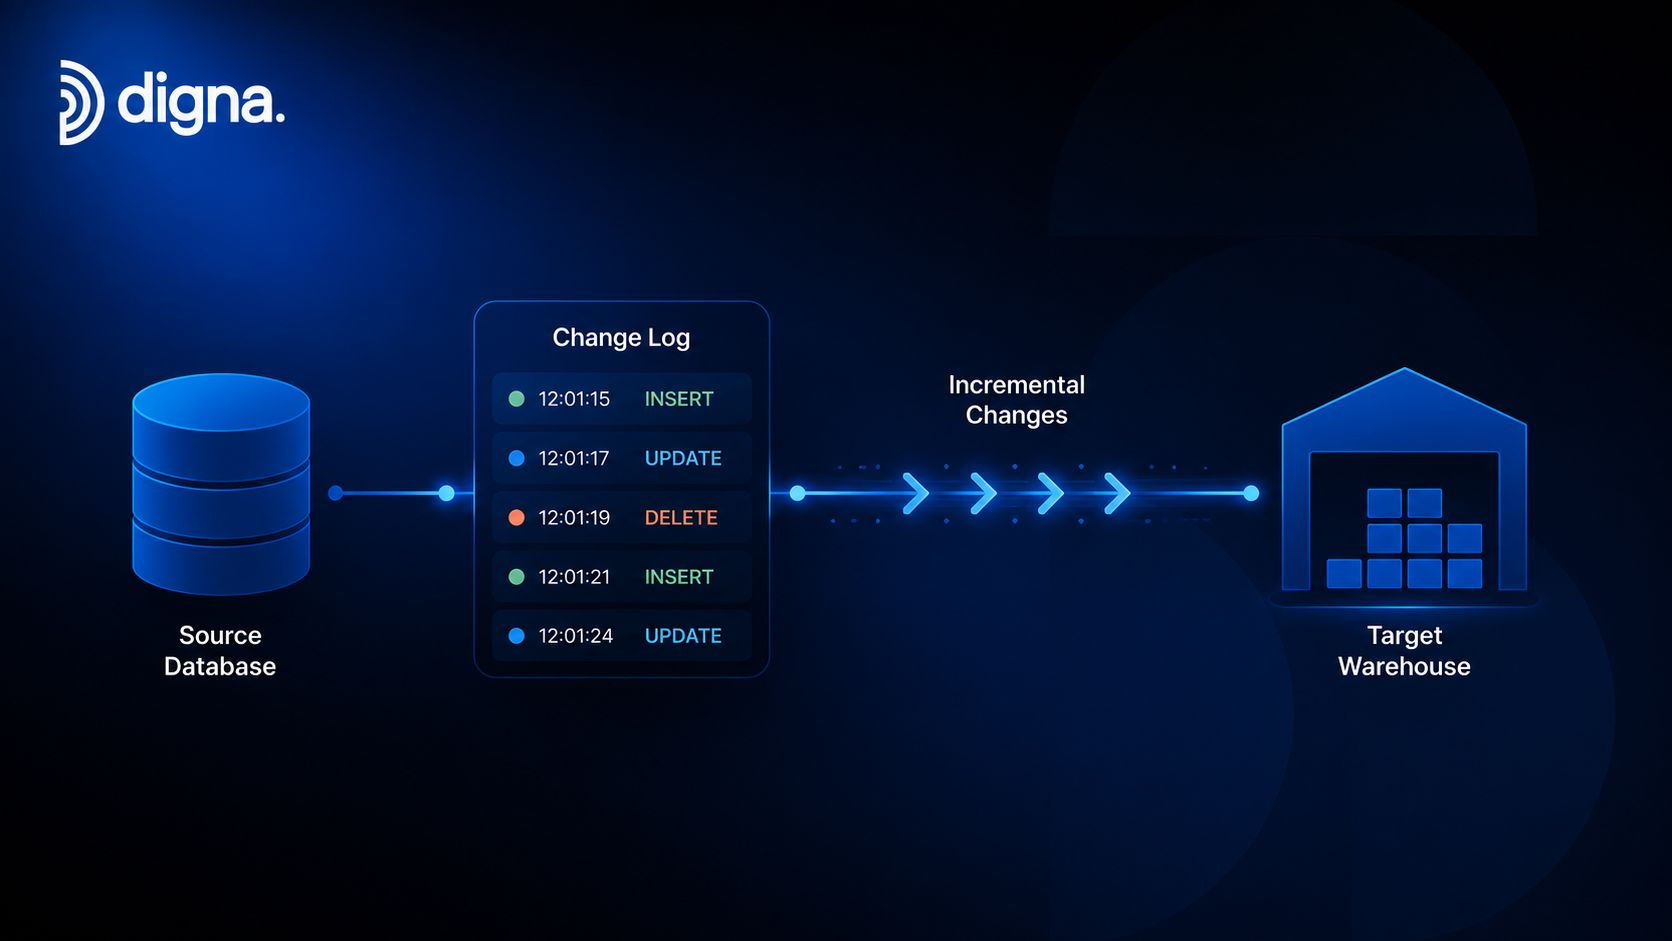
CDC-Pipelines übertragen nur, was sich geändert hat. Statt bei jedem Lauf vollständige Tabellen zu scannen, erfassen sie Inserts, Updates und Deletes aus operativen Datenbanken und geben diese Änderungen an nachgelagerte Systeme weiter. Debezium, AWS DMS und native Replikationsmechanismen sind gängige Optionen.
Dies ist eine der praxistauglichsten Arten von Datenpipelines, weil sie unnötige Neuberechnungen reduziert und eine Synchronisierung zwischen Systemen mit geringerer Latenz unterstützt. Reporting-Marts, Cloud-Warehouse-Synchronisierungen und operative Analysen erzielen mit CDC oft deutlich bessere Ergebnisse als mit wiederholten vollständigen Extrakten.
Warum CDC so schnell wächst
Research and Markets prognostiziert CDC-Pipelines als das am zweitschnellsten wachsende Segment unter den Datenpipeline-Typen, mit einer erwarteten jährlichen Wachstumsrate (CAGR) von 18 % bis 20 % bis 2030, da Unternehmen eine Synchronisierung mit geringer Latenz für Anwendungsfälle wie Bestands- und Hauptbuch-Updates ohne vollständige Tabellenneuberechnung anstreben (Research and Markets zu Segmenten von Pipeline-Tools).
Dieses Wachstum ist nachvollziehbar. Vollständige Tabellen-Loads sind verschwenderisch, wenn sich nur ein kleiner Ausschnitt geändert hat, und sie sind betrieblich riskant, wenn Quellsysteme empfindlich auf Extraktionslast reagieren.
Das Schwierige ist nicht die Erfassung
Das Schwierige ist, die Bedeutung zu erhalten. Deletes müssen nachgelagert sichtbar bleiben. Die Reihenfolge der Updates muss korrekt bleiben. Änderungen an Primärschlüsseln und Schemaänderungen können Duplikate oder verwaiste Datensätze erzeugen, wenn die Pipeline sie als einfache Append-Events behandelt.
Ein belastbares CDC-Betriebsmodell umfasst:
Deletes explizit validieren: digna Data Validation kann bestätigen, dass nachgelagerte Systeme Löschungen so abbilden, wie Ihre Consumer es erwarten.
Replikationsverzögerung messen: digna Timeliness hilft Betreibern zu erkennen, wann Änderungen aus der Quelle zu langsam eintreffen, um den Geschäftsprozess zu unterstützen.
Entwicklung der Quellen verfolgen: digna Schema Tracker ist für CDC wichtig, weil Änderungen an Quelldatenbanken oft außerhalb der Kontrolle des Analytics-Teams erfolgen.
Auch verdächtige Häufungen von Löschungen oder ungewöhnliche Update-Muster sollten Sie mit digna Data Anomalies markieren. Im Produktivbetrieb decken solche Muster oft Anwendungsfehler auf, bevor die Entwickler sie bemerken.
6. Datenvirtualisierungs-Pipelines
Nicht jede Pipeline muss Daten physisch bewegen. Datenvirtualisierung schafft eine logische Schicht, die eine einheitliche Sicht über mehrere Systeme hinweg bietet, während die Daten an Ort und Stelle bleiben. Denodo, föderierte Warehouse-Abfragen, Snowflake External Tables und BigQuery Federation sind bekannte Beispiele.
Dieses Muster ist nützlich, wenn das Kopieren von Daten langsam, organisatorisch schwierig oder durch Governance eingeschränkt ist. Organisationen im Gesundheitswesen benötigen möglicherweise eine einheitliche Patientensicht über mehrere Krankenhaussysteme hinweg. Finanzinstitute benötigen möglicherweise eine plattformübergreifende Kundensicht, ohne zuerst jede Legacy-Quelle in ein einziges Warehouse zu zwingen.
Wann Virtualisierung die richtige Wahl ist
Virtualisierung funktioniert gut, wenn der Zugriff wichtiger ist als aufwendige Transformationen. Sie verschafft Teams schnell eine gemeinsame semantische Schnittstelle und kann die Autonomie der Domänen unterstützen, wenn eine zentrale Konsolidierung zu lange dauern oder Konflikte um die Verantwortung auslösen würde.
Sie reduziert außerdem die Datenbewegung. Das ist attraktiv, wenn Systeme groß, reguliert oder häufigen Änderungen unterworfen sind.
Wo virtuelle Schichten in der Praxis scheitern
Der größte Fehler besteht darin, so zu tun, als würde die virtuelle Schicht die Probleme der Quellsysteme beseitigen. Das tut sie nicht. Sie legt sie nur schneller offen. Wenn eine Quelle verspätet, langsam oder strukturell inkonsistent ist, übernimmt das föderierte Ergebnis diese Schwäche.
Deshalb muss die Qualitätsüberwachung am Rand der Quellen beginnen und nicht erst auf der semantischen Schicht. digna in einem Private-Cloud-Setup ist hier nützlich, weil Teams Qualität und Schemaänderungen über föderierte Quellen hinweg überwachen können, ohne sensible Datensätze zu bewegen. Timeliness-Monitoring hilft außerdem zu erkennen, welche Quelle die Abfrageleistung oder Aktualität verschlechtert, bevor die virtualisierte Ausgabe unbrauchbar wird.
Eine virtuelle Schicht kann den Zugriff vereinheitlichen. Die Zuverlässigkeit kann sie nur vereinheitlichen, wenn Sie jede Quelle einzeln beobachten.
7. Event-Streaming mit Event Sourcing
Event Sourcing verändert die Vorstellung davon, was ein System als maßgeblichen Datenbestand führt. Statt nur den aktuellen Zustand zu speichern, speichert das System jede Zustandsänderung als unveränderliches Event. Subscriber bauen aus dieser Historie anschließend Projektionen, materialisierte Views und nachgelagerte Lesemodelle auf.
Das macht diese Architektur attraktiv für Auftragsmanagement, Audit-Trails im Bankwesen, die Nachverfolgung des Fahrtlebenszyklus und CQRS-Systeme, bei denen die zeitliche Historie ebenso wichtig ist wie der aktuelle Zustand. Wenn jemand fragt: „Was wussten wir zu diesem Zeitpunkt?“, kann Event Sourcing das sauber beantworten.
Was Ihnen unveränderliche Events bringen
Nachvollziehbarkeit für Audits ist der offensichtlichste Vorteil, doch der praktische Gewinn liegt in der Rekonstruierbarkeit. Teams können Projektionen neu aufbauen, Übergänge untersuchen und genau nachvollziehen, welche Events zu einem Endzustand geführt haben.
Das ist in regulierten Umgebungen und in komplexen Transaktionssystemen wichtig. Wenn eine Bestellung von „aufgegeben“ über „verpackt“ und „versendet“ zu „erstattet“ wechselt, hat jeder Übergang eine betriebliche Bedeutung.
Warum Observability hier besonders wichtig ist
Ein auf Event Sourcing basierendes System verzeiht fehlerhafte Events nicht. Gelangt ein fehlerhaftes Event ins Log, interpretieren es nachgelagerte Projektionen möglicherweise unterschiedlich oder scheitern an unterschiedlichen Stellen. Auch die Versionierung ist schwierig, weil alte und neue Consumer lange Zeit nebeneinander bestehen können.
Nutzen Sie digna Data Validation, um Event-Struktur und Pflichtfelder durchzusetzen, bevor sich Schäden über Subscriber-Ketten ausbreiten. Nutzen Sie Timeliness, um nachhinkende Subscriber zu erkennen, und Schema Tracker, um Übergänge zwischen Event-Versionen zu überwachen, damit Producer ältere Projektionen nicht ohne Vorwarnung beschädigen. Data Anomalies ist außerdem nützlich, um verdächtige Event-Sequenzen zu erkennen, die auf Betrug, Missbrauch oder Anwendungsfehler hindeuten können.
In diesen Systemen überschneiden sich „Pipeline-Qualität“ und „Anwendungskorrektheit“. Deshalb reicht generisches Infrastruktur-Monitoring nicht aus.
8. Data Mesh mit dezentralen Pipelines
Data Mesh ist weniger ein einzelnes Pipeline-Muster als ein Betriebsmodell für viele Pipelines. Domänenteams verantworten ihre Datenprodukte und die dahinterliegenden Pipelines, während eine Governance-Schicht gemeinsame Standards für Auffindbarkeit, Qualität, Verträge und Zugriff festlegt.
Dieser Ansatz ist attraktiv für große Organisationen, in denen ein zentrales Datenplattform-Team zum Engpass geworden ist. Produkt-, Finanz-, Risiko-, Marketing- und Operations-Teams können schneller vorankommen, wenn sie ihre eigenen Datenergebnisse verantworten.
Was Dezentralisierung löst
Sie behebt den Verlust von lokalem Kontext. Das Domänenteam versteht die Bedeutung von Stornierungen, aktiven Nutzern, Vertragsverlängerungen oder fehlgeschlagenen Zahlungen in der Regel besser als ein weit entferntes zentrales Team. Das verbessert Modellierungsentscheidungen und die Reaktionszeit, wenn sich etwas ändert.
Sie skaliert außerdem die Bereitstellung. Es gibt nicht mehr einen zentralen Backlog für jede Extraktion, jedes Schema-Update und jede Anfrage eines Consumers.
Ein genauerer Blick auf die Data-Mesh-Architektur und ihre Bedeutung heute lohnt sich, wenn Ihre Organisation sich von einer zentralisierten Verantwortung wegbewegt.
Was ein Data Mesh ins Chaos stürzt
Ohne gemeinsame Observability wird ein Data Mesh zu einer Sammlung isolierter Fehler. Ein Team definiert Aktualität auf die eine Weise, ein anderes ignoriert Schema-Verträge, und Consumer erhalten je nach abgefragter Domäne fünf unterschiedliche Qualitätsstandards.
digna eignet sich hier gut als verbindende Schicht. Jede Domäne kann die Autonomie über ihre Pipelines behalten und dennoch dieselben Data-Validation-Muster, dasselbe Timeliness-Framework und dieselbe Disziplin beim Schema Tracker nutzen. Auch ein Deployment in der Private Cloud oder On-Premises ist wichtig, da dezentrale Teams häufig in sensiblen Geschäftsbereichen arbeiten, die Produktionsdaten nicht außerhalb kontrollierter Umgebungen senden dürfen.
Es geht nicht darum, die Verantwortung erneut zu zentralisieren. Es geht darum, die Zuverlässigkeit zu standardisieren, ohne die Fachkompetenz der Domänen einzuebnen.
9. Machine-Learning-Feature-Pipelines
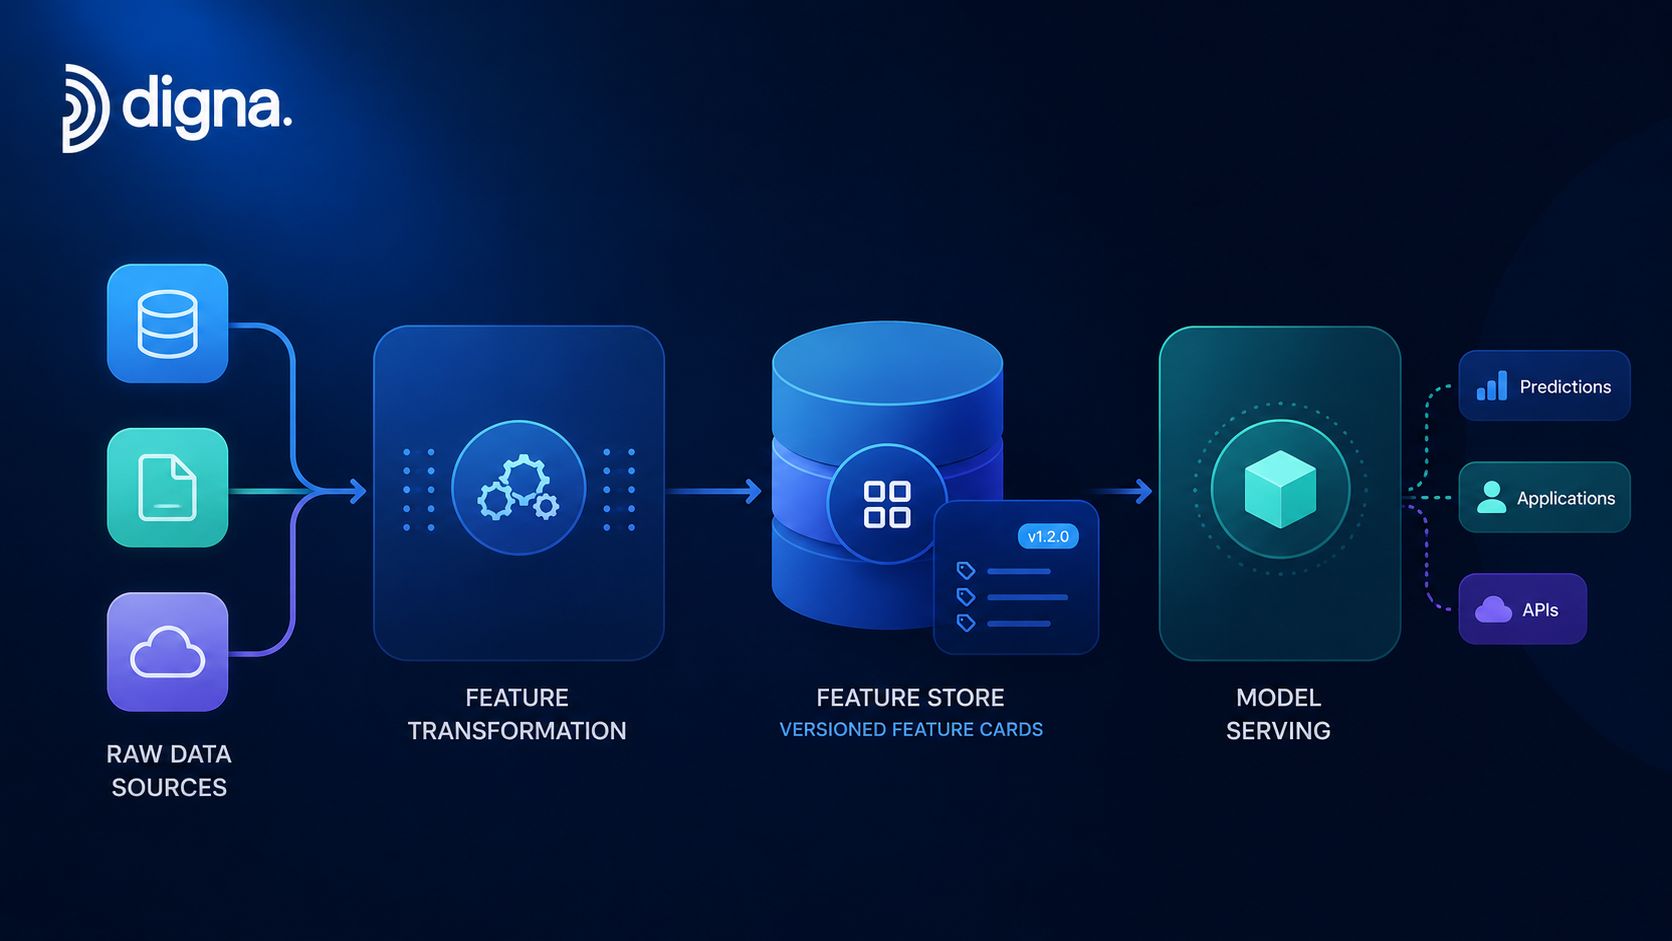
Feature-Pipelines liegen zwischen Data Engineering und ML Operations. Sie berechnen, versionieren, speichern und liefern die aufbereiteten Eingaben, die Modelle für Training und Inferenz nutzen. Feast, Databricks Feature Store und Tecton sind gängige Beispiele.
Aus der Ferne ähneln sie anderen Arten von Datenpipelines, doch der betriebliche Anspruch ist höher. Ein Dashboard kann eine veraltete Kennzahl eine Weile verkraften. Ein Produktivmodell kann unbemerkt an Qualität verlieren, wenn sich Feature-Aktualität, Null-Behandlung oder Werteverteilung verschieben und niemand es bemerkt.
Warum Feature-Pipelines anders sind
Sie haben zwei Consumer mit unterschiedlichen Anforderungen. Trainingssysteme benötigen Reproduzierbarkeit und historische Konsistenz. Online-Inferenz benötigt aktuelle Werte und eine geringe Serving-Latenz.
Die Architektur ändert sich zudem je nach Transformationsansatz. GII Research stellt fest, dass ELT das klassische ETL in Cloud-nativen Umgebungen deutlich überholt hat, weil skalierbare Warehouse-Rechenleistung Transformationen nach dem Laden effizient ermöglicht, während ETL dort dominant bleibt, wo eine strikte Bereinigung und Schemadurchsetzung vor dem Laden erforderlich ist. Cloudbasiertes Deployment ist der vorherrschende Modus, und hybride Ansätze mit Serverless-Prozessen wie AWS Glue und Azure Data Factory werden zum Standard für Organisationen, die Skalierung und Legacy-Integration in Einklang bringen müssen (GII Research zu Deployment sowie ETL im Vergleich zu ELT).
Der Fehlermodus, den Teams zu spät bemerken
Der häufige Fehler besteht darin, das Modell zu überwachen und die Feature-Pipeline zu ignorieren. Bis die Modellleistung nachlässt, kann das zugrunde liegende Feature-Problem bereits seit Tagen bestehen.
Ein praxistaugliches Observability-Setup umfasst:
Drift-ähnliches Verhalten in den Eingaben beobachten: digna Data Anomalies kann unerwartete Veränderungen in Feature-Verteilungen markieren, bevor sie sich als schlechte Modellergebnisse zeigen.
Serving-Aktualität überwachen: digna Timeliness hilft, veraltete Features abzufangen, bevor der Online Store überholte Werte ausliefert.
Strukturelle Änderungen verfolgen: digna Schema Tracker ist nützlich, wenn sich Feature-Definitionen weiterentwickeln, Spalten hinzukommen oder wegfallen oder Transformationsergebnisse ihre Form ändern.
Feature-Pipelines benötigen außerdem harte geschäftliche Constraints. Wenn ein aus Preisen abgeleitetes Feature negativ wird oder ein Kategoriefeld leer ankommt, sollte Data Validation das Problem an der Pipeline-Grenze stoppen. Für Teams, die kundenorientierte Personalisierungssysteme entwickeln, ist das ebenso wichtig wie die Modellauswahl selbst. Dieselbe betriebliche Disziplin wirkt sich auch auf angrenzende Systeme aus, die das Kundenerlebnis prägen, etwa auf Initiativen zur Optimierung von E-Commerce-Visuals mit KI.
Vergleich der 9 Datenpipeline-Typen
Pipeline / Architektur | Implementierungskomplexität 🔄 | Ressourcenbedarf & Betriebsaufwand ⚡ | Erwartete Ergebnisse (Aktualität / Genauigkeit) ⭐📊 | Ideale Anwendungsfälle 📊 | Zentrale Vorteile & Kurztipp 💡 |
|---|---|---|---|---|---|
Batch-Processing-Pipelines | Niedrig → mittel (geplante Jobs, einfacherer Betrieb) 🔄 | Effizient bei großen Volumina; Ressourcenkonkurrenz in Spitzenzeiten während der Zeitfenster ⚡ | Hohe Genauigkeit ⭐⭐⭐, hohe Latenz (Stunden→Tage) 📊 | Nächtliches Reporting, groß angelegtes ETL, periodische Analysen | Bewährte Zuverlässigkeit; Tipp: Timeliness überwachen, um verpasste Zeitfenster zu erkennen 💡 |
Echtzeit-Streaming-Pipelines | Hoch (verteilte Stream-Prozessoren & Broker) 🔄 | Hohe laufende Rechen- & Betriebskosten; erfordert spezialisiertes Personal ⚡ | Sehr geringe Latenz, Aktualität nahezu in Echtzeit ⭐⭐📊 (Genauigkeit hängt von den Garantien ab) | Betrugserkennung, operative Dashboards, Live-Analysen | Ermöglicht sofortige Erkennung; Tipp: Anomalieerkennung für Streaming-Muster nutzen 💡 |
Lambda-Architektur | Sehr hoch (doppelte Codepfade + Serving-Layer) 🔄 | Sehr hoch (Pflege von Batch- + Streaming-Infrastruktur) ⚡ | Näherungswerte mit geringer Latenz + präzise Batch-Korrekturen ⭐⭐⭐📊 | Workloads, die sowohl eine sofortige Sicht als auch eine exakte historische Neuberechnung benötigen | Verbindet Geschwindigkeit und Genauigkeit; Tipp: Konsistenz zwischen den Layern per Monitoring validieren 💡 |
Kappa-Architektur | Hoch (nur Streaming, Replay-Fähigkeit) 🔄 | Hoch (Broker-Speicher für Historie und Lastspitzen bei der Neuverarbeitung) ⚡ | Konsistente Logik, Aktualität in Echtzeit; Neuverarbeitung möglich ⭐⭐📊 | Eventgesteuerte Systeme, bei denen der Stream die Neuverarbeitung übernehmen kann (Kafka/Flink) | Einfacherer Betrieb als Lambda; Tipp: Aufbewahrung des Event-Logs sicherstellen und Replays überwachen 💡 |
Change-Data-Capture-Pipelines (CDC) | Mittel → hoch (Log-Zugriff, Mapping) 🔄 | Geringe Netzwerkübertragung; mittlerer Infrastrukturbedarf für Verarbeitung und Reihenfolge ⚡ | Inkrementelle Updates mit geringer Latenz, hohe Detailtreue ⭐⭐⭐📊 | Inkrementelle Synchronisierung, Echtzeit-Warehouses, Reporting-Marts | Minimiert Datenbewegung; Tipp: Schemaänderungen und Behandlung von Löschungen sorgfältig verfolgen 💡 |
Datenvirtualisierungs-Pipelines | Mittel (semantische Schicht & Konnektoren) 🔄 | Geringer Speicherbedarf, aber Laufzeit abhängig von der Leistung der Quellen; variable Kosten ⚡ | Aktualität in Echtzeit, aber schwankende Abfrageleistung ⭐⭐📊 | Ad-hoc-Analysen, föderierte Abfragen, schnelle Governance-Demos | Schnell bereitgestellt bei minimaler Datenbewegung; Tipp: SLAs der Quellen und Join-Leistung überwachen 💡 |
Event-Streaming mit Event Sourcing | Hoch (unveränderliches Log, Projektionen, Versionierung) 🔄 | Hoher Speicherbedarf für die vollständige Historie; betriebliche Komplexität bei Projektionen ⚡ | Vollständige Auditierbarkeit und Rekonstruierbarkeit, zeitliche Analyse ⭐⭐⭐📊 | Audit-Trails, CQRS, Systeme, die vollständige Historie und Replay benötigen | Hervorragend für Compliance & Debugging; Tipp: Event-Schemas und Pünktlichkeit des Eintreffens validieren 💡 |
Data Mesh mit dezentralen Pipelines | Hoch (organisatorische + technische Komplexität) 🔄 | Höherer Gesamtinfrastrukturbedarf über alle Domänen; Kosten für föderierte Tools ⚡ | Domänenorientierte, skalierbare Ergebnisse; Qualität variiert je nach Domäne ⭐⭐📊 | Große Organisationen, die Domänenautonomie und produktisierte Daten anstreben | Skaliert durch Autonomie; Tipp: föderierte Observability und gemeinsame Verträge durchsetzen 💡 |
Machine-Learning-Feature-Pipelines | Hoch (Feature-Versionierung, Point-in-Time-Korrektheit) 🔄 | Mittlerer→hoher Speicher- & Rechenbedarf; Betrieb des Feature Stores ⚡ | Konsistente Features für Training und Serving, weniger Modell-Drift ⭐⭐⭐📊 | Feature Stores, Model Serving, reproduzierbare ML-Workflows | Erhöht die ML-Zuverlässigkeit; Tipp: Feature-Aktualität und Drift kontinuierlich überwachen 💡 |
Von der Architektur zum Betrieb: So machen Sie Ihre Pipeline zuverlässig
Die Wahl der richtigen Architektur ist die erste wichtige Entscheidung. Sie ist nicht die letzte. Batch-, Streaming-, CDC-, Event-Sourcing- und ML-orientierte Pipelines lösen jeweils unterschiedliche Bereitstellungsprobleme, doch jede Architektur bringt auch eigene Qualitäts- und Zuverlässigkeitsrisiken mit sich.
Batch-Pipelines verbergen Verspätungen, bis ein geplanter Lauf sein Zeitfenster verpasst. Streaming-Systeme laufen weiter, während sie unmerklich vom erwarteten Verhalten abdriften. Lambda erzeugt Konsistenzprobleme zwischen den Pfaden. Kappa macht die Korrektheit von Replays zu einem zentralen Anliegen. CDC kann Änderungen schnell replizieren und dennoch Löschungen oder die Update-Reihenfolge falsch behandeln. Virtualisierung kann den Zugriff vereinheitlichen und zugleich Schwächen in den zugrunde liegenden Systemen verdecken. Data Mesh kann das Tempo der Domänen erhöhen und dabei Standards fragmentieren. Feature-Pipelines können noch lange Daten ausliefern, nachdem die Modelleingaben fehlerhaft geworden sind.
Diese betriebliche Realität ist der Grund, warum Architekturdiagramme nicht ausreichen. Jede Produktiv-Pipeline benötigt eine Kontrollschicht, die Ihnen sagt, ob die Daten pünktlich eintreffen, ob die Datensätze die Geschäftsregeln noch erfüllen, ob sich Schemas geändert haben und ob die Muster in den Daten noch normal aussehen. Wenn Sie nur Jobs, Container oder Warehouse-Kosten überwachen, entgehen Ihnen genau die Fehler, die Vertrauen zerstören.
Die stärksten Teams integrieren Observability und Validierung vom ersten Tag an in die Pipeline. Sie warten nicht auf den ersten Ausfall eines Management-Dashboards oder den ersten Modellvorfall. Sie definieren das erwartete Eintreffverhalten. Sie verfolgen Schemaänderungen, bevor nachgelagerte Systeme ausfallen. Sie validieren zentrale Datensätze dort, wo die Daten bewegt werden, und nicht erst, nachdem Analysten Tickets erstellt haben. Sie untersuchen Anomalien im Kontext, statt sich nur auf fragile, manuell abgestimmte Schwellenwerte zu verlassen.
Genau hier passt digna gut zu allen wichtigen Arten von Datenpipelines. Die Kombination aus Timeliness, Data Validation, Schema Tracker, Data Anomalies und Data Analytics adressiert Fehlermuster, mit denen Engineers in der Praxis zu tun haben. Da digna Metriken innerhalb der Datenbank des Kunden berechnet und Deployments in der Private Cloud oder On-Premises unterstützt, können Teams sensible Umgebungen überwachen, ohne Produktionsdaten an einen externen Anbieter zu übergeben.
Es gibt auch einen strategischen Vorteil. Wenn Stakeholder darauf vertrauen können, dass Aktualität, Struktur und Gültigkeit der Datensätze aktiv überwacht werden, verbessern sich Architekturdiskussionen. Teams hören auf, abstrakt über Pipeline-Stile zu debattieren, und wählen das Design, das zum geschäftlichen Bedarf passt – mit einem klaren Plan, wie sie es sicher betreiben.
Bei zuverlässigen Datenpipelines geht es nicht nur darum, Daten von A nach B zu bewegen. Es geht darum, Daten bereitzustellen, auf deren Grundlage Menschen handeln können, ohne sie infrage zu stellen. Das ist der Standard, auf den es sich hinzuarbeiten lohnt.
Wenn Sie dieses Maß an Kontrolle über Batch, Streaming, CDC, Feature-Pipelines und dezentrale Datenprodukte hinweg wünschen, ist digna genau dafür gebaut. digna bietet Datenteams eine Plattform für Anomalieerkennung, Validierung auf Datensatzebene, Timeliness-Monitoring, Verfolgung von Schemaänderungen und historische Observability-Analysen – und die Daten bleiben dabei stets in kundenkontrollierten Umgebungen.
Batch-Läufe, die ihr Zeitfenster verpassen, und CDC-Feeds mit wachsender Replikationsverzögerung haben ein gemeinsames Symptom: Daten treffen später ein, als das Unternehmen erwartet. Genau das lernt digna Timeliness und alarmiert entsprechend.
Häufig gestellte Fragen
Welche sind die wichtigsten Arten von Datenpipelines?
Der Artikel behandelt neun: Batch Processing, Echtzeit-Streaming, Lambda, Kappa, Change Data Capture, Datenvirtualisierung, Event-Streaming mit Event Sourcing, Data Mesh mit dezentralen Pipelines sowie Machine-Learning-Feature-Pipelines. Jede löst ein anderes Bereitstellungsproblem, und jede bringt eigene Qualitäts- und Zuverlässigkeitsrisiken mit sich, die vom ersten Tag an überwacht werden müssen.
Wann sollte ich Batch Processing statt Streaming einsetzen?
Wählen Sie Batch, wenn die geschäftliche Entscheidung morgen früh fällt und nicht in den nächsten Sekunden. Nächtliche Snowflake-Warehouse-Loads, der wöchentliche Bestandsabgleich im Einzelhandel und das Finanzreporting zum Tagesabschluss passen gut zu Batch, während Betrugserkennung, IoT-Alarme und Live-Dashboards die zusätzlichen Kosten und die Komplexität von Streaming in der Regel rechtfertigen.
Was ist der Unterschied zwischen Lambda- und Kappa-Architektur?
Lambda betreibt zwei Pfade: eine Streaming-Speed-Layer für schnelle Näherungswerte und eine Batch-Layer, die die vollständige Wahrheit neu berechnet; beide werden in einer Serving-Layer zusammengeführt. Kappa behandelt alles als Stream und verarbeitet die Historie erneut, indem das Event-Log mit derselben Logik erneut abgespielt wird, typischerweise mit Kafka und Kafka Streams oder Flink.
Was geht bei Change-Data-Capture-Pipelines typischerweise schief?
Die Erfassung ist selten das Problem – die Bedeutung zu erhalten schon. Deletes müssen nachgelagert sichtbar bleiben, die Update-Reihenfolge muss korrekt bleiben, und Änderungen an Primärschlüsseln oder am Schema können Duplikate oder verwaiste Datensätze erzeugen, wenn sie als einfache Appends behandelt werden. Research and Markets prognostiziert für CDC-Pipelines eine jährliche Wachstumsrate von 18 % bis 20 % bis 2030.
Wie überwacht man Machine-Learning-Feature-Pipelines?
Überwachen Sie die Feature-Pipeline selbst und nicht nur das Modell, da Feature-Probleme tagelang unbemerkt bleiben können, bevor die Leistung nachlässt. Der Artikel empfiehlt, Feature-Verteilungen auf Drift zu beobachten, die Serving-Aktualität zu prüfen, damit der Online Store niemals veraltete Werte ausliefert, Schemaänderungen zu verfolgen und harte Constraints wie nicht negative Preis-Features zu validieren.



