Apache Iceberg: der Leitfaden für die Praxis
|
8
min. Lesezeit

Sie haben Apache Iceberg eingeführt, ein paar Tabellen registriert und Spark auf den Objektspeicher gerichtet. Der erste Produktionsvorfall kommt meist, bevor sich die Architektur fertig anfühlt: Eine nachgelagerte Abfrage liest ein unerwartetes Schema, eine Partitionsänderung verhält sich in Trino anders, oder niemand weiß, welche Snapshots sich gefahrlos entfernen lassen. Die Parquet-Dateien sind selten der schwierige Teil. Eigentum, Katalogkoordination, Metadatenpflege und der Nachweis, dass eine Tabelle vertrauenswürdig ist, machen die eigentliche Arbeit aus.
Der Wert von Apache Iceberg entsteht daraus, den Tabellenzustand vom physischen Dateilayout zu trennen. Diese Trennung trägt verlässliche Analytik über Engines hinweg, bedeutet aber auch, dass Teams Betriebspraktiken brauchen, die über die Formatspezifikation hinausgehen. Dieser Leitfaden behandelt das offene Tabellenformat Apache Iceberg als Plattformdisziplin, mit klaren Grenzen zwischen Speicher, Katalogen, Engines, Wartung und Observability.
Inhaltsverzeichnis
Warum Iceberg eine Betriebsdisziplin ist und nicht bloß ein Dateiformat
Ein praktisches Beispiel: eine Iceberg-Tabelle anlegen und abfragen
Bewährte Praktiken zu Partitionierung, Sortierung und Dateigrößen
Iceberg-Tabellen mit Blick auf Schema, Qualität und Timeliness betreiben
Von Hive, Delta oder Hudi migrieren, ohne den Lake niederzubrennen
Warum Iceberg eine Betriebsdisziplin ist und nicht bloß ein Dateiformat
Ein Team kann Iceberg schnell einführen und dennoch keine Antworten auf die Fragen haben, die in der Produktion zählen. Wer verantwortet den Snapshot-Ablauf? Welches Team genehmigt eine Schemaänderung? Wie erkennen Sie, dass ein Produzent ein Feld mit unverträglicher Bedeutung ergänzt? Was passiert, wenn Spark und Trino eine Partitionstransformation unterschiedlich deuten, weil ihre Katalog- oder Connector-Konfiguration auseinandergelaufen ist?
Iceberg begann 2017 bei Netflix, um Grenzen bei Skalierbarkeit und Konsistenz in Apache-Hive-Tabellen anzugehen. Netflix spendete es im November 2018 an die Apache Software Foundation, und im Mai 2020 wurde es ein Top-Level-Apache-Projekt, wie die Release-Historie des Projekts zeigt. Diese Meilensteine erklären den technischen Fokus des Formats, doch sie nehmen nicht die Betriebsverantwortung ab, die nach der Einführung auftaucht.
Die physische Datenschicht ist vergleichsweise unkompliziert. Engines schreiben Dateien, meist Parquet, in den Objektspeicher. Die schwierige Arbeit beginnt rund um diese Dateien:
Katalog-Governance: Legen Sie fest, wer Tabellen anlegen, ändern, löschen oder promoten darf und wie Bezeichner über Umgebungen hinweg aufgelöst werden.
Metadatenhygiene: Steuern Sie die Snapshot-Aufbewahrung, entfernen Sie verwaiste Dateien und überwachen Sie das Manifestwachstum.
Engine-Koordination: Testen Sie, wie Spark, Flink, Trino und andere Reader mit demselben Schema, denselben Partitionsspezifikationen, Deletes und Isolationsregeln umgehen.
Nachweise: Verbinden Sie Datenqualität, Frische, Lineage und Deployment-Historie mit einem konkreten Tabellenzustand.
Praktische Regel: Behandeln Sie jede Iceberg-Tabelle als verwaltetes Produkt mit Verantwortlichen, einer Betriebsrichtlinie und einem beobachtbaren Lebenszyklus.
Genau hier passt Data Observability hinein. Observability ersetzt weder den Katalog noch die Query-Engine. Sie liefert die Nachweise, um zu beantworten, ob eine Tabelle jetzt gesund ist, ob eine Änderung eine Regression verursacht hat und ob eine Engineerin im Bereitschaftsdienst dem aktuellen Snapshot trauen kann.
Leistung und Korrektheit entscheiden sich auf dieser Betriebsschicht. Iceberg gibt Teams starke Bausteine, doch eine Plattform, die Wartung nicht plant, Zugriff nicht koordiniert und Verhalten nicht überwacht, wird weiterhin unzuverlässige Daten erzeugen.
Die Kernbausteine einer Iceberg-Tabelle
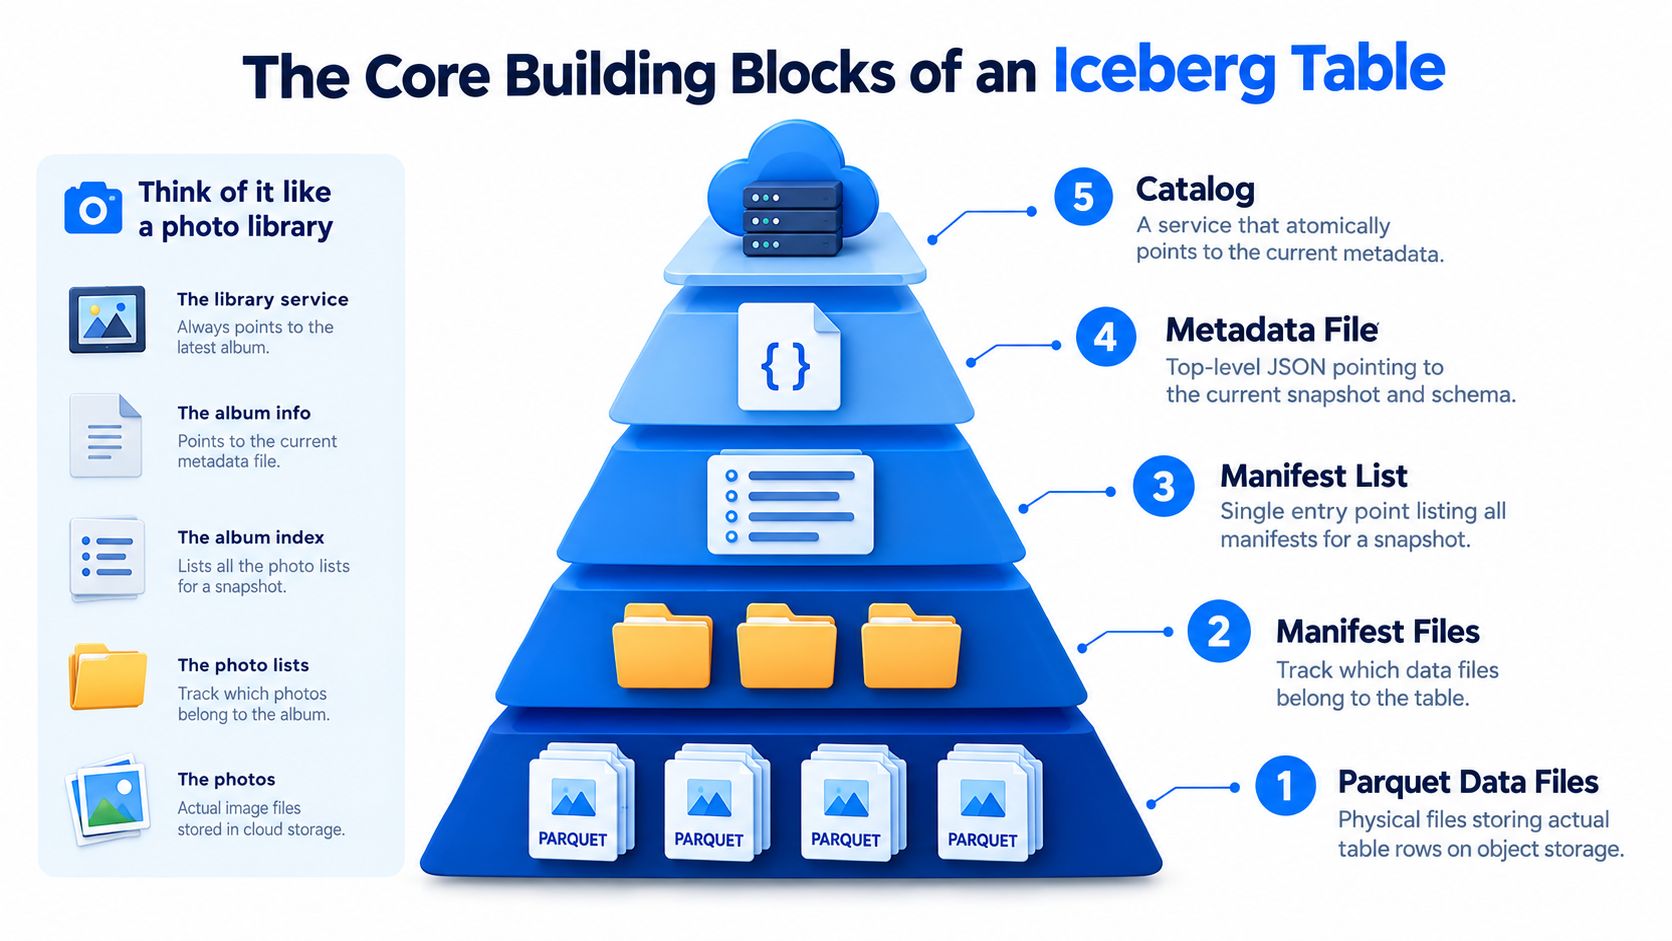
Ein brauchbares Denkmodell beginnt mit einer Fotosammlung. Die Fotos sind die Zeilen, Ordner beschreiben Gruppen von Fotos, ein Albumverzeichnis sagt Ihnen, wo Sie nachsehen müssen, und ein Bibliothekskatalog sagt Ihnen, welche Sammlung aktuell ist.
Ganz unten speichern Parquet-Datendateien die eigentlichen Zeilen im Objektspeicher. Parquet ist ein spaltenorientiertes Dateiformat, und Iceberg verwaltet Verweise auf diese Dateien, statt Reader zu zwingen, sie durch das Scannen von Verzeichnisnamen zu entdecken. Eine fokussierte Erklärung der Dateischicht finden Sie unter was Parquet ist und wie es funktioniert.
Manifestdateien wirken wie kuratierte Ordner mit Verweisen auf Datendateien, samt Informationen, die Engines helfen zu entscheiden, welche Dateien relevant sind. Eine Manifestliste ist das Verzeichnis für einen bestimmten Snapshot. Sie benennt die Manifeste, die diesen Tabellenzustand bilden, sodass ein Planer mit einem strukturierten Einstiegspunkt beginnen kann, statt den gesamten Objektspeicher zu durchsuchen.
Die Metadaten- und Katalogschichten
Die Tabellenmetadatendatei ist der Katalogeintrag der Bibliothek. Iceberg speichert den Tabellenzustand in JSON-Metadaten, einschließlich Schemata, Partitionsspezifikationen, Snapshot-Historie und Eltern-Kind-Lineage. Snapshots sind in den Tabellenmetadaten eingebettet, statt als unabhängiges Zustandssystem serialisiert zu werden, wodurch Reader eine Tabelle zu einem bestimmten Zeitpunkt aus dem Snapshot-Log und den Lineage-Informationen rekonstruieren können, wie die Iceberg-Tabellenspezifikation beschreibt.
Der Katalog hält den atomaren Verweis auf die aktuelle Metadatendatei. Ein Writer erzeugt neue Daten und Metadaten und aktualisiert dann diesen Verweis über den Commit-Mechanismus des Katalogs. Reader lösen den Tabellenbezeichner über den Katalog auf, ermitteln den aktuellen Metadatenort und planen gegen die Manifeste, auf die der gewählte Snapshot verweist.
Das wiederverwendbare Modell ist einfach:
Datendateien speichern Zeilen.
Manifestdateien verfolgen Einträge zu Datendateien.
Manifestlisten benennen die Manifeste eines Snapshots.
Metadaten erfassen Schemata, Partitionsspezifikationen, Snapshots und Lineage.
Der Katalog verweist atomar auf die aktuellen Metadaten.
Diese Indirektion ist die Grundlage für atomare Commits und engine-unabhängige Lesevorgänge. Sie erklärt auch, warum das manuelle Löschen von Dateien oder das Ändern von Objektspeicherpfaden außerhalb der Iceberg-Verfahren die Tabellenintegrität brechen kann.
Snapshots, Manifeste, Hidden Partitioning und Time Travel
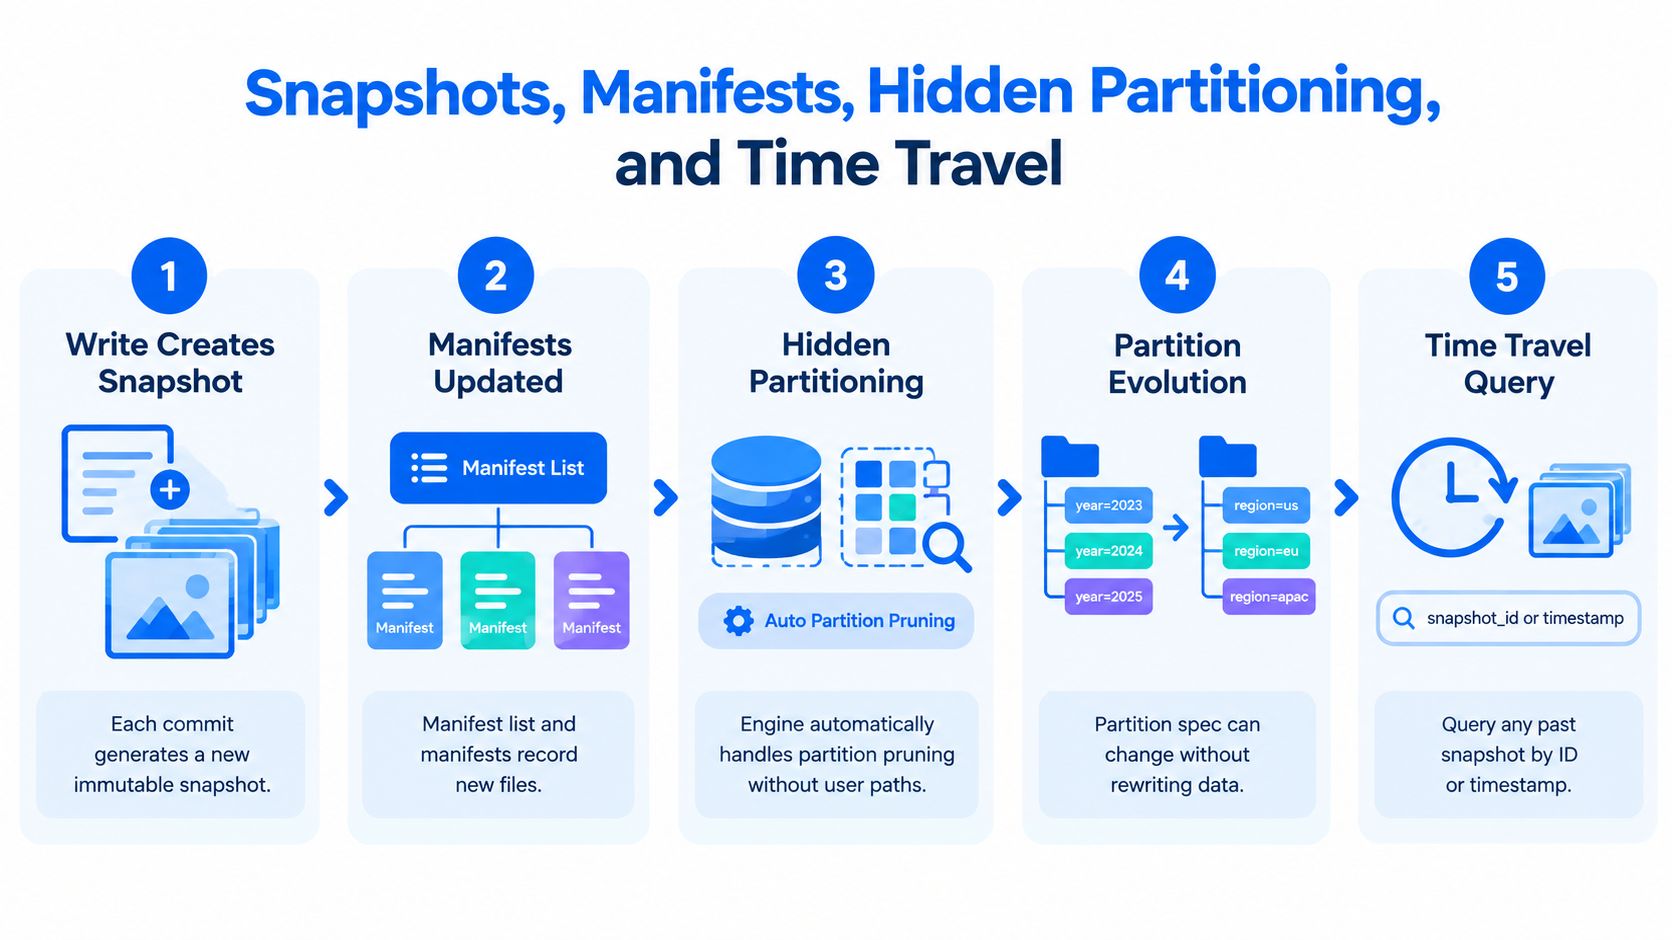
Ein Iceberg-Schreibvorgang ändert den Tabellenzustand, indem er einen neuen Snapshot committet. Der Snapshot hält einen neuen Punkt in der Tabellenhistorie fest und verweist auf die Manifestliste, die die zu diesem Zeitpunkt sichtbaren Dateien beschreibt. Da Iceberg Snapshot-Historie und Eltern-Kind-Lineage in Metadaten führt, kann ein Reader nicht nur den neuesten, sondern auch frühere committete Zustände rekonstruieren.
Die Reihenfolge zählt:
Ein Writer erzeugt oder stellt neue Datendateien bereit.
Der Commit erzeugt einen neuen Snapshot.
Die Manifestliste benennt die Manifeste für diesen Snapshot.
Reader nutzen Manifestmetadaten und Dateistatistiken, um Arbeit einzusparen.
Eine historische Abfrage kann einen früheren Snapshot statt des aktuellen wählen.
Hidden Partitioning nimmt Abfragen die Pfadlogik
Iceberg hält Partitionstransformationen in Metadaten fest. Eine Transformation wie Datumsextraktion, Bucketing oder Kürzung kann das Pruning leiten, ohne dass Nutzerinnen Filter gegen physische Partitionsspalten oder Objektspeicherpfade schreiben müssen. Die Engine deutet die Partitionsinformationen der Tabelle während der Planung, was SQL auf fachliche Spalten konzentriert hält.
Das bedeutet nicht, dass Partitionierung zur automatischen Leistungsoptimierung wird. Die Engine braucht weiterhin brauchbare Statistiken, ein sinnvolles Dateilayout und eine Partitionsspezifikation, die zum Abfrage-Workload passt. Hidden Partitioning beseitigt eine Klasse nutzerseitiger Pfadfehler, doch es rettet keinen ungeeigneten Entwurf.
Evolution, ohne die Historie neu zu schreiben
Partitionsevolution betrifft nur Metadaten. Ein Team kann eine Partitionsspezifikation ändern, alte Daten in ihrem ursprünglichen physischen Layout belassen und neue Daten unter der neuen Spezifikation schreiben, wie in der Iceberg-Partitionsevolution dokumentiert. Die Tabelle verfolgt jede Partitionsversion getrennt.
Diese Flexibilität ist wertvoll, wenn sich Zugriffsmuster ändern. Sie erzeugt zugleich eine Planungspflicht, weil Query-Engines mehrere Partitionsspezifikationen in einer Tabelle deuten müssen. Der Nutzen ist, einen großen Rewrite-Job zu vermeiden, der Preis sind komplexere Metadaten und Planung.
Time Travel wird damit zu einem praktischen Diagnosewerkzeug. Fragen Sie einen älteren Snapshot ab, vergleichen Sie die Ergebnisse mit dem aktuellen Zustand, untersuchen Sie die Änderung und kehren Sie zum neuesten Snapshot zurück. Icebergs Modell committeter Snapshots bietet Snapshot-Isolation, sodass Reader einen konsistenten committeten Zustand sehen, während Writer neue Snapshots atomar erzeugen. Für Workflows mit historischen Daten ist dasselbe Muster auch über Iceberg hinaus nützlich, wie dieser Leitfaden zur Analyse historischer Daten zeigt.
Apache Iceberg vs. Delta Lake vs. Apache Hudi
Ein Tabellenformat nach Funktionsanzahl zu wählen ist eine schlechte Produktionsmethode. Der nützliche Vergleich betrifft Metadatenverhalten, Engine-Abdeckung und Semantik historischer Lesevorgänge, gefolgt von den Workload- und Governance-Beschränkungen, die Ihre Plattform tragen kann.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Metadatenmodell | Snapshot-basierte Metadaten mit Manifestlisten und Manifesten, die Tabellendateien beschreiben und die Planung tragen | Eine Kette aus | Eine Commit-Zeitachse, entworfen um Änderungen auf Satzebene und streaming-orientierte Tabellenoperationen |
Stärkstes Engine-Muster | Breite Nutzung über mehrere Engines wie Spark, Flink, Trino, Presto, Impala, Dremio und Snowflake | Am stärksten in Spark-zentrierten Umgebungen | Am stärksten bei Streaming-Upserts und inkrementeller Verarbeitung |
Modell für Time Travel | Lesevorgänge zielen auf committete Snapshots, wobei Tabellenoperationen die Aufbewahrung steuern | Lesevorgänge hängen von der aufbewahrten Transaktionslog-Historie und Checkpoints ab | Lesevorgänge hängen von der konfigurierten Commit-Zeitachse und dem Aufbewahrungsfenster ab |
Wichtigster Produktionskompromiss | Die Koordination über Kataloge und Engines hinweg erfordert bewusste Governance | Portabilität kann außerhalb des stärksten Ökosystems schwierig werden | Die Wahl zwischen Merge-on-Read und Copy-on-Write erhöht die betriebliche Komplexität |
Icebergs Metadatenmodell trennt den Tabellenzustand von den Datendateien. Engines können Manifestlisten und Statistiken auf Dateiebene nutzen, um Planungsarbeit zu senken, ohne dass jeder Reader eine Verzeichniskonvention deuten muss. Deltas Log-Kette ist wirksam, um Änderungen festzuhalten, doch eine breite historische Auswertung kann zu einer Frage der Log-Verwaltung werden. Hudis Zeitachse passt natürlich zu Streaming-Updates, besonders wo inkrementeller Konsum und Upsert-Verhalten den Workload prägen.
Die Engine-Abdeckung ändert, wie sich dieselbe Tabelle in der Praxis verhält. Spark und Flink können Iceberg-Tabellen schreiben und an Commit-Protokollen teilnehmen, wodurch neue Snapshots atomar entstehen. Trino und Presto werden üblicherweise als leseorientierte Planer eingesetzt, die Manifestmetadaten beziehen, Filter-Pushdown anwenden und Partitionstransformationen bei der Planung nutzen. Impala greift über seine Katalogabstraktion auf Iceberg zu und kann vom Metadaten-Pruning profitieren. Dremio und Snowflake ergänzen weitere Konsumwege, doch jede Kombination aus Connector und Katalog braucht weiterhin Kompatibilitätstests.
Der Katalog ist der Koordinationspunkt
REST-, Hive-, Glue-, Nessie- und Polaris-Kataloge lösen Tabellenbezeichner zum aktuellen Metadatenverweis auf. Dieser Verweis ist die Entscheidung der Steuerungsebene, die einer Engine sagt, welchen Tabellenzustand sie lesen oder aktualisieren soll. Speicherkompatibilität allein garantiert keine konsistente Governance.
Nebenläufige Writer brauchen Konfliktbehandlung. Ein Writer kann feststellen, dass sich der Katalogverweis geändert hat, nachdem er seinen Commit begonnen hat, was einen Retry oder eine Konfliktantwort erzwingt. Verschiedene Engines zeigen diese Fehlschläge unterschiedlich an, deshalb sollten Plattformteams Retries, Fehlerbehandlung und operative Verantwortung testen, statt anzunehmen, jeder Connector verhalte sich gleich.
Eine praktische Auswahl-Checkliste sieht so aus:
Wählen Sie Iceberg, wenn mehrere Engines, offene Kataloge und portable Tabellen-Governance wichtiger sind als enge Plattformintegration.
Wählen Sie Delta Lake, wenn Spark und die umgebende Plattform den dominierenden Schreib-, Governance- und Servierweg bilden.
Wählen Sie Hudi, wenn Streaming-Upserts, inkrementelle Lesevorgänge und Ingestion auf Satzebene die zentralen Anforderungen sind.
Testen Sie zuerst den Katalog, wenn dieselben Tabellen über Engines hinweg gesteuert werden müssen.
Prüfen Sie historische Lesevorgänge mit echten Aufbewahrungs- und Rollback-Verfahren, nicht nur mit einer gelungenen Demoabfrage.
Auch der Betrieb der Datenqualität muss zur gewählten Ausführungsumgebung passen. Für Teams mit Databricks ist Datenqualitätsmanagement in Databricks ein relevanter operativer Weg, den Sie neben dem Verhalten von Katalog und Engine bewerten sollten.
Ein praktisches Beispiel: eine Iceberg-Tabelle anlegen und abfragen
Ein kleiner PySpark-Ablauf macht das Metadatenmodell greifbar. Die konkrete Katalogimplementierung variiert, deshalb nutzt das Beispiel einen benannten Iceberg-Katalog und einen Warehouse-Ort, den Sie durch die Einstellungen Ihrer Umgebung ersetzen würden.
Die Tabellendefinition speichert die Partitionstransformation in den Metadaten. Nutzerinnen können auf event_time filtern; sie müssen keine erzeugte Partitionsspalte oder ein Objektspeicherverzeichnis referenzieren.
Der Append erzeugt einen neuen committeten Snapshot. Um die Historie zu prüfen, fragen Sie die Metadatentabellen der Tabelle ab, wählen die gewünschte Snapshot-Kennung und nutzen diese Kennung für einen historischen Lesevorgang.
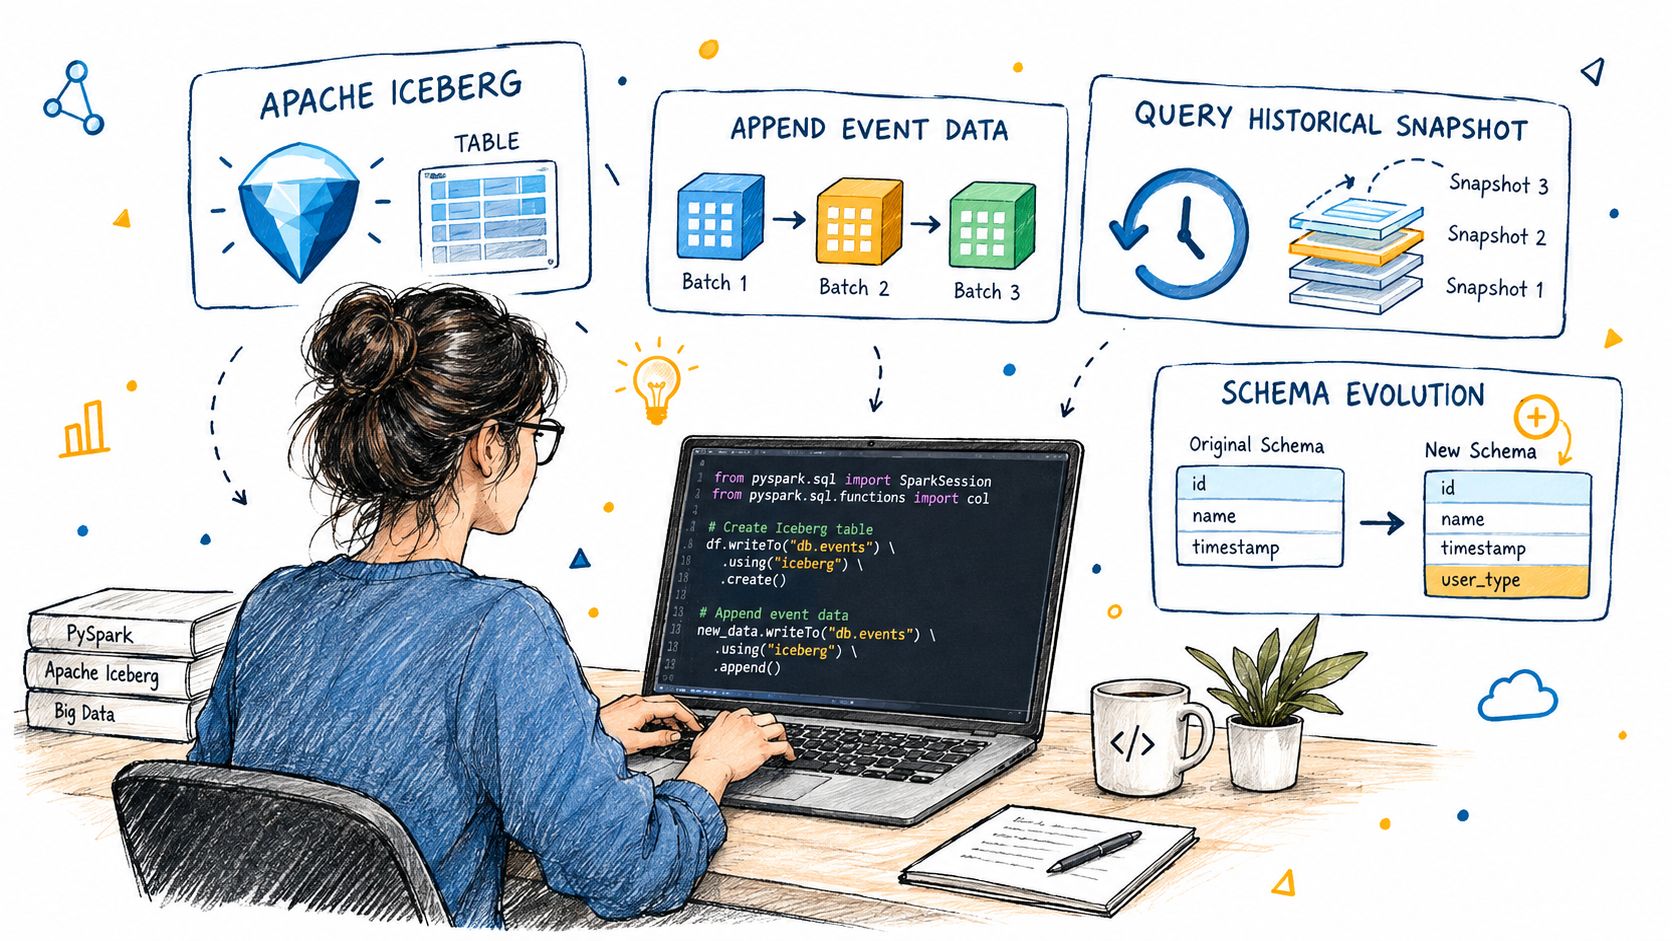
Schemaevolution betrifft bei unterstützten Änderungen nur Metadaten. Fügen Sie eine Spalte hinzu und hängen Sie dann Datensätze an, die sie befüllen:
Reader, die auf den älteren Snapshot zielen, nutzen weiterhin die ältere Schemaprojektion. Im Hintergrund verweist der Katalog auf aktualisierte Tabellenmetadaten, die Metadaten referenzieren einen neuen Snapshot, die Manifestliste benennt die relevanten Manifeste, und die Manifeste zeigen auf Datendateien. Dieses Dateisystemlayout sollte für das Team, das die Tabelle betreibt, sichtbar und erklärbar sein.
Bewährte Praktiken zu Partitionierung, Sortierung und Dateigrößen
Iceberg macht eine langsame Abfrage nicht automatisch schnell. Die Abfrageleistung hängt meist vom Zusammenspiel aus Dateigröße, Sortierreihenfolge, Partitionstransformationen und dem tatsächlichen Filtermix ab. Das Format gibt Ihnen Mechanismen, das Layout weiterzuentwickeln, doch Engineers müssen dieses Layout weiterhin testen und pflegen.
Beginnen Sie mit der Dateigröße. Ein verbreiteter Startbereich sind 128 bis 512 MB, doch das richtige Ziel hängt von Lesemustern, Dateiformateinstellungen, Kompression und Engine-Verhalten ab. Kleine Dateien erhöhen den Planungsaufwand und machen Scans ineffizient. Sehr große Dateien können die Parallelität senken oder selektive Lesevorgänge unwirtschaftlicher machen.
Sortierung ist der zweite Hebel. Sortieren Sie nach Ereigniszeit, wenn Scans über Zeitfenster dominieren. Nutzen Sie eine Filterspalte mit hoher Kardinalität, wenn sie sinnvolle Clusterbildung erzeugt, und erwägen Sie eine Organisation im Z-Order-Stil nur dort, wo Engine und Wartungswerkzeuge sie durchgängig unterstützen. Ein Sortierschlüssel, der im Entwurfsdokument attraktiv wirkt, kann für den tatsächlichen Abfragemix falsch sein.
Hidden Partitioning ist ein Feinschliffwerkzeug, kein Ersatz für die Workload-Analyse. Partitionsevolution erlaubt Ihnen, die Spezifikation anzupassen, ohne historische Dateien sofort neu zu schreiben, doch jede zusätzliche Spezifikation erhöht die Zahl der Layouts, die Planer deuten müssen.
Hebel | Ausgangspunkt | Wann anpassen | Häufiger Fehler |
|---|---|---|---|
Dateigröße | Beginnen Sie bei rund 128 bis 512 MB und prüfen Sie mit repräsentativen Scans | Passen Sie für selektive Lesevorgänge, Nebenläufigkeit und Engine-Parallelität an | Viele winzige Dateien anhäufen lassen |
Sortierreihenfolge | Beginnen Sie mit gängigen Zeitfiltern oder stabilen selektiven Spalten | Ändern Sie sie, wenn die Abfragehistorie andere vorherrschende Prädikate zeigt | Einen Schlüssel aus dem Bauch statt aus beobachteten Abfragen wählen |
Partitionstransformation | Nutzen Sie eine grobe, fachlich relevante Transformation | Entwickeln Sie sie weiter, wenn sich Zugriffsmuster deutlich ändern | Zu viele Partitionen erzeugen |
Wartung | Planen Sie Kompaktierung und Metadatenbereinigung ein | Erhöhen Sie die Frequenz, wenn Ingestion und Tabellenzahl wachsen | Bereinigung als Notfallaufgabe behandeln |
Vermeiden Sie Überpartitionierung, die Dateien unter 64 MB erzeugt. Bevorzugen Sie tägliche oder monatliche Granularität gegenüber stündlicher, wenn das resultierende Datenvolumen gering ist. Das sind Betriebsheuristiken, keine Garantien, prüfen Sie sie also an repräsentativen Workloads, bevor Sie sie zum Standard machen.
Kompaktierung ist im großen Maßstab nicht optional. Spark-Rewrite-Prozeduren, Flink-basierte Wartung oder externe Werkzeuge können Dateien zusammenführen und das Layout verbessern, doch sie müssen mit Snapshot-Aufbewahrung und der Bereinigung verwaister Dateien abgestimmt sein. Partitionsevolution senkt den Rewrite-Druck, beseitigt aber nicht die Notwendigkeit, das Metadatenwachstum zu überwachen.
Iceberg-Tabellen mit Blick auf Schema, Qualität und Timeliness betreiben
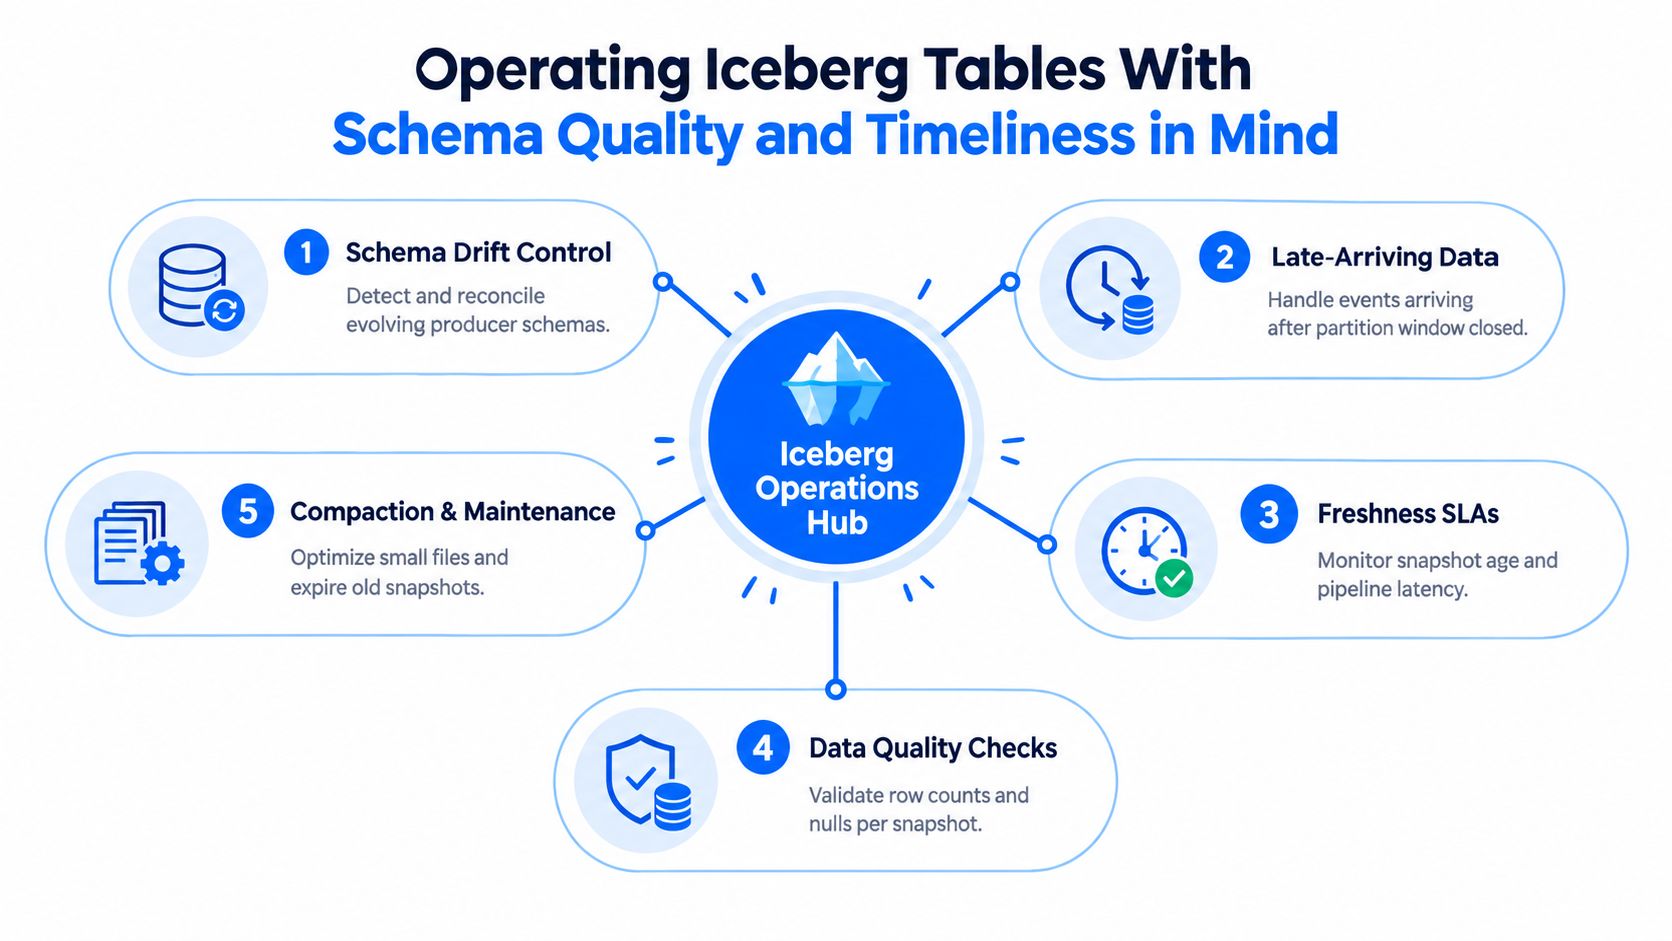
Sobald Teams viele Iceberg-Tabellen betreiben, beginnen die meisten Vorfälle als Erkennungsfehler. Ein Produzent ändert ein Feld, ohne Konsumenten zu informieren, verspätete Ereignisse landen nach dem erwarteten Partitionsfenster, eine Pipeline erzeugt Snapshots, ohne nützliche Daten zu liefern, oder Wartung hinterlässt eine Tabelle technisch lesbar, aber betrieblich teuer.
Behandeln Sie jedes Risiko als Signal, das Verantwortliche und eine Reaktion braucht:
Schemadrift: Erkennen Sie hinzugefügte, entfernte, umbenannte oder typgeänderte Felder, bevor nachgelagerte Jobs sie falsch deuten.
Verspätete Daten: Vergleichen Sie Ereigniszeit mit Ankunftszeit, damit eine geschlossene Zeitpartition keine Lieferprobleme verdeckt.
Frische: Verfolgen Sie das Alter des neuesten nützlichen Snapshots, nicht bloß, ob ein Writer lief.
Qualität: Binden Sie Validierungsergebnisse an einen konkreten Snapshot, damit ein Vorfall reproduzierbar wird.
Metadatengesundheit: Beobachten Sie Snapshot-Anzahl, Manifestwachstum, verwaiste Dateien und Verteilungen der Dateigrößen.
Den aktuellen Snapshot erklärbar machen
Eine vertrauenswürdige Betriebssicht verbindet den Tabellenzustand mit dem Verhalten der Pipeline. Eine Zeilenzahlprüfung ohne Snapshot-Identität kann einer Engineerin nicht sagen, welche Version gescheitert ist. Ein Frischealarm allein auf Basis der Uhrzeit kann eine Tabelle falsch einordnen, die einen leeren oder fehlerhaften Batch erhalten hat. Ein Schemaalarm ohne nachgelagerte Verantwortung erzeugt Lärm statt Handlung.
digna kann für diesen Zweck neben Katalog- und Compute-Schicht sitzen. Der Schema Tracker überwacht strukturelle Änderungen, Data Validation wendet Geschäftsprüfungen auf Satzebene an, Timeliness verfolgt erwartete Ankünfte und Verzögerungen, und Observability-Sichten helfen Teams, Trends und Plattformverhalten zu prüfen. Das Ausführungsmodell in der Datenbank hält die Kennzahlenberechnung in der Kundenumgebung, statt Produktionsdaten an einen externen Dienst zu übertragen.
Die Betriebsfrage um zwei Uhr nachts lautet nicht, ob Iceberg erfolgreich committet hat. Sie lautet, ob die Tabelle gerade vertrauenswürdig ist, welcher Snapshot betroffen ist und was sich seit dem letzten gesunden Zustand geändert hat. Diese Antwort verlangt Signale zu Qualität, Timeliness, Schema und Metadaten in einem gemeinsamen Vorfallskontext.
Von Hive, Delta oder Hudi migrieren, ohne den Lake niederzubrennen
Migrationspfade unterscheiden sich stark nach Quellformat. Externe Hive-Tabellen sind oft am zugänglichsten, weil die bestehenden Dateien womöglich bereits nutzbar sind, doch abweichende Bezeichner, SerDe-Annahmen und die Katalogregistrierung können nachgelagerte Reader dennoch brechen. Eine Metadatenkonvertierung oder ein CTAS-Weg mag für eine Tabelle funktionieren und für eine andere scheitern, wenn Annahmen zum physischen Layout abweichen.
Delta erfordert eine genauere Prüfung. Konvertierungs- oder Rewrite-Werkzeuge müssen Deletion Vectors, Einstellungen zum Change Data Feed und Identitätsspalten berücksichtigen, die sich nicht sauber auf das Zielmodell abbilden. Eine erfolgreiche Tabellenregistrierung belegt nicht, dass historisches Verhalten, Deletes oder inkrementelle Konsumenten sich gleich verhalten werden.
Hudi ist meist die schwierigste Migration, wenn die Quelle auf Merge-on-Read-Verhalten, Copy-on-Write-Verhalten oder Zeitachsensemantik beruht. Iceberg-Snapshots liefern keinen direkten Eins-zu-eins-Ersatz für jede Hudi-Zeitachsenoperation, deshalb brauchen Teams womöglich einen vollständigen Rewrite und eine sorgfältig definierte Umstellungsgrenze.
Eine sicherere Umstellungsreihenfolge
Die Katalogwahl kommt zuerst. Entscheiden Sie, ob die Ziellandschaft REST, Glue, Nessie oder den Hive Metastore nutzt, und testen Sie dann Berechtigungen, Bezeichner, den Umgang mit Zugangsdaten und das Rollback-Verhalten. BI-Werkzeuge cachen oft vollqualifizierte Namen, deshalb kann das Ändern von Katalog- oder Namespace-Pfaden Berichte brechen, selbst wenn die Daten selbst korrekt sind.
Die Partitionsmigration verdient einen eigenen Test. Hidden Partitioning ändert, wie Nutzerinnen Filter ausdrücken und wie Engines Transformationen deuten, während alte und neue Layouts während eines Übergangs koexistieren können. Doppeltes Schreiben kann Rollback-Optionen bewahren, erzeugt aber auch Abgleicharbeit, die überwacht werden muss.
Nutzen Sie diese Reihenfolge:
Inventarisieren: Erfassen Sie Schemata, Partitionen, Konsumenten, Schreibvorgänge, Aufbewahrungsregeln und Anforderungen an historische Lesevorgänge.
Pilotieren: Konvertieren Sie unkritische Tabellen und testen Sie jede wichtige Engine.
Doppelt lesen: Vergleichen Sie Ergebnisse, Anzahlen, Schemata, Frische und Zugriffsverhalten.
Umstellen: Ziehen Sie Konsumenten bewusst um, bewahren Sie einen Rollback-Weg und halten Sie die alte Route verfügbar, bis die Validierung abgeschlossen ist.
Für die übergreifende Planung nutzen Sie bewährte Praktiken für die Migration vom Data Warehouse zum Data Lake als Checkliste und passen sie dann an die Katalog- und Engine-Beschränkungen Ihrer Landschaft an.
digna liefert Datenqualität und Observability innerhalb Ihrer Umgebung für Iceberg-nahe Abläufe, darunter Schema-Tracking, Satzvalidierung, Timeliness-Überwachung, Anomalieerkennung und Plattformkennzahlen. Besuchen Sie digna, um zu bewerten, wie diese Signale Ihrem Team helfen können, große Tabellenlandschaften mit klareren Nachweisen und schnellerer Vorfallsreaktion zu betreiben.
Die Snapshot-Historie sagt Ihnen, was sich geändert hat, aber nicht, ob die Änderung falsch war — dafür verbinden Sie Iceberg-Metadaten mit Data Platform Observability.
Häufig gestellte Fragen
Woher kommt Apache Iceberg?
Es begann 2017 bei Netflix, um Grenzen bei Skalierbarkeit und Konsistenz in Apache-Hive-Tabellen anzugehen. Netflix spendete es im November 2018 an die Apache Software Foundation, und im Mai 2020 wurde es ein Top-Level-Apache-Projekt.
Warum ist Iceberg eine Betriebsdisziplin und kein Dateiformat?
Weil ein Team es schnell einführen kann und dennoch keine Antworten auf die Fragen hat, die in der Produktion zählen. Die physische Datenschicht ist vergleichsweise unkompliziert; Leistung und Korrektheit entscheiden sich auf der Betriebsschicht darüber.
Was verlangt der Betrieb von Iceberg tatsächlich?
Vier Dinge: Katalog-Governance, die festlegt, wer Tabellen anlegen, ändern, löschen oder promoten darf und wie Bezeichner aufgelöst werden; Metadatenhygiene, die Snapshot-Aufbewahrung, Entfernen verwaister Dateien und Manifestwachstum steuert; Engine-Koordination, die prüft, wie Spark, Flink und Trino mit denselben Spezifikationen umgehen; und Nachweise, die Qualität, Frische und Lineage mit einem Tabellenzustand verbinden.
Was ist Icebergs zentrale Entwurfsidee?
Den Tabellenzustand vom physischen Dateilayout zu trennen. Aus dieser Trennung entsteht sein Wert, und sie ist auch der Grund, warum die operativen Fragen eine Ebene höher wandern, statt zu verschwinden.
Wie sollte eine Iceberg-Tabelle behandelt werden?
Als verwaltetes Produkt mit Verantwortlichen, einer Betriebsrichtlinie und einem beobachtbaren Lebenszyklus. Eine Tabelle ohne diese drei hat eine Spezifikation, aber niemanden, der für ihr Verhalten über die Zeit einsteht.



