Anomalieerkennung mit Machine Learning: Ein Praxisleitfaden
|
10
min. Lesezeit

Um 9:00 Uhr sieht Ihr Umsatz-Dashboard unauffällig aus. Um 11:30 Uhr stellt die Finanzabteilung die Wochenprognose infrage, die Vertriebsleitung zweifelt die Pipeline-Zahlen an, und niemand kann auf einen Systemausfall verweisen. Das Problem ist kein fehlgeschlagener Warehouse-Job. Es ist eine stille Verschiebung weiter vorne in der Kette. Eine Quelltabelle hat begonnen, Datensätze zu duplizieren, ein Zeitstempel kam verspätet an, oder die Werteverteilung einer Spalte ist gerade so weit gedriftet, dass sie die nachgelagerte Logik verfälscht, ohne einen fest codierten Alarm auszulösen.
Genau für diese Art von Fehler ist Anomalieerkennung mit Machine Learning gemacht. Nicht für laute Vorfälle, sondern für stille. Für jene, die die grundlegende Validierung passieren, in vertrauenswürdigen Tabellen landen und nach und nach das Vertrauen in jeden Bericht und jedes Modell untergraben, das von ihnen abhängt.
Viele Teams haben nicht deshalb Schwierigkeiten, weil ihnen Alarme fehlen. Sie haben Schwierigkeiten, weil herkömmliches schwellenwertbasiertes Monitoring nicht mit hochdimensionalen Daten, wechselnder Saisonalität, sich weiterentwickelnden Pipelines und den Anforderungen von Unternehmen an Datenschutz und Deployment Schritt halten kann. Moderne Anomalieerkennung funktioniert, wenn sie normales Verhalten kontinuierlich erlernt, nah an den Daten läuft und sich in Observability-Workflows einfügt, die operative Teams pflegen können.
Inhaltsverzeichnis
Wenn stille Datenfehler laute Probleme verursachen
Ein typisches Fehlermuster beginnt damit, dass ein Fachanwender Daten vertraut, die technisch vorhanden, aber in ihrem Verhalten falsch sind. Umsatzprognosen springen. Die Kundenabwanderung scheint sich über Nacht zu verbessern. Ein ML-Feature-Store übernimmt verzerrte Werte und verändert die Modellergebnisse. Niemand sieht einen Absturz, denn nichts ist abgestürzt.
Regelbasierte Prüfungen erkennen in der Regel offensichtliche Fehler: Null-Spitzen, fehlende Dateien, Zeilenzahlen, die auf null fallen. Schwierig wird es, wenn das Problem subtiler ist – etwa wenn eine Quelle doppelte Datensätze sendet, sich eine Verteilung innerhalb eines akzeptierten Bereichs verschiebt oder korrelierte Felder gemeinsam auf eine Weise driften, die keine statische Regel vorhergesehen hat.
Diese Lücke ist im echten Betrieb relevant. Auf Machine Learning basierende Methoden zur Anomalieerkennung übertreffen klassische statistische Ansätze in der Genauigkeit um 8 bis 12 %, wobei einige Implementierungen eine bis zu 15 % höhere Präzision bei der Erkennung komplexer, multivariater Anomalien erreichen – insbesondere in hochdimensionalen Umgebungen wie der Überwachung von Finanztransaktionen und der Vorhersage von Ausfällen industrieller Anlagen, so diese Zusammenfassung der Forschung zur Anomalieerkennung.
Warum herkömmliches Monitoring versagt
Klassisches Monitoring setzt voraus, dass Teams Fehler im Voraus definieren können. In der Praxis können sie das nicht.
Geschäftslogik ändert sich: Neue Kampagnen, Preisänderungen, Neuaufteilungen von Vertriebsgebieten und Produkteinführungen verändern das Datenverhalten schneller, als Alarmregeln angepasst werden.
Pipelines werden vielschichtig: Ein einzelner KPI kann von Ingestion-Jobs, dbt-Modellen, Reverse-ETL-Synchronisierungen und APIs von Drittanbietern abhängen.
Anomalien verstecken sich in Beziehungen: Jede Spalte kann für sich genommen normal aussehen, während das kombinierte Muster eindeutig falsch ist.
Praxisregel: Wenn Ihr Team von Datenproblemen durch einen Dashboard-Nutzer statt durch das Monitoring erfährt, ist Ihre Erkennungslogik zu fragil.
Teams, die diese Workflows modernisieren wollen, beginnen oft damit, zuerst die Ingestion- und Transformationsschicht zu verbessern. Deshalb bieten Ressourcen wie die Datenverarbeitungslösungen von Osher Digital hilfreichen Kontext. Zuverlässige Verarbeitung reduziert vermeidbare Fehler, ersetzt aber keine Anomalieerkennung. Sie benötigen weiterhin ein System, das unbekannte Unbekannte erkennt, sobald die Daten fließen.
Was Machine Learning verändert
Anomalieerkennung mit Machine Learning verlagert die Aufgabe vom Schreiben von Regeln hin zum Erlernen von Baselines. Statt von einem Engineer zu verlangen, jeden fehlerhaften Zustand im Voraus zu definieren, modelliert das System das erwartete Verhalten und markiert relevante Abweichungen.
Dieser Wandel ist operativ, nicht akademisch. Er schützt Prognosen, Finanzreporting, Compliance-Workflows, Betrugsüberwachung und Modelleingaben vor genau der Art von stiller Drift, die in Datenteams von Unternehmen die kostspieligsten Diskussionen auslöst.
Die Anatomie einer Anomalie verstehen
Eine Anomalie sind Daten, die vom erwarteten Verhalten abweichen. Hilfreich ist dabei nicht die Definition, sondern zu wissen, welche Art von Abweichung vorliegt. Denn Erkennungsmethoden scheitern, wenn Teams jede Anomalie als dasselbe Problem behandeln.
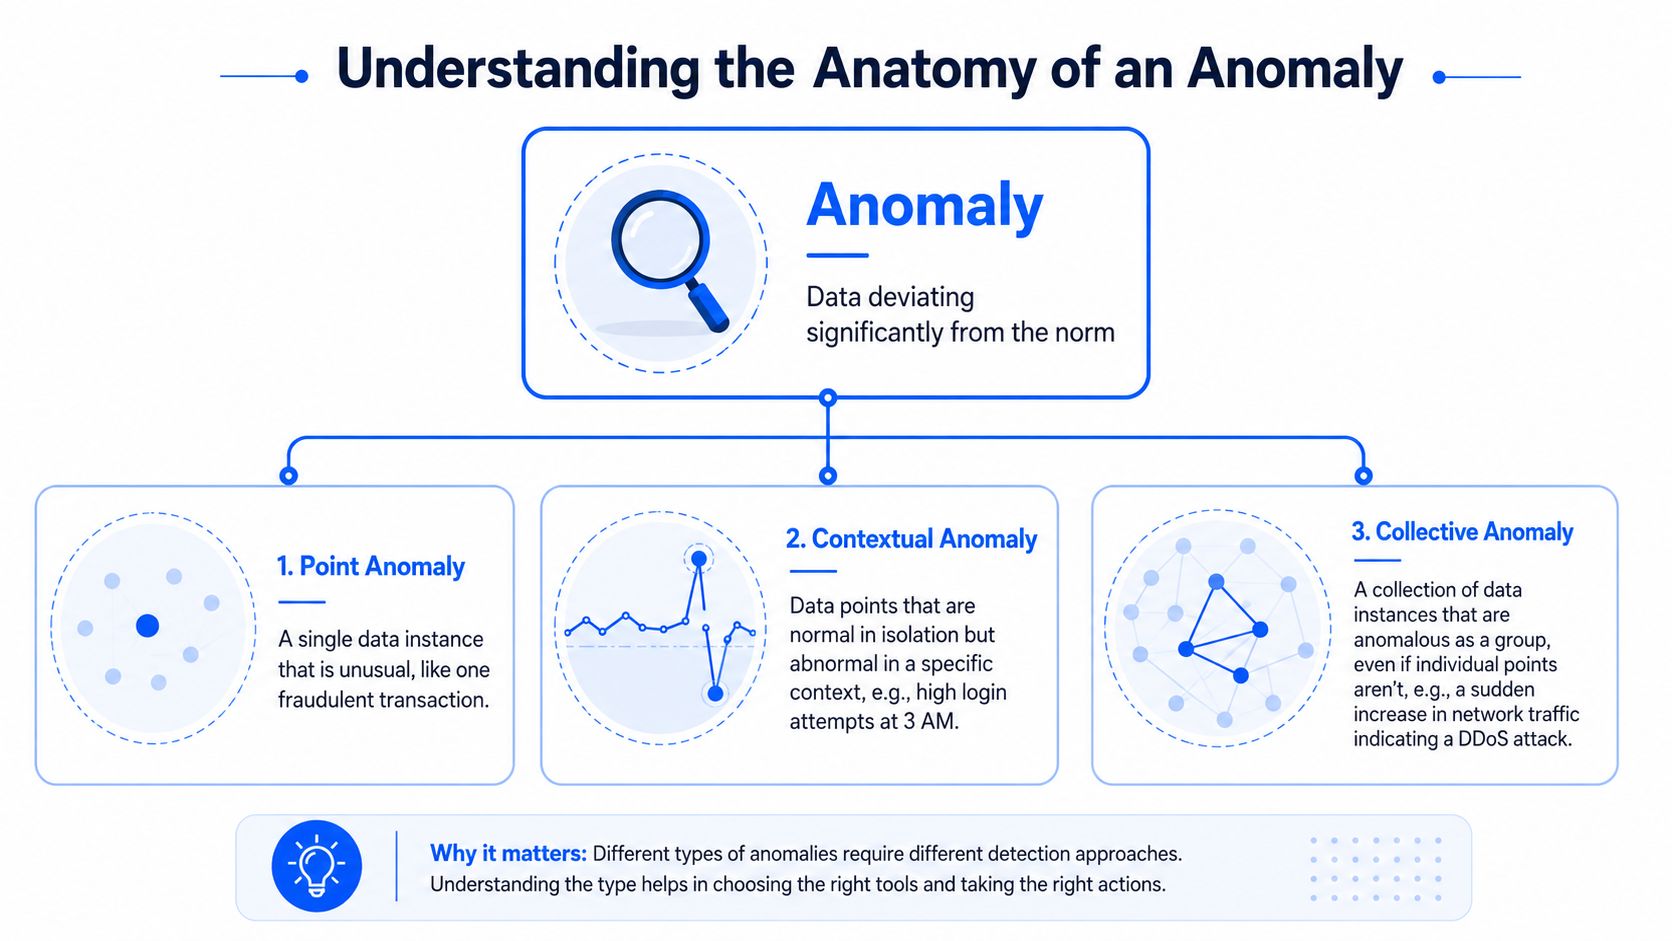
Punktanomalien
Eine Punktanomalie ist am einfachsten vorstellbar. Ein Event, ein Wert, eine Zeile wirkt falsch. Denken Sie an eine einzelne Kartentransaktion, die weit außerhalb des üblichen Musters eines Kunden liegt, oder an einen Warehouse-Load mit einer unmöglichen Anzahl von Datensätzen.
Für diese Fälle wird meist zuerst eine Lösung entworfen, weil sie sich sauber auf Alarme abbilden lassen. Ein Wert ist zu hoch, zu niedrig, zu früh, zu spät oder zu weit von der Norm entfernt.
Kontextuelle Anomalien
Eine kontextuelle Anomalie wirkt unauffällig, bis Sie Zeitpunkt, Saisonalität oder Rahmenbedingungen berücksichtigen. Ein hohes Login-Volumen um 12 Uhr mittags kann normal sein. Dasselbe Volumen um 3 Uhr nachts auf einem sensiblen internen System kann ein ernstes Signal sein.
Datenplattformen erleben das häufig. Eine verspätet eintreffende Datei kann nach einem Feiertagsplan normal, an einem Handelstag aber alarmierend sein. Eine Traffic-Spitze kann während eines Kampagnenstarts erwartet, an einem ruhigen Wochenende jedoch verdächtig sein.
Kollektive Anomalien
Bei einer kollektiven Anomalie stößt das Monitoring in Unternehmen oft an seine Grenzen. Einzelne Datensätze wirken harmlos, doch die Gruppe bildet ein Muster, das nicht existieren sollte. Ein koordinierter Bot-Angriff, eine subtile Schema-Drift über mehrere Felder hinweg oder eine Abfolge von Events, die sich gemeinsam verändern, können alle in diese Kategorie fallen.
Einfache Schwellenwerte erfassen keinen Kontext. Teams benötigen Methoden, die Beziehungen über Spalten, Zeitfenster und Entitäten hinweg erkennen.
Eine fehlerhafte Zeile ist leicht zu finden. Was dem Vertrauen in die Produktion schadet, ist ein fehlerhaftes Muster, das über einen gesund wirkenden Datensatz verteilt ist.
Warum statische Schwellenwerte hier versagen
Statische Schwellenwerte sind attraktiv, weil sie leicht zu erklären sind. Sie sind aber auch teuer in der Pflege. Jede neue Quelle, jedes Saisonmuster und jede geschäftliche Ausnahme fügt weitere Regeln hinzu. Irgendwann wird das System so laut, dass die Leute es ignorieren.
Moderne Plattformen ersetzen dies durch adaptives Baseline-Learning. Wie in der Übersicht von digna zu KI-Techniken für die Anomalieerkennung beschrieben, profilieren Systeme zur Anomalieerkennung mit Machine Learning kontinuierlich Datensatzvolumen, fehlende Werte und Werteverteilungen, um die erwarteten Grenzen dynamisch festzulegen. Das hilft, stille Fehler wie fehlende oder doppelte Datensätze in Echtzeit zu erkennen.
Dieses Betriebsmodell verändert die tägliche Arbeit von Datenteams:
Weniger Regelpflege: Engineers müssen nicht für jede Tabelle und jede Metrik Schwellenwerte von Hand abstimmen.
Bessere Abdeckung: Das System kann Verhaltensänderungen beobachten, die nicht offensichtlich genug sind, um sie manuell zu codieren.
Transparentere Untersuchung: Teams können das aktuelle Verhalten mit erlernten Baselines vergleichen, statt darüber zu diskutieren, ob ein Schwellenwert richtig gesetzt war.
Was das für die Observability-Praxis bedeutet
In der Observability steht Anomalieerkennung nicht isoliert vom Rest des Stacks. Sie steht neben Timeliness-Monitoring, Schema-Tracking und Validierung. Das eine erkennt ein unerwartetes Metrikmuster. Das andere bestätigt eine Verzögerung. Ein drittes zeigt eine neue Spalte oder eine Änderung des Datentyps. Zusammen erklären sie, warum das Vertrauen verloren ging.
Das ist der praktische Nutzen. Sie erkennen nicht nur Ausreißer. Sie schützen Geschäftsentscheidungen vor Daten, die an der Oberfläche weiterhin verfügbar, aktuell und abfragbar wirken.
Die vier zentralen Machine-Learning-Ansätze
Der richtige Ansatz hängt weniger von der Popularität eines Algorithmus ab als davon, was Ihr Datenteam zur Verfügung hat. Labels, stabile historische Baselines, Sequenzstruktur, Rechenbudget, Latenzanforderungen und Prüfkapazität sind allesamt wichtiger als Neuheit.
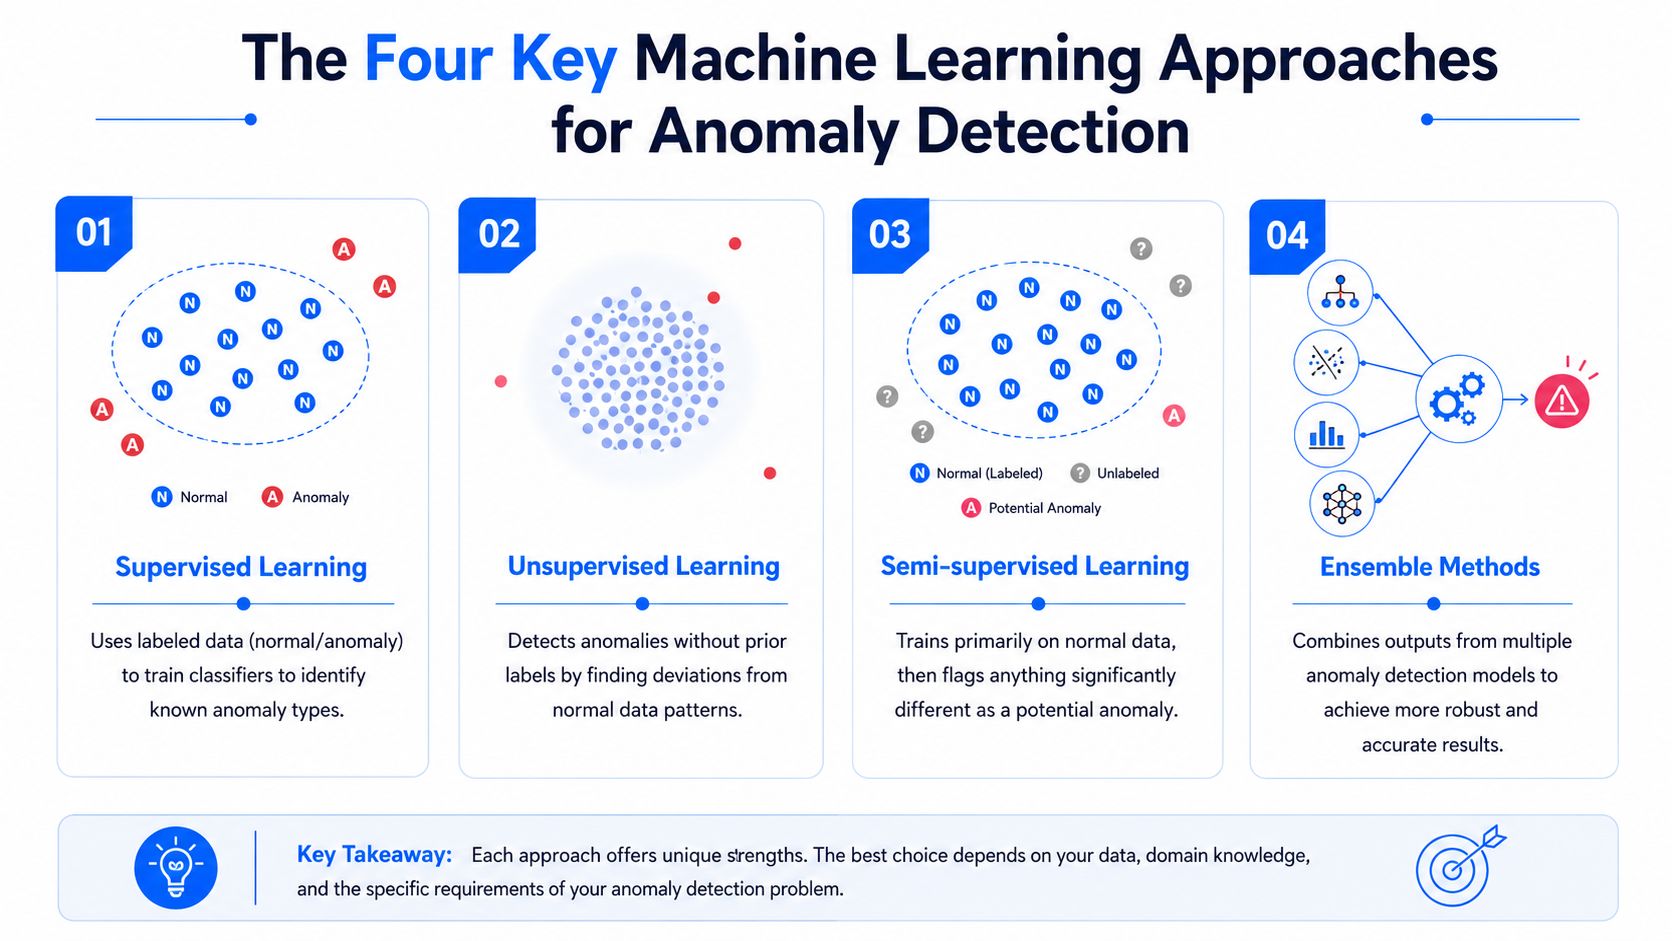
Überwachtes Lernen
Überwachte Erkennung funktioniert, wenn Sie bereits wissen, wie ein Fehler aussieht, und Labels haben, die das belegen. Betrugssysteme, Pipelines zur Schadenprüfung und einige Security-Workflows können dies rechtfertigen, weil sie im Lauf der Zeit geprüfte Vorfälle ansammeln.
Der Vorteil ist Präzision bei bekannten Fehlermodi. Wenn Ihre gelabelten Anomalien repräsentativ sind, kann ein Klassifikator diese Muster direkt erlernen.
Der Nachteil ist operativer Natur. Labels sind knapp, teuer und oft veraltet. Auch Datenprobleme in Unternehmen verändern ihre Gestalt. Die Anomalieklasse des letzten Quartals deckt den Integrationsfehler dieses Quartals möglicherweise nicht ab.
Setzen Sie überwachte Ansätze ein, wenn:
Geprüfte Anomalien vorliegen: Ihr Team verfügt über hochwertige Labels von Analysten, Betrugsermittlern oder Security Operations.
Fehlertypen sich wiederholen: Sie haben es mit wiederkehrenden, gut verstandenen Anomalieklassen zu tun.
Handlungswege definiert sind: Das Unternehmen weiß bereits, was zu tun ist, wenn das System ein Problem markiert.
Unüberwachtes Lernen
Unüberwachte Methoden sind auf vielen Datenplattformen der Standard, weil Labels oft nicht verfügbar sind. Das System sucht nach Abweichungen in den Daten selbst statt nach Beispielen bekannter fehlerhafter Ereignisse.
Für Observability im Unternehmen ist das oft der praktikabelste Weg. Sie können es über viele Tabellen und Metriken hinweg einsetzen, ohne zunächst einen Labeling-Prozess aufbauen zu müssen. Methoden wie Clustering, isolationsbasierte Modelle und distanzbasiertes Scoring gehören in diese Kategorie.
Ein überzeugendes Praxisdesign stammt aus der Dokumentation zur Anomalieerkennung von Netdata. Sie beschreibt unüberwachtes k-Means-Clustering mit k=2 auf gleitenden Zeitfenstern mit mehreren Modellen pro Metrik und berichtet von einer Reduzierung der Fehlalarme um 99 %, weil eine Anomalie erst markiert wird, wenn alle Modelle übereinstimmen. Das erinnert daran, dass Architekturentscheidungen ebenso wichtig sein können wie der zugrunde liegende Algorithmus.
Die erste Frage im Produktivbetrieb lautet nicht: „Welches Modell ist am klügsten?“ Sie lautet: „Welcher Ansatz übersteht ungelabelte Daten, verrauschte Eingaben und die Realität der Rufbereitschaft?“
Teilüberwachtes Lernen
Teilüberwachte Erkennung geht von einer praktischen Annahme aus: Sie kennen möglicherweise nicht jede Anomalie, aber in der Regel eine Menge vertrauenswürdiger normaler Daten. Das Modell erlernt diese Baseline und behandelt relevante Abweichungen als verdächtig.
Das ist besonders nützlich in Unternehmens-Pipelines, in denen gesunde Phasen leichter zu identifizieren sind als fehlerhafte. Sie können auf akzeptierten historischen Zeitfenstern trainieren und neue Daten anschließend anhand dieser erlernten Repräsentation bewerten.
Teilüberwachte Methoden funktionieren in der Regel gut, wenn:
Situation | Warum teilüberwachtes Lernen hilft |
|---|---|
Stabile Systeme mit gelegentlicher Drift | Das Modell erlernt einen klaren normalen Betriebsbereich |
Sensible Workflows | Teams bevorzugen eine konservative Erkennung, die auf vertrauenswürdigen Daten beruht |
Geringe Häufigkeit von Anomalien | Es gibt nicht genügend positive Beispiele für überwachtes Lernen |
Deep Learning
Deep Learning wird relevant, wenn die Struktur so komplex ist, dass einfachere Modelle sie übersehen. Zeitreihensignale, multivariate Telemetrie und hochdimensionales Verhalten fallen häufig in diese Kategorie.
Für Zeitreihen aus Industrie und Pipelines hält dieser Überblick über Methoden der Anomalieerkennung fest, dass LSTM-Prognosemodelle in Kombination mit Variational Mode Decomposition periodische Komponenten extrahieren können, bevor sie Anomalien in den Residuen der Zeitreihe erkennen. Vereinfacht gesagt: Das Modell trennt zunächst normales, sich wiederholendes Verhalten vom Rest und prüft dann, ob dieser Rest verdächtig aussieht.
Deep Learning ist nützlich, wenn:
Sequenzen wichtiger sind als isolierte Datensätze
Periodizität und Drift gleichzeitig auftreten
sich das Signal über viele korrelierte Variablen erstreckt
Es bringt aber auch höheren Rechenaufwand, mehr Tuning und einen größeren Monitoring-Aufwand mit sich. Wenn eine einfachere Methode das Problem mit akzeptabler Signalqualität erkennt, ist sie im Produktivbetrieb in der Regel die bessere Wahl.
Ensembles in der Praxis
Viele Unternehmenssysteme setzen letztlich Ensemble-Methoden ein, auch wenn Teams sie nicht so bezeichnen. Sie kombinieren mehrere Detektoren oder Scoring-Stufen, um Rauschen zu reduzieren und die Zuverlässigkeit zu erhöhen.
Ein praxistaugliches Ensemble könnte einen statistischen Basis-Check, einen erlernten Anomalie-Score und eine Validierungsregel umfassen. Ein anderes könnte einen Autoencoder mit isolationsbasierten Schwellenwerten kombinieren. Im Produktivbetrieb setzen sich Ensembles oft durch, weil sie der unbequemen Wahrheit Rechnung tragen, dass ein einzelner Detektor selten jede Tabelle, jeden Rhythmus und jeden Fehlermodus gut abdeckt.
Den richtigen Algorithmus für die Aufgabe wählen
Es gibt keinen allgemein besten Algorithmus zur Anomalieerkennung. Es gibt nur einen Algorithmus, der zu Ihrer Datenstruktur, der Form der Anomalien, den Latenzanforderungen und dem Prüfprozess passt. Teams geraten in Schwierigkeiten, wenn sie sich auf eine Methode festlegen, nur weil sie einmal funktioniert hat.
Die wichtigste Unterscheidung ist, ob Sie globale Anomalien oder lokale Anomalien erkennen müssen. Das klingt akademisch, bis Sie im großen Maßstab ausrollen. Dann entscheidet es darüber, ob Sie tatsächliche Drift erkennen oder sie monatelang übersehen.
Lokal oder global – das macht den Unterschied
Manche Anomalien liegen weit außerhalb des gesamten Datensatzes. Das sind globale Ausreißer. Andere sind nur innerhalb einer lokalen Nachbarschaft oder eines Clusters auffällig. Das sind lokale Ausreißer.
Diese Unterscheidung verändert die Modellwahl. Laut Forschung aus dem Journal of Machine Learning Research muss die Wahl des Algorithmus davon abhängen, ob die Anomalien lokal oder global sind. Enthalten die Daten mehrere Dichte-Cluster, übertrifft k-Nearest-Neighbors den Isolation Forest, während Isolation Forest besser für rein globale Anomalien geeignet ist.
Das ist für Unternehmensdaten unmittelbar relevant. Kundenverhalten gruppiert sich oft nach Region, Produkt oder Kanal. Anlagenmetriken gruppieren sich nach Betriebsmodus. Nutzeraktivität gruppiert sich nach Rolle. Ein Punkt kann global normal wirken und innerhalb seines eigenen Segments dennoch stark auffällig sein.
Spickzettel: Algorithmen zur Anomalieerkennung
Algorithmus | Typ | Am besten geeignet für | Wichtiger Hinweis |
|---|---|---|---|
Isolation Forest | Erkennung globaler Ausreißer | Klare, isolierte Anomalien in tabellarischen Daten | Kann lokale Anomalien in dichten Clustern übersehen |
k-Nearest Neighbors | Basierend auf lokaler Dichte und Distanz | Geclusterte Datensätze, bei denen das Verhalten der Nachbarschaft wichtig ist | Empfindlich gegenüber Skalierung und Distanzdefinition |
Local Outlier Factor | Basierend auf lokaler Dichte | Erkennung von Datensätzen mit deutlich geringerer lokaler Dichte als benachbarte Punkte | Schwieriger für nicht-technische Prüfer zu erklären |
Z-Score | Univariate statistische Baseline | Schnelle Prüfungen einzelner Metriken mit relativ stabilen Verteilungen | Schwach bei multivariaten Zusammenhängen |
ECOD | Baseline für tabellarische Ausreißer | Leichtgewichtige Baseline für Datenqualitäts-Workflows | Am besten als Benchmark, nicht als universelle Lösung |
LSTM | Sequenzmodell | Zeitreihen mit zeitlichen Abhängigkeiten und wiederkehrenden Mustern | Höhere Betriebskosten und höherer Tuning-Aufwand |
Autoencoder | Rekonstruktionsbasiert | Erlernen normaler Muster in hochdimensionalen Daten | Schwellenwerte und Umgang mit Drift erfordern Sorgfalt |
Was in typischen Unternehmensszenarien funktioniert
Für das Qualitätsmonitoring tabellarischer Daten haben einfache Baselines weiterhin ihren Platz. Isolation Forest und ECOD sind praxistaugliche Ausgangspunkte für Spalten, Metriken auf Zeilenebene und Integritätsprüfungen von Datensätzen.
Bei geclusterten Kunden- oder Produktdaten sollten Nachbarschaftsmethoden in der Regel frühzeitig getestet werden. Wenn Ihr Datensatz mehrere Betriebszustände aufweist, können Ansätze auf Basis lokaler Dichte Anomalien aufdecken, die globale Methoden glätten.
Bei Zeitreihen richtet sich die Wahl danach, wie viel Gedächtnis das Muster erfordert. Prüfungen auf kurzfristige Abweichungen funktionieren mit einfacheren statistischen Methoden. Längere Abhängigkeiten, Periodizität und Residualverhalten können rekurrente oder rekonstruktionsbasierte Modelle rechtfertigen. Wenn Ihr Team sequenzspezifische Designs bewertet, ist dieser Leitfaden zum Erkennen von Anomalien in Zeitreihen eine nützliche Referenz für den Betrieb.
Wählen Sie einen Algorithmus nicht, weil er populär ist. Wählen Sie ihn, weil sein Fehlermodus für Ihre Daten akzeptabel ist.
Die Zielkonflikte, die Teams unterschätzen
Der Algorithmus ist nicht das gesamte System. Der Erfolg im Produktivbetrieb hängt von mehreren weniger glamourösen Details ab:
Skalierung und Vorverarbeitung: Distanzbasierte Modelle versagen, wenn Features nicht normalisiert sind.
Interpretierbarkeit: Security-Teams und Data Stewards benötigen oft eine Begründung, nicht nur einen Score.
Retraining-Rhythmus: Auch ein starker Detektor verliert an Qualität, wenn sich das Baseline-Verhalten ändert und niemand ihn aktualisiert.
Prüf-Workflow: Ein etwas schwächeres Modell mit sauberer Triage schlägt oft ein stärkeres Modell, das Slack überflutet.
Deshalb sollte die Auswahl des Algorithmus parallel zum operativen Design erfolgen und nicht davor.
Erfolg messen und Fehlalarme vermeiden
Montagmorgen: Der Detektor schlägt bei 600 Datensätzen an. Zwölf erfordern Handlungsbedarf. Der Rest sind normale verspätete Lieferungen, geplante Katalogänderungen und einmalige Geschäftsereignisse. Wenn das Team diesen Stapel jeden Tag durchsehen muss, versagt das Modell – selbst wenn sein Offline-Score gut aussah.

Warum Accuracy in die Irre führt
Accuracy verschleiert die Kostenstruktur der Anomalieerkennung. Bei unausgewogenen Datensätzen kann ein Modell fast alles als normal klassifizieren und auf dem Papier trotzdem gut aussehen. Das hilft weder dem Betrugsanalysten noch dem Data Steward oder dem Plattform-Engineer, der ein System benötigt, das seltene Fehler erkennt, ohne ständig Rauschen zu erzeugen.
Bei dieser Art von Klassenungleichgewicht sind Precision, Recall und F1 die üblichen Ausgangsmetriken. Googles Machine-Learning-Leitfaden zu Klassifikationsmetriken für unausgewogene Datensätze ist eine praktische Referenz, wenn Ihr Team eine gemeinsame Grundlage für die Bewertung benötigt.
Die Metriken, die im Produktivbetrieb zählen
Jede Metrik beantwortet eine andere betriebliche Frage.
Precision: Wie viele der Alarme, die an eine Person oder ein nachgelagertes System gesendet wurden, waren es wert, darauf zu reagieren?
Recall: Wie viele aller Anomalien hat der Detektor erkannt?
F1-Score: Wie ausgewogen sind Precision und Recall, wenn Sie für den Modellvergleich eine einzige Zahl benötigen?
Diese Zahlen sollten sich auf geschäftliche Kosten abbilden lassen. Im Zahlungsverkehr bedeutet ein schwacher Recall übersehenen Betrug. Im Datenbetrieb bedeutet eine schwache Precision, dass sich Alarm-Warteschlangen füllen, Bereitschaftsteams dem Detektor nicht mehr vertrauen und echte Vorfälle länger auf eine Prüfung warten.
Die Festlegung von Schwellenwerten ist ebenso wichtig wie die Modellwahl. Teams verbringen oft Wochen damit, Algorithmen zu vergleichen, und wenden dann einen Standard-Grenzwert an, der nie auf ihre Prüfkapazität oder die Schwere von Vorfällen abgestimmt wurde.
Den Alarmprozess bewerten, nicht nur das Modell
Offline-Testdatensätze sind nützlich, übersehen aber eine häufige Realität in Unternehmen: Viele Anomalien sind nur im Kontext anomal.
Eine Schemaänderung kann ein gültiges Release sein. Eine Spitze bei den Bestellungen kann von einer geplanten Aktion stammen. Ein verspäteter Batch kann einem Lieferanten-SLA entsprechen, das sich im letzten Quartal geändert hat. Der Detektor kann das Muster korrekt markieren und dennoch einen schlechten Alarm erzeugen, wenn dem System der geschäftliche Kontext fehlt.
Ein besserer Bewertungsprozess umfasst:
Geprüfte Alarm-Stichproben durch die Personen, die für die nachgelagerte Entscheidung verantwortlich sind.
Bewertung auf Segmentebene, damit ein einzelner Durchschnittswert kein Versagen in einer Hochrisikoregion, einem Kundensegment oder einem Quellsystem verbirgt.
Schwellenwerttests gegen die Prüfkapazität, um sicherzustellen, dass das tägliche Alarmvolumen bewältigbar ist.
Erfassung von Feedback, damit bestätigte False Positives und True Positives das künftige Tuning verbessern.
Für Teams, die diese Prüfschicht aufbauen, ist dieser Leitfaden zu Methoden zur Ausreißererkennung nützlich, um während der Validierung einfache statistische Prüfungen mit ML-basierten Detektoren zu vergleichen.
Hoher Recall bei geringer Precision führt zu Ermüdung bei den Betreibern. Hohe Precision bei geringem Recall erzeugt blinde Flecken. Ein nützlicher Detektor passt zum Reaktionsmodell des Unternehmens.
Baselines verwenden, die einem Audit standhalten
Beginnen Sie mit einer Baseline, die das Team gegenüber Audit, Security und Betrieb erklären kann. Das kann eine Perzentilregel, ein saisonaler Schwellenwert oder ein einfaches unüberwachtes Modell mit klarer Schwellenwertlogik sein. Wenn ein komplexerer Detektor nur einen Offline-Benchmark verbessert, die Triage aber erschwert, gehört er noch nicht in den produktiven Alarmpfad.
Das ist in Unternehmensumgebungen noch wichtiger, in denen Modelle innerhalb des Warehouse oder Lakehouse laufen, um das Kopieren sensibler Daten in separate Systeme zu vermeiden. In-Database-Ausführung kann Datenschutzkontrollen vereinfachen und die Bewegung regulierter Datensätze reduzieren, setzt Teams aber auch unter Druck, Metriken, Schwellenwerte und Prüfabläufe zu wählen, die mit vorhandenen Observability-Werkzeugen funktionieren. Erfolg bedeutet nicht nur, Anomalien zu erkennen. Erfolg bedeutet, die richtigen Anomalien zu erkennen – bei einem Prüfvolumen, das die Organisation dauerhaft bewältigen kann.
Überlegungen zu Deployment und Monitoring im Unternehmen
Die meisten Beiträge zur Anomalieerkennung mit Machine Learning enden bei der Modellauswahl. Unternehmensteams scheitern meist später, beim Deployment. Sie stellen fest, dass das Modell zu viel Datenbewegung erfordert, Datenschutzerwartungen verletzt, zusätzlichen Betriebsaufwand verursacht oder Schwellenwerte erzeugt, die ihre Relevanz verlieren.
Das sind keine Randprobleme. Das ist die eigentliche Implementierungsarbeit.
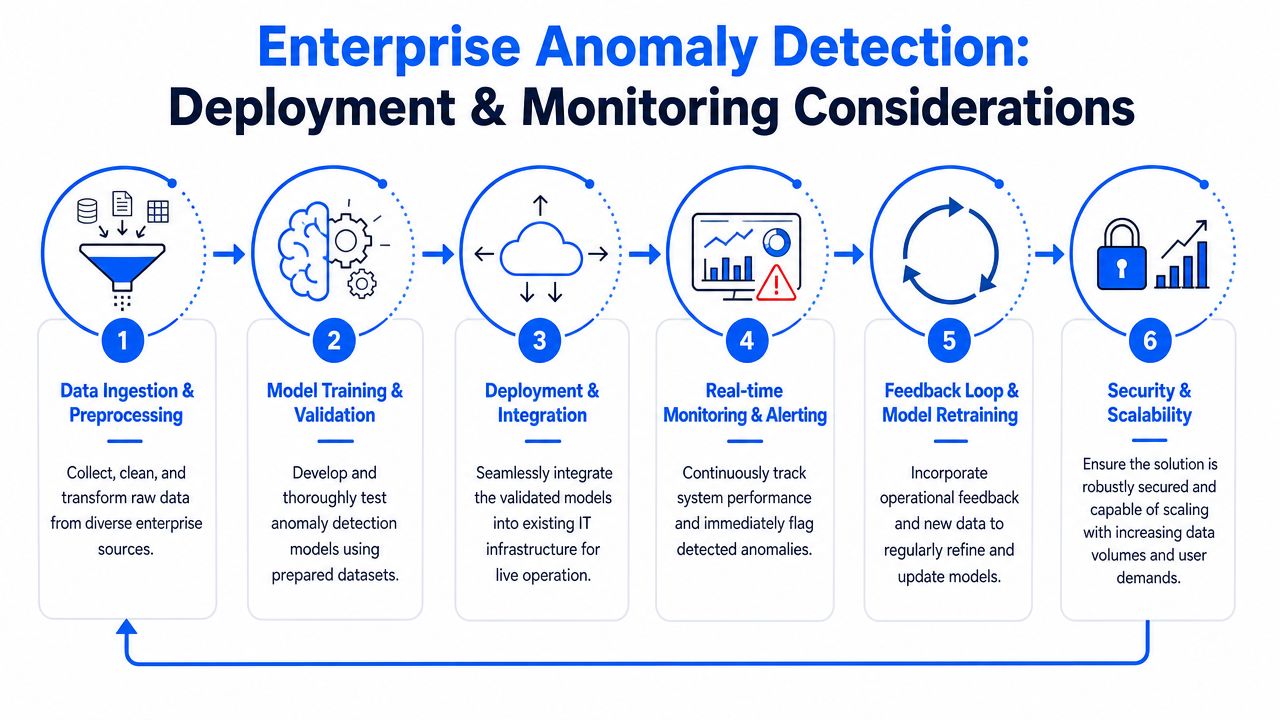
Echtzeit oder Batch
Nicht jede Anomalie muss sofort bewertet werden. Manche Geschäftsprozesse vertragen eine Batch-Erkennung, bei der das System stündliche oder tägliche Zeitfenster prüft. Andere nicht. Betrugsprüfung, operative Telemetrie, SLA-kritische Daten-Feeds und Management-Dashboards benötigen oft deutlich kürzere Feedbackschleifen.
Der Zielkonflikt ist einfach:
Deployment-Modus | Funktioniert gut, wenn | Zielkonflikt |
|---|---|---|
Echtzeit-Scoring | Verzögerungen teuer oder risikosensibel sind | Höhere Komplexität bei Infrastruktur und Betrieb |
Batch-Erkennung | Trends wichtiger sind als sofortige Reaktion | Probleme werden möglicherweise erst nach nachgelagerten Auswirkungen entdeckt |
Teams überschätzen oft ihren Bedarf an Echtzeit und unterschätzen die Kosten für deren Betrieb. Wenn die geschäftliche Maßnahme ohnehin erst am nächsten Morgen erfolgt, kann ein nächtliches Scoring ausreichen.
In-Database-Ausführung verändert die Wirtschaftlichkeit
In Unternehmensumgebungen kann der Ort, an dem das Modell läuft, ebenso wichtig sein wie das, was es tut. Produktionsdaten in einen externen Monitoring-Stack zu ziehen, verursacht zusätzliche Latenz, Governance-Prüfungen, Kosten und Risiken. Außerdem wird Logik über Systeme hinweg dupliziert.
Die Analyse innerhalb der Datenbank oder des Warehouse des Kunden auszuführen, löst mehrere praktische Probleme auf einmal:
Der Datenschutz bleibt strenger: Sensible Datensätze verbleiben in der kontrollierten Umgebung.
Die Performance verbessert sich: Weniger Datenbewegung bedeutet weniger Engpässe.
Der Betrieb wird einfacher: Teams müssen keine großen Metrikmengen exportieren, nur um sie anderswo zu bewerten.
Governance wird einfacher: Security- und Compliance-Teams bevorzugen in der Regel Architekturen mit weniger Datenkopien.
Hier spielt die Produktarchitektur eine Rolle. digna basiert beispielsweise auf In-Database-Metrikberechnung und Baseline-Learning und läuft in Private-Cloud- oder On-Premises-Umgebungen. Damit ist digna relevant für Teams, die Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking und Validierung benötigen, ohne einem Anbieter Zugriff auf Produktionsdatensätze zu gewähren.
Dynamische Schwellenwerte sind keine Option, sondern Pflicht
Statische Schwellenwerte versagen bei sich ändernden Verteilungen. Im Unternehmensmaßstab wird dieses Problem gravierend, weil sich jeder Datensatz anders entwickelt. Neue Regionen, neue Kanäle, neue Geschäftskalender und sich ändernde Nutzungsmuster machen manuell abgestimmte Grenzwerte ungültig.
Aktuelle Arbeiten, zusammengefasst in dieser Forschung zu dynamischen Schwellenwerten für Anomalien, zeigen eine praktische Lösung auf: Autoencoder-basierte Systeme in Kombination mit Isolation Forest können eine ausreißerbewusste Schwellenwertbildung nutzen, um Schwellenwerte dynamisch auf Basis des erlernten Normalverhaltens anzupassen. Das ist wichtig, weil sich manuelles Abstimmen von Schwellenwerten nicht über große Observability-Landschaften hinweg skalieren lässt.
Den Detektor selbst überwachen
Ein Anomaliedetektor ist ein weiteres Produktivsystem. Er benötigt sein eigenes Monitoring.
Input-Drift beobachten: Wenn sich vorgelagerte Schemas oder Verteilungen ändern, können Anomalie-Scores bedeutungslos werden.
Alarmvolumen verfolgen: Plötzliche Anstiege können auf echte Vorfälle oder auf eine Verschlechterung des Detektors hindeuten.
Prüfergebnisse messen: Wenn Analysten Alarme eines Detektors wiederholt verwerfen, trainieren Sie ihn neu oder ersetzen Sie ihn.
Modelllogik sorgfältig versionieren: Änderungen am Feature Engineering oder an Zeitfenstern können das Alarmverhalten ebenso stark verändern wie ein Wechsel des Algorithmus.
Ein Detektor, der nicht überwacht wird, ist der nächste stille Ausfall, der nur darauf wartet, einzutreten.
Observability ist mehr als Anomalien
Die nützlichsten Unternehmens-Setups behandeln Anomalieerkennung nicht als eigenständiges Feature. Sie verknüpfen sie mit Timeliness, Validierung und Schema-Monitoring. Eine Volumenanomalie erhält Kontext, wenn dasselbe System auch einen verspäteten Quell-Load oder eine Änderung des Spaltentyps anzeigt. Die Ursachenanalyse wird schneller, weil Betreiber nicht zwischen unverbundenen Werkzeugen wechseln müssen.
Diese umfassendere Sicht macht Anomalieerkennung handlungsrelevant statt bloß interessant.
Best Practices und typische Fallstricke
Teams erzielen bessere Ergebnisse, wenn sie Anomalieerkennung mit Machine Learning als operative Disziplin und nicht als Modellexperiment behandeln. Die stärksten Deployments sind meist auf die richtige Art unspektakulär: klares Ziel, saubere Eingaben, definierte Verantwortlichkeiten, gemessenes Feedback.
Best Practices, die sich im Produktivbetrieb bewähren
Mit einer geschäftlichen Konsequenz beginnen: Verknüpfen Sie die Erkennung mit einem realen Fehler wie fehlerhaften Prognosen, verzögertem Reporting, Betrugsprüfung oder beschädigten Modelleingaben.
Die Daten profilieren, bevor Sie das Modell wählen: Nutzen Sie bei Bedarf Feature-Skalierung, die Behandlung fehlender Werte und relevantes Feature Engineering. Wie in dieser Übersicht über Methoden der Anomalieerkennung und Vorverarbeitung zusammengefasst, sind Normalisierung, Imputation, Feature Engineering und Hyperparameter-Tuning entscheidende Bestandteile wirksamer Workflows zur Anomalieerkennung.
Zuerst einfache Baselines verwenden: Eine einfache statistische oder baumbasierte Methode kann zeigen, ob das Signal überhaupt existiert, bevor Sie in aufwendigere Architekturen investieren.
Verantwortung für die Alarmprüfung festlegen: Jemand muss bestätigen, ob eine markierte Anomalie echt ist und ob der Reaktionsweg funktioniert hat.
Gezielt neu trainieren: Baselines altern. Legen Sie Retraining und die Überprüfung von Schwellenwerten in einem expliziten Zeitplan fest, der an Datenänderungen gekoppelt ist – nicht an Wunschdenken.
Fallstricke, die Rauschen und Misstrauen erzeugen
Einige Fehler treten immer wieder auf.
Ein Algorithmus für alles: Kunden-Events, Finanztransaktionen, Sensor-Streams und Qualitätsmetriken auf Tabellenebene verhalten sich selten gleich.
Kontext ignorieren: Eine Spitze ohne Informationen zu geschäftlichem Zeitpunkt, Zeitplan oder Segment erzeugt oft Fehlalarme.
Vorverarbeitung auslassen: Distanz- und dichtebasierte Methoden verschlechtern sich bei unskalierten oder unsauberen Eingaben schnell.
Alarme als endgültige Wahrheit behandeln: Ein Anomalie-Score ist eine Entscheidungshilfe, kein Beweis für die Schwere eines Vorfalls.
Nachgelagerte Nutzer vergessen: Wenn das Ergebnis für Analysten, Betreiber oder Stewards nicht verständlich ist, wird das System keine Entscheidungen beeinflussen.
Eine praktische Checkliste
Bevor Sie einen Detektor in Produktion bringen, stellen Sie sicher, dass diese Fragen klar beantwortet sind:
Prüfpunkt | Warum es wichtig ist |
|---|---|
Welche geschäftliche Maßnahme folgt auf einen Alarm? | Erkennung ohne Reaktion erzeugt Rauschen |
Auf welche Art von Anomalie zielen wir ab? | Punkt-, kontextuelle und kollektive Fälle erfordern unterschiedliche Logik |
Benötigen wir lokale oder globale Sensitivität? | Das verändert die Algorithmusauswahl grundlegend |
Wie bewerten wir die Qualität? | Precision, Recall und F1 sind nützlicher als Accuracy |
Wo wird das Scoring ausgeführt? | Die Deployment-Architektur beeinflusst Datenschutz, Kosten und Latenz |
Wer prüft und labelt Grenzfälle? | Feedback hält das System langfristig nützlich |
Anomalieerkennung mit Machine Learning gewinnt Vertrauen, wenn sie Probleme frühzeitig erkennt, genug erklärt, um Handeln zu ermöglichen, und zu den Realitäten des Datenbetriebs in Unternehmen passt. Das bedeutet in der Regel weniger Fixierung auf neuartige Modelle und mehr Disziplin bei Architektur, Prüfschleifen und Integration in die Observability.
Wenn Ihr Team Anomalieerkennung benötigt, die zu den Anforderungen von Unternehmen passt, ist digna eine Option, die sich zu prüfen lohnt. digna konzentriert sich auf Datenanomalien, Validierung, Timeliness und Schema-Tracking mit In-Database-Ausführung in kundenkontrollierten Umgebungen. Das ist hilfreich, wenn Datenschutz, einfacher Betrieb und die Integration in die Observability ebenso wichtig sind wie das Erkennungsmodell selbst.
Für erlernte Baselines zu Tabellenvolumen, fehlenden Werten und Werteverteilungen ohne manuell abgestimmte Schwellenwerte sehen Sie sich an, wie digna Data Anomalies Anomalieerkennung direkt in Ihrer Datenbank ausführt.
Häufig gestellte Fragen
Was ist Anomalieerkennung mit Machine Learning?
Sie ersetzt manuell geschriebene Regeln durch erlernte Baselines: Das System modelliert das erwartete Verhalten und markiert relevante Abweichungen. So erkennt es stille Fehler wie doppelte Datensätze, verspätete Zeitstempel oder driftende Verteilungen. Der Artikel zitiert Forschungsergebnisse, nach denen ML-Methoden klassische statistische Ansätze in der Genauigkeit um 8 bis 12 % übertreffen, insbesondere bei multivariaten, hochdimensionalen Daten.
Was sind Punktanomalien, kontextuelle und kollektive Anomalien?
Punktanomalien sind einzelne Werte, die falsch wirken, etwa ein Warehouse-Load mit einer unmöglichen Anzahl von Datensätzen. Kontextuelle Anomalien hängen von Zeitpunkt oder Rahmenbedingungen ab, etwa ein hohes Login-Volumen um 3 Uhr nachts. Kollektive Anomalien sind Gruppen harmlos wirkender Datensätze, die ein fehlerhaftes Muster bilden, etwa ein koordinierter Bot-Angriff oder Schema-Drift über mehrere Felder.
Sollte ich überwachte oder unüberwachte Anomalieerkennung einsetzen?
Unüberwachte Methoden sind in der Regel der praktikable Standard, weil gelabelte Anomalien knapp und teuer sind. Überwachte Methoden eignen sich, wenn geprüfte Vorfälle vorliegen und sich Fehlertypen wiederholen, etwa bei der Betrugs- oder Schadenprüfung. Das unüberwachte k-Means-Setup von Netdata mit k=2 erzielte eine Reduzierung der Fehlalarme um 99 %, weil Übereinstimmung zwischen mehreren Modellen verlangt wurde.
Ist Isolation Forest oder k-Nearest Neighbors besser für die Anomalieerkennung?
Das hängt davon ab, ob die Anomalien global oder lokal sind. Forschung im Journal of Machine Learning Research ergab, dass k-Nearest Neighbors den Isolation Forest übertrifft, wenn die Daten mehrere Dichte-Cluster enthalten, während Isolation Forest für rein globale Ausreißer geeignet ist. Kundendaten, die nach Region oder Kanal gruppiert sind, erfordern oft den lokalen, nachbarschaftsbasierten Ansatz.
Wie misst man die Leistung eines Anomaliedetektors?
Verzichten Sie auf Accuracy, die bei unausgewogenen Daten gut aussieht, selbst wenn ein Modell fast alles als normal einstuft. Nutzen Sie Precision, Recall und F1 und testen Sie Schwellenwerte anschließend gegen die tatsächliche Prüfkapazität: Ein Detektor, der bei 600 Datensätzen anschlägt, obwohl nur zwölf Handlungsbedarf haben, versagt – egal wie gut sein Offline-Score aussah.



