Data drift detection: guida pratica per il 2026
|
7
min di lettura

La vostra dashboard si aggiorna ancora secondo programma. Il modello continua a restituire previsioni. Il job della pipeline è ancora verde. Eppure i numeri non rispecchiano più la realtà.
È questo l'aspetto scomodo del drift. Di solito non si annuncia con un guasto clamoroso del sistema. Una previsione dei ricavi inizia a sbagliare in un segmento. Un modello antifrode lascia passare schemi che prima intercettava. Una dashboard di marketing fa improvvisamente sembrare un canale più forte di un altro perché il mix di input sottostante è cambiato a monte senza che nessuno se ne accorgesse. I team continuano ad agire sui risultati perché i meccanismi sembrano sani.
In pratica, è in queste circostanze che la fiducia inizia a erodersi. Gli ingegneri non vedono alcun incidente. Gli analisti vedono schemi strani. Gli stakeholder di business vedono report che sembrano sbagliati ma non riescono a dimostrare perché. Quando qualcuno riconduce il problema a distribuzioni cambiate, baseline obsolete o a un effetto collaterale silenzioso dello schema, il team ha già passato giorni a discutere del sintomo invece di correggerne la causa. Ecco perché la data drift detection appartiene alla stessa categoria operativa del monitoraggio delle pipeline e dei controlli di data quality.
I team che adottano sempre più strumenti di AI sono particolarmente esposti, perché aumentano il numero di sistemi che dipendono da input stabili. Se state cercando di orientarvi in questo panorama di strumenti più ampio, Iwo Szapar sugli strumenti di AI per founder offre un utile punto di vista esterno sulla rapidità con cui questi stack si evolvono. La parte che molti team trascurano è più semplice: nessuno di questi strumenti resta affidabile quando i dati sottostanti si spostano senza che nessuno se ne accorga.
Per i sistemi di ML come per l'analytics, la dura verità è la stessa. I vostri risultati sono affidabili solo quanto gli input e la disciplina di monitoraggio che li sostengono. Ecco perché il lato operativo della qualità conta quanto la progettazione del modello, e perché la qualità dei dati incide direttamente sull'affidabilità dei modelli di AI anche molto dopo il deployment.
Indice
La minaccia silenziosa per i vostri dati e la vostra AI
Uno schema di guasto comune all'inizio sembra banale. Una dashboard che i dirigenti usano ogni lunedì continua a caricarsi, ma una dimensione a monte ha cambiato significato. Un modello di churn restituisce ancora punteggi, ma il comportamento recente dei clienti non somiglia più alla baseline di addestramento. Nessuno riceve un alert perché il sistema funziona, nel senso tecnico più stretto.
Ciò che si rompe per primo non è sempre il modello. Di solito è la fiducia.
Quando i risultati restano disponibili ma diventano inaffidabili
I team di analytics spesso rilevano il drift in modo indiretto. Sentono dire che un KPI “sembra strano”. Confrontano i risultati di questa settimana con i periodi precedenti e trovano una discrepanza che non sanno spiegare. Gli ingegneri controllano allora i log di orchestrazione, la freschezza del warehouse e i conteggi delle righe. Tutto sembra normale. Il problema si trova un livello più in profondità, nella distribuzione dei dati stessi.
Il data drift è pericoloso perché conserva l'apparenza della salute mentre degrada il significato del risultato.
Ecco perché il drift non andrebbe trattato come una questione MLOps di nicchia. I team di BI lo affrontano quando i segmenti di clientela cambiano, i cataloghi prodotto si modificano, i payload degli eventi evolvono o la logica di raccolta viene aggiornata senza un corrispondente adeguamento delle ipotesi a valle. I team di ML affrontano lo stesso schema con conseguenze più immediate, perché un modello può continuare a produrre punteggi con sicurezza su dati che non comprende più.
Perché i team di business sentono il problema prima dell'engineering
Gli utenti di business di solito notano il problema per primi perché convivono con le decisioni. Vedono il targeting delle campagne mancare il bersaglio. Notano report che non corrispondono alla realtà sul campo. Mettono in discussione il data team, anche quando tecnicamente nessuna pipeline ha fallito.
Questo scollamento genera un rumore costoso:
Gli analisti perdono tempo: iniziano a validare a mano ogni report a valle.
Gli ingegneri inseguono i sintomi: controllano freschezza e disponibilità mentre il cambiamento delle distribuzioni passa inosservato.
Gli stakeholder smettono di fidarsi dei modelli: una volta incrinata la fiducia, ogni previsione o raccomandazione viene messa in dubbio.
La soluzione non è soltanto più QA sulle dashboard. I team hanno bisogno di controlli continui che confrontino il comportamento attuale in produzione con una baseline stabile e segnalino i cambiamenti significativi prima che gli utenti ne subiscano l'impatto. Quando si inquadra il drift come un problema di affidabilità operativa, l'implementazione diventa molto più chiara. Si smette di chiedersi se il modello è “attivo” e si inizia a chiedersi se gli input somigliano ancora al mondo per cui il sistema è stato progettato.
Che cos'è il data drift: un kit concettuale
Il data drift è più facile da capire se si smette di pensarlo come un singolo bug. Si comporta piuttosto come un fiume che cambia corso. L'acqua continua a scorrere, ma il percorso, la forma e la forza non sono più quelli per cui il vostro ponte è stato progettato.
Alcuni spostamenti sono graduali. Altri arrivano dopo il lancio di un prodotto, un cambio di policy, una nuova coorte di clienti o una trasformazione a monte. Il punto importante è che il sistema può continuare a funzionare mentre le sue ipotesi smettono lentamente di corrispondere alla realtà della produzione.

Perché il drift sembra invisibile finché non fa danni
Gli approcci comuni alla data quality si concentrano su disponibilità, validità dello schema e completezza dei record. Questi controlli contano, ma non vi dicono se la popolazione stessa si è spostata. Una feature può restare presente, correttamente tipizzata e completamente popolata mentre la sua distribuzione cambia abbastanza da rendere un report fuorviante o un modello fragile.
Ecco perché il drift appartiene al vostro kit concettuale accanto alla data quality. Risponde a una domanda diversa: non “il campo c'è?” ma “questo campo si comporta ancora come la baseline di cui ci fidiamo?”
I tre tipi di drift che i team dovrebbero distinguere
Gli ingegneri finiscono nei guai quando chiamano tutto drift senza classificarlo. Modalità di guasto diverse richiedono risposte diverse.
Il concept drift si verifica quando cambia la relazione tra input ed esiti. Nella fraud detection può accadere quando gli attaccanti cambiano tattica e i vecchi segnali comportamentali smettono di indicare la frode come facevano prima. Le feature possono sembrare ancora familiari, ma la vecchia relazione appresa non regge più.
Il feature drift si verifica quando cambiano le distribuzioni degli input. Un modello di previsione della domanda potrebbe ricevere improvvisamente un mix di regioni, categorie di prodotto o comportamenti dei clienti diverso da quello visto durante l'addestramento. La logica del modello può essere ancora valida, ma gli input si sono spostati.
Il label drift si verifica quando cambia la distribuzione del target. Un flusso di classificazione può ricevere ancora gli stessi tipi di record, ma la proporzione delle classi di esito cambia abbastanza da influire su soglie, calibrazione o interpretazione a valle.
Regola pratica: classificate il drift prima di discutere il rimedio. Il riaddestramento può aiutare con un tipo e incidere a malapena su un altro.
Una semplice diagnosi aiuta. Se sono cambiati gli input, partite dal feature drift. Se sono cambiati gli output o il mix di classi, esaminate il label drift. Se nessuno dei due spiega il degrado ed è cambiato il mondo stesso, sospettate il concept drift. Questo inquadramento evita molto lavoro sprecato perché costringe il team a collegare i sintomi al livello corretto del sistema.
Metodi chiave per la data drift detection
Nella data drift detection esistono due grandi scuole. La prima si basa su test statistici che confrontano direttamente le distribuzioni di addestramento e di produzione. La seconda usa metodi basati su modelli per rilevare cambiamenti più difficili da cogliere con semplici controlli univariati.
Per i dati tabellari strutturati, i metodi statistici sono di solito il primo punto di partenza. Sono più facili da spiegare, meno costosi da eseguire e più semplici da rendere operativi in ambienti incentrati sul warehouse. Per dati ad alta dimensionalità, sparsi o non strutturati, i team spesso hanno bisogno di approcci basati su modelli, perché il drift non emerge in modo netto in una singola feature alla volta.
Controlli statistici per i dati strutturati
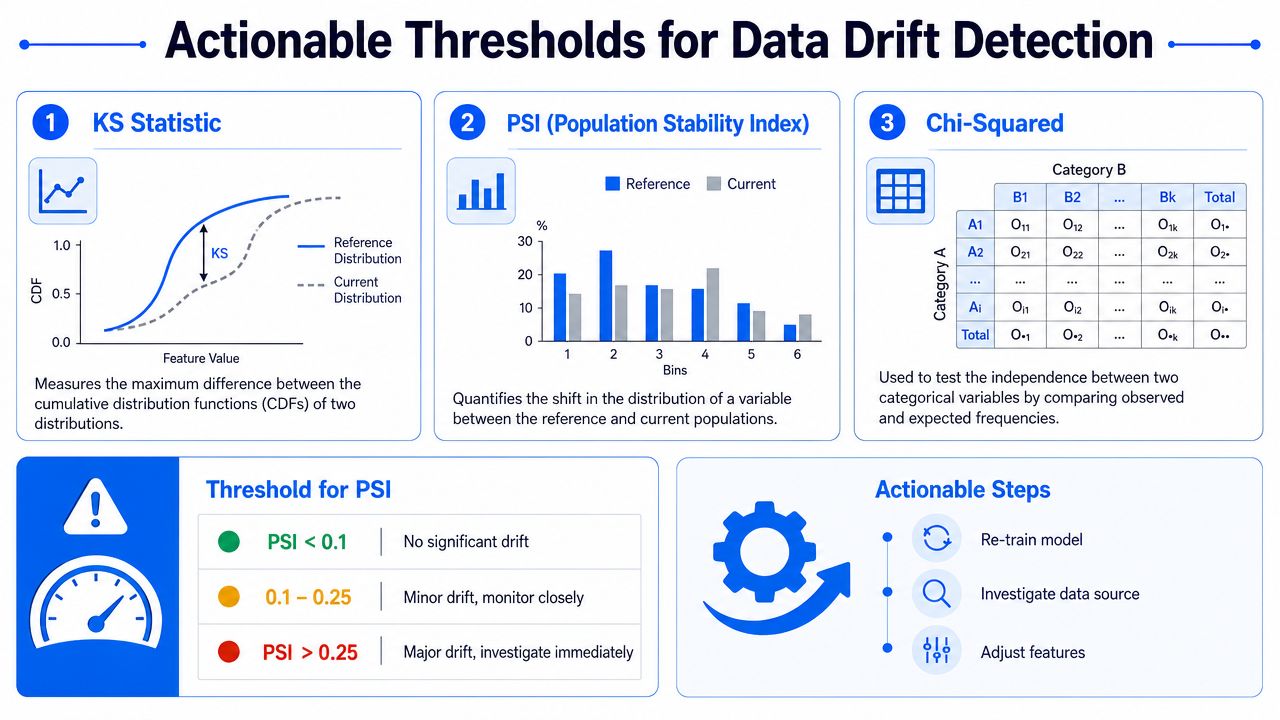
Il test di Kolmogorov-Smirnov è una scelta standard per le feature numeriche. Confronta le funzioni di distribuzione cumulativa dei campioni di addestramento e di produzione e restituisce un p-value. Quando quel p-value scende sotto 0,05, l'ipotesi nulla che entrambi i campioni provengano dalla stessa distribuzione viene rifiutata, il che conferma la presenza di drift, come descritto nella panoramica di DASCA sul data drift e sul test K-S.
Il Population Stability Index, di solito chiamato PSI, è particolarmente diffuso negli ambienti operativi perché i team possono interpretarlo rapidamente. Funziona bene quando serve un semplice segnale di gravità per i cambiamenti tra una baseline attesa e il comportamento attuale in produzione.
Un buon approccio è combinarli entrambi. Usate un test formale come il K-S per la significatività statistica sulle feature numeriche, poi usate il PSI per stabilire quali cambiamenti sono abbastanza importanti, dal punto di vista operativo, da meritare un'indagine.
Approcci basati su modelli per i segnali più difficili
La statistica pura inizia a faticare quando i dati sono ad alta dimensionalità o quando le interazioni contano più delle singole colonne. Embedding testuali, feature di immagini, flussi di eventi e ampie tabelle comportamentali rientrano spesso in questa categoria.
In queste situazioni, i team di solito passano alla drift detection basata su modelli:
Monitoraggio delle rappresentazioni: tracciate gli spostamenti nelle feature latenti o negli embedding invece che nelle colonne grezze.
Classificatori di dominio: addestrate un modello a distinguere i dati di baseline dai dati attuali di produzione. Se quel classificatore li separa facilmente, le distribuzioni sono divergenti in modo significativo.
Monitoraggio dello spazio delle previsioni: osservate la confidenza, le distribuzioni dei punteggi o gli schemi di previsione a livello di coorte quando le etichette dirette arrivano in ritardo.
Se cercate un complemento pratico a questo modo di ragionare, gli approfondimenti di Flaex.ai sull'AI adattiva sono utili per capire come il monitoraggio adattivo cambi il modello di manutenzione una volta che i sistemi sono in produzione. Per schemi di implementazione affini, questa panoramica sulle tecniche di anomaly detection basate sull'AI è altrettanto pertinente, perché molti team di produzione combinano l'anomaly detection con controlli specifici per il drift invece di sceglierne solo uno.
Confronto tra i metodi di data drift detection
Metodo | Tipo | Ideale per | Pro | Contro |
|---|---|---|---|---|
Test K-S | Statistico | Feature numeriche | Test d'ipotesi chiaro, indipendente dalla distribuzione per i dati numerici, facile da automatizzare | Meno utile per interazioni complesse tra feature |
PSI | Statistico | Monitoraggio operativo stabile per dati tabellari | Punteggio di gravità interpretabile, comune nei flussi di produzione | Dipende da un binning sensato e dalla scelta della baseline |
Controlli categoriali di tipo chi-quadro | Statistico | Distribuzioni di feature categoriali | Semplice per gli spostamenti a livello di categoria | Può generare alert rumorosi con categorie sparse |
Classificatore di dominio | Basato su ML | Dati strutturati o semi-strutturati ad alta dimensionalità | Coglie gli spostamenti multivariati meglio dei controlli isolati | Più difficile da spiegare agli stakeholder non tecnici |
Monitoraggio del drift degli embedding | Basato su ML | Testo, immagini, sequenze comportamentali | Utile per i dati non strutturati | Richiede pipeline di rappresentazione e una definizione accurata della baseline |
Monitoraggio dello spazio delle previsioni | Basato su ML | Sistemi con etichette in ritardo | Aiuta a cogliere cambiamenti significativi nel comportamento degli output | Può nascondere la causa principale se non si monitorano anche le feature di input |
Il compromesso è semplice. I metodi statistici sono migliori per trasparenza e disciplina operativa. I metodi basati su modelli sono migliori quando la realtà è più disordinata di un istogramma a colonna singola.
Definire metriche e soglie azionabili
Il rilevamento senza soglie crea rumore. Le soglie senza un piano d'azione creano teatro. La parte utile della data drift detection inizia quando il team concorda quale livello di cambiamento merita attenzione, escalation e intervento.
L'esempio più pratico è il PSI, perché i team possono trasformarlo in una chiara regola operativa. Secondo le indicazioni di Machine Learning Mastery sulla gestione del data drift in produzione, un valore di PSI superiore a 0,25 indica che la distribuzione si è spostata in modo sostanziale rispetto alla sua baseline storica e suggerisce che il modello stia probabilmente ricevendo dati di input su cui non è stato addestrato.
Le soglie devono innescare azioni, non panico
Non ogni spostamento merita un riaddestramento. I team hanno bisogno di un modello di interpretazione a livelli. Un framework PSI pratico tratto dalla guida di TrueFoundry al tracciamento del drift è il seguente:
PSI inferiore a 0,1: nessun cambiamento significativo della popolazione
PSI da 0,1 a 0,2: cambiamento moderato che merita un'indagine
PSI pari o superiore a 0,2: drift significativo che in genere richiede un riaddestramento o un aggiornamento del feature engineering
Queste soglie sono utili, ma non sono universali. Un modello usato per una prioritizzazione interna a basso rischio può tollerare più variazione di un sistema legato a decisioni regolamentate o ad automazioni rivolte ai clienti. I team dovrebbero calibrare le soglie in base all'impatto sul business, al costo del riaddestramento e alla rapidità con cui arrivano le etichette per la validazione.
Se una soglia non cambia ciò che qualcuno fa subito dopo, non è una soglia operativa. È una decorazione del grafico.
Come rendere operative le soglie
Il modo più pulito per rendere utili le soglie è abbinarle a runbook espliciti.
Segnale | Interpretazione | Azione del team |
|---|---|---|
Intervallo stabile | Variazione attesa | Continuare il monitoraggio |
Intervallo di indagine | Primo segnale di spostamento | Verificare modifiche a monte, coorti, stagionalità e data contract |
Intervallo di azione | Drift rilevante | Avviare una revisione del riaddestramento, una revisione delle feature o guardrail temporanei |
I team migliori definiscono anche le soglie per famiglia di feature. Le feature comportamentali ad alta volatilità non dovrebbero condividere le stesse impostazioni di sensibilità delle dimensioni di riferimento o degli identificativi di business principali. Questa sola scelta progettuale previene molta alert fatigue.
Progettare un'architettura di monitoraggio moderna
I controlli SQL ad hoc non reggono a lungo. Quando si hanno più modelli, pipeline di warehouse e gruppi di stakeholder, il monitoraggio del drift ha bisogno di una vera architettura alle spalle.
Una progettazione solida parte vicino ai dati e, quando possibile, calcola le metriche dove i dati risiedono già. Questo riduce gli spostamenti di dati, semplifica la postura di privacy e mantiene lo stack di monitoraggio allineato alla realtà della produzione, invece di basarsi su export campionati o copie laterali.
L'architettura minima indispensabile
La maggior parte delle configurazioni di livello enterprise richiede cinque componenti.
Punti di raccolta che attingono da tabelle del warehouse, feature store, pipeline di eventi o log degli input dei modelli.
Calcolo delle metriche che esegue controlli sulle distribuzioni, confronti con la baseline e segnali di anomalia.
Archiviazione storica delle metriche, così che i team possano esaminare i trend invece di istantanee isolate.
Gestione delle baseline per definire che cosa significa “normale” per ogni feature, flusso di previsioni o coorte.
Alerting e visualizzazione, così che le persone giuste vedano il problema in tempo e con abbastanza contesto per agire.
Il monitoraggio programmato conta più di quanto molti team pensino. Le indicazioni di Acceldata sull'analisi programmata del drift raccomandano confronti automatizzati con una baseline stabile a cadenza settimanale o quindicinale e osservano esplicitamente che attendere controlli ad hoc dopo un guasto è insufficiente. È uno standard operativo pratico perché intercetta il drift che si accumula prima che abbia un impatto visibile per gli utenti.
Qui il confine tra data observability e data quality spesso si confonde, ma la distinzione conta quando si progetta lo stack. Questa spiegazione su data observability e data quality a confronto è un utile riferimento concettuale, perché il monitoraggio del drift si colloca al confine tra le due.
Chi deve vedere cosa
L'architettura fallisce se ogni alert arriva a un unico team tecnico privo di contesto di business. La drift detection dovrebbe instradare gli alert in modo diverso in base alla modalità di guasto.
I data engineer hanno bisogno di indizi su lineage, freschezza, schema e modifiche a monte.
Gli ML engineer hanno bisogno di diagnostica a livello di feature e di previsione collegata alle versioni dei modelli.
Gli analytics engineer e i responsabili BI hanno bisogno di confronti tra coorti e di visibilità sull'impatto sui report.
Gli utenti di business hanno bisogno di una sintesi in linguaggio semplice di cosa è cambiato e se le decisioni vanno sospese.
Un modello operativo sintetico aiuta:
Stakeholder | Di cosa ha bisogno per prima cosa | Decisione tipica |
|---|---|---|
Data engineer | Modifica della sorgente, storico della pipeline | Correggere il problema a monte o la violazione del contratto |
ML engineer | Portata del drift, feature interessate, versione del modello | Riaddestrare, ricalibrare o sospendere il deployment |
Analista | Impatto sulle metriche per segmento | Validare l'interpretazione della dashboard |
Responsabile della governance | Audit trail ed evidenze | Documentare revisione e risposta |
Una dimostrazione pratica rende questa architettura più facile da visualizzare:
Nota dal campo: i migliori sistemi di monitoraggio non si limitano a rilevare il drift. Conservano abbastanza storico e contesto da permettere ai team di spiegare perché è accaduto.
Errori comuni e come porvi rimedio
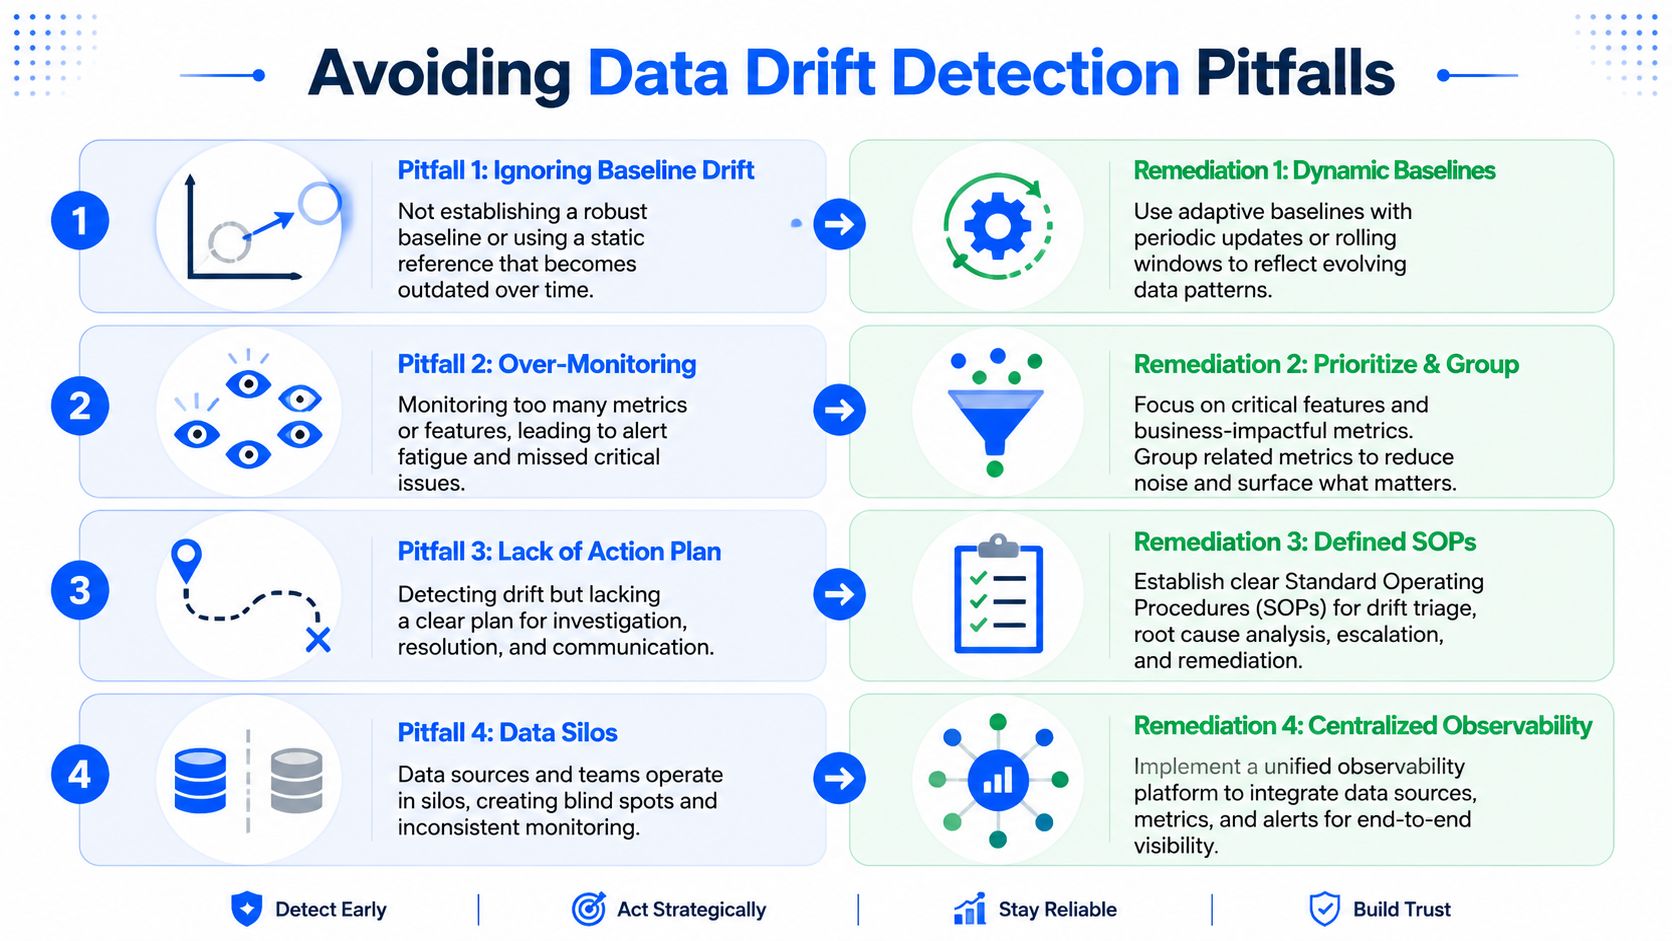
La maggior parte dei programmi di drift detection falliti non fallisce perché la matematica è sbagliata. Fallisce perché il modello operativo è debole. I team monitorano troppo, reagiscono alla cosa sbagliata oppure rilevano il cambiamento senza decidere chi è responsabile della risposta.
Dove le implementazioni di solito si rompono
Alcuni schemi si ripresentano di continuo:
Soglie troppo strette: i team generano alert sulle normali variazioni stagionali e abituano tutti a ignorare il sistema. Il rimedio è allargare le soglie per le feature volatili e rivedere gli alert per coorte prima dell'escalation.
Troppe feature monitorate allo stesso modo: una lunga coda di colonne di scarso valore produce rumore. Concentratevi prima sugli input critici per il business, sulle feature dei modelli più importanti e sulle dimensioni che alimentano il reporting direzionale.
Non esiste un percorso di rimedio: rilevare il drift senza un runbook crea backlog, non affidabilità. Definite che cosa succede quando il drift è confermato. Può significare riaddestramento, ricalibrazione, dismissione di una feature o sospensione temporanea di un output a valle.
La stagionalità viene confusa con un cambiamento strutturale: una certa variazione è normale. Usate baseline mobili o finestre di confronto che rispettino i cicli ricorrenti, invece di trattare ogni spostamento periodico come un nuovo incidente.
Una semplice regola evita molti problemi. Partite in piccolo, dimostrate la qualità del segnale, poi ampliate. Un sistema di drift detection che intercetta meno problemi ma porta ad azioni rapide e credibili è molto meglio di uno rumoroso che inonda Slack e viene ignorato.
Drift detection pronta per l'enterprise
Su scala enterprise, la drift detection smette di essere solo un problema di statistica. Diventa un problema di privacy, architettura e governance.
Privacy, scala e governance cambiano la progettazione
Le grandi organizzazioni non possono affidarsi a flussi che, per comodità, copiano dati di produzione sensibili in servizi di monitoraggio esterni. Negli ambienti regolamentati, la progettazione del monitoraggio deve rispettare dove risiedono i dati, chi può esaminarli e come vengono conservate le evidenze di una revisione continua. È uno dei motivi per cui l'esecuzione in-database è così interessante: consente ai team di calcolare metriche e apprendere baseline all'interno dell'ambiente controllato dal cliente, invece di spostare dati grezzi.
Anche la scala cambia il modello operativo. Un'azienda può avere centinaia di tabelle critiche, molte dashboard a valle, diverse pipeline di feature e domini di responsabilità differenti. La revisione manuale non sopravvive in un ambiente del genere. Servono baseline standard, instradamento degli alert, contesto storico e flussi documentati, così che responsabili della governance, data engineer e team di ML possano coordinarsi senza inventare un nuovo processo ogni volta.
I programmi più solidi trattano inoltre il drift come parte della business continuity. Se un sistema decisionale diventa inaffidabile, la domanda non è solo se il modello vada riaddestrato. È se gli utenti a valle debbano continuare ad agire sull'output, se le evidenze di audit siano sufficienti e se l'incidente debba innescare una revisione più ampia sui dataset adiacenti.
Ecco perché i team maturi collocano la drift detection sotto lo stesso ombrello strategico di data quality, observability e governance. Protegge modelli, report e processi decisionali allo stesso tempo.
Se state costruendo uno stack di monitoraggio di questo tipo, digna è pensata per le realtà operative che i team affrontano: anomaly detection, tempestività, validazione, tracciamento dello schema e observability che girano all'interno di ambienti controllati dal cliente, senza accesso del vendor ai dati di produzione. Per le aziende che hanno bisogno di privacy, flussi chiari e monitoraggio sia degli input di analytics sia di quelli di AI, è un punto di partenza concreto.
Per i team che vogliono baseline apprese invece di soglie PSI calibrate a mano su ogni feature, digna Data Anomalies apprende il comportamento normale delle tabelle monitorate direttamente nel database e segnala gli spostamenti delle distribuzioni non appena emergono.
Domande frequenti
Che cos'è la data drift detection?
La data drift detection è il confronto continuo dei dati di produzione attuali con una baseline stabile, per intercettare i cambiamenti nelle distribuzioni prima che gli utenti ne subiscano l'impatto. Una feature può restare presente, correttamente tipizzata e completamente popolata mentre la sua distribuzione si sposta abbastanza da rendere un report fuorviante o un modello fragile.
Qual è la differenza tra concept drift, feature drift e label drift?
Il concept drift indica che è cambiata la relazione tra input ed esiti, come quando i truffatori cambiano tattica. Il feature drift indica che sono cambiate le distribuzioni degli input, ad esempio un nuovo mix di regioni. Il label drift indica che sono cambiate le proporzioni delle classi target. Classificate il drift prima di discutere il rimedio, perché il riaddestramento aiuta alcuni tipi più di altri.
Come rileva il data drift il test di Kolmogorov-Smirnov?
Il test K-S confronta le funzioni di distribuzione cumulativa dei campioni di addestramento e di produzione per una feature numerica e restituisce un p-value. Quando quel p-value scende sotto 0,05, l'ipotesi che entrambi i campioni provengano dalla stessa distribuzione viene rifiutata, confermando il drift. Abbinatelo al PSI per stabilire le priorità dei cambiamenti.
Quale valore di PSI indica un data drift significativo?
Un framework pratico considera un PSI inferiore a 0,1 come nessun cambiamento significativo, da 0,1 a 0,2 come un cambiamento moderato che merita un'indagine, e pari o superiore a 0,2 come un drift significativo che richiede un riaddestramento o un aggiornamento delle feature. Machine Learning Mastery osserva che un PSI superiore a 0,25 indica che la distribuzione si è spostata in modo sostanziale rispetto alla baseline.
Con quale frequenza vanno eseguiti i controlli sul data drift?
I controlli sul drift dovrebbero essere eseguiti secondo una pianificazione, non ad hoc dopo un guasto. Acceldata raccomanda confronti automatizzati con una baseline stabile a cadenza settimanale o quindicinale, così da intercettare il drift che si accumula prima che raggiunga gli utenti. Usate baseline mobili che rispettino i cicli stagionali, in modo che gli spostamenti periodici non generino falsi incidenti.


