Rilevamento delle anomalie nelle serie temporali: guida 2026
|
12
min di lettura

Raramente una dashboard si guasta con un picco clamoroso o un grafico vuoto. Più spesso continua a mostrare numeri plausibili mentre un job a monte perde record, una modifica dello schema sposta una metrica o un caricamento in ritardo arriva subito dopo la scadenza del reporting. Il grafico sembra abbastanza normale. E il business prende comunque le sue decisioni.
Ecco perché il rilevamento delle anomalie nelle serie temporali conta ben oltre la data science. Nelle pipeline enterprise, le serie temporali sono il battito operativo della vostra piattaforma: numero di righe per ora, volumi di eventi per sorgente, freshness per tabella, tassi di valori null per partizione, ricavi per mercato, sinistri per fornitore, transazioni per canale. Se questi segnali derivano, il problema non è solo un monitoraggio carente. È una governance carente, previsioni sbagliate e decisioni sbagliate.
In passato i team gestivano tutto questo con regole statiche. Alert se il volume scende sotto una soglia fissa. Alert se un job dura più del solito. Alert se ieri differisce troppo dalla settimana scorsa. Questi controlli aiutano, ma non reggono quando i sistemi crescono, la stagionalità cambia e il comportamento normale varia tra prodotti, regioni o giorni della settimana. Il moderno rilevamento delle anomalie funziona diversamente. Apprende una baseline, tiene conto del contesto e segnala le deviazioni senza costringere gli ingegneri a mantenere a mano ogni regola.
Indice
I guasti nascosti nella vostra pipeline di dati
I guasti di pipeline più difficili da individuare sono quelli che non sembrano guasti. Un batch in ritardo arriva comunque. Una trasformazione viene comunque eseguita. Un riquadro BI viene comunque visualizzato. Ma il segnale sottostante si è spostato quanto basta per trarre in inganno tutti a valle.
È uno dei vantaggi principali del rilevamento delle anomalie: intercetta le deviazioni prima che diventino verità accettate. Come spiega la panoramica di FirstEigen sul rilevamento delle anomalie, gli algoritmi di rilevamento delle anomalie migliorano la qualità dei dati isolando gli outlier che segnalano errori, eventi imprevisti o opportunità, così che i team possano affrontare i problemi prima che compromettano analisi e decisioni.
Negli ambienti regolamentati, i guasti silenziosi dei dati possono diventare più di un problema di analytics. Si trasformano in rilievi di audit, lacune nel reporting o debolezze dei controlli. Un esempio utile è l'articolo di Visbanking sui fallimenti nella gestione dei dati regolamentari, che mostra come i guasti operativi nel trattamento dei dati possano avere conseguenze molto concrete.
L'affidabilità inizia sotto la dashboard
Le organizzazioni investono spesso molto in dashboard, modelli semantici e accesso self-service. Meno investono la stessa energia nell'osservare se i segnali di origine si comportano ancora come dovrebbero. Questo squilibrio crea un punto cieco.
Tra i modelli di guasto più comuni:
Dati in ritardo: una tabella arriva dopo la finestra di consegna prevista, ma nessuno se ne accorge finché un report mattutino non appare scarno.
Caricamenti parziali: le pipeline hanno tecnicamente successo ma perdono una partizione, un tenant o una sorgente a monte.
Deriva comportamentale: una metrica cambia forma in modo così graduale che i controlli a soglia statica non scattano mai.
Effetti collaterali dello schema: il tipo di una colonna cambia, la cardinalità di una join si sposta e i valori aggregati restano plausibili pur essendo sbagliati.
Regola pratica: se una metrica può influire su una decisione di business, monitoratene il comportamento come serie temporale, non solo lo stato di successo del job che la produce.
L'observability deve passare dai controlli binari ai controlli comportamentali. Invece di chiedersi soltanto se un task è andato a buon fine, bisogna chiedersi se i dati risultanti sembrano ancora sé stessi. È questa la mentalità alla base di un monitoraggio orientato alla produzione, ed è anche il motivo per cui i team investono in sistemi di allerta precoce, come illustrato nelle indicazioni sul perché le pipeline di dati falliscono in produzione e su come rilevare tempestivamente i problemi.
I tipi di anomalie nelle serie temporali
Prima di poter rilevare un'anomalia, dovete definire che tipo di anormalità state cercando. Nelle serie temporali non si tratta di una cosa sola. La stessa metrica può guastarsi in diversi modi, e ogni modello di guasto richiede una risposta diversa.
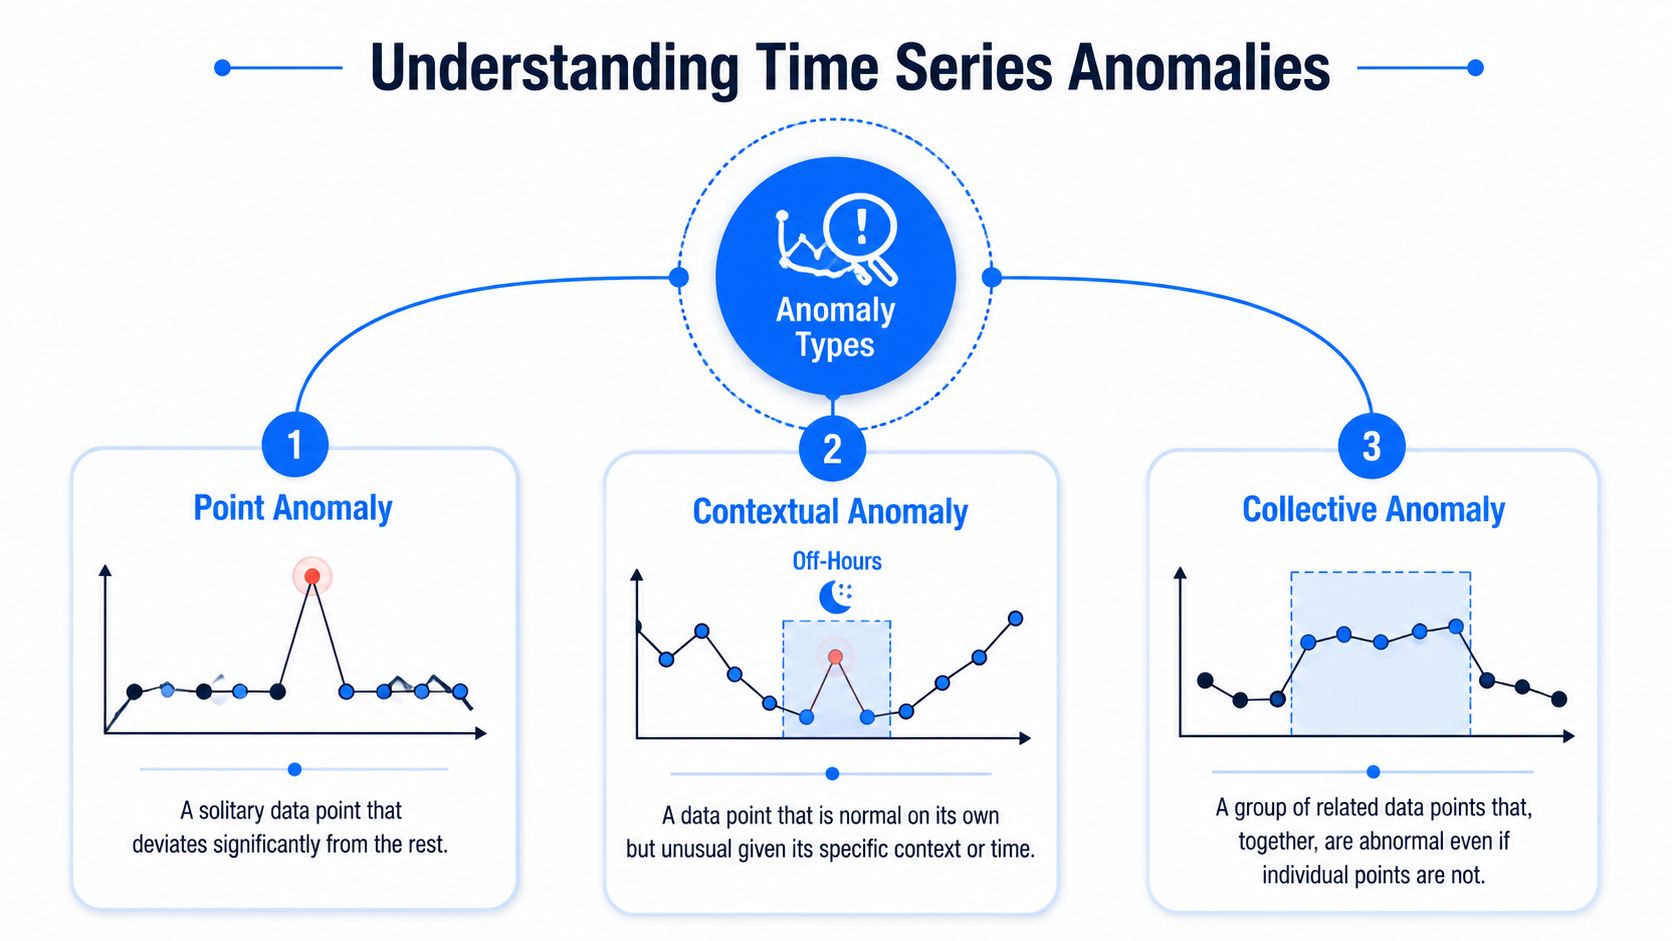
La ricerca distingue in genere le anomalie delle serie temporali in anomalie puntuali, contestuali e collettive: le anomalie puntuali sono deviazioni isolate, quelle contestuali dipendono dal momento o dalle condizioni, mentre quelle collettive emergono lungo una sequenza anziché in un singolo valore, come riassunto in questa recente rassegna sulle categorie di anomalie e sulle combinazioni di detector.
Anomalie puntuali
Un'anomalia puntuale è il caso più semplice. Un valore si discosta nettamente dall'andamento circostante.
Pensate alle transazioni di pagamento orarie che di solito si muovono in una fascia ristretta, finché in un'ora si verifica un picco improvviso perché una sorgente ha duplicato gli eventi. Oppure a un sensore che emette una singola lettura impossibile a causa di un errore di raccolta. Sono le anomalie più facili da spiegare e spesso le più facili da rilevare.
Contano comunque sul piano operativo, perché un singolo punto errato può distorcere gli aggregati, attivare automazioni a valle o contaminare una feature di un modello.
Anomalie contestuali
Un'anomalia contestuale è più insidiosa. Il valore può essere normale preso da solo, ma sbagliato per il momento in cui compare.
Un buon esempio è il traffico o il volume degli ordini in un orario insolito. Un'elevata attività di checkout a mezzogiorno può essere prevista. Lo stesso valore fuori orario potrebbe indicare eventi riprocessati, errori di fuso orario o un'ingestion ritardata arrivata tutta in blocco. Nei dati infrastrutturali, un elevato utilizzo della CPU può essere previsto durante una finestra batch ma sospetto durante la notte.
È qui che molte regole statiche falliscono spesso. Non capiscono che il comportamento normale cambia in base all'ora, al giorno della settimana, alla stagione, al mercato o alla linea di prodotto.
Un numero può essere valido ed essere comunque anomalo se è arrivato nel contesto sbagliato.
Anomalie collettive
Un'anomalia collettiva si presenta quando una sequenza di punti forma un andamento anomalo, anche se ciascun punto preso singolarmente sembra accettabile.
Un classico esempio di pipeline è un job che inizia a consegnare record con un andamento appiattito. Ogni conteggio orario può restare entro un intervallo ragionevole, ma alla sequenza mancano i normali picchi e avvallamenti che ci si aspetterebbe. Un altro esempio è una latenza che cresce lentamente per diversi intervalli senza che nessun singolo intervallo superi una soglia rigida.
Questi casi sono pericolosi perché i team operativi esaminano spesso i grafici punto per punto. L'andamento diventa evidente solo quando si guarda la forma della serie.
Un modo semplice per inquadrare le tre categorie è questo:
Tipo | Cosa appare sbagliato | Esempio enterprise |
|---|---|---|
Puntuale | Un singolo valore isolato | Raffica di eventi duplicati in un intervallo |
Contestuale | Un valore è sbagliato per il momento in cui compare | Volume di ordini elevato fuori orario |
Collettiva | La forma della sequenza è sbagliata | Andamento piatto prolungato nei conteggi orari di ingestion |
Se il vostro monitoraggio intercetta solo le anomalie puntuali, vi sfuggiranno molti dei problemi che danneggiano l'affidabilità dei dati.
Un workflow pratico di rilevamento delle anomalie
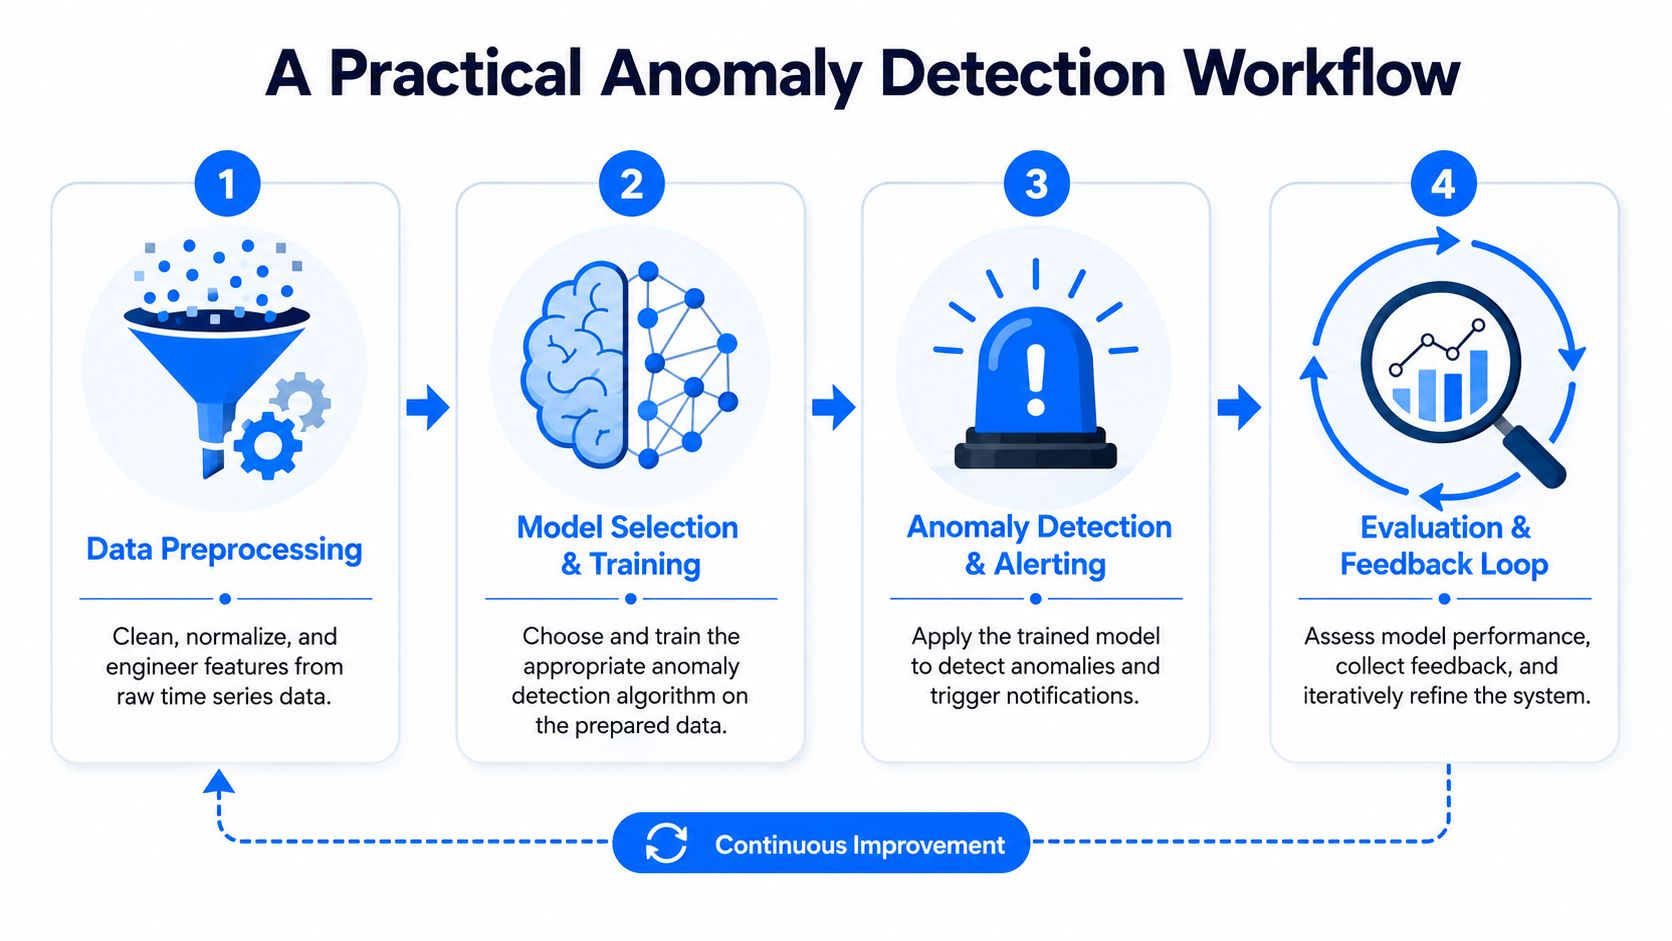
I sistemi di produzione hanno bisogno di un workflow ripetibile, non di un sacco di algoritmi. Il settore è passato da controlli statistici ad hoc a una pipeline più standardizzata con pre-processing dei dati, metodo di rilevamento, scoring e post-processing, come descritto in questa rassegna sul rilevamento delle anomalie nelle serie temporali.
Un buon modello mentale è una catena di montaggio. I segnali grezzi arrivano disordinati. Ogni fase elimina ambiguità prima che la successiva aggiunga capacità di giudizio.
All'inizio di questa catena, lo schema seguente aiuta ad allineare il processo:
Preprocessing prima della modellazione
La maggior parte dei progetti sulle anomalie fallisce prima della modellazione perché la baseline è sporca. Timestamp mancanti, granularità incoerente, partizioni obsolete ed eventi duplicati distorcono ciò che il modello apprende come normale.
Il preprocessing comprende di solito:
Ricampionamento: portare la serie a una granularità coerente, come minuto, ora o giorno.
Gestione delle lacune: decidere se imputare i valori, lasciare espliciti quelli mancanti o segmentare la serie.
Normalizzazione: rendere confrontabili i segnali quando una metrica opera su una scala molto diversa da un'altra.
Rimozione degli outlier dalle finestre di baseline: se usate statistiche di baseline, escludete prima gli outlier evidenti, così che le anomalie non contaminino media e dispersione.
Per i team che vogliono una visione pratica dell'implementazione, questa guida all'automazione del rilevamento delle anomalie è utile perché inquadra l'automazione come workflow operativo anziché come esercizio in un notebook.
Feature engineering e scoring
Spesso i valori grezzi non bastano. Di solito servono segnali derivati che mettano in evidenza trend, stagionalità e variazioni locali.
Tra le feature utili:
Feature di lag: valori precedenti che mostrano l'andamento recente della metrica.
Statistiche mobili: medie e deviazioni standard mobili che rendono visibile il comportamento locale.
Feature di frequenza: trasformazioni basate su Fourier quando la periodicità è rilevante.
Queste tecniche sono evidenziate nella sintesi di Decube sulle best practice per le serie temporali, che osserva anche come i sistemi di produzione valutino comunemente i risultati con precision, recall e F1.
Più avanti nella pipeline, non si produce semplicemente un «anomalia» o «non anomalia». Si produce un punteggio. Questo punteggio può derivare da un errore di previsione, da un errore di ricostruzione, da una distanza dal comportamento atteso o da una deviazione rispetto a una baseline statistica.
Ecco un'utile spiegazione dell'implementazione prima che i team inizino a configurare gli alert:
Rilevamento e post-processing
Il detector in sé è solo una fase. Il post-processing decide se il punteggio diventa un alert, un evento a bassa priorità o semplicemente un dato storico.
Quest'ultima fase di solito:
Filtra il rumore, così che variazioni isolate non allertino inutilmente le persone.
Raggruppa le anomalie correlate in un unico incidente invece di generare tempeste di alert.
Instrada gli incidenti in base a ownership, gravità e probabile causa principale.
Il rilevamento individua i comportamenti sospetti. Il post-processing stabilisce se il team può agire di conseguenza.
Questa distinzione è importante negli ambienti enterprise. Un detector matematicamente corretto può essere comunque inutile sul piano operativo se genera una valanga di alert senza alcuna logica di triage.
Come scegliere il metodo di rilevamento delle anomalie
Un metodo che sembra solido in un notebook può fallire rapidamente in una pipeline di produzione. Di solito il problema non è l'accuratezza pura del modello. È l'adeguatezza. Adeguatezza al segnale, al budget di latenza, al volume di metriche da valutare e al modo in cui gli incidenti vengono gestiti dopo il rilevamento.
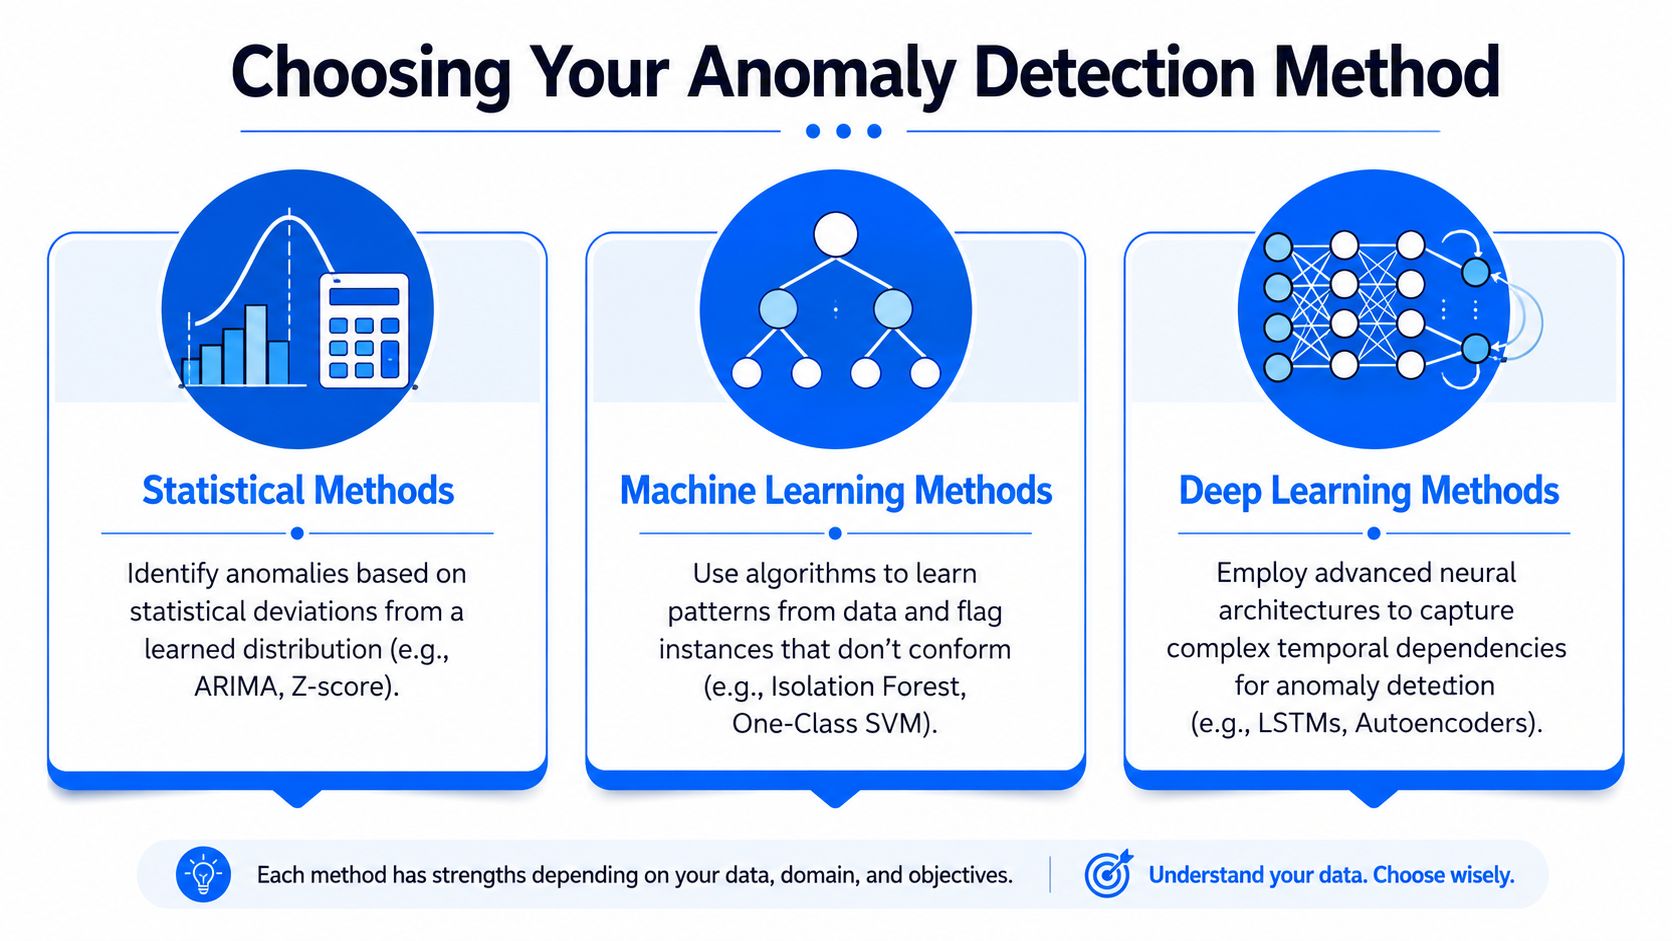
Per le serie temporali enterprise, di solito suddivido le opzioni in tre gruppi: metodi statistici, machine learning classico e deep learning. Questa impostazione è utile perché ogni gruppo comporta un costo operativo diverso. Alcuni sono facili da spiegare ed economici da eseguire su migliaia di flussi. Altri colgono comportamenti più sottili, ma richiedono una gestione più rigorosa delle feature, disciplina nel riaddestramento e un migliore monitoraggio del detector stesso.
Il confronto seguente aiuta a inquadrare questi compromessi:
Metodi statistici per segnali stabili
I metodi statistici restano la scelta predefinita giusta per molte metriche di pipeline. Profondità delle code, numero di righe, tassi di valori null, latenza delle API e durata dei job rispondono spesso bene a un approccio baseline più soglia, purché la metrica abbia un andamento stabile e il team sappia che cosa significa «normale».
Un'implementazione comune è una soglia basata sullo Z-score, con (x - avg) / stddev. La guida di Tinybird al rilevamento delle anomalie offre consigli pratici che si adattano bene all'uso in produzione: calcolare la baseline su una finestra di contesto pertinente, rimuovere gli outlier estremi prima di calcolare media e deviazione standard e valutare gruppi aggregati anziché singoli punti quando si vogliono meno falsi allarmi. Queste indicazioni contano perché baseline sbagliate creano più problemi operativi di una matematica sbagliata.
I metodi statistici sono adatti quando:
Il segnale è interpretabile. Gli ingegneri sanno spiegare la soglia e difenderla durante la revisione di un incidente.
La metrica ha un comportamento regolare. Trend e stagionalità esistono, ma non cambiano ogni settimana.
Serve scalabilità. Questi modelli sono abbastanza economici da essere eseguiti su grandi inventari di metriche senza costruire un'infrastruttura dedicata ai modelli.
Non reggono quando è il contesto a determinare l'anomalia. Un calo del 20 percento dei record può essere normale in una certa ora del giorno, grave per un tenant specifico e irrilevante durante un backfill pianificato.
Per gli andamenti ricorrenti, la decomposizione STL è spesso una scelta migliore di una semplice soglia. Separa trend, stagionalità e rumore residuo, quindi segnala i comportamenti insoliti dei residui. In pratica funziona bene per le metriche legate a cicli operativi giornalieri o settimanali, soprattutto quando i team hanno bisogno di un detector che si possa ispezionare durante l'analisi delle cause principali.
Machine learning classico quando le regole non scalano più
Man mano che le pipeline crescono, una semplice soglia per ogni metrica diventa costosa da mantenere. Iniziano a emergere interazioni tra le feature: i cali di volume contano solo se anche la freshness peggiora, i tassi di errore pesano di più per un sistema sorgente rispetto a un altro e il «normale» differisce nettamente per segmento di clientela o classe di carico di lavoro.
È qui che i modelli non supervisionati e semi-supervisionati sono utili.
La panoramica di MindBridge sulle tecniche di rilevamento delle anomalie indica Isolation Forest e Local Outlier Factor come scelte pratiche quando i dati etichettati sulle anomalie sono limitati. Ciò corrisponde a quanto funziona in molti contesti enterprise. Le etichette sono scarse, tardive o sepolte nelle note dei ticket, quindi i modelli che apprendono la struttura normale da dati per lo più puliti sono spesso l'unica opzione realistica.
Usateli in modo selettivo:
Situazione | Scelta più adatta |
|---|---|
Etichette scarse | Isolation Forest, LOF, One-Class SVM |
Comportamento normale ricco di feature | One-Class SVM |
Complessità moderata senza l'overhead del deep learning | Modelli non supervisionati con feature temporali ingegnerizzate |
Questi modelli possono cogliere andamenti che sfuggono a una soglia su una singola serie, ma non sono esenti da manutenzione. Dipendono dalla progettazione delle feature, dalla strategia di campionamento, dalla frequenza di riaddestramento e da una calibrazione sensata dei punteggi. Se nel set di feature manca il contesto relativo a ora del giorno, giorno della settimana, sistema sorgente o tenant, il modello segnalerà spesso variazioni attese e non coglierà gli incidenti che interessano agli operatori.
Per i team che vogliono una base più ampia su come la scelta del modello influisca su deployment e manutenzione, gli approfondimenti ML di Nexus IT Group sono un utile ripasso generale prima di concentrarsi sulle scelte progettuali specifiche per le anomalie.
Deep learning per i problemi di sequenza più difficili
Il deep learning inizia ad avere senso quando la serie contiene dipendenze a lungo raggio, molti input che interagiscono o comportamenti che cambiano in modi che le feature manuali non riescono a cogliere bene. Ciò accade con flotte di sensori, telemetria applicativa e flussi di eventi ad alto volume, dove l'anomalia dipende dalla forma della sequenza anziché da un singolo punto che supera una soglia.
Due opzioni comuni sono gli LSTM e gli autoencoder. Gli LSTM prevedono il comportamento atteso della sequenza e segnalano i grandi errori di previsione. Gli autoencoder imparano a ricostruire gli andamenti normali e considerano sospetto un errore di ricostruzione elevato.
Questi approcci possono rilevare modalità di guasto sottili, ma alzano l'asticella operativa:
Addestramento e tuning sono più impegnativi. Servono più risorse di calcolo, più esperimenti e un controllo di versione più rigoroso su dati e modelli.
L'inferenza costa di più. Un aspetto rilevante quando si valutano molti flussi a intervalli brevi.
L'analisi dei guasti diventa più difficile. Spiegare perché un modello è scattato è più complesso che mostrare un picco nei residui o il superamento di una soglia.
La deriva colpisce più in fretta. Se il sistema a monte cambia, il modello può degradarsi in modo impercettibile finché la qualità degli alert non cala.
Per molti team enterprise, la risposta migliore non è un unico detector. È un'architettura a livelli. Uno screening statistico economico garantisce un'ampia copertura, un modello classico valuta un contesto più ricco sui flussi più importanti e un modello di sequenza più profondo è riservato al piccolo insieme di segnali per i quali i metodi più semplici hanno già fallito.
Partite dal metodo più semplice di cui i vostri operatori si fideranno e che la vostra piattaforma può supportare. Aggiungete complessità solo quando porta a un rilevamento migliore degli incidenti, a meno alert inutili o a un isolamento più rapido delle cause principali.
Valutare le prestazioni ed etichettare le anomalie
Un detector che produce punteggi ogni minuto non è automaticamente utile. Potrebbe semplicemente generare rumore con grande sicurezza. Il problema si aggrava nel lavoro enterprise sui dati, perché le anomalie reali etichettate sono di solito scarse, incoerenti o sepolte nei ticket degli incidenti anziché in dati di addestramento strutturati.
La ricerca lo ha evidenziato in modo diretto. Il poster di NeurIPS 2024 sulla validazione dei punteggi di anomalia descrive una lacuna critica nella validazione dei punteggi di anomalia basati sulla distribuzione quando le anomalie etichettate sono scarse. Osserva inoltre che in queste condizioni dominano i metodi non supervisionati e semi-supervisionati, mentre i benchmark rigorosi rispetto a una ground truth sono in gran parte assenti.
Perché essere in produzione non dimostra l'accuratezza
I team danno spesso per scontato che un modello «funzioni» perché è online, integrato e ogni tanto intercetta qualcosa di reale. È un'asticella troppo bassa.
Bisogna porsi domande più impegnative:
Gli alert sono azionabili? Una deviazione tecnicamente valida può essere comunque irrilevante sul piano operativo.
Qual è l'andamento dei falsi positivi? Se il modello continua a segnalare normali variazioni stagionali, gli ingegneri lo silenzieranno.
Qual è l'andamento dei mancati rilevamenti? I guasti silenziosi contano più dei rilevamenti appariscenti.
La deriva dei punteggi riflette un rischio o solo un cambiamento della baseline? Senza questa distinzione, le soglie si degradano nel tempo.
Un utile quadro di valutazione è dato da precision, recall e F1. Ma i soli numeri non vi salveranno se le vostre etichette sono deboli.
Come i team costruiscono comunque la fiducia
In pratica, la fiducia nasce da un ciclo di feedback, non solo da una metrica.
I team più solidi adottano di solito una combinazione delle seguenti pratiche:
Addestramento semi-supervisionato: addestrare il modello su periodi noti come normali e considerare sospette le deviazioni da quella baseline appresa.
Code di revisione umana: permettere agli analisti di classificare gli alert come utili, rumorosi, attesi o legati a eventi a monte.
Correlazione degli incidenti: confrontare i timestamp delle anomalie con log di deployment, modifiche dello schema, interruzioni dei fornitori e ritardi dei batch.
Revisioni delle soglie: rivedere la logica delle soglie dopo cambiamenti stagionali importanti, lanci di prodotto o modifiche delle policy.
La parte difficile non è costruire un punteggio. È costruire la certezza che il punteggio corrisponda a qualcosa che valga la pena indagare.
Un basso errore di ricostruzione o una distribuzione ordinata dei punteggi di anomalia non dimostrano che il modello comprenda il vostro sistema. Dimostrano soltanto che il modello ha appreso un andamento.
Ecco perché l'etichettatura va trattata come un processo operativo. Ingegneri, analisti e responsabili di dominio hanno tutti bisogno di un modo per riportare gli esiti nel sistema.
Dal modello alla pipeline di produzione
Un modello in un notebook rileva le anomalie. Una pipeline di produzione deve spiegarle, instradarle e restare affidabile mentre il comportamento dei dati cambia.
È in questa fase che la maggior parte dei progetti si complica. La sfida passa dalla scelta degli algoritmi alla costruzione dell'apparato operativo che li circonda.
I requisiti operativi che contano
Il primo requisito è una baseline dinamica. Le soglie statiche non sopravvivono a cicli di business in evoluzione, a una domanda stagionale o a una crescita graduale. I sistemi basati sull'AI sono utili in questo caso perché stabiliscono una baseline dinamica del comportamento normale e valutano continuamente i nuovi dati rispetto a essa, invece di affidarsi a regole fisse, come illustrato nella spiegazione di Plixer sul rilevamento delle anomalie basato sull'AI.
Il secondo requisito è il monitoraggio della deriva. Il vostro modello può restare online pur diventando meno affidabile. Di solito ciò si manifesta con più alert rumorosi, più mancati rilevamenti inspiegabili o una maggiore dipendenza da interventi manuali.
Il terzo è l'integrazione degli alert. Il solo rilevamento non chiude gli incidenti. Il segnale deve arrivare dove gli operatori già lavorano, che si tratti di Slack, PagerDuty, sistemi di ticketing o runbook interni.
Una checklist pratica per la produzione è la seguente:
Governance delle baseline: decidete con quale frequenza si aggiornano le baseline e chi approva le modifiche importanti.
Ownership degli alert: ogni classe di anomalie ha bisogno di un team chiaro e di un percorso di escalation.
Contesto per le cause principali: allegate a ogni alert il contesto di lineage, freshness, schema e deployment.
Verificabilità: conservate lo storico dei rilevamenti, le modifiche ai modelli e gli esiti degli alert per le revisioni.
Strumenti e scelte di deployment
Alcuni team costruiscono da soli l'intero stack. Può funzionare quando l'ambiente è circoscritto e la superficie di observability è ridotta. Diventa costoso quando servono calcolo in-database, baseline su più segnali, analisi dei trend, monitoraggio della tempestività e un'interfaccia condivisa per ingegneri e stakeholder.
Un'opzione in questa categoria è il monitoraggio dei dati in tempo reale di digna, che combina rilevamento delle anomalie, monitoraggio della tempestività, validazione e tracciamento dello schema eseguendo le analisi all'interno dell'ambiente del cliente. Questa architettura è importante per le aziende che non possono spostare i dati di produzione in sistemi di monitoraggio esterni.
Il compromesso principale è semplice:
Approccio | Vantaggio | Vincolo |
|---|---|---|
Pipeline fai-da-te | Pieno controllo su logica e infrastruttura | Maggiore carico di engineering e manutenzione |
Approccio a piattaforma | Messa in operatività più rapida e workflow unificati | Minore controllo personalizzato in alcuni casi limite |
Se intendete fare sul serio con il rilevamento delle anomalie nelle serie temporali su larga scala, trattatelo come una capacità di observability, non come un artefatto di modellazione.
Il futuro della data observability proattiva
La direzione è chiara. I team dati si stanno allontanando da insiemi di regole fragili per passare a sistemi che apprendono il comportamento normale, si adattano ai cambiamenti dell'ambiente e supportano l'analisi delle cause principali invece di limitarsi a generare alert.
Questo non significa che i metodi statistici siano superati. Contano ancora, soprattutto quando servono velocità, chiarezza e un basso carico operativo. Né significa che ogni team abbia bisogno del deep learning. Molti non ne hanno bisogno. Ciò che conta è costruire un modello operativo completo attorno al rilevamento delle anomalie: buone baseline, scoring utile, alerting sensato e un ciclo di feedback che aumenti la fiducia nel tempo.
Il passo successivo per i team maturi è un'integrazione più stretta tra rilevamento e spiegazione. Non solo «questa metrica è anomala», ma «questa anomalia coincide con un caricamento a monte in ritardo, una modifica dello schema e un cambiamento nel modello di consegna». È qui che l'observability inizia a diventare diagnostica anziché reattiva.
Alcune idee daranno probabilmente forma alla prossima ondata:
Una migliore validazione dei punteggi: i team hanno bisogno di maggiore fiducia nei punteggi di anomalia quando gli eventi etichettati sono rari.
Modelli consapevoli dei cicli: i processi di business periodici non seguono sempre cicli perfettamente regolari, quindi il rilevamento deve gestire cadenze variabili.
Spiegabilità operativa: gli ingegneri hanno bisogno di alert che indichino le cause probabili, non solo una deviazione matematica.
Superfici di monitoraggio unificate: freshness, anomalie, validazione e modifiche dello schema funzionano meglio insieme che come strumenti isolati.
La conclusione pratica è semplice. Il rilevamento delle anomalie nelle serie temporali non è un esercizio una tantum di scelta del modello. È una disciplina continua per mantenere affidabili le pipeline nelle reali condizioni di produzione.
Se il vostro team vuole un rilevamento delle anomalie adatto alle data operations enterprise invece che confinato in un notebook, vale la pena valutare digna. Si concentra su rilevamento delle anomalie in-database, monitoraggio della tempestività, validazione e tracciamento dello schema, così che i team dati possano monitorare le pipeline e indagare sui problemi senza spostare i dati di produzione al di fuori del proprio ambiente controllato.
Domande frequenti
Quali sono i tipi di anomalie nelle serie temporali?
Le anomalie puntuali sono singole osservazioni molto al di fuori dell'intervallo previsto. Le anomalie contestuali sono normali in generale ma anomale per il momento in cui si presentano, come un volume tipico di un giorno feriale che compare di domenica. Le anomalie collettive sono sequenze insolite nel loro insieme, anche se ogni singolo punto sembra regolare.
Come si articola un workflow di rilevamento delle anomalie nelle serie temporali?
Preprocessing per gestire lacune, ricampionamento e stagionalità nota; feature engineering per mettere in evidenza il comportamento che vi interessa; scoring delle osservazioni rispetto a un modello del normale; infine post-processing per eliminare i duplicati e raggruppare gli alert correlati in un unico incidente.
Quale metodo usare per il rilevamento delle anomalie nelle serie temporali?
I metodi statistici funzionano bene per segnali stabili e ben compresi. Il machine learning classico gestisce relazioni multivariate e stagionalità irregolari. Il deep learning giustifica il suo costo solo con sequenze lunghe e complesse. Partite in modo semplice, perché un metodo che sapete spiegare è un metodo di cui vi fiderete davvero.
Come si gestisce la stagionalità nel rilevamento delle anomalie?
Modellandola in modo esplicito anziché appianarla. Gli andamenti giornalieri, settimanali e festivi sono comportamenti normali, e un detector che non li ha appresi segnalerà ogni lunedì mattina. Disporre di uno storico sufficiente a coprire un intero ciclo stagionale è di solito il requisito minimo.
Perché le anomalie nelle serie temporali sono importanti per le pipeline di dati?
Perché le pipeline raramente si guastano mostrando un grafico vuoto. Continuano a produrre numeri plausibili mentre un job perde record, una modifica dello schema sposta una metrica o un caricamento in ritardo arriva dopo l'aggiornamento. Il monitoraggio delle serie temporali coglie la forma di quel guasto.


