Profilazione dei dati: significato, tecniche, utilizzi e osservabilità
|
5
min di lettura

La profilazione dei dati (data profiling) consiste nell'esaminare, analizzare e riassumere i dati prima di utilizzarli, in genere attraverso quattro metodi operativi e generando statistiche come minimi, massimi, medie, deviazioni standard, frequenze e tassi di occorrenza dei null. In pratica, è la disciplina che vi dice se un dataset è strutturalmente solido, logicamente plausibile e adatto ad analytics, reportistica o IA.
Probabilmente siete qui perché qualche dataset vi ha già tradito. Un dashboard è cambiato senza preavviso. Un join ha smesso di trovare corrispondenze. Una tabella di feature per il ML sembrava a posto ieri e oggi appare sospetta. Nessuno ha toccato il layer di BI, eppure gli utenti di business chiedono perché il fatturato settimanale, il numero di lead o i volumi di servizio sembrano improvvisamente sbagliati.
È lì che inizia il vero significato della profilazione dei dati. Non è solo una definizione da glossario. È il processo di esaminare, analizzare e creare sintesi utili dei dati, affinché i team ne comprendano qualità, struttura e contenuto prima che vengano usati in un progetto. Nei progetti di un tempo, ciò significava spesso una scansione una tantum prima di caricare i dati in un warehouse. Nelle piattaforme moderne, quell'istantanea da sola non regge a lungo.
I guasti più dolorosi di solito non sono eclatanti. Sono silenziosi. Un team a monte cambia il tipo di un campo. Una sorgente inizia a inviare valori vuoti dove prima inviava dati. Una relazione di chiave esterna comincia a produrre record orfani. La pipeline continua a girare, la tabella si aggiorna e il grafico viene visualizzato. Ma la fiducia crolla immediatamente non appena gli utenti notano l'incoerenza.
Gli ingegneri trattano spesso la profilazione come un lavoro di configurazione. Gli analisti la vedono spesso come un report sulla qualità dei dati. Entrambe le visioni sono troppo ristrette. La profilazione è la prima ispezione fattuale di un dataset e, nei team maturi, diventa parte di un ciclo continuo di osservabilità che mantiene affidabili le pipeline dopo il rilascio, non solo prima.
Indice
Tecniche e metriche fondamentali della profilazione dei dati
Profilazione dei dati e concetti correlati di qualità dei dati
Introduzione: quando i dati buoni si guastano
Il dashboard settimanale delle vendite si aggiorna puntualmente. Nessuno riceve un errore. I grafici si caricano rapidamente. Poi qualcuno in finanza nota che una regione è crollata mentre un'altra è raddoppiata. Il team perde mezza giornata a controllare l'SQL, poi il job ETL, poi il modello di BI, prima di individuare la causa reale: una sorgente a monte ha cambiato il formato di un campo e ha involontariamente infranto un'ipotesi della trasformazione.
Incidenti di questo tipo sono il motivo per cui la profilazione dei dati è importante. Offre ai team una visione basata sulle evidenze di ciò che c'è nei dati, non di ciò che tutti presumono ci sia. Invece di aspettare che un report rotto riveli il problema, la profilazione fa emergere prima formati non corrispondenti, valori mancanti, duplicati e problemi di relazione.
Perché la fiducia si incrina così in fretta
La fiducia nei sistemi di dati è fragile perché gli utenti giudicano l'intera piattaforma in base all'ultimo numero strano che hanno visto. Un report sbagliato non genera solo un ticket. Rende ogni dashboard futuro un po' meno credibile.
Regola pratica: se una metrica di business sorprende le persone, esaminate i dati prima di esaminare la visualizzazione.
Negli ambienti di produzione, i dati raramente si guastano in modo netto. Le pipeline spesso continuano a girare mentre il significato dei dati cambia sotto di loro. Ecco perché la profilazione non dovrebbe restare in una checklist pre-lancio dimenticata. Va collocata vicino all'ingestione, alla trasformazione e al monitoraggio, dove gli ingegneri possono vedere i cambiamenti prima dei consumatori a valle.
Cosa previene la profilazione
Quando i team profilano presto e rivedono costantemente quei risultati, intercettano problemi come:
Deriva del formato: una colonna di date inizia ad arrivare con un pattern diverso.
Deriva semantica: un codice di stato sembra ancora sintatticamente valido, ma ora ha un significato di business diverso.
Rottura delle relazioni: i record vengono caricati nelle tabelle figlie senza chiavi padre corrispondenti.
Perdita di completezza: un campo prima popolato inizia ad arrivare vuoto.
La maggior parte delle emergenze inizia con uno di questi pattern. La profilazione non elimina ogni problema, ma offre al team una baseline fattuale e un percorso molto più rapido verso la causa radice.
Che cos'è davvero la profilazione dei dati
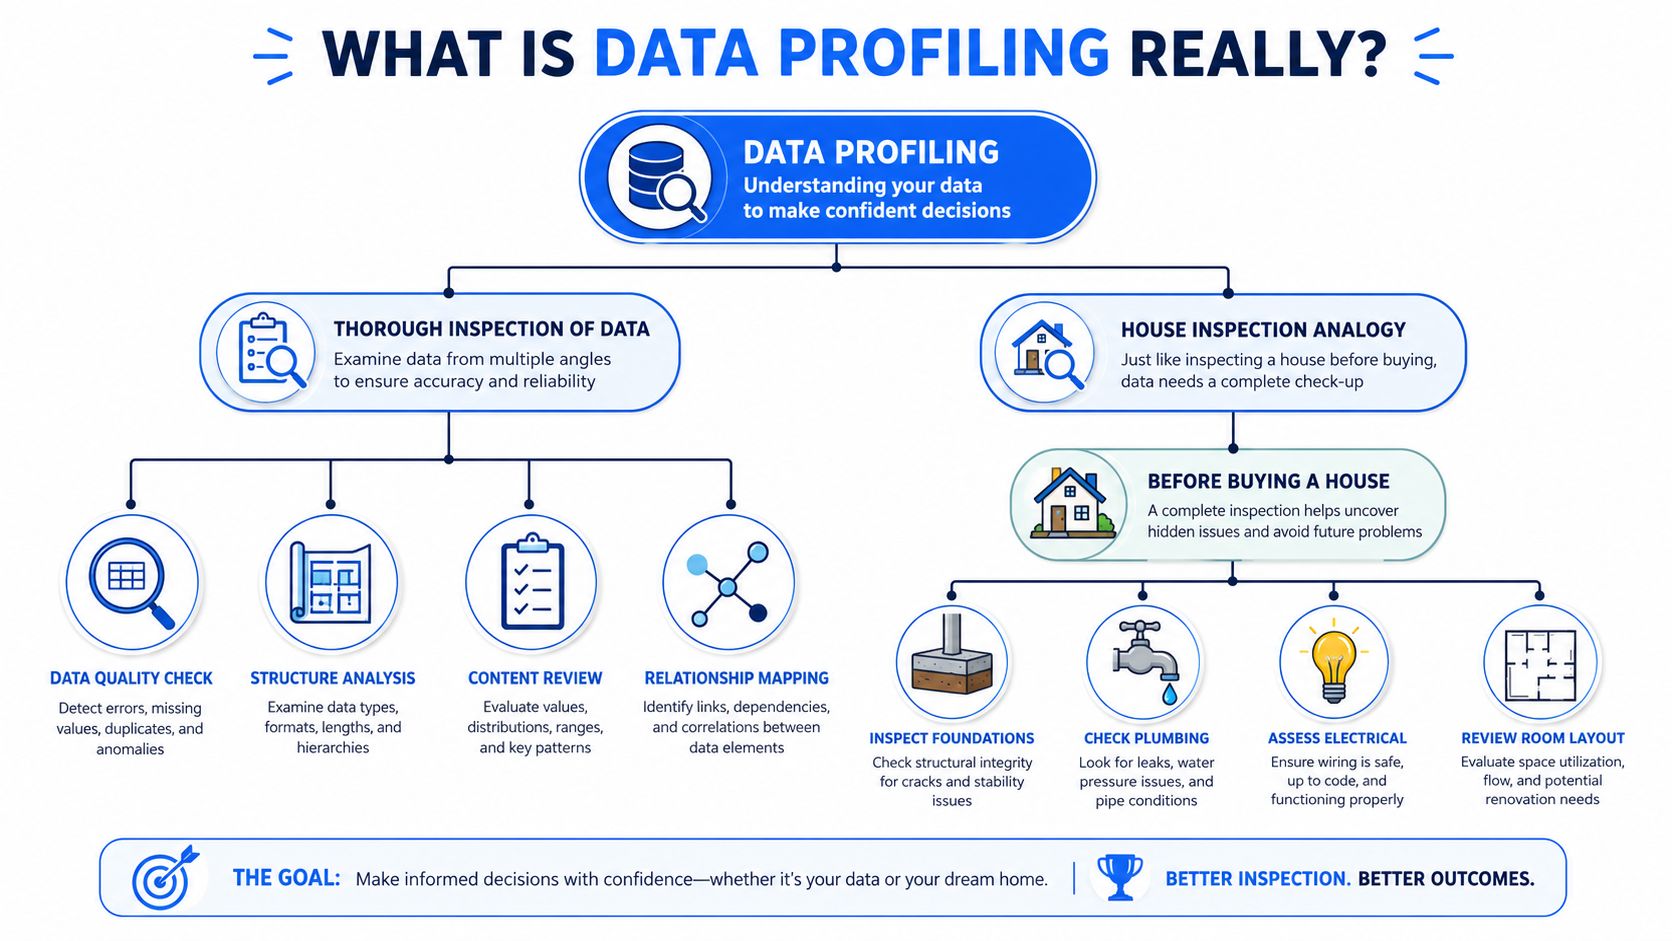
La profilazione dei dati si comprende meglio come un'ispezione approfondita dei dati prima di farvi affidamento. Se doveste comprare una casa, non vi fidereste solo delle foto dell'annuncio. Ispezionereste fondamenta, impianto idraulico, planimetria e impianto elettrico, perché ognuno vi dice qualcosa di diverso sulle condizioni dell'immobile. Con i dati funziona allo stesso modo.
Perché le ipotesi falliscono
Un dataset può sembrare utilizzabile dall'esterno ed essere comunque inaffidabile al suo interno. I nomi delle colonne possono sembrare familiari. Il numero di righe può apparire normale. Ma se i valori sono malformati, le chiavi non corrispondono o un campo contiene per lo più valori predefiniti, il dataset può comunque fuorviare ogni modello, report e decisione di business costruiti su di esso.
Ataccama lo dice chiaramente: la profilazione dei dati è il primo passo obbligatorio di qualsiasi iniziativa sui dati, perché ne valuta accuratezza, coerenza e tempestività prima che inizi l'elaborazione, e senza questa analisi i team non possono nemmeno verificare se i dati siano completi, corretti o pronti per analytics o IA, come spiegato nella panoramica di Ataccama sulla profilazione dei dati.
Ecco perché la profilazione sostituisce le ipotesi con i fatti. Ispeziona le condizioni reali dei dati prima del caricamento nel warehouse, della migrazione, del ciclo di addestramento del modello o del dashboard direzionale.
Se il vostro team sta ancora lavorando sulle pratiche di acquisizione a monte, è utile anche scoprire soluzioni di raccolta dei dati che migliorino la qualità della raccolta prima ancora che i record raggiungano la pipeline.
I tre tipi di discovery
Il significato della profilazione dei dati diventa più chiaro se lo si scompone nelle tre categorie di discovery usate dai professionisti.
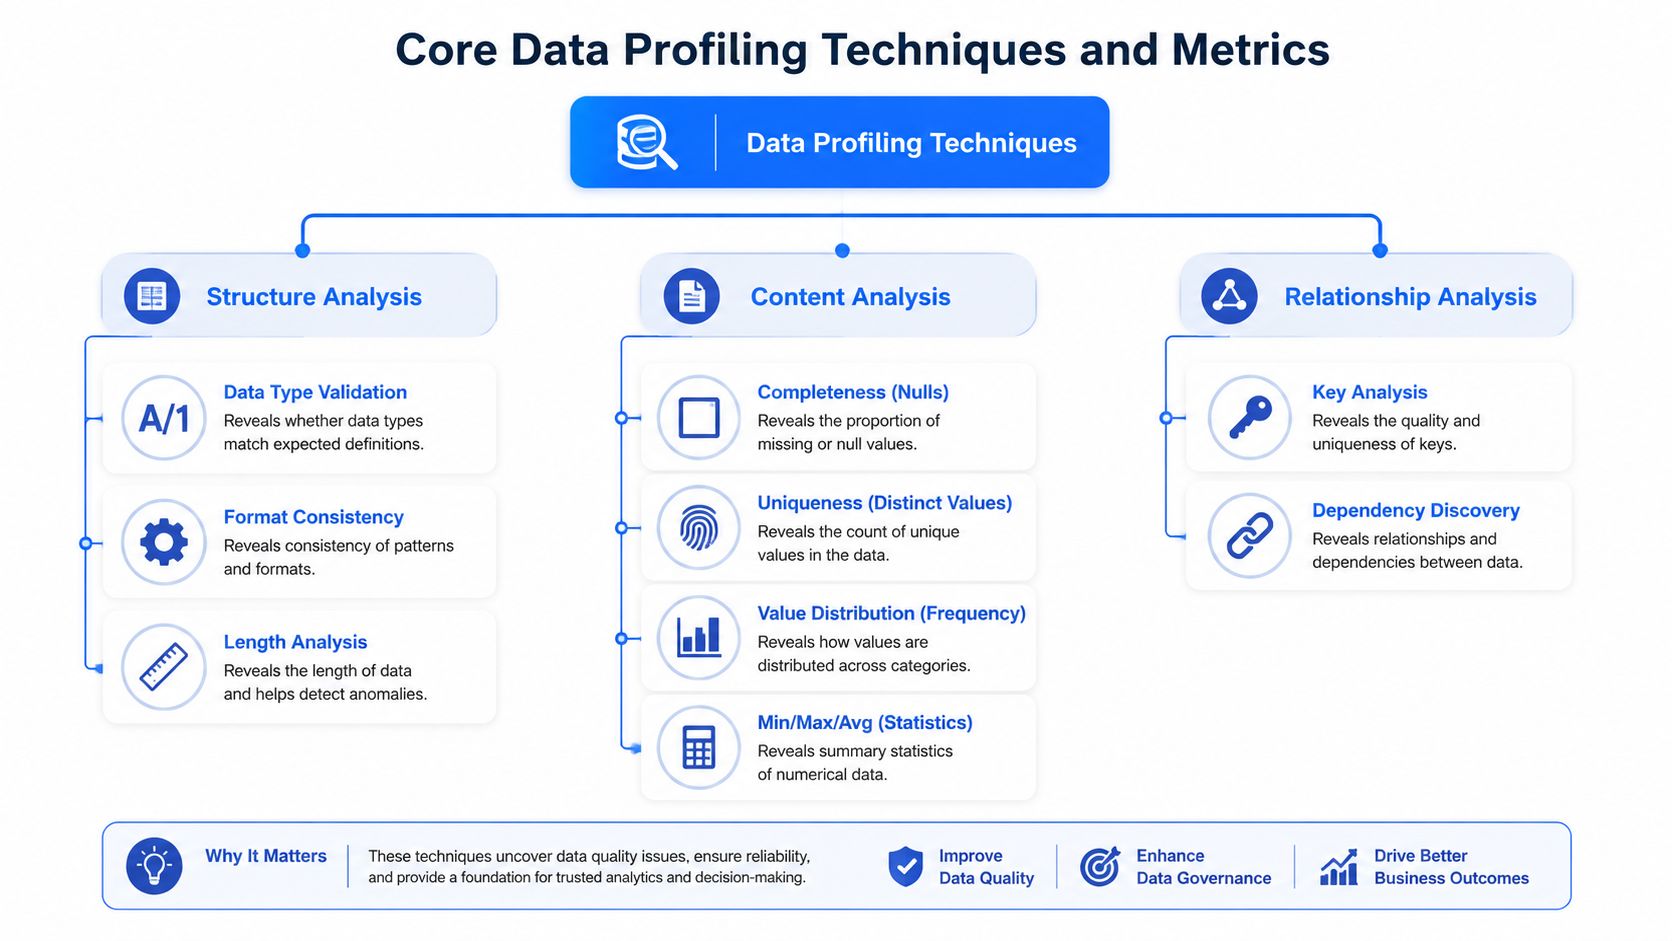
Structure discovery verifica se i dati hanno la forma che pensate. Comprende formattazione, tipi di dati, lunghezze e la disposizione generale dei campi.
Content discovery verifica se i valori stessi hanno senso. Un campo può essere presente e correttamente tipizzato, ma contenere comunque contenuti di business non validi.
Relationship discovery verifica come un dataset si collega a un altro. Aiuta a scoprire problemi di chiavi esterne, record senza corrispondenza e join rotti.
Una tabella pulita non è necessariamente una tabella affidabile. La fiducia nasce quando struttura, contenuto e relazioni sono allineati contemporaneamente.
Queste tre prospettive sono importanti perché la maggior parte dei problemi di produzione non resta isolata. Un cambio di formato crea spesso errori di contenuto. Un problema di contenuto si propaga spesso in rotture delle relazioni. La profilazione vi permette di vedere questi livelli prima che i consumatori ne subiscano l'impatto.
Tecniche e metriche fondamentali della profilazione dei dati
Se la definizione concettuale sembra astratta, le tecniche la rendono concreta. La profilazione diventa utile quando produce segnali che gli ingegneri possono interpretare e su cui possono agire.
Cosa fanno davvero i quattro metodi
Il lato operativo della profilazione si articola di solito in quattro metodi distinti: profilazione delle colonne, profilazione tra colonne, profilazione tra tabelle e validazione delle regole sui dati. Questi metodi generano statistiche descrittive come minimi, massimi, medie, deviazioni standard, frequenze e tassi di occorrenza dei null, che aiutano a rilevare anomalie strutturali, come riassunto in questa panoramica tecnica sulla profilazione dei dati.
Ecco come si traduce nella pratica:
La profilazione delle colonne offre un primo esame di un singolo campo. Si cercano null, tipi di dati non corrispondenti, valori minimi e massimi, pattern comuni e unicità.
La profilazione tra colonne verifica le dipendenze all'interno della stessa tabella. Due campi possono essere validi singolarmente ma contraddittori insieme.
La profilazione tra tabelle esamina l'integrità referenziale tra dataset. Identifica record orfani e join falliti.
La validazione delle regole sui dati applica condizioni esplicite. Inizia a sovrapporsi alla validazione formale, ma viene ancora usata spesso all'interno dei processi di profilazione per verificare se le ipotesi chiave reggono.
Come leggere le metriche di profilazione da ingegneri
I numeri in sé non sono il punto. Lo è la loro interpretazione.
Un valore minimo o massimo può rivelare date impossibili, valori negativi non validi o identificatori convertiti per errore. Un tasso di null vi parla della completezza, ma solo nel contesto. Alcune colonne possono tollerare valori vuoti. Altre no. Una distribuzione di frequenza rivela se un campo ha una variazione sana o se un unico valore predefinito sta inghiottendo il dataset.
Una deviazione standard è utile perché aiuta a stabilire come appare una dispersione normale. Quando quella dispersione cambia bruscamente, può indicare una modifica lato sorgente, un parsing errato o un cambiamento semantico nel modo in cui il campo viene popolato.
Anche la cardinalità conta, anche quando i team non la chiamano così. Se un presunto identificatore univoco contiene molti valori ripetuti, potreste non avere affatto un identificatore. Se un campo di categoria esplode improvvisamente in varianti inattese, le definizioni di business potrebbero essere andate alla deriva.
Per i team che formalizzano questi controlli, un passo successivo pratico è definire e monitorare le metriche di qualità dei dati, così che i risultati della profilazione non restino bloccati in notebook improvvisati o report una tantum.
Le metriche che di solito rivelano la prima crepa
Quando esamino un nuovo dataset, non tratto tutte le metriche allo stesso modo. Alcuni controlli fanno emergere con costanza il primo vero problema:
Metrica o controllo | Cosa rivela spesso |
|---|---|
Tasso di occorrenza dei null | Dati obbligatori mancanti, lacune nell'estrazione dalla sorgente |
Distribuzione di frequenza | Valori predefiniti, asimmetrie, categorie collassate |
Valori minimi e massimi | Date fuori intervallo, importi impossibili, errori di parsing |
Tipo di dato e lunghezza | Troncamenti, errori di conversione, formattazione incoerente |
Unicità | Chiavi duplicate, identificatori deboli |
Analisi delle chiavi tra tabelle | Record orfani, join rotti |
Partite dalle metriche che rompono più rapidamente la logica a valle. Completezza, unicità e integrità referenziale contano di solito più di eleganti statistiche di sintesi.
La profilazione diventa utile sul piano operativo quando i team collegano questi segnali ad azioni concrete. Un picco di null in un campo di commento può essere innocuo. Un picco di null nell'ID cliente no. I bravi ingegneri non si limitano a raccogliere l'output della profilazione. Decidono quali scostamenti meritano un intervento.
Casi d'uso comuni e insidie nascoste
La profilazione dimostra il suo valore quando i dati passano dalla teoria al lavoro di delivery. La costruzione di warehouse, le migrazioni, il feature engineering per l'IA e la reportistica operativa dipendono tutti dall'utilizzabilità dei dati sorgente.
SAS descrive la profilazione come un catalizzatore per decisioni sicure, perché fa emergere completezza e accuratezza su più sorgenti e aiuta a stabilire se un dataset è adatto a uno specifico obiettivo di progetto prima del deployment, come illustrato nelle indicazioni di SAS sulla profilazione dei dati negli ambienti big data.
Dove la profilazione ripaga
Alcuni casi d'uso traggono beneficio immediato dalla profilazione, ancora prima che sia in atto un framework di qualità avanzato.
Ingestione in data warehouse e data lake: la profilazione aiuta i team a capire cosa stanno caricando prima che ipotesi errate vengano codificate nella logica di trasformazione.
Migrazione dei dati: aiuta a confrontare le condizioni di origine e destinazione, così che i team possano individuare corruzioni, troncamenti, chiavi mancanti o distribuzioni cambiate.
Analytics e BI: riduce le probabilità che un dashboard diventi il primo luogo in cui qualcuno nota un problema di qualità.
Preparazione per IA e ML: fa emergere distribuzioni anomale, campi instabili e incoerenze nascoste che possono distorcere gli input dei modelli.
I dataset di lead e funnel sono un buon esempio. I team che progettano logiche di qualificazione o di instradamento si concentrano spesso prima sull'automazione del workflow, ma è la qualità dei campi in ingresso a determinare se l'automazione è affidabile. In questo contesto, gli approfondimenti di Formzz sull'automazione dei lead sono utili perché mostrano come la logica operativa dipenda da dati di input acquisiti in modo coerente.
Cosa sbagliano i team
La prima insidia è trattare i risultati della profilazione come se fossero una validazione completa. Non sempre lo sono. Una sintesi statistica può dirvi che un campo sembra insolito. Non sempre può dimostrare se ogni record soddisfa un obbligo di business.
La seconda insidia è affidarsi troppo al campionamento. Il campionamento è utile per la velocità e per individuare pattern generali, ma può nascondere guasti a bassa frequenza che contano comunque sul piano operativo o contrattuale.
La terza insidia è eseguire la profilazione una sola volta all'avvio del progetto e mai più. Funziona solo nei sistemi stabili, e la maggior parte dei sistemi non resta stabile a lungo.
È la deriva silenziosa a fare più male. La pipeline continua a girare, quindi nessuno controlla finché non lo fa un utente di business.
Un'ultima insidia è ignorare il contesto di business delle anomalie. Un picco, un outlier o un pattern di duplicati non è automaticamente un difetto. A volte i dati cambiano perché è cambiato il business. La profilazione vi fornisce il segnale. Ingegneri e analisti devono comunque interpretare se quel segnale indica un errore, un'evoluzione o entrambi.
Profilazione dei dati e concetti correlati di qualità dei dati
Molta confusione nei team dati nasce dall'usare profilazione, validazione, rilevamento delle anomalie e tracciamento dello schema come se fossero la stessa cosa. Non lo sono. Lavorano insieme, ma ognuno risponde a una domanda diversa.
Un confronto pratico
Bigeye osserva che molte definizioni si fermano alla profilazione come strumento per produrre descrizioni di base, mentre le piattaforme moderne aggiungono la validazione a livello di record per applicare la logica di business definita dagli utenti. È una capacità diversa dalla profilazione statistica tradizionale, che identifica pattern generali come duplicati o outlier, come discusso nella spiegazione di Bigeye su profilazione e validazione.
Concetto | Obiettivo principale | Metodo | Esempio di domanda a cui risponde |
|---|---|---|---|
Profilazione dei dati | Comprendere struttura, contenuto e pattern generali di qualità | Sintesi statistiche, controlli dei pattern, analisi delle chiavi | Quali valori esistono in questa colonna, quanto spesso sono null e sembrano strutturalmente plausibili? |
Validazione dei dati | Applicare regole di business ai record | Controlli deterministici delle regole su ogni riga o evento | Ogni record d'ordine contiene un ID cliente valido e lo stato richiesto? |
Rilevamento delle anomalie | Segnalare cambiamenti inattesi rispetto a una baseline | Confronto automatizzato con il comportamento storico | Il tasso di null, il volume o la distribuzione di oggi sono usciti dal comportamento normale? |
Tracciamento dello schema | Rilevare cambiamenti strutturali | Monitoraggio delle modifiche a colonne, tipi e layout | Una sorgente ha aggiunto, rimosso o modificato un campo che potrebbe rompere le pipeline? |
Questa distinzione è molto importante negli ambienti regolamentati. Se un team confonde la profilazione statistica con la validazione deterministica, potrebbe pensare che una panoramica basata su campioni basti per processi sensibili agli audit, quando non è così.
Perché la distinzione è importante
La profilazione risponde a “Che aspetto hanno questi dati?”. La validazione risponde a “Ogni record soddisfa la regola?”. Il rilevamento delle anomalie risponde a “Oggi c'è stato un cambiamento sospetto?”. Il tracciamento dello schema risponde a “È cambiata la struttura stessa?”.
Sembrano domande vicine, ma supportano modelli operativi diversi.
La profilazione è investigativa.
La validazione è vincolante.
Il rilevamento delle anomalie è adattivo.
Il tracciamento dello schema è una difesa strutturale.
I team devono anche considerare privacy e governance. Quando la profilazione tocca dati personali, valgono comunque le aspettative di conservazione e minimizzazione. Per i team di governance che esaminano questo aspetto, i consigli sulla conformità al GDPR del Regno Unito aiutano a capire perché la minimizzazione dei dati dovrebbe influenzare quanti dati vengono scansionati, conservati ed esposti nei processi di qualità.
La conclusione pratica è semplice. Non chiedete a un solo strumento o a un solo report di fare ogni lavoro. Usate la profilazione per conoscere i dati, la validazione per applicare le regole, il rilevamento delle anomalie per intercettare i cambiamenti e il tracciamento dello schema per proteggere il contratto tra producer e consumatori.
Dall'analisi statica all'osservabilità continua
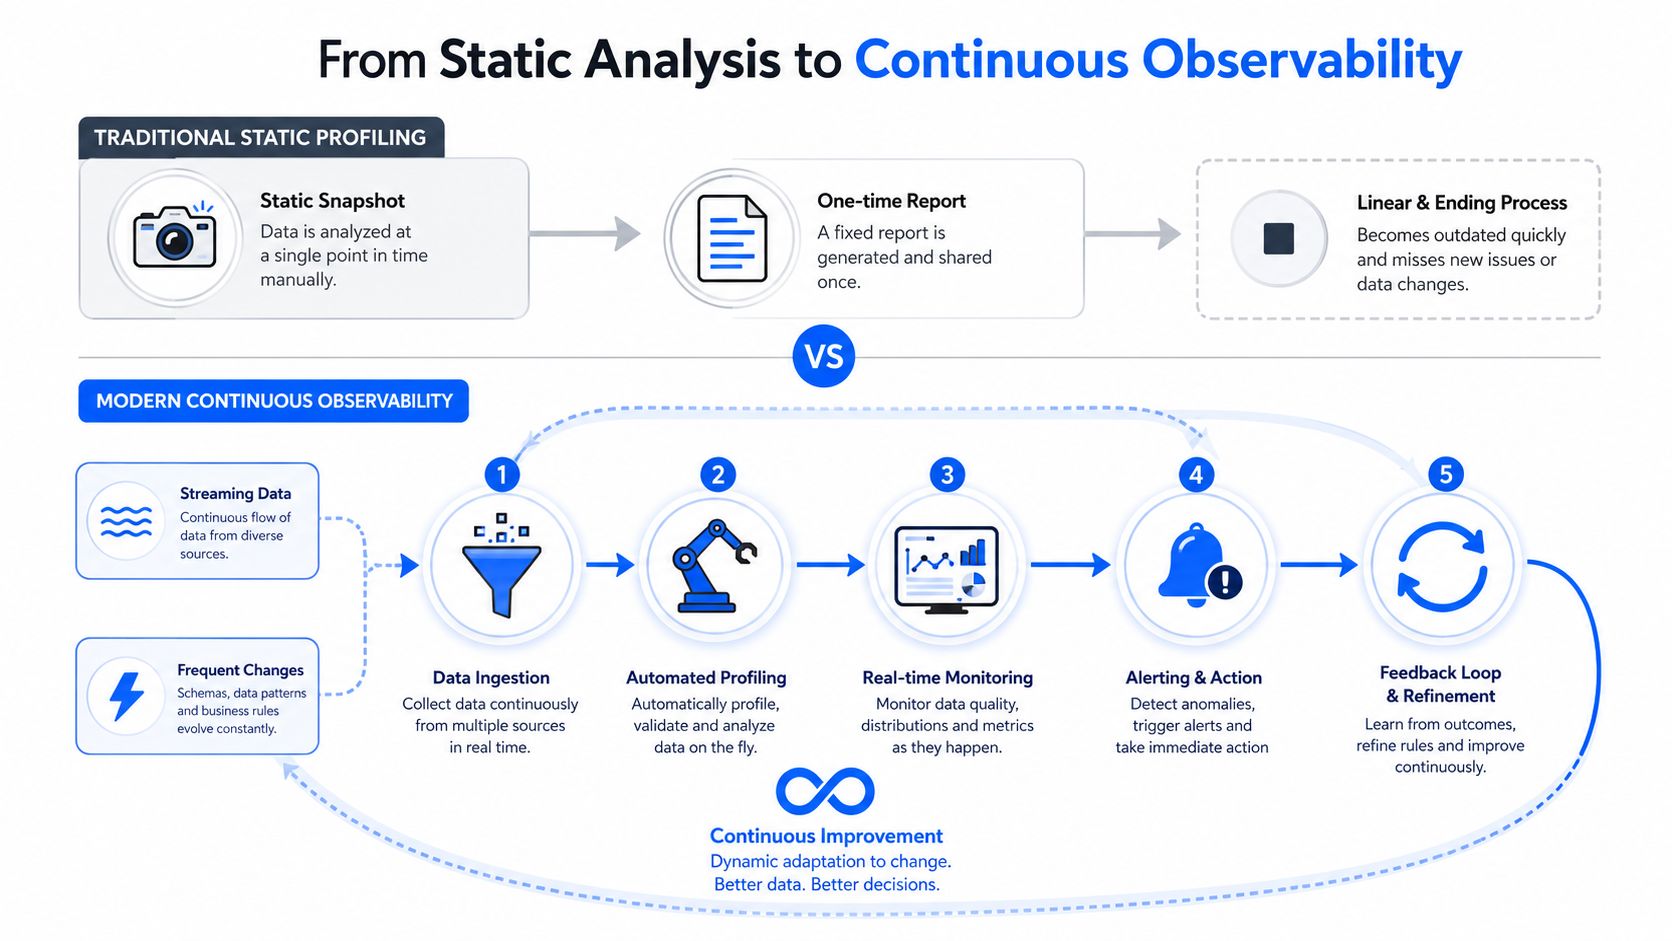
Il vecchio modello trattava la profilazione come una fase di progetto. Si ispezionavano i dati prima di farvi affidamento, si documentavano i risultati, si correggevano i problemi evidenti e si andava avanti. Aveva senso quando i sistemi sorgente cambiavano lentamente e le pipeline batch erano relativamente prevedibili.
Perché la profilazione una tantum non regge
Quel modello non regge nelle pipeline moderne. TDWI fa notare che la maggior parte dei contenuti presenta ancora la profilazione come una fase diagnostica statica precedente all'uso, lasciando una lacuna nello spiegare come i team dovrebbero passare a un ciclo di osservabilità continuo e automatizzato che rilevi deriva e modifiche di schema in tempo reale; questa lacuna lascia gli ingegneri senza un framework per intercettare la deriva silenziosa dei dati, come descritto nella discussione di TDWI sulla profilazione dei dati moderna.
Il problema non è che la profilazione statica sia sbagliata. È che scade. In fretta.
Un profilo vi dice com'erano i dati al momento dell'ispezione. Non garantisce che le stesse ipotesi reggano ancora dopo un rilascio della sorgente, un aggiornamento del parser, una modifica al feed di un fornitore o un nuovo workflow operativo.
Come si presenta la profilazione continua
Un modello operativo moderno tratta la profilazione come parte della Data Observability anziché come un report una tantum. Ciò significa che il team misura continuamente le caratteristiche chiave dei dati e confronta il nuovo comportamento con una baseline appresa.
Nella pratica, la profilazione continua comprende di solito:
Calcolo automatizzato delle metriche: null, unicità, distribuzioni e integrità delle chiavi vengono ricalcolati in modo continuo.
Consapevolezza delle modifiche di schema: aggiunte, rimozioni e cambi di tipo delle colonne vengono monitorati come rischi di produzione.
Controlli di tempestività: freschezza e pattern di arrivo vengono sorvegliati, perché i dati in ritardo possono essere dannosi quanto i dati errati.
Alert legati all'azione: gli ingegneri hanno bisogno di segnali che dicano cosa è cambiato, dove e con quale gravità.
Per i team che costruiscono questo modello operativo, è utile capire che cos'è la Data Observability e come estende i classici controlli di qualità al monitoraggio continuo.
Un report di profilazione è un'istantanea. L'osservabilità è la telecamera che resta accesa.
Questo cambiamento modifica il comportamento dei team. Invece di aspettare che un analista metta in dubbio un dashboard, gli ingegneri ricevono una notifica quando una baseline si rompe. Invece di discutere se una sorgente “sembra a posto”, possono confrontare il comportamento attuale con pattern storici consolidati. È una base molto migliore per analytics e IA affidabili.
Come digna abilita la profilazione dei dati enterprise
La profilazione enterprise moderna richiede più di una schermata di statistiche statiche. Richiede misurazione continua, consapevolezza strutturale e applicazione delle regole senza costringere i team a spostare dati di produzione sensibili in un ulteriore strumento.
digna si adatta a questo modello combinando il calcolo delle metriche nel database con moduli che affrontano diversi livelli del problema. Le sue capacità di rilevamento delle anomalie apprendono il comportamento normale e segnalano i cambiamenti inattesi. Le sue funzionalità di validazione gestiscono le regole di business a livello di record. Il suo tracciamento dello schema intercetta colonne aggiunte o rimosse e modifiche di tipo. Il suo monitoraggio della tempestività sorveglia i pattern di arrivo dei dati, così che caricamenti obsoleti o in ritardo non passino inosservati.
Questa combinazione è importante perché i team enterprise raramente si scontrano con un solo tipo di guasto. Una tabella di warehouse può essere aggiornata ma strutturalmente modificata. Uno schema può restare stabile mentre i valori vanno alla deriva. Un dataset può sembrare statisticamente normale pur violando una regola di business a livello di record.
Il valore pratico di una piattaforma come questa è la chiarezza operativa. Ingegneri, analisti e stakeholder della governance possono esaminare tendenze, anomalie, tempestività e modifiche di schema in un unico posto, mantenendo i dati in ambienti controllati dal cliente, come deployment in cloud privato o on-premise.
Se il vostro team vuole passare dall'ispezione una tantum alla fiducia continua, vale la pena valutare digna come parte di questa architettura. Offre ai team dati un modo per combinare profilazione, rilevamento delle anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema all'interno dell'ambiente del cliente, il che spesso fa la differenza tra individuare i problemi in anticipo e scoprirli in un dashboard rotto.
Per mantenere visibili le statistiche di profilazione, come tassi di null e distribuzioni, sotto forma di tendenze nel tempo anziché come istantanea una tantum, scoprite digna Data Analytics.
Domande frequenti
Che cosa significa profilazione dei dati?
Profilazione dei dati significa esaminare, analizzare e riassumere i dati prima di utilizzarli, producendo statistiche come minimi, massimi, medie, deviazioni standard, frequenze e tassi di occorrenza dei null. Vi dice se un dataset è strutturalmente solido, logicamente plausibile e adatto ad analytics, reportistica o IA, sostituendo le ipotesi con i fatti.
Quali sono i quattro metodi di profilazione dei dati?
I quattro metodi operativi sono la profilazione delle colonne, la profilazione tra colonne, la profilazione tra tabelle e la validazione delle regole sui dati. La profilazione delle colonne verifica un singolo campo per null, tipi e intervalli; quella tra colonne individua campi contraddittori in una tabella; quella tra tabelle fa emergere record orfani e join rotti; la validazione delle regole verifica condizioni esplicite.
Cosa sono structure, content e relationship discovery?
Sono le tre categorie di discovery che i professionisti usano per scomporre la profilazione. La structure discovery verifica formati, tipi di dati e lunghezze; la content discovery verifica se i valori hanno senso per il business; la relationship discovery verifica come si collegano i dataset, scoprendo problemi di chiavi esterne e record senza corrispondenza. La fiducia richiede che tutte e tre siano allineate.
Qual è la differenza tra profilazione dei dati e validazione dei dati?
La profilazione è investigativa: descrive l'aspetto dei dati tramite sintesi statistiche e controlli dei pattern. La validazione è vincolante: applica regole deterministiche a ogni record, ad esempio che ogni ordine abbia un ID cliente valido. Nei processi sensibili agli audit, un profilo basato su campioni non sostituisce la validazione a livello di record.
Perché la profilazione dei dati una tantum non basta?
Un profilo descrive i dati solo al momento dell'ispezione e scade rapidamente dopo un rilascio della sorgente, un aggiornamento del parser o una modifica al feed di un fornitore. La profilazione continua ricalcola in modo costante null, unicità, distribuzioni e integrità delle chiavi e aggiunge consapevolezza delle modifiche di schema e controlli di tempestività, trasformando un'istantanea in osservabilità.


