Pipeline di data science robuste: costruzione, deployment, monitoraggio
|
6
min di lettura

Probabilmente in questo momento vi trovate in una di due situazioni. O un modello in produzione ha iniziato a comportarsi in modo strano e nessuno riesce a capire se il problema sia nella logica delle feature, nei dati sorgente o in un caricamento a monte arrivato in ritardo. Oppure il vostro team ha una pipeline che "funziona" quasi tutti i giorni, ma ogni rilascio sembra rischioso perché una modifica dello schema, una partizione mancante o un file malformato possono contaminare i risultati a valle.
È questo il volto delle pipeline di data science in produzione. La parte difficile di solito non è addestrare un modello. È mantenere affidabile il flusso dei dati lungo ingestion, trasformazione, creazione delle feature, deployment e monitoraggio continuo. I team che si concentrano solo sull'orchestrazione lo imparano a proprie spese. Un DAG verde non garantisce dati validi e l'esecuzione riuscita di un job non garantisce input utili per il modello.
Indice
Perché le pipeline di data science sono la spina dorsale dell'AI moderna
Molti fallimenti dell'AI non nascono da una cattiva modellazione. Nascono da una pipeline che ha fornito feature incomplete, record duplicati, aggregati obsoleti o dati di training etichettati in modo errato. La colpa ricade sul modello perché è visibile. La pipeline sfugge all'esame perché è sepolta sotto scheduler, script, connettori e job del data warehouse.
Per questo considero le pipeline di data science un'infrastruttura, non un collante di progetto. Alimentano esperimenti, job di training, scoring batch, feature per l'inferenza online, dashboard e cicli di riaddestramento. Quando derivano, ogni consumatore a valle ne eredita i danni.
Il segnale per il business è chiaro. Il mercato globale delle data pipeline è valutato 10,01 miliardi di USD nel 2024 e si prevede che raggiunga 43,61 miliardi di USD entro il 2032, con un CAGR del 19,9%, e il 90% dei progetti di AI e machine learning dipende direttamente da queste pipeline, secondo Fortune Business Insights sul mercato delle data pipeline. I team non investono nell'infrastruttura delle pipeline perché è di moda. Lo fanno perché i sistemi di AI non sopravvivono a fondamenta di dati fragili.
Cosa si rompe negli ambienti reali
I guasti evidenti sono facili da individuare. Un task si blocca. Un file non arriva mai. Un connettore va in timeout.
I guasti pericolosi sono più silenziosi:
Deriva della freschezza, quando i dati giornalieri iniziano ad arrivare sempre più tardi
Deriva semantica, quando un campo esiste ancora ma il suo significato è cambiato a monte
Deriva della distribuzione, quando i valori rispettano i vincoli di tipo ma si allontanano dal comportamento normale
Successo parziale, quando una pipeline scrive l'output, ma solo per una parte del perimetro previsto
Regola pratica: se l'unico segnale di salute è il successo dei job, non state monitorando la pipeline. State monitorando lo scheduler.
Le pipeline di data science affidabili devono rispondere ogni giorno a due domande. I job sono stati eseguiti? E hanno prodotto dati ancora adatti al training, allo scoring e alle decisioni?
Il concetto di pipeline di data science
Il modello mentale più chiaro è una catena di montaggio. Le materie prime arrivano da fornitori diversi. Ogni postazione pulisce, rimodella, controlla, arricchisce o assembla qualcosa. Alla fine non si vuole un mucchio di componenti. Si vuole un prodotto finito di cui potersi fidare.
Una pipeline di data science funziona allo stesso modo. Prende dati grezzi da applicazioni, log, file, API, flussi di eventi e tabelle del data warehouse. Poi li trasforma in set di training, feature, previsioni e output monitorati che altri sistemi possono utilizzare.
Più di un ETL
Un job ETL di base sposta e trasforma i dati. È importante, ma è solo una parte del quadro. Le pipeline di data science di solito aggiungono passaggi che le pipeline di analytics standard non coprono del tutto:
Creazione delle feature per input pronti per il modello
Generazione dei dataset di training e validazione
Riproducibilità degli esperimenti
Packaging e deployment dei modelli
Cicli di feedback successivi al deployment
Questa differenza conta a livello operativo. Un report BI rotto è un problema. Una pipeline di input del modello rotta può compromettere ranking, controlli antifrode, previsioni, triage o flussi di revisione clinica, a seconda del dominio.
Script e pipeline di produzione a confronto
I progetti di data science iniziano spesso con un notebook o uno script Python. È normale. Ed è anche lì che iniziano molti problemi di affidabilità.
Uno script occasionale può andare bene per l'esplorazione. È un pessimo sistema di produzione perché spesso dipende da presupposti locali:
Scenario | Cosa succede |
|---|---|
Flusso di lavoro su notebook | Percorsi, credenziali, versioni dei pacchetti e scelte di campionamento vivono nell'ambiente di una sola persona |
Pipeline di produzione | Input, output, dipendenze, retry, test, lineage e ownership sono espliciti |
Le pipeline di data science di livello production richiedono ripetibilità. Se domani arriva lo stesso input, il sistema dovrebbe eseguire la stessa logica con modifiche controllate, dipendenze note e output osservabili. Di solito questo significa strumenti come Airflow, Dagster, Prefect, Spark, dbt, SQL nativo del data warehouse, pipeline CI e infrastruttura di model serving che lavorano insieme, anziché un unico stack tutto-in-uno.
Una pipeline non è matura perché è automatizzata. È matura quando un altro ingegnere può modificarla in sicurezza e capire se l'output è ancora affidabile.
È questo lo standard a cui puntare.
Le sette fasi fondamentali di una pipeline di data science
La maggior parte dei sistemi di produzione appare disordinata nei dettagli, ma il ciclo di vita è coerente. Se i team condividono un vocabolario comune per le fasi, il debugging diventa più semplice e l'ownership più chiara.
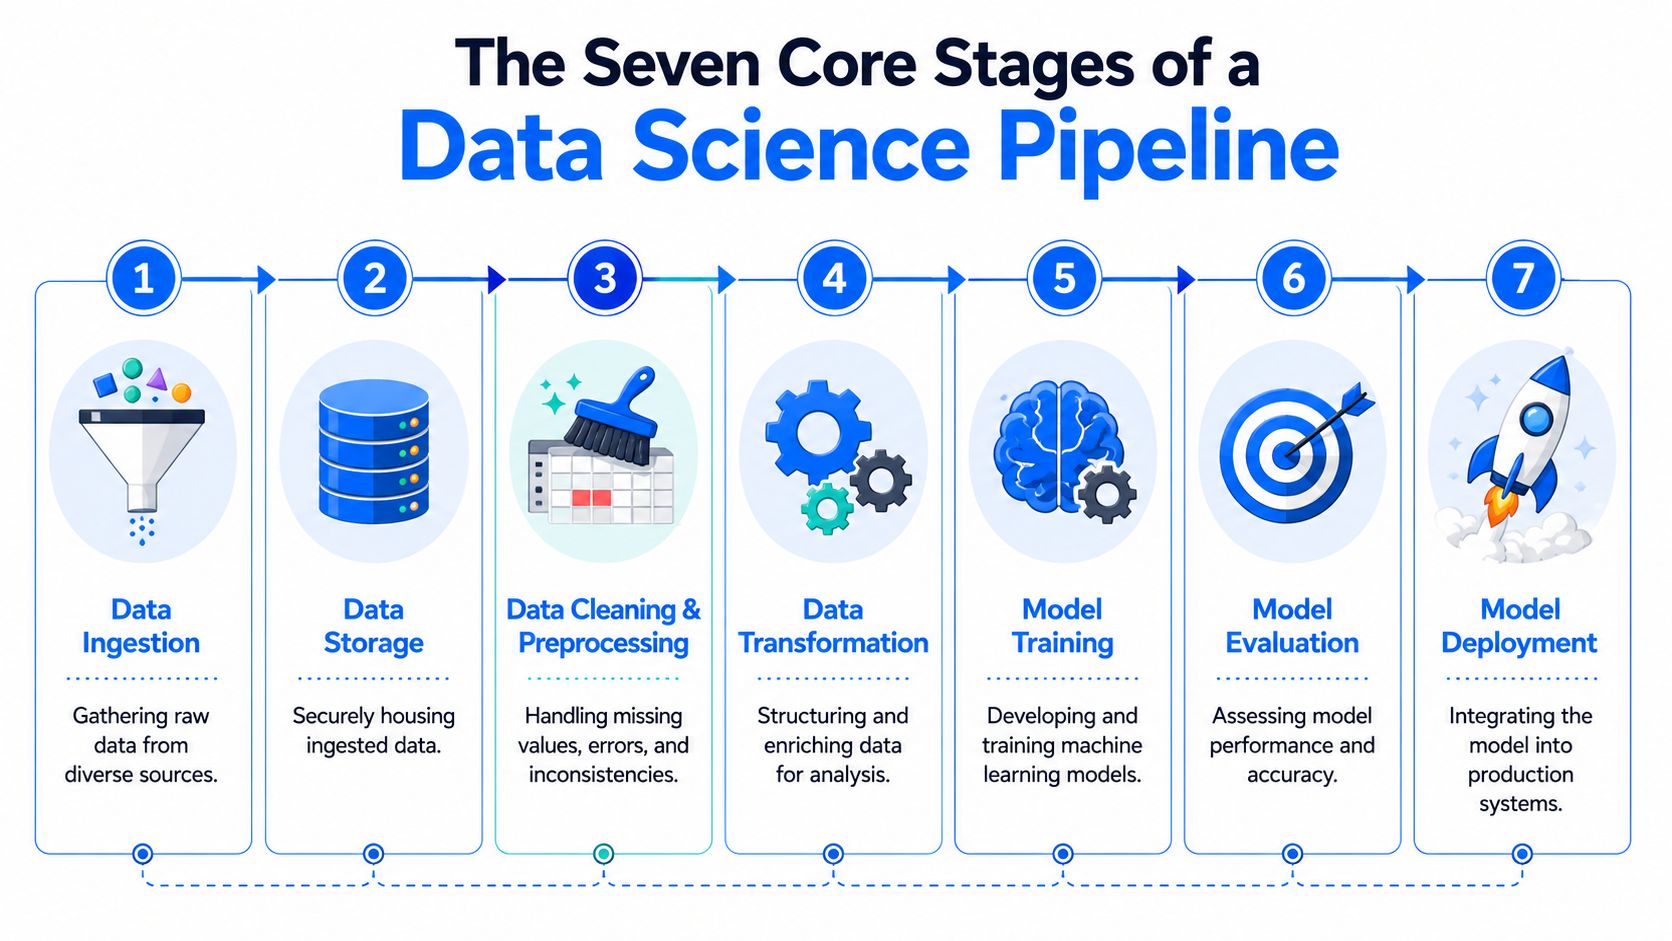
Ingestion dei dati
La pipeline si scontra con la realtà quando arrivano i dati. I dati provengono da database OLTP, strumenti SaaS, flussi CDC, object storage, log applicativi e API. Alcune sorgenti sono strutturate e stabili. Altre no.
La decisione principale qui è tra batch, streaming o entrambi. Il batch è più semplice da comprendere e più facile da recuperare con un backfill. Lo streaming supporta casi d'uso a bassa latenza, ma alza l'asticella per ordinamento, deduplicazione, eventi in ritardo e gestione dei checkpoint.
Tra gli strumenti più comuni ci sono Kafka, Pub/Sub, Kinesis, Airbyte, Fivetran, connettori personalizzati e job di ingestion diretta nel data warehouse.
Archiviazione e integrazione dei dati
Una volta arrivati, i dati hanno bisogno di una collocazione duratura e di una forma su cui i consumatori a valle possano contare. I team scelgono quindi tra ETL ed ELT, definiscono i livelli raw e curati e decidono quanta trasformazione spetti ai job Spark rispetto ai modelli SQL.
Questa fase di solito produce:
Zone di atterraggio raw per replay e audit
Dataset conformati per l'uso condiviso
Input di feature integrati tra domini come clienti, prodotti, sinistri o dati dei dispositivi
Un buon livello di integrazione conserva abbastanza dettagli raw per la rielaborazione, offrendo al contempo interfacce stabili agli utenti a valle.
Prima di approfondire le fasi successive, è utile fissare un controllo pratico. Solide pratiche di validazione dei dati per le pipeline di produzione impediscono che difetti evidenti viaggino a valle senza controlli.
Elaborazione dei dati e feature engineering
Molte pipeline diventano specifiche del dominio man mano che i team gestiscono valori mancanti, codificano categorie, costruiscono feature ritardate, aggregano eventi in finestre temporali, calcolano rapporti e uniscono dati comportamentali con dati di riferimento.
La logica delle feature nasce spesso nei notebook e poi si consolida in trasformazioni SQL, Spark o Python. La modalità di guasto è prevedibile: la logica viene copiata tra i percorsi di training e di inferenza, poi diverge. Anche la soluzione è prevedibile: centralizzare le definizioni delle feature e versionarle.
Alcuni pattern reggono bene:
Separare la pulizia dei dati raw dalla logica di business
Tenere le definizioni delle feature vicine ai test
Progettare trasformazioni idempotenti
Registrare la versione dei dati usata per ogni esecuzione di training
Ecco la panoramica integrata dell'intero ciclo di vita:
Addestramento e tuning del modello
Il training utilizza i dataset elaborati e li trasforma in modelli candidati. I meccanismi variano a seconda dello stack. Alcuni team usano scikit-learn su estrazioni dal data warehouse. Altri usano Spark ML, XGBoost, PyTorch, TensorFlow o piattaforme ML gestite.
La preoccupazione operativa non è solo il tuning degli iperparametri. È la riproducibilità. Se il mese prossimo un modello rende meno del previsto, bisogna sapere quale versione del codice, quale set di feature, quale porzione di training e quali parametri lo hanno prodotto.
Validazione e selezione del modello
Questa fase decide cosa merita di andare avanti. I team confrontano i modelli candidati con dati di holdout, vincoli di business, requisiti di spiegabilità e limiti operativi come la latenza di inferenza o l'uso della memoria.
La validazione dovrebbe includere più delle sole metriche del modello. Dovrebbe anche chiedersi se i dati sottostanti rappresentino ancora il processo target. Un modello con un punteggio elevato, addestrato su input instabili, può comunque fallire in produzione.
Il miglior modello candidato è quello che la vostra piattaforma può supportare in sicurezza, non solo quello con il miglior punteggio offline.
Deployment del modello
Il deployment trasforma un artefatto in un servizio o in un processo di scoring pianificato. I pattern più comuni includono lo scoring batch in una tabella del data warehouse, l'inferenza in tempo reale dietro un'API e configurazioni ibride in cui un servizio in tempo reale richiama feature precalcolate.
Questa fase richiede contratti espliciti:
Aspetto del deployment | Cosa definire |
|---|---|
Input | Campi obbligatori, tipi, gestione dei null e aspettative di freschezza |
Output | Schema delle previsioni, campi di confidenza e destinazione di scrittura |
Rollback | Versione precedente del modello, condizioni di attivazione e percorso di ripristino |
Monitoraggio e riaddestramento
La pipeline non finisce con il deployment. Il monitoraggio in produzione deve coprire la salute del serving, la freschezza delle feature, la stabilità dello schema, la qualità dei dati e i trigger di riaddestramento.
Il riaddestramento dovrebbe avvenire per un motivo, non perché lo dice un cron job. Nei sistemi maturi, le decisioni di riaddestramento sono legate alla deriva osservata, al cambiamento del contesto di business o al feedback sulle prestazioni del modello. Altrimenti i team si limitano ad automatizzare il caos.
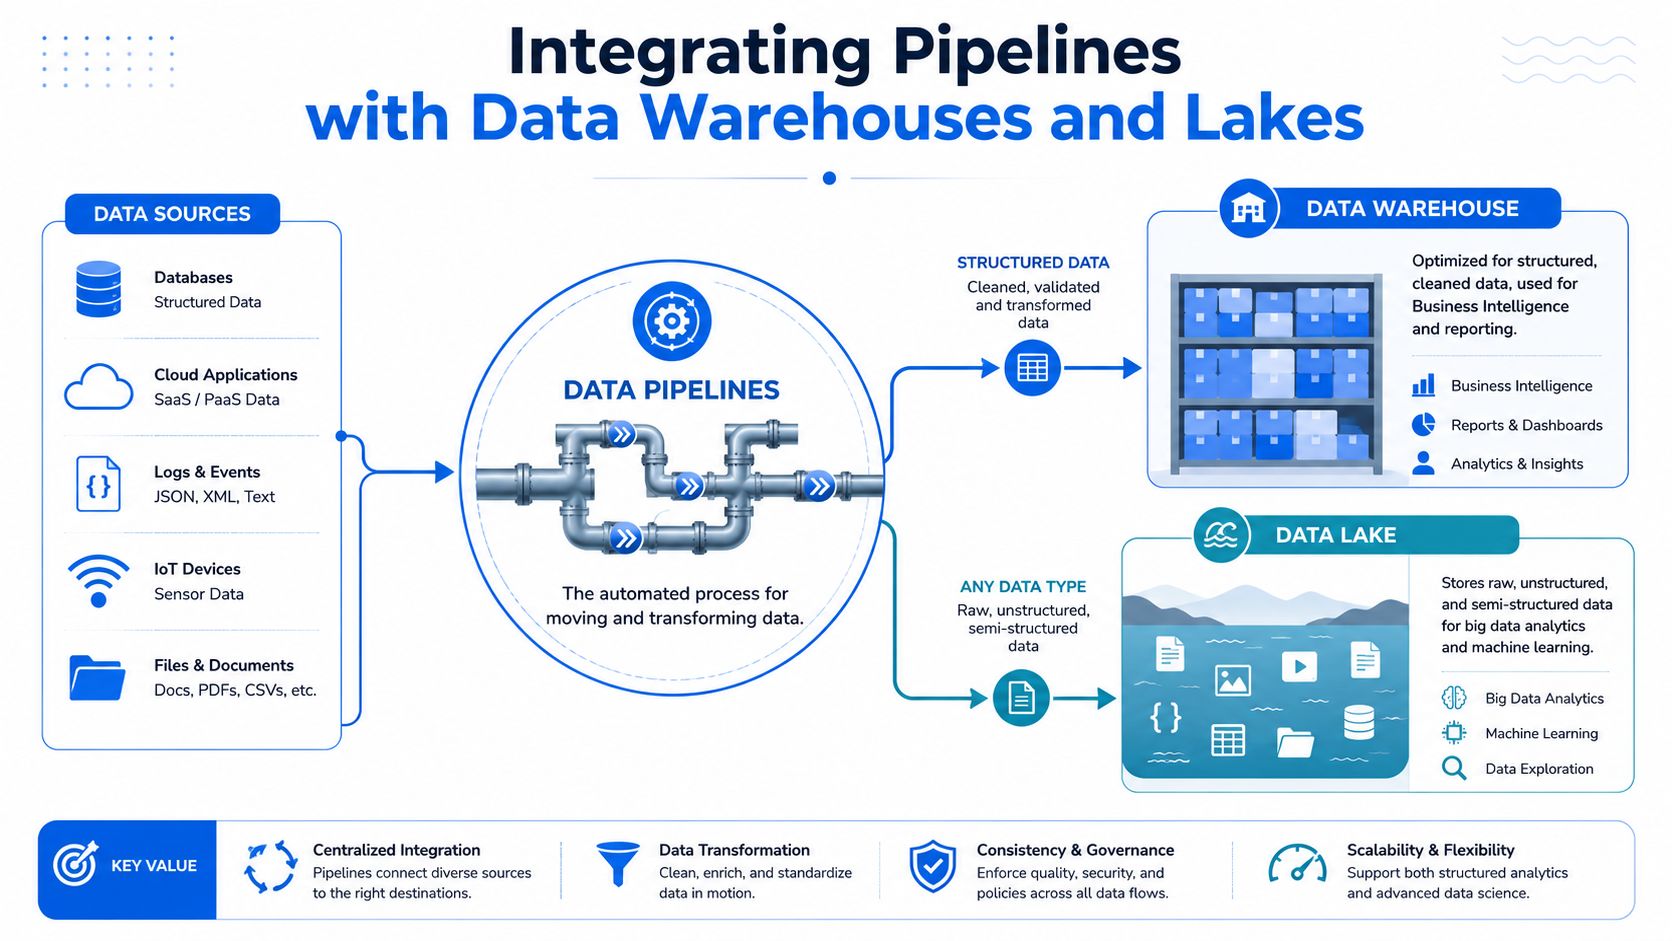
Integrare le pipeline con data warehouse e data lake
Le pipeline di data science di solito non vengono costruite in modo isolato. Si basano su tabelle del data warehouse, storage del data lake o una combinazione di entrambi. La scelta architetturale incide su latenza, governance, velocità di sperimentazione e quantità di logica duplicata da mantenere.
Pattern warehouse-first
I data warehouse funzionano al meglio quando gli input sono già abbastanza strutturati e il business ha bisogno di dataset governati e interrogabili. Snowflake, BigQuery, Redshift e sistemi simili sono ottime scelte quando analytics engineering e generazione delle feature ML devono condividere tabelle curate.
In questo pattern, il data warehouse diventa di solito la fonte di verità per:
Entità standardizzate come cliente, conto, fornitore o esercente
Feature curate usate ripetutamente da più team
Output dei modelli riscritti per il consumo in BI e il reporting operativo
Un'impostazione warehouse-first semplifica la governance. Contratti di schema, trasformazioni basate su SQL, controllo degli accessi e verificabilità sono di solito più chiari che nei sistemi ad hoc basati su file. Si abbina bene anche ai team che pianificano una strategia di migrazione dal data warehouse al data lake per carichi di lavoro misti.
Pattern lake-first
I data lake sono preferibili quando i team hanno bisogno di flessibilità su file raw, dati semi-strutturati, log, documenti o grandi dataset sperimentali. Consentono ai data scientist di esplorare i dettagli a livello di sorgente senza costringere troppo presto ogni segnale in uno schema rigido del data warehouse.
Funziona bene per casi d'uso come:
Generazione di feature basata su grandi volumi di eventi
Sviluppo di modelli su telemetria raw
Pipeline per testi, immagini o documenti
Rielaborazione dei dati storici dopo modifiche alla logica delle feature
Il compromesso è la disciplina operativa. I data lake offrono libertà, ma rendono anche più facile accumulare formati incoerenti, asset duplicati e confini di ownership deboli.
Cosa funziona negli ambienti misti
La maggior parte delle aziende finisce con un modello ibrido. I dati raw e ad alto volume arrivano in un data lake. Gli output curati, governati e destinati al business risiedono nel data warehouse. La pipeline si muove tra i due.
Una suddivisione pratica spesso si presenta così:
Livello | Uso ideale |
|---|---|
Data lake | Ingestion raw, replay, sperimentazione ed elaborazione intermedia su larga scala |
Data warehouse | Dimensioni affidabili, fatti curati, feature riutilizzabili e reporting a valle |
Logica della pipeline | Spostamento, trasformazione, validazione e serving tra i due |
Mantenete la libertà di sperimentazione a monte. Mantenete il consumo affidabile da parte del business a valle.
Questa separazione evita un errore comune. I team o forzano troppo presto tutto nel data warehouse, rallentando la sperimentazione, oppure lasciano troppo nel data lake, rendendo analytics a valle e compliance più difficili del necessario.
Oltre l'orchestrazione: qualità dei dati e osservabilità
Uno scheduler può dirvi che i task sono stati eseguiti. Non può dirvi se i record erano sensati, se un campo critico si è appiattito su valori quasi costanti o se i produttori a monte hanno cambiato il significato di business mantenendo invariato lo schema.
Per questo l'orchestrazione da sola non basta.
Come si presentano i guasti silenziosi
Il carico operativo è maggiore di quanto molti team ammettano. Le pipeline di dati soffrono di un'instabilità persistente: tra il 30% e il 40% fallisce ogni settimana. Questi guasti contribuiscono a una media di 67 incidenti sui dati al mese per organizzazione, e ogni incidente richiede circa 15 ore per essere risolto, secondo la raccolta di statistiche sul data engineering di Folio3.
Questi numeri descrivono solo gli incidenti visibili. In pratica, alcuni dei guasti più costosi non sono affatto guasti evidenti. Sono variazioni silenziose della qualità:
Una sorgente inizia a inviare stringhe vuote invece di null
Un enum acquisisce una nuova categoria che la logica a valle ignora
Un timestamp arriva con una convenzione di fuso orario diversa
La distribuzione di una feature cambia abbastanza lentamente da sfuggire alle regole basate su soglie
Quando accade nei sistemi ML, il modello può continuare a fornire previsioni mentre la fiducia nell'output si erode costantemente.
I quattro segnali che contano
I team hanno bisogno di un'unica vista operativa che combini qualità e osservabilità, invece di suddividerle tra strumenti e dashboard scollegati. Considererei questi quattro segnali indispensabili.
Qualità dei dati
Si tratta della correttezza a livello di record. I campi obbligatori sono valorizzati? I valori rispettano le regole di business? Le chiavi esterne corrispondono correttamente? I campi calcolati sono coerenti al loro interno?
Le validazioni esplicite sono le più importanti. I controlli di qualità dovrebbero stare vicino ai dati che proteggono, non solo nel codice applicativo o nei notebook a valle.
Puntualità
Dati freschi che arrivano troppo tardi restano un problema di produzione. Il monitoraggio della puntualità dovrebbe tracciare i pattern di arrivo attesi, le partizioni in ritardo, i caricamenti incompleti e gli aggiornamenti tardivi delle sorgenti.
Negli ambienti batch questo significa di solito controlli consapevoli delle pianificazioni. Nelle pipeline di eventi significa osservare il ritardo di ingestion e gli eventi fuori ordine.
Integrità dello schema
Una rottura dello schema è evidente quando una colonna scompare e un job si blocca. Il caso più difficile è una modifica additiva o di tipo affine che non fallisce subito ma cambia comunque il significato. I team dovrebbero tenere d'occhio colonne aggiunte, colonne rimosse, modifiche di tipo e deriva dei contratti a livello di campo.
Rilevamento delle anomalie
Le regole intercettano i problemi noti. Il rilevamento delle anomalie intercetta cambiamenti inattesi in volumi, distribuzioni, pattern e trend. Servono entrambi.
Un confronto utile si presenta così:
Tipo di segnale | Efficace nell'intercettare | Poco efficace nell'intercettare |
|---|---|---|
Regole statiche | Picchi di null, intervalli non validi, violazioni di formato | Nuovi pattern di deriva che non avevate previsto |
Rilevamento delle anomalie | Variazioni inattese di comportamento e distribuzione | Errori espliciti di logica di business, se non codificati |
Per i team che confrontano direttamente le due discipline, questa guida su data observability e qualità dei dati nella pratica offre un utile quadro di riferimento, perché le tratta come controlli complementari anziché come categorie in competizione.
Perché il monitoraggio unificato batte la proliferazione di strumenti
Le configurazioni frammentate generano incidenti propri. Uno strumento controlla la freschezza. Un altro verifica lo schema. Un terzo esegue le validazioni. Un quarto invia gli alert. Gli ingegneri passano poi il tempo dell'incidente a riconciliare segnali contrastanti e a inseguire l'ownership tra i sistemi.
Funziona meglio un modello operativo unificato:
Un unico punto in cui verificare la salute di tutte le fasi della pipeline
Un'unica vista degli incidenti che collega freschezza, schema, qualità e anomalie
Un unico modello di ownership per escalation e remediation
Un unico audit trail di cosa è cambiato e quando
Se a un ingegnere servono quattro dashboard per spiegare una previsione sbagliata, la progettazione del monitoraggio fa parte del problema.
Negli ambienti private cloud e on-prem questa unificazione conta ancora di più, perché spesso i team non possono contare su servizi di monitoraggio cloud-native completamente gestiti. Hanno bisogno di controlli che rispettino i confini aziendali senza imporre ulteriori spostamenti di dati.
Pipeline on-prem e in private cloud: aspetti da considerare
Gli ambienti on-prem e private cloud cambiano le priorità di progettazione. I consigli abituali per il public cloud non sempre si applicano bene quando i dati non possono lasciare la rete, i cicli di procurement sono più lenti e le revisioni di sicurezza più rigorose.
Questo non rende di per sé più difficili pipeline di data science solide. Significa solo che l'architettura deve rispettare i vincoli locali fin dall'inizio.

Vincoli di sicurezza e di architettura
Nei settori regolamentati, i team di solito vogliono che il calcolo avvenga dove i dati risiedono già. Ciò riduce l'esposizione in termini di sicurezza, evita copie superflue e semplifica le revisioni di governance. In pratica, significa spesso trasformazioni nel database, calcolo locale delle metriche, validazione nativa nel data warehouse e confini di servizio controllati attorno al training o all'inferenza dei modelli.
Le principali domande architetturali sono semplici:
Questo componente può funzionare senza esportare dati sensibili altrove?
I team di sicurezza possono verificare chi ha toccato cosa?
I team di piattaforma possono aggiornarlo e gestirlo con i controlli esistenti?
La pipeline può fallire in modo sicuro quando una dipendenza si degrada?
Formati aperti, contratti espliciti e spostamenti di dati minimi dimostrano qui il loro valore.
Capacity planning e costo totale
I team on-prem non possono risolvere ogni problema di throughput cliccando su "scale up". Il capacity planning diventa importante prima e deve basarsi su carichi di lavoro realistici. Le indicazioni di Google sul benchmarking dei job Dataflow con il throughput per core vCPU sono utili in questo senso, perché insistono sui test con tipi di dati, dimensioni, comportamento di rete e condizioni reali di sorgenti e destinazioni attesi, anziché su benchmark idealizzati.
Anche la valutazione dei costi deve includere il comportamento in caso di guasto. Come spiega Databricks nelle sue indicazioni sulla valutazione del rapporto costo-prestazioni delle pipeline, sia i costi di calcolo totali sia i tassi di errore rientrano nel calcolo, perché i frequenti fallimenti dei job costringono a rielaborazioni e ritardano il time-to-value.
Cosa regge negli ambienti enterprise
I pattern più solidi che ho visto negli ambienti enterprise sono noiosi nel senso migliore del termine. Privilegiano la prevedibilità rispetto alla novità.
Servizi modulari: mantenete ingestion, trasformazione, validazione e serving debolmente accoppiati, così che un singolo guasto non blocchi tutto.
Backfill deterministici: rieseguite la logica per una finestra definita con lo stesso codice e una lineage chiara.
Osservabilità locale: conservate i segnali di salute dove gli ingegneri possono esaminarli senza attraversare confini di sicurezza.
Ownership esplicita: ogni pipeline, tabella e input del modello ha bisogno di un team designato responsabile degli incidenti.
L'affidabilità enterprise nasce di solito da confini disciplinati, non da diagrammi architetturali sofisticati.
I sistemi private cloud e on-prem premiano progettazioni ispezionabili, sottoposte a benchmark e prudenti nello spostare i dati. Ciò vale soprattutto quando le pipeline di AI dipendono da un'infrastruttura condivisa di data warehouse e data lake usata contemporaneamente da molti team.
Conclusione: costruire una strategia di pipeline resiliente
Le pipeline di data science affidabili non sono semplici flussi di lavoro pianificati. Sono sistemi operativi che determinano come i dati grezzi diventano set di training affidabili, feature di produzione, output dei modelli e decisioni di business.
La fase di costruzione riceve la maggior parte dell'attenzione. La fase di manutenzione decide se la pipeline continua a generare valore. È qui che molti team si fermano. Automatizzano lo spostamento, ma non la fiducia. Monitorano i task, ma non la salute dei dati. Aggiungono strumenti, ma non chiarezza.
Una strategia più solida è più semplice da descrivere che da implementare. Costruite fasi chiare. Mantenete le scelte di storage e serving allineate ai carichi di lavoro reali. Trattate qualità dei dati, puntualità, integrità dello schema e rilevamento delle anomalie come un'unica disciplina operativa. Negli ambienti privati, mantenete il calcolo vicino ai dati ed eseguite benchmark in condizioni realistiche.
Il passo successivo migliore di solito non è avviare un nuovo progetto di piattaforma. È fare un audit della pipeline più critica per il business che avete già. Verificate dove può fallire senza essere rilevata. Verificate quanto rapidamente il vostro team riesce a spiegare un output errato. Verificate se osservabilità e qualità sono ancora suddivise in troppi punti.
Se cercate un modo pratico per unificare rilevamento delle anomalie, validazione a livello di record, monitoraggio della puntualità e tracciamento dello schema senza spostare i dati fuori dal vostro ambiente, date un'occhiata a digna. È pensata per i team che gestiscono la moderna qualità dei dati e l'osservabilità all'interno dei propri database, del private cloud o di infrastrutture on-prem.
Per intercettare distribuzioni di feature che derivano troppo lentamente per le regole a soglia, guardate come digna Data Anomalies apprende il comportamento normale e segnala variazioni inattese di volume e distribuzione.
Domande frequenti
Che cos'è una pipeline di data science?
Una pipeline di data science trasforma dati grezzi provenienti da applicazioni, log, file, API e flussi di eventi in set di training, feature, previsioni e output monitorati. A differenza di un job ETL di base, copre anche la creazione delle feature, la generazione dei dataset di training e validazione, la riproducibilità degli esperimenti, il deployment dei modelli e i cicli di feedback successivi al deployment.
Quali sono le fasi di una pipeline di data science?
L'articolo descrive sette fasi fondamentali: ingestion dei dati, archiviazione e integrazione dei dati, elaborazione dei dati e feature engineering, addestramento e tuning del modello, validazione e selezione del modello, deployment del modello, monitoraggio e riaddestramento. Un vocabolario condiviso per queste fasi semplifica il debugging e chiarisce l'ownership tra i team.
Con quale frequenza falliscono le pipeline di dati?
Piuttosto spesso. Secondo le statistiche di Folio3 citate nell'articolo, tra il 30% e il 40% delle pipeline di dati fallisce ogni settimana, contribuendo a una media di 67 incidenti sui dati al mese per organizzazione, ciascuno dei quali richiede circa 15 ore per essere risolto. Le variazioni silenziose della qualità aggiungono ulteriori danni, meno visibili.
Una pipeline di data science dovrebbe usare un data warehouse o un data lake?
La maggior parte delle aziende li usa entrambi. I dati raw e ad alto volume arrivano in un data lake per ingestion, replay e sperimentazione, mentre dimensioni affidabili, fatti curati, feature riutilizzabili e reporting risiedono nel data warehouse. La logica della pipeline gestisce spostamento, trasformazione, validazione e serving tra i due livelli.
Cosa bisogna monitorare in una pipeline ML in produzione?
Monitorate insieme quattro segnali: la qualità dei dati per la correttezza a livello di record, la puntualità per i caricamenti in ritardo o incompleti, l'integrità dello schema per colonne aggiunte, rimosse o con tipo modificato, e il rilevamento delle anomalie per variazioni inattese di volume e distribuzione. Se il successo dei job è il vostro unico segnale di salute, state monitorando lo scheduler, non la pipeline.


