8 KPI di data governance da misurare nel 2026
|
8
min di lettura

La maggior parte dei programmi di governance non fallisce perché nessuno ha scritto le policy. Fallisce perché i team non riescono a dimostrare che quelle policy cambiano ciò che accade in produzione. Un benchmark sulla governance enterprise del 2025 ha rilevato che il 71% delle organizzazioni gestisce un programma formale di data governance, rispetto al 60% di due anni prima (benchmark sulla governance enterprise del 2025). L'adozione formale è in crescita, ma lo stesso benchmark ha indicato la qualità dei dati come principale criticità di business, al 56%, seguita a breve distanza dalla governance al 54%. L'implicazione è chiara: documentare l'ownership e pubblicare standard non basta. I leader hanno bisogno di prove che i controlli funzionano, che i dati arrivano in modo affidabile, che gli incidenti vengono contenuti e che le decisioni diventano più sicure.
Gli otto KPI di data governance che seguono formano un sistema di misurazione interconnesso. La copertura mostra dove esiste la governance, l'enforcement mostra se i controlli funzionano, qualità e timeliness mostrano lo stato dei dati, e le metriche su incidenti, schema e business mostrano se la governance protegge le decisioni. Per ogni KPI sono indicati logica di calcolo, scelte di implementazione e compromessi.
Prima di calcolare qualsiasi cosa, definite popolazione di asset, owner, finestra di misurazione, livello di criticità, soglia obiettivo e aspettative di risposta agli alert. Un punteggio senza un owner designato è un report. Un punteggio legato a un percorso di remediation è un controllo.
Indice
5. Rilevamento delle modifiche allo schema e tempo di risoluzione
6. Efficacia del rilevamento delle anomalie nei KPI di business
7. Tasso di adozione e di enforcement delle policy di data governance
8. Copertura della data observability e profondità del monitoraggio
Trasformate otto metriche in un ritmo operativo di governance
1. Data Quality Score
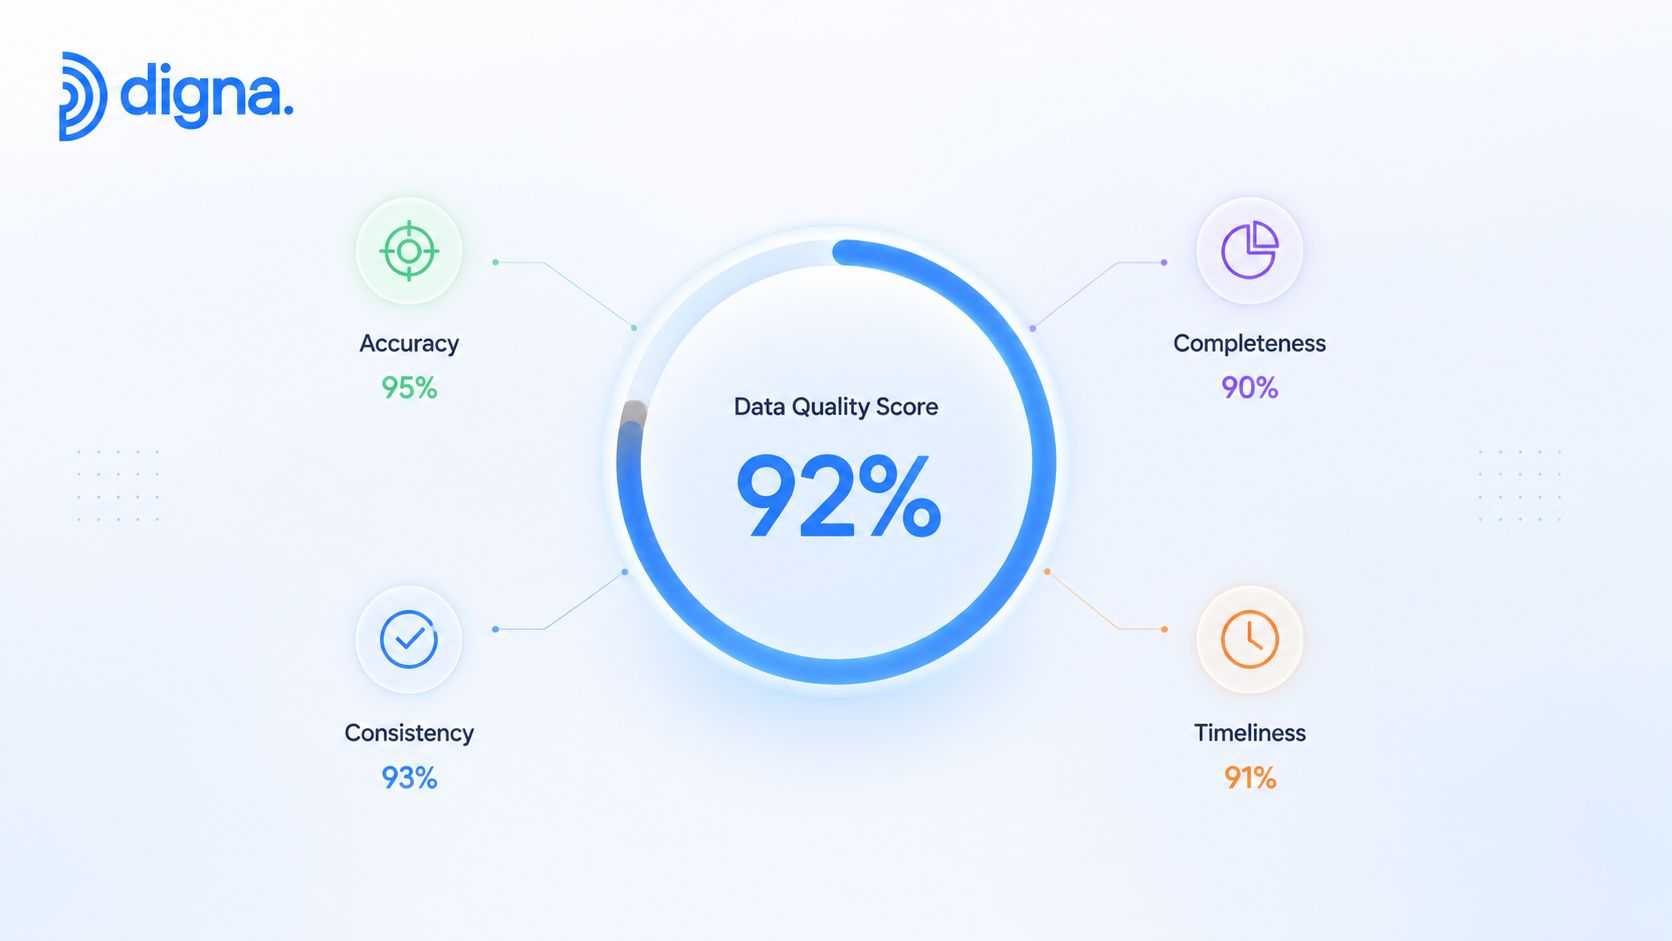
Un Data Quality Score è il segnale di stato nel sistema di misurazione a otto KPI. La copertura mostra dove esiste la governance, l'enforcement mostra se i controlli funzionano, mentre questo punteggio mostra se i dati critici sono adatti a reporting, operations, compliance o flussi di lavoro di AI. Le dimensioni più comuni includono accuratezza, completezza, coerenza, timeliness e unicità. I team possono usare le indicazioni sulle metriche di qualità dei dati per definire e combinare queste dimensioni senza trattare il risultato composito come una diagnosi.
Un calcolo semplice è:
Data Quality Score = somma dei punteggi delle dimensioni moltiplicati per i rispettivi pesi
I pesi dovrebbero riflettere il modo in cui ciascun dataset viene utilizzato. Un report regolamentare può dare più peso a validità e completezza, mentre una dashboard operativa quasi in tempo reale può privilegiare la freschezza. Un punteggio enterprise condiviso migliora la comparabilità, ma i punteggi specifici per dataset conservano il contesto necessario per identificare owner e attività di remediation.
Costruite il punteggio attorno agli asset critici
Iniziate da un gruppo definito di dataset critici invece di assegnare un punteggio all'intero patrimonio. Per ogni asset documentate le dimensioni misurate, le regole di validazione, la baseline delle anomalie, le aspettative di timeliness, l'owner e il percorso di escalation. Date priorità ai dati collegati a reporting, compliance, operations verso i clienti o flussi di lavoro di AI, poi estendete la copertura quando il processo di misurazione è stabile.
Il punteggio dovrebbe far emergere il rischio operativo, non nasconderlo. Un risultato di completezza più basso può riflettere una modifica pianificata del sistema sorgente, un errore di una pipeline senza owner o un difetto ricorrente a monte. Queste cause richiedono risposte diverse, quindi allegate alla vista direzionale il contesto degli incidenti e i risultati per singola dimensione.
Regola pratica: un punteggio composito dovrebbe avviare un'indagine, non sostituirla.
Le indicazioni di digna sono rilevanti quando i team combinano risultati di validazione, segnali di anomalia e osservazioni sulla timeliness mantenendo l'elaborazione all'interno del proprio ambiente. L'esecuzione in-database può inoltre ridurre la necessità di spostare dati sensibili al di fuori dell'infrastruttura approvata.
2. Tasso di superamento della validazione dei dati
Un tasso di superamento della validazione dei dati mostra se le regole governate operano sui record effettivi. Misura la quota di record che superano i controlli di business e strutturali definiti in un periodo stabilito, collegando i requisiti delle policy alle prestazioni dei controlli.
Tasso di superamento della validazione = record che superano tutti i controlli applicabili diviso il totale dei record valutati, moltiplicato per 100
Calcolate il KPI a livello di regola, di dataset e di dominio. Il tasso aggregato indica l'enforcement complessivo, mentre i risultati per regola identificano gli errori relativi a indirizzi, identificativi, date, relazioni finanziarie o altri campi. Poiché un record può fallire più controlli, riportate i record interessati separatamente dal totale delle violazioni di regole. Questa distinzione evita che errori ripetuti in un piccolo gruppo di record distorcano il quadro operativo.
Rendete spiegabili gli errori
Date priorità alle regole legate a reporting, compliance, input di AI o erogazione dei servizi. I controlli deterministici supportano un confronto coerente, ma i conteggi aggregati non bastano. Esaminate campioni di record non validi e classificatene la causa, come un errore di configurazione a monte, una definizione della sorgente modificata o un processo che ammette valori non validi.
Il rischio del caso d'uso dovrebbe fissare la tolleranza. I controlli sul reporting finanziario richiedono in genere limiti più stretti dell'analisi esplorativa. La validazione dello schema può essere calcolata come record che superano i controlli di schema diviso il totale dei record. I benchmark pubblicati sui KPI di data governance indicano obiettivi superiori al 99,5% e considerano un campanello d'allarme i risultati inferiori al 98%, ma queste soglie vanno adattate alla criticità dei dati e all'ambito delle regole.
Le regole e i controlli di validazione dei dati di digna supportano test a livello di record rispetto alla logica di business e ai requisiti di audit. Abbinate il tasso di superamento a ownership delle regole, conteggi dei record non validi e tempi di risoluzione. Un tasso elevato senza un esame degli errori può riflettere controlli deboli piuttosto che dati sani.
3. Conformità agli SLA di timeliness dei dati
I dati in ritardo possono invalidare una decisione altrimenti corretta. La conformità agli SLA di timeliness dei dati misura se le consegne attese arrivano entro la finestra concordata, collegando l'affidabilità delle pipeline alla freschezza delle dashboard, ai flussi operativi e alla latenza decisionale. Costituisce il livello di stato del sistema di KPI: la copertura mostra dove esiste la governance, l'enforcement mostra se i controlli funzionano e la timeliness mostra se i dati governati sono utilizzabili quando le decisioni lo richiedono.
Conformità agli SLA di timeliness = consegne di dati disponibili in tempo diviso il totale delle consegne attese, moltiplicato per 100
Calcolate il numeratore a partire da record di consegna con timestamp. Includete nel denominatore ogni consegna attesa, compresi i caricamenti mancanti. Escludere i dati mancanti fa apparire le prestazioni migliori proprio quando la pipeline sta fallendo.
Regolate l'orologio sulle esigenze di business
Fissate lo SLA in base ai requisiti a valle, non alle prestazioni attuali della pipeline. Un referto clinico necessario per un flusso di dimissione ha un'urgenza diversa da un'estrazione mensile per la pianificazione. Tenete conto di fine mese, fine trimestre, festività, finestre di manutenzione e altre variazioni di calendario prima di fare escalation su un ritardo.
Un benchmark pubblicato raccomanda almeno il 98% di timeliness per i dati operativi critici (definizione e formula del KPI di timeliness). Un altro riferimento sulla governance colloca il rispetto degli SLA di freschezza oltre il 99% e considera un campanello d'allarme i valori inferiori al 95%. Queste cifre sono punti di riferimento, non obiettivi universali. La soglia appropriata dipende dalle conseguenze per il business, dalla frequenza delle consegne e dal costo dei dati in ritardo.
L'approccio di digna al monitoraggio della timeliness dei dati utilizza i pattern di consegna attesi per identificare ritardi, caricamenti mancanti e arrivi anticipati. Correlate gli SLA mancati con tempi di esecuzione dei job, profondità delle code, disponibilità delle sorgenti ed eventi infrastrutturali. Questa analisi distingue un difetto della pipeline da un vincolo dell'ambiente operativo, offrendo agli owner un percorso di remediation più chiaro.
4. Tasso di rilevamento degli incidenti critici sui dati
Un programma di governance non può ridurre incidenti che non rileva mai. Il tasso di rilevamento degli incidenti critici sui dati misura quante anomalie rilevanti, errori di qualità e modifiche allo schema vengono individuati dal monitoraggio entro una finestra di risposta definita.
La formula di base è:
Tasso di rilevamento = incidenti critici rilevati entro la finestra obiettivo diviso gli incidenti critici identificati attraverso tutte le evidenze disponibili, moltiplicato per 100
La parte difficile è il denominatore. I team possono scoprire gli incidenti tramite monitoraggio, reclami degli utenti, report non riusciti, revisioni di audit o riconciliazioni a valle. Questi canali di scoperta vanno riconciliati, così che il KPI non premi un sistema di monitoraggio che riporta solo i propri alert.
Misurate il segnale, non il volume di alert
Iniziate dai dataset ad alto impatto e definite cosa si qualifica come critico. Un improvviso cambiamento di distribuzione in un dataset regolamentare può richiedere un'escalation immediata, mentre una fluttuazione stagionale in una tabella esplorativa no. Monitorate la latenza di rilevamento, i falsi positivi e il percorso dall'alert al ticket. Un rilevamento senza evidenza di risposta è solo una protezione parziale.
Le capacità di rilevamento delle anomalie di digna combinano l'apprendimento delle baseline con la validazione e il tracciamento dello schema. Questa combinazione è importante perché un incidente visibile al business può avere origine in una distribuzione di valori, nella violazione di una regola o in una modifica strutturale.
Un team di monitoraggio dovrebbe porsi due domande per ogni incidente: “Lo abbiamo rilevato abbastanza presto?” e “Ha agito l'owner giusto?”
Esaminate regolarmente i pattern dei falsi positivi. Eventi stagionali noti, migrazioni pianificate e comportamenti batch ricorrenti dovrebbero orientare la calibrazione delle baseline. L'obiettivo non è massimizzare il numero di alert, ma far emergere i guasti rilevanti abbastanza presto da evitare report rotti, modelli non funzionanti o output regolamentari inaffidabili.
5. Rilevamento delle modifiche allo schema e tempo di risoluzione
Le modifiche allo schema possono causare guasti che i normali controlli di qualità non intercettano. Una colonna rimossa o un tipo incompatibile possono bloccare una pipeline, mentre la modifica di un campo opzionale può passare inosservata e alterare la logica a valle senza che nessuno se ne accorga subito. Il rilevamento delle modifiche allo schema e tempo di risoluzione misura il tempo trascorso dal rilevamento di una modifica strutturale alla conferma del suo assorbimento da parte dei consumatori a valle.
Tempo di risoluzione = timestamp dell'assorbimento confermato a valle meno timestamp del rilevamento della modifica
Monitorate separatamente il tempo di risoluzione medio, mediano e nel caso peggiore. La media riassume le prestazioni complessive, la mediana mostra la velocità operativa tipica e il massimo evidenzia il rischio di escalation. Fermate il cronometro solo dopo la conferma dell'assorbimento a valle, non quando qualcuno prende in carico un alert o apre un ticket.
Classificate le modifiche prima che avvengano
Un runbook dovrebbe separare le modifiche urgenti da quelle adatte a una revisione pianificata. La rimozione di colonne, le modifiche di tipo incompatibili e l'alterazione della semantica delle chiavi richiedono in genere un'escalation rapida. Le nuove colonne opzionali possono entrare in una coda di revisione quando non incidono sui contratti a valle.
Ownership e lineage accorciano l'indagine, perché gli ingegneri possono identificare i consumatori interessati senza ricostruire le dipendenze durante un incidente. Documentate il significato delle colonne, l'ownership delle sorgenti, la logica di trasformazione e l'uso a valle. Coordinate le modifiche pianificate con il controllo di versione per le trasformazioni SQL, dbt e Python.
La spiegazione dello schema drift e le indicazioni di monitoraggio di digna coprono il tracciamento di colonne aggiunte o rimosse e delle modifiche ai tipi di dato. Il KPI dovrebbe quindi verificare più della semplice copertura del rilevamento: dovrebbe mostrare se ogni modifica rilevante ha raggiunto l'owner corretto ed è stata assorbita in sicurezza, collegando l'enforcement della governance all'affidabilità delle pipeline e al rischio decisionale.

6. Efficacia del rilevamento delle anomalie nei KPI di business
I punteggi di qualità tecnica proteggono le decisioni solo quando rivelano se le metriche di business restano affidabili. L'efficacia del rilevamento delle anomalie nei KPI di business misura la quota di variazioni significative nelle metriche importanti che vengono rilevate, spiegate e portate in escalation entro una latenza accettabile.
Efficacia = variazioni di business significative rilevate e correttamente portate in escalation diviso le variazioni significative confermate tramite revisione, moltiplicato per 100
Il denominatore richiede un processo di revisione documentato. Classificate ogni alert esaminato come movimento reale del business, problema di qualità dei dati, problema di pipeline o falso positivo. Queste etichette collegano i risultati di business alle metriche di qualità dei dati sottostanti e forniscono agli analisti evidenze per calibrare le soglie e ridurre le indagini evitabili.
Definite cosa è “significativo” insieme ai decisori
I dirigenti possono privilegiare ricavi, attività dei clienti, volume delle transazioni o efficienza operativa. I team di dati possono monitorare le tabelle sorgente e le trasformazioni che producono queste misure. Il controllo è efficace solo quando le due prospettive si collegano: un alert dovrebbe indicare la metrica, il contesto storico, le relative modifiche ai dati e l'owner dell'indagine.
La funzionalità di Business Monitoring di digna supporta l'analisi delle metriche di business e operative. Il suo modulo Data Analytics può aiutare i team a esaminare volatilità storica e stagionalità prima di impostare i livelli di sensibilità. Questo conta per le metriche influenzate da pattern di calendario, cicli promozionali o scadenze di reporting, dove una soglia fissa può generare falsi positivi ripetuti.
L'alert di anomalia di business più efficace aiuta un decisore a capire se è cambiato il business o se sono cambiati i dati.
Esaminate i risultati con cadenza regolare. Confrontate i risultati di rilevamento ed escalation per metrica, dominio di business e categoria di causa. Un punteggio in calo può indicare una copertura di monitoraggio debole, mentre un volume elevato di alert con poche anomalie confermate può indicare soglie inadeguate. Collegare le etichette a incidenti sulle sorgenti, eventi di schema ed errori di validazione trasforma questo KPI da un conteggio di alert in una prova che la governance protegge le decisioni operative.
7. Tasso di adozione e di enforcement delle policy di data governance
Una policy documentata ha un valore limitato finché un controllo non la verifica e qualcuno non interviene sulle eccezioni. Questo KPI misura quanto ampiamente le policy approvate siano implementate tramite monitoraggio, validazione, controlli di accesso, controlli di timeliness, controlli sullo schema o altri meccanismi.
Tasso di enforcement = policy con controlli attivi e testati diviso il totale delle policy definite, moltiplicato per 100
Definite il denominatore prima di misurare i progressi. Includete standard formali e regole operative documentate, separando le policy approvate dalle linee guida aspirazionali. Altrimenti, l'aggiunta di nuove policy può abbassare il tasso anche quando la copertura dei controlli migliora.
Misurate la maturità dell'automazione
Un benchmark ha rilevato che il 61% delle organizzazioni aveva policy in vigore, ma solo il 38% disponeva di un enforcement automatizzato (benchmark sulla maturità della governance). Questo divario rende il numero di policy un'evidenza debole. Una policy può esistere in un documento senza un controllo di sistema, un owner responsabile o un percorso di gestione delle eccezioni attuabile.
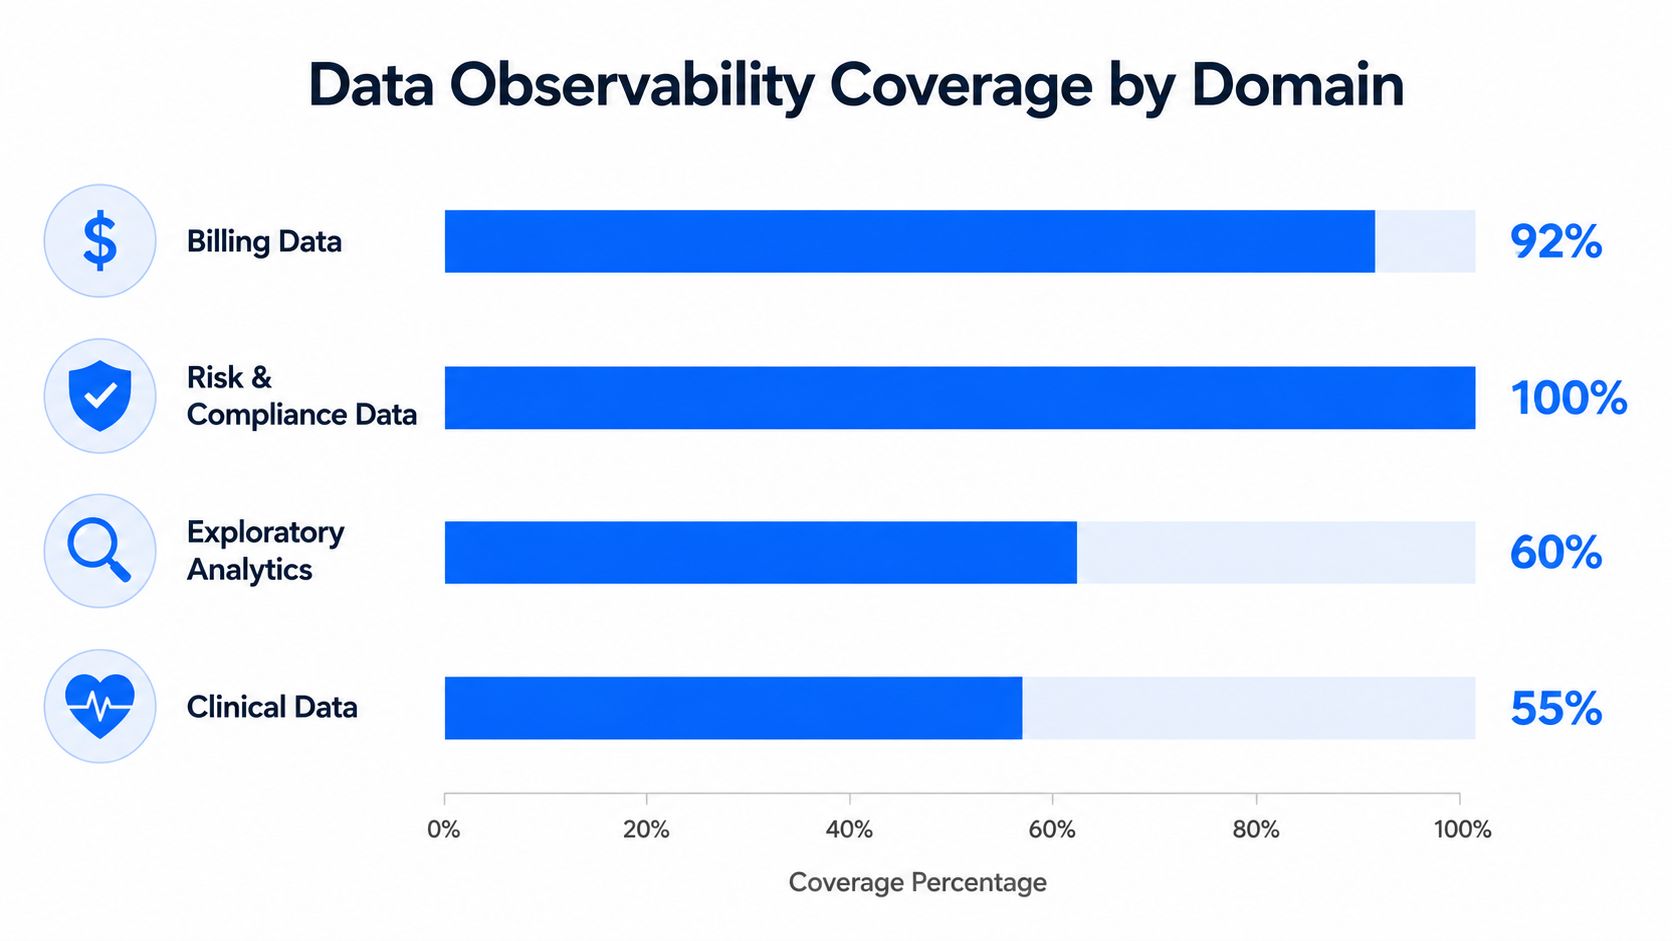
Mappate ogni policy al relativo controllo, perimetro di dataset, owner, frequenza dei test, processo di gestione delle eccezioni e posizione delle evidenze. Riportate i risultati per dominio e livello di rischio, non solo come media aziendale. Un'organizzazione sanitaria, ad esempio, potrebbe scoprire che i controlli sulla fatturazione funzionano in automatico mentre quelli clinici restano manuali.
Anche il monitoraggio della timeliness fornisce evidenze sull'enforcement. Verificare se i dati rispettano i livelli di servizio concordati aiuta a confermare che una policy opera in produzione, invece di esistere solo nella documentazione. Consultate le indicazioni su definizioni, metriche e monitoraggio della timeliness dei dati.
L'adozione include il comportamento dopo il rilevamento. Monitorate la presa in carico degli alert, la risoluzione delle eccezioni e la conformità ai flussi di lavoro. Un controllo automatizzato i cui risultati vengono abitualmente ignorati è applicato solo in parte, quindi abbinate questo KPI agli esiti degli incidenti e alle misure di impatto sul business.
8. Copertura della data observability e profondità del monitoraggio
La copertura mostra dove esiste la governance, mentre la profondità del monitoraggio mostra se è in grado di proteggere le decisioni. Misurate la quota di tabelle critiche, pipeline e metriche di business sottoposte a monitoraggio attivo.
Copertura dell'observability = asset critici monitorati diviso il totale degli asset critici, moltiplicato per 100
Una percentuale di copertura può nascondere una protezione debole. Monitorare una tabella solo per la completezza offre meno controllo che monitorarne un'altra per completezza, timeliness, anomalie e modifiche allo schema. Riportate sia la quota di asset monitorati sia il numero e il tipo di controlli attivi per asset.
Distinguete l'ampiezza dalla protezione
Fate l'inventario di warehouse, lake, pipeline e metriche di business. Classificate ogni asset in base al suo legame con decisioni, obblighi di compliance, accordi sui livelli di servizio e rischio operativo. Date priorità alle lacune in cui un guasto potrebbe interrompere il reporting, le attività regolamentari o le operations.
Gli obiettivi di riferimento possono includere circa il 90% di copertura del catalogo e il 95% di copertura di lineage o policy, con il 100% di completamento delle revisioni degli accessi per un programma maturo. Queste cifre orientano la pianificazione più che definire requisiti universali. Un dataset di rischio regolamentato può giustificare un monitoraggio completo, mentre un asset esplorativo a basso rischio può richiedere meno profondità.
Usate lo storico degli incidenti, gli obblighi di compliance e le priorità di business per stabilire la profondità del monitoraggio. Un punteggio di copertura elevato con controlli superficiali può creare una falsa sicurezza, mentre controlli più approfonditi sugli asset più rilevanti possono ridurre il rischio decisionale in modo più efficace di un monitoraggio uniforme.
La soluzione di Data Platform Observability di digna monitora carichi di lavoro sui dati, consumo, disponibilità, misure legate alle prestazioni e modifiche. Il suo modello di esecuzione in-database può aiutare i team ad ampliare il monitoraggio senza spostare i dati di produzione fuori dal proprio ambiente.
Confronto degli 8 KPI di data governance
Metrica | Complessità di implementazione 🔄 | Risorse necessarie ⚡ | Risultati attesi 📊 | Casi d'uso ideali 💡 | Vantaggi principali ⭐ |
|---|---|---|---|---|---|
Data Quality Score | 🔄 Media, richiede logica di ponderazione e aggregazione tra le dimensioni | ⚡ Moderate: regole di validazione, rilevamento delle anomalie, archiviazione storica | 📊 Punteggio unificato della salute dei dati per benchmarking e analisi dei trend | 💡 Reporting direzionale, monitoraggio degli SLA, confronti tra unità | ⭐ Semplifica il reporting; definisce le priorità di remediation |
Tasso di superamento della validazione dei dati | 🔄 Media, richiede un'attenta progettazione e calibrazione delle regole | ⚡ Elevate: controlli a livello di record e manutenzione continua delle regole | 📊 Metrica di enforcement precisa con report dettagliati sugli errori | 💡 Audit di compliance, validazione a monte, correzioni mirate | ⭐ Pronto per l'audit, evidenze degli errori su cui agire |
Conformità agli SLA di timeliness dei dati | 🔄 Bassa–media, richiede apprendimento delle baseline e integrazione con le pianificazioni | ⚡ Moderate: pipeline di monitoraggio e sistemi di alerting | 📊 % di consegne puntuali; allerta precoce per caricamenti in ritardo/mancanti | 💡 Monitoraggio degli SLA delle pipeline, freschezza delle dashboard, SLA operativi | ⭐ Automatizza il monitoraggio degli SLA; quantifica l'affidabilità delle pipeline |
Tasso di rilevamento degli incidenti critici sui dati | 🔄 Alta, baseline AI + integrazione con i sistemi di gestione degli incidenti | ⚡ Elevate: rilevamento continuo delle anomalie e alerting | 📊 Rilevamento più rapido (MTTD inferiore); fa emergere problemi noti e sconosciuti | 💡 Analisi in produzione, monitoraggio dei modelli, domini di dati ad alto rischio | ⭐ Rilevamento precoce delle anomalie; riduce l'impatto dei disservizi |
Rilevamento delle modifiche allo schema e tempo di risoluzione | 🔄 Bassa–media, tracciamento continuo + runbook per la risposta | ⚡ Basse–moderate: strumenti di monitoraggio dello schema e analisi d'impatto | 📊 Metrica del tempo di risoluzione; previene guasti silenziosi a valle | 💡 Ambienti con schema drift frequente o molte integrazioni | ⭐ Rilevamento immediato; visibilità dell'impatto e audit trail |
Efficacia del rilevamento delle anomalie nei KPI di business | 🔄 Alta, richiede definizioni accurate dei KPI e calibrazione | ⚡ Elevate: baseline AI, analisi multidimensionale, indicazioni sulla causa principale | 📊 % di variazioni di business significative rilevate e contestualizzate | 💡 Dashboard direzionali, monitoraggio di ricavi/volumi, alert operativi | ⭐ Alert orientati al business con indicazioni contestuali sulla causa principale |
Tasso di adozione e di enforcement delle policy | 🔄 Media, mappatura tra policy e monitoraggio e flussi di gestione delle eccezioni | ⚡ Moderate: gestione delle policy, audit logging, approvazioni | 📊 % di policy rese operative; indicatore di maturità della governance | 💡 Programmi di governance, reporting di compliance, gestione del rischio | ⭐ Mostra il controllo operativo; indica le priorità tra le lacune di enforcement |
Copertura dell'observability e profondità del monitoraggio | 🔄 Alta, discovery automatizzata e configurazione di un monitoraggio multilivello | ⚡ Elevate: inventario, baseline, dashboard su più livelli | 📊 Rapporto di copertura e metriche di profondità per individuare i punti ciechi | 💡 Grandi piattaforme di dati, pianificazione della maturità dell'observability | ⭐ Quantifica la maturità del monitoraggio; orienta gli investimenti in copertura |
Trasformate otto metriche in un ritmo operativo di governance
Questi otto KPI funzionano al meglio come sistema, non come un inventario di numeri scollegati. La copertura vi dice se gli asset critici sono visibili. L'enforcement delle policy vi dice se gli standard scritti operano nei flussi di lavoro reali. Qualità e validazione mostrano se i record sono adatti all'uso. La timeliness mostra se i dati arrivano quando le decisioni lo richiedono. Rilevamento degli incidenti e risoluzione delle modifiche allo schema rivelano con quale rapidità l'organizzazione risponde ai cambiamenti. L'efficacia sulle anomalie di business collega il monitoraggio tecnico ai risultati che i leader gestiscono.
Iniziate stabilendo una baseline sugli asset critici. Registrate le dimensioni di qualità attuali, i risultati di validazione, le prestazioni di consegna, la copertura del monitoraggio, i controlli sulle policy, i percorsi di gestione degli incidenti e gli esiti degli alert sulle metriche di business. Evitate di cambiare l'obiettivo mentre cambiate il metodo di misurazione. Un trend è utile solo quando popolazione, formula e finestra di osservazione restano comprensibili.
Assegnate un owner a ogni KPI e a ogni asset critico. L'owner dovrebbe avere l'autorità per indagare, approvare eccezioni, coordinare la remediation e confermare la chiusura. Questo affronta un problema centrale di governance emerso da un sondaggio del 2025, in cui il 47% degli intervistati ha indicato ownership e responsabilità poco chiare come principale ostacolo alla scalabilità della governance (sondaggio 2025 sulla data governance). Una dashboard può far emergere un problema, ma solo persone responsabili possono risolverlo.
Fissate le soglie in base all'impatto sul business. Applicate controlli più rigorosi ai dati che supportano reporting regolamentare, operations sui pazienti, rischio finanziario o decisioni sui clienti ad alto impatto. Come riferimento, i framework pubblicati includono obiettivi come almeno il 90% di copertura del catalogo, almeno il 95% di copertura delle policy, un MTTR inferiore a quattro ore e il 100% di completamento delle revisioni trimestrali degli accessi (framework di metriche di data governance). Considerateli input di progettazione, poi validateli rispetto alle reali esigenze di servizio e alla capacità di risposta.
Esaminate segnali diversi con cadenze diverse. Ingegneri e data steward hanno bisogno di viste frequenti su validazioni non superate, consegne mancate, incidenti aperti, falsi positivi e modifiche allo schema. I leader della governance hanno bisogno dei trend su copertura, enforcement, qualità e remediation. I dirigenti hanno bisogno di un collegamento sintetico tra controlli sui dati e risultati di business. Questa distinzione conta perché il 39% dei data leader ha dichiarato di avere difficoltà a dimostrare al management l'impatto della governance, mentre l'85% dei senior executive di dati e analytics ha dato priorità al miglioramento della governance per prepararsi all'AI (report 2025 sullo stato della data governance enterprise).
Nessun singolo KPI dimostra la salute della governance. Un punteggio di qualità elevato può coesistere con punti ciechi. Un'ampia copertura può coesistere con un enforcement debole. Un rilevamento rapido può coesistere con una remediation lenta. Costruite la scorecard in modo che ogni misura risponda a una diversa domanda operativa e collegate ogni alert a evidenze di ownership, azione e risoluzione confermata.
digna è un'opzione per i team che hanno bisogno di monitorare qualità, timeliness, anomalie, validazione, modifiche allo schema, metriche di business e observability della piattaforma. La sua piattaforma modulare gira all'interno dell'ambiente del cliente e supporta l'esecuzione in-database, così i team possono mantenere i dati dove si trovano mentre ampliano il sistema di misurazione della governance.
Usate digna per monitorare i segnali critici di qualità dei dati, timeliness, validazione, anomalie, schema e observability all'interno del vostro ambiente. Visitate digna per collegare questi controlli a owner responsabili, alert operativi ed evidenze che la governance funziona in produzione.
Domande frequenti
Che cosa occorre definire prima di calcolare un KPI di governance?
Sei elementi: la popolazione di asset, l'owner, la finestra di misurazione, il livello di criticità, la soglia obiettivo e le aspettative di risposta agli alert. Senza di essi, la stessa formula produce un numero diverso ogni volta che qualcuno la esegue.
Come si calcola un Data Quality Score?
Come somma dei punteggi delle dimensioni moltiplicati per i rispettivi pesi, con pesi che riflettono l'uso effettivo di ciascun dataset. Iniziate da un gruppo definito di dataset critici invece di valutare l'intero patrimonio, così che il punteggio faccia emergere il rischio operativo invece di diluirlo in una media.
Un punteggio composito sostituisce l'indagine?
No. Un punteggio composito dovrebbe avviare un'indagine, non sostituirla. Il suo compito è segnalare che qualcosa si è mosso in un insieme ponderato di dimensioni, ed è il dettaglio per singola dimensione a indicare dove guardare.
Quanto è diffusa nella pratica la governance formale?
Un benchmark sulla governance enterprise del 2025 ha rilevato che il 71% delle organizzazioni gestisce un programma formale di data governance, rispetto al 60% di due anni prima. Questa crescita spiega perché la misurazione sia diventata una questione più difficile dell'adozione.
Perché misurare otto KPI anziché uno solo?
Perché formano un sistema di misurazione interconnesso che copre qualità, timeliness, copertura e controllo. Un unico numero di sintesi non può distinguere una lacuna di copertura da un problema di stato dei dati, e queste due situazioni richiedono risposte completamente diverse.


