Database Reliability Engineering: guida pratica per il 2026
|
8
min di lettura

La dashboard è di nuovo in ritardo. Il reparto finanza chiede perché i ricavi di ieri sembrano sbagliati, l'ingegnere reperibile fissa grafici della CPU perfettamente sani e qualcuno su Slack scrive: “Il database deve essere a posto, non c'è niente di rosso”. Quel divario tra una vista dell'infrastruttura pulita e dati di business rotti è esattamente il punto in cui la Database Reliability Engineering inizia a contare. Tratta il database come un servizio di produzione con obiettivi di affidabilità, non come un semplice motore di storage con dei backup.
Questo cambiamento conta perché il vecchio modello cede sotto pressione. Il lavoro reattivo del DBA può risolvere i singoli incidenti, ma non crea un modello operativo ripetibile per il cambiamento, il ripristino o la visibilità. La Database Reliability Engineering nasce dalla stessa disciplina dell'affidabilità che ha dato forma alla SRE, e il suo compito principale è mantenere i database disponibili, performanti e gestibili anche in presenza di cambiamenti e guasti (O'Reilly, Database Reliability Engineering). Se il vostro team sta cercando di ridurre le emergenze continue, rendere più rigoroso il ripristino e rendere i dati affidabili per analytics e AI, questo è il modello operativo che vi porta lì.
Indice
Dal downtime alla fiducia nei dati: il passaggio alla DBRE
Una dashboard rotta all'inizio sembra spesso un problema di reportistica. Il grafico non si carica, scatta un controllo di freschezza o i numeri non corrispondono al sistema operativo. In produzione, la causa principale è spesso un problema del database che il monitoraggio di base non ha rilevato, perché il database può essere tecnicamente “attivo” e allo stesso tempo servire dati obsoleti, lenti o incompleti.
Questo cambiamento nella modalità di guasto è il motivo per cui la Database Reliability Engineering è importante. La DBRE parte dalla definizione dell'affidabilità come contratto di servizio misurabile, poi gestisce il database nello stesso modo in cui i team gestiscono gli altri servizi di produzione. La disciplina tratta le operazioni sui database come una pratica affine alla SRE, con un modello operativo ripetibile pensato per mantenere i servizi affidabili attraverso cambiamenti e guasti.

Perché il cambio di ruolo conta
Chiamare qualcuno DBA non dice molto su come lavora. Un team DBRE definisce cosa significa “buono”, lo misura continuamente e progetta in funzione dei guasti prima che gli utenti li percepiscano. È un lavoro diverso dall'attendere i ticket per poi ripristinare il servizio sotto pressione.
Il vantaggio pratico è una responsabilità più chiara. Invece di chiedersi “Cosa si è rotto?”, i team si chiedono “Quale aspettativa di livello di servizio abbiamo violato e quale controllo avrebbe dovuto impedirlo?”. Questa domanda cambia il modo in cui engineering, analytics e team di piattaforma collaborano, perché la conversazione passa dalla ricerca di colpe a controlli, soglie e percorsi di ripristino.
Se state assumendo con questa mentalità, selezionate persone capaci di collegare comportamento delle applicazioni, comportamento dello storage e design del ripristino senza giri di parole. Un utile punto di partenza è il recruiting di DBRE per infrastruttura e cloud, perché il ruolo si colloca all'incrocio tra operazioni sui database, automazione e responsabilità del servizio.
In pratica il cambiamento è semplice. Il lavoro tradizionale sui database spesso protegge il sistema dopo un incidente. La DBRE protegge il sistema prima, durante e dopo il cambiamento, quindi ha il suo posto tanto nelle discussioni di pianificazione quanto nelle revisioni degli incidenti.
Per una visione più orientata al business di questo cambiamento, la panoramica interna su affidabilità dei database e fiducia nei dati è un utile complemento. Si allinea con la visione operativa presentata qui, soprattutto se il vostro team è responsabile della reportistica o delle analytics a valle.
I principi fondamentali della DBRE
Un programma DBRE dovrebbe funzionare come un contratto di prestazione, perché l'affidabilità diventa utile solo quando il team sa dire cosa viene promesso e cosa conta come mancato rispetto. La promessa di un servizio di consegna pizze rende l'idea facile da capire. Se l'ordine arriva caldo e puntuale, il contratto è rispettato. Se arriva in ritardo, freddo o sbagliato, il contratto è violato. I database hanno bisogno della stessa chiarezza, con segnali che riflettano il comportamento del servizio.
Gli SLI definiscono cosa misurate
I Service Level Indicator, o SLI, sono le misurazioni che mostrano se il servizio si comporta come gli utenti hanno bisogno. Per i database, di solito includono latenza delle query, disponibilità, frequenza delle chiamate e utilizzo. Un'impostazione fondamentale della DBRE afferma che i team dovrebbero gestire i servizi di database con questi indicatori, insieme all'osservabilità necessaria per vedere direttamente il comportamento dei dati, mentre il PDF sulla DBRE collega queste idee al ragionamento per livelli di servizio.
Un errore comune è scegliere metriche facili invece di metriche significative. CPU e disco sono utili, ma non vi dicono se il percorso critico delle query è ancora utilizzabile. Un buon SLI dovrebbe corrispondere a ciò che percepiscono i vostri utenti, anche se un'altra metrica è più facile da rappresentare in un grafico.
Gli SLO trasformano l'affidabilità in un contratto
I Service Level Objective, o SLO, definiscono l'obiettivo. Un esempio di DBRE stabilisce che la latenza delle richieste al 99° percentile, su una finestra di un minuto, resti tra 25 ms e 100 ms. Un obiettivo del genere sposta la conversazione da “il database sembra a posto” a “il servizio ha rispettato la soglia concordata?”.
Regola pratica: se uno SLO di database non può essere espresso in una frase, probabilmente è troppo vago per essere gestito operativamente.
La parte utile non è il numero esatto, è la disciplina. Gli SLO costringono team di prodotto, data engineer e responsabili della piattaforma a concordare cosa significhi “buono” prima dell'incidente. Questo riduce la solita discussione post-incidente in cui ognuno usa una definizione diversa di guasto, e dà agli strumenti di osservabilità un obiettivo concreto invece di un vago controllo di salute.
Gli error budget rendono onesti i compromessi
Un error budget è il margine tra l'affidabilità perfetta e una realtà accettabile. Se il servizio rientra ancora nel suo contratto, i team possono muoversi più velocemente. Se il budget si consuma troppo in fretta, il lavoro sull'affidabilità deve avere la precedenza. Questo compromesso è il senso stesso del modello.
Il ruolo della DBRE va oltre il semplice monitoraggio. Offre ai team un modo per decidere quando rilasciare e quando stabilizzare, usando ogni volta la stessa logica. Senza quel budget, ogni rilascio diventa un dibattito e ogni interruzione una sorpresa.
Un modo pratico per adottare il modello è partire da un percorso di query critico, definirne lo SLI, scrivere lo SLO e poi decidere cosa deve succedere quando il budget viene superato. Non cercate di coprire tutte le tabelle dal primo giorno. Partite da dove gli utenti soffrono, poi estendete il contratto man mano che il team diventa più bravo a gestirlo. Per i team che vogliono verificare queste ipotesi rispetto al comportamento reale del database, il test di integrità del database offre un modo concreto per controllare se il servizio corrisponde ancora al modello di affidabilità.
Implementare i pattern essenziali di affidabilità dei database
I database affidabili sono il risultato di pattern deliberati che limitano l'impatto dei guasti e rendono il ripristino prevedibile sotto carico. Il compromesso è chiaro: più ridondanza e automazione di solito significano più lavoro di progettazione all'inizio, ma riducono il caos quando il sistema è sotto pressione.
L'alta disponibilità protegge dai guasti di zona
Per i sistemi ad alto traffico, le linee guida DBRE indicano il deployment multi-AZ, i backup point-in-time automatizzati, i test di ripristino regolari e il connection pooling per evitare che i picchi di sessioni client facciano crollare il throughput (Medium). La logica è semplice. La ridondanza riduce il raggio d'impatto di un guasto di zona, mentre il pooling limita il numero di client che possono sovraccaricare il backend contemporaneamente.
Il costo operativo è reale. Le configurazioni multi-AZ richiedono più impegno di analisi rispetto a una singola istanza, e i percorsi di failover vanno esercitati prima che qualcuno ci faccia affidamento. L'alternativa è peggiore, perché un singolo dominio di guasto può trasformare un problema locale in un'interruzione totale.
Il connection pooling merita un'attenzione particolare. Un proxy come PgBouncer in modalità transaction pooling, o opzioni gestite come RDS Proxy e Cloud SQL Proxy, può ridurre il numero di connessioni attive al backend e proteggere il database dalle tempeste di connessioni. Questo non corregge un cattivo design delle query, ma impedisce che un picco di traffico diventi un collasso della capacità.
Il design del ripristino va dimostrato, non dato per scontato
I backup sono utili solo se i ripristini funzionano. Le esercitazioni di ripristino contano più dei messaggi di successo dei job di backup. Una guida DBRE raccomanda di definire prima RTO e RPO e poi scegliere la strategia, con esercitazioni di ripristino mensili e test di failover trimestrali come pratica di routine (Lawzava).
Gli obiettivi di ripristino dovrebbero guidare l'architettura fin dall'inizio, invece di essere un ripensamento.
Questo ordine conta perché sistemi di business diversi tollerano tipi di perdita diversi. Un'app consumer potrebbe accettare una breve finestra di ripristino, mentre un carico di lavoro regolamentato potrebbe richiedere controlli molto più rigorosi. Lo scopo è rendere le promesse di ripristino esplicite e verificabili, non copiare il design di qualcun altro.
Per i team che vogliono una checklist pratica per questo livello, la guida interna sul test di integrità del database si abbina bene a questo approccio. Rafforza la stessa idea operativa: dimostrare che i vostri dati possono essere ripristinati in modo pulito, non solo che i backup esistono.
Le architetture DBRE più solide sono noiose nel senso migliore del termine. Eseguono il failover in modo prevedibile, si ripristinano in modo pulito e impediscono che la pressione dei client abbatta l'intero servizio. È questo lo standard a cui puntare.
Gestire i cambiamenti in produzione in modo sicuro
La maggior parte degli incidenti sui database non sono guasti hardware spettacolari. Sono modifiche che sembravano innocue finché non hanno incontrato il traffico di produzione. Modifiche allo schema, aggiornamenti degli indici, script di migrazione e ordine di deployment possono tutti causare interruzioni quando non vengono trattati come lavoro di affidabilità.
Il cambiamento ha bisogno di protezioni prima che di velocità
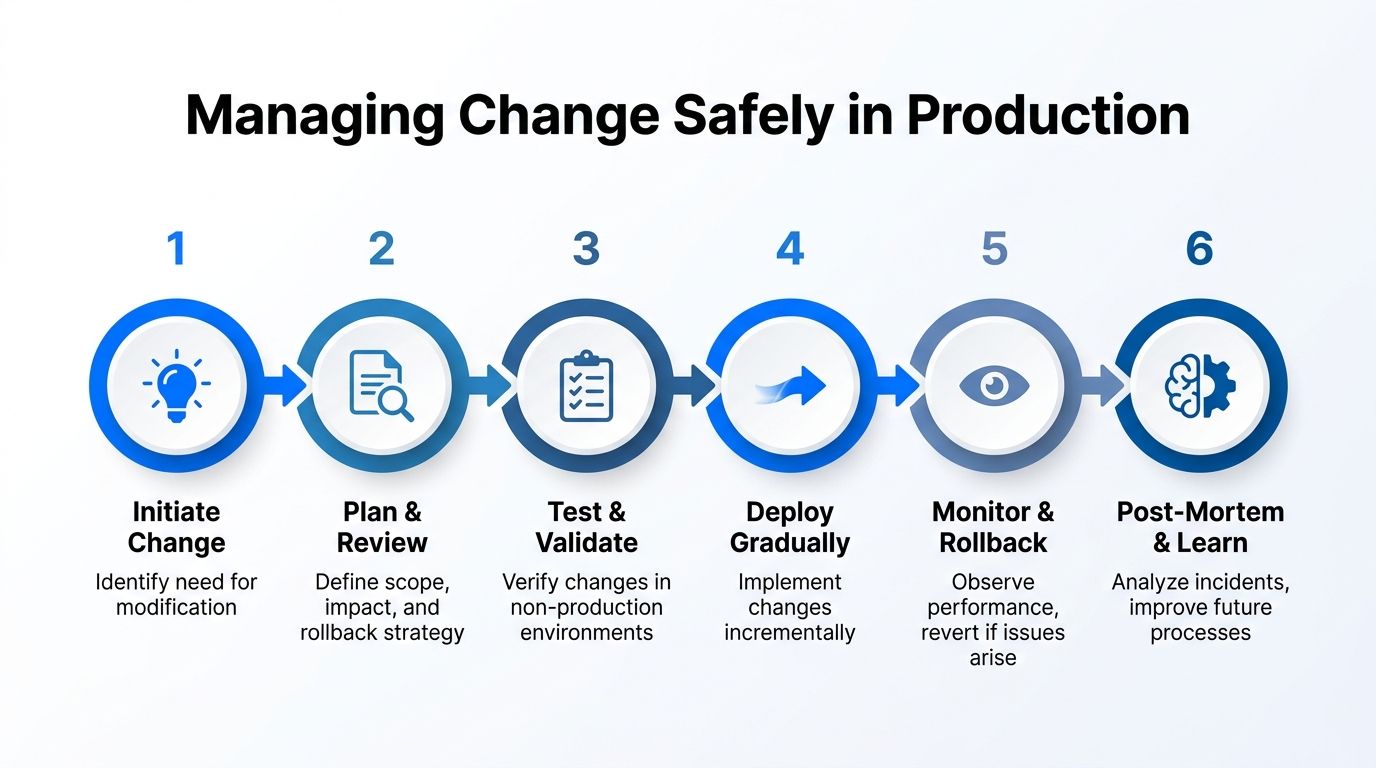
I team più sicuri non si chiedono se una migrazione sia ingegnosa. Si chiedono se possa essere portata avanti, annullata e osservata senza dover tirare a indovinare. Questo significa pianificare il perimetro, validare negli ambienti non di produzione, distribuire gradualmente e monitorare il risultato con un percorso di rollback già pronto.
Il lavoro sullo schema a zero downtime è un buon esempio. Se una modifica richiede lock esclusivi nel momento sbagliato, il rilascio potrebbe andare bene in staging ed essere disastroso con la concorrenza reale. Per questo la strategia di rollout conta quanto l'SQL stesso.
L'automazione elimina i punti di errore ripetitivi
Un principio centrale della DBRE è eliminare il toil automatizzando il lavoro manuale ripetitivo e soggetto a errori, come backup e ripristino (Optimadata). La stessa logica vale per i deployment. Se il team copia ancora gli script a mano, li modifica in produzione o si affida alla memoria collettiva per il rollback, il processo è già fragile.
Qui aiuta una semplice regola operativa.
Standardizzate i passaggi di deployment: usate lo stesso percorso di promozione per ogni rilascio, così gli ingegneri non devono inventare procedure sotto pressione.
Automatizzate le parti noiose: backup, ripristini e failover dovrebbero essere azioni di routine, non atti eroici.
Mantenete aggiornati i runbook: ogni alert dovrebbe rimandare a un runbook che corrisponde al sistema attuale, non all'architettura del trimestre scorso.
Testate le migrazioni in sequenza: validate modifiche allo schema, backfill dei dati e tempistiche di cutover prima che arrivino in produzione.
Il beneficio non è solo un minor numero di errori. L'automazione libera anche gli ingegneri senior, che possono concentrarsi sui miglioramenti dell'affidabilità che richiedono giudizio, come ridurre la contesa sui lock, riprogettare i passaggi di cutover o restringere le finestre di rollout sicuro.
Processo di rilascio e affidabilità devono fondersi
I team applicativi si aspettano già rollout sicuri, canary e deploy osservabili. I database meritano lo stesso trattamento. Se il processo di modifica del database dipende ancora da un singolo esperto che resta sveglio, il processo non è ancora affidabile.
È questa la mentalità DBRE nella pratica. Trattate il database come codice, ma non fingete che il database si comporti come codice. Ha uno stato, effetti collaterali e vincoli di ripristino che richiedono controlli propri. I team che rispettano questi vincoli rilasciano più velocemente, perché smettono di pagare il prezzo di incidenti evitabili.
Costruire un'osservabilità profonda per i database
Una dashboard può dirvi che un database è attivo. Un'osservabilità profonda vi dice se il servizio è ancora affidabile. Questo conta perché un host sano può comunque restituire query lente, risultati obsoleti o dataset a valle che in superficie sembrano corretti e poi falliscono in produzione.
I segnali dell'infrastruttura sono necessari ma non sufficienti
CPU, memoria, disco e rete contano ancora. Di solito sono i primi indizi che un sistema è sotto pressione. Non spiegano però perché un report è in ritardo, perché una join ha rallentato o perché lo stesso carico di lavoro si comporta diversamente dopo una modifica dei dati.
L'osservabilità a livello di dati colma questo divario. La ricerca sulla stabilità dei database mette in evidenza le “sorprese a livello di dati”, tra cui gli heavy hitter nelle join, i dati non uniformi o correlati e le semplici dimensioni dei dati, tutti fattori che possono destabilizzare le prestazioni anche quando l'infrastruttura sembra sana (report di Dagstuhl). Il server può sembrare a posto mentre il carico di lavoro diventa più difficile da servire.
Un hardware sano non garantisce un comportamento prevedibile delle query.
L'osservabilità deve includere i dati stessi
Uno stack di monitoraggio pratico dovrebbe includere i percentili di latenza delle query, il ritardo di replica, il throughput delle transazioni e la saturazione del connection pool. Questo offre una visione del comportamento del servizio che va oltre le semplici metriche sullo stato dell'host. Aiuta anche i team a individuare i cambiamenti prima che gli utenti si accorgano di un incidente.
Per i team che vogliono una visione orientata alla piattaforma, digna è un'opzione che monitora il comportamento dei dati, valida i record, traccia la tempestività, rileva le modifiche allo schema e osserva le metriche di business e di piattaforma all'interno dell'ambiente del cliente. Per approfondire questi pattern, leggete le tecniche di monitoraggio e auditing dei database che ogni azienda dovrebbe implementare. L'esecuzione nel database mantiene i dati al loro posto, facendo comunque emergere i segnali di affidabilità che gli strumenti di infrastruttura non colgono.
Questo approccio aiuta anche con lo schema drift e i problemi di freschezza. Se una tabella cambia forma o una pipeline arriva in ritardo, il primo segnale può comparire nel livello del database, prima che la dashboard del warehouse renda evidente il problema. I team che osservano presto questi segnali possono smettere di inseguire i sintomi quando il business ha già subito l'impatto.
L'obiettivo non è sommergere il team di grafici. È dare agli ingegneri reperibili abbastanza contesto per rispondere rapidamente a tre domande: cosa è cambiato, dove è cambiato e quale comportamento visibile agli utenti ne è stato influenzato? Una volta disponibili queste risposte, il database smette di essere una scatola nera.
Padroneggiare la risposta agli incidenti e i postmortem
Gli incidenti capitano anche nei sistemi ben gestiti. La domanda è se il team reagisce nel panico o segue un playbook che avvia rapidamente la mitigazione. La DBRE tratta gli incidenti come eventi operativi con un proprio ciclo di vita, il che aiuta il team a restare concentrato sul ripristino del servizio invece di perdersi nel rumore.
Partire da obiettivi di ripristino e da un playbook
Un'abitudine DBRE pratica è definire RTO e RPO prima dell'interruzione e poi scegliere la strategia di ripristino in base a questi obiettivi. Una guida raccomanda esercitazioni di ripristino e test di failover regolari per rendere il ripristino una pratica ripetibile (Lawzava). La cadenza esatta conta meno della disciplina che costruisce, perché un ripristino provato è molto più facile da eseguire sotto pressione di un piano che esiste solo sulla carta.
Quando scatta un alert, il primo passo è confermare l'impatto. Il servizio è non disponibile, degradato o sta solo generando alert rumorosi? Una volta chiarito il perimetro, l'ingegnere reperibile segue il runbook, verifica se il guasto riguarda i dati o l'infrastruttura e sceglie il percorso di mitigazione meno rischioso. La priorità è ripristinare prima il servizio e poi esaminare la causa principale a mente lucida.
La revisione senza colpe trasforma il dolore in cambiamento operativo
Un postmortem dovrebbe rispondere a cosa è successo, perché è successo e cosa il sistema deve fare diversamente la prossima volta. Dovrebbe stare lontano dalle colpe. Se nella catena compare un errore umano, di solito significa che il sistema ha reso troppo facile l'azione sbagliata o troppo difficile quella sicura.
Un formato di postmortem utile resta semplice.
Cronologia: registrate l'alert, i passaggi di mitigazione e il punto di ripristino.
Fattori concorrenti: individuate le lacune tecniche e di processo che hanno reso possibile l'incidente.
Causa sistemica: identificate la protezione, l'alert, il passaggio di automazione o il test mancante.
Azioni correttive: assegnate responsabili e scadenze per i controlli che riducono le recidive.
Questa struttura mantiene la discussione onesta senza renderla personale. Rende anche il risultato utile per la leadership di engineering, perché le azioni sono legate ai meccanismi dell'affidabilità invece che a un vago linguaggio di miglioramento.
I team migliori usano gli incidenti per rafforzare il proprio modello operativo. Chiudono i ticket, aggiornano il runbook, migliorano il percorso di ripristino o eliminano il passaggio manuale che ha causato il ritardo. È così che la DBRE trasforma un'interruzione in resilienza.
Scalare la DBRE con la data observability
Una volta che un team ha fatto funzionare la DBRE per un database, la sfida successiva è la scala. Le piattaforme dati enterprise comprendono store operativi, sistemi analitici, pipeline e livelli di reportistica. L'affidabilità deve estendersi a tutti questi elementi, altrimenti la fiducia nei dati si spezza da qualche parte nella catena.
L'affidabilità deve seguire il percorso dei dati
La DBRE moderna punta a livelli di affidabilità molto elevati: gli esempi del settore citano un uptime del 99,9995%, cioè meno di 2,6 minuti di downtime all'anno, e una risposta di failover in 2,7 secondi, ottenuti grazie all'automazione e a operazioni incentrate sull'affidabilità (iCEDQ). Queste cifre ricordano che l'obiettivo operativo non è più “disponibile la maggior parte del tempo”. È un servizio quasi continuo.
L'aspetto interessante è il modo in cui questi obiettivi si collegano alla data observability. Se una tabella del warehouse è in ritardo, uno schema cambia inaspettatamente o una metrica di business deriva, il problema potrebbe non essere affatto una classica interruzione del database. Potrebbe essere un guasto di affidabilità da qualche parte a monte o a valle. La DBRE vi dà la disciplina operativa, mentre la data observability fornisce le evidenze lungo tutta la pipeline.
La fiducia nasce dall'unione tra salute della piattaforma e comportamento dei dati
Su larga scala, i team devono vedere più dell'uptime degli host. Devono sapere se i dati sono freschi, se gli schemi sono stabili e se i pattern di utilizzo stanno diventando rischiosi. Ecco perché la DBRE funziona al meglio quando è abbinata a strumenti di data observability che monitorano il comportamento all'interno dell'ambiente del cliente, invece di guardare soltanto alla salute esterna del servizio.
digna si inserisce in questo modello come piattaforma che osserva anomalie, tempestività, validazione, modifiche allo schema e metriche di business all'interno dell'infrastruttura del cliente. Questo la rende utile per i team che vogliono collegare l'affidabilità dei database alla data quality e alla governance a valle senza spostare altrove i dati sensibili. In pratica, questo tipo di visibilità aiuta i team a individuare un feed rotto prima che una riunione sulle dashboard si trasformi in un'operazione di contenimento dei danni.
La lezione più ampia è semplice. La Database Reliability Engineering non riguarda più soltanto il mantenere online un'istanza. Riguarda la certezza che i dati alla base di analytics, operazioni e AI siano tempestivi, coerenti e affidabili. Se il vostro team di piattaforma, il gruppo di governance e gli analytics engineer vedono tutti gli stessi segnali di affidabilità, l'organizzazione smette di discutere su quale metrica sia giusta e inizia a risolvere il problema reale.
Se siete pronti a passare dalla gestione reattiva delle emergenze sui database a un modello di affidabilità misurabile, visitate digna e vedete come l'osservabilità nel database può aiutare il vostro team a tracciare il comportamento dei dati, le modifiche allo schema e la tempestività all'interno del vostro ambiente. È un modo pratico per collegare i principi della DBRE ai sistemi di dati da cui il vostro business dipende ogni giorno.
Domande frequenti
Che cos'è la database reliability engineering?
Un passaggio dalla protezione dell'uptime alla protezione della fiducia nei dati. Il guasto che conta non è più solo il database inattivo; è il database attivo che serve valori che una dashboard presenta poi come fatti.
Perché conta il passaggio dal ruolo di DBA?
Perché chiamare qualcuno DBA dice poco su come lavora. L'impostazione DBRE dà un nome alla pratica, e il vantaggio concreto è una responsabilità più chiara su quali risultati di affidabilità quella persona deve rispondere.
Perché una dashboard rotta sembra prima un problema di reportistica?
Perché è lì che diventa visibile. Il livello di reportistica è l'ultima fase, quindi raccoglie i sintomi di tutte le fasi precedenti, e l'indagine parte dal punto più lontano dalla causa.
Che cosa fa cedere il vecchio modello operativo?
La pressione. Un modello costruito attorno alla disponibilità regge finché il rischio principale è un'interruzione, e inizia a fallire quando il rischio più costoso diventa un sistema che continua a funzionare mentre fornisce silenziosamente valori sbagliati.
Che ruolo hanno gli SLO nella DBRE?
Trasformano l'affidabilità da un giudizio in un contratto. Uno SLO stabilisce cosa il database deve ai suoi consumatori, ed è questo che permette a un team di decidere se un incidente è una violazione o una fluttuazione accettabile.


