Cos'è un Open Table Format
|
10
min di lettura

Probabilmente siete qui perché il vostro data lake sembra già una tabella in uno strumento, ma si comporta come un mucchio di file in un altro.
Una dashboard finanziaria cambia a posteriori. Un backfill corregge una query e ne rompe un'altra. Le scritture Spark vanno a buon fine, Trino legge dati obsoleti e nessuno sa rispondere a una domanda elementare: quale versione di questo dataset è quella corretta? È il momento in cui si smette di chiedersi “quale formato di file dovremmo usare?” e si inizia a chiedersi che cos'è davvero un open table format?
La risposta breve è semplice. Un open table format è lo strato di metadati che fa comportare l'object storage come una tabella di database. La risposta lunga conta di più, perché il formato in sé è solo metà della storia. L'altra metà è il modo in cui il vostro team lo gestisce: compattazione, controllo dello schema, cataloghi e osservabilità.
Indice
Il momento in cui un data lake smette di essere affidabile
Un guasto tipico inizia così.
Il reparto finanza controlla il report sui ricavi di ieri e vede che non corrisponde più alla dashboard. Nessuna pipeline è in rosso. Nessun orchestratore mostra un task fallito. I file sono ancora nell'object storage. Ma da qualche parte tra un'aggiunta in streaming e un job di manutenzione, i lettori hanno ottenuto una vista parziale della tabella.
Perché lo storage grezzo si rompe in modi sottili
L'object storage è ottimo per conservare file. Da solo, però, non è un sistema di tabelle.
Se salvate dei file Parquet in una cartella e la chiamate revenue, non avete ancora risposto alle domande che interessano agli analisti:
Quali file appartengono alla tabella in questo momento
Quale scrittura ha prodotto la versione attuale
Quale schema deve usare un lettore
Com'era la tabella la settimana scorsa
Quali file si possono ignorare senza rischi durante una query
Senza quello strato di metadati, ogni engine deve dedurre lo stato dagli elenchi delle directory e dai nomi dei file. Per un po' funziona. Poi qualcuno riscrive le partizioni, compatta i file o cambia il tipo di una colonna, e i lettori iniziano a vedere verità diverse nello stesso percorso di storage.
I file grezzi possono memorizzare i dati correttamente e produrre comunque analisi inaffidabili.
Lo strato mancante
Un open table format aggiunge, accanto ai dati, la registrazione dello stato della tabella che mancava. Invece di trattare lo storage come “qualunque file si trovi sotto questo prefisso”, registra una vista governata della tabella: file correnti, snapshot storici, schema e metadati di layout.
Ecco perché i team che investono nel monitoraggio del data lake scoprono spesso lo stesso schema. Il problema di solito non è solo una scrittura di file fallita. È che la piattaforma non dispone di un modo affidabile per descrivere lo stato della tabella a lettori e scrittori.
La differenza sembra piccola fino alla prima incoerenza silenziosa. Da quel momento in poi diventa fondamentale.
Che cosa fa davvero un open table format
Una nuova pipeline deposita file sostitutivi per revenue. Il job Spark termina. Un analista aggiorna una dashboard in Trino. Un job di feature per il machine learning legge la stessa tabella tramite un altro engine. Tutte e tre le query colpiscono lo stesso percorso di storage, ma non sempre vedono la stessa risposta.
È proprio questo divario che un open table format è progettato per colmare.
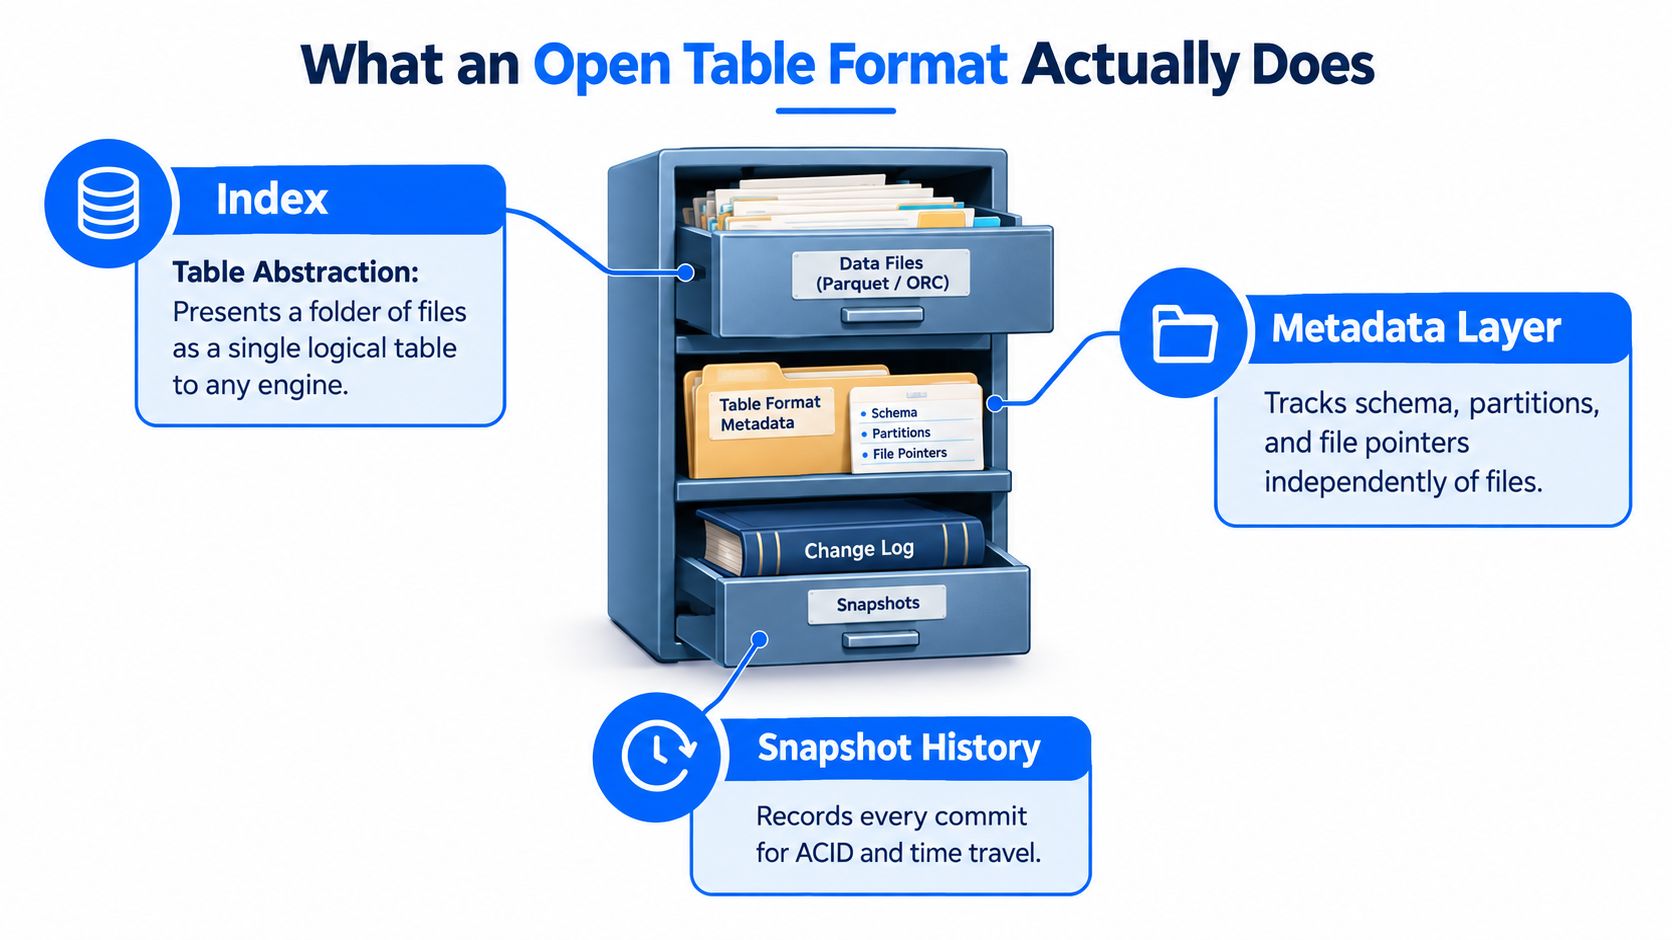
Si colloca sopra i file e definisce lo stato della tabella
Gli open table format vengono spesso confusi con i formati di file perché entrambi compaiono nello stesso bucket di storage. Risolvono però problemi diversi.
Parquet, ORC e Avro definiscono come un singolo file memorizza righe e colonne. Un open table format definisce come un insieme di file diventa un'unica tabella logica che molti engine possono leggere e scrivere in modo sicuro. Databricks descrive gli open table format come uno strato di metadati sopra Parquet, ORC o Avro nell'object storage, che aggiunge funzionalità da tabella come transazioni ACID, evoluzione dello schema e time travel, nella sua panoramica sugli open table format.
Se la distinzione vi sembra ancora sfumata, questa guida su che cos'è Parquet e come memorizza i dati colonnari può aiutarvi. Parquet risponde a "come è codificato questo file?" Un table format risponde a "quali file compongono la tabella e di quale versione devono fidarsi i lettori?"
Il formato funge da control plane della tabella
Un modello mentale utile è una cronologia Git per i file di dati, con regole più rigorose su concorrenza e schema. Il table format tiene traccia dello stato attuale e del percorso che lo ha prodotto. I query engine non devono scansionare cartelle e tirare a indovinare. Possono leggere i metadati della tabella e ottenere una risposta esatta.
In pratica, quello strato di metadati svolge quattro compiti.
Dichiarare l'appartenenza dei file
Il formato registra quali file appartengono alla tabella in questo momento. Se la compattazione riscrive dieci file piccoli in un unico file più grande, i lettori seguono il puntatore nei metadati verso l'insieme valido invece di mescolare dati vecchi e nuovi.Pubblicare gli snapshot in modo atomico
Una scrittura diventa visibile come nuovo snapshot confermato. I lettori vedono la versione vecchia o quella nuova, non uno stato intermedio in cui metà dei file è cambiata.Tracciare lo schema come metadato della tabella
Nomi delle colonne, tipi, ID dei campi e modifiche consentite risiedono nella definizione della tabella, non solo in ciò che uno scrittore ha emesso per caso. Questo conta quando engine diversi iniziano a rinominare colonne, ampliare tipi o aggiungere campi annidati.Memorizzare metadati di layout e di pruning
Valori di partizione, statistiche dei file e talvolta metadati di eliminazione aiutano gli engine a saltare i file irrilevanti e a pianificare le query in modo efficiente.
Lo strato operativo è la parte che i team sottovalutano di solito
L'elenco delle funzionalità è la parte facile. È il modello operativo a dimostrare il vero valore degli open table format.
Una volta che un formato gestisce lo stato della tabella, il vostro team deve decidere chi è responsabile della compattazione, chi approva le modifiche allo schema e quale catalogo è la fonte di verità. Sono domande di produzione, non da brochure di prodotto. Se nessuno si occupa della compattazione, i file piccoli si accumulano e le prestazioni delle query peggiorano. Se ogni scrittore può modificare lo schema liberamente, un solo deployment sbagliato può rompere i lettori a valle. Se Spark usa una vista del catalogo e Trino un'altra, siete di nuovo a più verità, solo con un branding migliore.
Il formato vi dà i meccanismi. Il vostro team di piattaforma ha comunque bisogno di regole.
Perché il cambiamento conta nel lavoro quotidiano
Senza un table format, scrivere dati spesso significa "i file sono stati caricati". Con un table format, scrivere dati significa "una nuova versione della tabella è stata confermata e pubblicata".
È un contratto più solido per ogni sistema a valle. Job batch, query BI e lettori in streaming possono concordare sullo stato della tabella. Gli engine possono interoperare tramite metadati condivisi invece che tramite convenzioni sui percorsi di storage. I data engineer possono ragionare sulle attività di manutenzione, come la compattazione o l'evoluzione delle partizioni, senza trattare ogni riscrittura come un potenziale disservizio.
Un open table format, quindi, è lo strato che trasforma l'object storage in un sistema di tabelle che le persone possono gestire con fiducia. Il formato di file conta ancora. Il vantaggio nascosto è che i metadati danno al vostro team un modo controllato per mantenere coerente lo stato della tabella man mano che scritture, schemi ed engine si moltiplicano.
Come il formato si è evoluto da Hive al lakehouse
La storia conta perché ogni formato è nato per risolvere un problema specifico, non per vincere una matrice di funzionalità.
Una cronologia utile tratta da la storia e l'evoluzione degli open table format colloca Apache Hive nel 2008, Apache Hudi nel 2016, Apache Iceberg nel 2017 e Delta Lake tra il 2017 e il 2019. Questa sequenza mostra quanto rapidamente lo strato di tabelle del lakehouse sia maturato una volta che i team hanno raggiunto i limiti dei primi modelli di data lake.

Hive ha risolto il problema di un'epoca
Hive ha dato ai primi team Hadoop un modo per trattare i file su HDFS come tabelle. Il suo modello di partizionamento si basava molto sulla struttura delle directory. Era coerente con le ipotesi dell'epoca.
Quelle ipotesi sono invecchiate male nell'object storage cloud. Il partizionamento basato sulle directory è diventato fragile. Il comportamento di listing e rename non era quello di HDFS. Le tabelle di lunga durata diventavano scomode quando le strategie di partizionamento cambiavano.
L'ondata successiva ha corretto modalità di guasto concrete
Ogni formato più recente ha risposto a una diversa debolezza operativa.
Apache Hudi è nato nel 2016 per supportare carichi di lavoro che richiedevano upsert a livello di record ed elaborazione incrementale in ambienti data lake.
Apache Iceberg è arrivato nel 2017 per affrontare i problemi legati a grandi tabelle analitiche, alla scalabilità dei metadati e all'evoluzione delle partizioni.
Delta Lake ha preso forma tra il 2017 e il 2019 come approccio basato su transaction log per portare un comportamento affidabile di tipo ACID sullo storage aperto.
A quel punto, il settore era passato da “come mettiamo i file in un lake?” a “come possono più engine condividere tabelle affidabili su storage economico?”
Il nome lakehouse è arrivato dopo la svolta ingegneristica
Prima è arrivata la svolta architetturale. L'etichetta lakehouse è venuta dopo.
Se volete il contesto più ampio dello stack attorno a formati, cataloghi, engine e governance, questa guida su che cos'è un lakehouse e come mantenere la qualità dei dati offre la visione d'insieme. Il punto importante qui è più circoscritto: gli open table format sono diventati lo strato che ha reso tecnicamente credibili le promesse del lakehouse.
Tra il 2025 e il 2026, quello strato è maturato ulteriormente. La stessa cronologia osserva che la specifica di tabella v3 di Iceberg è stata ratificata nel 2025, e Iceberg 1.10 e 1.11 hanno introdotto il supporto stabile a funzionalità quali deletion vector, tipi variant, tipi geospaziali e timestamp al nanosecondo in questa fase più recente dell'evoluzione del formato.
Iceberg, Delta Lake e Hudi a confronto
La scelta di un formato di solito sembra semplice in fase di valutazione. Poi arriva la produzione, un job in streaming resta indietro, i file piccoli si accumulano, due engine non concordano sulle modifiche allo schema e sorge la domanda: chi è responsabile della manutenzione delle tabelle, e quanto è prevedibile quel lavoro?
Apache Iceberg, Delta Lake e Apache Hudi sono tutti table format pronti per la produzione. Il confronto utile non riguarda solo la parità di funzionalità, ma il modo in cui ciascun formato organizza i metadati, coordina le scritture e assegna la responsabilità delle attività operative come compattazione, pulizia e compatibilità tra engine.
La differenza principale è l'architettura dei metadati
I file possono trovarsi tutti nell'object storage, ma ogni formato tiene l'"indice" della tabella in modo diverso. La panoramica di Dremio sull'architettura di Iceberg, Delta Lake e Hudi è un buon punto di riferimento:
Delta Lake registra le modifiche alla tabella in un transaction log sequenziale sotto
_delta_log.Iceberg traccia lo stato della tabella tramite metadati di snapshot e file manifest che descrivono quali file di dati appartengono a ciascuna versione.
Hudi mantiene una timeline di azioni, che include commit e operazioni di manutenzione come compattazione, clustering e pulizia.
Questa scelta progettuale incide su molto più delle prestazioni di lettura. Cambia la velocità con cui crescono i metadati, la sicurezza con cui più engine possono scrivere, il modo in cui vengono gestite le modifiche alle partizioni e quanta cura ordinaria la tabella richiede al vostro team.
Iceberg vs Delta Lake vs Hudi in sintesi
Dimensione | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Design dei metadati | Metadati di snapshot con manifest list e manifest | Transaction log sequenziale in | Timeline di istanti immutabili che copre scritture e servizi di tabella |
Modello di partizionamento | Partizionamento nascosto ed evoluzione delle partizioni, così lo schema di partizionamento logico può cambiare senza riscrivere i file più vecchi | Il comportamento delle partizioni è gestito tramite lo stato della tabella tracciato nel log e le convenzioni degli scrittori | Progettato attorno a layout orientati all'ingestione, con servizi per riorganizzare i file nel tempo |
Stile di concorrenza | Modello di snapshot isolation incentrato su versioni della tabella e scambi di metadati | Protocollo di commit basato su log con modelli di concorrenza ottimistica | Protocollo di commit basato su timeline, spesso abbinato a servizi in background |
Ideale per | Tabelle analitiche condivise tra più engine | Piattaforme incentrate su Spark, soprattutto dove gli strumenti nativi Delta fanno parte delle operazioni quotidiane | Upsert frequenti, change capture ed elaborazione incrementale |
Compromesso principale | Forte interoperabilità, ma la disciplina del catalogo è importante e le regole di scrittura tra engine devono essere esplicite | I modelli operativi sono spesso più semplici dove Spark e gli strumenti compatibili con Delta definiscono lo standard | La flessibilità di scrittura è elevata, ma la responsabilità di compattazione e clustering richiede una pianificazione attiva |
Approccio all'interoperabilità | Ampio supporto tra engine e cataloghi. La specifica di Apache Iceberg è uno dei motivi per cui molti team la considerano l'opzione più neutrale per le tabelle condivise | Forte eredità Spark, con una compatibilità crescente nel resto dell'ecosistema | L'interoperabilità è migliorata, ma le ipotesi operative tendono ancora a essere più orientate all'ingestione che neutrali rispetto agli engine |
Un criterio di scelta migliore: chi gestirà la tabella
Se un team confronta solo le caselle di controllo, i tre formati possono sembrare simili. Nella pratica, generano un lavoro di reperibilità diverso.
Iceberg si adatta spesso alle organizzazioni che vogliono che una tabella sia letta da diversi engine e governata tramite uno strato di catalogo. Il vantaggio è la portabilità. Il costo è la disciplina. Modifiche allo schema, scelte dell'ordinamento, dimensionamento dei file, conservazione degli snapshot e coerenza del catalogo richiedono tutti una responsabilità chiara, soprattutto quando più di un motore di calcolo può scrivere.
Delta Lake si adatta spesso a piattaforme già incentrate su workflow Spark e strumenti compatibili con Delta. Il percorso operativo può essere lineare perché il modello transazionale e gli strumenti circostanti sono strettamente allineati. Il compromesso è che la strategia di interoperabilità diventa più importante nel tempo se la piattaforma si espande oltre le ipotesi dell'engine originale.
Hudi si adatta spesso a sistemi orientati all'ingestione, in cui aggiornamenti a livello di record e consumo incrementale fanno parte del design di base. Questo punto di forza comporta servizi di tabella più visibili. Compattazione, clustering e pulizia non sono dettagli secondari. Qualcuno deve pianificarli, monitorarli e decidere quando la latenza di scrittura conta più del layout di lettura.
È anche qui che il lavoro sull'affidabilità smette di essere separato da quello sulla qualità. Un job di compattazione in ritardo, una modifica allo schema non revisionata o un engine che scrive con le impostazioni di catalogo sbagliate possono creare incidenti che gli analisti percepiscono come "dati errati". I team che gestiscono piattaforme Spark-first valutano spesso la scelta del formato insieme alle pratiche di gestione della qualità dei dati su Databricks, perché la correttezza delle tabelle e i controlli di qualità dei dati si incontrano nello stesso workflow di produzione.
Il formato sbagliato raramente fallisce durante una demo. Fallisce durante l'attività di manutenzione che il vostro team pensava si sarebbe gestita da sola.
ACID, time travel ed evoluzione dello schema spiegati
Un table format inizia a sembrare concreto la prima volta che qualcosa va storto in produzione. Una pipeline scrive metà dei suoi file, fallisce sul resto, e un analista aggiorna una dashboard proprio nel momento sbagliato. Senza controllo transazionale, il lake espone direttamente quel caos. Con un open table format, i lettori continuano a vedere l'ultimo stato valido della tabella finché il nuovo non è stato confermato completamente.
ACID significa che la tabella ha un punto di commit chiaro
Il vantaggio pratico di ACID in un lakehouse è semplice. I lettori non vedono lavoro lasciato a metà.
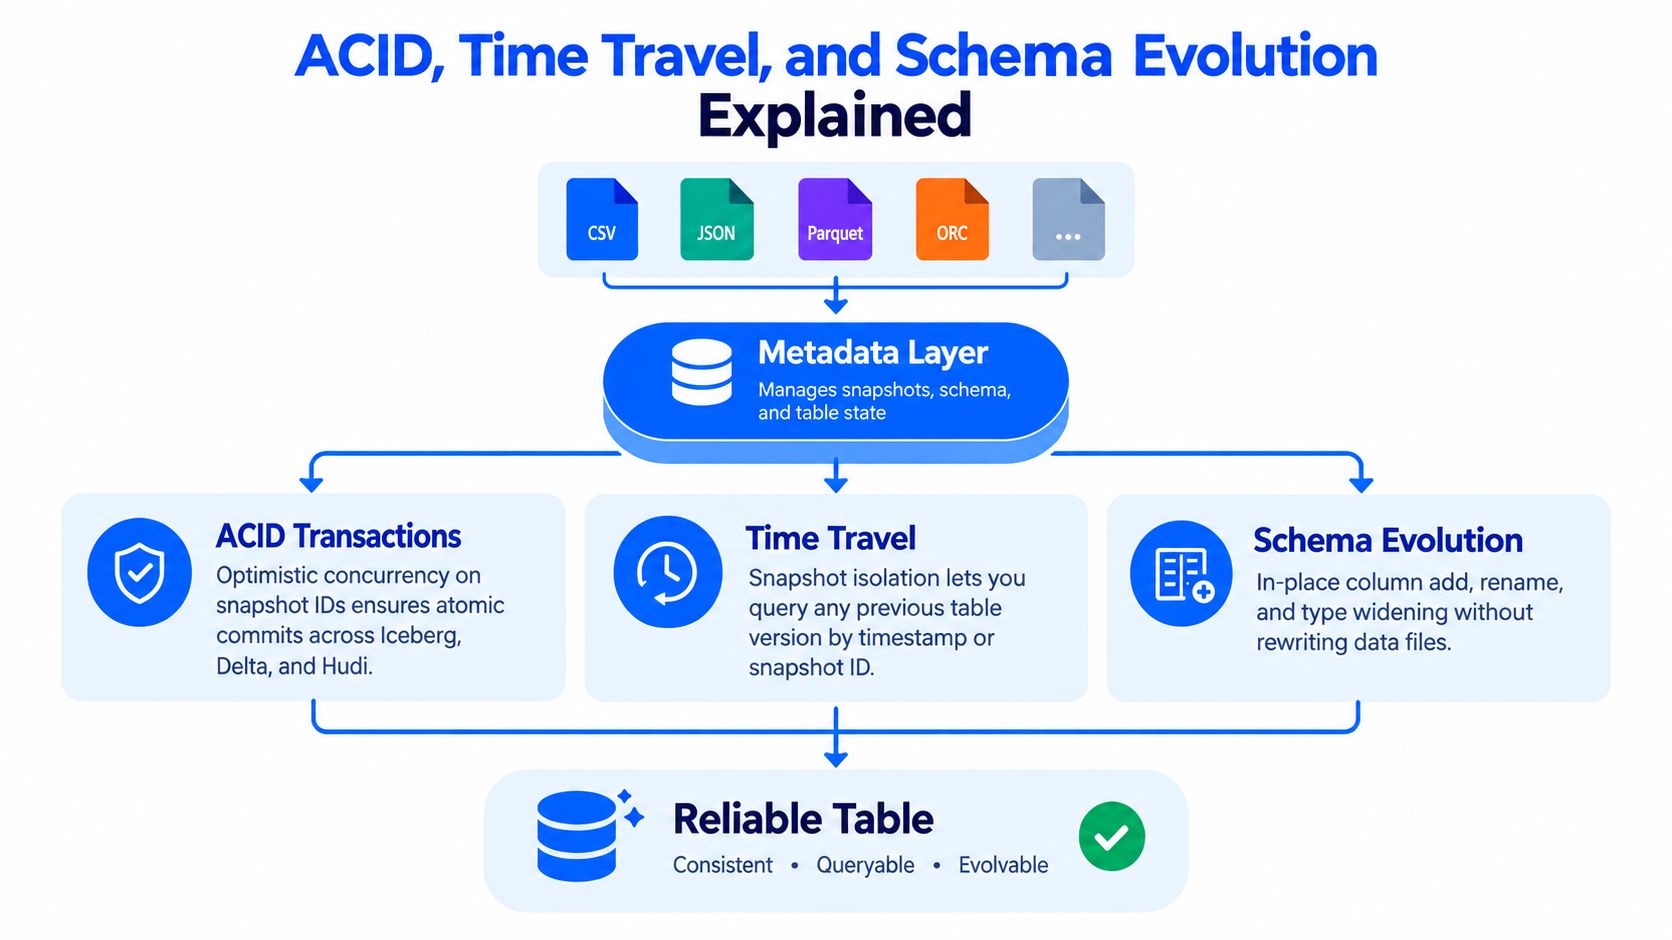
Dietro le quinte, questi formati pubblicano le modifiche tramite commit dei metadati. I file di dati possono già esistere nell'object storage, ma non diventano parte della tabella finché la nuova versione dei metadati non viene accettata. Questo vi offre il comportamento che i team di dati si aspettano da un database, anche se lo storage sottostante è ancora fatto di file in un lake.
In pratica, questo significa che:
un job batch può pubblicare un aggiornamento completo come un unico commit atomico
un job in streaming può continuare ad aggiungere dati mentre i lettori restano su uno snapshot coerente
una scrittura fallita può lasciare dietro di sé file orfani, ma non diventare la verità della tabella
gli scrittori concorrenti hanno bisogno di regole sui conflitti, logica di retry e coordinamento del catalogo per non pestarsi i piedi a vicenda
Quest'ultimo punto è facile da sottovalutare. ACID non è solo una funzionalità per i lettori. È anche un meccanismo di controllo per più scrittori, e i dettagli operativi variano in base a formato, engine e configurazione del catalogo.
Il time travel è il modo in cui i team eseguono il debug e riproducono gli stati dei dati
Time travel significa che la tabella può esporre versioni confermate precedenti, non solo quella attuale. Sembra una funzionalità di comodo finché un report non cambia dopo un backfill, o un job di eliminazione non rimuove più record del previsto.
Se avete lavorato con i dati storici in Snowflake, il modello mentale è simile. Interrogate uno stato precedente della tabella invece di ripristinare i file grezzi da un backup.
La domanda utile non è "il formato supporta il time travel?" La domanda utile è "per quanto tempo conserviamo la cronologia, chi controlla la conservazione e cosa succede quando viene eseguita la pulizia dello storage?" I team spesso celebrano le letture storiche durante la valutazione, per poi scoprire più tardi che una scadenza aggressiva degli snapshot ha eliminato proprio la versione di cui avevano bisogno per un audit o per l'analisi di un incidente.
Il time travel è affidabile solo quanto la policy di conservazione che lo sostiene.
L'evoluzione dello schema separa il cambiamento controllato dalle rotture accidentali
L'evoluzione dello schema consente a una tabella di cambiare forma nel tempo senza imporre la riscrittura completa di ogni vecchio file. Di solito include l'aggiunta di colonne nullable, la gestione di alcune promozioni di tipo e, in alcuni formati, il supporto alla ridenominazione delle colonne tramite un'identità stabile dei campi anziché la posizione grezza della colonna.
La funzionalità sembra permissiva. L'uso in produzione dovrebbe essere l'opposto.
Un processo sicuro di modifica dello schema risponde ad alcune domande precise:
Chi può approvare una modifica allo schema in produzione
Quali engine sono autorizzati a scrivere il nuovo schema
Se i lettori a valle sono in grado di gestire la modifica
Come le modifiche alle partizioni influiscono sui job e sulle ipotesi esistenti
Se il catalogo interpreterà il nuovo schema allo stesso modo in tutti gli strumenti
È qui che i team guadagnano flessibilità oppure creano lavoro di pulizia che dura a lungo. Una ridenominazione di colonna può essere valida a livello di formato e rompere comunque estrazioni BI, modelli dbt o codice di ingestione che faceva riferimento al vecchio nome. Un ampliamento di tipo può superare la validazione in scrittura e cambiare comunque il comportamento dei join o la gestione dei null a valle.
L'evoluzione dello schema è una capacità del formato. La governance dello schema è una decisione operativa.
Lo stesso schema vale anche per ACID e time travel. Il formato fornisce il meccanismo. L'affidabilità deriva dalla responsabilità: chi approva le modifiche, chi regola la conservazione, chi pulisce i file e chi decide quali engine sono autorizzati a scrivere.
La vera domanda dopo l'adozione
Un lakehouse di solito sembra in salute subito dopo la prima scrittura riuscita. Le query girano. Il time travel funziona. Tutti spuntano l'elenco delle funzionalità e passano oltre.
Poi iniziano le domande operative. Quale catalogo è la fonte di verità. Quali engine sono autorizzati a scrivere. Chi esegue la compattazione. Chi approva modifiche allo schema tecnicamente valide ma rischiose per i job a valle. Queste decisioni determinano l'affidabilità quotidiana più della sola scelta del formato di file.
Il catalogo detta le regole del gioco
Un open table format definisce come metadati della tabella e file di dati si combinano. Il catalogo decide come i sistemi trovano quella tabella, coordinano le modifiche e applicano le policy. In pratica, il catalogo funziona come il controllo del traffico aereo del lakehouse. Gli aerei possono essere costruiti tutti correttamente, ma serve comunque un unico punto che coordini decolli, atterraggi e cambi di rotta.
L'analisi di Uplatz su convergenze e divergenze degli open table format evidenzia il ruolo crescente di progetti di traduzione e interoperabilità come Apache XTable, l'output Iceberg nativo di Hudi e Delta Lake UniForm. Sottolinea anche una realtà di produzione che sfugge nei confronti tra formati. Molte aziende utilizzano più di un formato, e l'interoperabilità dipende ancora fortemente dal supporto degli engine, dal comportamento del catalogo e dai vincoli specifici del cloud.
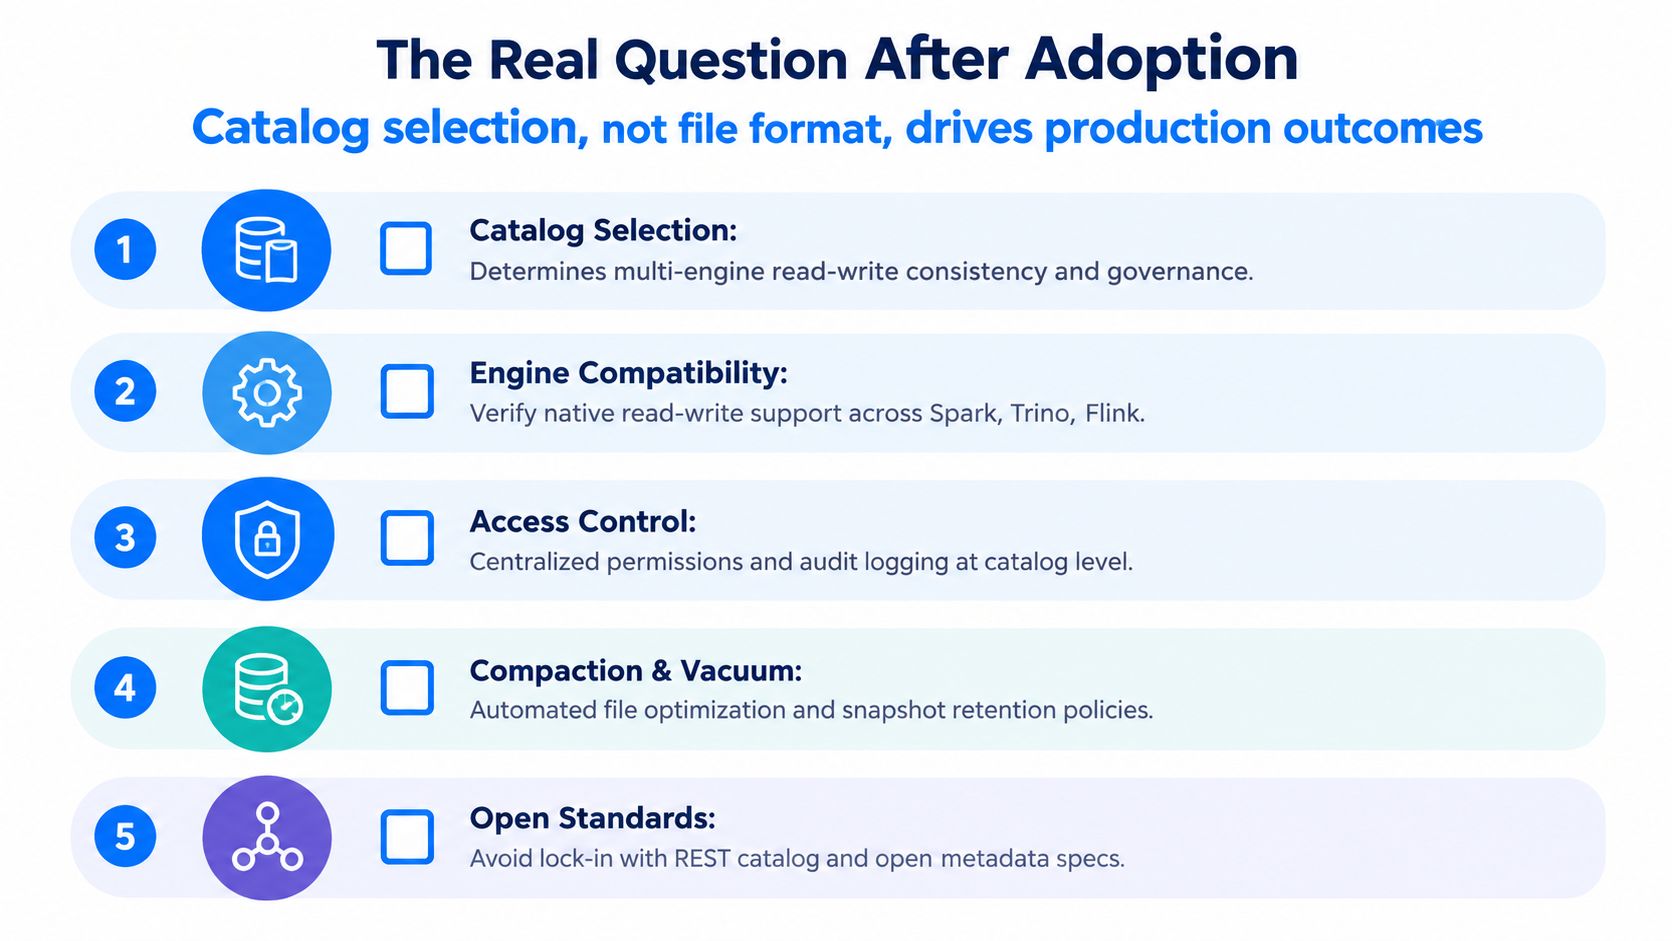
Ecco perché la stessa tabella Iceberg, Delta Lake o Hudi può sembrare prevedibile in una configurazione e fragile in un'altra. Un catalogo REST, Glue, Hive Metastore, Nessie, Polaris o un control plane gestito dal fornitore differiranno per discovery, permessi, modelli di branching, coordinamento delle scritture e gestione dei guasti.
La responsabilità della compattazione diventa un modello operativo
La compattazione sembra una manutenzione in background. In produzione è più simile a una garbage collection unita al tuning degli indici. Fatta bene, mantiene ragionevole la pianificazione delle query e stabili le prestazioni di lettura. Fatta male, consuma tempo di cluster, entra in conflitto con i carichi di ingestione e crea lavoro di pulizia dopo le riscritture fallite.
Qualcuno deve essere responsabile di:
Cadenza della compattazione
Scelte di ordinamento e clustering
Pulizia e conservazione degli snapshot
Passaggi di rollback quando la manutenzione peggiora le cose
Rilevamento dei file orfani
Non sono caselle da spuntare nel formato. Sono job ricorrenti con modalità di guasto, compromessi di costo e chiare esigenze di responsabilità. Un'analisi franca di Shirokoff sugli open table format lo dice esplicitamente, segnalando overhead dei metadati, lavoro di manutenzione, costi della curva di apprendimento e una governance disomogenea tra gli strumenti.
L'affidabilità dipende da chi controlla il cambiamento
I team di produzione imparano anche che la governance raramente risiede solo nei file della tabella. Mascheramento delle colonne, controlli a livello di riga, audit trail e tagging dei dati PII dipendono di solito dal catalogo e dai query engine che li applicano in modo coerente.
I team che mantengono affidabili queste tabelle osservano lo strato dei metadati come il control plane di un'applicazione. Monitorano l'età degli snapshot, i commit falliti, il numero di file, i file orfani, il ritardo della manutenzione e quale scrittore ha modificato per ultimo lo stato della tabella. I team che osservano solo lo stato dell'object storage spesso non colgono i segnali d'allarme precoci. Il bucket sembra a posto mentre la tabella diventa sempre meno affidabile.
Un piano di rollout pratico per i team di data engineering
Un rollout pulito parte in piccolo, ma non dovrebbe partire in modo vago. Vi serve un progetto pilota che faccia emergere presto i limiti operativi.
La fase 1 sceglie il control plane
Scegliete prima il catalogo. Il layout dei file conta, ma è il catalogo a decidere come gli engine scoprono le tabelle, coordinano le scritture e applicano le policy.
Valutate opzioni come cataloghi orientati a REST, configurazioni in stile Hive Metastore e cataloghi cloud-native ponendovi domande pratiche:
Quali engine devono leggere e scrivere in modo nativo
Dove risiederanno la titolarità delle tabelle e i permessi
Come verranno revisionate le modifiche allo schema
Cosa succede se il catalogo non è disponibile
Se saltate questo passaggio, spesso dovrete ricostruirlo più tardi sotto pressione.
La fase 2 definisce la baseline di sicurezza e governance
Prima di un'adozione su larga scala, definite il contratto operativo minimo.
Di solito include SSO, RBAC, crittografia in transito e a riposo, identità di servizio controllate e una policy per le restrizioni su righe o colonne dove necessario. Include anche le aspettative di lineage, il tagging dei dati PII e i percorsi di approvazione per le modifiche allo schema.
Uno strumento utile in questa fase è digna, che viene eseguito nell'ambiente del cliente e monitora il comportamento dei dati, la tempestività, la validazione dei record, le modifiche allo schema e le metriche di piattaforma su lake, warehouse e pipeline. Per gli open table format questo è importante, perché i problemi di affidabilità si manifestano spesso prima come snapshot obsoleti, schema drift, scritture in ritardo o anomalie nelle metriche di business, piuttosto che come guasti evidenti delle pipeline.
La fase 3 mette alla prova il percorso di scrittura sotto stress
Non validate l'architettura con un unico batch giornaliero.
Usate un dataset pilota con più scrittori giornalieri, almeno un workflow di manutenzione e un query engine diverso dall'engine di scrittura principale. Includete nella prova un job di partizionamento nascosto o di ottimizzazione del layout, così il vostro team dovrà gestire modifiche agli snapshot, effetti della compattazione e decisioni di rollback in condizioni realistiche.
Un buon progetto pilota dovrebbe sollevare alcune domande scomode. Chi approva le modifiche allo schema? Chi viene allertato per i commit falliti? Quali lettori sono ammessi durante le finestre di manutenzione? Sono proprio i problemi giusti da far emergere presto.
La fase 4 strumenta lo strato dei metadati
Il solo monitoraggio dello storage non vi dirà abbastanza.
Monitorate segnali come:
Età degli snapshot per la freschezza dello stato pubblicato della tabella
Ritardo della compattazione, affinché la proliferazione dei file non degradi le prestazioni
Modelli di errore degli scrittori tra i vari engine
Eventi di schema drift prima che le dashboard a valle si rompano
Crescita dei file orfani dopo retry od operazioni interrotte
Se non riuscite a vedere lo stato di salute del percorso dei metadati della tabella, state operando soprattutto sulla speranza.
Gli open table format risolvono il problema dello strato di tabelle, ma non eliminano la necessità di operazioni disciplinate. digna aiuta i team a monitorare modifiche allo schema, tempestività, anomalie e comportamento della piattaforma all'interno del proprio ambiente, il che corrisponde alle modalità di guasto che emergono dopo l'adozione del lakehouse. Se le vostre tabelle coinvolgono già più engine e job di manutenzione, vale la pena vedere come digna può aiutarvi a sorvegliare lo strato di affidabilità guidato dai metadati, non solo i file sottostanti.
I team che effettuano il rollout su Databricks di solito aggiungono l'osservabilità per la piattaforma Databricks nella stessa fase, così le garanzie a livello di tabella e i controlli a livello di valore arrivano insieme.
Domande frequenti
Come si sono evoluti i table format a partire da Hive?
Hive definiva una tabella come un layout di directory, quindi le partizioni erano cartelle e l'elenco dei file era la fonte di verità. Questo modello è crollato sull'object storage, dove i listing sono lenti ed eventualmente consistenti. I formati moderni hanno spostato la definizione della tabella nei file di metadati, eliminando del tutto la dipendenza dalla struttura delle directory.
Che cosa significa ACID per una tabella di un data lake?
Significa che una scrittura diventa visibile per intero oppure per niente, e che i lettori concorrenti non vengono mai esposti a una modifica in corso. In un lake questa garanzia deriva dallo scambio atomico di un puntatore nei metadati, non dal transaction log di un database, ed è per questo che funziona su un semplice object storage.
È possibile modificare lo schema di una tabella senza riscriverla?
Sì. Aggiungere, eliminare, rinominare o riordinare colonne viene registrato nei metadati e applicato in fase di lettura, quindi i file di dati esistenti restano intatti. Il problema è che i lettori devono implementare le stesse regole: un engine con supporto parziale può restituire valori null per una colonna rinominata invece di generare un errore.
Perché un lake si comporta come una tabella in uno strumento e come un mucchio di file in un altro?
Perché la garanzia risiede nello strato dei metadati, e solo gli engine che leggono quello strato ne beneficiano. Uno strumento puntato direttamente sui file Parquet sottostanti aggira completamente la cronologia dei commit e vede qualunque cosa si trovi nello storage, compresi i file di una scrittura mai confermata.
Come si presenta un rollout ragionevole?
Convertite prima una tabella ben conosciuta, mantenete in parallelo la scrittura originale e spostate gradualmente i consumatori confrontando gli output. Concordate chi è responsabile della scadenza degli snapshot e della compattazione prima del go-live, perché una manutenzione senza responsabile è il motivo più comune per cui un pilota riuscito si degrada nel trimestre successivo.


