Che cos'è la data observability
|
6
min di lettura
Una dashboard può essere tecnicamente disponibile e al tempo stesso inutile dal punto di vista operativo.
È la situazione in cui si trovano oggi molti team. La pipeline è stata eseguita. Il data warehouse è attivo. La BI si carica senza errori. Poi qualcuno nota che a mezzogiorno i ricavi sono piatti, che mancano gli ordini di ieri o che una colonna chiave ha cambiato tipo durante la notte, rompendo inaspettatamente un modello a valle. Nulla sembrava fuori servizio, eppure il business stava già prendendo decisioni sulla base di dati errati.
È in questo divario tra l'uptime dei sistemi e la fiducia nei dati che la data observability diventa importante. Se la vostra azienda usa i dati per allocare il budget, gestire le operations, supportare la compliance o alimentare sistemi di IA, l'osservabilità smette di essere un livello di ingegneria opzionale. Diventa parte della continuità operativa.
Indice
Perché la fiducia nei dati è più fragile che mai
I guasti silenziosi mettono a rischio la continuità operativa
Le correzioni reattive non scalano
Che cos'è esattamente la data observability
Il monitoraggio intercetta i guasti noti
L'osservabilità aiuta a capire il perché
I cinque pilastri della data observability
Freschezza e tempestività
Volume
Schema
Distribuzione
Lineage
Data observability e qualità dei dati: una distinzione fondamentale
Perché i team le confondono
Dove si colloca ciascuna
Come funzionano le architetture moderne di data observability
Il modello a T nella pratica
Perché l'IA conta a livello operativo
Dalla teoria alla pratica con una piattaforma
Come le funzionalità corrispondono ai guasti quotidiani
Che cosa fallisce di solito nel rollout
La vostra checklist per implementare la data observability
Una sequenza pratica per iniziare
Perché la fiducia nei dati è più fragile che mai
Uno schema di guasto comune è questo. La finanza apre la dashboard direzionale prima di un consiglio di amministrazione e vede numeri che non coincidono con il report di chiusura. Il marketing dice che la spesa delle campagne sembra normale. Le vendite dicono che la pipeline commerciale è calata. Il data engineering controlla i log di orchestrazione e vede job verdi. Nessuno sa se il problema sia un caricamento in ritardo, una trasformazione rotta, una modifica di schema o un feed duplicato.
Ecco perché gli incidenti legati a dati errati sono così dirompenti. Non sono rumorosi come i guasti infrastrutturali. Sono silenziosi. I report continuano a essere visualizzati, i grafici continuano ad aggiornarsi e le persone continuano a usarli finché qualcuno non nota l'incoerenza per caso.
Per i team che cercano di trattare i dati come un asset, la fiducia non è un concetto astratto. Incide su pianificazione, compliance, previsioni e output dei modelli. Se state lavorando su questa prospettiva di business più ampia, questa guida esperta sul ROI degli asset di dati è utile perché collega l'affidabilità tecnica al valore per il management, una conversazione che spesso manca.
I guasti silenziosi mettono a rischio la continuità operativa
Il problema non è solo la correttezza. È la tempistica.
Una dashboard non aggiornata un'ora prima di una decisione sui prezzi è un problema di continuità. Un batch mancante in un flusso di gestione dei sinistri è un problema di continuità. Uno spostamento inosservato nei dati di input di un modello è un problema di continuità. In ogni caso il business continua a muoversi, ma lo fa con informazioni compromesse.
I team di dati raramente vengono incolpati perché una pipeline è fallita in modo visibile. Vengono incolpati quando tutto sembrava normale e i numeri erano comunque sbagliati.
Questa pressione spiega perché la categoria si sta espandendo così rapidamente. Si prevede che il mercato globale della data observability raggiunga 7,01 miliardi di USD entro il 2033, partendo da 2,3 miliardi di USD nel 2023, con un CAGR dell'11,8%, secondo le proiezioni di mercato sulla crescita della data observability. La stessa proiezione collega questa crescita alla necessità di rilevare le anomalie, identificare le cause principali e prevenire le interruzioni prima che incidano sui risultati di business.
Le correzioni reattive non scalano
Molti team iniziano con controlli manuali, asserzioni SQL e qualche alert ad alto valore. Per un po' funziona.
Poi la piattaforma cresce. Arrivano nuove sorgenti. La responsabilità si distribuisce. BI e ML consumano le stesse tabelle a monte. Un problema in una dashboard oggi può avere origine cinque trasformazioni prima e, quando qualcuno se ne accorge, diversi prodotti a valle sono già stati colpiti.
A quel punto il debugging reattivo diventa costoso, perché ogni incidente si trasforma in un esercizio di scoperta. Non state solo correggendo dati errati. State ricostruendo la catena di eventi che li ha causati.
Che cos'è esattamente la data observability
La data observability è la pratica di comprendere lo stato di salute dei sistemi di dati ispezionando continuamente i segnali prodotti dai dati e dalle pipeline. In termini pratici, vi dice se i dati arrivano in orario, nella forma attesa, con il comportamento atteso e con un contesto sufficiente per risalire all'origine dei problemi.
Un'analogia utile viene dalle operations del software. L'Application Performance Monitoring dice agli ingegneri che un'applicazione è lenta, sta fallendo o si comporta in modo anomalo. La data observability applica la stessa mentalità alle piattaforme di dati. Non si ferma a “il job è andato a buon fine”. Si chiede se l'output sia affidabile.
Il monitoraggio intercetta i guasti noti
Il monitoraggio tradizionale è utile, ma ha un perimetro più ristretto.
Funziona meglio quando conoscete già la modalità di guasto. Se una pipeline fallisce, alert. Se la latenza supera una soglia, alert. Se una tabella non si è aggiornata entro un orario prestabilito, alert. Questi controlli sono necessari, ma presuppongono che il problema sia stato previsto e codificato.
L'osservabilità gestisce i casi che i vostri controlli statici non avevano previsto. Una pipeline può completarsi con successo producendo la metà delle righe attese. Un join può continuare a funzionare causando però uno spostamento nella distribuzione di una metrica critica. Una colonna può restare presente ma cambiare significato a causa della logica a monte.
L'osservabilità aiuta a capire il perché
È questo il cambiamento chiave dietro la domanda che cos'è la data observability. Non è solo un livello di monitoraggio con più alert. È un modo per passare dalla rincorsa reattiva dei sintomi alla diagnosi a livello di sistema.
Una solida pratica di osservabilità di solito fa quattro cose contemporaneamente:
Rileva anomalie nascoste: segnala comportamenti inattesi anche quando i job vanno a buon fine.
Fornisce contesto: mostra che cosa è cambiato, quando è cambiato e che cosa ne dipende.
Accelera il triage: aiuta a indirizzare più rapidamente gli incidenti al responsabile giusto.
Supporta la prevenzione: fa emergere pattern che permettono ai team di eliminare le cause ricorrenti, non solo di ripulire le conseguenze.
Regola pratica: se la vostra configurazione attuale vi dice che una pipeline è stata eseguita ma non sa dirvi se i dati risultanti sono utilizzabili, avete un monitoraggio. Non avete ancora l'osservabilità.
La differenza conta perché agli utenti di business non interessa se Airflow, dbt o il data warehouse hanno completato un'attività. A loro interessa sapere se la dashboard, il report o il modello sono affidabili in questo momento.
I cinque pilastri della data observability
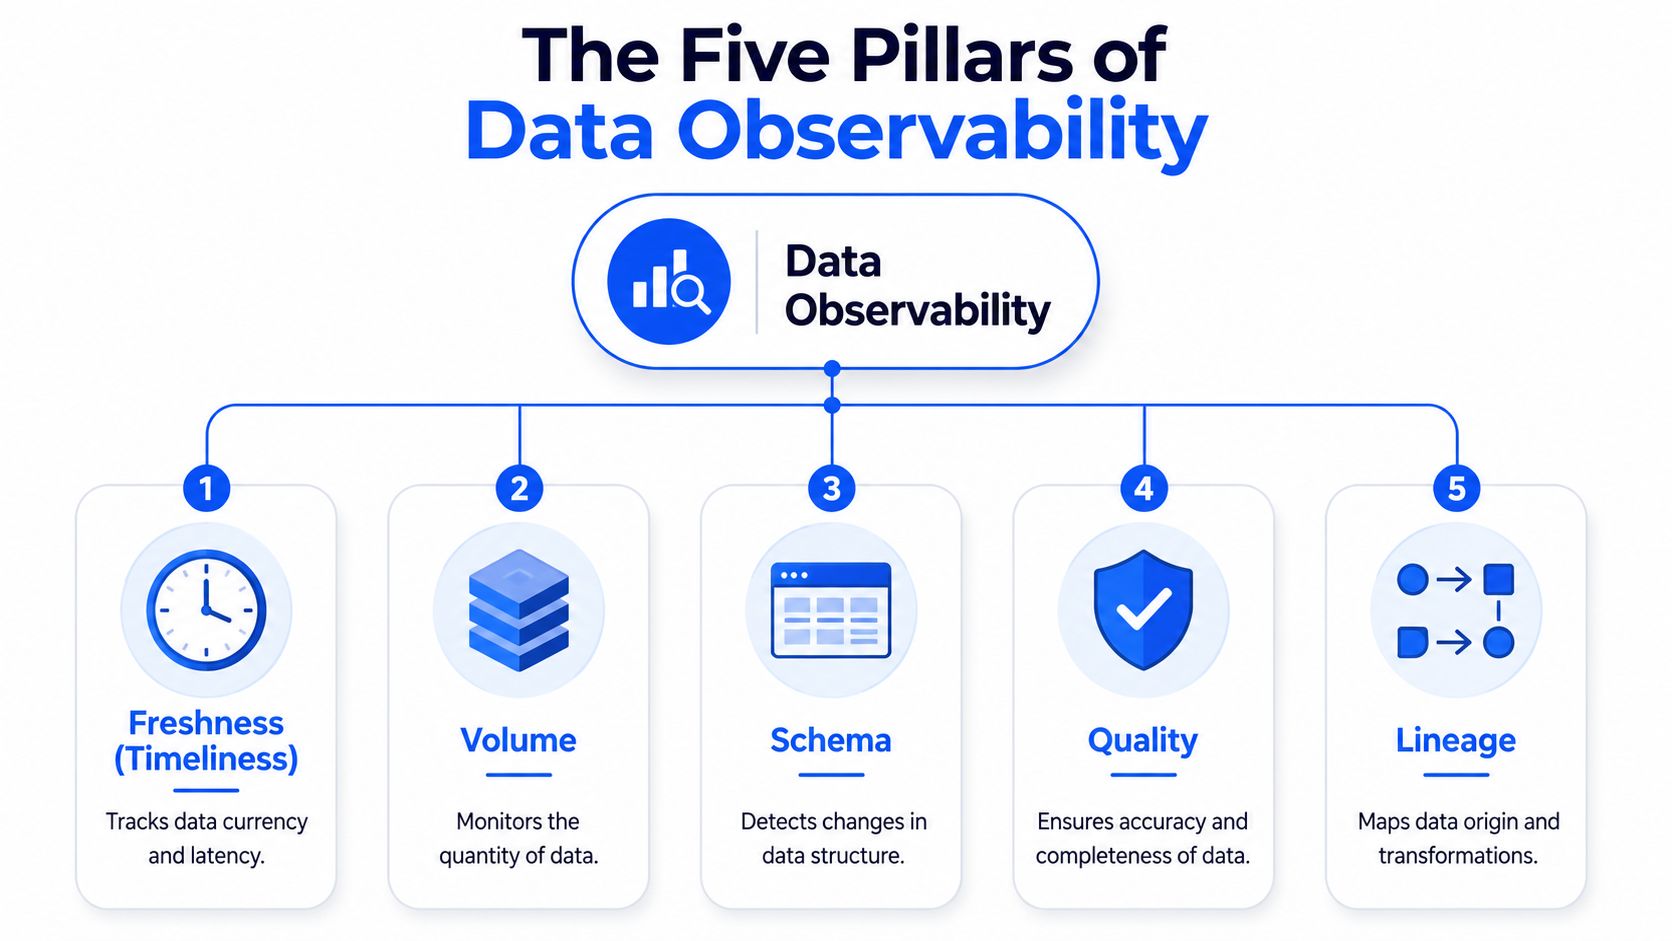
La data observability diventa più facile da rendere operativa quando la si scompone in segnali. Le ricerche di settore indicano che il tempo medio per rilevare e risolvere i problemi di qualità dei dati è di circa 4-9 ore in assenza di pratiche di osservabilità efficaci e che il monitoraggio continuo di freschezza, volume, schema, distribuzione e lineage aiuta i team a ridurre l'impatto di tali problemi, come descritto in questa panoramica dei cinque pilastri della data observability.
Freschezza e tempestività
La freschezza pone una domanda operativa di base. I dati sono arrivati quando il business se li aspettava?
Sembra semplice, ma è uno dei controlli più importanti in produzione. Un report strutturalmente corretto ma in ritardo di sei ore può comunque portare a decisioni sbagliate.
Usate il monitoraggio della freschezza per:
Feed pianificati: caricamenti giornalieri od orari che devono arrivare in tempo.
Dashboard operative: metriche legate a personale, magazzino, revisione delle frodi o finestre di trading.
Input di IA sensibili al tempo: feature che diventano fuorvianti quando sono in ritardo.
Se il vostro team cerca un esempio concreto di questa categoria di segnali, il monitoraggio della tempestività nella pratica mostra come la consapevolezza delle pianificazioni e il tracciamento delle consegne attese si inseriscono nell'osservabilità.
Un esempio pratico è una tabella degli ordini giornalieri che di solito si aggiorna prima dell'orario di apertura. Se non è arrivata, finanza e operations potrebbero entrambe guardare numeri obsoleti senza rendersene conto.
Prima di approfondire, questo breve video offre una buona panoramica visiva del concetto.
Volume
Il volume verifica se la quantità di dati rientra in un intervallo atteso.
Questo intercetta rapidamente i guasti più evidenti. Se il numero di righe crolla all'improvviso, probabilmente si è rotto qualcosa a monte. Se aumenta inaspettatamente, potrebbe esserci una duplicazione o una riesecuzione.
Un modello mentale utile è il ricevimento merci di un magazzino. Se di solito arrivano dieci camion e se ne presentano solo due, non serve un'analisi perfetta delle cause per capire che le operations sono a rischio.
Schema
L'osservabilità dello schema sorveglia la struttura. Colonne aggiunte, rimosse, rinominate o con tipo modificato possono rompere la logica a valle anche quando i job di ingestione e trasformazione continuano a segnalare successo.
Ecco perché gli incidenti di schema sono così frustranti. Spesso la pipeline non è tecnicamente “giù”. Sta semplicemente producendo un output che i consumatori a valle non riescono più a interpretare correttamente.
Esempi comuni includono:
Cambi di tipo: da intero a stringa, o modifiche al formato dei timestamp.
Rimozione di colonne: un campo scompare da un'API sorgente o da un modello di trasformazione.
Variazioni di nullabilità: un campo prima obbligatorio inizia ad arrivare parzialmente vuoto.
Distribuzione
La distribuzione va oltre i conteggi e la struttura. Osserva il comportamento dei valori.
Se tasso di conversione, tasso di null, mix di categorie o valore medio del carrello si spostano improvvisamente al di fuori dei pattern normali, i controlli di distribuzione lo fanno emergere. L'osservabilità inizia così a intercettare problemi di business sottili che le soglie fisse spesso non vedono.
Un join rotto è l'esempio classico. Il numero di righe può sembrare sano e lo schema può essere invariato, ma valori importanti possono comunque derivare in modi che danneggiano report e modelli.
Lineage
Il lineage risponde alla domanda che ogni responsabile di un incidente si pone per prima. Dove è iniziato e che cos'altro ha colpito?
Il lineage conta perché i guasti dei dati si propagano. Una singola trasformazione a monte può colpire più data mart, dashboard, output di reverse ETL e pipeline di feature. Senza lineage, i team perdono troppo tempo a indovinare dove guardare e chi avvisare.
Se non riuscite a risalire da una metrica alla sua sorgente e a seguirla fino ai suoi consumatori, farete il debug degli incidenti intervistando le persone invece di ispezionare i sistemi.
Nel loro insieme, questi pilastri formano una checklist pratica. Se una piattaforma o un processo ne copre solo uno o due, i team di solito finiscono con una visibilità frammentata e una risoluzione più lenta.
Data observability e qualità dei dati: una distinzione fondamentale
I team usano spesso questi termini come sinonimi, creando confusione nella scelta degli strumenti e nei modelli operativi. Sono correlati, ma non sono la stessa cosa.
Un'analogia semplice aiuta. Un medico che controlla polso, livello di ossigeno e temperatura sta osservando le condizioni del paziente. Un medico che prescrive un esame specifico per una malattia nota sta effettuando una verifica rispetto a una regola definita. La data observability è più vicina al primo caso. La qualità dei dati è più vicina al secondo.
Perché i team le confondono
La confusione nasce perché entrambe le discipline mirano a produrre dati affidabili.
La qualità dei dati si concentra sul fatto che i dati soddisfino aspettative di business definite. Un indirizzo email è valido? Un ID account è univoco? Un campo obbligatorio è presente? Sono regole esplicite, spesso legate a compliance, contratti o standard operativi.
La data observability si concentra sul fatto che il sistema di dati si comporti normalmente e che stiano emergendo anomalie. Osserva pattern, movimenti, dipendenze e cambiamenti nel tempo. Se volete un'analisi più orientata al prodotto, questa spiegazione su data observability e qualità dei dati è un utile complemento.
Dove si colloca ciascuna
Ecco la distinzione pratica:
Dimensione | Qualità dei dati | Data observability |
|---|---|---|
Focus principale | Contenuto dei dati e conformità alle regole | Salute dei dati, comportamento e contesto del sistema |
Metodo tipico | Regole di validazione e asserzioni | Rilevamento delle anomalie, monitoraggio e analisi del lineage |
Ideale per intercettare | Problemi noti | Problemi sconosciuti o emergenti |
Domanda di esempio |
| Perché il tasso di null in |
Orientamento temporale | Correttezza in un momento specifico | Consapevolezza operativa continua |
Risultato principale | Conformità alle regole | Rilevamento precoce e diagnosi più rapida |
Una piattaforma matura ha bisogno di entrambe.
La qualità dei dati senza osservabilità diventa fragile, perché i team possono intercettare solo ciò che hanno previsto. L'osservabilità senza qualità lascia lacune dove le regole di business esplicite sono obbligatorie. I flussi regolamentati, i requisiti di audit e gli standard contrattuali sui dati richiedono comunque controlli deterministici.
Una buona qualità dei dati vi dice se un record supera i controlli. Una buona osservabilità vi dice se il sistema che ha prodotto quel record sta scivolando verso un guasto.
Il modello operativo più solido tratta qualità e osservabilità come livelli complementari, non come categorie in concorrenza.
Come funzionano le architetture moderne di data observability
Una pipeline fallisce alle 2 di notte. La dashboard rotta è solo il sintomo visibile. Quando finanza, operations o un modello rivolto ai clienti mostrano numeri sbagliati, il business ha già assorbito il primo costo del data downtime: decisioni bloccate, fiducia persa e ingegneri distolti per un triage manuale.
È l'architettura a determinare se l'osservabilità accorcia quell'incidente o lo trascina per tutta la giornata.
Un design moderno monitora l'intero percorso di produzione, inclusi ingestione, livelli di trasformazione, tabelle di servizio, asset di BI e consumatori ML. I problemi raramente iniziano nella dashboard finale. Iniziano prima, con una modifica di schema a monte, una dipendenza in ritardo, una trasformazione rotta o un pattern di drift che nessuno ha modellato esplicitamente. Senza lineage attraverso questi livelli, la risposta agli incidenti diventa un costoso gioco di ipotesi.
Ecco perché il modello di esecuzione conta quanto l'elenco delle funzionalità. Se una piattaforma osserva solo le tabelle a valle, i team rilevano i guasti dopo che l'impatto sul business si è già manifestato. Se richiede l'estrazione dei dati in un ambiente del fornitore, revisioni di sicurezza, latenza e costi aggiuntivi possono rallentarne l'adozione. Se la copertura dei monitor dipende da controlli costruiti a mano per ogni asset importante, il sistema diventa un ulteriore onere di manutenzione invece di un livello operativo.
Il modello a T nella pratica
Un pattern architetturale funziona bene nei grandi ecosistemi di dati: il modello di monitoraggio a T.
Il livello orizzontale applica un monitoraggio leggero all'intero data warehouse. Di solito include freschezza, variazioni di volume, esecuzioni fallite, lacune nel lineage e altri segnali ampi che indicano che qualcosa è cambiato. Il livello verticale approfondisce gli asset legati al reporting dei ricavi, alle dashboard direzionali, ai flussi di compliance e al ML in produzione. DataHub descrive questo approccio nella sua spiegazione del monitoraggio a T.
È una decisione di continuità operativa, non solo una preferenza di monitoraggio. Una copertura uguale ovunque sembra disciplinata, ma spesso genera rumore negli alert e spreca tempo di ingegneria su asset a basso impatto. Concentrarsi solo su un insieme ristretto di tabelle critiche crea punti ciechi a monte, dove iniziano molti incidenti. La forma a T bilancia entrambi i compromessi. Consapevolezza ampia sull'intero ecosistema. Ispezione più profonda dove il downtime costa di più.
Nella pratica, i team più forti estendono questo modello anche con il contesto di utilizzo e comportamentale. Il monitoraggio diventa più utile quando gli architetti possono collegare i segnali tecnici ai pattern di consumo, alle responsabilità e ai processi di business a valle. È questo lo scopo di estendere la data observability con l'analisi. Aiuta i team a decidere quali anomalie sono rumore operativo e quali minacciano un processo di chiusura trimestrale, un KPI direzionale o un flusso rivolto ai clienti.
Perché l'IA conta a livello operativo
Le soglie statiche non reggono nei sistemi reali.
I pattern dei dati cambiano con la stagionalità, i lanci, gli aggiornamenti dei prezzi, le acquisizioni e il comportamento mutevole degli utenti. Una regola che funzionava tre mesi fa può non vedere un incidente reale oggi o scattare continuamente su una variazione normale. I team finiscono così per passare il tempo a regolare i monitor invece di migliorare l'affidabilità delle pipeline.
L'osservabilità guidata dall'IA affronta questo problema apprendendo il comportamento storico e valutando le anomalie nel loro contesto. È più adatta a rilevare drift, join insoliti, distribuzioni che cambiano e spostamenti temporali che non corrispondono in modo netto a una singola regola fissa. Questo riduce i falsi positivi e accorcia il tempo per individuare la causa principale, soprattutto in ambienti con centinaia o migliaia di asset.
L'architettura più solida è ibrida. Usate baseline apprese per intercettare modalità di guasto sconosciute. Mantenete controlli deterministici per gli SLA contrattuali, i campi regolamentati e le regole di business che richiedono una logica esplicita di superamento o fallimento. Questa combinazione trasforma l'osservabilità da pulizia reattiva a sistema di allerta precoce per i dati da cui il business dipende ogni giorno.
Dalla teoria alla pratica con una piattaforma
La teoria conta solo se cambia le operations quotidiane. Nella pratica, i team hanno bisogno di un livello per il rilevamento delle anomalie, di un altro per la validazione deterministica e di un contesto storico sufficiente per decidere se un alert è rumore o l'inizio di un incidente.
Un grande freno operativo è la manutenzione di monitor fragili. Un report di Accenture del 2025 sulla produttività del data engineering indica che il 40–60% del tempo dei team di dati viene dedicato alla manutenzione preventiva di regole basate su soglie, un costo evidenziato nell'analisi di Databricks sul carico di manutenzione nascosto nella data observability. È uno dei motivi per cui i team si stanno spostando verso un rilevamento guidato dall'IA, in grado di ridurre i falsi positivi e accorciare l'analisi delle cause principali.
Come le funzionalità corrispondono ai guasti quotidiani
Una piattaforma pratica corrisponde direttamente ai pattern di incidente che i team di dati conoscono già:
Caricamenti in ritardo o mancanti: il monitoraggio della tempestività rileva gli arrivi in ritardo prima che ne risenta una dashboard per il consiglio di amministrazione o un flusso vincolato da SLA.
Drift silenzioso delle metriche: il rilevamento delle anomalie fa emergere cambiamenti inattesi nel volume o nel comportamento dei valori, senza aspettare che se ne accorga una persona.
Modifiche strutturali dirompenti: il tracciamento dello schema segnala campi aggiunti, rimossi o modificati prima che le trasformazioni a valle falliscano.
Esigenze di policy a livello di record: le regole di validazione restano importanti dove logica di business, audit o compliance richiedono controlli espliciti di superamento o fallimento.
Analisi dei pattern nel tempo: l'analisi storica aiuta i team a capire se un alert è un picco isolato o parte di una debolezza operativa ricorrente.
Un esempio è l'estensione analitica di digna per l'osservabilità, che affianca al rilevamento delle anomalie e al monitoraggio della tempestività l'analisi dei trend storici, il tracciamento dello schema e la validazione a livello di record in ambienti controllati dal cliente. Questa combinazione riflette una realtà pratica. Osservabilità e qualità sono più facili da gestire quando non sono suddivise tra strumenti scollegati.
Che cosa fallisce di solito nel rollout
L'errore più comune nel rollout è cercare di strumentare ogni tabella con la stessa profondità fin dal primo giorno.
Questo genera troppi alert, responsabilità poco chiare e scetticismo da parte degli utenti di business. Una sequenza migliore è più mirata. Partite dagli asset legati a ricavi, finanza, reporting verso i clienti, processi regolamentati o input dei modelli. Applicate prima a questi freschezza, volume, schema e lineage. Poi estendete.
Un altro errore è trattare l'osservabilità come una questione puramente ingegneristica. Operations, analytics, governance e responsabili ML hanno tutti bisogno di visibilità, perché sperimentano sintomi diversi dello stesso difetto a monte.
La vostra checklist per implementare la data observability
Un rollout di solito inizia sempre allo stesso modo. La finanza chiede perché la metrica di ieri per il consiglio di amministrazione è cambiata. Le operations vedono un report SLA rotto. Il team di dati inizia a tracciare i job, controllare le esecuzioni dbt e confrontare a mano il numero di righe. Quando la causa principale diventa chiara, il business ha già lavorato con informazioni errate.
Ecco perché l'implementazione va trattata come un esercizio di continuità operativa, non come un progetto di monitoraggio. Partite da dove i dati errati interromperebbero decisioni, reporting, ricavi, compliance o prestazioni dei modelli. Poi estendete la copertura in un modo che il vostro team possa gestire.

Una sequenza pratica per iniziare
La copertura dovrebbe seguire il percorso dell'impatto sul business. Se un KPI si rompe in una dashboard, il guasto si trova spesso diversi passaggi a monte, nell'ingestione, nella trasformazione o in una modifica di schema che non ha mai raggiunto il livello di reporting. I team hanno bisogno di lineage e di una profondità di monitoraggio sufficienti per tracciare rapidamente quel percorso, senza cercare di strumentare ogni tabella fin dal primo giorno.
Usate questa checklist come sequenza di partenza:
Definite gli asset di dati critici
Elencate le dashboard, i report, i modelli e le tabelle operative senza i quali il business non può funzionare in sicurezza. Date priorità in base alle conseguenze, non al numero di tabelle.Partite da freschezza e volume
Questi segnali intercettano presto molti guasti operativi e di solito sono i più rapidi da configurare. Creano anche una prima baseline di alert chiara.Mappate un percorso di lineage ad alto valore
Tracciate una metrica importante dalla sorgente fino al consumo a valle nella BI o nel ML. Di solito questo fa emergere lacune di responsabilità, dipendenze non documentate e trasformazioni fragili più rapidamente di una copertura ampia ma superficiale.Aggiungete il rilevamento delle modifiche di schema
La deriva strutturale causa guasti silenziosi. Le colonne vengono rinominate, i tipi cambiano, i campi nullable smettono di esserlo e la logica a valle si rompe ore dopo.Aggiungete controlli di distribuzione per i dataset ad alto impatto
Anche dati freschi possono essere sbagliati. I controlli di distribuzione aiutano a intercettare join falliti, regressioni della logica di business, distorsioni e drift prima che gli utenti li notino in un report o nell'output di un modello.Scegliete una piattaforma che limiti la manutenzione manuale delle regole
Se ogni monitor richiede una continua regolazione delle soglie, l'osservabilità diventa un altro backlog. Baseline e triage assistiti dall'IA aiutano i team a dedicare più tempo a risolvere problemi reali e meno a fare da babysitter agli alert.
Il test è semplice. Il vostro modello operativo sa dire a finanza, operations, prodotto e analytics se i data product da cui dipendono sono sani in questo momento, e sa farlo prima che un difetto si trasformi in downtime per il business?
Se il vostro team vuole passare dal debugging reattivo al controllo proattivo, digna offre funzionalità di data observability e qualità dei dati come rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema, validazione ed esecuzione in-database per ambienti controllati dal cliente.
Domande frequenti
Che cos'è la data observability?
La data observability è la pratica di comprendere lo stato di salute dei sistemi di dati ispezionando continuamente i segnali prodotti dai dati e dalle pipeline. Indica se i dati arrivano in orario, nella forma attesa, con il comportamento atteso e con un contesto sufficiente per risalire all'origine dei problemi.
Quali sono i cinque pilastri della data observability?
I cinque pilastri sono freschezza, volume, schema, distribuzione e lineage. La freschezza verifica se i dati sono arrivati in orario, il volume se il numero di righe rientra nell'intervallo atteso, lo schema se la struttura è cambiata, la distribuzione se i valori si comportano normalmente e il lineage dove è iniziato un problema e che cosa ha colpito a valle.
Qual è la differenza tra data observability e qualità dei dati?
La qualità dei dati verifica se i dati rispettano regole definite, ad esempio se customer_id è univoco. L'osservabilità si chiede perché il tasso di null in customer_id sia aumentato all'improvviso. La qualità intercetta problemi noti in un momento specifico, mentre l'osservabilità offre una consapevolezza continua dei problemi sconosciuti o emergenti. Una piattaforma matura ha bisogno di entrambe.
In che cosa la data observability differisce dal monitoraggio dei dati?
Il monitoraggio funziona meglio quando si conosce già la modalità di guasto, ad esempio un job fallito o una tabella che non si è aggiornata in tempo. L'osservabilità copre i casi che i controlli statici non avevano previsto, come una pipeline che va a buon fine producendo la metà delle righe attese o un join che sposta una metrica critica.
Da dove dovrebbe iniziare un rollout di data observability?
Iniziate definendo gli asset di dati critici, come le dashboard dei ricavi, i report finanziari e gli input dei modelli, quindi aggiungete il monitoraggio di freschezza e volume, che sono i più rapidi da configurare. Poi mappate un percorso di lineage ad alto valore, aggiungete il rilevamento delle modifiche di schema e affiancate controlli di distribuzione ai dataset ad alto impatto.


