Vraisemblance des données : comment détecter les données qui semblent incorrectes mais qui respectent vos règles
|
8
minute de lecture

Les données peuvent passer toutes les règles de validation et rester néanmoins déraisonnables.
C'est le fossé opérationnel qui se cache derrière de nombreux tableaux de bord défaillants, rapports trompeurs et entrées d'IA non fiables. La Data Validation traditionnelle vérifie des conditions explicitement définies, telles que les types de données, les champs obligatoires, les valeurs autorisées et les seuils maximaux. La cohérence des données pose une question différente : les données se comportent-elles comme prévu dans leur contexte métier ?
Une transaction peut contenir une devise valide, un horodatage valide et un montant inférieur à la limite configurée, tout en représentant un problème de données sérieux. Un fichier retardé peut être complet lorsqu'il arrive enfin, mais inutilisable pour une décision qui en dépendait plus tôt. Un schéma peut rester techniquement lisible alors qu'un changement structurel subtil altère la signification des métriques en aval.
L'exposition financière est substantielle. L'indicateur largement cité est que la mauvaise qualité des données coûte aux organisations environ 12,9 millions de dollars par an en moyenne, tandis qu'IBM a rapporté en 2026 que plus d'un quart des organisations perdent plus de 5 millions de dollars par an, et 7 % perdent 25 millions de dollars ou plus en raison d'une mauvaise qualité des données. IBM a également rapporté que 43 % des directeurs des opérations ont identifié la qualité des données comme leur priorité de données la plus importante, montrant qu'il s'agit d'un risque opérationnel et non d'un simple inconvénient analytique. Voir l'analyse d'IBM sur le coût d'une mauvaise qualité des données pour le contexte métier plus large.
Table des matières
Quand des données valides semblent incorrectes
Ce qui rend les données déraisonnables
La cohérence est multidimensionnelle
Pourquoi la validation basée sur des règles est insuffisante
Là où les règles explicites fonctionnent
Là où les règles deviennent coûteuses
Comment les organisations détectent les données déraisonnables
Plages attendues
Historique de référence
Distributions statistiques
Tendances et comparaisons avec les pairs
Validation vs Cohérence vs Détection d'anomalies
Comment digna soutient la cohérence des données
Surveiller en continu les données déraisonnables
Quand des données valides semblent incorrectes
Les règles sont utiles car elles transforment des attentes connues en vérifications répétables. Elles détectent les valeurs nulles, les identifiants mal formés, les dates invalides, les clés en double et les valeurs en dehors d'un domaine approuvé. Mais elles ne détectent que ce que quelqu'un a déjà décrit.
La surveillance de la cohérence comble le fossé entre la validité technique et l'adéquation contextuelle. Une valeur peut satisfaire à une règle tout en contredisant le comportement historique, la distribution, le calendrier ou les relations qui rendent le jeu de données utile. C'est pourquoi un rapport de validation propre ne signifie pas nécessairement que les données sont sûres pour la finance, les opérations, les rapports réglementaires ou le machine learning.
Une distinction pratique s'impose :
Validité : L'enregistrement est conforme à une règle structurelle ou métier explicite.
Qualité : L'enregistrement est exact, complet, cohérent, opportun, unique et adapté à l'usage prévu.
Cohérence : La valeur ou le comportement a du sens dans son contexte.
Détection d'anomalies : L'observation actuelle diffère sensiblement du comportement appris ou attendu.
La différence entre la validité des données et la qualité globale des données est importante car les équipes traitent souvent une règle validée comme la preuve qu'aucune autre enquête n'est nécessaire. En production, cette hypothèse échoue lorsque le problème est une dérive progressive, une arrivée tardive, un changement de distribution ou un modèle multivarié qu'aucune règle unique au niveau des champs ne peut exprimer.
Règle pratique : Une règle de validation réussie signifie « cette condition connue n'a pas été violée ». Cela ne signifie pas que « rien d'inhabituel ne s'est produit ».
La cohérence ne remplace donc pas la validation. C'est une deuxième couche qui teste le comportement, le contexte et le changement. La validation traditionnelle vérifie ce que vous savez déjà rechercher. La surveillance de la cohérence peut révéler un comportement auquel vous ne vous attendiez pas.
Ce qui rend les données déraisonnables
Des données déraisonnables sont des données qui semblent techniquement acceptables mais qui entrent en conflit avec les modèles, les relations, le calendrier ou le contexte métier attendu pour leur utilisation. Le mot « déraisonnable » ne signifie pas « faux ». Cela signifie que l'observation mérite une attention particulière car son comportement est difficile à expliquer à l'aide du contexte disponible.
Prenons l'exemple d'un montant de transaction situé dans une plage autorisée mais considérablement plus élevé que l'activité habituelle du client. Une règle peut accepter toutes les valeurs de 0 € à 1 million d'euros, tandis que le modèle établi du client justifie une enquête sur une transaction exceptionnellement importante. Le même problème apparaît dans la surveillance des volumes. Une augmentation de 500 % des commandes quotidiennes peut refléter une campagne réussie, un véritable événement saisonnier, une ingestion dupliquée ou une jointure rompue. Le nombre est un signal, pas un verdict.
D'autres exemples incluent :
L'âge d'un client qui se situe dans une fourchette humaine techniquement valide mais qui est très inhabituel pour le segment.
Un changement soudain dans la distribution des prix des produits, même si chaque prix individuel reste dans les limites autorisées.
Une valeur de ventes régionales qui diffère complètement des modèles historiques tout en passant les vérifications de type, de valeur nulle et de plage.
Une livraison tardive récurrente qui laisse la table complète mais oblige les utilisateurs en aval à prendre des décisions avec des données obsolètes.
Une relation entre des champs qui change, comme les quantités et les totaux qui ne suivent plus la même courbe historique.

La cohérence est multidimensionnelle
Les équipes de qualité des données travaillent généralement sur plusieurs dimensions, notamment l'exactitude, la complétude, la cohérence, la rapidité d'accès, la validité et l'unicité. Un enregistrement peut être valide mais non opportun, complet mais incohérent, ou structurellement correct mais inexact. La surveillance de la cohérence aide à exposer ces combinaisons en examinant le comportement du jeu de données au lieu d'inspecter les champs de manière isolée.
La détection d'anomalies est particulièrement utile pour identifier les valeurs aberrantes, mais une valeur aberrante ne doit pas être automatiquement supprimée ou rejetée. Une promotion, une acquisition, une panne ou un événement de marché peut créer une anomalie légitime. La réponse correcte consiste à associer du contexte, à évaluer l'impact et à décider si l'observation représente un changement réel ou un défaut de données. Des conseils pratiques sur les méthodes d'identification des valeurs aberrantes renforcent cette distinction.
Pourquoi la validation basée sur des règles est insuffisante
Prenons une règle courante :
Le montant de la transaction doit être compris entre 0 € et 1 million d'euros.
Sous cette règle, 500 €, 50 000 € et 900 000 € passent tous. La règle fait exactement ce pour quoi elle a été conçue, et c'est précieux. Elle empêche les valeurs en dehors du domaine accepté d'entrer dans les processus en aval.
Mais supposons que les transactions historiques d'un client se situent normalement entre 50 € et 500 €. Une transaction de 900 000 € peut être légitime, mais elle est suffisamment différente du comportement établi de ce client pour nécessiter un examen. La règle statique ne peut pas porter ce jugement car elle n'a aucune représentation de l'historique spécifique au client.
Là où les règles explicites fonctionnent
La validation basée sur des règles reste le bon outil lorsque l'attente est connue et stable :
Un identifiant requis ne doit pas être nul.
Une date doit utiliser un format accepté.
Un statut doit appartenir à un ensemble approuvé.
Le montant d'une transaction ne doit pas dépasser une limite contractuelle.
Un enregistrement doit satisfaire à une relation documentée entre les champs.
Ces vérifications sont transparentes, faciles à auditer et utiles pour appliquer des contrôles déterministes. Elles produisent également des échecs exploitables lorsque la condition métier est explicite.
Là où les règles deviennent coûteuses
Les problèmes commencent lorsque les équipes tentent de coder manuellement chaque attente métier possible. Elles ajoutent des règles pour chaque région, produit, type de client, modèle saisonnier, exception et état de fonctionnement. Le résultat est une charge de maintenance croissante, des changements de seuils fréquents et un système de surveillance qui passe toujours à côté de modèles que personne n'a pensé à définir.
Les approches statistiques résolvent un problème différent. ML.TFDV_VALIDATE de BigQuery, par exemple, compare les statistiques d'entraînement et de service pour identifier les différences anormales entre les jeux de données, illustrant que la validation et la détection d'anomalies sont des couches de contrôle distinctes. La perspective sur les règles de validation des données et la qualité continue des données est utile ici : les vérifications déterministes appliquent des conditions connues, tandis que la surveillance statistique recherche des changements inattendus.
Une conception de production solide ne choisit pas une seule approche. Elle utilise la validation explicite pour les contraintes connues et la détection d'anomalies pour les comportements qui doivent être appris à partir des faits.
Comment les organisations détectent les données déraisonnables
Les organisations évaluent généralement la cohérence en combinant plusieurs formes de comportement attendu. Aucun seuil unique ne fonctionne pour tous les jeux de données, la conception de la surveillance doit donc refléter le grain, la saisonnalité, la latence et l'importance commerciale de chaque métrique.
Plages attendues
Commencez par des plages où l'attente métier est claire. Un prix, un âge, une quantité ou un solde peut avoir des limites inférieure et supérieure défendables. Ces vérifications sont simples et explicables, mais elles ne détecteront pas une valeur inhabituelle qui reste à l'intérieur de la plage.
Historique de référence
Un historique de référence décrit un comportement normal à l'aide d'observations historiques. Un flux de travail pratique collecte des données de référence représentatives, en dérive une description statistique et teste en continu les nouvelles données par rapport à celle-ci. Un point de changement détecté par les statistiques de test peut alors être traité comme une anomalie, comme décrit dans ce guide de détection d'anomalies basé sur un historique de référence.
Les historiques de référence doivent être segmentés lorsque le contexte modifie le modèle attendu. Le volume quotidien des commandes peut nécessiter un comportement distinct pour les jours de semaine et les week-ends. Les dépenses des clients peuvent nécessiter une comparaison au sein de segments de clientèle plutôt que sur l'ensemble de la population.
Distributions statistiques
Les moyennes seules peuvent masquer des changements importants. Surveillez la distribution des prix, des quantités, des soldes ou des valeurs catégorielles. Une moyenne stable peut coexister avec un changement net de la dispersion, une nouvelle concentration autour d'une valeur ou la disparition soudaine d'une catégorie.
Les détecteurs pratiques définissent une plage acceptable à partir d'un comportement normal. Un point de départ courant pour la détection d'anomalies par z-score est 3, ce qui représente environ trois écarts-types par rapport à la moyenne sous l'hypothèse d'une distribution normale, comme documenté dans le guide de détection de référence de Nokia. Ce seuil est un point de départ, pas un paramètre de production universel.
Tendances et comparaisons avec les pairs
Les vérifications de tendance identifient les augmentations, diminutions, inversions soudaines ou dérives prolongées. Les comparaisons avec les pairs ajoutent du contexte en comparant des régions, produits, entités ou unités commerciales similaires. Une région peut sembler inhabituelle à l'échelle mondiale mais normale par rapport à ses propres pairs saisonniers.
Enfin, ajoutez une cohérence basée sur des règles là où l'attente métier est connue mais plus contextuelle qu'une simple vérification de validité. Les programmes solides de qualité des données combinent des plages attendues, des historiques de référence, des distributions, des tendances, des comparaisons avec les pairs et des règles déterministes.
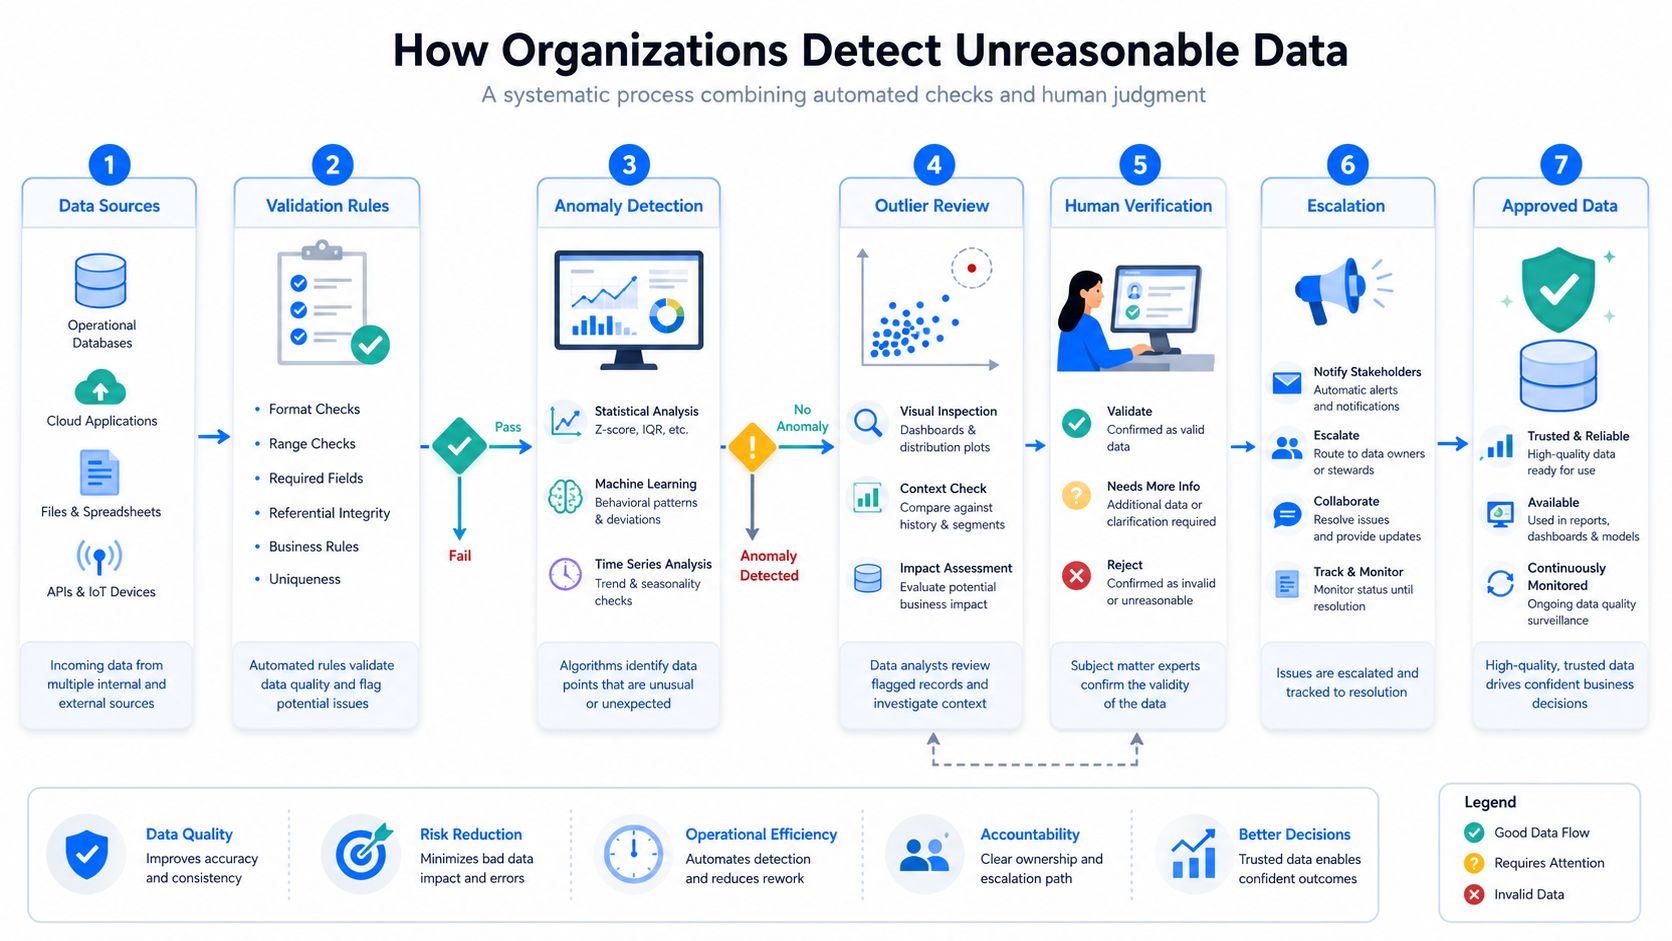
Pour des conseils de mise en œuvre plus larges, la détection d'anomalies pour les problèmes de données précoces fournit un cadre opérationnel utile. Le choix de conception important consiste à adapter les alertes aux conséquences. Un léger changement dans une table à faible impact peut être informatif, tandis qu'un changement modeste dans un jeu de données réglementaire ou financier peut nécessiter une escalade immédiate.
Validation vs Cohérence vs Détection d'anomalies
Une entreprise de vente au détail fournit un exemple clair de la différence entre les trois mécanismes. Sa table de ventes quotidiennes contient normalement environ 2 millions de transactions. Un jour, la table contient 2,1 millions, ce qui peut passer une règle de volume car la table est présente, remplie et dans une large limite opérationnelle. Pourtant, la valeur moyenne des commandes augmente de 350 %, créant un changement de comportement qu'une validation statique n'inspectera peut-être jamais.
La réponse doit être structurée en couches :
La validation vérifie les contraintes connues. Elle confirme que les montants, les dates, les identifiants et les champs requis respectent les règles définies.
La cohérence vérifie le contexte métier. Elle se demande si le montant est plausible pour le client, le produit, la région ou le canal de vente.
La détection d'anomalies compare le comportement actuel avec l'historique. Elle signale le changement soudain de la valeur moyenne des commandes et les éventuels changements de distribution associés.
L'analyse historique fournit le contexte. L'équipe vérifie les campagnes, les changements de prix, les promotions, le comportement d'ingestion et les événements du système source.
L'enquête détermine le résultat. L'anomalie peut représenter une activité de vente réelle, des enregistrements dupliqués, un problème de devise ou un défaut de transformation.
Approche | Question | Exemple |
|---|---|---|
Validation | La valeur satisfait-elle à la règle ? | Montant ≤ 1m € |
Règle de cohérence | Satisfait-elle à une condition métier attendue ? | Montant dans la plage attendue du client |
Détection d'anomalies | Le comportement est-il inhabituel par rapport à l'historique ? | Augmentation de 350 % de la valeur moyenne des commandes |
La distinction ressemble à d'autres disciplines de surveillance opérationnelle. Les équipes explorant la maintenance prédictive avec Forge Reliability reconnaîtront le même principe : un système peut rester dans une plage de fonctionnement autorisée alors que son comportement change suffisamment pour justifier une inspection. Dans les plateformes de données, cela signifie surveiller la trajectoire et les relations, et pas seulement l'état de réussite ou d'échec.
C'est également pourquoi Data Observability versus qualité des données ne doit pas être traité comme un choix binaire. La validation permet de contrôler les exigences connues. La cohérence fournit un jugement contextuel. La détection d'anomalies permet une comparaison adaptative par rapport au comportement observé.
Comment digna soutient la cohérence des données
digna Data Anomalies comble le fossé opérationnel entre les règles rédigées manuellement et la surveillance basée sur le comportement. Il utilise l'apprentissage automatique de l'historique de référence basé sur l'IA et la détection continue des anomalies pour identifier les écarts par rapport au comportement historique sans exiger des équipes qu'elles définissent chaque condition possible à l'avance.
Le module peut révéler des changements de volume inattendus, des variations de distribution, des valeurs métriques inhabituelles, des changements abrupts dans les modèles historiques et des anomalies récurrentes. Cela le rend pertinent lorsque les données restent syntaxiquement valides mais changent d'une manière qui pourrait affecter les rapports, les décisions opérationnelles ou les entrées de l'IA.
digna Data Analytics aide les enquêteurs à examiner le contexte historique derrière une alerte. Les équipes peuvent utiliser des métriques d'observabilité historique pour examiner les tendances, la volatilité et les modèles statistiques au lieu de traiter une anomalie comme un événement isolé. digna Data Validation reste utile lorsque la condition attendue peut être formulée explicitement sous la forme d'une règle métier, d'une exigence d'audit ou d'un contrôle au niveau de l'enregistrement.
Le modèle d'implémentation est important pour les entreprises. digna s'exécute au sein de la propre infrastructure du client, le calcul et l'analyse des métriques étant effectués directement dans la base de données, de sorte que les données de production restent en place. Le déploiement peut utiliser un cloud privé ou un environnement sur site au sein du cloud, du VPC ou du centre de données du client.
La valeur pratique provient de la combinaison plutôt que d'un module unique. Les anomalies identifient les comportements inattendus, l'analyse fournit le contexte, la validation applique les conditions connues et la surveillance associée peut suivre la ponctualité ou les changements de schéma qui rendent des données autrement valides dangereuses à utiliser.
Surveiller en continu les données déraisonnables
La surveillance continue commence par la hiérarchisation, et non par une tentative de surveiller chaque colonne de la même manière. Identifiez les jeux de données dont le comportement déraisonnable pourrait affecter les rapports financiers, les décisions des clients, le contrôle opérationnel, le travail réglementaire ou les systèmes d'IA. Définissez ensuite le comportement à observer, tel que le volume, l'heure d'arrivée, les distributions, les relations et les métriques métier.
Un modèle opérationnel utile comporte quatre parties :
Historique de référence : Apprendre le comportement normal à partir de données historiques représentatives.
Détection : Comparer les nouvelles observations avec les modèles attendus et signaler les écarts significatifs.
Contexte : Afficher la tendance historique, les dimensions affectées et les métriques associées.
Action : Acheminer l'alerte vers un responsable qui peut enquêter, classer et documenter le résultat.
L'automatisation est essentielle car l'examen manuel n'est pas évolutif. Une présentation de supervision sur la governance des données a rapporté que 42 % des répondants mondiaux identifiaient la pénurie de compétences et de personnel comme le principal obstacle à des données de haute qualité. Cette contrainte rend la surveillance contextuelle plus pratique que de demander à des équipes déjà surchargées de rédiger et de maintenir des règles pour chaque scénario possible. Le même principe s'applique aux flux opérationnels où la rapidité d'accès est essentielle, notamment les méthodes fiables de livraison de données d'esports, car un bloc de données complet qui arrive en retard peut tout de même échouer dans son objectif commercial.
Une anomalie ne signifie pas que les données sont fausses. Cela signifie que l'observation actuelle diffère du comportement attendu et doit être classée. Les équipes doivent enregistrer si la cause était un événement commercial légitime, un changement de système source, un défaut de pipeline, un chargement dupliqué, une livraison retardée ou un seuil trop sensible.
Les meilleurs programmes d'alerte mesurent également la qualité des alertes. Supprimez les événements connus lorsque cela est approprié, segmenter les historiques de référence par contexte significatif et hiérarchisez les incidents en fonction des dommages en aval plutôt que de la fréquence d'échec d'une règle. Cela réduit le bruit tout en préservant l'attention pour les changements qui peuvent induire en erreur les décisions.
Pour les organisations qui préparent des données pour l'IA, le fossé de préparation est important. Precisely a rapporté que seulement 12 % des organisations considéraient leurs données comme étant d'une qualité et d'une accessibilité suffisantes pour l'IA, tandis que 64 % ont désigné la qualité des données comme leur principal défi en matière d'intégrité des données et 49 % ont cité l'insuffisance des outils d'automatisation comme principal obstacle. Ces résultats soutiennent un principe opérationnel clair : la surveillance de la qualité des données doit tester non seulement si les données sont valides, mais aussi si elles restent dignes de confiance pour la décision qui les consomme.
digna combine Data Anomalies, Data Analytics, Data Validation, la surveillance de la rapidité d'accès et le suivi des schémas pour détecter les données qui passent les règles statiques mais se comportent de manière inattendue. Visitez digna pour voir comment sa plateforme intégrée à la base de données peut aider votre équipe à surveiller en continu les données déraisonnables et à enquêter sur les anomalies avant qu'elles ne nuisent à l'analyse ou à l'IA.


