Tests de qualité des données : guide pratique
|
7
minute de lecture

Dans une enquête sectorielle de 2026, 68 % des répondants ont indiqué qu'il fallait quatre heures ou plus pour détecter un incident de données, contre 62 % en 2022. Le temps moyen de résolution a lui aussi augmenté de 166 %, atteignant 15 heures par incident (enquête qualité des données de Monte Carlo). Ces chiffres changent la façon d'évaluer les tests de qualité des données. La question n'est pas seulement de savoir si une règle repère une valeur invalide. C'est de savoir à quelle vitesse votre équipe découvre une défaillance, en comprend la portée et empêche des données peu fiables d'atteindre tableaux de bord, modèles et systèmes opérationnels.
Les tests SQL statiques gardent leur place. Ils sont précis, relisibles et utiles pour des règles métier stables. Mais des contrôles périodiques laissent des trous entre deux exécutions, et des règles maintenues à la main suivent rarement le rythme des schémas, calendriers de livraison et comportements de données qui changent. Des tests de qualité efficaces associent validation déterministe et observabilité continue, de sorte que les équipes surveillent à la fois l'exactitude et le temps nécessaire pour détecter une défaillance et s'en remettre.
Table des matières
Le coût croissant des incidents de données tardifs
Un incident de données devient coûteux quand la détection arrive après que les données ont déjà servi. Un tableau de bord cassé, un KPI contesté ou un modèle contaminé peuvent déclencher une enquête à travers pipelines et consommateurs. Les ingénieurs reconstituent alors le changement, identifient les jeux de données concernés et décident quelles sorties doivent être reconstruites.
68 % des répondants ont signalé des délais de détection de quatre heures ou plus, contre 62 % en 2022, tandis que le temps moyen de résolution augmentait de 166 % pour atteindre 15 heures par incident (résultats de l'enquête Monte Carlo). Ces chiffres décrivent un temps d'exposition, pas seulement une performance de test. Pendant cet intervalle, une information peu fiable peut circuler dans des rapports, des extractions, des applications et des workflows d'apprentissage automatique.
MTTD et MTTR ont leur place dans la conversation qualité
Les tests de qualité classiques vérifient si les enregistrements remplissent des conditions telles que champs non nuls, types valides ou plages acceptables. Ces assertions mesurent l'exactitude au moment où elles s'exécutent. Elles ne montrent pas combien de temps l'organisation est restée ignorante de l'échec de la condition.
Le temps moyen de détection, ou MTTD, mesure le délai avant qu'une équipe sache qu'un incident existe. Le temps moyen de rétablissement, ou MTTR, mesure la durée nécessaire pour restaurer des données fiables ou un pipeline solide. Une suite peut produire des résultats exacts de réussite ou d'échec et exposer malgré tout l'entreprise à un risque évitable si les alertes arrivent tard.
Règle pratique : Traitez chaque contrôle qualité comme un signal opérationnel. Consignez quand la condition a changé, quand le système l'a détecté, qui a reçu l'alerte et quand les données concernées sont redevenues exploitables.
Les tests planifiés laissent des intervalles aveugles. Entre deux contrôles, une source peut cesser de charger, ajouter une colonne, changer un type ou produire une distribution inhabituelle. L'observabilité continue rétrécit cet intervalle en évaluant fraîcheur, schéma, valeurs et signaux de plateforme pendant que les données circulent, au lieu d'attendre la prochaine exécution.
La priorité d'un incident doit refléter l'impact métier. Un KPI de direction en retard, la défaillance d'un flux réglementaire et un problème sur une table de staging inutilisée ne devraient pas recevoir la même urgence. Le lineage, la propriété et l'usage en aval aident à diriger l'attention vers les défaillances susceptibles d'affecter des décisions ou des consommateurs critiques. Les équipes peuvent aussi utiliser un outil pour chiffrer le coût opérationnel d'une indisponibilité de données au moment de décider quels contrôles et quelles voies d'alerte méritent un investissement.
L'objectif opérationnel est clair : l'exactitude reste nécessaire, tandis que la latence de détection détermine jusqu'où voyage une défaillance. Les tests de qualité apportent plus de valeur quand ils donnent aux ingénieurs des preuves à temps, un contexte exploitable et un chemin direct de l'anomalie à la cause racine.
Métriques essentielles et mesure multidimensionnelle
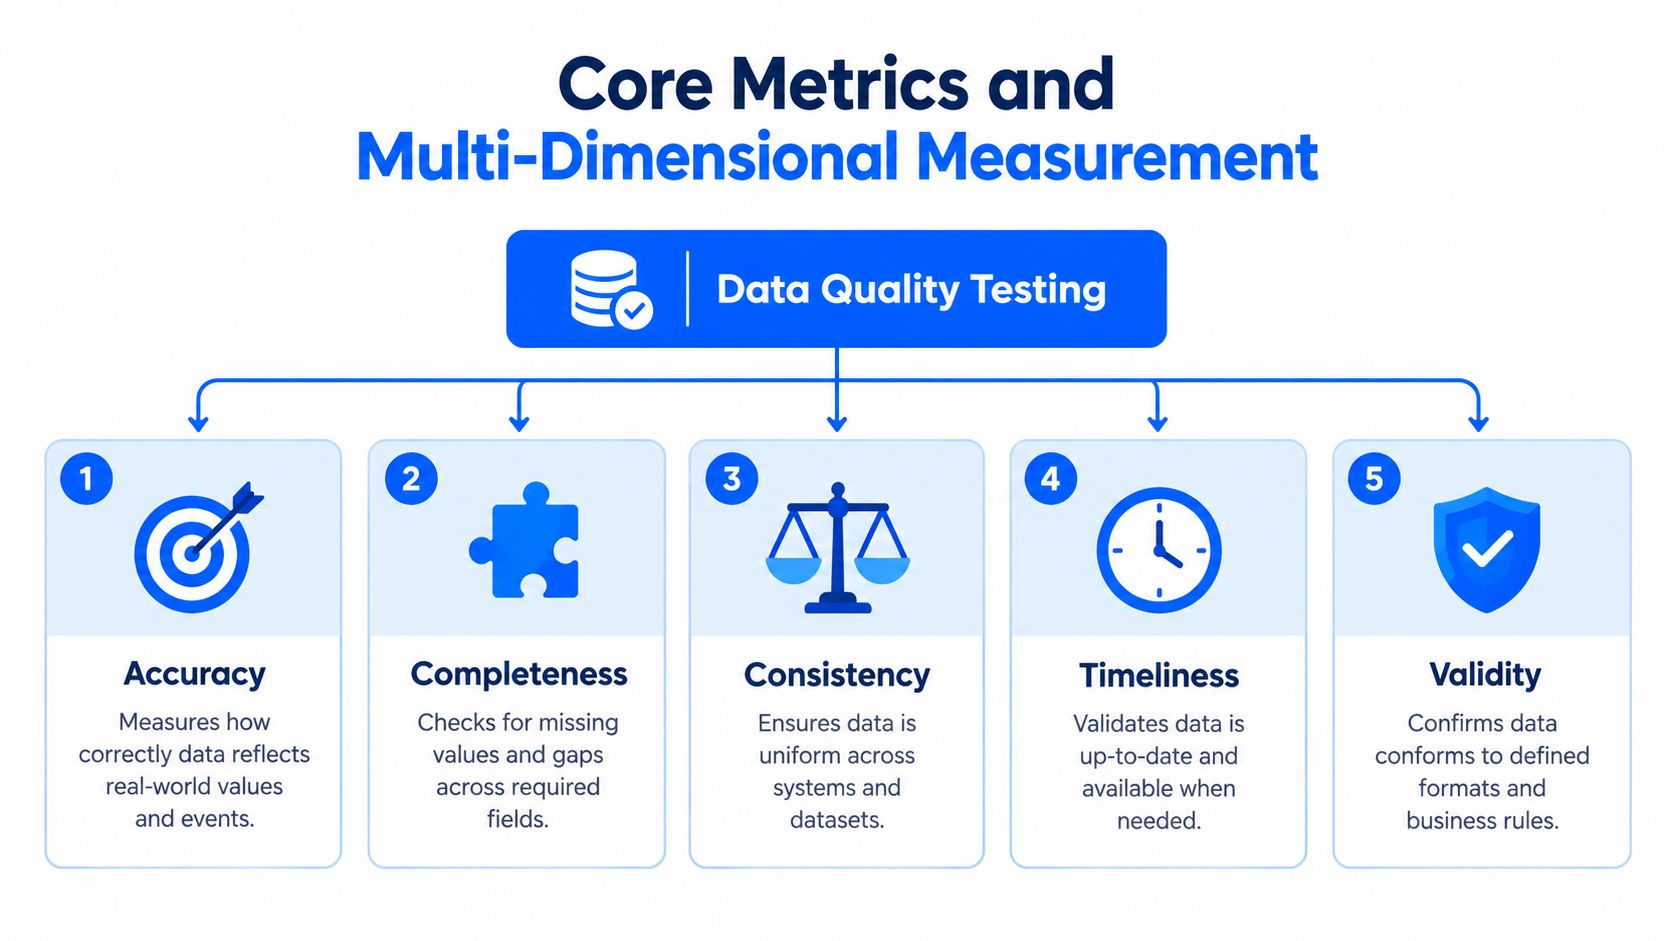
Un programme qualité fiable a besoin de plus qu'un pourcentage unique sur un tableau de bord. Le profilage établit des références statistiques, tandis que les dimensions de la qualité des données montrent si un jeu reste adapté à son usage prévu. La question opérationnelle est de savoir à quelle vitesse un écart significatif devient visible, pas seulement si une assertion planifiée finit par échouer.
Commencez par la forme des données
Profilez un jeu de données avant de décider quels contrôles appliquer. Parmi les sorties utiles :
Volume et structure : Les comptes de lignes et de colonnes révèlent chargements manquants, croissance inattendue et changements structurels.
Valeurs manquantes : Les pourcentages de nuls indiquent si les champs requis perdent en complétude.
Cardinalité : Les comptes de valeurs distinctes et de doublons signalent répétitions, unicité rompue et problèmes d'identité.
Distribution : Minimum, maximum, moyenne, médiane, écart-type, asymétrie et motifs de fréquence montrent si les valeurs correspondent encore au comportement attendu.
Le standard de qualité des données OpenMetadata inclut ces mesures de profilage aux côtés d'indicateurs opérationnels comme le taux de réussite ou d'échec des tests et le temps moyen de détection et de résolution. La combinaison relie deux points de vue. Le profilage décrit ce qui a changé dans les données, les mesures opérationnelles montrent si l'équipe a détecté et traité ce changement assez vite.
Testez plus que le contenu
Les contrôles de schéma et de complétude peuvent passer alors qu'un jeu reste inadapté à un modèle ou à un processus métier. Les valeurs peuvent avoir des types valides et peu de nuls, tout en provenant d'une source peu fiable, en représentant des conditions dépassées ou en reflétant une population déséquilibrée.
Une synthèse du cadre ETSI recense 18 métriques couvrant qualité fondamentale, utilisabilité, équité et confidentialité. La couverture du cadre ETSI est une synthèse de TelecomTV et non la publication du cadre elle-même. Son périmètre comprend complétude, exactitude, cohérence, lineage, traçabilité, fraîcheur, qualité des libellés et biais. Ensemble, ces dimensions définissent la qualité par le contenu, le contexte et la gouvernance.
Une conception de mesure en couches doit demander :
Les données sont-elles présentes et structurellement valides ?
Représentent-elles fidèlement les événements ou entités visés ?
Restent-elles cohérentes entre systèmes et transformations ?
Sont-elles arrivées dans la fenêtre métier ?
L'équipe peut-elle retracer origine, transformations, libellés et usages autorisés ?
Soutiennent-elles une analytique ou un développement de modèles équitables et respectueux de la vie privée ?
Les seuils dépendent de la finalité. Un jeu financier peut exiger rapprochement et traçabilité stricts. Un jeu exploratoire peut tolérer des champs incomplets tout en ayant besoin de fraîcheur et de lineage. N'appliquez que les contrôles capables d'invalider l'usage prévu, puis surveillez ces signaux en continu pour que les défaillances qualité apparaissent avant que des décisions en aval n'en dépendent.
Tests fondés sur des règles face à l'observabilité continue
Des règles écrites à la main offrent du contrôle. Une assertion SQL peut exprimer une attente exacte, comme exiger qu'une clé soit unique ou qu'une valeur de statut appartienne à une liste approuvée. Ce déterminisme a de la valeur pour la logique métier contractuelle, les contrôles réglementaires et les transformations dont le comportement attendu est connu.
Le problème apparaît quand les équipes font des règles statiques leur seule ligne de défense. Chaque nouvelle source, table, colonne et exception crée davantage de maintenance. Les seuils se périment, la couverture de tests reste concentrée sur les jeux les plus visibles, et les ingénieurs passent leur temps à mettre à jour des contrôles au lieu d'enquêter sur des changements significatifs.
La distinction s'évalue mieux côte à côte :
Dimension | Tests fondés sur des règles | Observabilité continue |
|---|---|---|
Mécanisme principal | Assertions SQL explicites et conditions fixes | Télémétrie, profilage, références et détection d'anomalies |
Meilleur usage | Règles métier stables et contraintes contractuelles | Pipelines changeants et modes de défaillance inconnus |
Force | Transparent et déterministe | Large couverture avec moins de gestion manuelle des seuils |
Faiblesse | La maintenance croît avec l'évolution des systèmes | Les alertes exigent du contexte et parfois une enquête |
Signal typique | Réussite ou échec face à une règle définie | Écart au comportement attendu dans le temps |
Réponse aux incidents | Commence souvent après un contrôle en échec | Peut révéler plus tôt les changements de fraîcheur, de schéma et de distribution |
Utilisez chaque approche là où elle a un levier
Les règles déterministes doivent garder les invariants. Exemples : intégrité référentielle, listes de codes autorisés, logique de rapprochement et contraintes de champs obligatoires. Ces contrôles expliquent exactement ce qui a échoué et pourquoi, ce qui les rend adaptés aux portes de release et aux preuves d'audit.
L'observabilité prend en charge les comportements difficiles à coder de façon exhaustive. L'apprentissage de référence peut repérer des volumes inhabituels, des chargements manquants, une dérive de schéma ou des distributions de valeurs sans obliger un ingénieur à prévoir chaque variation valide. Les travaux opérationnels cités dans les analyses de surveillance d'entrepôt et de qualité relient la surveillance des anomalies de volume, de schéma et de valeur à des MTTD et MTTR plus faibles, car la télémétrie fait remonter les défaillances plus près du moment où elles surviennent.
Les règles statiques vous disent si une condition connue a échoué. L'observabilité aide à révéler que le système se comporte différemment avant que vous sachiez quelle condition écrire.
Cela ne fait pas de la détection automatique d'anomalies un substitut au jugement d'ingénierie. Un changement saisonnier peut sembler anormal, et un ajout de schéma légitime peut déclencher une alerte. Les équipes ont toujours besoin de propriété, de lineage, de contexte d'incident et de workflows de suppression. Le motif pratique combine des contrôles explicites pour les obligations connues et une surveillance adaptative pour les changements inconnus.
Les ingénieurs à cheval entre fiabilité logicielle et fiabilité des données gagneront aussi à regarder le travail d'assurance qualité, en particulier là où conception de tests, tri des défauts et discipline de release recoupent l'exploitation des pipelines de données. Pour un traitement ciblé du modèle hybride, voir règles de validation et qualité des données continue.
Aligner les contrôles techniques sur le contexte métier
Un pipeline peut afficher un taux élevé de tests réussis et saper malgré tout une décision métier. La défaillance commence généralement par un écart entre ce que mesurent les ingénieurs et ce que les parties prenantes entendent par « bonnes données ».
La finance peut définir un enregistrement de revenu valide par le statut de comptabilisation, la période comptable, le traitement des devises et le rapprochement. Le marketing peut s'intéresser au consentement, à la résolution d'identité, à l'attribution et à la fraîcheur des campagnes. Les opérations peuvent privilégier la ponctualité de livraison, la disponibilité des stocks ou la couverture complète des événements. Le même jeu sous-jacent peut satisfaire la définition d'une équipe et échouer à celle d'une autre.
Rattachez les contrôles à des décisions, pas seulement à des tables
Partez de la question métier et remontez jusqu'aux conditions de données qui rendent la réponse fiable. Pour chaque KPI ou produit analytique important, documentez :
Le consommateur : Identifiez l'équipe ou le processus qui dépend de la sortie.
La définition : Consignez comment sont calculés des termes tels que « client actif », « revenu net » ou « livraison à l'heure ».
La conséquence d'une défaillance : Décrivez ce qui devient faux si les données sont tardives, incomplètes, dupliquées ou mal classées.
Les preuves : Précisez quels tests, enregistrements de lineage, rapprochements et journaux d'incidents attestent que la sortie reste apte à l'usage.
Cela crée un contrat de qualité doté d'une finalité. Cela évite aussi qu'une équipe célèbre une métrique qui exclut précisément les cas auxquels tiennent les parties prenantes.
Rendez visibles les définitions qui changent
Les définitions métier changent, et les schémas de pipeline changent avec elles. Une nouvelle colonne source peut modifier une jointure, un champ renommé peut casser un modèle en aval, et une définition de KPI révisée peut exiger des reprises historiques. Un lineage fondé sur les métadonnées aide à identifier quels consommateurs dépendent d'un champ ou d'une transformation, tandis qu'une validation native à l'entrepôt garde les contrôles près des données qu'ils protègent.
Les tableaux de bord qualité doivent exposer le périmètre, pas seulement le statut. Un score réussi a besoin d'une définition de métrique visible, d'une population, d'une fenêtre temporelle et d'une politique d'exclusion. Sinon, les équipes comparent l'incomparable ou confondent couverture étroite et fiabilité globale.
Un score de qualité n'est utile que lorsque son public comprend ce qu'il inclut, ce qu'il exclut et quelle décision il protège.
Les programmes les plus solides laissent les parties prenantes participer à la priorisation sans leur demander d'écrire du SQL. Les ingénieurs de données implémentent les contrôles, les analystes valident les définitions, et les responsables métier approuvent les conditions qui comptent. Cette répartition transforme les tests de qualité, d'une liste d'ingénierie, en une pratique d'exploitation dont on répond.
Le trou de gouvernance dans la gestion des données de test
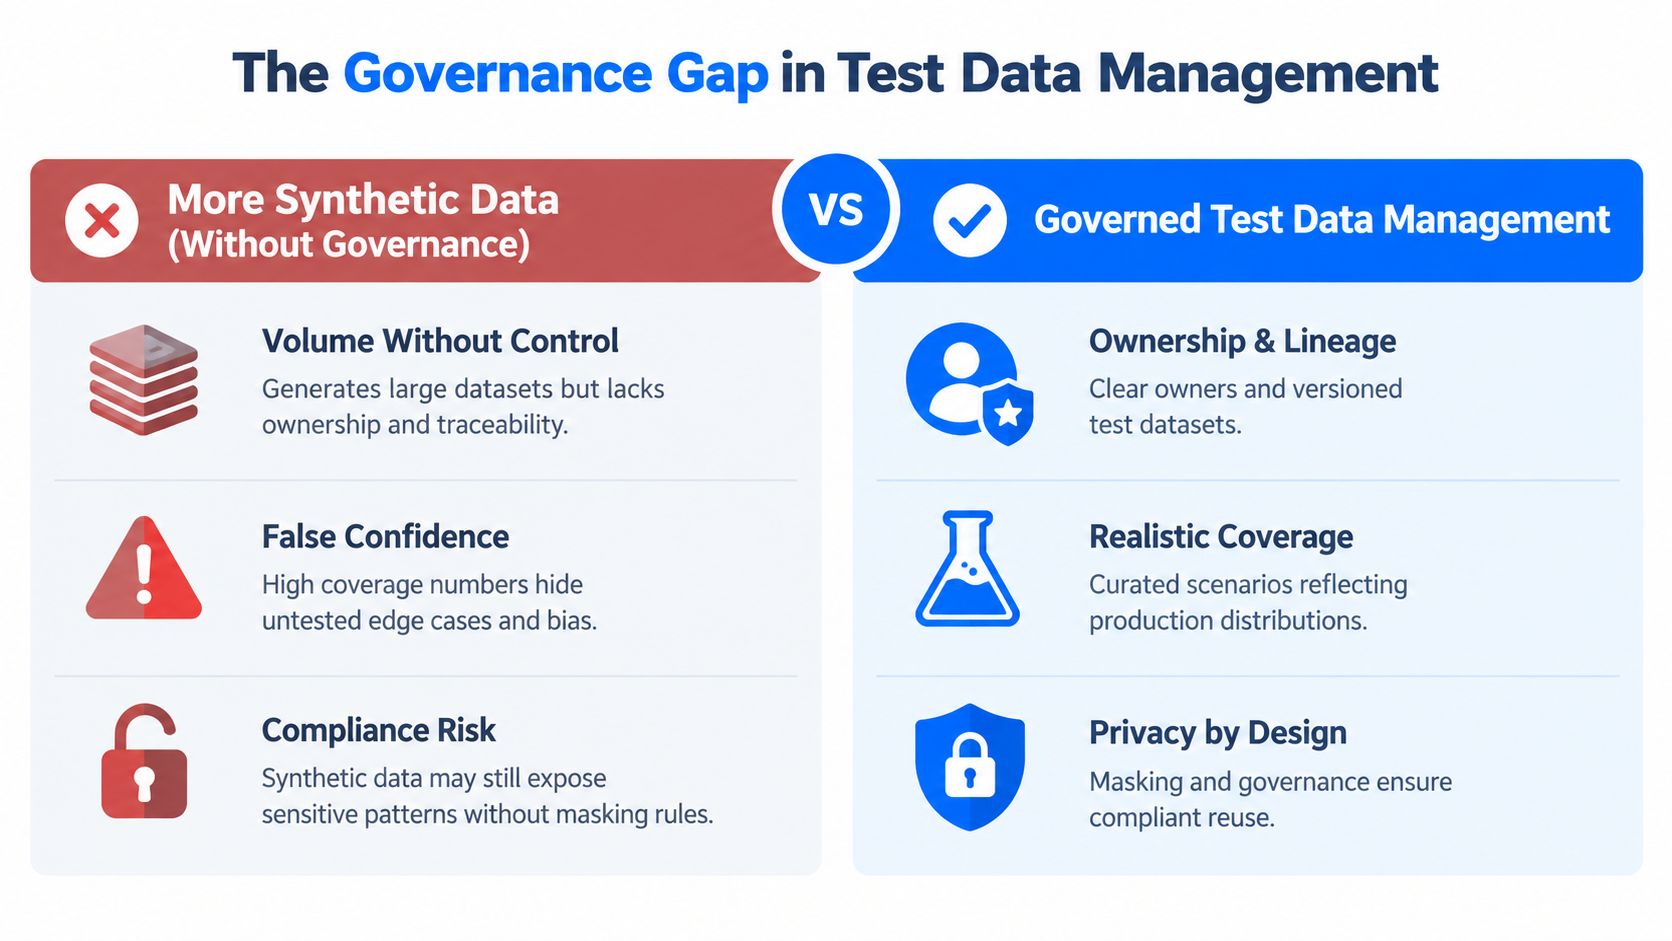
Des données de test synthétiques peuvent élargir la couverture de scénarios, mais le volume seul ne crée pas des tests dignes de confiance. Les équipes doivent savoir à qui appartient chaque jeu, quelles caractéristiques de production il représente, comment il a été généré et s'il peut être réutilisé sans risque.
La synthèse du World Quality Report 2025 à 2026 indique que 95 % des organisations utilisent l'IA pour générer des données de test, alors que seules 10 % ont pleinement intégré une gestion des données de test pilotée par l'IA et que près de 50 % n'ont pas de propriété centralisée (synthèse du World Quality Report). La même source indique que 35 % s'appuient sur des données synthétiques pour plus d'un quart de leurs données de test. Ensemble, ces constats décrivent un problème de gouvernance, et pas seulement de génération.
Plus de données peut masquer moins de couverture
Des données synthétiques non gouvernées paraissent souvent productives parce qu'elles produisent vite beaucoup d'enregistrements. Pourtant le volume généré peut omettre des combinaisons rares, des distributions réalistes, des transitions invalides ou les cas limites qui provoquent les pannes en production. Une suite de tests peut donc sembler large tout en restant faible là où le risque réel se concentre.
Une gestion gouvernée des données de test suppose un modèle d'exploitation clair :
Propriété : Attribuez la responsabilité de la création, de l'approbation, de la maintenance et du retrait des jeux de données.
Traçabilité : Consignez caractéristiques sources, logique de génération, transformations, versions et scénarios de test visés.
Application des politiques : Appliquez masquage, accès, rétention et réutilisation de façon cohérente.
Revue de couverture : Comparez les scénarios synthétiques au comportement de production et aux modes de défaillance connus.
Intégration : Reliez les workflows de données de test aux pipelines de livraison, aux résultats qualité et à la remédiation des incidents.
La confidentialité exige elle aussi plus que d'étiqueter des données « synthétiques ». Les enregistrements générés peuvent reproduire des motifs sensibles ou ressembler d'assez près à des distributions réelles pour créer une exposition si les équipes sautent le masquage et les contrôles d'accès. La gouvernance doit couvrir tout le cycle de vie, de la création au stockage, au partage, à l'exécution et à la suppression.
La conclusion à contre-courant est pratique : davantage de données synthétiques ne signifie pas automatiquement de meilleurs tests. Sans propriété centralisée ni traçabilité, elles peuvent ajouter fragmentation, fausse confiance et angles morts. Les équipes devraient optimiser des scénarios représentatifs et une réutilisation assumée, pas le volume d'enregistrements.
Construire un cadre de tests en couches pour l'ETL
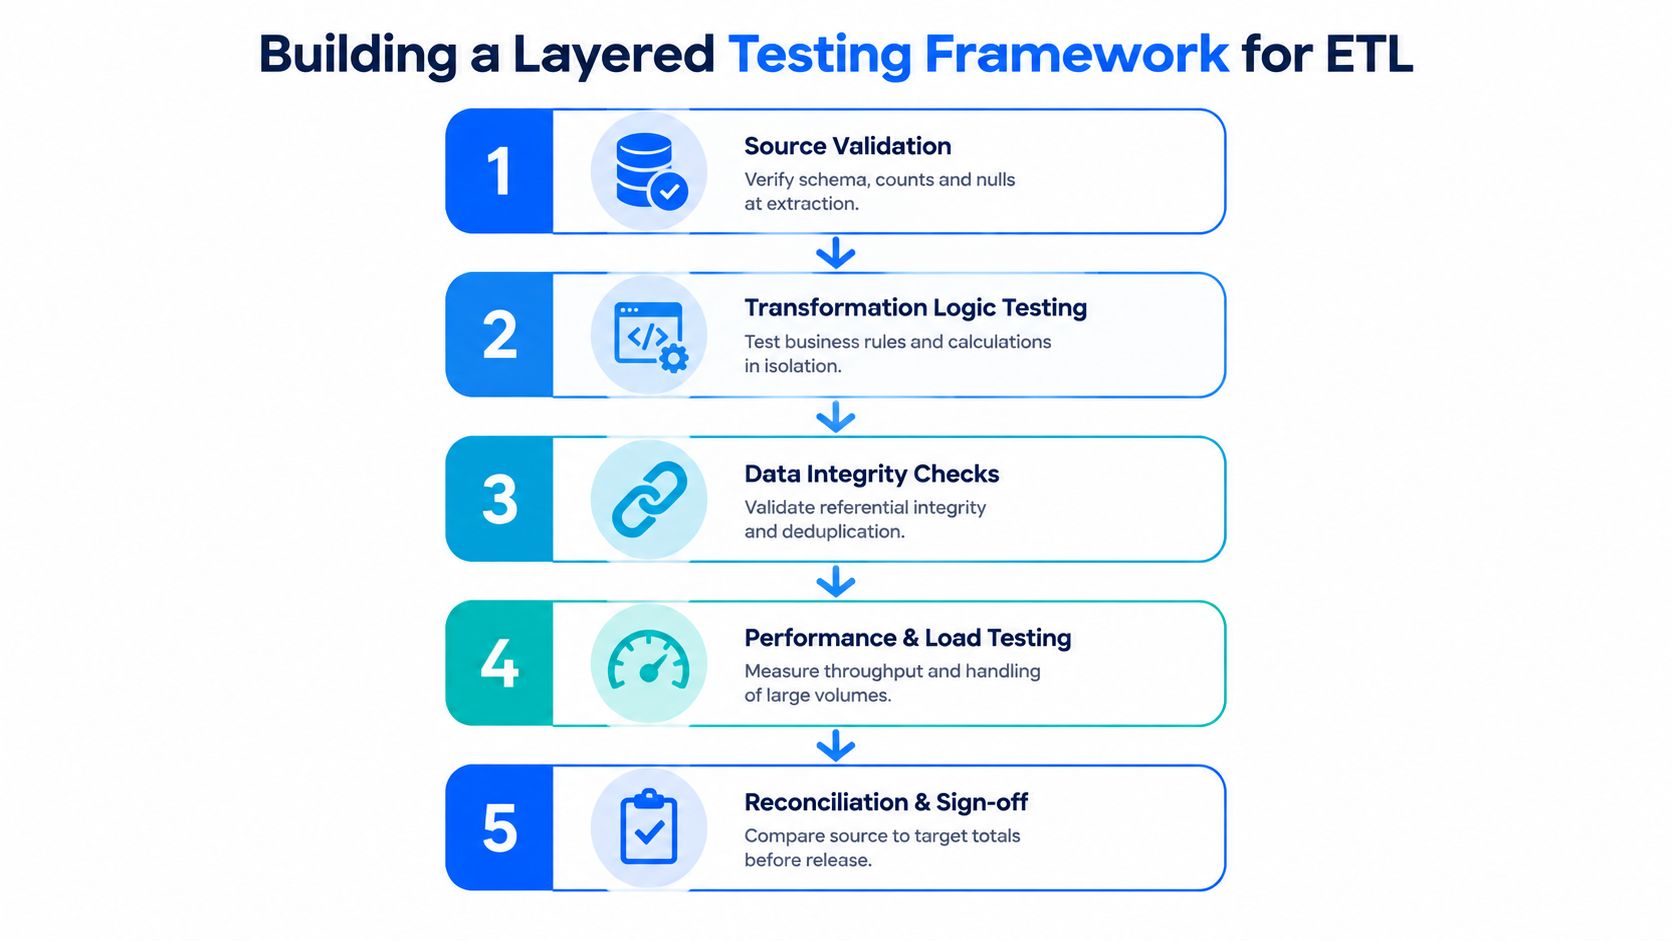
Un job ETL doit rester non vérifié tant qu'il n'a pas passé les contrôles de fraîcheur, de schéma et au niveau de l'enregistrement. Exécuter ces contrôles en séquence donne aux ingénieurs un moyen rapide de distinguer les défaillances de livraison des changements structurels et des défauts de contenu.
Commencez par la livraison et la structure
La fraîcheur d'abord. Confirmez que le chargement attendu est arrivé dans la fenêtre métier du jeu de données. Une table techniquement valide contenant les données d'hier peut rester inutilisable pour une décision opérationnelle. Les alertes Timeliness doivent se déclencher quand le retard de livraison franchit cette fenêtre définie, plutôt que de s'appuyer sur un calendrier générique ignorant le contexte métier.
Viennent ensuite les contrôles de schéma. Surveillez colonnes ajoutées, colonnes supprimées et modifications de type. Certains changements sont compatibles et intentionnels, d'autres cassent des transformations ou modifient le sens en aval sans prévenir. L'alerte doit indiquer l'objet concerné, le type de changement, le responsable et les dépendances en aval.
Puis la validation au niveau de l'enregistrement. Testez présence de nuls, valeurs exactes, seuils, plages, listes de référence, doublons, relations et règles métier. Gardez ces contrôles près de la couche de transformation ou de destination, là où la sémantique pertinente est disponible.
Pour la mise en œuvre, utilisez une porte de release qui consigne chaque couche indépendamment :
Validation de la source : Confirmez structure, volume et champs requis attendus avant transformation.
Logique de transformation : Testez calculs, mappages, filtres et règles métier isolément.
Validation d'intégrité : Vérifiez relations référentielles, unicité, déduplication et rapprochement.
Observation de performance : Surveillez comportement d'exécution, débit et prise en charge de la charge.
Validation de release : Comparez les preuves source et cible, puis consignez la décision et les exceptions approuvées.
Calculez l'exactitude là où vivent les données
Les règles de validation en SQL peuvent s'exécuter nativement sur le moteur de calcul de la source, évitant une extraction inutile pour les contrôles d'enregistrement. La documentation d'Actian décrit un calcul d'exactitude concret fondé sur le pourcentage d'enregistrements où is_valid = 1 (validation de la qualité au niveau de l'enregistrement). Ce qui est utile n'est pas l'étiquette elle-même. C'est la capacité de calculer un résultat transparent au niveau de l'enregistrement, près de la source, et de conserver les preuves des enregistrements en échec pour la remédiation.
Pour un panorama des concepts ETL appliqués aux workflows de test, voir ce que signifie ETL dans les tests logiciels. Le détail d'implémentation le plus important est la gestion des échecs. Un contrôle de fraîcheur en échec doit arrêter ou mettre en quarantaine la publication en aval, tandis qu'un petit nombre d'enregistrements invalides peut partir en remédiation selon le risque du jeu de données et la politique métier.
Passer la qualité à l'échelle avec l'observabilité en base
Les tests de qualité continus deviennent difficiles quand chaque métrique exige un déplacement de données, une infrastructure séparée et une interface différente. L'observabilité en base change l'architecture en calculant et en analysant les signaux qualité à l'intérieur de l'environnement existant du client.
Cette conception réduit les déplacements inutiles et garde les contrôles d'accès alignés sur les systèmes qui protègent déjà les données de production. Elle permet aussi aux ingénieurs de surveiller tables d'entrepôt, actifs de lac et sorties de pipeline sans créer une copie parallèle uniquement pour l'analyse qualité. Pour les équipes soumises à des exigences strictes de sécurité ou de gouvernance, la distinction compte : la plateforme analyse les données là où elles résident au lieu d'exiger que les enregistrements de production quittent l'environnement.
Combinez statistiques, règles et contexte opérationnel
Une couche d'observabilité pragmatique doit réunir plusieurs formes de preuves :
Références statistiques : Apprenez volume, distributions et volatilité normaux pour chaque jeu de données.
Validation déterministe : Faites respecter règles métier et contraintes au niveau de l'enregistrement.
Surveillance Timeliness : Détectez les livraisons tardives, manquantes ou étonnamment précoces.
Suivi de schéma : Repérez colonnes ajoutées ou supprimées et changements de type.
Lineage et propriété : Reliez les incidents aux consommateurs concernés et aux équipes responsables.
Statut partagé : Donnez à ingénieurs, analystes et référents métier une vue commune de la qualité.
L'approche d'exécution de la qualité en base est utile quand les équipes ont besoin de ces contrôles sans exporter de données de production sensibles. La contrepartie est que l'observabilité demande encore une configuration réfléchie. Les références peuvent produire des alertes bruyantes si les équipes ignorent la saisonnalité, si la propriété est floue ou si les consommateurs ne voient pas pourquoi un incident compte.
Le modèle d'exploitation durable traite la qualité des données comme un niveau de service de l'information. Les équipes définissent ce qui doit être exact, ce qui doit arriver à l'heure et quels changements exigent une revue. La surveillance mesure alors non seulement si la condition a échoué, mais aussi à quelle vitesse les gens l'ont détectée et résolue.
Les tests de qualité des données ne sont pas une tâche ponctuelle de migration. C'est une pratique continue qui protège l'analytique, le reporting et les systèmes d'IA contre les changements silencieux et les réponses tardives.
digna fournit détection d'anomalies en base, validation au niveau de l'enregistrement, surveillance Timeliness et suivi de schéma au sein de votre propre environnement de données. Rendez-vous sur digna pour évaluer comment sa plateforme d'observabilité modulaire peut aider votre équipe à détecter plus tôt les défaillances qualité et à relier les incidents techniques aux jeux de données et décisions qu'ils touchent.
Les tests vous disent qu'une règle a échoué ; l'observabilité de plateforme de données vous dit quel changement en amont l'a provoquée, et c'est cela qui fait baisser le MTTR, pas seulement le MTTD.
Questions fréquentes
Combien de temps faut-il aujourd'hui pour détecter un incident de données ?
Plus qu'avant. Dans une enquête sectorielle de 2026, 68 % des répondants ont indiqué une détection de quatre heures ou plus, contre 62 % en 2022, tandis que le temps moyen de résolution a augmenté de 166 % pour atteindre 15 heures par incident.
Pourquoi MTTD et MTTR ont-ils leur place dans un programme qualité ?
Parce que l'exactitude seule ne borne pas les dégâts. Le temps moyen de détection mesure le délai avant qu'une équipe sache qu'un incident existe, et la latence de détection détermine jusqu'où la défaillance se propage avant qu'on l'arrête.
Que profiler en premier dans une suite de tests ?
La forme des données : volume et structure pour révéler les chargements manquants et les changements structurels, valeurs manquantes via les pourcentages de nuls, cardinalité via les comptes distincts et doublons, et distribution via minimum, maximum, moyenne, médiane, écart-type et asymétrie.
Tester le contenu suffit-il ?
Non. Les contrôles de schéma et de complétude peuvent passer alors que le jeu de données reste inadapté à un modèle ou à un processus métier. Une synthèse du cadre ETSI recense 18 métriques couvrant qualité fondamentale, utilisabilité, équité et confidentialité.
Où les règles l'emportent-elles sur l'observabilité, et l'inverse ?
Les règles déterministes doivent garder les invariants et les contraintes contractuelles, là où la transparence compte. L'observabilité couvre les pipelines changeants et les modes de défaillance inconnus, révélant les changements de fraîcheur, de schéma et de distribution avant qu'on sache quelle condition écrire.



