Qualité des données ETL : un guide pratique pour des pipelines fiables
|
6
minute de lecture

Votre pipeline est passé au vert à 2:14 AM. Au petit-déjeuner, la finance scrute des lignes de revenus incohérentes, les analystes se demandent si l'entrepôt est en panne, et votre outil d'orchestration continue d'insister sur le fait que tout a réussi. Cet écart entre la santé du job et la santé des données est précisément l'endroit où la qualité des données ETL échoue généralement en pratique.
Le plus difficile n'est pas d'exécuter des vérifications. C'est de concevoir des contrôles qui remarquent quand le comportement des données a changé, et pas seulement quand une tâche a échoué. Les pipelines ETL peuvent se terminer à temps, atteindre les nombres de lignes attendus, tout en acheminant en aval des données corrompues, obsolètes ou structurellement incompatibles. C'est pourquoi la qualité doit être mesurée sur les données elles-mêmes, et non sur le statut de succès associé au job.
Table des matières
Quand les pipelines au vert produisent des données corrompues
Les cinq dimensions de qualité que chaque pipeline ETL doit surveiller
Validation basée sur des règles versus détection d'anomalies par l'IA
Mécanismes de validation au niveau de l'enregistrement pour intercepter les défauts
Surveillance de la Timeliness et fenêtres de livraison attendues
Dérive de schéma et comment la détecter avant les pannes en aval
Quand les pipelines au vert produisent des données corrompues
Une exécution au vert peut sembler correcte jusqu'à ce que quelqu'un ouvre le tableau de bord et constate des chiffres déconnectés de la réalité. La couche ETL peut se terminer avec succès alors qu'un système source modifie un champ décimal, qu'un fichier arrive à moitié vide ou qu'une contrainte de type transforme des valeurs valides en quelque chose qui se charge toujours mais ne signifie plus ce qu'il était censé signifier. Au moment où la finance, les opérations ou la BI repèrent le problème, l'incident du pipeline est déjà de l'histoire ancienne et le nettoyage s'est déplacé en aval.
La recherche historique sur l'ETL est catégorique quant à l'origine de ces échecs. Une étude sur les déploiements ETL a révélé que les jobs ETL échouant en cours de route, les systèmes verrouillés pendant l'exécution, et le fait que les utilisateurs ne trouvent pas les données dans la cible parce que les clés primaires ont été incorrectement transformées figuraient parmi les problèmes les plus courants, et ces mêmes processus provoquaient des problèmes d'exactitude, de Timeliness, de crédibilité et de cohérence de représentation (Étude sur les échecs de qualité des données ETL). La leçon est simple. Le pipeline lui-même peut introduire le défaut, même si le système source semblait correct.
Pourquoi le statut d'exécution ne suffit pas
Les outils d'orchestration indiquent principalement si une tâche s'est exécutée, et non si les données se sont comportées correctement. Un job peut se terminer à l'heure et tout de même livrer des charges partielles, manquer une partition ou contraindre des valeurs lors de la transformation. C'est pourquoi les contrôles doivent se situer au niveau de la couche de données, et pas seulement de la couche de workflow.
Règle pratique : traitez chaque exécution ETL réussie comme non vérifiée tant que les données n'ont pas passé les contrôles de fraîcheur, de schéma et de niveau d'enregistrement.
Le coût d'une mauvaise gestion de ce problème n'est pas abstrait. Gartner a estimé qu'une mauvaise qualité des données coûte aux entreprises en moyenne 12,9 millions de dollars par an, et les synthèses du secteur indiquent que les mauvaises données peuvent entraîner une perte de revenus de 15 % à 25 % dans certaines entreprises, ce qui explique pourquoi les contrôles de qualité ETL précoces sont si importants (Coûts d'une mauvaise qualité de données). Eppler et Helfert ont également décrit 23 types de coûts distincts liés à des données de faible qualité, notamment la maintenance, le travail excédentaire, la ressaisie des données, la perte de revenus, la perte de clients et le retraitement. Ils ont également identifié 10 catégories de coûts d'assurance qualité des données, telles que l'inspection, la prévention des défauts, la réparation, la formation et l'amélioration des processus. En termes clairs, la facture arrive, que vous investissiez ou non dans la qualité.
Ce qui casse généralement en premier
Les pannes qui font le plus mal sont les plus silencieuses. Un fichier arrive en retard mais se charge quand même. Un système source ajoute une colonne et votre parseur l'ignore. Un champ numérique devient du texte, et l'entrepôt de données l'accepte après conversion. Aucun de ces problèmes n'arrête nécessairement le job, mais ils empoisonnent tous les données.
La bonne réponse est une surveillance superposée, pas l'espoir. Vous avez besoin de signaux comportementaux qui vous indiquent quand le pipeline produit des données qui ne correspondent plus à la forme, au timing ou à la distribution attendus. Cela signifie qu'il faut regarder au-delà de l'exécution et s'intéresser aux propriétés des enregistrements eux-mêmes.
Les cinq dimensions de qualité que chaque pipeline ETL doit surveiller
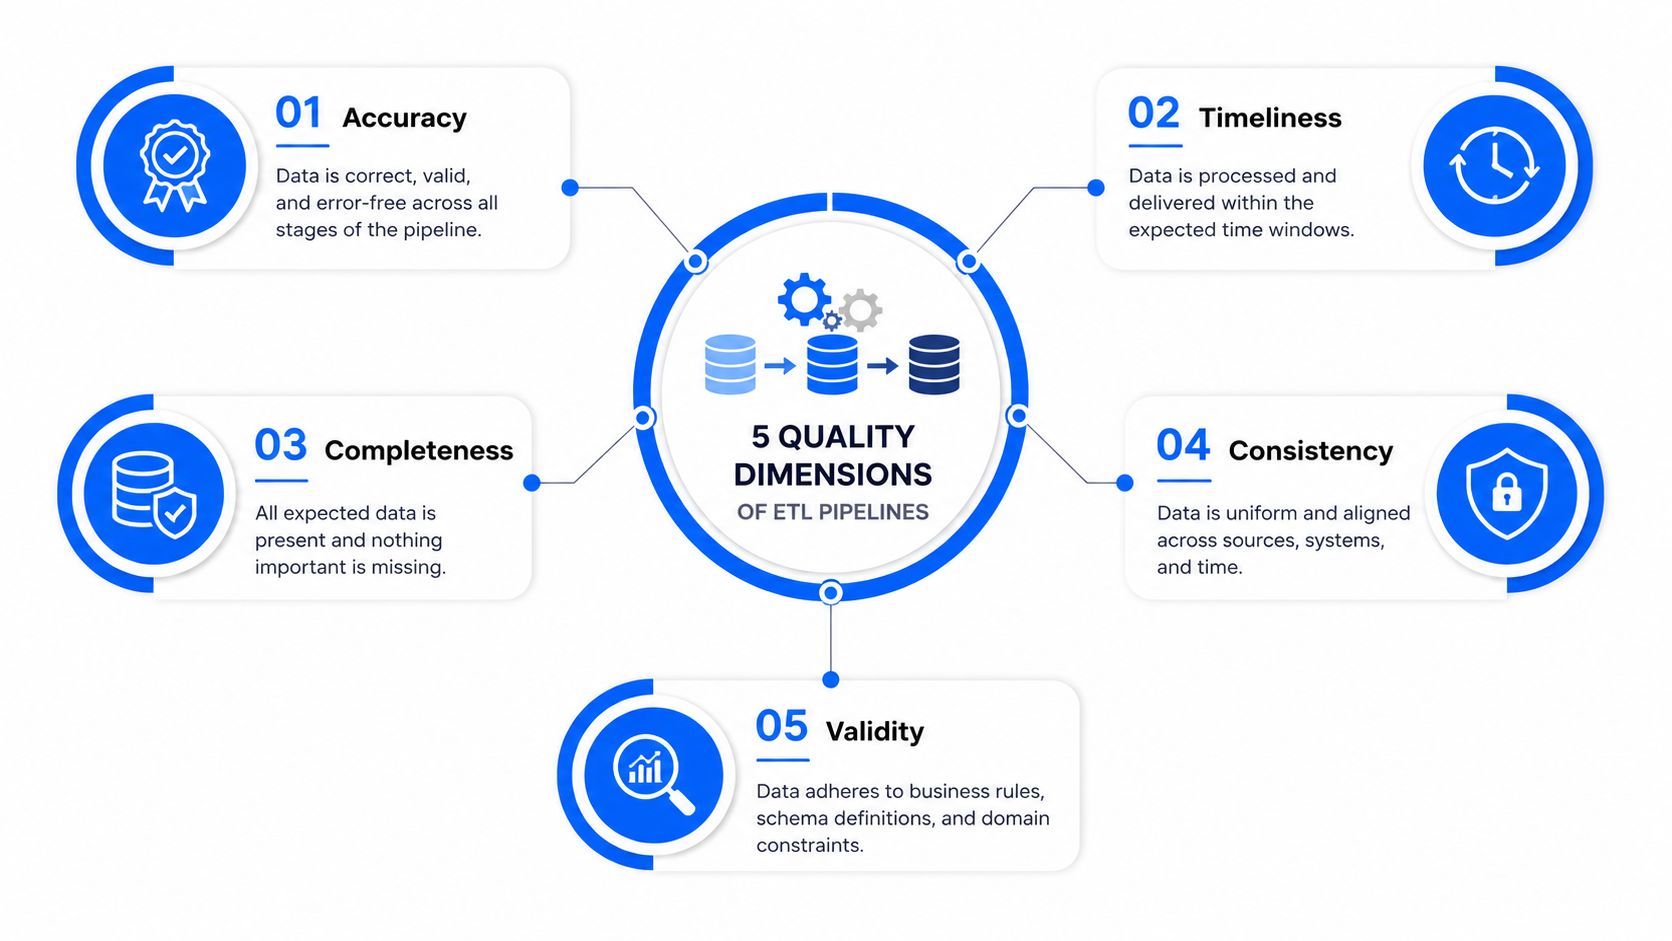
La qualité ETL fonctionne au mieux lorsque vous arrêtez de la traiter comme un score unique. La recherche moderne en Observability structure le problème autour de la fraîcheur, du schéma, du volume, de la distribution et de la lignée, et ce découpage correspond parfaitement aux dimensions académiques plus anciennes que sont l'exactitude, l'exhaustivité, la cohérence, la Timeliness, la validité et l'unicité (Piliers de l'Observability moderne, aperçu académique des dimensions de qualité ETL). Chacune d'elles détecte un mode de défaillance différent, et aucune ne remplace les autres.
La fraîcheur vous indique si le dernier enregistrement valide arrive bien. Le schéma détecte la dérive structurelle, y compris les nouvelles colonnes, les champs supprimés et les changements de types. Le volume signale les baisses ou hausses soudaines qui suggèrent une troncature ou une duplication. La distribution fait ressortir des changements plus subtils, comme des variations de taux de valeurs nulles ou des plages de valeurs modifiées. La lignée permet de remonter le problème jusqu'à la source et à l'étape de transformation qui l'a introduit.
Pourquoi les cinq piliers doivent fonctionner ensemble
Si vous ne surveillez que le schéma, vous manquerez des données obsolètes mais structurellement valides. Si vous ne surveillez que le volume, un chargement incorrect peut tout de même passer car le nombre de lignes semble normal. Si vous ne surveillez que la fraîcheur, vous pouvez toujours livrer un fichier structurellement incorrect pile à l'heure. C'est pourquoi il s'agit de signaux comportementaux, et non de cases à cocher interchangeables.
Une excellente ressource pour les équipes qui construisent cette discipline est le guide sur les normes de qualité des données d'entraînement, surtout si vous essayez d'aligner les analystes, les ingénieurs et les responsables de la governance sur les mêmes attentes. Le but n'est pas d'accumuler les verrous, mais de rendre visible le bon mode de défaillance avant que l'entrepôt ne devienne le seul endroit où l'on s'en aperçoit.
Je garde également une référence interne simple pour les équipes qui souhaitent une décomposition plus formelle des piliers dans les dimensions de la qualité des données de digna. Ce type de vocabulaire partagé est essentiel lorsque différentes équipes utilisent les mêmes mots pour désigner des choses différentes.
Ce que chaque dimension détecte réellement
La Fraîcheur détecte les livraisons manquantes ou retardées avant que les tableaux de bord ne deviennent obsolètes.
Le Schéma détecte les changements de structure non annoncés qui bloquent les consommateurs ou corrompent les correspondances.
Le Volume détecte la troncature, la duplication et les chargements partiels.
La Distribution détecte les variations des taux de valeurs nulles, des plages de valeurs et de la cardinalité que les règles ligne par ligne manquent souvent.
La Lignée vous aide à tracer la défaillance jusqu'à un système source, un job ou une étape de transformation.
Un entrepôt de données ne semble sain que lorsque vous vérifiez la bonne couche.
Les déploiements d'Observability les plus robustes ne demandent pas à une seule dimension de faire tout le travail. Ils utilisent chaque dimension comme un prisme différent sur le même pipeline afin qu'un problème puisse être intercepté là où il a commencé, et non après avoir déjà impacté les rapports en aval.
Validation basée sur des règles versus détection d'anomalies par l'IA
La validation basée sur des règles reste essentielle, mais elle ne couvre que ce que vous savez déjà attendre. Si un champ de revenus ne doit jamais être négatif, si un code pays doit appartenir à un ensemble défini, ou si une clé étrangère doit exister avant le chargement d'une ligne de faits, une règle doit l'imposer. C'est un contrôle strict, et les contrôles stricts sont une bonne chose.
Le problème est que les règles sont aveugles aux comportements qui évoluent sans enfreindre de contrainte stricte. Une source peut commencer à envoyer des enregistrements en retard, un champ peut devenir plus bruité, une jointure peut perdre des clés correspondantes, ou une distribution peut dériver suffisamment pour fausser les analyses tout en passant chaque contrôle statique. C'est là que la détection d'anomalies prend tout son sens. Pour un aperçu plus large de ce modèle, le guide de détection des anomalies ETL mérite d'être lu en parallèle avec l'approche de détection des anomalies de digna.
Le compromis pratique est simple. Les règles sont précises et faciles à expliquer. La détection d'anomalies couvre un territoire plus vaste, mais elle nécessite une référence et peut générer du bruit si vous n'ajustez pas soigneusement la responsabilité et les alertes. D'après mon expérience, les équipes s'exposent à des problèmes lorsqu'elles traitent la détection d'anomalies comme un substitut aux contrôles déterministes. Ce n'est pas le cas.
Là où chaque approche l'emporte
Dimension | Validation basée sur des règles | Détection d'anomalies par l'IA |
|---|---|---|
Coût de configuration | Plus faible pour les contraintes connues | Plus élevé car nécessite un comportement de référence historique |
Couverture | Étroite, mais exacte | Plus large, détecte les dérives et les schémas inhabituels |
Charge de maintenance | Augmente à mesure que les règles s'accumulent | Augmente si les références, les responsables et l'ajustement ne sont pas gérés |
Délai d'obtention des insights | Immédiat pour les défaillances définies | Rapide une fois les modèles appris, mais pas toujours instantané au premier jour |
Points aveugles | Inconnues inconnues et dérive de comportement | Invariants métier stricts et exigences réglementaires explicites |
Comment les superposer sans créer un chaos d'alertes
Commencez par des règles pour les invariants que vous ne voudriez jamais assouplir. Superposez ensuite la détection d'anomalies pour les métriques sujettes à la dérive, telles que le volume, les taux de valeurs nulles et les corrélations de champs. Si un enregistrement échoue à l'une ou l'autre couche, orientez-le vers une zone de quarantaine ou une file d'attente d'examen plutôt que de le laisser continuer en aval.
Cette approche maintient également vos contrôles explicables. Les ingénieurs peuvent déboguer une contrainte en échec. Les analystes peuvent comprendre pourquoi une référence a changé. Les équipes de governance disposent d'un enregistrement de ce qui a été bloqué et pourquoi. Lorsqu'il est bien conçu, le système ressemble moins à un mur de contrôles fragiles qu'à un ensemble calibré de garde-fous.
Mécanismes de validation au niveau de l'enregistrement pour intercepter les défauts
Les contrôles au niveau de l'enregistrement ne fonctionnent que lorsqu'ils sont associés à un impact métier, et pas seulement à un statut de réussite ou d'échec. Un champ nullable manquant dans un ensemble de données à faible risque n'a pas la même importance qu'une clé manquante dans une table de faits de revenus. Le contrôle doit refléter cette différence, sous peine de devenir soit trop strict pour être viable, soit trop lâche pour être utile.
Les travaux sur l'ETL clinique montrent à quel point la qualité peut rapidement se dégrader lorsque les définitions sont floues. Dans une étude hospitalière, les taux d'erreur d'extraction manuelle et les taux d'erreur d'exportation automatisée variaient selon que les champs ambigus étaient exclus ou non, ce qui met en évidence une leçon simple : l'automatisation ne garantit pas la qualité, et la clarté des définitions de données modifie sensiblement les taux de défauts.
Utiliser des seuils, pas seulement des comptages
Un taux d'échec de 0,1 % sur un chargement de 50 millions de lignes pose un problème opérationnel différent du même taux sur un lot de 1 000 lignes. Le premier peut masquer des dizaines de milliers de lignes incorrectes. Le second peut être un échantillon restreint mais critique où le moindre défaut compte.
C'est pourquoi les niveaux de gravité sont essentiels. Les statuts Avertir, Quarantaine et Arrêter donnent au pipeline la marge nécessaire pour réagir sans devenir à la fois rigide et permissif.
Les mécanismes de validation doivent rester concrets. Un article sur la validation ETL de 2021 recommande de vérifier le nombre exact de colonnes, les types de données et les contraintes de colonnes, ainsi que la présence et l'ordre des colonnes pour les fichiers plats, en plus des contraintes de clé primaire, de clé étrangère et d'index unique (article sur les mécanismes de validation). Cela reste le pilier d'une validation fiable au niveau de l'enregistrement.
Les vérifications payantes en pratique
Détection des valeurs nulles : Analysez le profil des colonnes et définissez des plages de densité acceptables, en particulier pour les champs métier obligatoires.
Application des clés : Rejetez les clés primaires dupliquées et les clés étrangères orphelines avant qu'elles ne contaminent les jointures en aval.
Validation de domaine : Utilisez des valeurs contrôlées pour des champs tels que les codes pays ISO et d'autres énumérations limitées.
Seuils métiers : Exprimez les bandes de tolérance de revenus, les limites de taux de retour ou les seuils d'annulation sous forme de pourcentages des lignes entrantes.
Faits à arrivée tardive : Validez par rapport aux fenêtres de date d'effet pour que les événements se positionnent dans la bonne tranche temporelle.
Je préfère mettre en quarantaine les lignes ambiguës plutôt que de les laisser altérer le jeu de données de confiance. La quarantaine donne aux producteurs de données une chance de corriger la source ou le mapping sans transformer l'entrepôt en collecteur de déchets.
Règle opérationnelle : si l'équipe ne peut pas expliquer pourquoi une ligne en échec peut être ignorée en toute sécurité, elle ne doit pas être ignorée.
Un point pratique : n'écrivez pas de règles pour chaque cas limite. Commencez par les champs qui alimentent la finance, la Compliance, les workflows clients et l'entraînement des modèles. C'est là que les défauts de qualité deviennent le plus rapidement coûteux.
Type de contrôle | Ce qu'il détecte | Conseils sur les seuils | Action recommandée |
|---|---|---|---|
Contrôles de valeurs nulles | Valeurs obligatoires manquantes | Défini selon la criticité du champ et la taille du jeu de données | Avertir pour les champs à faible risque, quarantaine pour les champs critiques |
Contraintes de clé | Doublons et relations rompues | Tolérance zéro pour les clés d'identité | Arrêter ou mettre en quarantaine |
Règles de domaine | Codes invalides et valeurs hors ensemble | Utiliser des listes limitées de valeurs autorisées | Rejeter ou orienter vers une correction |
Contrôles de plage | Valeurs aberrantes et impossibles | Définir des limites spécifiques au métier | Avertir sur les limites souples, quarantaine sur les limites strictes |
Date d'effet | Événements tardifs ou mal datés | Valider par rapport aux fenêtres attendues | Mettre en quarantaine et retraiter si nécessaire |
Pour les équipes souhaitant un ensemble de contrôles plus large, le guide des règles de Data Validation et de qualité continue de digna est un complément utile à ces contrôles au niveau de l'enregistrement.
Surveillance de la Timeliness et fenêtres de livraison attendues
Un pipeline peut être au vert tout en fournissant des données obsolètes. C'est ce qui casse les tableaux de bord du matin, et non une alerte de job en échec. La Timeliness doit être traitée comme un SLA, avec une fenêtre de livraison attendue liée au moment où l'entreprise utilise le jeu de données.
Le contrôle est simple dans son concept et impitoyable en pratique. Comparez l'arrivée attendue avec l'arrivée réelle, puis qualifiez l'exécution de précoce, tardive, manquante ou partielle. Un flux de ventes qui doit arriver avant une revue de revenus à 8h00 dispose d'une fenêtre étroite, tandis qu'un flux de rapports de l'après-midi peut tolérer une attente plus longue. Utilisez l'heure limite du métier, et non la planification de l'outil d'orchestration, comme point de référence.
La manière la plus propre de définir cette fenêtre est d'apprendre des schémas d'exécution antérieurs, de la cadence de validation des sources et du temps de consommation. Si l'équipe consulte les tableaux de bord en début de journée, un glissement de dix minutes peut avoir de l'importance. Si les données ne sont utilisées qu'après le déjeuner, ce même retard peut être insignifiant. Le guide des métriques de Timeliness de digna offre un cadre utile pour définir ces fenêtres et les mesurer de manière cohérente.
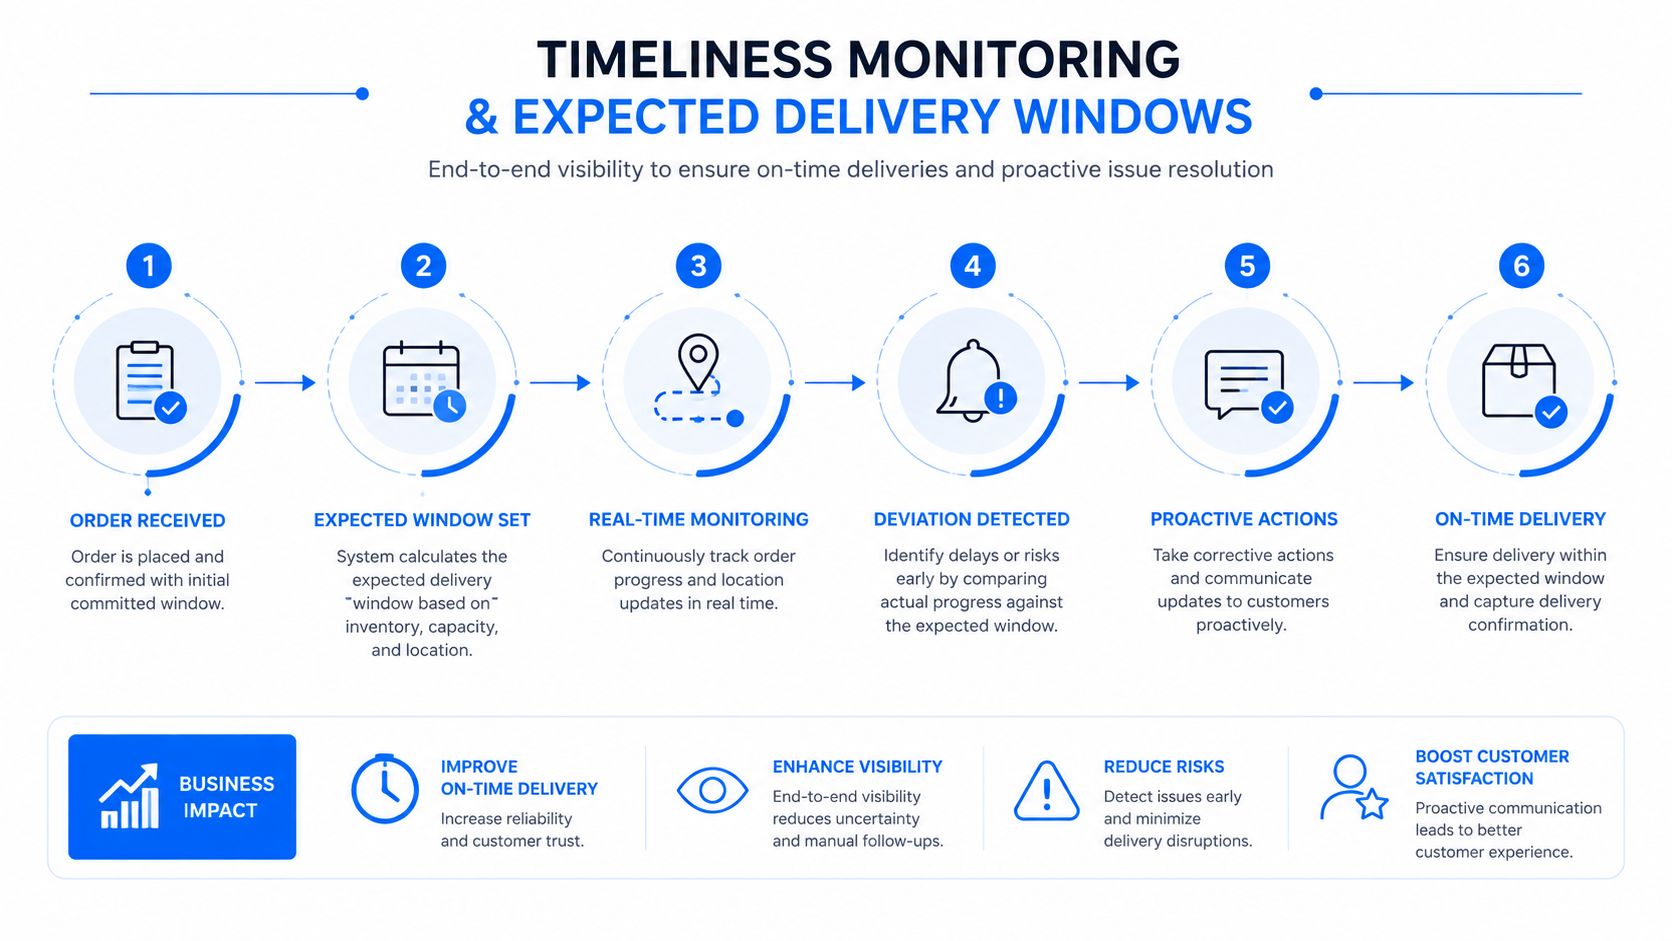
Surveillez plus que le simple horodatage final. Les vérifications de type
Questions fréquentes
Pourquoi un pipeline ETL au vert produit-il des données cassées ?
Parce que les outils d'orchestration rapportent surtout si une tâche a tourné, pas si la donnée s'est bien comportée. La règle pratique consiste à traiter toute exécution ETL réussie comme non vérifiée tant que la donnée n'a pas passé les contrôles de fraîcheur, de schéma et de niveau enregistrement.
Quelles dimensions tout pipeline ETL doit-il surveiller ?
Cinq, car un score unique masque la défaillance. La fraîcheur dit si le dernier enregistrement valide arrive, les autres couvrent volume, schéma, distribution et validité au niveau enregistrement. Chacune attrape une classe de défaillance différente, et c'est leur traitement séparé qui rend le signal utile.
Quelles défaillances ETL font le plus mal ?
Les silencieuses. Un pipeline qui plante se signale et se répare ; une exécution qui se termine tout en perdant une partition, en forçant un type ou en acceptant des enregistrements invalides voyage jusqu'au tableau de bord avant que quiconque ne pose une question.
Que coûte une mauvaise qualité des données en ETL ?
Gartner estime la mauvaise qualité des données à 12,9 millions USD en moyenne par organisation et par an, et des synthèses sectorielles relèvent que de mauvaises données peuvent entraîner 15 % à 25 % de perte de chiffre d'affaires dans certaines entreprises. Les contrôles précoces comptent car le coût croît à chaque saut en aval.
Plus de tests est-il la réponse ?
C'est la surveillance en couches, pas l'espoir ni une suite de tests plus longue. Les contrôles déterministes attrapent les violations de règles connues, les contrôles statistiques les comportements que les règles ne décrivent pas, et le suivi de schéma le changement structurel ; aucune couche ne couvre les deux autres.



