Maîtriser la qualité des données de l'IA pour la surveillance d'entreprise 2026
|
7
minute de lecture

Le lundi matin commence par une douleur familière. Un tableau de bord qui aurait dû être calme clignote en rouge, les chiffres semblent faux, et personne ne parvient à s'entendre sur le fait que le problème soit réel ou qu'il s'agisse simplement d'un autre flux obsolète. Le temps que quelqu'un remonte jusqu'à un fichier en retard, un lot en double ou un changement de schéma discret, le mal est déjà fait dans les notes de réunion, les résultats du modèle ou le rapport du conseil d'administration.
C'est l'état actuel de la qualité des données d'IA en 2026. Il ne s'agit plus d'un simple exercice consistant à corriger les valeurs nulles et à dédoublonner les lignes, car les pipelines modernes évoluent trop vite pour que des contrôles statiques puissent intercepter chaque changement significatif. En Europe en particulier, la conversation est passée de « les données sont-elles propres ? » à « pouvons-nous faire confiance aux données, le prouver et les gouverner tout au long de leur cycle de vie ? ». C'est pourquoi l'observabilité, l'auditabilité et le lignage se placent désormais aux côtés de la précision en tant que priorités de premier ordre, en particulier pour l'IA à haut risque et les environnements réglementés. Un bon point de départ est la vue pratique de l'observabilité sur l'aperçu de la data observability de digna.
Au-delà des données propres : le nouvel impératif
Une équipe financière peut s'accommoder d'un graphique erroné pendant une heure. Un moteur de tarification ne le peut pas. Lorsque le flux est légèrement retardé, ou lorsque la distribution entrante change juste assez pour rester dans les limites d'une règle fragile, l'entreprise en subit tout de même les conséquences. Les contrôles manuels permettent de détecter les anomalies évidentes, mais ils passent à côté des défaillances discrètes qui surviennent un groupe d'enregistrements à la fois.
C'est pourquoi la qualité des données d'IA a dépassé l'ancienne logique du « on nettoiera plus tard ». Les recherches axées sur l'UE traitent désormais les contrôles de qualité des données comme une partie intégrante d'une Data Governance plus large, en particulier lorsque l'IA à haut risque est impliquée et que les ensembles de données doivent être pertinents, représentatifs, exempts d'erreurs et complets (analyse de l'article 10 par le European Journal of Information Law). L'angle de la gouvernance est important car un mauvais ensemble de données n'est pas seulement une nuisance pour la modélisation, c'est la preuve qu'on ne peut pas encore faire confiance au pipeline.
Le passage du nettoyage au contrôle
L'ancien modèle était simple. Un ingénieur de données écrivait une règle, un tableau de bord déclenchait une alerte, et quelqu'un menait l'enquête une fois les dégâts propagés. Cela fonctionne lorsque le problème est littéral et répété. Cela s'effondre lorsque la défaillance est comportementale, comme un flux qui arrive à l'heure mais avec une distribution modifiée, ou un segment de clientèle qui disparaît sans déclencher de contrôle de valeur nulle.
C'est tout l'intérêt de la modern observability. Elle ne se demande pas seulement si la colonne existe. Elle demande si les données se comportent toujours comme les données attendues. Pour les équipes en Espagne ou dans toute l'UE, c'est plus qu'une commodité, cela s'aligne sur la vision axée sur les droits selon laquelle une IA fiable commence par des contrôles fiables. Une approche pratique et utile est celle utilisée par les plateformes conçues pour ce problème, telles que les dimensions de la qualité des données et comment les mesurer, car les dimensions comptent autant que l'outillage.
Règle pratique : Si un problème de données ne peut être découvert que par une personne ouvrant un tableur à la fin de la semaine, il est déjà trop tard pour l'IA opérationnelle.
La meilleure question est de savoir si le système peut détecter la dérive, le retard, la duplication et les problèmes de validité avant que les utilisateurs métier n'en voient les symptômes. C'est la norme essentielle aujourd'hui, et c'est une exigence de gouvernance autant que technique.
Ce que signifie réellement la qualité des données d’IA
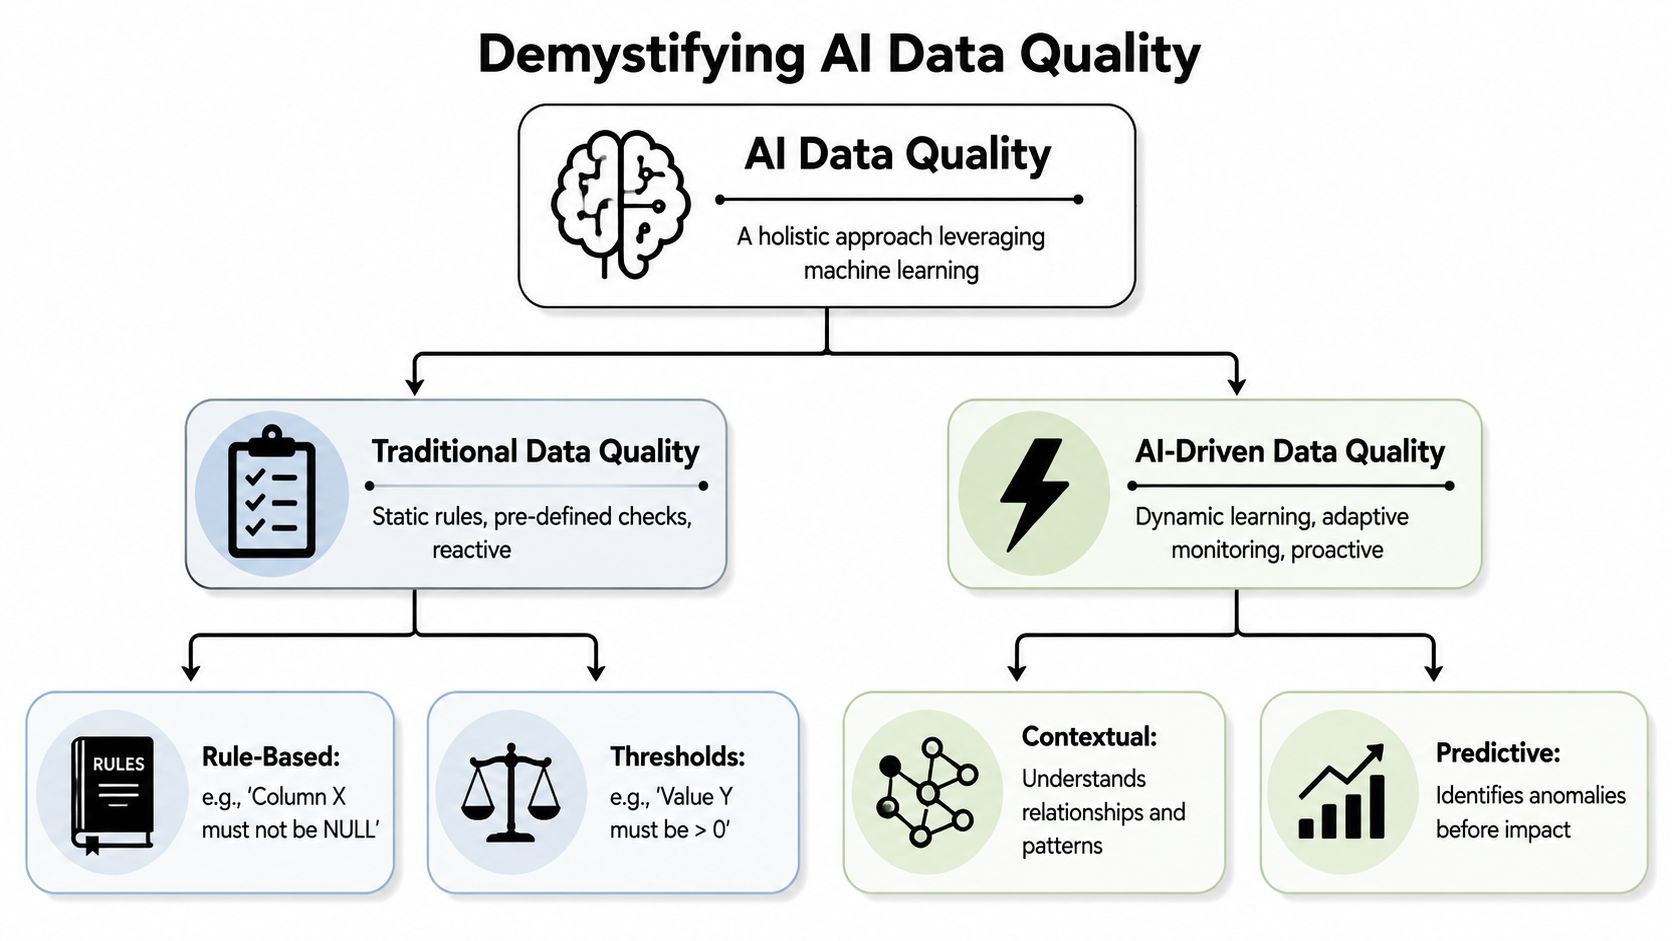
Les contrôles de données traditionnels sont comme une alarme de voiture qui n'a qu'une seule fonction : elle hurle lorsqu'une vitre s'ouvre. Utile, mais rudimentaire. Un système de sécurité domestique intelligent surveille les schémas de mouvement, les horaires d'ouverture des portes, les accès inhabituels et le contexte de ce qui est normal pour cette maison. La qualité des données d'IA fonctionne davantage comme le second modèle, car elle apprend le rythme cardiaque d'un pipeline au lieu d'attendre la rupture d'une seule règle.
La définition de la FRA est un bon point d'ancrage ici. Elle stipule que la qualité des données pour l'IA comprend la complétude, l'exactitude, la cohérence, la ponctualité, la duplication, la validité, la disponibilité et la provenance (rapport de la FRA). Cela est important car cela élargit la perspective. Un ensemble de données peut être exact dans un sens strict et rester inutile s'il arrive en retard, manque de provenance ou a suffisamment dérivé pour rendre les décisions en aval peu fiables.
Règles statiques par rapport au comportement appris
La surveillance basée sur des règles pose des questions telles que « La colonne X est-elle nulle ? » ou « La valeur Y est-elle supérieure à zéro ? ». Ces contrôles restent utiles, et personne de sérieux ne devrait s'en débarrasser. Mais ils ne détectent que les conditions que vous avez déjà pensé à encoder.
La surveillance optimisée par l'IA apprend les schémas normaux à travers le temps, le volume, la distribution, la saisonnalité et les relations entre les champs. Elle peut signaler un changement même lorsque les valeurs brutes respectent toujours un seuil fixe. C'est la différence clé, et c'est pourquoi les équipes modernes utilisent l'IA pour compléter, et non remplacer, les règles strictes.
Les dimensions qui comptent vraiment
Le cadre de la FRA aide également les équipes à éviter une erreur courante, qui consiste à traiter la « qualité des données » comme une note vague et unique. Ce n'est pas le cas. Les dimensions se divisent en différentes questions opérationnelles.
La Complétude demande si les données sont bien présentes.
La Ponctualité demande si elles sont arrivées au moment prévu.
La Cohérence demande si les enregistrements concordent toujours entre eux.
La Provenance demande d'où elles viennent et comment elles ont changé.
La Validité demande si les enregistrements sont toujours cohérents avec le profil attendu de l'activité.
Cette définition plus large s'aligne parfaitement avec l'observabilité opérationnelle. Un système qui surveille les tendances, les changements de schéma, les arrivées tardives et la validité au niveau des enregistrements effectue un véritable travail de qualité des données, et pas seulement de la maintenance de routine.
Comment l’IA améliore activement la surveillance des données
La pratique de la statistique publique européenne montre déjà comment cela fonctionne concrètement. L'IA est utilisée pour soutenir l'ingestion, la classification, l'édition, la détection d'anomalies et la suggestion d'imputations de données, tandis que la supervision humaine reste intégrée pour protéger la qualité (webinaire sur les statistiques officielles de l'UE). C'est également un modèle utile pour les équipes en entreprise, car il permet à la machine de se concentrer sur la détection des schémas et à l'expert de se pencher sur le jugement.
Le plus grand avantage de l'IA n'est pas qu'elle soit magique. C'est qu'elle déploie à grande échelle le type de vigilance que les humains ont du mal à maintenir manuellement. Une plateforme peut apprendre qu'un flux arrive généralement à la même heure en semaine, ou qu'une métrique augmente naturellement après un événement commercial spécifique, puis mettre en évidence l'exception sans que personne n'ait à rédiger une règle personnalisée pour chaque cas. Pour une vision plus axée sur le produit, le flux de travail décrit dans comment l'IA détecte les anomalies de données dans les pipelines correspond parfaitement à la façon dont les équipes gèrent les incidents.
Des références qui évoluent avec les données
Les seuils statiques sont fragiles car la normalité change avec le temps. Une entreprise saisonnière n'a pas de schéma fixe unique, et un entrepôt moderne non plus. L'apprentissage des références par l'IA s'adapte aux comportements récurrents, de sorte que l'alerte se déclenche sur un changement inattendu plutôt que sur le cycle prévu.
Cela fait une réelle différence dans la réponse aux incidents. Au lieu de débattre pour savoir si un pic est « mauvais », les équipes peuvent voir s'il s'écarte du schéma appris. Le signal s'améliore et le bruit diminue.
La ponctualité est un problème de qualité, pas un désagrément de calendrier
La gestion européenne des données traite la ponctualité comme un aspect formel de la qualité, et non comme une simple préoccupation opérationnelle secondaire. Le cadre EUROCAT DQI inclut la ponctualité de la transmission des données aux côtés de la complétude et de l'exactitude (liste EUROCAT DQI). C'est un rappel fort qu'une livraison tardive peut être tout aussi préjudiciable qu'une valeur erronée.
Un flux qui arrive avec deux heures de retard peut être plus dangereux qu'un flux comportant une erreur visible, car le tableau de bord semble toujours correct alors que l'entreprise prend des décisions basées sur des chiffres obsolètes.
Règles traditionnelles vs Surveillance alimentée par l'IA
Aspect | Approche traditionnelle basée sur des règles | Approche alimentée par l'IA |
|---|---|---|
Style de détection | Seuils fixes et contrôles manuels | Apprend le comportement et surveille les écarts |
Délai de réponse | Souvent réactif | Proactif et continu |
Couverture | Limitée aux modes de défaillance connus | Plus efficace pour trouver les anomalies inconnues |
Maintenance | Les règles nécessitent une maintenance constante | Les modèles s'adaptent à mesure que les pipelines évoluent |
Ponctualité | Généralement séparée des autres contrôles | Surveillée dans le cadre du comportement normal |
Pour les équipes qui gèrent des pipelines complexes, ce changement transforme la surveillance d'une simple alarme incendie en un système d'alerte précoce.
Les avantages réels et les risques cachés
Le meilleur argument en faveur de la qualité des données d'IA est simple. Elle réduit le temps que les équipes consacrent à rédiger et à maintenir des tests fragiles, et elle détecte des problèmes que personne n'avait pensé à encoder à l'avance. Cela est important lorsque les pipelines changent souvent et que les modes de défaillance continuent d'évoluer. Cela améliore également la confiance, car les analystes et les utilisateurs métier cessent de voir les contrôles de qualité comme un rituel administratif et commencent à les considérer comme faisant partie intégrante du produit.
Il existe également un avantage plus profond dans les secteurs réglementés. Des recherches menées par des praticiens et alignées sur les réglementations de l'UE ont révélé que les données manquantes constituaient le principal problème de qualité, tandis que les problèmes de confidentialité (37 %) représentaient une préoccupation majeure (recherche de praticiens alignée sur l'UE). C'est un rappel que le travail sur la qualité dans la finance, la santé et les télécoms doit se faire au sein d'environnements contrôlés, et non après que les données sensibles ont été envoyées ailleurs pour inspection.
Ce qui s'améliore rapidement
Les équipes constatent généralement d'abord trois victoires pratiques. La première est la réduction du tri manuel, car le système filtre le bruit évident avant qu'une personne n'intervienne. La deuxième est une alerte plus précoce sur les problèmes inconnus, ce qui importe plus qu'une classification parfaite de chaque incident. La troisième est une meilleure confiance dans les rapports en aval, ce qui rend les utilisateurs moins enclins à créer leurs propres contrôles parallèles.
Cette confiance est toutefois fragile. Si la couche de surveillance devient elle-même opaque, ou si chaque cas limite déclenche une alerte bruyante, l'adoption s'essouffle. La lassitude face aux alertes peut tuer un bon système plus rapidement qu'une mauvaise modélisation.
Le compromis sur la confidentialité que la plupart des articles ignorent
Un fournisseur qui copie des données sensibles en dehors d'un environnement contrôlé crée un nouveau problème tout en essayant de résoudre l'ancien. Pour les équipes réglementées, le modèle le plus sûr est généralement la surveillance en base de données ou sur site (on-premise), où l'analyse s'exécute à côté des données plutôt que de déplacer les données vers l'analyse. Cette architecture correspond aux secteurs qui exigent la confidentialité par défaut, et c'est l'une des raisons pour lesquelles le choix de la plateforme importe plus que les listes de fonctionnalités.
Cette même tension entre confidentialité et governance se retrouve également dans les tests médicaux. Un parallèle utile est la maîtrise de la précision des tests cliniques, car elle aide à comprendre pourquoi la sensibilité, la spécificité et le contexte sont cruciaux lorsque le coût d'un faux signal est élevé.
Pourquoi l'architecture fait partie de l'histoire de la qualité
digna s'exécute au sein de l'environnement client, soit sur site, soit dans un cloud privé, et sa documentation précise qu'il n'est jamais fourni en mode SaaS, sans aucun accès du fournisseur aux données du client (documentation de digna en espagnol). Ce choix de conception n'est pas un argument marketing. Il répond directement à l'obstacle pratique auquel sont confrontées de nombreuses équipes européennes : comment améliorer la qualité sans affaiblir le contrôle.
Cela est également important pour les preuves de gouvernance. Si le système qui contrôle la qualité fonctionne lui-même au sein de l'environnement protégé, le processus d'audit est plus clair et l'examen de sécurité est généralement moins fastidieux.
Adopter l’IA pour la qualité des données dans l’entreprise
Le déploiement en entreprise échoue généralement pour l'une de ces deux raisons : soit l'équipe achète un outil rutilant avant d'avoir défini le problème opérationnel, soit elle le greffe sur un flux de travail dont personne n'est responsable. La meilleure voie est plus étroite et moins spectaculaire. Choisissez un pipeline critique, un consommateur métier et un ensemble de questions de qualité qui causent déjà des difficultés.
À partir de là, les critères d'évaluation deviennent plus clairs. Une véritable plateforme doit s'intégrer à votre infrastructure actuelle, apprendre des schémas sans nécessiter la rédaction fastidieuse de règles manuelles, fournir suffisamment d'explications pour que les ingénieurs et les analystes fassent confiance aux résultats, et fonctionner selon le modèle de sécurité que votre organisation utilise déjà. Si elle ne peut pas faire cela, elle finira par devenir un logiciel inutilisé avec un simple tableau de bord.
Ce qu'il faut rechercher avant de déployer quoi que ce soit
Profondeur de l'intégration : Elle doit fonctionner avec votre entrepôt, votre lac de données et vos pipelines sans imposer d'infrastructure parallèle.
Transparence du modèle : Les équipes doivent comprendre pourquoi un élément a été signalé, et pas seulement savoir qu'il l'a été.
Adéquation avec la gouvernance : Elle doit produire des preuves qui facilitent la validation, les tests et l'examen.
Contrôle du déploiement : Pour les charges de travail sensibles, privilégiez une exécution sur cloud privé ou sur site.
Accessibilité pour différents profils : Les ingénieurs, les analystes et les responsables de la gouvernance ont tous besoin de vues différentes sur un même problème.
Ce dernier point est sous-estimé. Si un seul spécialiste peut utiliser l'outil, le processus ne peut pas passer à l'échelle.
La pression réglementaire modifie la décision d'achat
En vertu de la loi sur l'IA de l'UE (EU AI Act), les ensembles de données destinés aux systèmes d'IA à haut risque doivent être gouvernés tout au long de leur cycle de vie afin de rester pertinents, représentatifs, exempts d'erreurs et complets (analyse de la loi sur l'IA de l'UE). Cela signifie que la détection d'anomalies, les contrôles de biais et la gestion des données manquantes ne sont pas des options facultatives. Ils font partie intégrante du plan de contrôle.
Une plateforme avec exécution en base de données peut aider car elle maintient l'analyse à proximité des données et préserve la piste d'audit. C'est particulièrement utile lorsque les équipes de gouvernance ont besoin de montrer comment un ensemble de données a été surveillé, et pas seulement de prétendre qu'il a été « nettoyé ».
Une approche pratique consiste à commencer par un flux qui a déjà un impact sur le chiffre d'affaires, la Compliance ou l'expérience client. Prouvez que le système peut détecter des arrivées tardives, des modifications de schéma ou des variations de volatilité avant qu'elles ne soient visibles par l'entreprise, puis étendez la solution à partir de là. Cela l'emporte de loin sur un déploiement global et indifférencié.
Vos prochaines étapes vers une surveillance intelligente des données
Le changement d'orientation majeur est déjà clair. La qualité des données d'IA n'est pas une couche décorative superposée à d'anciennes règles, c'est le modèle opérationnel pour des données qui évoluent trop rapidement pour être surveillées manuellement. Les organisations qui réussissent dans ce domaine cessent de débattre pour savoir si chaque ligne est parfaite et se concentrent sur la question de savoir si le pipeline est fiable, explicable et prêt pour l'audit.
Si vous souhaitez faire avancer les choses dès la semaine prochaine, restez simple.
Choisissez un pipeline à forte valeur ajoutée et listez les problèmes de qualité qui nuisent aux prises de décision.
Testez la façon dont vos outils actuels gèrent les anomalies inconnues, et pas seulement les violations de règles connues.
Intégrez l'observabilité dans la discussion sur la gouvernance afin que la conformité, l'ingénierie et l'analyse s'appuient sur les mêmes preuves.
Pour un point de départ concret, examinez les outils de surveillance de la qualité des données de digna et comparez-les à vos types d'incidents actuels, à vos contraintes de déploiement et à vos besoins d'audit. Ensuite, intégrez cette sélection lors de votre prochain examen de plateforme de données en posant une question claire : cette configuration peut-elle préserver la confiance envers les données sans ralentir l'activité ?
Un appel à l'action pour digna.
Pour voir comment les références apprises, Timeliness et la surveillance des schémas se combinent dans l'environnement du client plutôt que dans le cloud d'un fournisseur, consultez digna pour l'observabilité des plateformes de données.
Questions fréquentes
Qu'est-ce que la qualité des données par l'IA ?
La qualité des données par l'IA est une surveillance qui apprend les schémas normaux d'un pipeline selon le temps, le volume, la distribution, la saisonnalité et les relations entre champs, puis signale les écarts même lorsque les valeurs respectent des seuils fixes. L'article la compare à un système de sécurité domestique intelligent, face aux contrôles classiques, semblables à une alarme de voiture à fonction unique.
Quelles dimensions définissent la qualité des données pour l'IA ?
Selon la définition de la FRA citée dans l'article, la qualité des données pour l'IA couvre l'exhaustivité, l'exactitude, la cohérence, la ponctualité, la duplication, la validité, la disponibilité et la provenance. Cela élargit la perspective : un jeu de données peut être exact au sens strict et pourtant inutilisable s'il arrive en retard, n'a pas de provenance ou a dérivé.
L'IA remplace-t-elle les contrôles de qualité fondés sur des règles ?
Non, l'IA complète les règles fixes au lieu de les remplacer. Des contrôles comme « La colonne X est-elle nulle ? » ou « La valeur Y est-elle supérieure à zéro ? » restent utiles, mais ne détectent que les conditions déjà codées. La surveillance apprise couvre en plus les anomalies inconnues, comme un flux ponctuel dont la distribution a changé.
Qu'exige l'AI Act de l'UE en matière de qualité des données d'entraînement ?
Selon l'AI Act de l'UE, les jeux de données des systèmes d'IA à haut risque doivent être gouvernés tout au long de leur cycle de vie pour rester pertinents, représentatifs, exempts d'erreurs et complets. L'article en conclut que la détection d'anomalies, les contrôles de biais et la gestion des données manquantes font partie du plan de contrôle, et non d'options facultatives.
Comment une entreprise doit-elle commencer à adopter la qualité des données par l'IA ?
Commencez petit : choisissez un pipeline critique, un consommateur métier et un ensemble de questions de qualité qui posent déjà problème. Prouvez que le système détecte les arrivées tardives, les changements de schéma ou les variations de volatilité avant le métier, puis étendez en vérifiant l'intégration, la transparence du modèle, l'adéquation à la gouvernance, le contrôle du déploiement et l'usage multi-profils.



