Qu'est-ce que la plausibilité des données ? Un guide pratique
|
7
minute de lecture
La plausibilité des données évalue si les données ont du sens dans le cadre de leurs conditions commerciales, logiques, statistiques ou contextuelles attendues. Des données valides suivent une règle définie. Des données plausibles se comportent d'une manière qui a du sens dans leur contexte.
Un enregistrement peut passer un contrôle de type, s'intégrer dans une plage autorisée, et tout de même sembler incorrect à toute personne qui comprend le métier. Un âge de patient accepté de 187, une transaction de €500,000 alors que les transactions typiques sont inférieures à €500, ou une augmentation soudaine de 400% des inscriptions quotidiennes de clients ne prouvent pas nécessairement une erreur, mais chacun mérite une investigation. Ce fossé entre la validation réussie et le bon sens est l'endroit où la qualité des données de plausibilité devient essentielle.
Table des matières
Qu'est-ce que la plausibilité des données et pourquoi est-elle importante
En quoi la plausibilité diffère de la validité, de l'exactitude et de la cohérence
Comment les organisations mesurent la plausibilité des données
Pourquoi la plausibilité est essentielle pour l'analytique et l'IA
Comment digna prend en charge la surveillance continue de la plausibilité
Foire aux questions sur la plausibilité des données
Quelle est la différence entre la plausibilité et la validité ?
Des données peuvent-elles être valides mais non plausibles ?
Des données non plausibles peuvent-elles tout de même être exactes ?
Comment la plausibilité peut-elle être surveillée en continu ?
Quel module digna prend en charge la plausibilité des données ?
Qu'est-ce que la plausibilité des données et pourquoi est-elle importante
Un système de facturation hospitalier peut accepter un âge de patient de 150 ans parce que le champ est numérique et que la plage configurée le permet. L'enregistrement est structurellement valide, mais un clinicien, un spécialiste de la facturation ou un gestionnaire de données se demanderait immédiatement si la valeur représente une faute de frappe, un décalage de colonne ou un enregistrement inhabituel mais authentique.
La plausibilité des données évalue si une valeur se comporte de manière plausible dans ses conditions attendues. Ces conditions peuvent être des règles métier, des relations logiques, des modèles statistiques, un comportement historique, des normes de groupe de pairs ou des connaissances du domaine. La question n'est pas : « Cette valeur peut-elle exister dans le champ ? » C'est : « Cette valeur a-t-elle du sens ici ? »
Règle pratique : Un indicateur de plausibilité est une demande d'investigation, et non une preuve automatique que l'enregistrement est erroné.
Cette distinction repose sur des bases de longue date dans les statistiques officielles. Statistique Canada décrit la qualité à travers six dimensions : la pertinence, l'exactitude, la rapidité, l'accessibilité, la convivialité et la cohérence, et associe la qualité à « l'adéquation à l'usage » plutôt qu'à la seule exactitude. Les lignes directrices sur la qualité de Statistique Canada montrent pourquoi un ensemble de données peut être présent et techniquement correct tout en n'atteignant pas son objectif prévu s'il arrive en retard, perd en comparabilité ou enfreint les relations attendues.
Pourquoi les règles déterministes ne suffisent pas
Une règle déterministe peut tester si un champ contient un nombre, si une date utilise le bon format ou si un montant reste inférieur à un plafond configuré. Elle ne peut pas comprendre automatiquement chaque contexte commercial légitime.
La plausibilité ajoute cette couche contextuelle grâce à :
Des références historiques, qui révèlent si les valeurs d'aujourd'hui ressemblent au comportement antérieur.
Des comparaisons avec les pairs, qui comparent une agence, un produit, un client ou une région avec des groupes similaires.
Des relations inter-champs, telles que la vérification que la livraison suit l'expédition.
Le profilage statistique, qui met en évidence les changements de distribution et les concentrations inhabituelles.
Une revue de domaine, qui aide à distinguer les événements rares des données corrompues.
Le développement historique du contrôle statistique de la qualité soutient également cette approche. Un examen de la qualité des données et des erreurs d'enquête par les Académies nationales retrace les pratiques de qualité modernes à travers le contrôle des mesures, le contrôle du processus de collecte, l'échantillonnage et l'analyse des erreurs. La plausibilité est le prolongement en entreprise de cette discipline, appliquée aux entrepôts, lacs, pipelines, tableaux de bord et modèles.
La conséquence pratique est claire. La plausibilité offre un garde-fou tardif mais important avant que des données suspectes n'influencent l'analytique, les rapports financiers, les décisions opérationnelles ou les systèmes automatisés. Les équipes qui cherchent à associer ces vérifications à une surveillance plus large des pipelines peuvent les intégrer dans une approche de Data Observability.
En quoi la plausibilité diffère de la validité, de l'exactitude et de la cohérence
La plausibilité est liée à d'autres dimensions de la qualité des données, mais elle ne les remplace pas. La validité vérifie les règles explicites, l'exactitude vérifie la correspondance avec la réalité, et la cohérence vérifie l'accord entre les représentations. La plausibilité demande si le résultat est plausible dans son contexte.
Un poids d'expédition de 9 999 kg pour un ordinateur portable peut correspondre à un champ numérique et à un maximum technique généreux. L'horodatage d'une transaction de vente au détail réelle à 3h00 du matin peut refléter fidèlement ce que le système source a enregistré, même si le magasin ferme à 21h00. Si chaque employé enregistre exactement 8,00 heures chaque jour pendant un an, les enregistrements peuvent parfaitement concorder entre les systèmes tout en suggérant un modèle de processus ou de saisie qui mérite d'être examiné.
Une comparaison utile se présente comme suit :
Dimension | Ce qu'elle vérifie | Exemple de règle | Réussite ? | Verdict de plausibilité |
|---|---|---|---|---|
Validité | Si une valeur suit une règle explicite | Le montant est numérique et inférieur au maximum autorisé | Oui | Peut tout de même être peu plausible |
Exactitude | Si une valeur reflète la réalité | L'adresse enregistrée correspond à l'adresse vérifiée du client | Oui | Des données exactes peuvent tout de même être inhabituelles |
Cohérence | Si les représentations concordent | Le statut du client correspond entre deux systèmes | Oui | L'accord ne prouve pas le sens contextuel |
Plausibilité | Si le comportement correspond au contexte attendu | L'achat s'aligne avec le client, le produit, l'heure et l'historique | Nécessite du contexte | Signale les valeurs pour investigation |
Plausibilité par rapport à la validité
La validité demande : « La valeur satisfait-elle à une règle définie ? » Un montant de transaction de 900 000 € peut être valide si le maximum technique est plus élevé, mais il peut être non plausible lorsque les transactions normales sont inférieures à 5 000 €.
C'est pourquoi un guide de qualité des données est utile pour établir un vocabulaire plus large, tandis que les équipes ont toujours besoin d'une évaluation contextuelle distincte. Vous pouvez également distinguer la plausibilité de la digna Data Validation et de la manière de la mesurer lors de la conception des contrôles.
Plausibilité par rapport à l'exactitude
L'exactitude demande si la valeur reflète la réalité. La plausibilité demande si la valeur semble plausible compte tenu du contexte disponible. Une valeur inhabituelle peut être tout à fait exacte, comme un véritable achat de grande valeur, une admission d'urgence ou un employé effectuant un quart de travail exceptionnel.
Rejeter chaque anomalie éliminerait des événements rares valides. Une meilleure conception consiste à signaler l'observation, conserver la valeur d'origine, enregistrer le motif de préoccupation et l'envoyer vers un flux de travail approprié.
Plausibilité par rapport à la cohérence
La cohérence se concentre sur l'accord entre les représentations de données ou les systèmes. La plausibilité se concentre sur le comportement attendu. Une valeur peut être cohérente dans chaque table en aval tout en restant non plausible parce que la valeur d'origine viole un modèle métier qu'aucune comparaison de système à système ne teste.
Exemples concrets de données non plausibles
Les données non plausibles apparaissent dans tous les domaines car les systèmes connaissent généralement mieux la structure autorisée que le contexte métier environnant. Un système financier peut accepter un montant correctement formaté sans comprendre la catégorie de commerçant, tandis qu'un système de santé peut stocker un dosage sans évaluer s'il correspond au profil du patient.
Dans la finance, une transaction par carte de crédit de 0,01 $ chez un concessionnaire de voitures de luxe peut passer les contrôles de format, de devise et de valeur minimale. Il peut s'agir d'un frais de test, d'un acompte, d'un artefact de règlement ou d'une transaction suspecte. Le signalement devrait inciter à une révision, et non prouver une fraude.
Dans le secteur de la santé, un dosage pédiatrique attribué à un patient enregistré comme ayant 72 ans crée un conflit contextuel grave. L'âge, le dosage et le médicament peuvent être chacun des champs valides, mais leur relation nécessite une enquête clinique ou de qualité des données immédiate.
Dans la chaîne d'approvisionnement, un entrepôt signalant une démarque inconnue nulle pendant douze mois consécutifs est possible, mais ce modèle ininterrompu est suffisamment inhabituel pour être examiné. Dans les RH, une date de début d'un employé survenant trois ans avant sa date de naissance enregistrée indique une anomalie inter-champs qu'un simple contrôle de format de date ne détectera pas.
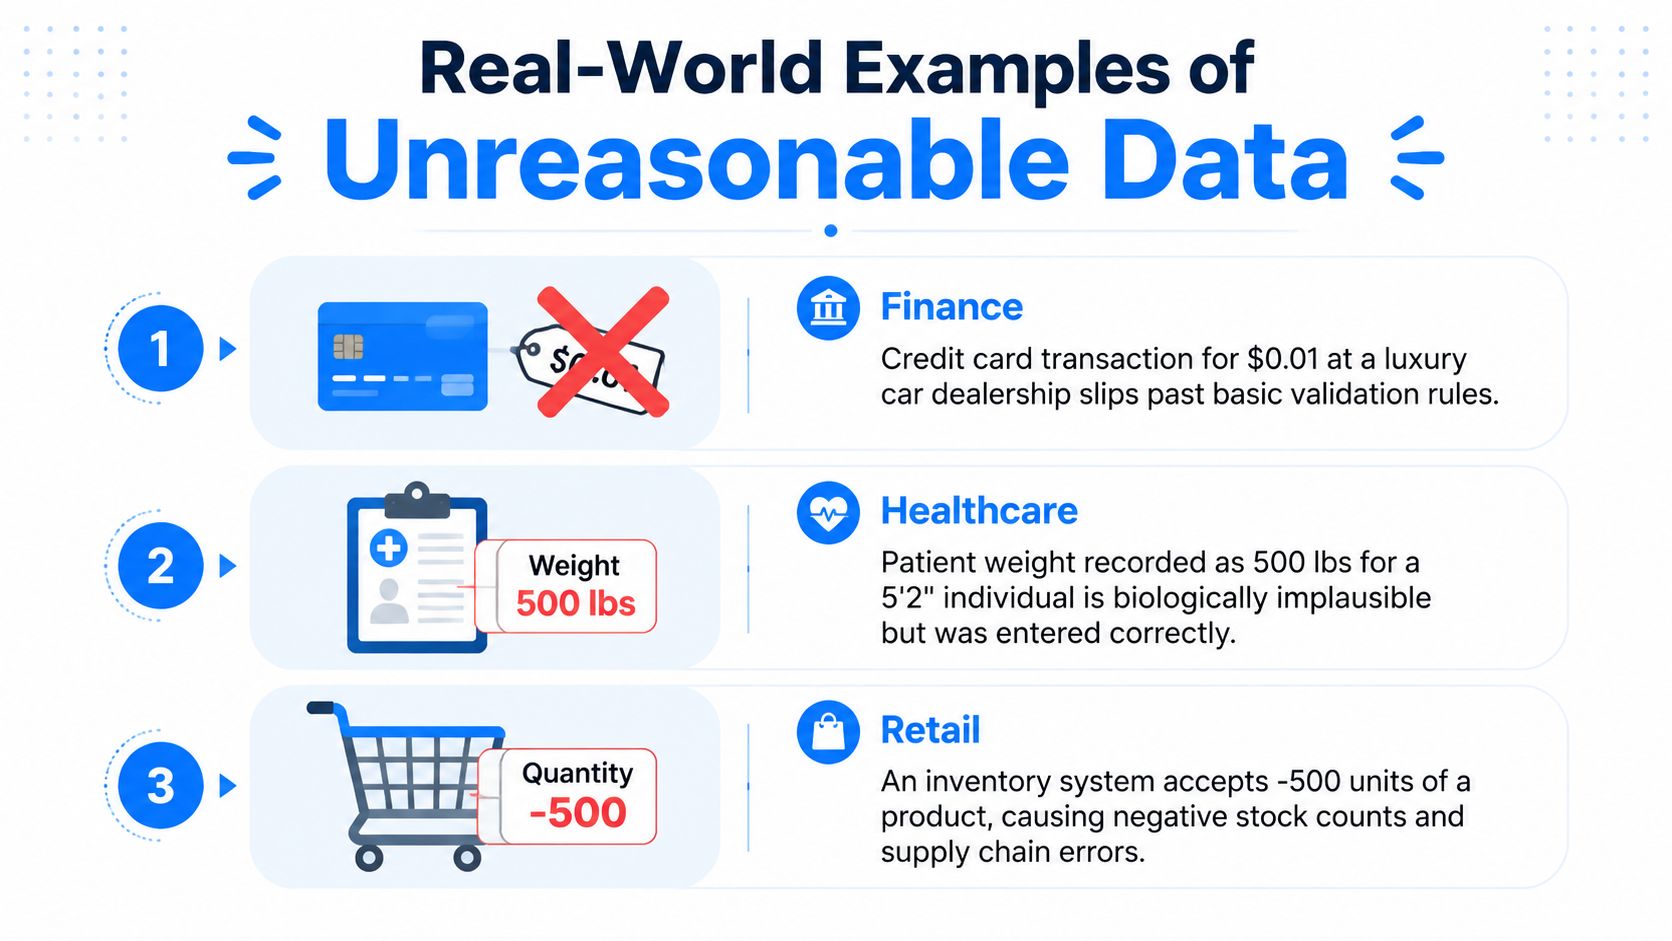
Les exemples fournis illustrent également un principe de fonctionnement important : un enregistrement inhabituel n'est pas automatiquement incorrect. Un poids de patient qui semble biologiquement invraisemblable pourrait refléter un problème de conversion d'unités, une mesure réelle ou une saisie rattachée au mauvais patient. Une quantité de stock négative pourrait représenter un ajustement plutôt qu'une transaction échouée.
La plausibilité facilite l'investigation des anomalies de données en séparant la détection de la décision. Le système identifie le comportement qui mérite attention, tandis qu'un humain ou un flux de travail de domaine détermine s'il convient de le corriger, de l'approuver, de le mettre en quarantaine ou de le documenter.
Comment les organisations mesurent la plausibilité des données
Les organisations mesurent la plausibilité en combinant des connaissances métier explicites avec le comportement des données observées. Il n'existe pas de métrique de plausibilité universelle unique. La bonne méthode dépend du domaine, de la population, de la décision et du coût d'une anomalie manquée.
Commencer par des attentes connues
Les règles métiers et les seuils sont le point de départ le plus clair. Une équipe peut signaler un âge de 187 ans, un prix de produit en dehors des limites de sa catégorie ou un montant de transaction supérieur à un plafond approuvé. Les ratios ajoutent du contexte, comme les réclamations par police, les retours par commande ou le chiffre d'affaires par client actif.
Ces contrôles fonctionnent bien lorsque la condition attendue est connue. Ils deviennent moins efficaces lorsque le comportement change selon la saison, le segment de clientèle, l'emplacement ou le type de produit.
Ajouter des références et des comparaisons avec les pairs
Les références historiques comparent le comportement actuel avec les observations antérieures. Les équipes peuvent examiner les changements de volume, de moyenne, de médiane, de percentile, de distribution ou la proportion de valeurs en dehors d'une plage attendue. Une augmentation soudaine des inscriptions, une nouvelle concentration de commandes inhabituellement importantes ou un changement dans l'activité des clients peuvent indiquer un défaut de pipeline ou un événement commercial réel.
Les comparaisons avec les pairs réduisent les fausses alertes. Une transaction importante peut être ordinaire pour un client entreprise et inhabituelle pour un client particulier. Un changement de ventes régional doit être interprété par rapport à des régions comparables, et non par rapport à un seuil universel unique.
Utiliser des analyses statistiques et intersystèmes
L'analyse de distribution peut révéler des changements que les règles de saisie individuelles manquent. Les équipes peuvent surveiller les anomalies, comparer les distributions au fil du temps et étudier les changements d'étalement ou de tendance centrale. La détection des anomalies prolonge ce processus en apprenant les modèles attendus et en mettant en évidence les écarts.
Les contrôles inter-champs ajoutent un contexte logique. Les dates d'expédition doivent suivre les dates de commande, le dosage du patient doit s'aligner sur ses attributs et le prix d'un produit doit être logique pour sa catégorie. Les contrôles intersystèmes peuvent comparer les enregistrements opérationnels avec des données de référence fiables ou des systèmes internes connexes.
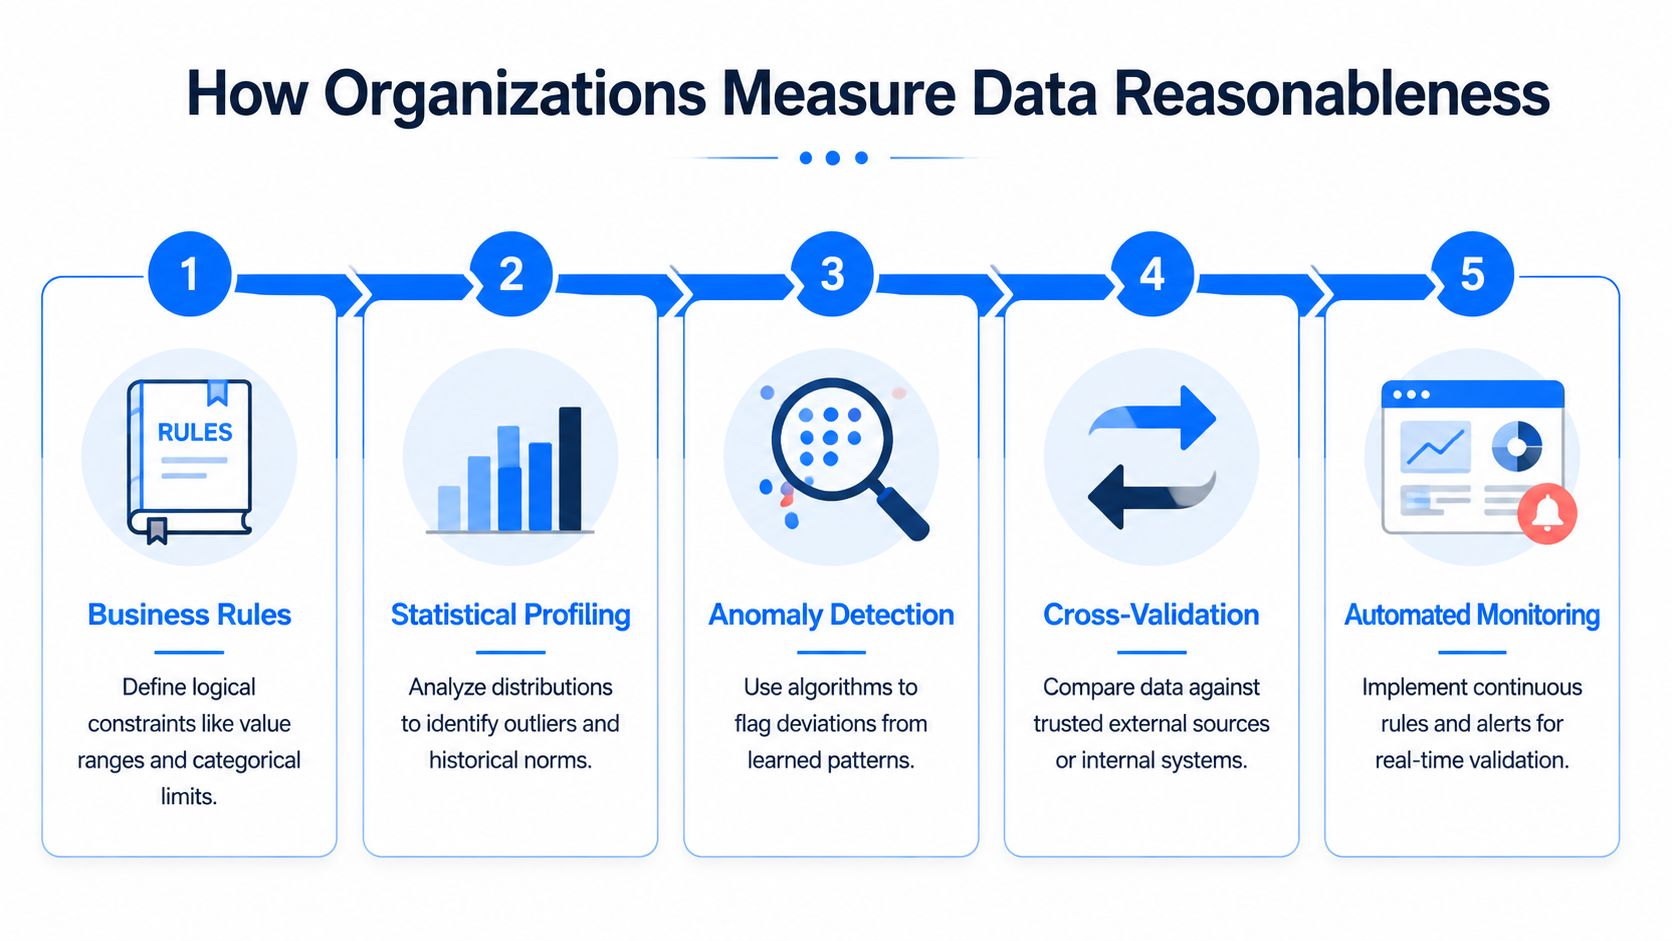
Un programme de mesure pratique peut suivre le pourcentage de valeurs en dehors des plages attendues, le pourcentage d'enregistrements signalés pour investigation, l'écart par rapport à une référence historique, les changements de distribution et les variations de volume. Ces mesures décrivent des signaux, pas des verdicts. Un cadre de qualité des données pour les CDO peut aider à connecter ces signaux avec la responsabilité, la governance et le risque de décision, tandis que les métriques de qualité des données fournissent un cadre pour formaliser le modèle de surveillance.
La version révisée de DAMA-DMBOK® 2.0 Revised Edition traite la plausibilité comme une dimension standard de la qualité des données. DAMA explique que son cadre révisé contient 9 dimensions, ajoute la récurrence, et utilise la plausibilité (Reasonableness) à la place du terme précédent (Reasonability). Ce positionnement renforce la nécessité de surveiller la plausibilité indépendamment de l'exactitude, de la validité et de la cohérence.
Pourquoi la plausibilité est essentielle pour l'analytique et l'IA
Des données non plausibles peuvent fausser les analyses sans déclencher un échec de validation conventionnel. Une transaction importante peut gonfler les tableaux de bord de revenus, un pic d'inscription dupliqué peut modifier un KPI de croissance, et une unité incorrecte peut déplacer les moyennes opérationnelles. Les dirigeants peuvent alors prendre des décisions basées sur un rapport techniquement complet mais contextuellement trompeur.
Les systèmes d'IA et de machine learning sont confrontés au même problème à grande échelle. Un enregistrement peut sembler statistiquement ordinaire de manière isolée tout en contredisant la situation commerciale qu'il représente. Une commande d'épicerie de grande valeur étiquetée comme un comportement d'achat de routine peut influencer la segmentation, les prévisions, la détection des fraudes ou la logique de recommandation sans produire d'erreur de schéma ou de type évidente.
La plausibilité est la couche qui se demande si les données restent défendables pour la décision qu'elles vont influencer.
Les équipes chargées des risques et des fraudes s'appuient sur des signaux contextuels car les comportements suspects se cachent souvent derrière des valeurs autorisées. Un sinistre peut être inférieur à une limite formelle tout en différant nettement de l'historique de l'assuré. Un emplacement peut utiliser un format de coordonnées valide tout en impliquant un modèle de déplacement invraisemblable. Une identité synthétique peut contenir des champs complets et cohérents tout en combinant des relations qui ne correspondent pas au comportement normal des clients.
Les organisations doivent également expliquer pourquoi des décisions automatisées se sont basées sur des données particulières. Un ensemble de données utilisé pour un modèle, un rapport réglementaire ou une évaluation des risques a besoin de plus qu'une simple validité structurelle. Les équipes doivent être en mesure de montrer ce qu'elles ont surveillé, quels modèles ont déclenché l'examen, qui a évalué l'exception et si la valeur a été conservée en tant qu'anomalie légitime ou corrigée en tant que défaut. La perspective de qualité des données de l'IA est donc pratique, et pas seulement technique.
Les recherches sur la préparation à l'IA mettent en évidence l'ampleur du défi. Une enquête mondiale a révélé que seulement 12% des personnes interrogées considéraient leurs données comme suffisamment de haute qualité et accessibles pour l'IA, tandis que 64% identifiaient la qualité des données comme leur principal défi en matière d'intégrité des données et 77% qualifiaient la qualité de moyenne ou pire, comme le rapportent les perspectives de planification 2025 de Precisely. La plausibilité contribue à l'aptitude à l'IA, mais elle ne peut pas résoudre à elle seule le problème des données inaccessibles, mal gouvernées ou définies de manière incohérente.
Comment digna prend en charge la surveillance continue de la plausibilité
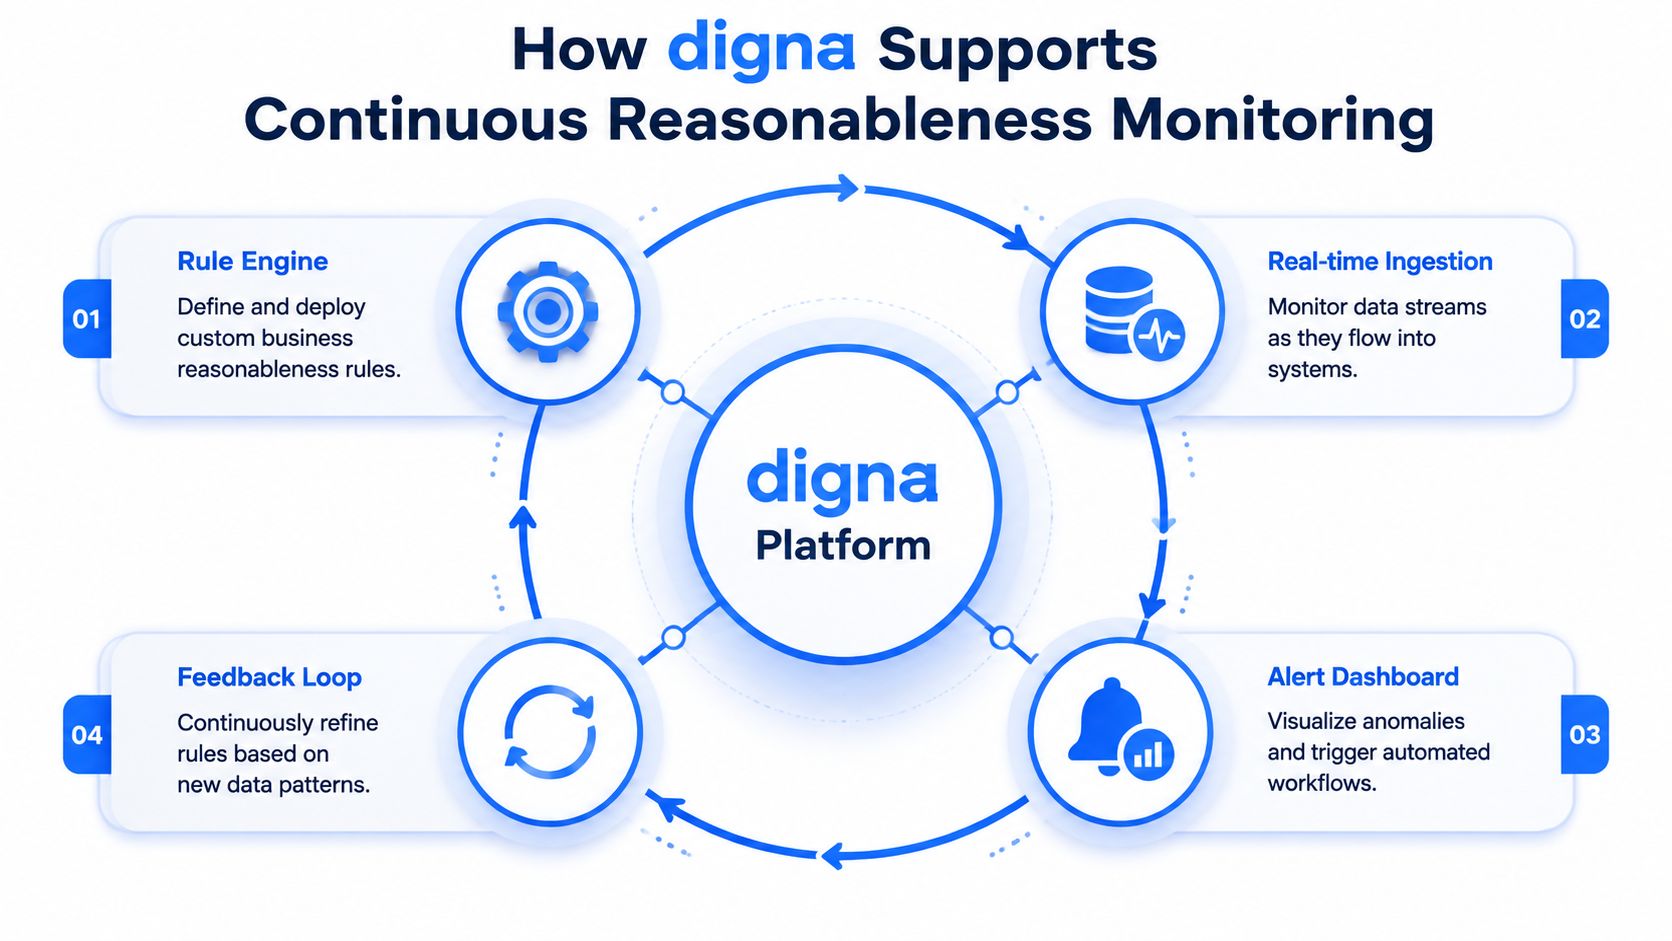
La surveillance continue traite la plausibilité comme un signal opérationnel plutôt que comme un audit périodique. digna Data Anomalies est la principale fonctionnalité permettant d'identifier les changements inattendus dans les distributions, les pics ou chutes soudains, les valeurs inhabituelles, les changements de comportement historique et les écarts par rapport aux modèles établis.
Prenons l'exemple d'un flux de travail de transaction financière. L'entreprise définit un montant de transaction valide comme étant compris entre 0 € et 1 million d'euros. Une transaction de 800 000 € respecte cette règle, mais les transactions historiques de ce même client se situent normalement entre 50 € et 500 €.
Les modules répondent à des objectifs différents :
La digna Data Validation confirme que le montant respecte la règle technique et commerciale explicite.
Le module digna Data Anomalies signale le montant car il diffère du comportement établi du client.
La digna Data Analytics fournit les tendances historiques et le contexte pour l'enquêteur.
Un utilisateur ou un flux de travail détermine si la transaction est légitime, nécessite une escalade ou reflète un problème de données.
La validation vérifie ce que vous avez explicitement défini. La détection des anomalies peut identifier des comportements que vous n'aviez pas explicitement anticipés.
digna Data Analytics prend en charge l'analyse historique, l'examen des références, l'analyse des tendances, l'évaluation de la volatilité et l'investigation. La digna Data Validation gère les conditions de plausibilité explicites, y compris les plages, les domaines, les relations inter-champs et les contraintes métier connues. Ensemble, ces capacités prennent en charge à la fois les contrôles déterministes et comportementaux sans traiter chaque valeur inhabituelle comme une erreur.
La plateforme effectue le calcul et l'analyse des métriques directement au sein des bases de données du client, ce qui permet aux organisations de conserver leurs données en place. Le déploiement peut utiliser un cloud privé ou une installation sur site au sein du cloud, du VPC ou du centre de données du client. Cette architecture est essentielle lorsque des dossiers financiers, de santé, du secteur public ou d'autres dossiers sensibles doivent rester au sein d'une infrastructure contrôlée.
Un flux de travail continu doit également tirer les leçons des décisions prises. Lorsque les enquêteurs confirment qu'un modèle inhabituel est légitime, les équipes peuvent affiner les seuils, les groupes de pairs ou la logique d'examen. Lorsqu'ils confirment un défaut, l'organisation peut remonter le problème en amont et ajouter une règle ciblée. Ce retour d'expérience évite que la surveillance de la plausibilité ne se transforme en un flux d'alertes bruyant.
Foire aux questions sur la plausibilité des données
Qu'est-ce que la plausibilité des données ?
La plausibilité des données évalue si les données ont du sens dans le cadre de leurs conditions commerciales, logiques, statistiques ou contextuelles attendues.
Qu'est-ce que la plausibilité dans la qualité des données ?
Il s'agit d'une dimension distincte de la qualité des données qui évalue la plausibilité et le comportement attendu, et pas seulement le format ou l'exactitude.
Quel est un exemple de donnée non plausible ?
Un montant qui respecte une plage technique mais qui est radicalement différent du modèle de transaction habituel d'un client en est un exemple.
Comment mesure-t-on la plausibilité ?
Utilisez des règles métier, des seuils, des ratios, des plages attendues, des références historiques, des comparaisons avec les pairs, des analyses de distribution, des analyses de tendances et la détection d'anomalies.
Quelle est la différence entre la plausibilité et la validité ?
La validité vérifie une règle explicite. La plausibilité vérifie si la valeur a du sens dans son contexte.
Des données peuvent-elles être valides mais non plausibles ?
Oui. Une valeur peut satisfaire ses règles de format et de plage tout en contredisant le comportement commercial normal.
Des données non plausibles peuvent-elles tout de même être exactes ?
Oui. Une valeur rare ou inhabituelle peut représenter fidèlement la réalité, elle doit donc souvent faire l'objet d'une enquête plutôt que d'être rejetée automatiquement.
Comment la plausibilité peut-elle être surveillée en continu ?
Combinez la validation déterministe avec la détection automatisée des anomalies, la surveillance des références, les alertes et les flux de travail de révision humaine.
Quel module digna prend en charge la plausibilité des données ?
Le module digna Data Anomalies est la fonctionnalité principale, appuyée par Data Analytics pour le contexte et Data Validation pour les règles explicites.
digna fournit une détection modulaire des anomalies, des analyses historiques et une validation au niveau des enregistrements pour surveiller si les données de l'entreprise se comportent comme prévu. Visitez digna pour découvrir comment la surveillance continue de la plausibilité peut soutenir des analyses et une IA plus fiables.
Questions fréquentes
Qu'est-ce que la vraisemblance des données ?
Elle évalue si la donnée a du sens dans ses conditions métier, logiques, statistiques ou contextuelles attendues. Un enregistrement peut passer un contrôle de type, tenir dans une plage autorisée et paraître pourtant faux à quiconque connaît le métier.
À quoi ressemble une valeur invraisemblable ?
Plausible jusqu'à ce qu'on la lise. Un âge de patient accepté de 187, une transaction de 500 000 € quand les transactions habituelles sont sous 500 €, ou une hausse soudaine de 400 % des inscriptions quotidiennes franchissent chacun leurs contraintes de champ tout en méritant une investigation.
Un signalement de vraisemblance prouve-t-il une erreur ?
Non. Un signalement de vraisemblance est une demande d'investigation, pas une preuve automatique d'erreur. Le prendre pour une preuve engendre exactement la fatigue de faux positifs qui pousse les équipes à cesser de lire le canal.
Pourquoi les règles déterministes ne suffisent-elles pas ?
Parce qu'elles testent la forme, pas la plausibilité. Une règle peut confirmer qu'un champ contient un nombre, qu'une date utilise le bon format ou qu'un montant reste sous un plafond configuré ; un système de facturation hospitalier acceptera volontiers un âge de patient de 150 sur ces trois points.
Qu'apporte la couche contextuelle ?
Les lignes de base historiques, qui révèlent si les valeurs du jour ressemblent au comportement antérieur, et les comparaisons entre pairs, qui confrontent une agence, un produit, un client ou une région à des groupes similaires. Toutes deux répondent à des questions qu'un enregistrement seul ne peut trancher sur lui-même.


