Qu'est-ce qu'un format de table ouvert
|
9
minute de lecture

C'est mardi matin. Un job Spark a saisi un fichier Parquet pendant qu'un autre processus l'écrivait encore. Un modèle dbt en aval lit un lot incomplet, le joint à nouveau lors d'une reprise et double une partie du total de chiffre d'affaires. L'équipe ne trouve pas le problème dans les journaux du pipeline. C'est la finance qui le trouve, dans un rapport.
Voilà le genre de défaillance qui fait qu'un data lake brut ressemble moins à une base de données qu'à un dossier partagé au débit excellent. Les fichiers ont beau être durables, peu coûteux et ouverts, le lake a toujours besoin d'un moyen fiable de définir quels fichiers appartiennent à une table, quelle version les lecteurs doivent voir et comment les écrivains publient les changements en toute sécurité. C'est le rôle d'un format de table ouvert.
Table des matières
Comment les formats de table ouverts s'intègrent aux plateformes de données modernes
Limites et compromis que la plupart des articles passent sous silence
Le problème que résout un format de table ouvert
Un data lake brut stocke généralement des fichiers dans le stockage objet, souvent aux formats Parquet, ORC ou Avro. Le système de stockage sait que les fichiers existent, mais il ne sait pas automatiquement qu'un ensemble particulier de fichiers représente une table logique, qu'un nouveau lot est complet, ou qu'un lecteur doit voir soit l'ancien état, soit le nouveau, jamais un mélange des deux.
Les conventions de répertoires tentent de combler ce manque. Les équipes créent des dossiers par date, région, locataire ou exécution d'ingestion, puis demandent aux moteurs de traitement de déduire la structure de la table à partir des chemins et du contenu des fichiers. Cette approche fonctionne jusqu'à ce que plusieurs écrivains, reprises, mises à jour, suppressions, changements de schéma et lecteurs concurrents surviennent en même temps.
Règle pratique : un dossier de fichiers, c'est du stockage. Une table a besoin d'un contrat d'identité, d'état et de changement.
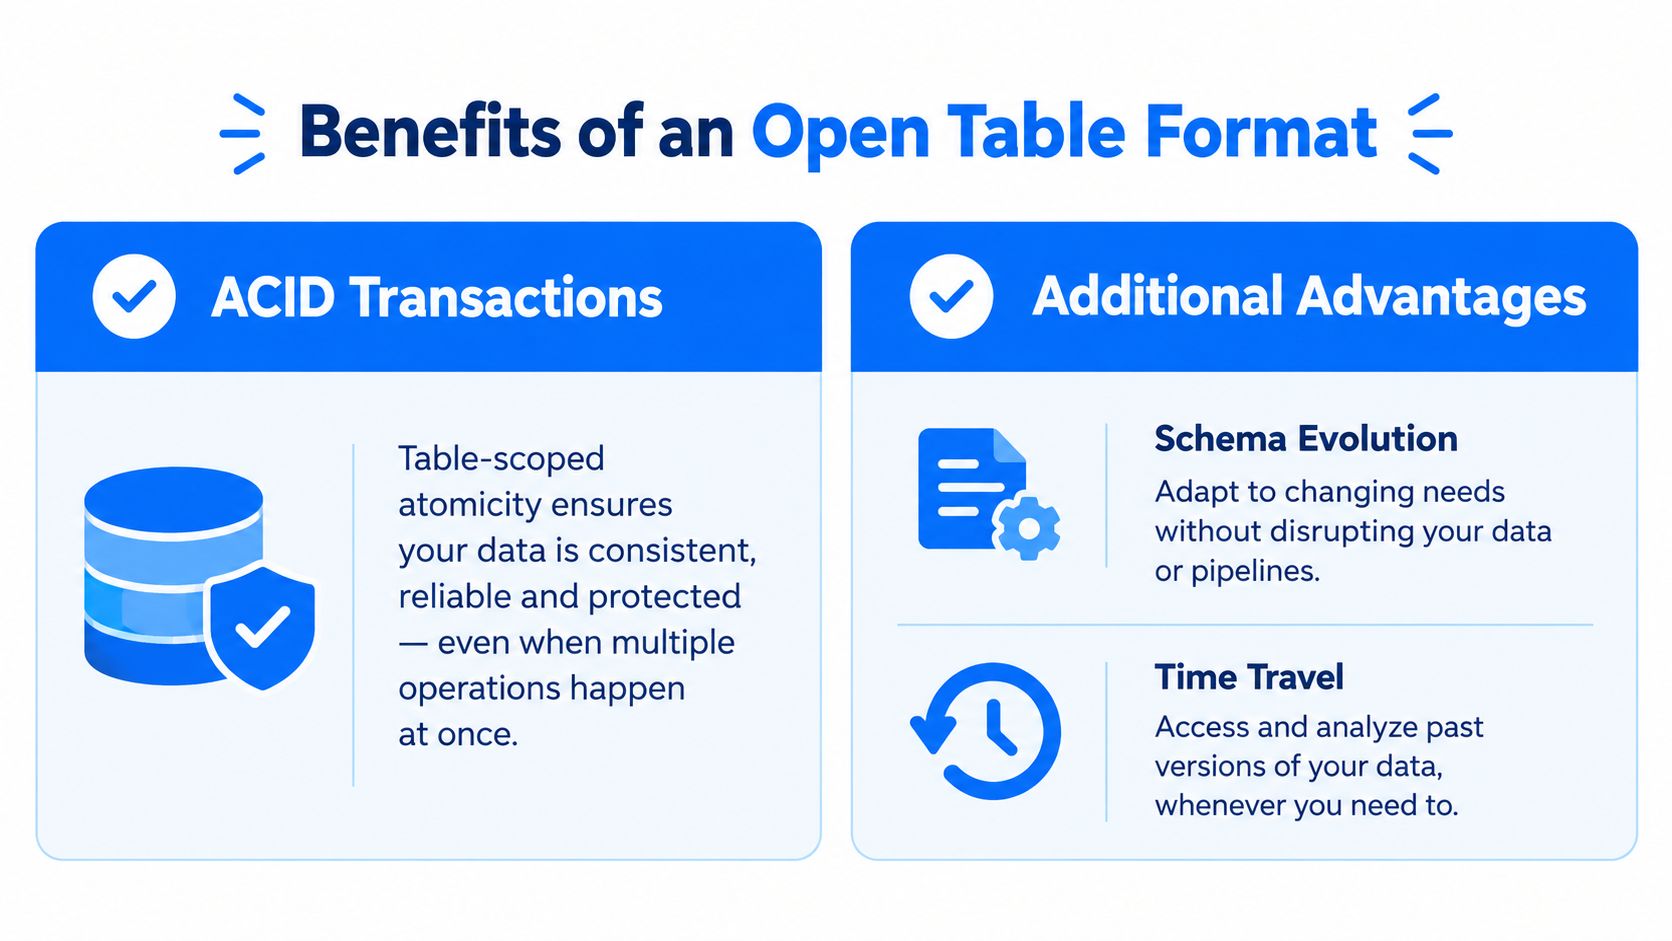
Un format de table ouvert est une couche de spécification et de métadonnées placée au-dessus des fichiers de données bruts et sous les moteurs de requête ou de traitement. Elle décrit ces fichiers comme une table versionnée et transactionnelle, incluant le schéma, les règles de partitionnement, les fichiers actifs et les snapshots validés. Les données restent dans un stockage ouvert, tandis que les métadonnées de table fournissent la coordination qui manque aux répertoires bruts. La présentation des formats de table ouverts par Databricks décrit cette couche comme le mécanisme qui ajoute aux fichiers du stockage objet des capacités telles que les transactions ACID, l'évolution de schéma, le voyage dans le temps et les mises à jour ou suppressions au niveau des lignes.
Le format sépare aussi la table logique des hypothèses de stockage propres à un moteur. Des clients compatibles peuvent laisser Spark, Trino, Flink, Snowflake, BigQuery et DuckDB travailler sur la même table sous-jacente, même si la prise en charge exacte des fonctionnalités dépend du moteur, du connecteur, du catalogue et de la version du format. Cette neutralité vis-à-vis des moteurs est l'essentiel. Une équipe plateforme peut utiliser Spark pour la transformation, Trino pour le SQL interactif, Flink pour le streaming et un autre moteur pour la BI sans créer une copie physique distincte pour chaque charge de travail.
C'est pourquoi un format de table ouvert a sa place dans une architecture de plateforme de données plus large. Il ne remplace pas la plateforme. Il fournit un état de table fiable que le reste de la plateforme peut découvrir, interroger, surveiller et gouverner.
Historiquement, les formats de table ouverts sont nés des limites de la gestion de tables à la Hive, fondée sur les répertoires. Apache Hudi a démarré chez Uber en 2016, Apache Iceberg est né chez Netflix vers 2017, et Delta Lake a été introduit par Databricks en 2017 puis ouvert en 2019. Ces jalons ont marqué le passage à une gestion des métadonnées au niveau des fichiers, à un comportement ACID, à l'évolution de schéma et à des mises à jour plus sûres sur le stockage objet en nuage. Une histoire des formats de table ouverts place ces projets au cœur de l'évolution du lakehouse.
Comment fonctionne un format de table ouvert sous le capot
Un format de table ouvert devient plus clair quand on décompose la table en couches. Imaginez un congélateur rempli de glaçons.
Les fichiers de données sont les glaçons. Ils contiennent les enregistrements réels, généralement dans un format en colonnes comme Parquet. Une table peut contenir de nombreux fichiers, répartis à travers le stockage objet.
Le partitionnement est le bac. Il regroupe les fichiers selon un agencement qui peut aider la planification des requêtes, comme une date ou une autre transformation d'une colonne. La distinction importante est qu'un format de table moderne peut gérer cet agencement en tant que métadonnées de table, au lieu d'obliger chaque utilisateur à comprendre l'arborescence physique.
Les fichiers de manifeste sont des listes d'inventaire. Chaque manifeste indique quels fichiers de données appartiennent à une partie donnée de la table et inclut des informations aidant un moteur à décider quels fichiers il peut ignorer. Une requête sur une plage de dates étroite n'a pas besoin d'examiner chaque glaçon du congélateur si l'inventaire désigne le bon bac.
La couche de métadonnées est le classeur. Elle suit le schéma de la table, la spécification de partition, le snapshot courant et les références aux listes de manifestes. Un snapshot est une vue cohérente de tout le classeur, et non un simple horodatage accolé à un dossier quelconque.
Le modèle d'Apache Iceberg illustre cette approche en couches. Il organise les tables au moyen de snapshots immuables et de fichiers de manifeste. Chaque commit crée une nouvelle vue datée tout en conservant les versions antérieures pour le voyage dans le temps et le rollback, le JSON de métadonnées, les listes de manifestes et les fichiers de manifeste formant la hiérarchie habituellement décrite. Cette fiche mémo des métadonnées Apache Iceberg détaille ces composants.
Publier un nouvel état de table
Un écrivain n'écrase normalement pas sur place le snapshot publié. Il prépare de nouveaux fichiers ou des fichiers de remplacement, crée des métadonnées et manifestes à jour, puis valide un nouvel état de table via le catalogue ou le protocole de table. L'étape finale de publication modifie de façon atomique la référence de métadonnées courante de la table.
Les lecteurs qui démarrent avant le commit continuent d'utiliser le snapshot antérieur. Ceux qui démarrent après utilisent le nouveau. Cette séparation empêche une requête de voir la moitié d'un lot parce que des fichiers sont apparus dans le stockage objet à des instants différents.
Un catalogue coordonne l'identité et la découverte des tables. Il peut s'appuyer sur une interface REST, un service à la Hive ou une autre implémentation. Le catalogue répond à des questions telles que l'emplacement des métadonnées de la table et la version de métadonnées courante. C'est le point de contrôle qui empêche chaque moteur d'inventer sa propre interprétation de la table.
Les listes de manifestes soutiennent l'élagage au moment de la planification, tandis que les métadonnées stockent le schéma et la spécification de partition. Le partitionnement masqué va plus loin en permettant d'interroger des colonnes logiques sans écrire de filtres sur des noms de dossiers physiques. Autrement dit, une table peut faire évoluer sa stratégie de partitionnement sans forcer chaque analyste à réécrire du SQL autour des chemins de stockage.
Choisir un mode d'écriture
Copy-on-write et merge-on-read représentent des compromis différents.
Avec copy-on-write, une mise à jour réécrit les fichiers de données concernés. Les lectures restent plus simples car le dernier état de la table est déjà matérialisé dans des fichiers en colonnes, mais des mises à jour fréquentes peuvent générer plus de travail d'écriture.
Avec merge-on-read, les changements récents peuvent être stockés séparément puis fusionnés avec les fichiers de base lors des lectures ou d'un compactage ultérieur. Les écritures restent plus réactives pour les charges à fortes mises à jour ou en streaming, mais les lecteurs et les processus de maintenance portent davantage de responsabilité.
Si vous vous familiarisez encore avec les fichiers sous-jacents, cette explication de Parquet fournit le contexte de plus bas niveau. Parquet stocke des enregistrements. Le format de table ouvert explique comment ces enregistrements participent à une table gouvernée et versionnée.
Ce qu'un format de table ouvert vous apporte réellement
Les bénéfices s'évaluent plus facilement sous forme de matrice. Chaque capacité résout un mode de défaillance précis, mais aucune ne garantit que le sens métier des données est correct.
Capacité | Ce qu'elle permet | Où elle s'arrête |
|---|---|---|
Transactions ACID | Les lecteurs voient un état de table validé, tandis que les écrivains publient les changements de façon atomique à l'échelle de la table. | Elles ne rendent pas atomique une transaction couvrant plusieurs tables. |
Voyage dans le temps | Les équipes peuvent interroger ou restaurer un snapshot antérieur quand l'état courant paraît douteux. | La rétention, le nettoyage et la prise en charge du catalogue déterminent combien de temps ces snapshots restent disponibles. |
Évolution de schéma | Les équipes peuvent ajouter, renommer, réordonner ou supprimer des colonnes selon les règles de compatibilité du format et du moteur. | Elle ne décide pas si un changement métier est sans danger pour les modèles en aval. |
Performance guidée par les métadonnées | Les moteurs peuvent élaguer des partitions et ignorer des fichiers grâce aux métadonnées, statistiques et informations d'agencement. | Un mauvais partitionnement, de petits fichiers et un ordre de tri inadapté peuvent encore produire des requêtes coûteuses. |
Les transactions ACID sont la fondation. Sans elles, les équipes s'en remettent souvent à un schéma « renommer et prier ». Un job écrit dans un répertoire temporaire et espère qu'un renommage final empêchera les lecteurs de voir un résultat incomplet. Cette approche devient fragile dès que reprises, écrivains multiples, comportement du stockage objet et moteurs de requête indépendants interagissent.
Le voyage dans le temps change la réponse aux incidents. Si un pipeline introduit de mauvaises valeurs, une analyste peut comparer la table courante à un snapshot antérieur, rejouer une requête sur l'état précédent ou restaurer une version réputée saine, à condition que les métadonnées et fichiers concernés n'aient pas été supprimés par les procédures de rétention. L'historique de la table devient un artefact d'exploitation plutôt qu'une suite invisible de mutations de fichiers.
L'évolution de schéma traite un autre problème. Les systèmes sources changent. Un producteur ajoute un champ, renomme une colonne ou change l'ordre des champs. Un format de table peut consigner les changements structurels compatibles sans exiger la réécriture immédiate de chaque fichier historique. Cela réduit les frictions de migration, mais l'équipe a toujours besoin d'un contrat sur la façon dont les consommateurs en aval interprètent le changement.
Les gains de performance viennent du déplacement du travail du temps de scan vers le temps de planification. Le moteur peut utiliser les métadonnées de partition, les statistiques de colonnes au niveau des fichiers et l'ordre de tri pour éviter de lire des fichiers non pertinents. Le résultat dépend de la façon dont la table est écrite et entretenue. Les métadonnées peuvent réduire la recherche, mais elles ne peuvent pas sauver un agencement qui crée un brassage excessif de fichiers ou une mauvaise localité des données.
La frontière compte :
Une table peut être transactionnellement correcte et sémantiquement fausse.
Un commit atomique peut préserver un lot complet contenant un chiffre d'affaires erroné, des clients en double ou un code de statut invalide. Les formats de table ouverts apportent la cohérence structurelle et l'état historique. La validation des données, le lignage, la propriété et la surveillance métier demandent encore une conception à part.
Iceberg, Delta Lake et Hudi comparés
Apache Iceberg, Delta Lake et Apache Hudi sont les trois choix dominants de format de table ouvert. Ils partagent l'objectif général d'apporter un comportement de table fiable au stockage objet, mais leurs modèles de métadonnées et leurs priorités de charge diffèrent.
Fonctionnalité | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modèle de métadonnées | Des snapshots immuables référencent des listes de manifestes et des fichiers de manifeste, qui énumèrent les fichiers de données de la table. | Un journal de transactions séquentiel dans | Une chronologie et un système de métadonnées soutiennent les commits, l'indexation au niveau des enregistrements et le traitement incrémental. |
Modes d'écriture | Utilise couramment le remplacement de fichiers pour les mises à jour, avec des fonctions de version de table définies par les capacités du format. | Utilise couramment un remplacement de fichiers coordonné par le journal de transactions et des schémas de concurrence optimiste. | Prend en charge Copy On Write et Merge On Read. |
Garanties transactionnelles | Le comportement ACID s'organise autour des snapshots de table validés. | Les commits atomiques, l'isolation par snapshot et l'historique reproductible proviennent du journal de transactions. | Les commits transactionnels soutiennent les upserts et les suppressions, avec un comportement dicté par le mode d'écriture retenu. |
Stratégie de partitionnement | Le partitionnement masqué et l'évolution des partitions aident à séparer les requêtes logiques de l'agencement physique. | Les agencements de tables partitionnées sont coordonnés par le protocole de transactions Delta et les intégrations de moteur. | Le partitionnement fonctionne avec l'indexation au niveau des enregistrements et des services de table conçus pour des données mutables. |
Charges les mieux adaptées | Analytique multi-moteurs, tables par lots et environnements où la portabilité des métadonnées compte. | Charges étroitement intégrées à l'outillage natif Delta et aux opérations de lakehouse centrées sur Spark. | Traitement incrémental, CDC, upserts, suppressions et pipelines orientés streaming. |
La force d'Iceberg réside dans son architecture de snapshots et de manifestes. Un moteur peut planifier à partir des métadonnées sans lister chaque fichier du stockage objet, et le partitionnement masqué permet aux administrateurs de table de modifier l'organisation physique sans exposer chaque détail d'agencement aux utilisateurs SQL.
Delta Lake utilise un journal de transactions stocké dans le répertoire _delta_log/. Les opérations apparaissent comme des fichiers JSON ou Parquet numérotés séquentiellement, et ce journal soutient les commits atomiques, l'isolation par snapshot et un historique de table reproductible. Cette comparaison de Delta Lake, Iceberg et Hudi explique le rôle du journal dans la conception de Delta.
Hudi est bâti autour de l'indexation au niveau des enregistrements et prend en charge Copy On Write et Merge On Read, une combinaison adaptée aux pipelines traitant des upserts et suppressions fréquents. Les recommandations d'AWS sur les formats de table ouverts décrivent ces modes d'écriture et l'orientation de Hudi vers le traitement incrémental et le CDC en streaming.
Pour une charge ETL par lots, les trois peuvent convenir. Pour la BI, la question pratique est de savoir quels moteurs de requête peuvent lire la table avec les fonctionnalités dont vos requêtes ont besoin, y compris l'élagage, les lectures par snapshot et le comportement de schéma. Pour le CDC en streaming, l'amplification d'écriture, l'indexation, la sémantique de fusion et le compactage peuvent compter davantage qu'une simple liste de fonctionnalités.
La prise en charge par l'écosystème évolue sans cesse entre Spark, Trino, Flink, Snowflake, BigQuery et d'autres moteurs. Cela rend les tests de compatibilité plus utiles que l'hypothèse selon laquelle un logo sur une page de support garantirait un comportement identique partout. Les équipes devraient valider les écritures, les commits concurrents, les changements de schéma, les suppressions, le voyage dans le temps et la reprise après incident avec leurs moteurs et catalogues réels. Une approche de la qualité des données sur Databricks doit aussi être évaluée en parallèle du choix de format, car le protocole d'écriture d'une table ne remplace pas les contrôles sur les données qu'elle contient.
Le vrai choix n'est pas « quel format l'emporte ? ». C'est quelle sémantique d'écriture, quel modèle de catalogue, quel processus de maintenance et quelles intégrations de moteur correspondent au pipeline que vous exploitez.
Comment les formats de table ouverts s'intègrent aux plateformes de données modernes
Un lakehouse comporte généralement quatre couches fonctionnelles. Le stockage objet contient les fichiers. Le format de table ouvert gère les métadonnées et l'état validé. Les moteurs de traitement et de requête lisent ou écrivent via des clients compatibles. Les systèmes de gouvernance et d'observabilité examinent ce qui s'est passé et si les données obtenues sont exploitables.
Un flux typique commence quand des enregistrements arrivent dans S3 ou ADLS. Un écrivain crée ou met à jour une table, publie les métadonnées et enregistre la table dans un catalogue. Spark peut transformer les données, Flink traiter un flux, Trino servir des requêtes interactives, et Snowflake, BigQuery ou Athena offrir des voies de consommation supplémentaires lorsque leurs intégrations prennent en charge le protocole et les fonctionnalités de la table.
Cette séparation rend un même jeu de données logique disponible pour plusieurs charges. L'analytique peut interroger la table, un pipeline d'apprentissage automatique peut en dériver des variables, et un consommateur en streaming peut traiter les changements récents sans obliger chaque équipe à maintenir une copie distincte. La contrepartie est que chaque client doit s'accorder sur la sémantique de la table, l'accès au catalogue, les fonctionnalités prises en charge et le comportement d'autorisation.
C'est pourquoi il vaut mieux comprendre le format comme une partie du plan de contrôle du lakehouse, et non comme un simple choix de format de fichier. Le plan de contrôle expose des signaux qui comptent un jour d'incident ordinaire :
Motifs de commit : repérez les écrivains bloqués, une fréquence de commit inhabituelle ou des échecs répétés.
Fraîcheur des métadonnées : identifiez les tables dont l'état de catalogue ou les mises à jour de métadonnées accusent du retard sur la livraison attendue.
Dérive des partitions : trouvez les changements d'organisation physique qui modifient le comportement des requêtes.
Événements de schéma : suivez les colonnes ajoutées, supprimées ou modifiées avant que les consommateurs en aval ne cassent.
Comportement des snapshots : reliez les incidents de qualité des données à l'état de table exact que les lecteurs ont consommé.
Une plateforme telle que digna peut se placer aux côtés de cette couche en surveillant la fraîcheur des métadonnées, les événements de changement de schéma, la ponctualité, les résultats de validation, les anomalies et les signaux de plateforme au sein de l'environnement du client. Cette approche utilise l'historique de la table comme source de signaux opérationnels tout en gardant la responsabilité de la qualité des données distincte du protocole de table.
La distinction est utile. Le format vous dit quel état de table a été validé. L'observabilité vous dit si cet état est arrivé à temps, suit les motifs attendus, satisfait les règles métier et reste sûr pour un usage en aval. Davantage de contexte sur cette relation figure dans comment maintenir la qualité des données dans un lakehouse.
Limites et compromis que la plupart des articles passent sous silence
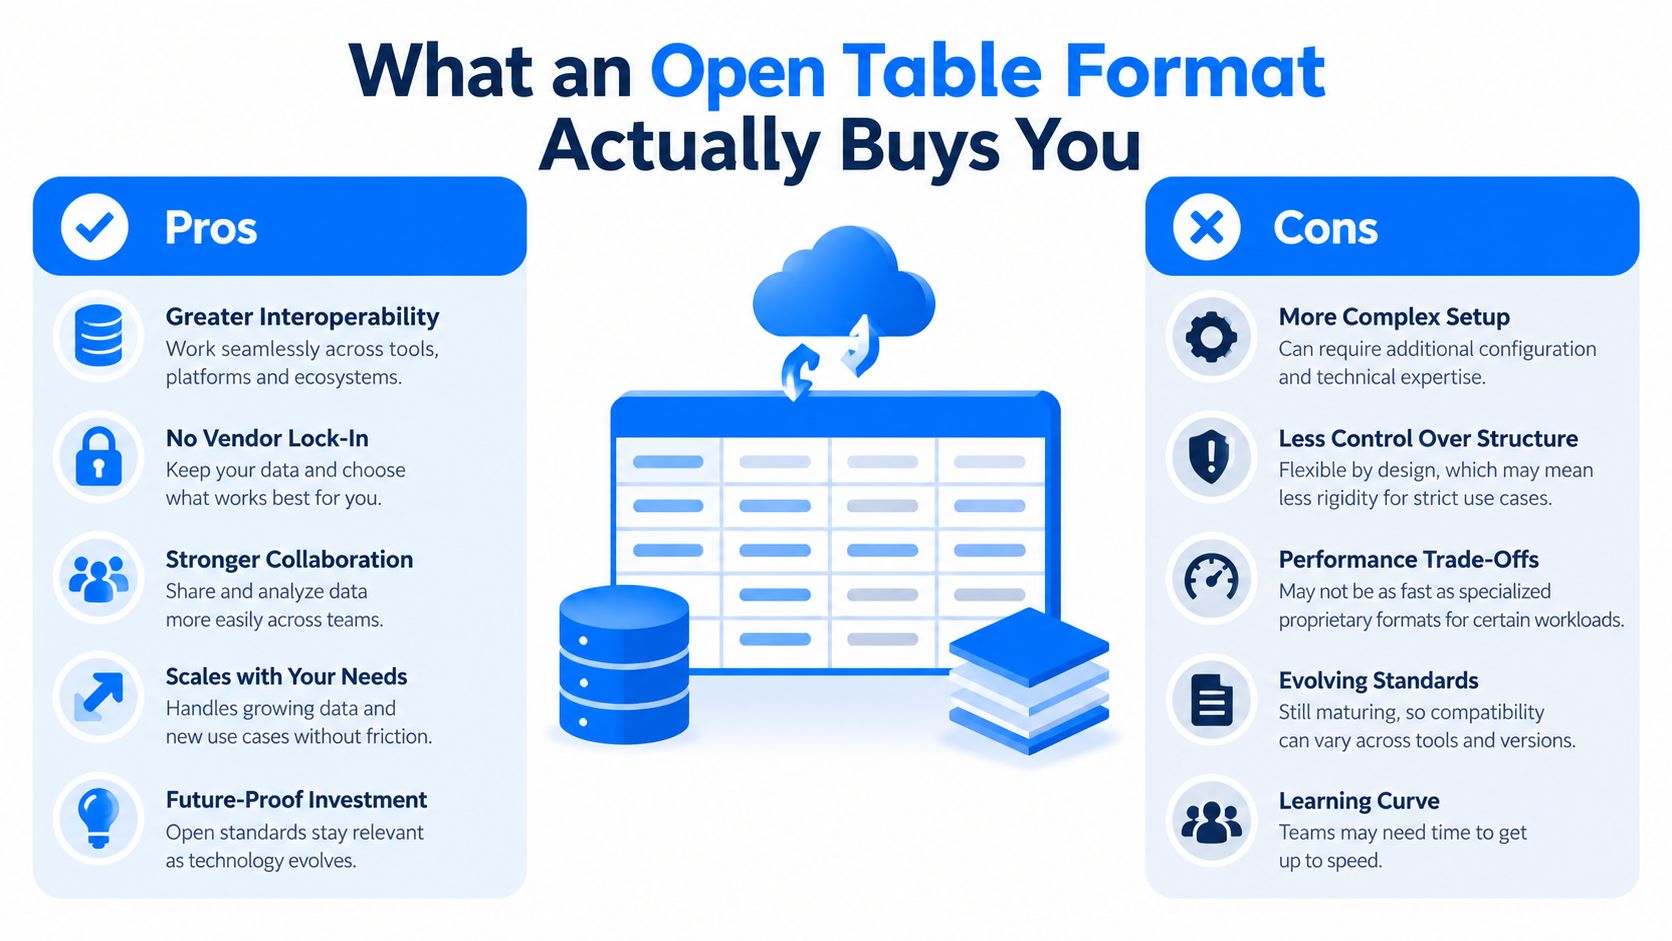
Un format de table ouvert comble le manque d'atomicité pour une table. Il ne transforme pas un lake sur stockage objet en base de données relationnelle pleinement coordonnée.
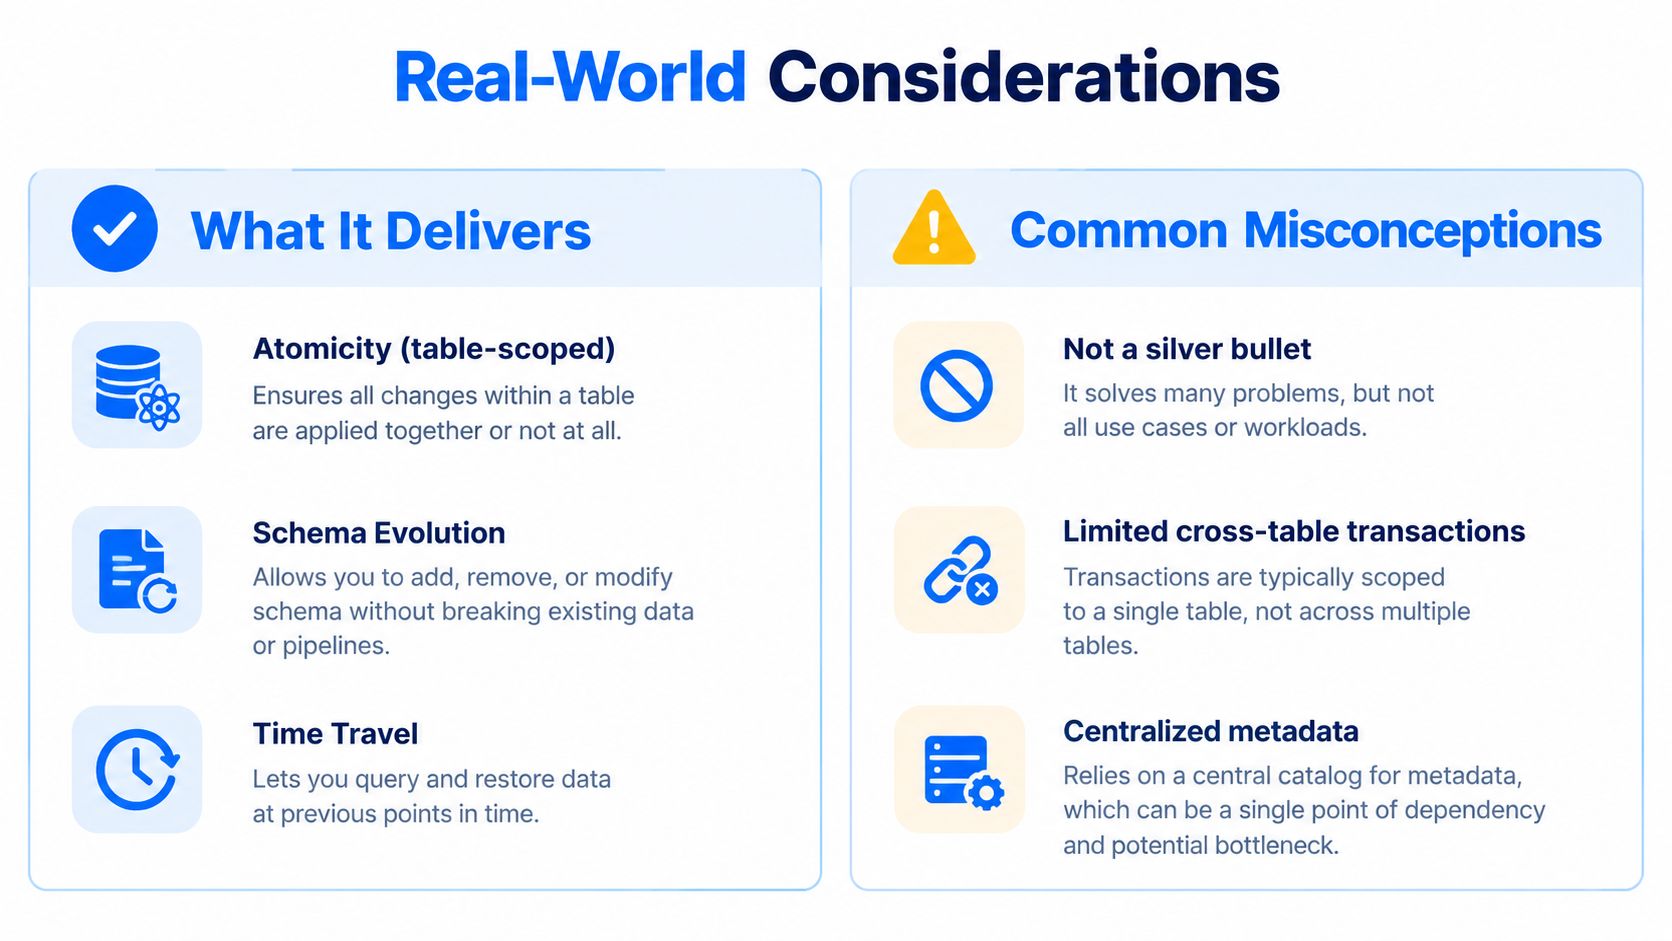
La première limite est la portée transactionnelle. Dans le modèle général, les garanties ACID restent limitées à la table. Si un pipeline met à jour une table de ventes et une table de stocks, chaque table peut valider sans risque tandis que l'opération métier globale devient malgré tout incohérente entre les deux. Une transaction multi-tables exige un coordinateur ou une fonctionnalité de plateforme conçue pour cela.
La seconde limite est la qualité sémantique. Une table peut contenir tous les fichiers attendus, un schéma valide et un snapshot propre tout en portant des valeurs incorrectes. Un format de table ouvert ne saura pas qu'un remboursement dépasse sa commande, qu'un identifiant client enfreint une règle métier ou que le chiffre d'affaires reflète soudain la mauvaise devise.
Le travail d'exploitation ne disparaît pas
L'entretien des tables réclame toujours une attention d'ingénierie.
Compactage : les agencements merge-on-read et les charges à fortes mises à jour peuvent exiger un compactage afin que les lecteurs ne réconcilient pas sans cesse de nombreux fichiers de changements.
Dimensionnement des fichiers : un excès de petits fichiers augmente le coût de planification et de scan, même lorsque les métadonnées permettent l'élagage.
Réglage des partitions : un schéma de partitions adapté aux accès d'hier peut mal se comporter après une évolution de la charge ou de la distribution des données.
Rétention : le voyage dans le temps dépend de la conservation des métadonnées et fichiers requis par les snapshots anciens. Les politiques de nettoyage doivent équilibrer besoins de reprise et gestion du stockage.
Concurrence : plusieurs écrivains peuvent entrer en conflit. Le pipeline doit gérer les reprises, les commits échoués et l'idempotence plutôt que de supposer que chaque écriture réussira.
La gouvernance vit elle aussi au-delà du format de table proprement dit. Des catalogues tels que Unity Catalog, Glue, Polaris et Nessie peuvent gérer la découverte, les permissions, les intégrations de lignage et la coordination, mais chacun introduit des responsabilités de configuration, de disponibilité, de compatibilité et de mise à niveau. Les différences entre éditeurs autour des spécifications de catalogue, des interfaces REST et du partitionnement masqué peuvent compliquer la portabilité même quand deux systèmes revendiquent la prise en charge du même format sous-jacent.
Frontière opérationnelle : le format protège l'état de la table. Votre plateforme reste responsable de la qualité, du lignage, de la politique d'accès, de la réponse aux incidents et de la conception des charges.
Ces contraintes ne sont pas des raisons de rejeter les formats de table ouverts. Ce sont les limites à documenter avant la production. Une conception qui inclut l'exploitation du catalogue, les travaux de maintenance, les contrôles qualité, la surveillance et les procédures de rollback se comportera très différemment d'une conception qui traite le format comme un remplaçant direct d'un entrepôt.
Choisir et adopter un format de table ouvert
Choisissez le format face à la charge de travail, pas face au slogan d'un éditeur. Commencez par les moteurs qui doivent lire et écrire la table, puis testez les motifs d'écriture, l'intégration au catalogue, le comportement en cas d'échec, le chemin de maintenance et les signaux de qualité qui comptent en production.
Critère | Ce qu'il faut évaluer | Pourquoi cela compte |
|---|---|---|
Compatibilité des moteurs | Testez Spark, Trino, Flink, les outils de BI et toutes les intégrations d'entrepôt cloud que vous utilisez réellement. | Une intégration nominale peut ne pas prendre en charge toutes les fonctionnalités de table ni toutes les opérations d'écriture. |
Concurrence en écriture | Simulez des ajouts, mises à jour, suppressions, reprises et commits échoués concurrents. | La gestion des conflits détermine si les pipelines se rétablissent proprement ou exigent une intervention manuelle. |
Besoins de CDC et de mutation | Comparez les upserts, suppressions, lectures incrémentales et le comportement de Copy On Write et Merge On Read. | Les charges en streaming et mutables imposent des exigences différentes au stockage et aux lectures. |
Intégration au catalogue | Évaluez l'accès REST ou à la Hive, la découverte, les permissions, le lignage et la disponibilité du catalogue. | Le plan de contrôle détermine comment les moteurs identifient et coordonnent l'état de la table. |
Outillage de maintenance | Testez le compactage, le nettoyage des fichiers, l'évolution des partitions, les statistiques et la rétention des snapshots. | Un format facile à écrire mais difficile à entretenir devient une charge d'exploitation. |
Observabilité et qualité | Reliez les événements de commit, les changements de schéma, la ponctualité, la validation et les indicateurs métier aux processus d'incident. | La seule cohérence structurelle ne prouve pas que les données sont aptes à l'usage. |
Une migration concrète peut tenir dans un plan de 90 jours sans prétendre qu'un changement de format est un simple déploiement.
Pilote
Choisissez des tables représentatives, dont une table à forte proportion d'ajouts, une table avec des changements de schéma et une charge comportant des mises à jour ou des suppressions. Mesurez le comportement des requêtes, les conflits de commit, la croissance des métadonnées, les étapes de reprise et l'effort nécessaire pour valider les enregistrements.
Validation par double écriture
Écrivez les mêmes entrées logiques via le chemin hérité et le nouveau chemin de table. Comparez le nombre de lignes, les clés, le comportement des valeurs nulles, les agrégats, les événements de schéma, les délais de livraison et le contenu des snapshots. Gardez la comparaison centrée sur des critères d'acceptation métier, et pas seulement sur le fait que les deux systèmes ont produit des fichiers.
Bascule
Déplacez une charge en aval à la fois. Définissez la responsabilité du catalogue, des travaux de maintenance, des commits échoués, des décisions de rollback et des alertes. Gardez le chemin hérité disponible jusqu'à ce que le nouveau ait démontré des lectures, écritures, reprises et surveillances stables en conditions normales d'exploitation.
Mise hors service
Ne retirez les écrivains et chemins de stockage redondants qu'après avoir documenté les exigences de rétention, d'audit, de lignage et de rollback. Archivez les preuves nécessaires pour expliquer quand la bascule a eu lieu et quel snapshot de table est devenu la référence.
Les erreurs d'adoption courantes sont prévisibles : sous-estimer l'exploitation du catalogue, sauter les tests d'évolution des partitions, traiter le format comme un remplaçant d'entrepôt, ignorer les conflits entre écrivains concurrents et négliger la planification du rollback. Le processus de sélection le plus solide inclut l'observabilité dès le pilote, afin que les équipes voient non seulement si un commit a réussi, mais aussi si les données obtenues sont arrivées à temps et sont restées correctes pour leurs consommateurs.
Pour des décisions d'architecture plus larges, des recommandations sur la plateforme de données d'entreprise peuvent aider à situer les formats de table aux côtés de la gouvernance, de la qualité et de la responsabilité opérationnelle.
digna aide les entreprises à surveiller la qualité des données, la ponctualité, les changements de schéma, les anomalies et le comportement de la plateforme au sein de leur propre infrastructure, ce qui en fait un compagnon concret du plan de contrôle de métadonnées et de snapshots d'un format de table ouvert. Rendez-vous sur digna pour évaluer comment ces signaux peuvent soutenir une exploitation plus sûre du lakehouse.
Un commit atomique garantit qu'un lecteur ne verra jamais la moitié d'un lot ; il ne garantit pas que le lot était juste, ce qui reste un problème de gestion de la qualité des données.
Questions fréquentes
Qu'est-ce qu'un format de table ouvert ?
Une couche de spécification et de métadonnées placée au-dessus des fichiers de données bruts et sous les moteurs de requête ou de traitement. Elle fournit ce qu'un dossier ne peut pas : un contrat d'identité, d'état et de changement.
Pourquoi un dossier de fichiers n'est-il pas une table ?
Parce qu'un dossier, c'est du stockage. Un data lake brut range des fichiers dans le stockage objet aux formats Parquet, ORC ou Avro, et les conventions de répertoires tentent de combler le manque, ce qui fait qu'un lake ressemble moins à une base de données qu'à un dossier partagé au débit excellent.
Quand ces formats sont-ils apparus ?
Ils sont nés des limites de la gestion de tables à la Hive, fondée sur les répertoires. Apache Hudi a démarré chez Uber en 2016, Apache Iceberg est né chez Netflix vers 2017, et Delta Lake a été introduit par Databricks en 2017 puis ouvert en 2019.
Que sépare le format ?
La table logique des hypothèses de stockage propres à un moteur. Cette séparation est ce qui permet à plusieurs moteurs de lire la même table sans que chacun impose sa propre interprétation des fichiers qui comptent.
Quels compromis la plupart des articles omettent-ils ?
Les compromis opérationnels. Adopter un format ajoute des métadonnées à gérer, des décisions de rétention à prendre et des comportements de moteur à réconcilier : le coût n'est donc pas nul, même quand la spécification est ouverte et que la migration semble mécanique.



