Optimisation des performances de base de données : maîtrisez votre système
|
8
minute de lecture
Votre tableau de bord n’est pas tombé en panne d’un coup. Il est devenu un peu plus lent chaque semaine. Un rapport financier qui se chargeait instantanément se bloque désormais aux heures de pointe. Une actualisation BI commence à dépasser sa fenêtre. Un pipeline de features de ML tourne toujours, mais le profil des données qui l’alimentent a juste assez changé pour que les plans de requête ne se comportent plus comme lors de votre dernier réglage du système.
C’est là que se trouvent aujourd’hui de nombreuses équipes. Elles abordent l’optimisation des performances de base de données comme un exercice de traitement des requêtes lentes, alors que le véritable problème est la dérive. Pas seulement la dérive de la charge de travail, mais la dérive des données. Le nombre de lignes change, les distributions se déséquilibrent, un champ nullable commence à arriver avec de nouveaux motifs, une mise à jour de schéma passe inaperçue, et la référence à laquelle vous faisiez confiance cesse de décrire la réalité.
L’optimisation traditionnelle reste importante. Vous avez toujours besoin de plans d’exécution, de revues d’index, de réglages mémoire et de retours arrière rigoureux. Mais une optimisation statique est incomplète dans des systèmes où la forme des données change chaque jour.
Table des matières
Au-delà des requêtes lentes : la véritable source des problèmes de performance
Établir une référence : comment mesurer et diagnostiquer les problèmes
Prioriser les points chauds pour obtenir les gains les plus importants
Optimiser le cœur grâce au réglage des requêtes et du schéma
Régler le moteur par des ajustements de configuration et de ressources
Au-delà des requêtes lentes : la véritable source des problèmes de performance
La plupart des incidents de performance ne commencent pas par une seule requête manifestement défaillante. Ils commencent par un système qui devient moins prévisible. Un tableau de bord est rapide le matin et erratique à midi. Un job d’entrepôt qui tenait confortablement dans sa fenêtre de traitement par lots commence à entrer en collision avec d’autres charges de travail. Personne n’a modifié le SQL la veille, et pourtant les utilisateurs ressentent toujours la dégradation.
L’ancienne méthode consiste à trouver la requête la plus lente et à l’optimiser. Cela reste utile, mais passe à côté d’une catégorie croissante de problèmes où le SQL n’est que le symptôme. Une analyse récente montre que 68 % des dégradations de performance des bases de données en 2024–2025 ne proviennent pas de l’inefficacité des requêtes, mais de problèmes de qualité des données en amont qui modifient les schémas d’accès de manière inattendue, alors que seulement 12 % des contenus consacrés à l’optimisation relient les métriques d’observabilité à l’optimisation des performances, selon l’analyse de Last9 sur l’optimisation des performances de base de données.
Pourquoi des systèmes stables deviennent instables
Une requête peut être parfaitement adaptée à la forme des données du mois dernier et mal adaptée à celle d’aujourd’hui. PostgreSQL en est un bon exemple. Une table peut accumuler des modifications, l’autovacuum prend du retard, le bloat augmente, et ce qui ressemblait à un balayage modeste se transforme en comportement d’E/S désastreux. Les équipes SQL Server observent une dérive similaire autour de la contention de tempdb et de la sélection des plans face à des charges de travail changeantes. Les environnements Teradata peuvent sembler sains au niveau du système alors qu’une classe de charge de travail évolue subtilement, suffisamment pour fausser la mise en file d’attente et les temps de réponse.
L’optimisation statique suppose que les données restent similaires. Les systèmes de production respectent rarement cette hypothèse.
C’est pourquoi l’optimisation des performances de base de données exige une vision plus large. Vous ne gérez pas seulement le texte des requêtes et les paramètres du moteur. Vous gérez les conditions dans lesquelles ces requêtes s’exécutent.
Une façon pratique de l’envisager est la suivante :
Un SQL lent signifie souvent de mauvais chemins d’accès, des jointures inadaptées, des statistiques obsolètes ou des lectures excessives.
Une dérive des performances signifie souvent que la charge de travail a changé parce que les données ont changé.
L’impact métier se manifeste d’abord par des rapports obsolètes, des tableaux de bord retardés et des résultats de modèles moins fiables.
Les équipes qui travaillent sur la performance full-stack pour les développeurs savent déjà que la latence concerne généralement plusieurs couches. Le travail sur les bases de données n’est pas différent. Si un chargement en amont introduit des doublons, modifie la cardinalité ou change le rythme d’arrivée des nouvelles données, votre plan de requête peut se dégrader même si le code applicatif n’a pas été touché.
La faille cachée de la plupart des processus d’optimisation
Les références traditionnelles sont souvent des instantanés. Elles capturent une bonne période, éventuellement une mauvaise, puis comparent les deux. C’est utile, mais cela ne vous indique pas quand la référence elle-même n’est plus fiable parce que le schéma, le volume, la fraîcheur ou la distribution ont dérivé.
C’est dans cet écart que se logent de nombreux incidents récurrents. La base de données ne s’est pas soudainement dégradée. L’environnement qui l’entoure a changé, et l’équipe a continué à optimiser à partir d’une image dépassée.
Établir une référence : comment mesurer et diagnostiquer les problèmes
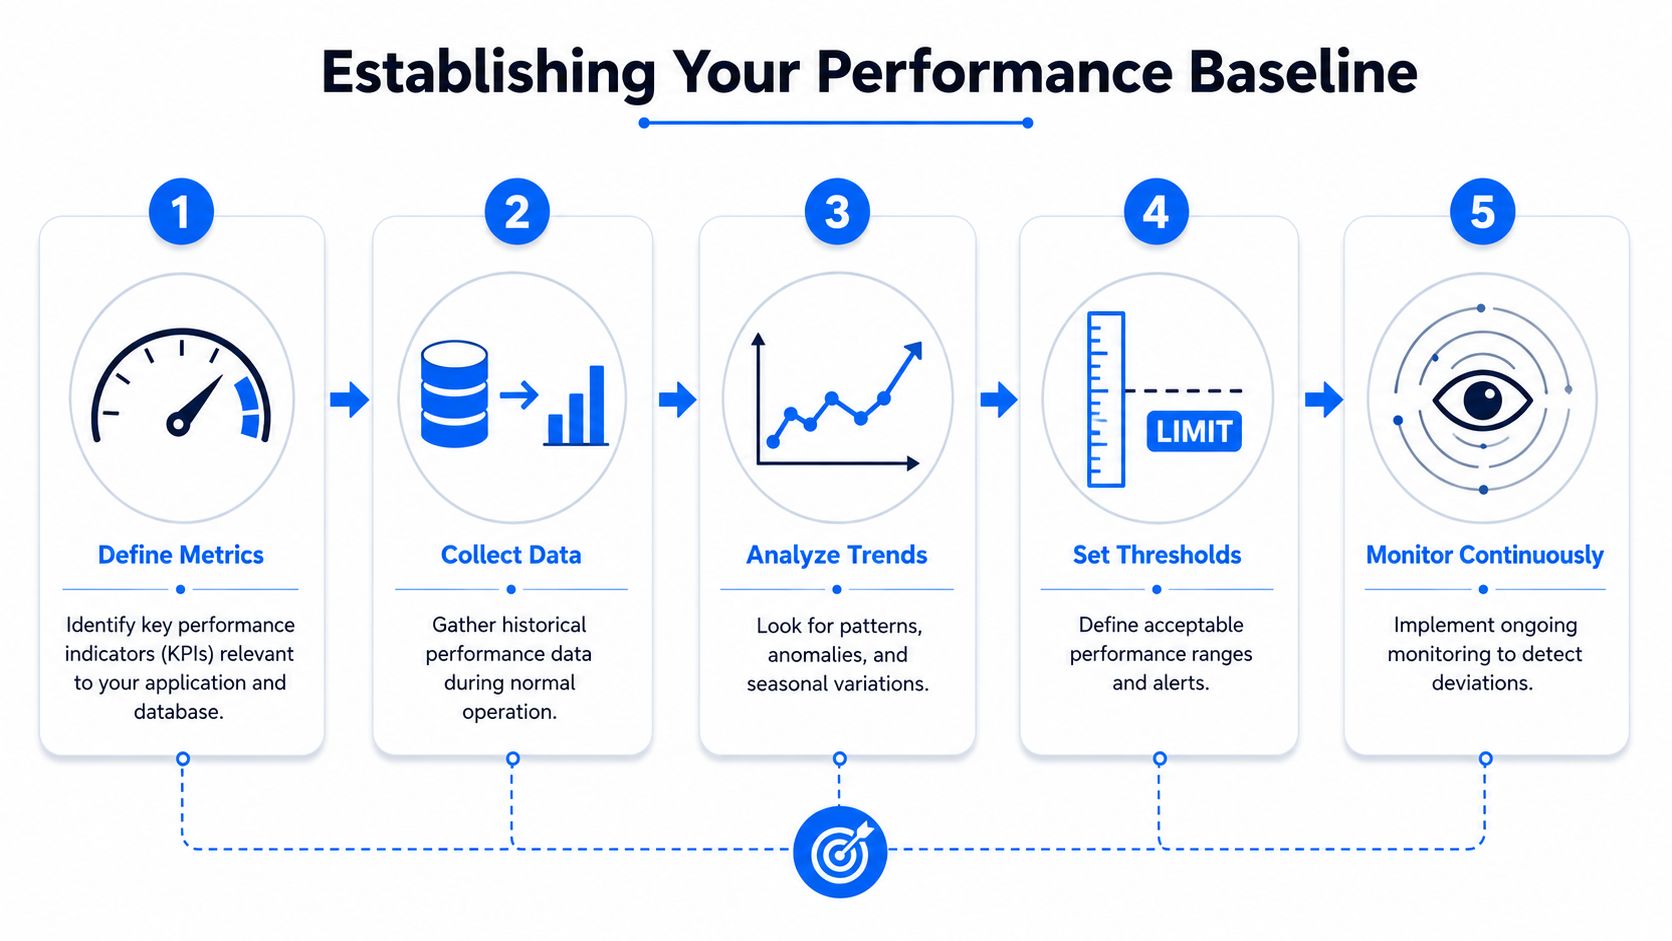
L’optimisation des performances de base de données commence par des preuves. Si vous ne pouvez pas décrire l’état normal du système, vous ne pouvez pas savoir si un changement a amélioré quoi que ce soit ou simplement déplacé le problème ailleurs.
Le processus de base n’a pas changé, car il fonctionne. Le cycle « mesurer, analyser, optimiser, valider » est la norme universelle : il exige de capturer la latence, le débit et l’utilisation des ressources avant toute optimisation, afin que les changements soient validés par rapport à une référence, comme le décrit cette présentation du cycle d’optimisation des performances.
Mesurer d’abord, intervenir ensuite
Même les bonnes équipes s’impatientent à ce stade. C’est compréhensible. Les utilisateurs attendent, et la pression pousse à « simplement ajouter un index » ou à « lui donner plus de mémoire ». Résistez à cette tentation tant que vous n’avez pas capturé une référence couvrant à la fois des périodes saines et des périodes dégradées.
Les recommandations d’optimisation d’Oracle restent utiles sur ce point, car elles insistent sur la collecte complète des statistiques du système d’exploitation, de la base de données et de l’application, aussi bien dans les bons que dans les mauvais états. Cette discipline compte. Des statistiques manquantes ne sont pas un problème administratif : elles transforment l’analyse des causes profondes en conjectures.
Règle pratique : si vous n’avez pas enregistré l’état initial, vous ne pouvez pas prouver que l’état final est meilleur.
La collecte de la référence doit couvrir l’enveloppe de fonctionnement de la charge de travail, et pas seulement une instruction lente isolée. Cela signifie mesurer ce que fait le système par module, par fenêtre temporelle et par type de ressource.
Pour les équipes qui souhaitent renforcer leurs pratiques de surveillance, ces techniques de surveillance et d’audit des bases de données méritent d’être examinées en complément des outils natifs du moteur.
Ce que la référence doit capturer
L’outillage exact varie selon la plateforme, mais les catégories restent les mêmes. Query Store dans SQL Server et Azure SQL, pg_stat_statements dans PostgreSQL, les vues de performance d’Oracle et les tables système de Teradata permettent tous de mettre en évidence les mêmes catégories de preuves.
Signal | Ce qu’il faut rechercher | Ce que cela indique généralement |
|---|---|---|
Latence | Hausse de la latence de queue et temps de réponse instables | Changements de plan, pression sur les E/S, blocages, défauts de cache |
Débit | Moins de travail accompli par module ou par fenêtre de job | Contention, mise en file d’attente, amplification des écritures |
CPU et mémoire | Saturation, variations soudaines, mauvais comportement du cache | Mauvais plans, sursouscription, caches sous-dimensionnés |
E/S et attentes | Pics de lecture, débordements, pression sur le stockage, événements d’attente | Index manquants, pression sur les tris, bloat, travail temporaire |
Erreurs et nouvelles tentatives | Délais d’expiration, renouvellement fréquent des connexions, actualisations échouées | Épuisement des ressources, pools mal dimensionnés, chaînes de verrous |
Capturez ces métriques sous une charge reproductible lorsque c’est possible. Si vous n’échantillonnez que pendant une panne, vous ne saurez pas si le problème est exceptionnel ou s’il fait partie d’une tendance.
Une référence solide répond généralement à quatre questions opérationnelles :
Ce qui était lent. Pas une simple anecdote, mais les catégories de requêtes, les jobs et les parcours utilisateur concernés.
Où se situait la pression. CPU, mémoire, stockage, espace temporaire ou concurrence.
Quand cela a changé. Après un déploiement, après l’arrivée de données, pendant une fenêtre de reporting ou pendant une maintenance en arrière-plan.
Si le métier s’en est aperçu. Tableaux de bord retardés, analyses obsolètes, SLA non respectés ou scoring de modèles retardé.
Les références ont besoin de contexte, pas seulement de métriques
Une référence trop étroite peut vous induire en erreur. Supposons qu’une requête d’entrepôt ait ralenti après qu’un changement de schéma a ajouté une nouvelle colonne et que l’ETL en aval a commencé à la remplir avec des motifs de valeurs nulles inattendus. Le plan de requête est peut-être le mécanisme immédiat, mais le diagnostic n’est complet que lorsque vous reliez l’évolution des performances à l’évolution de la forme des données.
C’est pourquoi une optimisation mature des performances de base de données ne s’arrête pas à « collecter des métriques ». Elle relie les métriques système au calendrier de la charge de travail, à l’état du schéma et au comportement d’arrivée des données. Sinon, votre référence est précise mais incomplète.
Prioriser les points chauds pour obtenir les gains les plus importants
Une fois le système mesuré, le piège suivant est l’optimisation au hasard. Les équipes se noient dans les graphiques, puis passent une semaine à peaufiner des requêtes à faible impact pendant que le véritable goulet d’étranglement continue de consommer du CPU ou de saturer les E/S.
Le moyen le plus rapide d’en sortir est de prioriser par impact. Pas selon la requête qui paraît la plus laide. Pas selon l’alerte qui s’est déclenchée en premier. Mais selon le point chaud qui consomme les ressources les plus significatives ou qui cause la gêne la plus large pour les utilisateurs.
Classer par impact, pas par agacement
Une requête qui s’exécute en permanence et gaspille des ressources modérées peut compter davantage qu’un rapport ponctuel spectaculaire. SQL Server Query Store, les visualisations d’Azure SQL, les vues de charge de travail d’Oracle, pg_stat_statements de PostgreSQL et les métriques de charge de travail de Teradata aident tous à répondre à la même question : qu’est-ce qui est assez coûteux, de manière répétée, pour façonner le comportement du système ?
Commencez par un modèle de classement simple :
La fréquence compte. Une petite inefficacité exécutée toute la journée peut dominer la charge totale.
L’étendue compte. Les requêtes liées à des tableaux de bord partagés ou à des API centrales méritent plus d’attention que des jobs d’administration de niche.
Le type de ressource compte. Les points chauds gourmands en CPU et ceux gourmands en E/S appellent des corrections différentes.
Le moment compte. Un job qui entre en collision avec le reporting du matin peut être plus urgent qu’une tâche plus lente exécutée la nuit.
N’optimisez pas d’abord la requête la plus bruyante. Optimisez celle qui perturbe le plus la plateforme.
C’est dans les plans d’exécution que cela devient concret. Recherchez les balayages complets de grandes tables, les jointures coûteuses avec de mauvaises estimations du nombre de lignes, les débordements vers le stockage temporaire ou les recherches de clés répétées qui gonflent les lectures. Dans PostgreSQL, vérifiez si la pression des checkpoints ou le retard de l’autovacuum coïncide avec le ralentissement. Dans SQL Server, examinez le comportement de tempdb et les schémas d’allocation de mémoire. Dans Teradata, examinez quelles classes de charge de travail sont en file d’attente et si une famille de requêtes monopolise les ressources.
À quoi ressemble un véritable point chaud
Un véritable point chaud prend généralement l’une de ces formes :
Une requête de reporting qui semblait correcte sur une table de taille modérée, mais qui balaie désormais beaucoup plus de données parce que la distribution a changé.
Une instruction transactionnelle fréquemment exécutée qui a perdu un chemin d’accès efficace après une dérive des statistiques.
Une transformation d’entrepôt dont le volume de tri intermédiaire a augmenté jusqu’à commencer à déborder.
Une large jointure BI qui était acceptable avant qu’une dérive de schéma n’introduise des clés dupliquées ou orphelines en amont.
Raisonnez en termes d’effort et d’impact avant de commencer à modifier des objets. Certains gains sont simples : actualiser les statistiques, supprimer un index manifestement inutilisé qui alourdit les écritures, ou corriger un prédicat qui empêche l’utilisation d’un index. D’autres demandent plus de précautions, car ils modifient le comportement de l’application ou la conception du stockage.
L’objectif n’est pas de constituer un backlog parfait. Il s’agit d’identifier les quelques changements qui ramèneront la plateforme vers des rapports stables, des fenêtres de traitement par lots prévisibles et des consommateurs en aval fiables.
Optimiser le cœur grâce au réglage des requêtes et du schéma
Une fois les points chauds classés, optimisez d’abord le chemin principal. Cela concerne généralement les schémas de requêtes, les index, les statistiques, et seulement ensuite les changements de schéma plus lourds. La plupart des systèmes offrent encore une marge étonnante d’améliorations à faible risque avant qu’il ne soit nécessaire d’envisager un repartitionnement ou une refonte majeure.
Commencer par des changements à faible risque
Une démarche rigoureuse commence petit. Actualisez les statistiques si elles sont obsolètes. Examinez les plans d’exécution. N’ajoutez ou n’ajustez des index que lorsque le plan et le schéma d’accès le justifient. Les réécritures SQL mineures, les corrections des pools de connexions et la validation des plans passent généralement avant une refonte structurelle.
Une erreur pratique se retrouve partout : les équipes continuent d’ajouter des index sans vérifier si les index existants se recoupent déjà ou si le chemin d’écriture peut supporter un coût de maintenance supplémentaire. Les recommandations résumées dans cette présentation de l’optimisation des performances de base de données vont dans le bon sens : supprimer les index inutilisés ou redondants peut réduire la surcharge en écriture et le coût de stockage, tandis qu’en ajouter aveuglément peut pousser l’optimiseur vers de mauvais choix ou alourdir la maintenance.
Quelques actions d’optimisation sont systématiquement payantes :
Faites le ménage dans la prolifération des index. Les index redondants augmentent le coût des écritures et peuvent compliquer le diagnostic.
Privilégiez des index courts et ciblés. Les grands champs de type texte sont généralement de mauvais candidats à l’indexation, car ils augmentent la taille de la structure et le coût de calcul.
Vérifiez le comportement du cache après les modifications de requêtes. Les buffer pools doivent contenir l’ensemble de travail sans consommer toute la mémoire du système.
Auditez régulièrement. La revue des index et l’hygiène de configuration évitent la lente dégradation qui s’installe dans les systèmes matures.
Utiliser les réécritures par IA avec prudence
La réécriture de requêtes par IA est séduisante, car elle promet des gains rapides. Elle aide parfois. Elle peut suggérer des simplifications de jointures, un nettoyage des prédicats ou des formulations alternatives que des humains pressés par le temps pourraient manquer.
Mais l’IA présente un vrai danger dans les bases de données de production. Une enquête sectorielle de 2025 a révélé que 44 % des optimisations de requêtes générées par IA introduisaient des bogues subtils dans des jeux de données de la finance et de la santé, en raison d’une mauvaise interprétation du traitement des valeurs nulles ou de la sémantique des plages de dates, selon ce résumé d’enquête sectorielle sur l’optimisation pilotée par l’IA.
Ce résultat confirme ce que les ingénieurs expérimentés savent déjà : la rapidité d’une requête n’est pas la même chose que son exactitude.
Traitez les suggestions de l’IA comme le brouillon d’un relecteur junior :
Vérifiez le changement de plan d’exécution.
Validez la sémantique au niveau des enregistrements.
Comparez les jeux de résultats sur des cas limites représentatifs.
Surveillez de près le traitement des valeurs nulles, les bornes de dates et le comportement des doublons.
Un SQL plus rapide qui renvoie les mauvaises lignes est un défaut de production, pas une optimisation.
C’est encore plus important dans les systèmes d’analytique et de ML. Une erreur sémantique subtile dans une requête de reporting peut produire un KPI obsolète ou trompeur. Une mauvaise réécriture dans un pipeline de features peut modifier les entrées du modèle tout en donnant l’impression que l’entrepôt est « plus rapide ».
Savoir quand les changements de schéma en valent la peine
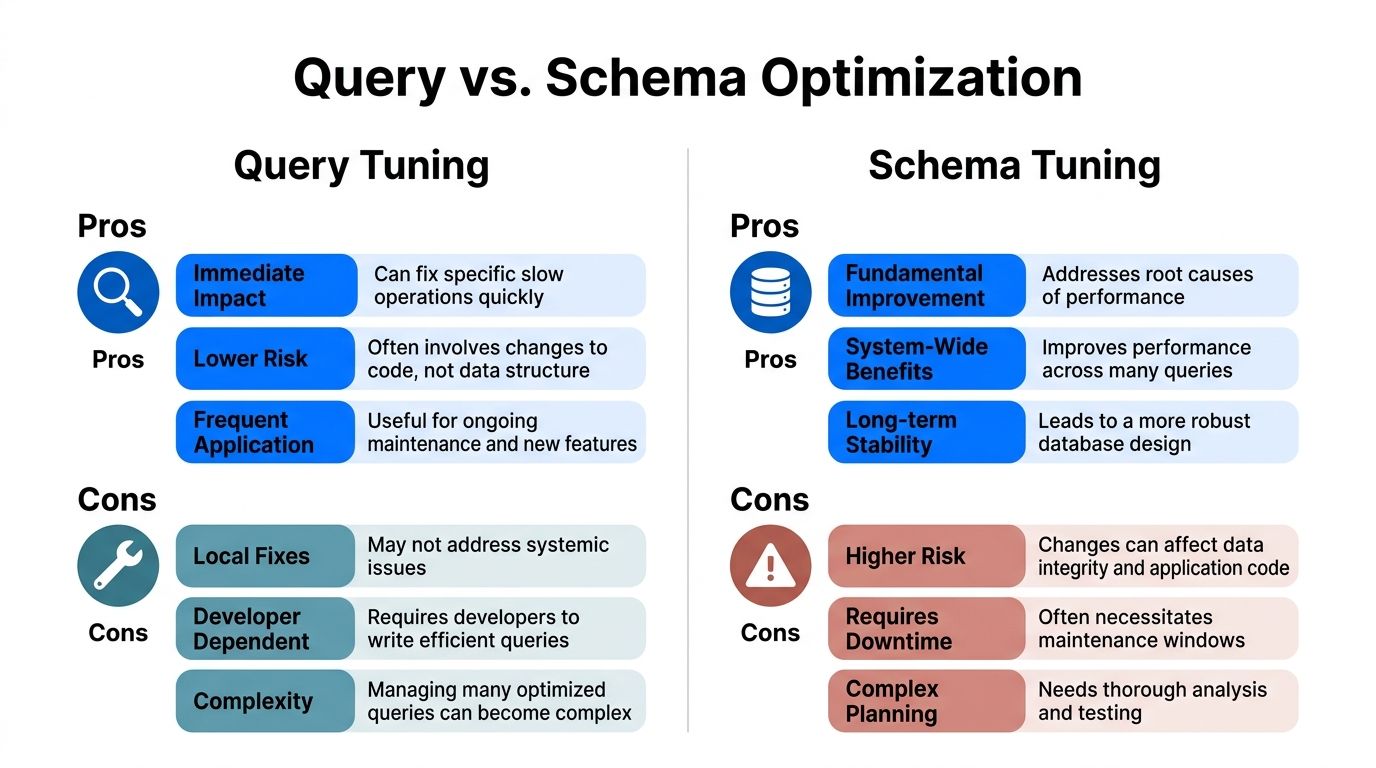
L’optimisation des requêtes est locale. L’optimisation du schéma est systémique. C’est pourquoi les changements de schéma peuvent apporter des bénéfices étendus, mais comportent aussi davantage de risques.
Recourez aux changements de schéma lorsque le problème est structurel et non cosmétique. Par exemple, des tables qui ont clairement dépassé leur structure actuelle, des chemins de jointure qui dépendent systématiquement de formes de clés maladroites, ou des charges de travail qui nécessitent un partitionnement et une gestion du cycle de vie plutôt qu’une nouvelle série de rustines sur les requêtes.
Une façon utile de présenter le choix :
Option | Idéale lorsque | Principal compromis |
|---|---|---|
Optimisation des requêtes | Un petit nombre d’instructions est à l’origine du problème | Vous risquez de ne corriger que des symptômes locaux |
Optimisation des index | Les chemins d’accès sont erronés ou incomplets | Les écritures deviennent plus coûteuses |
Optimisation du schéma | De nombreuses requêtes souffrent de la même contrainte de conception | Risque de changement plus élevé et davantage de coordination |
L’ordre compte. Commencez par l’option la moins perturbatrice susceptible de résoudre le problème. Si rien ne bouge, revenez proprement en arrière et passez à la couche suivante.
Cet état d’esprit évite que l’optimisation des performances de base de données ne se transforme en refonte accidentelle.
Régler le moteur par des ajustements de configuration et de ressources
Une fois le travail sur les requêtes et le schéma engagé, portez votre attention sur le moteur lui-même, une phase où beaucoup d’équipes en font soit trop, soit pas assez. Soit elles tournent tous les boutons qu’elles trouvent, soit elles laissent de côté des problèmes de ressources évidents parce qu’elles supposent que « ça doit venir du SQL ».
Ce sont deux erreurs.
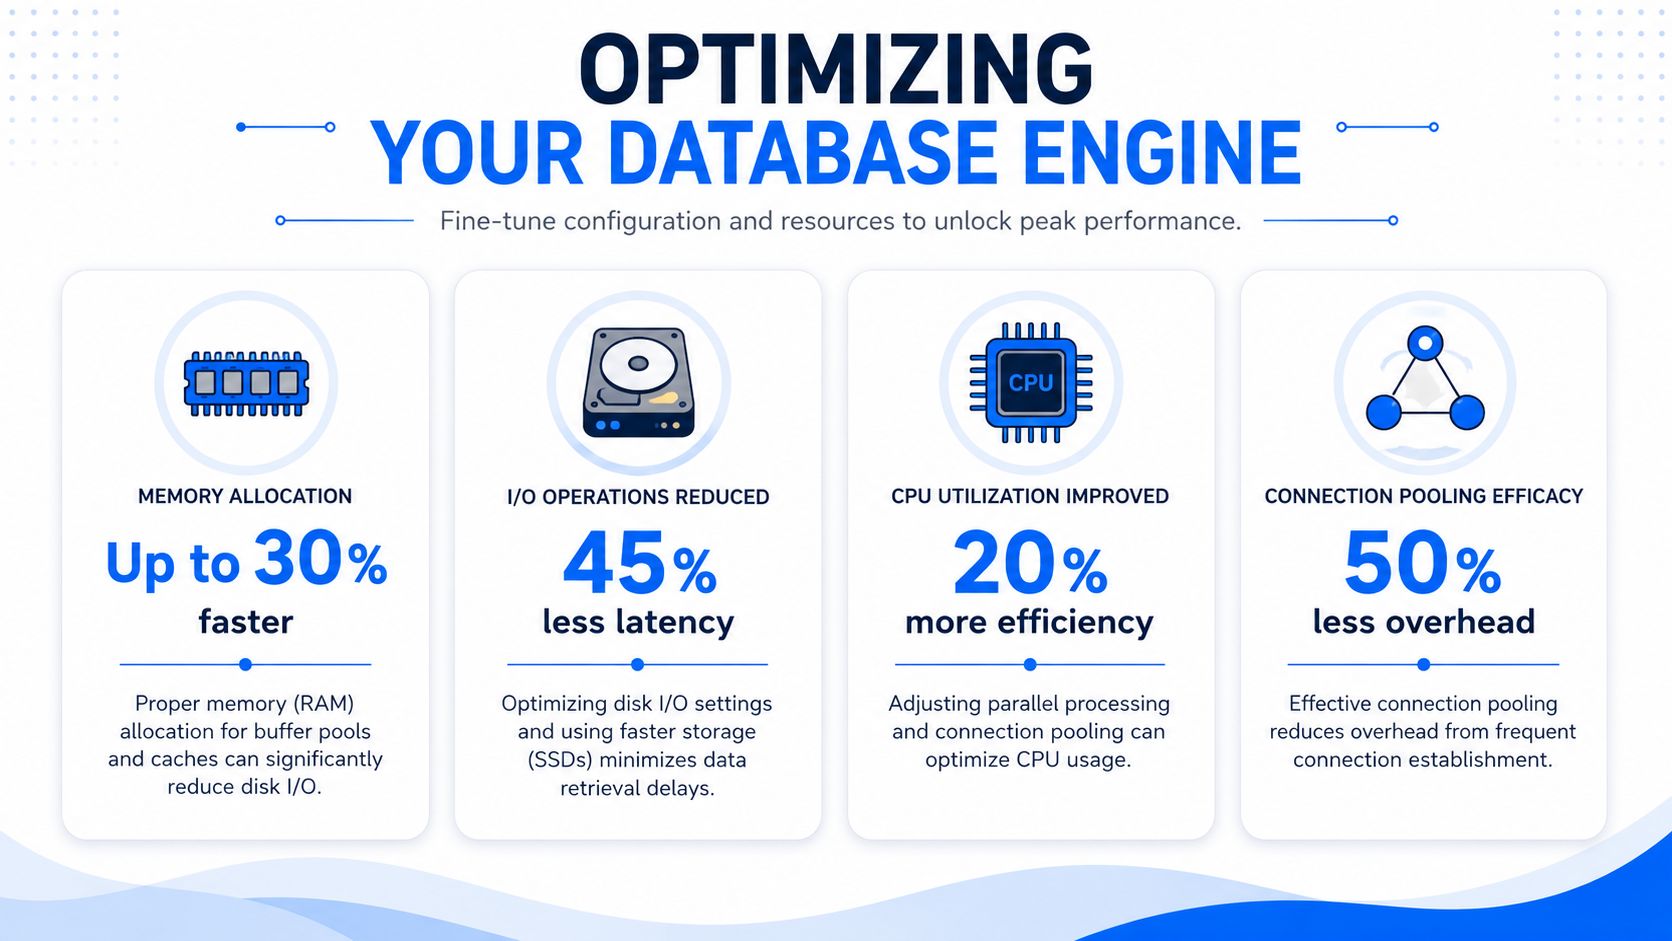
Traiter la configuration comme une expérience
Le réglage de la configuration ne fonctionne que s’il suit une méthode stricte, un changement à la fois. La méthodologie d’optimisation d’Oracle est explicite sur ce point dans ses recommandations pour une méthode d’optimisation pas à pas. Modifiez un paramètre ou un objet à la fois, enregistrez les métriques avant et après, et ne revendiquez pas de succès tant que le lien de causalité n’est pas clair.
Cela s’applique aux réglages mémoire, aux pools de connexions, au parallélisme, à l’emplacement du stockage et aux outils de diagnostic. Cela s’applique aussi au piège, petit mais courant, qui consiste à laisser tourner en production des traces ou des sessions Extended Events après une investigation. Ces outils peuvent finir par peser dans le profil de latence si personne ne les nettoie.
Un ordre d’intervention utile se présente ainsi :
La mémoire d’abord. Vérifiez si le buffer pool ou les shared buffers peuvent contenir l’ensemble de travail sans priver le reste de l’hôte de ressources.
Le comportement des connexions ensuite. Un trop grand nombre de sessions actives peut créer une contention artificielle et une pression sur l’ordonnanceur.
Le chemin d’E/S après cela. Recherchez les schémas de débordement temporaire, la profondeur des files d’attente ou un mauvais emplacement des fichiers critiques.
Ce n’est qu’ensuite qu’il faut ajuster les réglages plus profonds. Le parallélisme, les paramètres des workers et les comportements avancés du moteur exigent des preuves plus solides.
Les vérifications propres à chaque plateforme qui comptent
Les détails varient d’un moteur à l’autre, mais certaines vérifications sont trop importantes pour être ignorées.
Interaction entre Oracle et le système d’exploitation
Une règle historique essentielle d’Oracle reste valable : si l’utilisation du noyau du système d’exploitation dépasse 40 %, la cause probable est une contention au niveau du système d’exploitation, comme la pagination, le swapping, la surcharge des transferts réseau ou l’emballement des processus, plutôt que de simples défauts SQL, comme le documente le guide d’optimisation des performances d’Oracle. Lorsque ce seuil apparaît, cessez de faire comme si le problème se limitait à une requête.
SQL Server et tempdb
Si tempdb est mal placé ou sous-dimensionné pour la charge de travail, le reste de la discussion sur l’optimisation devient vite confus. Les débordements, la pression liée au versionnage et l’activité temporaire concurrente aggravent les symptômes de « requête lente » au-delà de ce qu’ils paraissent.
PostgreSQL et le comportement de maintenance
Surveillez de près les checkpoints et l’autovacuum. Si l’autovacuum prend du retard, le bloat des tables peut transformer des lectures ordinaires en E/S coûteuses. Si les paramètres des checkpoints ne correspondent pas au schéma d’écriture, la latence devient irrégulière.
Teradata et les classes de charge de travail
Sur Teradata, les moyennes du système peuvent masquer les difficultés. La vue utile est celle du comportement au niveau des charges de travail, de la mise en file d’attente et de la part des ressources consommée par une classe d’activité pendant les fenêtres critiques.
C’est dans le réglage du moteur que la discipline compte le plus. Un changement, un cycle de mesure, une voie de retour arrière.
Sans cette rigueur, l’optimisation des performances de base de données devient de la superstition. Vous ne saurez pas si le changement de mémoire a aidé, si le changement de pool a nui à la concurrence ou si une correction du stockage a masqué un problème de plan pendant une semaine.
De l’optimisation réactive à l’observabilité continue
Les séances d’optimisation ponctuelles restent nécessaires. Elles ne sont simplement plus suffisantes.
La raison est simple. Votre plateforme de données continue d’évoluer après la fin de la séance d’optimisation. Les tables grossissent. Les jobs en amont arrivent en retard. Les schémas dérivent. Les distributions des enregistrements évoluent. Une référence capturée pendant une période saine cesse peu à peu de représenter la réalité de la production.
Les références statiques se dégradent
Si vous ne revenez sur les performances que lorsque les utilisateurs se plaignent, vous êtes toujours sur la défensive. À ce stade, le problème s’est déjà propagé sous forme de rapports obsolètes, de tableaux de bord défaillants, d’analyses retardées ou de fonctionnalités d’IA peu fiables.
L’observabilité continue comble cet écart. Le changement important consiste à surveiller non seulement les métriques du moteur, mais aussi les conditions des données qui invalident les hypothèses de performance :
Les anomalies de volume qui modifient les schémas d’accès
Les changements de schéma tels que l’ajout de colonnes, la suppression de champs ou les changements de type
La dérive de ponctualité lorsque les données attendues arrivent en retard ou n’arrivent pas du tout
Les problèmes de qualité au niveau des enregistrements, notamment les doublons, les anomalies de valeurs nulles et les relations rompues
L’IA peut être utile ici lorsqu’elle est appliquée à la détection d’anomalies plutôt qu’à la réécriture aveugle des requêtes. La détection d’anomalies par IA peut réduire jusqu’à 90 % la charge de maintenance manuelle des règles lorsque des méthodes non supervisées apprennent le comportement normal et définissent automatiquement des seuils adaptatifs, selon la description de la plateforme de données d’entreprise de digna. C’est important, car les seuils maintenus manuellement vieillissent mal dans des entrepôts dynamiques.
Ce que change l’observabilité continue
L’élément architectural qui rend cela possible en pratique est l’analyse au sein de la base de données. Le calcul des métriques au sein de la base de données élimine les coûts de déplacement des données en exécutant l’inspection directement dans les bases sources, ce qui permet une surveillance en temps réel et l’apprentissage des références tout en garantissant que les données du client restent privées dans son propre environnement, comme le décrit cette présentation de l’analyse des charges de travail au sein de la base de données.
Ce modèle est particulièrement utile dans les environnements de cloud privé et sur site, où les équipes ont besoin de visibilité sans exporter de données de production sensibles. Il correspond aussi à la façon dont travaillent les data engineers. Si l’observabilité peut s’exécuter au plus près des tables de charge de travail Teradata, des statistiques système de PostgreSQL ou de la logique de validation résidant dans l’entrepôt, vous pouvez repérer la dérive avant qu’elle ne devienne un incident visible par les utilisateurs.
Un modèle d’exploitation plus solide combine :
la télémétrie des requêtes et du moteur,
le suivi des schémas,
la surveillance de la fraîcheur,
la détection d’anomalies sur la forme des données,
et la validation au niveau des enregistrements liée aux règles métier.
Si vous souhaitez une introduction plus large à ce modèle d’exploitation, cette présentation de l’observabilité des données en pratique constitue un bon point de départ.
L’optimisation des performances de base de données donne les meilleurs résultats lorsqu’elle évolue d’une activité de sauvetage vers une boucle de contrôle continue. C’est ainsi que vous protégez non seulement la latence des requêtes, mais aussi la confiance dans les résultats que fournit votre base de données.
Si votre équipe cherche à relier les performances de base de données à la dérive des données, aux changements de schéma, à la ponctualité et à la validation au niveau des enregistrements dans un même modèle d’exploitation, digna est conçu pour cela. Il exécute les analyses au sein de votre environnement, aide à faire apparaître les anomalies avant qu’elles ne deviennent des rapports obsolètes ou des entrées d’IA peu fiables, et donne aux ingénieurs un moyen de garder des références de performance fidèles à mesure que les données évoluent.
Pour surveiller les conditions des données qui invalident discrètement une référence d’optimisation, comme les variations de volume, les changements de schéma et les chargements tardifs, découvrez comment digna aborde l’observabilité des plateformes de données au sein de votre propre base de données.
Questions fréquentes
Qu’est-ce qui dégrade les performances d’une base de données au fil du temps ?
Souvent les données, et non le SQL. L’analyse de Last9 citée dans l’article attribue 68 % des dégradations de performance des bases de données en 2024-2025 à des problèmes de qualité des données en amont qui modifient les schémas d’accès, comme l’évolution du nombre de lignes, des distributions déséquilibrées, de nouveaux motifs de valeurs nulles ou des mises à jour de schéma passées inaperçues qui rendent une ancienne référence obsolète.
Que doit inclure une référence de performance de base de données ?
Une référence utile capture la latence, le débit, le CPU et la mémoire, les E/S et les événements d’attente, ainsi que les erreurs et les nouvelles tentatives, mesurés pendant des périodes saines comme dégradées. Elle doit répondre à quatre questions : ce qui était lent, où se situait la pression, quand cela a changé et si le métier s’en est aperçu à travers des tableaux de bord retardés ou des SLA non respectés.
Comment choisir les requêtes lentes à optimiser en premier ?
Classez les points chauds par impact, et non selon la requête qui paraît la plus laide ou qui a déclenché la première alerte. Tenez compte de la fréquence, de l’étendue, du type de ressource et du moment : une petite inefficacité exécutée toute la journée peut dominer la charge totale, et un job qui entre en collision avec le reporting du matin peut compter davantage qu’une tâche nocturne plus lente. Query Store et pg_stat_statements vous y aident.
Est-il sûr d’utiliser l’IA pour réécrire des requêtes SQL ?
Uniquement avec une revue attentive. Une enquête sectorielle de 2025 citée dans l’article a révélé que 44 % des optimisations de requêtes générées par IA introduisaient des bogues subtils dans des jeux de données de la finance et de la santé, principalement autour du traitement des valeurs nulles et des plages de dates. Traitez les suggestions comme le brouillon d’un junior : vérifiez le plan, comparez les jeux de résultats et testez les cas limites.
Comment tester les changements de configuration d’une base de données ?
Modifiez un paramètre à la fois, enregistrez les métriques avant et après, et conservez une voie de retour arrière, conformément à la méthode pas à pas d’Oracle. Procédez dans l’ordre : la mémoire d’abord, puis le comportement des connexions, puis le chemin d’E/S, et seulement ensuite le parallélisme ou les paramètres des workers. Oracle signale aussi qu’une utilisation du noyau du système d’exploitation supérieure à 40 % indique une contention au niveau du système d’exploitation.


