Optimisation des requêtes T-SQL : Guide pratique de performance
|
7
minute de lecture

Une requête SQL Server lente ne se présente généralement pas avec une explication claire. Elle atterrit en production sous la forme d'un tableau de bord qui expire, d'une procédure stockée qui fonctionnait bien auparavant, ou d'un rapport qui n'échoue que lorsque le bon client ou la bonne plage de dates est ciblé. C'est pourquoi la tsql query optimization fonctionne le mieux lorsqu'elle commence par des preuves, et non par une réécriture.
Table des matières
Commencer par les diagnostics avant de réécrire quoi que ce soit
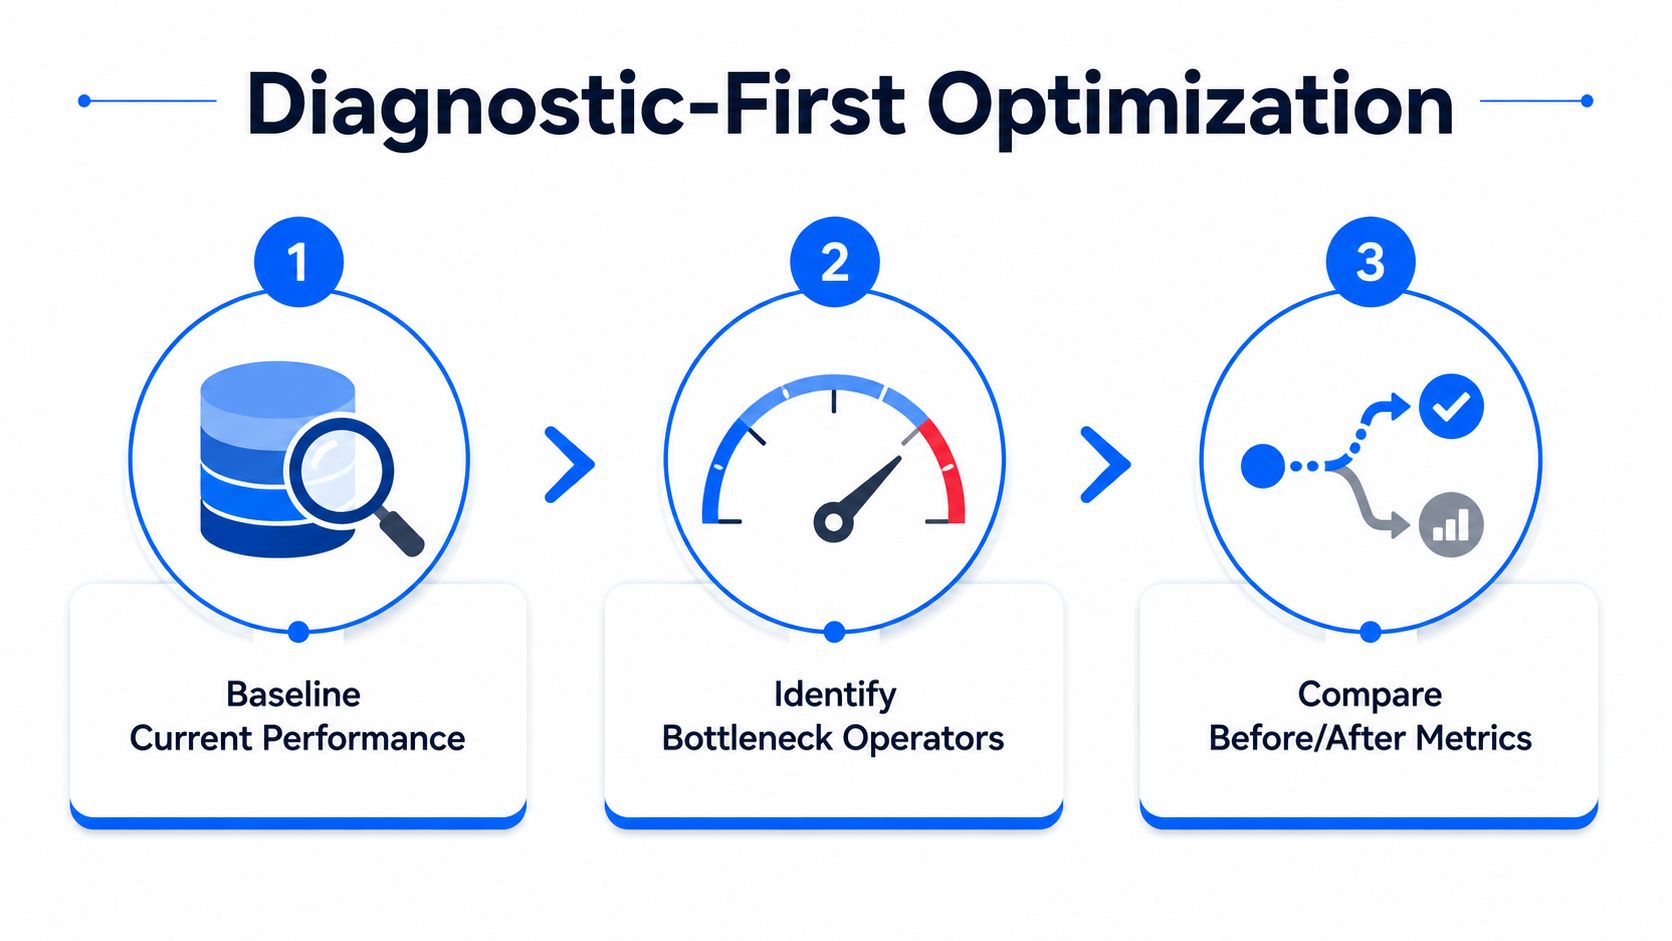
Établir d'abord une référence, puis toucher au SQL
Modifier une seule chose à la fois
Lire les plans d'exécution et comprendre le comportement de l'optimiseur
Lire le plan à partir des feuilles vers le haut
Lignes estimées par rapport aux lignes réelles
Réécrire des requêtes avec des modèles basés sur les ensembles et un filtrage précoce
Faire en sorte que le moteur touche moins de données
Utiliser les objectifs de lignes (row goals) et les indices avec retenue
Conception d'index et stratégies de maintenance des statistiques
Concevoir pour la requête que vous exécutez réellement
Garder des statistiques assez fraîches pour s'y fier
Résoudre les défis de reniflage de paramètres (parameter sniffing) et de forçage de plan
Quand le plan mis en cache est le problème
Choisir le remède qui correspond au mode de défaillance
Traiter la pression mémoire et les contraintes de ressources de la plateforme
Séparer le coût de la requête locale de la pression sur les ressources partagées
Escalader vers la planification de la capacité quand la charge de travail l'exige
Mettre en œuvre une surveillance continue avec l'Observability en base de données
Surveiller les dérives avant les utilisateurs
Utiliser l'observability pour boucler la boucle
Commencer par les diagnostics avant de réécrire quoi que ce soit
Le moyen le plus rapide de perdre du temps est de modifier le SQL avant de savoir ce qui est lent. En production, une requête peut sembler coupable alors que le problème réside dans une contention partagée, des statistiques obsolètes ou un mauvais plan mis en cache à partir d'une valeur de paramètre différente. Une phase d'optimisation disciplinée commence par la capture de la charge de travail exacte, y compris les paramètres réels, et la mesure de la requête avant que quoi que ce soit ne change.
Établir d'abord une référence, puis toucher au SQL
La référence n'est pas facultative. Une boucle d'optimisation pratique commence par le temps d'exécution, les lectures logiques et le processeur, puis capture le plan et la charge de travail environnante afin de déterminer si un changement a aidé ou s'il a simplement déplacé le coût ailleurs, ce qui est le même flux de travail recommandé dans les guides d'optimisation de SQL Server car il maintient la cause et l'effet visibles (tuning workflow guidance).
Règle pratique : si vous ne pouvez pas expliquer l'opérateur goulot d'étranglement avant la réécriture, vous ne comprenez probablement pas encore le problème.
C'est particulièrement vrai lorsque le symptôme est un temps de réponse lent mais que la cause se situe en dehors du texte de l'instruction. L'analyse des attentes au niveau du serveur, la corrélation des files d'attente, puis l'inspection au niveau de la base de données ou de la requête constituent la séquence qui évite de se tromper de cible, car la charge de travail peut être bloquée par la pression des E/S, de la mémoire ou de la concurrence avant même d'atteindre votre candidate à la réécriture (instance-to-query tuning sequence).
Modifier une seule chose à la fois
L'optimisation variable par variable semble lente, mais c'est le seul moyen d'avoir confiance dans le résultat. Si vous modifiez le texte de la requête, l'index et la mise à jour des statistiques au cours de la même phase, vous ne saurez pas quel levier a eu de l'importance. Pire encore, une réécriture peut améliorer les lectures logiques tout en augmentant l'utilisation du processeur ou en rendant le plan plus fragile sous un ensemble de paramètres différent.
Un bon flux de travail ressemble à ceci :
Capturer le texte exact de la requête et ses paramètres. Une même procédure stockée peut se comporter de manière très différente selon les entrées.
Trouver l'opérateur goulot d'étranglement. Les tris, les scans et les recherches de clés (key lookups) sont souvent les endroits où le coût s'accumule.
Appliquer une seule modification ciblée. Puis réexécuter la même charge de travail dans les mêmes conditions.
Comparer avec la référence. Vérifier à nouveau les lectures, le processeur et le temps écoulé avant de continuer.
Cette méthode semble simple parce qu'elle l'est. Le plus difficile est de résister à l'envie de tout « corriger » en même temps. Si la requête souffre réellement d'une contention des ressources partagées, la première correction utile peut se situer en dehors de la requête elle-même, c'est pourquoi les administrateurs de bases de données expérimentés ne considèrent pas le texte SQL comme le seul endroit où chercher.
Lire les plans d'exécution et comprendre le comportement de l'optimiseur
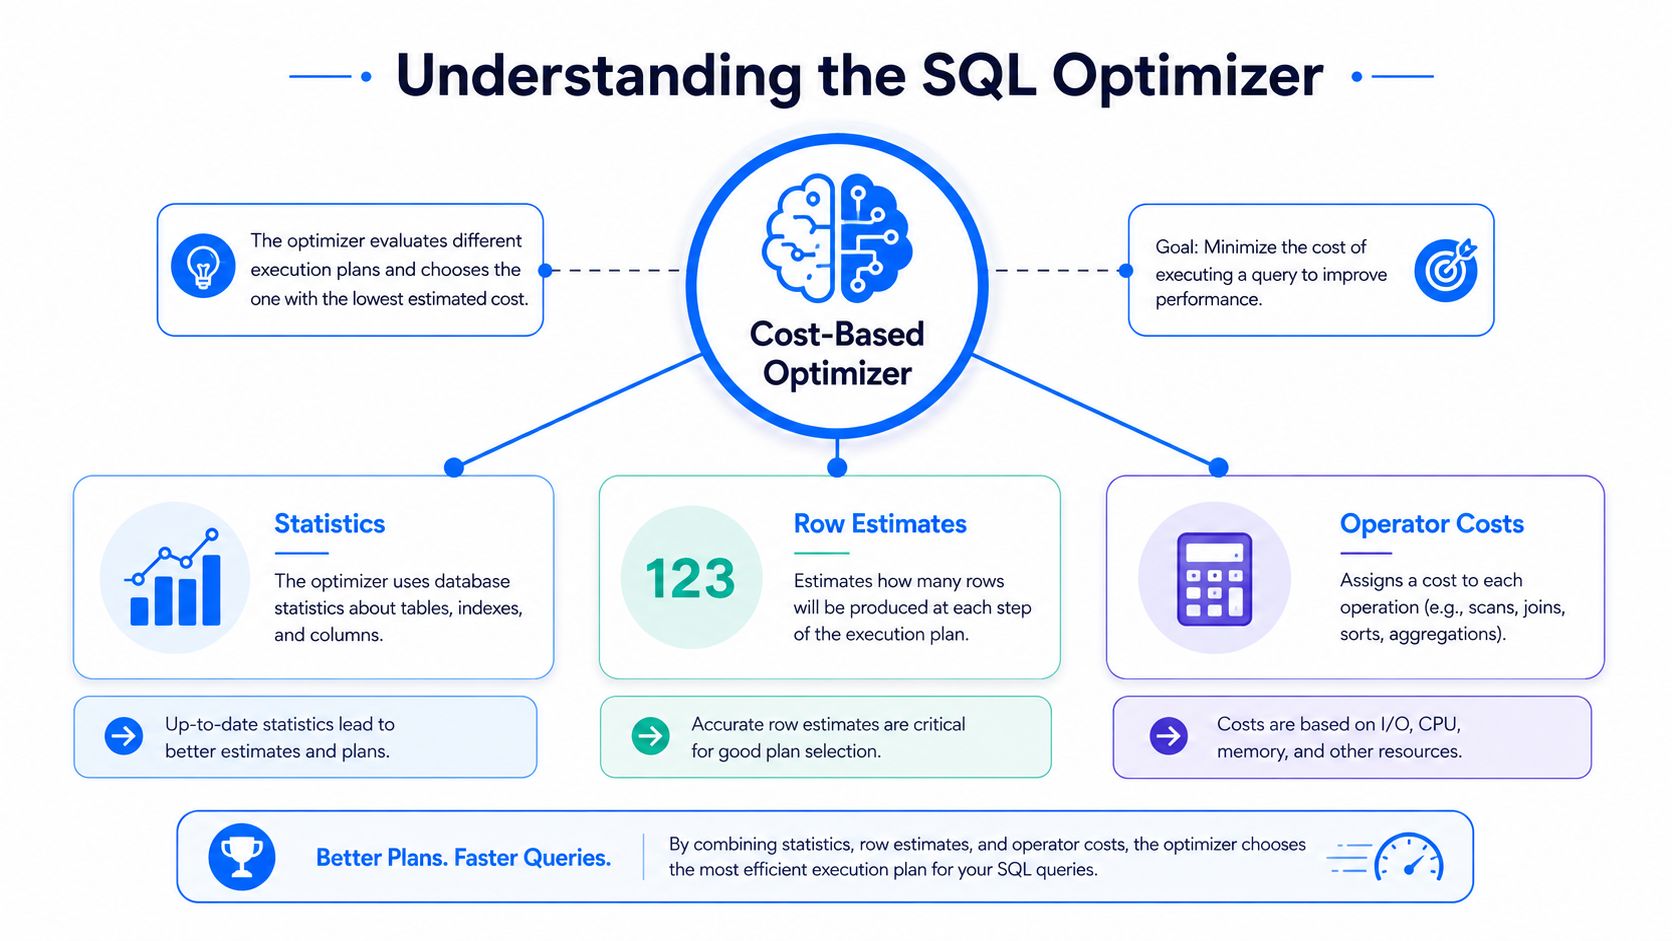
Une mauvaise requête semble souvent correcte dans l'éditeur de texte et s'effondre pourtant à l'exécution. SQL Server n'exécute pas les instructions dans l'ordre où elles sont écrites. L'optimiseur est basé sur les coûts et guidé par les statistiques, il évalue donc les plans possibles, estime le nombre de lignes et choisit le chemin qu'il estime être le moins coûteux (cost-based optimizer overview). Dans la tsql query optimization, cela fait de la lecture des plans la première véritable compétence de diagnostic, et non une réflexion après coup.
Lire le plan à partir des feuilles vers le haut
Commencez par les feuilles, pas par la racine. Les opérateurs de feuilles montrent où les lignes entrent dans le plan, et la feuille la plus coûteuse, souvent celle qui présente le coût boucles-fois-temps le plus élevé, indique généralement le premier endroit où le plan échoue. Si un scan alimente une jointure puis un tri, le scan est souvent le problème principal même lorsque le tri domine le temps écoulé.
Cette habitude de lecture devient plus utile lorsque vous la connectez aux entrées de l'optimiseur. DBCC SHOW_STATISTICS expose les statistiques que SQL Server utilise pour une table ou une vue indexée, y compris STAT_HEADER, DENSITY_VECTOR et HISTOGRAM (Microsoft documentation). Ces objets sont importants car l'optimiseur fait son estimation de cardinalité avant de fixer un plan. Les informations de densité sont particulièrement utiles pour les filtres multi-colonnes sur la même table, là où l'intuition simple du nombre de lignes fait souvent défaut.
Si le plan semble suspect, je le compare à une liste de contrôle d'optimisation pratique telle que how to optimize SQL queries with execution plan analysis. Ce type d'étape permet de garder l'examen ancré dans les opérateurs réels, et non dans de simples conjectures sur le texte de la requête.
Lignes estimées par rapport aux lignes réelles
La première chose que je vérifie dans un mauvais plan est l'écart entre les lignes estimées et réelles. Lorsque ces chiffres divergent fortement, l'optimiseur travaille à partir d'une image déformée, et le reste du plan est généralement construit sur cette erreur. Un article de la VLDB 2025 a révélé que les erreurs d'estimation de cardinalité sont répandues et constituent souvent le facteur dominant des plans médiocres (VLDB 2025 paper), ce qui correspond à ce qui apparaît en production lorsque des distributions asymétriques ou des prédicats corrélés poussent le moteur vers une mauvaise méthode de jointure ou d'accès.
Si l'optimiseur pense que 10 lignes arrivent alors qu'il en arrive réellement 10 000, le plan n'est pas légèrement erroné, il résout le mauvais problème.
C'est également pourquoi les statistiques obsolètes méritent une attention précoce. Des statistiques fraîches ne garantissent pas un plan parfait, mais des statistiques obsolètes rendent une mauvaise estimation beaucoup plus probable. Pour les tables optimisées en mémoire, Microsoft note que l'optimiseur conserve des statistiques sur les colonnes clés d'index et peut créer des statistiques supplémentaires sur les colonnes non clés si nécessaire, de sorte que ces charges de travail dépendent toujours de la même image de cardinalité.
Réécrire des requêtes avec des modèles basés sur les ensembles et un filtrage précoce
Une fois que le goulot d'étranglement est réel et visible, réécrivez le SQL avec un objectif précis. Les modifications à plus forte valeur ajoutée sont généralement celles qui réduisent la quantité de données que le moteur doit traiter, et non celles qui rendent la requête élégante. Filtrer tôt, projeter moins de colonnes et garder des prédicats sargables aident l'optimiseur à utiliser les index plus efficacement et réduisent la pression sur les E/S et la mémoire (optimization techniques guide).
Faire en sorte que le moteur touche moins de données
Les victoires les plus simples sont souvent celles que les équipes négligent parce qu'elles semblent trop basiques. Évitez SELECT * lorsque la requête n'a pas besoin de toutes les colonnes, car les colonnes projetées supplémentaires élargissent les lignes et augmentent les E/S. Placez des filtres sélectifs dans la clause WHERE avant les jointures lorsque vous le pouvez, car cela réduit le volume de jointure que le moteur doit transporter à travers le reste du plan.
Quelques schémas comptent systématiquement :
Utiliser des prédicats sargables. Si le prédicat ne peut pas être mis en correspondance efficacement avec un index, l'optimiseur a moins de marge de manœuvre.
Préférer
UNION ALLlorsque les doublons n'ont pas besoin d'être supprimés.UNIONajoute un travail de tri ou de déduplication.Élaguer les sous-requêtes qui ne font que reformater les données. Une logique imbriquée qui ne réduit pas les lignes ajoute souvent de la surcharge sans aider le plan.
Faire correspondre les index aux filtres réels. Un index ciblé est utile lorsqu'il s'aligne sur le chemin d'accès utilisé par la requête.
Une bonne réécriture réduit le travail que l'optimiseur doit envisager, et non seulement les lignes de SQL que vous devez lire.
Utiliser les objectifs de lignes (row goals) et les indices avec retenue
Microsoft documente des indices de requête qui peuvent modifier le comportement d'exécution, y compris le comportement de l'objectif de lignes, où après le retour du premier nombre spécifié de lignes, la requête continue de s'exécuter pour produire l'ensemble des résultats (query hints documentation). Cela peut être utile lorsque la rapidité de la sortie initiale importe plus que le débit total, mais cela modifie le compromis de l'optimiseur. Un plan excellent pour un très petit ensemble de résultats peut s'avérer un mauvais choix pour un ensemble volumineux.
C'est pourquoi je traite les indices comme une correction de dernier recours, et non comme une première réponse. Si la requête traîne encore après un filtrage précoce et un nettoyage basé sur les ensembles, la question suivante est généralement de savoir si le chemin d'accès lutte contre la forme des données ou les statistiques sous-jacentes.
Conception d'index et stratégies de maintenance des statistiques
Les index ne sont pas des commutateurs de performance magiques. Ce sont des entrées pour le modèle de coût de l'optimiseur, et ils ne sont utiles que s'ils correspondent au modèle de requête et à la distribution des données. Si le chemin d'accès ne correspond pas à la façon dont la requête filtre, joint ou projette les colonnes, le moteur peut toujours choisir un scan, un plan lourd en recherches (lookups) ou un tri sujet aux débordements (spills).
Concevoir pour la requête que vous exécutez réellement
Le meilleur index en théorie et le meilleur index en production sont rarement les mêmes. En pratique, vous voulez des index qui correspondent aux modèles d'accès les plus coûteux et reproductibles, en particulier les filtres qui apparaissent dans vos requêtes les plus lentes. Un index couvrant (covering index) peut éliminer les recherches de clés (key lookups) lorsque la requête nécessite un ensemble de colonnes restreint et stable, mais il peut également ajouter une surcharge d'écriture et un coût de stockage ; la conception nécessite donc une charge de travail réelle, pas une supposition.
Le modèle statistique de Microsoft est important ici car l'optimiseur estime la cardinalité à partir de ces objets avant de sélectionner un plan (DBCC SHOW_STATISTICS). Si les statistiques sont obsolètes, même un index bien construit peut être ignoré ou mal utilisé. C'est pourquoi une bonne conception d'index et une bonne maintenance des statistiques vont de pair.
Garder des statistiques assez fraîches pour s'y fier
La maintenance des statistiques n'est pas une simple tâche ménagère, elle fait partie de la qualité du plan. Lorsque la distribution des lignes change, l'optimiseur peut toujours penser que la table ressemble à ce qu'elle était hier ou le mois dernier, et cette image obsolète peut entraîner de mauvais choix de jointures, des méthodes d'accès médiocres et une utilisation inattendue de la mémoire. Pour les tables optimisées en mémoire, Microsoft gère toujours les statistiques sur les colonnes de clés d'index et peut en ajouter d'autres sur les colonnes non-clés si nécessaire, ce qui montre à quel point les statistiques restent centrales à travers les modèles de stockage.
Une posture de maintenance pratique est simple :
Mettre à jour les statistiques lorsque les plans régressent. N'attendez pas que le problème devienne systémique.
Surveiller les modèles répétés de recherche de clés (key lookup). Ils montrent souvent où un index couvrant serait utile.
Utiliser les reconstructions (rebuilds) et les réorganisations pour une bonne raison. La maintenance doit soutenir la charge de travail, et non se faire en pilote automatique.
Examiner régulièrement l'utilisation des index. Un index qui semblait judicieux il y a six mois peut être un poids mort aujourd'hui.
Les suggestions d'index manquants peuvent vous aider à repérer des lacunes évidentes, mais elles ne constituent pas une stratégie de conception en soi. Je les traite comme des indices, puis je les compare à la charge de travail et au coût de maintenance. L'optimiseur ne peut choisir qu'à partir des formes que vous lui donnez, et des statistiques obsolètes peuvent faire paraître mauvaise même une bonne forme.
Résoudre les défis de reniflage de paramètres (parameter sniffing) et de forçage de plan
Certaines des pires surprises en production ne concernent pas du tout le texte de la requête. Elles se produisent parce qu'une même procédure stockée obtient des plans très différents selon la première valeur de paramètre vue par l'optimiseur, et ce plan est ensuite réutilisé pour des appels ultérieurs qui ne correspondent pas à la forme d'origine. C'est pourquoi le comportement des plans sensibles aux paramètres (parameter-sensitive plan behavior) figure en tête de tout guide sérieux sur la tsql query optimization.
Quand le plan mis en cache est le problème
Les conseils de Microsoft sur Azure SQL mentionnent explicitement RECOMPILE, OPTIMIZE FOR, OPTIMIZE FOR UNKNOWN, le forçage de plan et le fractionnement de procédures comme remèdes ciblés lorsqu'une requête est performante pour certaines valeurs de paramètres et médiocre pour d'autres (Microsoft training guidance). Cela est important car le texte de la requête peut être correct, mais le plan mis en cache peut être inadapté à la charge de travail actuelle.
Le symptôme pratique est bien connu. La procédure fonctionne à merveille pour un client, ralentit pour un autre, et oscille de l'un à l'autre après des modifications du cache ou des redémarrages. Dans ce cas, le problème d'optimisation consiste réellement à contrôler la variabilité du plan, et non à réécrire une requête parfaitement lisible en quelque chose d'impossible à maintenir.
Choisir le remède qui correspond au mode de défaillance
RECOMPILE est utile lorsque la requête a besoin d'un plan adapté aux paramètres actuels et que la surcharge est acceptable. OPTIMIZE FOR est préférable lorsque vous connaissez une valeur représentative et souhaitez orienter le plan vers celle-ci. OPTIMIZE FOR UNKNOWN peut être une voie intermédiaire plus sûre lorsqu'aucune valeur de paramètre unique ne reflète bien la charge de travail. Le forçage de plan aide lorsque vous avez déjà identifié une forme de plan qui se comporte de manière fiable.
La bonne solution pour le reniflage de paramètres n'est pas toujours un meilleur index. C'est parfois un choix de plan plus honnête.
Les contrôles opérationnels plus récents sont également importants. Les conseils modernes de Microsoft incluent DISABLE_RESULT_SET_CACHE, ce qui montre que l'optimisation des requêtes doit désormais tenir compte du comportement du cache ainsi que de l'indexation et des réécritures. C'est un rappel utile que les performances incohérentes sont souvent liées à l'interaction entre les données, le cache et les valeurs de paramètres, et non pas seulement au SQL lui-même.
Traiter la pression mémoire et les contraintes de ressources de la plateforme
Une requête peut être bien écrite, correctement indexée et pourtant lente. Lorsque cela se produit, le goulot d'étranglement est souvent lié à la pression mémoire, aux comportements de débordement sur disque (spill-to-disk) ou à des limites de plateforme plus larges plutôt qu'au texte de la requête lui-même. De nombreux guides d'optimisation passent rapidement sur cette réalité, même si c'est souvent la raison pour laquelle une requête « corrigée » déçoit toujours.
Séparer le coût de la requête locale de la pression sur les ressources partagées
Commencez par l'analyse des attentes et la surveillance des ressources avant de blâmer une seule instruction. Une requête qui déborde sur le disque, rivalise pour obtenir des allocations de mémoire ou se heurte à des contentions sur tempdb peut ressembler à une mauvaise candidate à la réécriture, alors que le problème profond est la pression sur le système. Les conseils de Microsoft sur le traitement des requêtes et l'observabilité d'Azure SQL orientent vers des outils tels que la surveillance des ressources, Database Watcher, Query Performance Insights et les mesures de capacité Fabric pour voir si la charge de travail est limitée par la plateforme elle-même (platform observability guidance).
Si l'ensemble de l'instance est sous pression, une réécriture SQL locale peut sembler inefficace même si elle fait exactement ce qu'elle doit faire.
C'est pourquoi les types d'attente (wait types) sont importants. Ils indiquent si le goulot d'étranglement est une saturation du processeur, un délai d'E/S, des bloqueurs de concurrence ou tout autre chose. Une requête qui réduit les lectures logiques mais continue de déborder peut améliorer un indicateur tout en laissant l'expérience utilisateur presque inchangée.
Escalader vers la planification de la capacité quand la charge de travail l'exige
À un certain stade, l'optimisation des requêtes cesse d'être le bon levier. Si la charge de travail continue de lutter contre les limites de mémoire, de stockage ou de concurrence, la solution peut résider dans la planification de la capacité, l'isolation de la charge de travail ou la refonte de la plateforme plutôt que dans une énième réécriture. C'est la différence pratique entre la résolution d'un problème au niveau d'une instruction et la résolution d'un problème au niveau du système.
Pour les équipes travaillant dans des environnements gérés, cette distinction importe encore plus car la plateforme peut masquer une partie de la pression sous-jacente jusqu'à ce que la charge de travail devienne bruyante. Si vos corrections continuent de réduire légèrement le coût de la requête mais que les utilisateurs ressentent toujours le ralentissement, la question suivante n'est pas de savoir quel SQL modifier, mais quelle ressource partagée est encore saturée. C'est également là qu'une approche d'ingénierie de la fiabilité des bases de données est utile, car elle lie le comportement des requêtes à des contrôles opérationnels reproductibles et évite que les régressions liées à la mémoire soient traitées comme des surprises ponctuelles. Voir les database reliability engineering practices pour le modèle opérationnel plus large derrière ce type de travail.
Mettre en œuvre une surveillance continue avec l'Observability en base de données
Une optimisation ponctuelle est utile, mais elle n'empêche pas la prochaine régression. Les données augmentent, les distributions changent, les charges de travail dérivent, et le plan qui fonctionnait le trimestre dernier peut mal vieillir sans avertissement. C'est pourquoi la surveillance continue est le seul moyen raisonnable d'éviter que la performance des requêtes ne devienne une gestion de crise permanente.
Surveiller les dérives avant les utilisateurs
Le changement utile consiste à passer de la réaction à la détection. Les plateformes d'observabilité en base de données peuvent surveiller les mesures de performance des requêtes, les changements de modèles d'exécution et les signaux de ponctualité sans déplacer les données hors de l'environnement, ce qui est important lorsque les règles de sécurité ou de governance rendent le déplacement des données coûteux ou indésirable. La Data Platform Observability de digna est un exemple de ce modèle, avec une surveillance qui reste à l'intérieur de l'environnement du client et suit la santé de la charge de travail, les modèles de consommation et les mesures liées aux performances à travers l'environnement de données (digna data observability).
Ce type de surveillance basé sur des références est précieux car il détecte les comportements anormaux avant que le tableau de bord n'échoue ou que l'accord de niveau de service (SLA) ne soit manqué. Le but n'est pas de remplacer l'optimisation, mais de la rendre proactive plutôt que réactive.
Utiliser l'observability pour boucler la boucle
La surveillance continue permet de pérenniser le flux de diagnostic précédent. Au lieu de diagnostiquer un ralentissement une seule fois et de l'oublier, les équipes peuvent comparer les nouveaux comportements avec l'ancien plan, détecter les régressions rapidement et maintenir la charge de travail proche de la référence éprouvée en production. digna publie également un guide de SQL query optimisation qui s'aligne sur ce modèle, en se concentrant sur les paramètres réels, les plans d'exécution, les nœuds goulots d'étranglement, le rafraîchissement des statistiques et la comparaison des plans.
C'est la partie que j'apprécie sur le plan opérationnel. Les corrections au niveau des requêtes sont réelles, mais elles se détériorent à moins que quelqu'un ne continue à surveiller la charge de travail après le déploiement du changement. L'observabilité transforme cela en une routine, et non en une mission de sauvetage.
Si vous faites face à une procédure stockée lente, à un plan qui ne cesse de changer ou à une requête qui semblait corrigée jusqu'à ce que les données évoluent à nouveau, visitez digna et évaluez si l'observability en base de données peut vous apporter la référence, la détection d'anomalies et la surveillance de la charge de travail dont vous avez besoin pour maintenir des performances stables. Le bon processus d'optimisation ne s'arrête pas à la réécriture, il continue à surveiller le système afin que la prochaine régression ne surprenne pas votre équipe.


