Formats de fichiers Parquet : structure, réglage et bonnes pratiques
|
12
minute de lecture

Votre tableau de bord BI est encore lent. Le traitement nocturne a déposé un nouveau tas de fichiers CSV dans le stockage objet, quelqu'un a ajouté quelques colonnes sans prévenir, et la seule requête qui intéresse le métier mâche désormais bien plus de données que le résultat ne le justifie.
C'est en général le moment où les formats de fichiers Parquet cessent de ressembler à un choix d'extension pour devenir une décision d'architecture. Si votre équipe fait tourner Spark, DuckDB, Trino, BigQuery, des modèles dbt ou des pipelines lakehouse, Parquet se trouve au cœur de votre histoire de fiabilité et de coût. Le problème est que la plupart des explications s'arrêtent à « Parquet est orienté colonnes », ce qui est vrai mais incomplet.
Ce qui compte en pratique, c'est la façon dont Parquet dispose les données sur le disque, quels encodages aident, quels changements de schéma sont sûrs et ce qui évolue encore dans le format lui-même. En 2026, Parquet n'est pas figé. De nouveaux types logiques et encodages continuent d'arriver, et la prise en charge atterrit de façon inégale selon les moteurs. C'est là que les équipes de production se font piéger.
Sommaire
Pourquoi les formats de fichiers Parquet existent pour l'analytique moderne
À l'intérieur d'un fichier Parquet : des row groups aux pages
Encodages et codecs de compression qui font vraiment la différence
Pourquoi les formats de fichiers Parquet existent pour l'analytique moderne
CSV est simple à produire et pénible à analyser à grande échelle. Si une requête de tableau de bord n'a besoin que de price, region et event_date, un lecteur CSV doit tout de même parser chaque champ de chaque ligne rien que pour atteindre ces colonnes. Le format ignore où les valeurs d'une colonne résident sous forme de bloc contigu, et il ne porte pas assez de métadonnées pour écarter proprement les fragments non pertinents.
Parquet corrige cela en stockant les données par colonne plutôt que par ligne. Il stocke aussi des métadonnées qui évitent du travail inutile aux lecteurs. Les présentations modernes du format notent que ces choix de conception rendent couramment les fichiers Parquet 5 à 10 fois plus petits que CSV et 10 à 100 fois plus rapides à interroger sur des charges analytiques, un exemple de benchmark montrant un fichier Parquet-Zstd de 164 Mo contre 1,09 Go pour CSV sur un jeu de 11,2 millions de lignes, et certaines requêtes de comptage environ 160 fois plus rapides lorsque les métadonnées seules peuvent y répondre (explication du format Parquet par MotherDuck).
Pourquoi la disposition en colonnes change tout
Quand les valeurs d'une même colonne sont regroupées, les moteurs peuvent faire trois choses utiles :
Lire moins d'octets : une requête qui a besoin de trois colonnes n'a pas à traîner les autres sur le réseau et dans le parseur.
Mieux compresser : les valeurs similaires se regroupent au sein d'une colonne, si bien que les encodages dictionnaire, run-length et delta deviennent efficaces.
Écarter des blocs entiers : Parquet stocke les métadonnées de minimum, maximum et nombre de valeurs nulles dans le pied de page, ce qui permet aux lecteurs d'écarter des row groups avant de les décoder.
Voilà pourquoi Parquet est devenu le format par défaut du stockage analytique plutôt que du traitement transactionnel. Il est optimisé pour les analyses, les agrégations, le filtrage et la projection.
Règle pratique : si les gens interrogent surtout des sous-ensembles de colonnes et parcourent de grands jeux de données, les formats texte orientés lignes luttent contre la charge de travail.
Ce que les ingénieurs doivent encore décider
Parquet ne supprime pas les choix de conception. Il les déplace.
Une équipe de production doit encore répondre à des questions sur la taille des row groups, les codecs par défaut, la disposition des pages, la prise en charge des versions et l'évolution du schéma. Ce ne sont pas des cas limites. Ils touchent directement le coût des analyses, l'interopérabilité et la capacité des lecteurs en aval à survivre à un changement de pipeline.
Si vous concevez un stockage lakehouse ou revoyez les formats d'extraction de votre entrepôt, c'est ici que les décisions d'architecture des systèmes de données cessent d'être abstraites. Le comportement du format façonne la latence des requêtes, l'efficacité du stockage et les modes de défaillance en exploitation.
L'histoire des origines et pourquoi elle compte encore
Une bonne part des douleurs de production autour de Parquet commence par une fausse hypothèse : qu'il s'agirait d'une simple extension neutre traitée de la même façon par tous les moteurs. Ce n'est pas le cas. Parquet est né d'un problème analytique précis, et ces choix de conception d'origine expliquent encore ses forces comme ses modes de défaillance.
Parquet a démarré en 2013 comme un effort conjoint de Twitter et Cloudera. La version 1.0 a été annoncée le 30 juillet 2013, alors que le projet comptait déjà plus de 90 pull requests fusionnées, ce qui montre la vitesse à laquelle le format prenait forme dans ses premiers mois (annonce de Parquet 1.0 par l'ingénierie de Twitter).

À l'époque, les équipes de l'ère Hadoop affrontaient des jeux de données larges, de longs temps d'analyse et des factures de stockage qui croissaient plus vite que les budgets. Parquet a été bâti pour cet environnement. Stocker les valeurs par colonne, compresser ensemble les valeurs similaires et donner aux moteurs assez de métadonnées pour éviter du travail. Cela paraît banal aujourd'hui parce que toute équipe lakehouse s'y attend. En 2013, cela réglait un goulot d'étranglement très coûteux.
Le projet est ensuite devenu projet de premier niveau de l'Apache Software Foundation le 27 avril 2015. C'est important car les formats de fichiers vivent ou meurent selon la prise en charge des lecteurs. Dès lors que plusieurs moteurs, entrepôts et formats de table ont misé sur Parquet, la compatibilité est devenue aussi importante que le taux de compression brut.
Les paris initiaux se voient encore en 2026
Deux décisions de conception prises au départ façonnent encore de vrais pipelines.
D'abord, Parquet a été optimisé pour les analyses analytiques, pas pour les recherches ponctuelles. Un fichier Parquet fonctionne comme un entrepôt organisé par type de produit plutôt que par commande client. Si vous avez besoin de toutes les valeurs d'une colonne sur 500 millions de lignes, cette disposition est efficace. Si vous cherchez une ligne précise au milieu, elle est maladroite. Les équipes s'attirent encore des ennuis en utilisant Parquet pour du rejeu d'événements, des API opérationnelles ou des charges exigeant un accès rapide à un enregistrement unique.
Ensuite, Parquet a rendu les fichiers autodescriptifs. Le schéma et les métadonnées de row group résident dans le pied de page, si bien que les lecteurs peuvent découvrir la structure sans dépendre d'un service de schéma séparé. Cette portabilité explique largement la diffusion de Parquet dans Spark, Hive, Trino, DuckDB, les tables externes Snowflake et les piles lakehouse.
Cela crée aussi un tranchant. Si le pied de page est endommagé, le fichier peut devenir illisible même si les pages de données restent intactes dans le stockage objet. Le format le rend explicite. Les fichiers se terminent par le nombre magique PAR1, et la longueur des métadonnées est stockée sous forme d'entier little-endian de 4 octets dans le pied de page, ce qui indique aux lecteurs où commencent le schéma et les métadonnées de row group (documentation du format de fichier Apache Parquet).
Ce détail paraît bas niveau, mais il pèse en exploitation. Un envoi tronqué, une écriture multipart échouée ou un travail de réécriture bogué peut transformer un pied de page abîmé en fichier illisible. Dans un jeu partitionné, cela apparaît souvent comme une journée manquante, un backfill cassé ou une requête qui échoue seulement pour un segment de clients. Pour les équipes qui travaillent sur les pratiques de qualité et de fiabilité des données en lakehouse, c'est l'une des raisons pour lesquelles la validation des fichiers appartient au pipeline et non au post-mortem.
L'histoire des origines aide aussi à comprendre ce que Parquet ne résout toujours pas par défaut. Le gain initial était évident sur les valeurs répétées, les dimensions à faible cardinalité et l'analytique gourmande en analyses. En 2026, les cas plus difficiles attirent davantage l'attention : colonnes de chaînes à forte cardinalité comme les URL ou les identifiants utilisateur, mesures en virgule flottante qui ne se compressent pas proprement, et changements de schéma qui se valident techniquement tout en cassant les lecteurs en aval. Ce ne sont pas des signes d'échec de Parquet. Ce sont des rappels que le format a été conçu comme une fondation, non comme la garantie que tout jeu de données obtiendra bonne taille, bonne vitesse et bonne compatibilité à partir des seuls réglages par défaut.
À l'intérieur d'un fichier Parquet : des row groups aux pages
Une requête de production est lente sur une partition et rapide sur les 364 autres jours de la table. La raison habituelle n'est pas « Parquet est lent ». C'est que le fichier a été disposé de façon à forcer le moteur à lire bien plus d'octets que la requête n'en demandait.
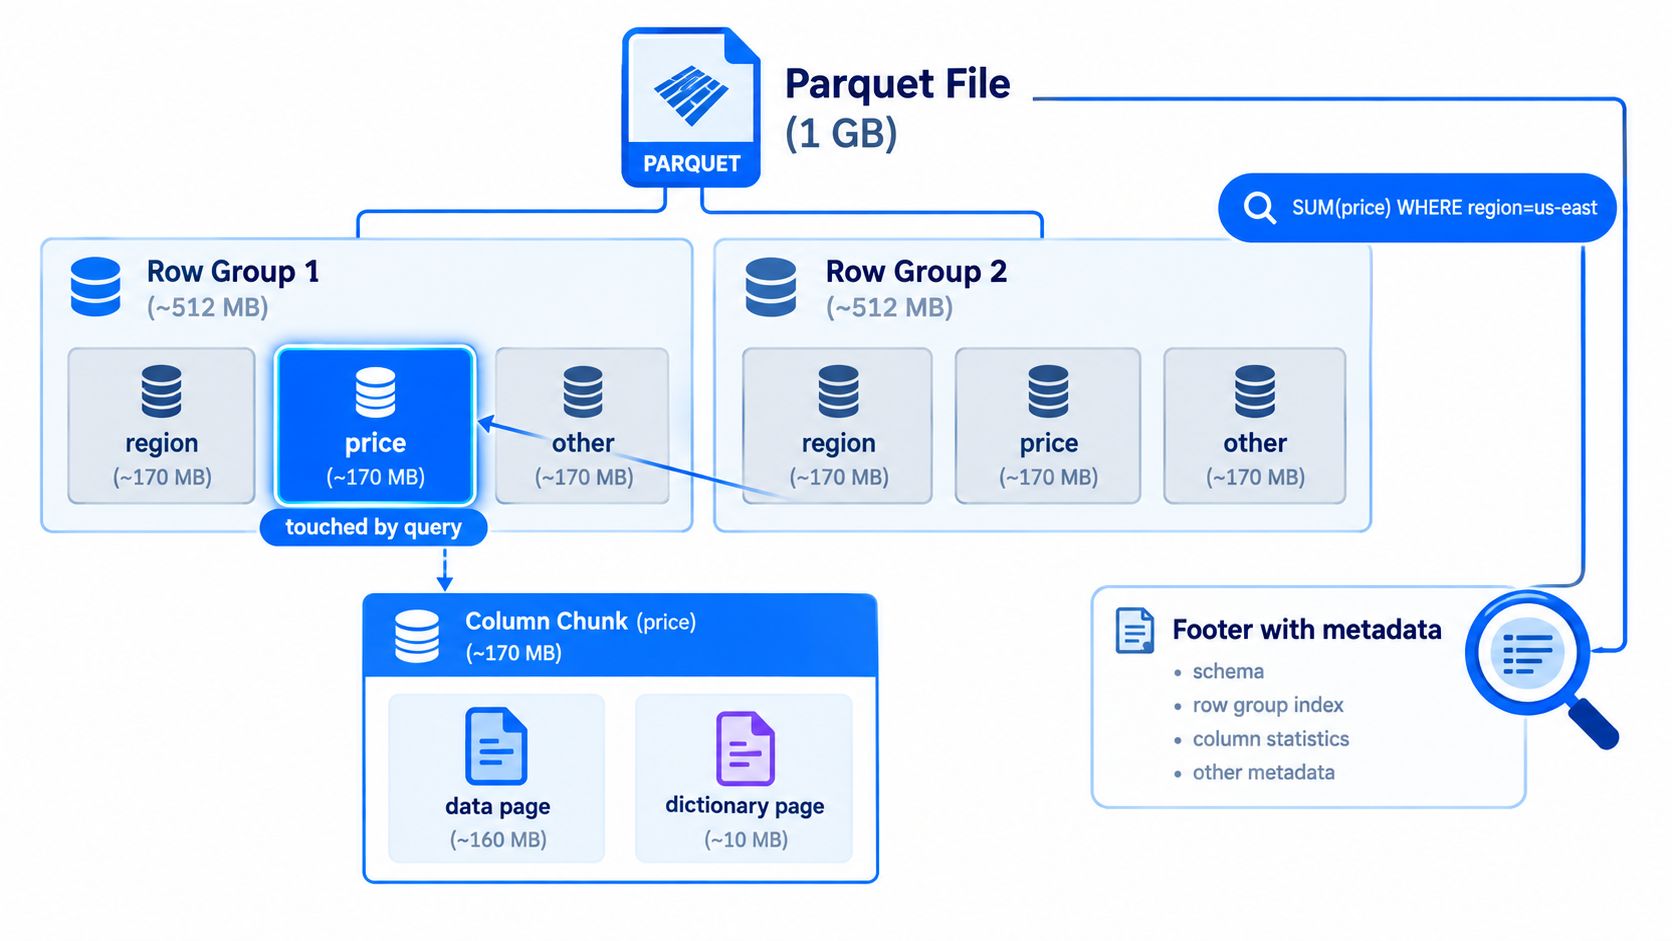
Parquet s'éclaire dès qu'on se représente sa disposition de stockage comme des conteneurs imbriqués. Un fichier contient des row groups. Chaque row group contient un column chunk par colonne. Chaque column chunk est découpé en pages. Cette hiérarchie permet aux moteurs de lire price sans toucher à comment_text, ou d'écarter des blocs de données incapables de satisfaire un filtre. La documentation du page index de Parquet décrit la structure et les métadonnées optionnelles plus fines utilisées pour écarter des pages (documentation du page index Parquet).
Commencer au niveau du row group
Si vous venez d'un état d'esprit row store, le row group aide à recadrer le modèle. C'est une tranche horizontale de la table, mais stockée par colonne à l'intérieur de cette tranche.
Supposons qu'un fichier contienne les colonnes region, price et event_date. Un row group contiendra trois column chunks : un pour region, un pour price et un pour event_date. Les valeurs ne sont pas rangées ligne par ligne. Elles le sont en trois suites de données distinctes au sein de ce row group. C'est pourquoi une requête qui n'a besoin que de price peut éviter de lire les octets des deux autres colonnes.
Pour l'analytique gourmande en analyses, les row groups sont la première unité utile de parallélisme et d'évitement. C'est aussi là que débutent beaucoup d'arbitrages d'exploitation. Un row group trop petit crée des métadonnées superflues et trop de lectures minuscules. Un row group trop grand peut amener les requêtes sélectives à lire plus de données que nécessaire, et rend les reprises et réécritures plus coûteuses en stockage objet.
Puis zoomer sur les pages
Les pages sont les blocs plus petits à l'intérieur de chaque column chunk. L'encodage et la compression se font à ce niveau.
Ce détail paraît mécanique mais touche de vraies charges. Une colonne de chaînes longues à forte cardinalité, comme des URL, des identifiants d'appareil ou des jetons de session, semble souvent correcte au niveau du fichier et se compresse pourtant mal page après page. Le même schéma se retrouve avec des mesures en virgule flottante qui se répètent peu et répondent mal aux encodages par défaut. En 2026, ces deux cas restent ceux où les équipes découvrent que « stocké en Parquet » ne veut pas dire automatiquement « petit et rapide ».
Un modèle mental utile est l'entrepôt. Le fichier est le bâtiment. Les row groups sont les allées. Les column chunks sont les rayonnages d'un type de produit dans une allée. Les pages sont les cartons sur chaque rayonnage. Une requête devrait ouvrir le moins de cartons possible.
Ce que fait réellement un lecteur
Un lecteur commence par les métadonnées du pied de page, puis décide quels row groups et quelles colonnes valent la peine d'être ouverts. Si une requête demande SUM(price) avec region = 'us-east', le moteur peut souvent inspecter les statistiques de row group pour region et écarter ceux dont les valeurs ne peuvent pas correspondre. S'il ne lui faut que price, il peut aussi éviter de lire les autres column chunks de ces row groups.
C'est le scénario idéal.
La nuance est que l'évitement dépend de la distribution des données et du comportement de l'écrivain. Si les lignes sont mélangées au hasard et que chaque row group contient toutes les region, les statistiques de minimum et de maximum aident moins. Si une colonne de chaînes est non triée et très unique, les frontières de pages peuvent contenir assez de variation pour que l'évitement au niveau page n'apporte pas grand-chose. Le format fournit la mécanique, mais la disposition de vos données détermine si cette mécanique économise du travail.
Pourquoi les métadonnées de page comptent davantage aujourd'hui
Les métadonnées de page comptent parmi les évolutions les plus intéressantes pour les systèmes de production, car elles peuvent réduire les lectures gaspillées à l'intérieur d'un row group et pas seulement entre row groups. Cela pèse à mesure que les fichiers grossissent et que les filtres sélectifs se généralisent.
C'est aussi inégal en pratique. Certains moteurs écrivent ces métadonnées, d'autres les lisent, d'autres les ignorent. L'erreur d'exploitation consiste à présumer la prise en charge parce que la spécification inclut la fonctionnalité. Les équipes qui font évoluer leur pile en 2026 devraient vérifier le comportement avec leurs moteurs réels et leurs chemins de stockage cloud, en particulier dans les parcs mixtes qui écrivent avec Spark et interrogent avec DuckDB, Trino ou des lecteurs d'entrepôt.
Les recommandations de configuration face au terrain
Les recommandations de configuration Parquet préconisent de grands row groups et de petites pages, avec des exemples comme des row groups de 512 Mo à 1 Go et des pages de 8 Ko, ainsi que des hypothèses de disposition alignées sur HDFS (recommandations de configuration Parquet).
Ces chiffres sont utiles comme orientation du format, pas comme réglages universels.
Sur du stockage objet, le choix pratique dépend souvent de la concurrence des lecteurs, de la taille des partitions, du coût des reprises et de la forme de vos prédicats. Une table de faits batch parcourue de bout en bout peut profiter de row groups plus grands. Un jeu frappé par des filtres sélectifs de client ou de temps fonctionnera peut-être mieux avec un autre équilibre. L'erreur fréquente est de recopier les valeurs par défaut d'un moteur ou d'un système de stockage vers un autre en espérant le même comportement.
Gardez cette hiérarchie en tête :
Fichier : l'objet stocké dans S3, GCS, ADLS ou HDFS
Row group : une tranche horizontale de lignes, et l'unité principale d'évitement grossier
Column chunk : les données d'une colonne à l'intérieur d'un row group
Page : le bloc qui est encodé, compressé et parfois écarté grâce à des métadonnées plus fines
Si vous comprenez ces quatre couches, Parquet cesse de paraître opaque. Il devient un ensemble de décisions de stockage que vous pouvez inspecter, mesurer et ajuster.
Parquet version 1 face à la version 2 en pratique
La spécification Parquet a évolué au fil de plusieurs versions, et la question utile est de savoir quelles capacités vos lecteurs et écrivains prennent en charge.
Parquet v2 a apporté plus qu'un nouveau label. Il a étendu la gestion des données imbriquées, la représentation des valeurs nulles et les métadonnées permettant un évitement plus fin. La structure du fichier reste familière, mais la prise en charge des capacités récentes atterrit de façon inégale selon les moteurs, si bien qu'« écrire en v2 » peut être un bon réglage par défaut ou un piège d'interopérabilité selon votre parc.
La matrice de capacités qui compte
Capacité | Parquet v1 | Parquet v2 | Fiable en 2026 ? |
|---|---|---|---|
Disposition en colonnes de base | Oui | Oui | Oui |
Statistiques min/max/nulls du pied de page au niveau row group | Oui | Oui | Oui |
Prise en charge des données imbriquées avec niveaux de répétition et de définition | Prise en charge dans la famille du format | Poursuivie et largement utilisée | Généralement oui, mais vérifiez le comportement du lecteur sur les schémas complexes |
Statistiques de page via le page index | Non | Oui | Seulement si votre moteur les prend en charge et les utilise explicitement |
Meilleure gestion des valeurs nulles dans les formats de page récents | Limitée | Meilleure prise en charge | Souvent oui, mais cela dépend du moteur |
Fonctionnalités optionnelles récentes comme les filtres de Bloom | Non | Disponible dans l'écosystème | Non, auditez d'abord la prise en charge des lecteurs |
Ce sur quoi vous pouvez compter sans risque
Si vous écrivez des fichiers pour des environnements mixtes incluant Spark, DuckDB, Trino et BigQuery, les hypothèses les plus sûres restent les fondamentaux : projection de colonnes, statistiques de row group, encodages standard et codecs de compression répandus.
Ce qui n'est pas universellement sûr, c'est tout ce qui dépend de métadonnées optionnelles récentes ou de fonctionnalités fraîchement spécifiées. Cette prudence compte d'autant plus que Parquet continue d'évoluer. En 2026, le projet a publié Parquet 2.14.0 et mis en avant les travaux sur le type logique FILE, l'encodage adaptatif sans perte pour la virgule flottante (ALP) et une meilleure gestion de l'ordre des horodatages. Le projet précise aussi que le déploiement est échelonné, ALP étant marqué « in preview » le temps que les implémentations rattrapent leur retard (blog du format Apache Parquet).
Règle de compatibilité : écrivez pour le lecteur le plus ancien que vous ne contrôlez pas.
C'est la bonne grille de lecture. Pour de nouveaux pipelines, v2 est généralement la meilleure cible d'écriture. Mais avant de vous appuyer sur des métadonnées de page récentes, une sémantique d'horodatage avancée ou des encodages en préversion, auditez chaque moteur qui lira les fichiers. Si votre équipe utilise Databricks ou des lecteurs lakehouse mixtes, les contrôles de qualité des données sur Databricks font partie de la conversation sur le format, car les problèmes de compatibilité surgissent souvent comme des incidents de qualité en aval plutôt que comme des erreurs de lecture évidentes.
Encodages et codecs de compression qui font vraiment la différence
Un fichier Parquet devient petit en deux étapes distinctes, et l'optimisation en production se simplifie dès qu'on garde ces étapes séparées.
D'abord, Parquet encode une colonne dans une forme adaptée à la nature des données. Ensuite, un codec de compression s'applique aux octets obtenus. Si vous sautez cette distinction, il devient facile d'accuser Snappy ou ZSTD d'un problème de taille qui a réellement commencé par un mauvais choix d'encodage. Des travaux comparant le comportement d'encodage et de compression de Parquet sur des charges analytiques ont montré que l'association compte davantage que le codec seul (synthèse de recherche sur la compression et les encodages Parquet).
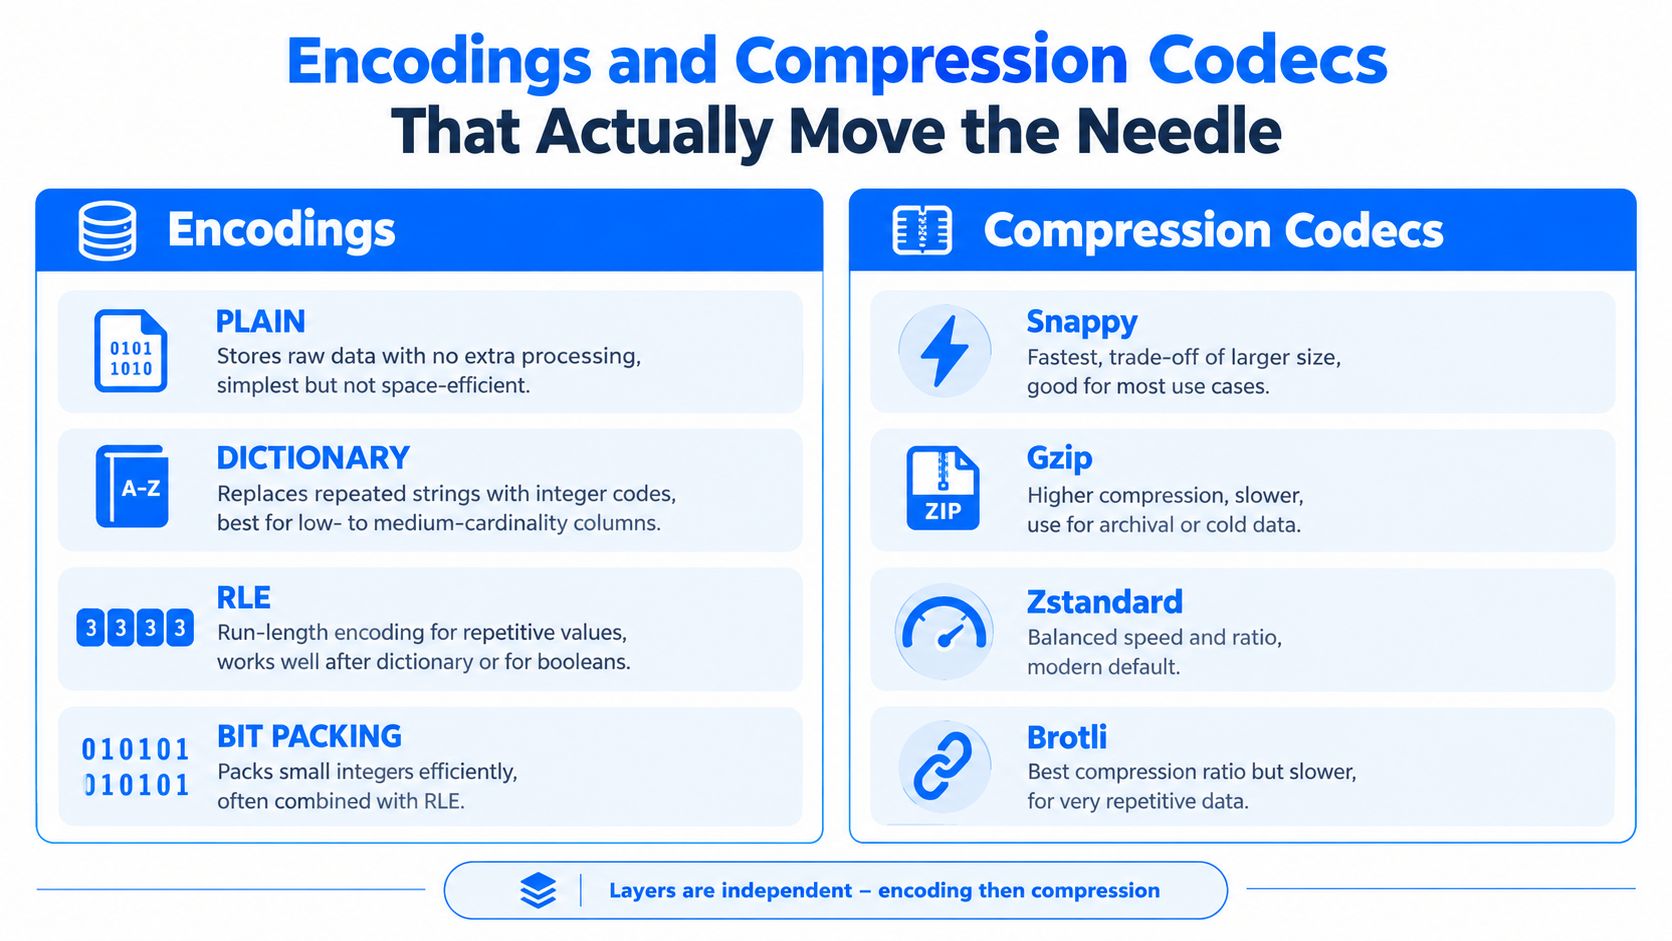
L'encodage revient à trier des outils dans des bacs étiquetés avant de charger un camion. La compression, ce sont les sangles et le film posés une fois le camion chargé. Un bon chargement commence par les bacs.
Les encodages d'abord, les codecs ensuite
Les encodages courants résolvent des problèmes différents :
PLAIN : stocke les valeurs telles quelles. Bon repli, faible sur la taille.
DICTIONARY : remplace les valeurs répétées par de petits codes entiers. Puissant pour les chaînes à cardinalité faible ou moyenne, les énumérations et beaucoup de colonnes d'identifiants.
RLE et bit-packing : compactent les entiers répétés ou de faible largeur. Utiles pour les booléens, les index de dictionnaire et les données très répétitives.
Encodages DELTA : stockent les écarts entre valeurs voisines plutôt que chaque valeur complète. Idéaux pour les entiers triés, les compteurs et certaines colonnes temporelles.
Un exemple concret aide. Supposons qu'une colonne status ne contienne que pending, paid et failed sur 100 millions de lignes. L'encodage par dictionnaire transforme ces chaînes en codes minuscules comme 0, 1 et 2. RLE et bit-packing peuvent ensuite stocker efficacement de longues séries ou des valeurs de faible largeur de bits. Après quoi ZSTD ou Snappy dispose d'un flux d'octets bien plus facile à compresser. Si le même fichier stocke des chaînes brutes en encodage PLAIN, le codec doit travailler bien davantage et obtient généralement de moins bons résultats.
La même synthèse indique que Parquet réduit souvent drastiquement des données analytiques mixtes, et que ZSTD dépasse habituellement Snappy sur le taux de compression tandis que Snappy reste meilleur que l'absence de compression. Elle note aussi que l'encodage par dictionnaire associé au bit-packing et au RLE est particulièrement efficace sur les colonnes de type entier à faible cardinalité. Ce schéma correspond à ce que les ingénieurs data observent dans les tables de faits et les journaux d'événements.
Associations sensées selon la forme des données
Laissez la forme de la colonne guider le choix.
Champs catégoriels, codes pays, valeurs de statut, types de produit : dictionnaire plus ZSTD est un réglage par défaut solide.
Indicateurs booléens, colonnes riches en valeurs nulles, marqueurs de type partition dans le fichier : les chemins compatibles RLE fonctionnent bien car la répétition domine.
Horodatages triés, numéros de séquence, compteurs strictement croissants : les encodages delta peuvent réduire la charge utile avant tout codec.
Chemins de requête interactifs où le temps CPU compte : Snappy reste populaire car le coût de décodage est prévisible.
Jeux d'archives où le coût de stockage prime sur la vitesse d'écriture : ZSTD, GZIP ou parfois Brotli peuvent valoir le CPU supplémentaire.
L'erreur courante consiste à appliquer une politique globale de codec et à considérer le travail terminé. Une table contenant des UUID, des agents utilisateurs, des prix, des booléens et des heures d'événement renferme cinq problèmes de compression différents.
Là où les valeurs par défaut restent insuffisantes en 2026
C'est la partie que beaucoup d'explications sur Parquet passent sous silence.
Les réglages standard de Parquet restent inégaux sur deux types de colonnes omniprésents dans les systèmes réels : les chaînes à forte cardinalité et les valeurs en virgule flottante. L'encodage par dictionnaire perd son avantage quand presque chaque chaîne est distincte, comme avec les URL, les identifiants de requête, les agents utilisateurs et les attributs de texte long. Les flottants posent un autre problème. Les codecs généralistes peuvent les réduire, mais les motifs d'octets sont souvent assez bruités pour que les gains soient plus faibles qu'attendu.
Cet écart explique largement pourquoi la conversation de 2026 autour de Parquet s'est déplacée vers des travaux récents comme FSST pour les chaînes et ALP pour les données en virgule flottante. Le propos n'est pas que le Parquet actuel soit cassé. Le propos est que les encodages par défaut laissent encore de l'argent sur la table pour la télémétrie, les journaux, les métriques, les sorties de modèles, les prix et les pourcentages. Une bonne synthèse de cette direction figure dans la discussion sur FSST et ALP pour les encodages Parquet.
La prise en charge des lecteurs décide encore de ce que vous pouvez utiliser sans risque. Des encodages en préversion ou récemment ajoutés peuvent améliorer la taille des fichiers dans les benchmarks, mais un pipeline de production se pose une question plus dure : Spark, Trino, DuckDB, votre travail d'ingestion et vos outils de reprise liront-ils tous les fichiers de la même façon le mois prochain ?
Ce qui fait vraiment la différence en production
Trois choix comptent généralement plus que les débats sur les codecs sur les réseaux sociaux.
Adaptez l'encodage à la cardinalité. L'encodage par dictionnaire est excellent jusqu'à ce que le dictionnaire devienne assez gros pour ne plus être rentable.
Triez ou regroupez les données avant l'écriture quand vous le pouvez. De meilleurs motifs locaux de valeurs donnent plus de matière au delta, au RLE, aux statistiques et à la compression.
Mesurez des chemins de lecture complets, pas seulement la taille des fichiers. Un fichier 20 pour cent plus petit n'est pas un gain si le coût CPU fait grimper la latence des tableaux de bord ou étire les SLA batch.
Un autre arbitrage mérite de l'honnêteté. Le plus petit fichier n'est pas toujours le moins cher à exploiter. Les équipes économisent souvent davantage avec un fichier un peu plus gros que tous les moteurs décodent vite et de façon fiable qu'avec un choix d'encodage agressif qui introduit un risque de compatibilité ou des défaillances de lecture difficiles à déboguer.
Faire évoluer le schéma sans casser les lecteurs en aval
L'évolution du schéma est l'endroit où de bonnes pratiques sur les formats de fichiers Parquet sauvent votre équipe ou la trahissent. Le format est assez souple pour accompagner le changement, mais cela ne veut pas dire que tout changement est sûr.
L'état d'esprit le plus sûr est simple : ajouter est généralement plus facile que muter.
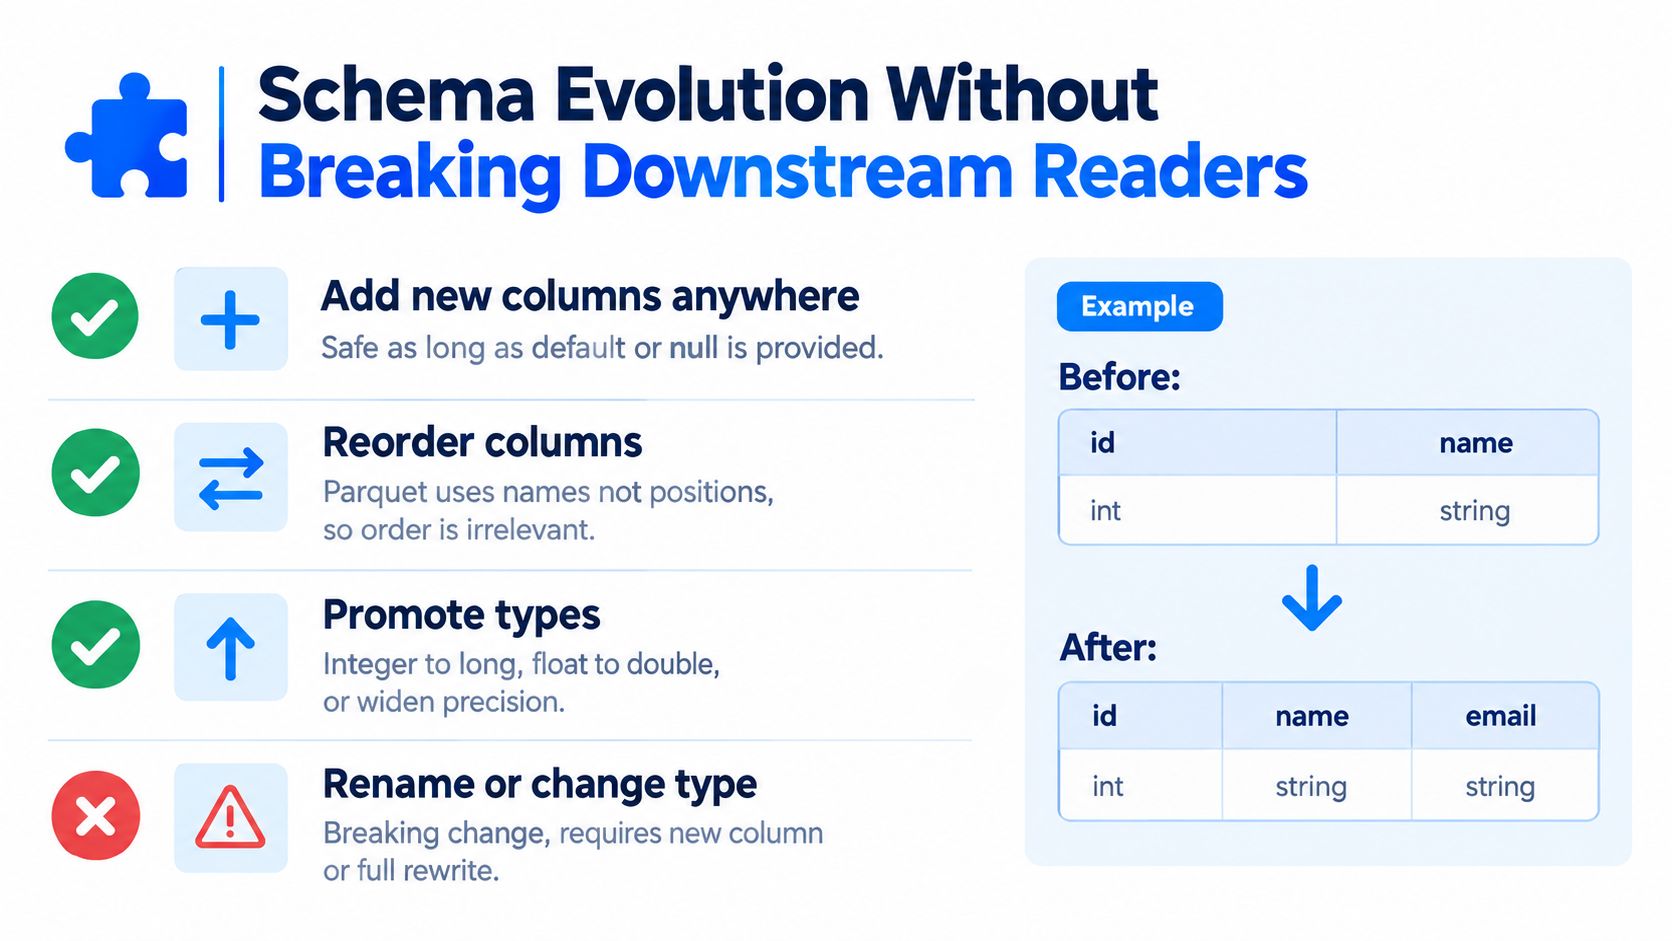
Les changements généralement sûrs
Ces changements sont largement gérables quand vos lecteurs se comportent bien :
Ajouter une nouvelle colonne : les anciens fichiers ne l'ont pas, donc les lecteurs remontent généralement des valeurs nulles ou par défaut.
Réordonner les colonnes : les lecteurs s'appuient en général sur les métadonnées de schéma, pas sur la position visuelle dans le fichier.
Élargir un type : passer d'un type plus étroit à un type compatible plus large est souvent acceptable si le moteur le prend en charge.
Ces schémas correspondent à la façon dont Parquet stocke le schéma dans les métadonnées plutôt que d'imposer une interprétation positionnelle. Ils méritent tout de même des tests, mais ce ne sont pas les changements qui causent habituellement des dégâts silencieux.
Les changements qui provoquent des défaillances silencieuses
Les renommages sont le piège classique. Pour les lecteurs en aval, un renommage ressemble souvent à « supprimer une colonne, en ajouter une autre ». Aucune exception n'est levée. Vous obtenez simplement des valeurs nulles là où figuraient des données.
Les changements de type peuvent être pires. Modifier le sens logique sous le même nom de champ peut produire des valeurs qui se parsent mais ne signifient plus la même chose. C'est ainsi que des équipes finissent par déboguer des lignes « valides » qui ne se réconcilient plus.
Dans les pipelines Parquet, les renommages ne sont pas de la cosmétique de métadonnées. Ce sont des opérations de migration.
Des habitudes qui évitent la dégradation des pipelines
Quelques habitudes d'exploitation font une grande différence :
Figez les contrats de schéma hors du code d'écriture. Un registre, un contrat en dépôt ou un processus adossé au catalogue vaut mieux que « ce que le job produira ce soir ».
Traitez les renommages comme une migration en deux temps. Ajoutez le nouveau champ, rétro-alimentez, mettez à jour les lecteurs, puis retirez l'ancien.
Validez l'élargissement et la compatibilité des types logiques avant la mise en production. Utilisez les mêmes bibliothèques de lecture que celles dont dépendent vos moteurs en aval.
Surveillez la dérive structurelle en continu. Des outils comme Schema Tracker sont utiles car ils détectent les colonnes ajoutées ou supprimées et les modifications de type avant que ces changements ne deviennent des incidents de production.
Si votre équipe gère des données réglementées ou une forte consommation partagée en aval, la discipline de schéma compte davantage que le réglage fin des codecs. Les erreurs de compression coûtent de l'argent. Les erreurs de schéma coûtent la confiance.
Comment Parquet se compare à ORC et Avro
Parquet, ORC et Avro résolvent des parties différentes du cycle de vie de la donnée. Les équipes s'attirent des ennuis quand elles demandent à un seul format de tout faire.
Avro est orienté lignes et s'intègre bien aux frontières d'ingestion. Parquet et ORC sont orientés colonnes et conviennent bien mieux aux lectures analytiques. Dès que l'on cadre le choix autour de la charge de travail plutôt que de la fidélité à une marque, les arbitrages deviennent plus clairs.
Parquet, ORC et Avro en un coup d'œil
Critère | Parquet | ORC | Avro |
|---|---|---|---|
Modèle de stockage | Orienté colonnes | Orienté colonnes | Orienté lignes |
Meilleure adéquation | Analytique multi-moteurs et échange lakehouse | Environnements très orientés entrepôt, souvent centrés sur Hive | Streaming, tampons de messages, échange ligne à ligne |
Élagage de colonnes | Fort | Fort | Faible comparé aux formats en colonnes |
Predicate pushdown | Fort lorsque les statistiques sont présentes et bien écrites | Fort | Limité car il lui manque des statistiques en colonnes à la manière de Parquet |
Gestion du schéma | Métadonnées de fichier autodescriptives | Métadonnées de fichier autodescriptives | Flux solides centrés sur le schéma |
Données imbriquées | Pris en charge | Pris en charge | Pris en charge |
Large interopérabilité des outils | Très forte sur les moteurs analytiques modernes | Forte, mais souvent maximale dans les piles favorables à ORC | Forte pour les flux d'ingestion et de sérialisation |
Une règle de décision pratique
Choisissez Avro si vous tenez aux écritures ligne à ligne, à l'échange d'événements et à une ingestion gouvernée par le schéma. C'est un bon format de frontière.
Choisissez ORC si votre pile est étroitement alignée sur des moteurs et des flux qui le privilégient, en particulier dans des environnements aux conventions d'entrepôt établies.
Choisissez Parquet quand la large interopérabilité prime. Cela inclut les moteurs mixtes, les formats de table ouverts, l'analytique ad hoc et les jeux lakehouse que de nombreux outils doivent lire sans négociation.
Si Parquet continue de remporter ce terrain intermédiaire, c'est moins grâce à une fonctionnalité décisive qu'à la gravité de l'écosystème. Il voyage bien entre lecteurs et, pour la plupart des équipes analytiques, cela compte autant que l'efficacité brute du fichier.
Bonnes pratiques pour des pipelines Parquet fiables
Un pipeline Parquet échoue généralement de façon ordinaire. Une mise à jour de l'écrivain change l'encodage par défaut d'une colonne. Un job de streaming produit des milliers de fichiers de 5 Mo pendant la nuit. Un champ nullable apparaît en INT32 chez un producteur et en INT64 chez un autre. Rien ne paraît dramatique à l'écriture, mais le lendemain matin Trino parcourt plus de données que prévu, Spark perd le predicate pushdown sur une partition, et un modèle en aval se met à lire des valeurs nulles là où il attendait des valeurs.
Voilà la réalité de production à optimiser. La fiabilité vient moins d'un réglage de fichier parfait que du fait de rendre explicites la disposition des fichiers, les règles de schéma et la compatibilité des lecteurs.
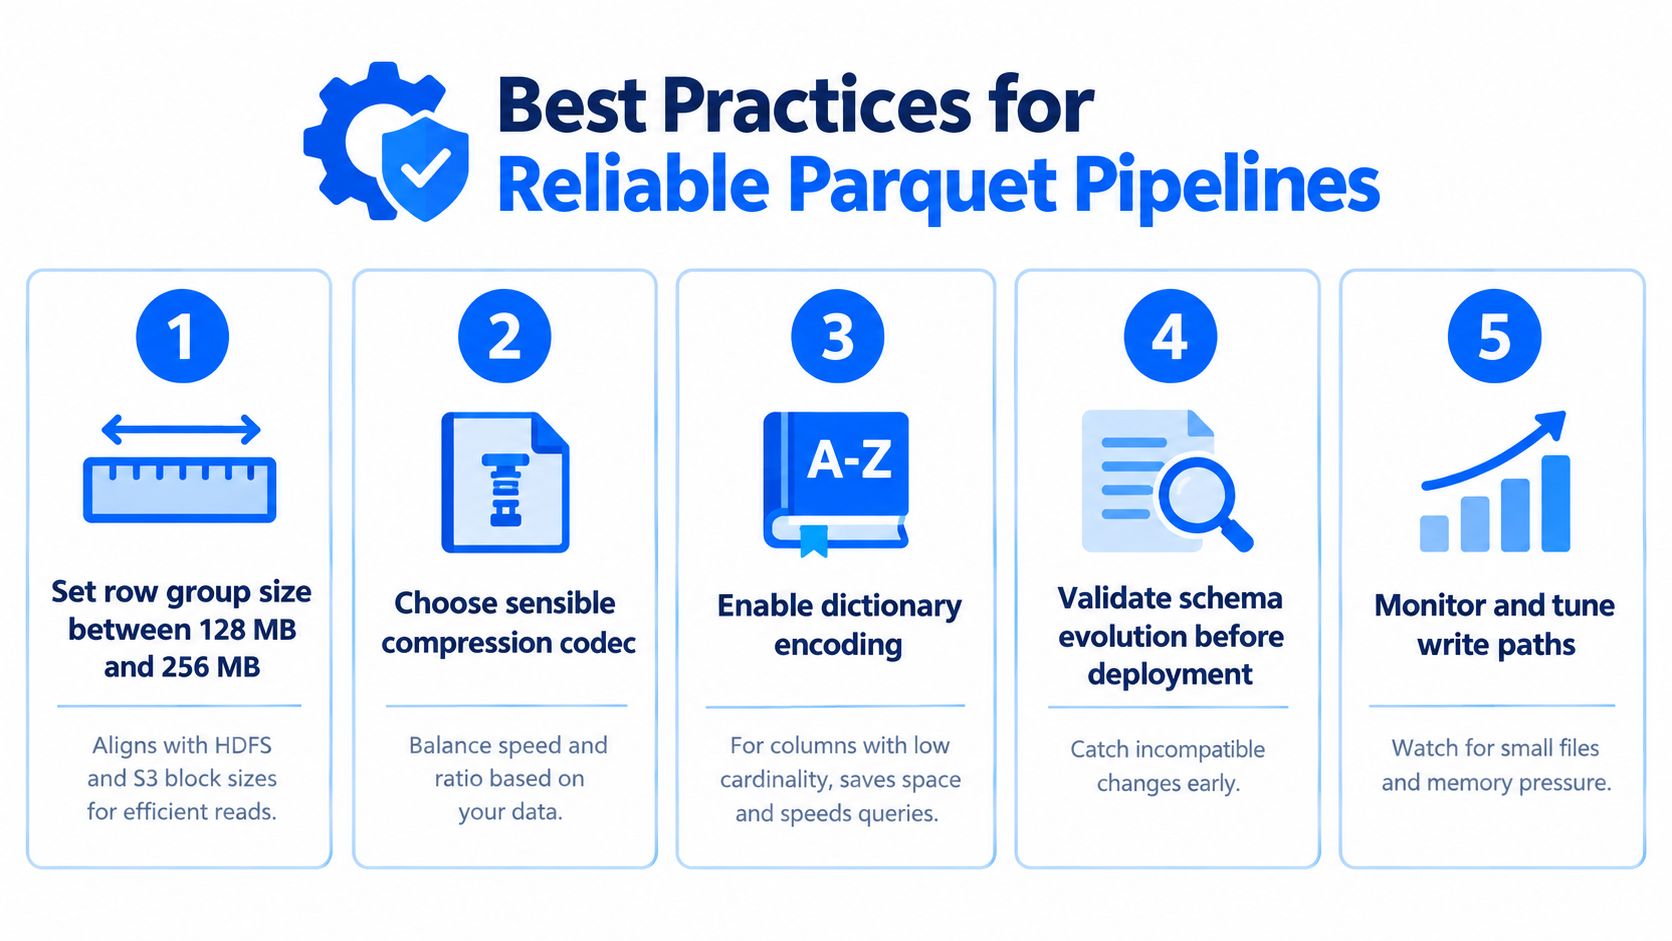
La checklist d'exploitation
Choisissez les tailles de row group à dessein. Beaucoup d'équipes démarrent autour de 128 Mo et ajustent selon les schémas d'analyse, la pression mémoire et le comportement du stockage objet. Des row groups plus grands peuvent améliorer l'efficacité des analyses, mais ils élargissent aussi le rayon d'impact quand les statistiques sont faibles. Des row groups plus petits donnent aux lecteurs plus d'occasions d'écarter des données, mais en avoir trop ajoute du surcoût de métadonnées. Traitez la taille des row groups comme des rayonnages d'entrepôt. Si chaque carton est minuscule, vous perdez du temps à manipuler des cartons. Si chaque carton est énorme, vous ouvrez sans cesse des conteneurs remplis de données inutiles.
Stoppez tôt la prolifération de petits fichiers. C'est l'une des erreurs les plus fréquentes des pipelines Parquet. Les petits fichiers gaspillent du temps de planification, augmentent le travail de métadonnées et réduisent l'efficacité de lecture dans Spark, Trino, DuckDB et les entrepôts cloud. Si un sink Kafka vide toutes les quelques secondes, faites de la compaction un travail à part entière et non une réflexion après coup.
Adaptez les encodages à la forme réelle de la colonne. Les valeurs par défaut conviennent souvent aux entiers et aux dimensions courantes. Elles satisfont bien moins pour les chaînes à forte cardinalité, les identifiants longs et beaucoup de colonnes en virgule flottante. Cet écart compte davantage en 2026 car les équipes stockent de plus en plus d'embeddings, de sorties de caractéristiques et d'identifiants générés par machine dans Parquet, et le chemin d'écriture par défaut laisse encore de l'argent sur la table pour ces formes. L'encodage par dictionnaire aide quand la répétition est réelle. Il aide beaucoup moins quand presque chaque valeur est unique.
Écrivez des données qui donnent une chance aux statistiques. Le predicate pushdown dépend de bien plus que de « statistiques activées ». Si une partition journalière contient des clients, des régions et des types d'événements mêlés dans chaque row group, les valeurs minimales et maximales deviennent de faibles filtres. Trier ou regrouper avant l'écriture fait souvent davantage pour l'efficacité d'évitement que changer de codec de compression.
Traitez l'évolution du schéma comme un changement d'API. Ajouter une colonne nullable est généralement peu risqué. Renommer un champ, changer la largeur numérique, modifier la sémantique des horodatages ou passer de requis à optionnel peut casser des lecteurs de façon subtile. Validez les changements de schéma avant le déploiement et testez-les face aux moteurs qui comptent en production, pas seulement face à la bibliothèque d'écriture. Un moyen pratique de formaliser ces contrôles est de les intégrer à vos bonnes pratiques de pipelines de données pour la validation, la surveillance et le contrôle des changements.
Testez Parquet entre moteurs, pas seulement au sein d'une pile. Un fichier qui paraît valide dans Spark peut révéler des cas limites dans Trino, pandas, Arrow ou un lecteur d'entrepôt. Les types logiques, les page indexes, la gestion des valeurs nulles et l'interprétation des horodatages varient encore assez pour que les tests inter-lecteurs révèlent de vrais bugs de production.
Les questions de production qui comptent le plus en 2026
Le réglage des fichiers compte toujours, mais deux sujets méritent désormais plus d'attention.
D'abord, les encodages par défaut restent inégaux pour les charges modernes. Parquet demeure excellent pour de nombreuses tables analytiques, pourtant les chaînes à forte cardinalité et les jeux riches en flottants se compressent et s'analysent souvent moins efficacement que les ingénieurs ne l'imaginent. Si votre lac stocke des caractéristiques de modèles, des identifiants de télémétrie ou des dimensions semi-structurées éclatées en colonnes, mesurez les réglages d'écriture sur vos propres données au lieu de vous fier aux valeurs par défaut.
Ensuite, le décalage de compatibilité est réel. Qu'une fonctionnalité entre dans la spécification n'est que la ligne de départ. Elle devient sûre en exploitation lorsque vos lecteurs, validateurs et outils de catalogue l'interprètent tous de la même façon. C'est pourquoi un travail Parquet fiable inclut des tests de version, des contrôles de différences de schéma et de l'observabilité. digna est l'une des options utilisées par les équipes pour cette couche opérationnelle : elle surveille les changements de schéma, la Timeliness, les anomalies et les signaux de validation à l'intérieur de l'environnement du client.
Les problèmes de fiabilité de Parquet restent rarement cantonnés au stockage. Ils réapparaissent plus tard sous forme d'analyses plus lentes, de dérive silencieuse des types, de tableaux de bord cassés et de modèles entraînés sur la mauvaise forme de données.
La taille des row groups et les choix de codecs dérivent à mesure que les écrivains évoluent : associez donc ces pratiques à une observabilité de plateforme de données qui signale quand la disposition des fichiers cesse de correspondre aux recommandations.
Questions fréquentes
Quelles tailles de row group et de page Parquet recommande-t-il ?
Les recommandations de configuration Parquet préconisent de grands row groups et de petites pages, avec des exemples comme des row groups de 512 Mo à 1 Go et des pages de 8 Ko, en supposant une disposition alignée sur HDFS. Beaucoup d'équipes sur stockage objet démarrent plutôt autour de 128 Mo et ajustent selon les schémas d'analyse, la pression mémoire et le comportement du stockage.
Quelle est la différence entre Parquet version 1 et version 2 ?
La spécification a connu plusieurs versions, mais la question pratique est de savoir quelles capacités vos lecteurs et écrivains implémentent réellement, plutôt que le numéro de version visé. Pour des environnements mixtes couvrant Spark, DuckDB, Trino et BigQuery, le terrain sûr reste la projection de colonnes, les statistiques de row group, les encodages standard et les codecs répandus.
Quels changements de schéma cassent les lecteurs Parquet en aval ?
Les renommages sont le piège classique. Pour les lecteurs en aval, un renommage ressemble à une colonne supprimée plus une nouvelle, si bien qu'aucune exception n'est levée : vous obtenez simplement des valeurs nulles là où figuraient des données. Ajouter des colonnes nullable est largement sûr ; les défaillances silencieuses commencent avec les changements de type et l'imbrication restructurée.
Comment les métadonnées de page améliorent-elles les performances ?
Elles réduisent les lectures gaspillées à l'intérieur d'un row group, pas seulement entre row groups. Le lecteur part du pied de page, décide quels row groups et colonnes valent la peine d'être ouverts, puis utilise les statistiques de page pour éviter de décoder celles qui ne peuvent pas satisfaire le filtre. Cela compte d'autant plus que les fichiers grossissent et que les filtres deviennent sélectifs.
Dois-je utiliser Parquet, ORC ou Avro ?
Choisissez selon l'étape du cycle de vie plutôt que selon un benchmark. Avro convient aux écritures ligne à ligne, à l'échange d'événements et à l'ingestion gouvernée par le schéma, ce qui en fait un bon format de frontière. Parquet et ORC visent tous deux les analyses analytiques, Parquet étant généralement devant sur l'ampleur de l'écosystème. Les ennuis commencent quand on demande à un format de couvrir toutes les étapes.



