Qu'est-ce qu'un format de table ouvert et pourquoi il compte
|
9
minute de lecture

Si votre lac stocke déjà des fichiers Parquet, pourquoi cela ne vous donne-t-il pas automatiquement une table ?
Cet écart fait trébucher beaucoup d'équipes. Elles ont des fichiers, des dossiers, des partitions et des moteurs SQL capables de les lire. Mais elles n'ont pas encore de réponse fiable à des questions de production basiques : quels fichiers composent la version actuelle de cette table ? Que se passe-t-il si deux jobs écrivent en même temps ? Puis-je annuler un chargement défectueux sans reconstruire les données à la main ?
Sommaire
Ce qu'est un format de table ouvert
Si votre lac stocke déjà des fichiers Parquet, pourquoi des pipelines de production cassent-ils encore sur une question aussi simple que « quelle est la table actuelle » ?

Les équipes qui lancent des écritures Spark concurrentes sur un préfixe Parquet partitionné apprennent souvent la réponse à leurs dépens. Les fichiers existent, mais l'état de la table est flou. Un moteur peut lire une partition partiellement mise à jour, un autre manquer des fichiers nouvellement ajoutés, et un ingénieur d'astreinte finit par inspecter à la main des chemins de stockage pour comprendre ce que « actuel » veut dire.
Un format de table ouvert règle ce problème au niveau des métadonnées. Il définit comment une table suit ses fichiers, versions, changements de schéma et opérations d'écriture, afin que plusieurs moteurs traitent les données du stockage objet comme une vraie table plutôt que comme une convention de répertoires approximative.
Cette distinction compte car la décision de fond est architecturale, et non un choix de nouveau type de fichier. Les fichiers de données restent souvent du Parquet ou de l'ORC. Pour une remise à niveau sur la couche de stockage en dessous, cette explication du format Parquet couvre cette base. Le format de table ouvert se place au-dessus de ces fichiers et consigne les règles de l'état de la table.
Une analogie utile est un entrepôt avec des bacs d'inventaire étiquetés. Les fichiers Parquet sont les cartons au sol. Un format de table ouvert est le système d'inventaire qui dit quels cartons appartiennent à l'expédition en cours, lesquels ont été remplacés, qui a mis à jour les fiches et à quoi ressemblait l'entrepôt avant le dernier mauvais changement. Sans ce système, chaque lecteur doit deviner à partir de ce qu'il voit dans le stockage.
En pratique, cette architecture de métadonnées vous donne un comportement de table que de simples fichiers n'offrent pas proprement. Vous obtenez des transactions ACID, l'évolution du schéma et le voyage dans le temps parce que le format tient un relevé cohérent de l'état de la table et de ses changements dans le temps. C'est pourquoi Apache Hudi, Apache Iceberg et Delta Lake sont généralement discutés ensemble. Ce sont trois manières de gérer le même problème de fond.
Les effets opérationnels sont ce que les ingénieurs ressentent. La dérive de schéma se contrôle mieux car la table possède un historique de schéma faisant autorité. Le coût des requêtes baisse car les moteurs peuvent exploiter les métadonnées au lieu de parcourir chaque fichier juste pour découvrir ce qui existe. L'observabilité s'améliore car vous pouvez inspecter instantanés, commits et changements au niveau fichier plutôt que traiter un préfixe de stockage comme une boîte noire.
La définition la plus courte et exacte est donc celle-ci : un format de table ouvert est une spécification ouverte pour gérer les métadonnées et le comportement d'une table au-dessus de fichiers en stockage objet. Les fichiers portent les données. Le format définit comment les systèmes s'accordent sur ce qu'est la table.
La couche de métadonnées qui change tout
Pourquoi deux moteurs lisent-ils parfois le même lac et renvoient-ils des réponses différentes ?
La cause n'est souvent pas les fichiers eux-mêmes. C'est l'absence d'un relevé partagé et faisant autorité de l'état de la table. Voilà pourquoi les formats de table ouverts se comprennent mieux comme un choix d'architecture de métadonnées. Les fichiers comptent toujours, mais le comportement en production dépend surtout de la façon dont la couche de métadonnées définit la vérité.
Un catalogue de bibliothèque est un bon modèle ici. Les livres sur les étagères sont vos fichiers Parquet. Le catalogue décide quels livres appartiennent à la collection, quelle édition fait foi, lesquels ont été retirés et à quoi ressemblait la collection hier. Sans ce catalogue, chaque lecteur parcourt les rayons et devine par lui-même.
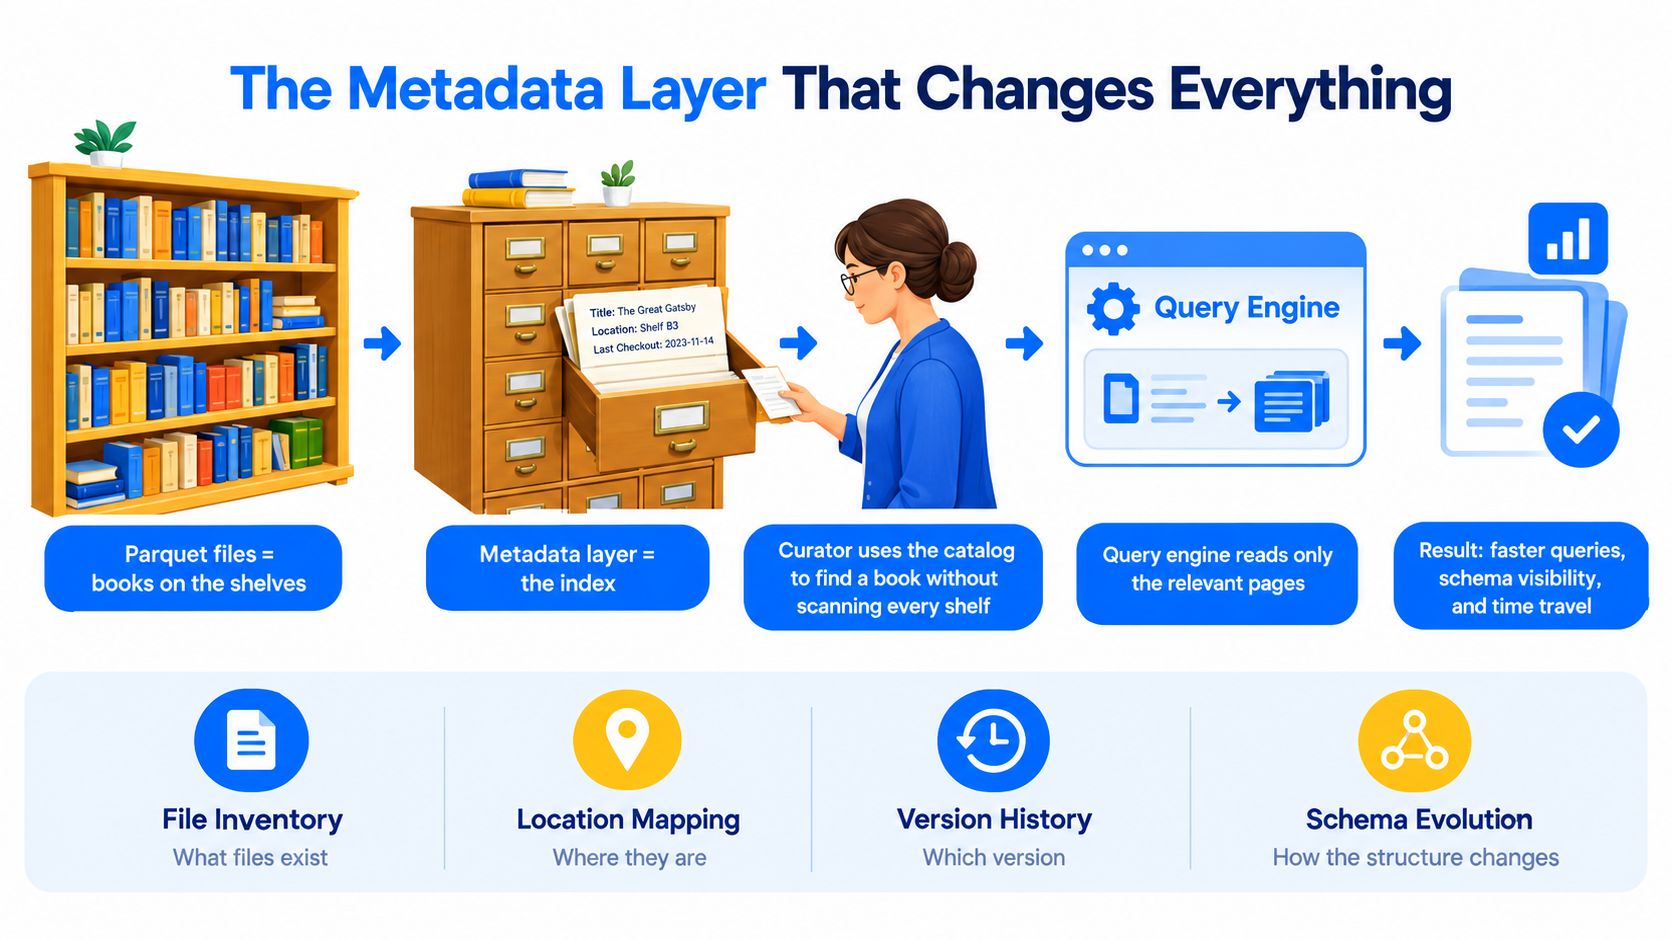
Cette distinction se voit vite en exploitation. Le coût des requêtes monte quand les moteurs doivent lister des répertoires et inspecter des fichiers juste pour découvrir la table. La dérive de schéma devient plus dure à contenir quand aucun système ne détient l'historique. L'observabilité reste faible quand un préfixe de stockage est la seule chose inspectable.
Pour un contexte plus large sur l'organisation et la gouvernance des métadonnées, le guide de gestion des métadonnées de digna couvre la discipline environnante.
Six choses que change la couche de métadonnées
Les instantanés créent une vue cohérente de la table
Les lecteurs n'interprètent pas « les fichiers présents en ce moment » comme la table. Ils lisent depuis un instantané défini, ce qui donne à chaque moteur la même réponse sur l'état actuel à cet instant.Le suivi des fichiers rend la planification moins coûteuse
Au lieu de parcourir toute une arborescence, le moteur peut consulter des métadonnées qui listent déjà les fichiers pertinents et leurs statistiques. L'effet pratique est un coût de requête plus faible et une planification plus prévisible, surtout à mesure que les tables grossissent.Les transactions évitent la visibilité partielle
Une écriture devient visible quand le commit réussit. Si un job échoue à mi-parcours, les lecteurs restent sur l'instantané valide précédent au lieu de voir un mélange d'anciens et de nouveaux fichiers.L'évolution du schéma devient explicite
Ajouts, renommages et changements de type de colonnes sont consignés comme des modifications de métadonnées. Cela vous donne une source de vérité pour l'historique du schéma au lieu de compter sur chaque moteur pour déduire la structure des fichiers.Le partitionnement devient une règle de la table
La disposition des répertoires cesse de porter autant de sens. Les métadonnées peuvent décrire directement la logique de partition, ce qui rend les changements de disposition plus faciles à gérer dans la durée.L'historique devient inspectable
Les anciens instantanés restent partie du relevé de la table. Cela aide pour le retour arrière, le débogage, les questions d'audit et des questions simples comme « qu'est-ce qui a changé entre ces deux exécutions ? ».
Un mode de défaillance concret rend cela plus visible.
Une pipeline batch écrit une nouvelle journée de données dans le stockage objet. Un moteur commence à lire alors que l'écriture est encore en cours. Un autre moteur lit quelques minutes plus tard, après l'arrivée de fichiers supplémentaires. Les deux équipes disent avoir interrogé « la même table ». Non. Elles ont interrogé des listings de fichiers différents à des moments différents.
Avec un format de table ouvert, le commit ne publie un nouvel état de table qu'une fois complet. En attendant, les lecteurs continuent d'utiliser l'instantané précédent. C'est le basculement opérationnel. Vous cessez de traiter le listing de dossiers comme le contrat et commencez à traiter les métadonnées comme le contrat.
Règle pratique : si le contenu des dossiers définit votre table au moment de la lecture, le comportement de votre table repose encore sur des conventions de stockage.
Apache Iceberg rend ce contrat particulièrement net. Sa spécification de table définit les métadonnées comme un objet JSON qui suit schéma, spécifications de partition, propriétés et instantanés, ces derniers étant consignés dans les métadonnées elles-mêmes, comme le décrit la spécification de table Iceberg.
Voilà pourquoi cette couche change tant de choses en production. Elle détermine comment les systèmes s'accordent sur la vérité de la table, et cette décision pèse sur l'exactitude, le coût et la rapidité avec laquelle votre équipe peut expliquer un mauvais résultat.
Apache Iceberg, Delta Lake et Apache Hudi comparés
Si les formats de table ouverts relèvent vraiment d'un choix d'architecture de métadonnées, et pas seulement de format de fichier, la comparaison change. Vous ne choisissez pas entre trois façons de stocker du Parquet. Vous choisissez trois façons de définir la vérité d'une table, de publier les changements et de coordonner lecteurs et écrivains en production.
Ce cadrage compte car la douleur opérationnelle surgit à des endroits différents. Un format peut réduire les frictions entre moteurs. Un autre peut coller plus naturellement à une plateforme centrée sur Spark. Un troisième peut simplifier l'exploitation de mises à jour fréquentes et de pipelines CDC. La question pratique est simple : où voulez-vous que le système de métadonnées porte la charge la plus lourde ?
Iceberg, Delta Lake et Hudi en un coup d'œil
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Origine | Développé chez Netflix en 2018, donné à Apache en 2019 | Passé en open source en 2019 | Créé chez Uber en 2016 |
Axe principal | Spécification de métadonnées portable entre moteurs | Protocole de table très centré sur Spark et intégration de plateforme | Upserts, traitement incrémental et maintenance de table orientée streaming |
Modèle de métadonnées | Arbre de métadonnées fondé sur instantanés et manifestes | Journal de transactions centré sur | Chronologie de commits avec services de table et maintenance orientée enregistrements |
Meilleure adéquation | Environnements lakehouse multi-moteurs | Parcs très orientés Databricks ou Spark | Pipelines CDC et streaming à mises à jour fréquentes |
Ressenti opérationnel | Séparation nette entre fichiers et métadonnées de table | Flux resserré pour les équipes déjà standardisées sur l'outillage Delta | Plus de services de table, davantage centré sur le chemin d'écriture |
L'histoire d'origine importe moins que le centre de gravité de la conception. Chaque format répond différemment à la même question : comment une table doit-elle consigner les changements, exposer l'état courant et permettre aux moteurs de s'accorder sur ce qu'ils lisent ?
Là où les conceptions divergent
Apache Iceberg organise la table autour d'un arbre de métadonnées. Cela séduit généralement les équipes multi-moteurs car le contrat de table est défini comme une spécification portable plutôt que par le comportement d'une seule pile de traitement. En pratique, cela signifie souvent moins de surprises quand Spark, Trino, Flink et d'autres doivent lire les mêmes données sans inventer des conventions distinctes.
Delta Lake organise la table autour d'un journal de transactions. Pour les équipes déjà standardisées sur Spark et Databricks, cela paraît souvent naturel car chemin d'écriture, contrôles de gouvernance et outillage d'exploitation s'alignent étroitement. Le choix de métadonnées se voit au quotidien. Changements de schéma, retour arrière et maintenance peuvent sembler plus intégrés quand la plateforme suppose déjà la sémantique Delta.
Apache Hudi oriente une bien plus grande part de sa conception vers l'exploitation à forte écriture. Si votre douleur n'est pas « plusieurs moteurs doivent s'accorder » mais « les enregistrements changent sans cesse et les consommateurs en aval ont besoin de mouvement incrémental », Hudi entre tôt dans la conversation. Son architecture reflète ce biais. La spécification technique de Hudi explique que les métadonnées sont stockées dans une table gérée en interne sous le chemin de la spécification technique Hudi .hoodie/metadata, et que cette table de métadonnées est elle-même une table Hudi en merge-on-read.
Une analogie utile est un système d'inventaire d'entrepôt. Iceberg est conçu pour que de nombreux services fassent confiance au même relevé de catalogue. Delta est conçu pour que l'entrepôt et son système d'exploitation fonctionnent étroitement ensemble. Hudi est conçu pour un entrepôt où les articles sont sans cesse corrigés, remplacés ou réapprovisionnés, et où l'inventaire doit suivre ce rythme.
Ce que ces choix impliquent en production
Les équipes ressentent la différence en premier.
Si la dérive de schéma revient sans cesse, le modèle de métadonnées compte car l'évolution du schéma n'est pas une simple case à cocher. Elle détermine si les jobs en aval échouent bruyamment, lisent des hypothèses mêlées ou exigent un traitement propre à chaque moteur.
Si le coût des requêtes ne cesse de monter, la disposition des métadonnées compte car la table doit aider le moteur à éviter des fichiers inutiles. Un chemin de planification plus net signifie généralement moins de fichiers parcourus et moins de mauvaises surprises à l'exécution.
Si le problème est l'observabilité, le choix du format compte car l'historique des métadonnées détermine la facilité avec laquelle votre équipe répond aux questions d'exploitation de base. Quel instantané a introduit les mauvais enregistrements ? Quel commit a changé le comportement de partition ? Quel écrivain a publié des fichiers incompatibles ?
C'est aussi pourquoi les décisions de format et les contrôles qualité finissent liés. Dans les environnements très orientés Databricks, les pratiques de qualité des données sur Databricks doivent souvent être conçues en même temps que le comportement des tables Delta, et non ajoutées après coup.
Une façon pratique de choisir
Prenez Iceberg si l'interopérabilité entre moteurs est une exigence de premier ordre et que vous voulez que la spécification de table reste aussi indépendante que possible d'un runtime d'éditeur.
Prenez Delta Lake si votre plateforme repose déjà largement sur Spark ou Databricks et que vous appréciez une intégration serrée entre chemin d'écriture, gouvernance et exploitation quotidienne.
Prenez Hudi si mises à jour fréquentes, ingestion CDC et consommation incrémentale définissent la charge plus que la portabilité entre moteurs.
Aucun format ne gagne dans toutes les catégories. Chacun place le contrat de métadonnées dans un rôle légèrement différent. Ce choix de conception façonne votre gestion de l'exactitude, du coût et du débogage d'incidents une fois la table en production.
Comment une requête atteint réellement les données
Pourquoi la même requête SQL paraît-elle bon marché sur une table et douloureusement coûteuse sur une autre, alors que les deux pointent vers le même stockage objet ?
La réponse tient généralement aux métadonnées, pas à Parquet.
SELECT * FROM sales WHERE order_date = current_date
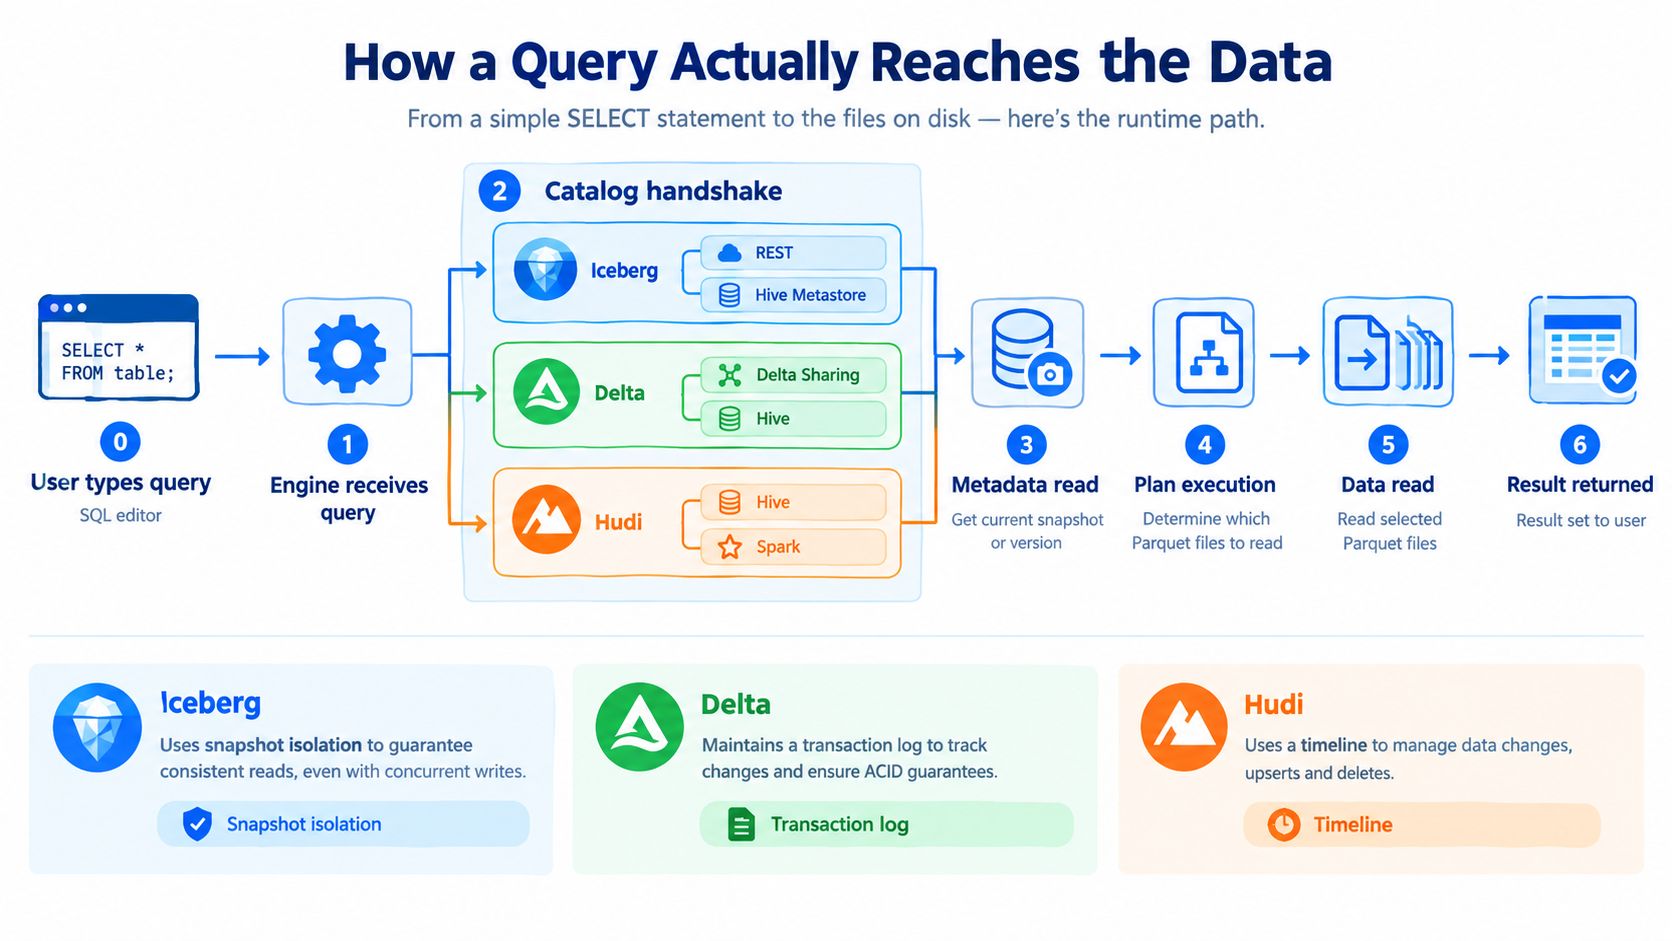
Une telle requête ne commence pas par parcourir des dossiers. Elle commence par demander : « que signifie cette table en ce moment ? ». C'est le modèle mental clé. Un format de table ouvert est une architecture de métadonnées pour répondre de façon fiable à cette question.
D'abord, le moteur demande l'état actuel de la table
Le moteur résout sales via un catalogue tel que Hive Metastore, AWS Glue, Unity Catalog ou Nessie. Le catalogue agit comme un accueil détenant l'adresse actuelle, pas comme l'entrepôt qui garde chaque carton. Son rôle est d'orienter le moteur vers l'entrée de métadonnées en vigueur.
Ce détail a de vraies conséquences opérationnelles. Si le catalogue pointe vers des métadonnées périmées, le moteur planifie contre un état de table périmé. Si un job d'ingestion dépose des fichiers directement dans le stockage sans commit valide, ces fichiers peuvent exister physiquement tout en restant invisibles logiquement.
Pour une vue d'architecture plus large, cet aperçu de l'architecture des systèmes de données aide à situer le catalogue par rapport au stockage et au calcul.
Ensuite le format de table fournit la carte des fichiers
Une fois que le moteur détient l'entrée de métadonnées, le format de table ouvert prend le relais :
Iceberg lit les métadonnées de table, les manifestes et l'instantané actif.
Delta Lake lit le journal de transactions plus tout état de point de contrôle.
Hudi lit sa chronologie et ses métadonnées de table pour déterminer la vue actuelle.
Mécaniques différentes, même objectif. Le moteur a besoin d'une carte des fichiers faisant autorité avant de lire le moindre fichier de données.
C'est le basculement pratique entre un simple lac de données et un format de table ouvert. Sans cette couche, le moteur doit souvent déduire l'état de la table des dossiers et des noms de fichiers. Avec elle, l'état de la table est déclaré explicitement.
La planification précède l'analyse
Le coût des requêtes commence à diverger.
Une fois que le moteur sait quels fichiers appartiennent à l'instantané courant, il peut restreindre le travail grâce aux données de partition, aux statistiques de fichiers et aux métadonnées de commit. Au lieu d'ouvrir chaque fichier sous un chemin et de trancher tard, il peut écarter les fichiers inutiles dès la planification.
Cela change le comportement en production de façons que les data engineers remarquent vite :
Coût de requête plus faible car moins de fichiers doivent être ouverts
Moins de confusion liée à la dérive de schéma car le chemin de lecture suit des métadonnées validées, pas les fichiers tombés au hasard dans le stockage
Meilleur débogage d'incidents car vous pouvez inspecter directement instantanés, commits et appartenance des fichiers
Moins d'angles morts d'observabilité car l'état de la table est consigné en métadonnées, pas caché dans des conventions de dossiers
Si un tableau de bord paraît soudain faux, la question de débogage devient plus précise. Quel instantané le moteur a-t-il lu ? Quel commit a ajouté ces fichiers ? Quel changement de métadonnées a modifié le comportement de partition ou de schéma ?
Voilà pourquoi les formats de table ouverts se comprennent mieux comme un plan de contrôle pour les tables. La requête n'atteint les données qu'après que les métadonnées ont défini ce qu'est la table, quels fichiers lui appartiennent et lesquels peuvent être ignorés.
Bénéfices réels et arbitrages que vous rencontrerez
Le premier sprint après l'adoption d'un format de table ouvert fait généralement du bien. Les écritures deviennent plus fiables. Les changements de table cessent de ressembler à de la chirurgie de dossiers. Les équipes retrouvent la confiance qu'une table signifie une seule chose cohérente à un instant donné.
Puis la réalité de la production arrive.
Bénéfices et arbitrages des formats de table ouverts en un coup d'œil
Bénéfice | Ce que vous obtenez | L'arbitrage dont vous héritez |
|---|---|---|
Écritures ACID | Les lecteurs ne voient pas de lots à moitié terminés | Vous dépendez désormais de la coordination des commits et de la santé des métadonnées |
Évolution du schéma | Changements de colonnes maîtrisés sans réécritures constantes | Il faut toujours de la discipline sur la compatibilité et les contrats en aval |
Voyage dans le temps | Retour arrière et débogage facilités | La rétention de l'historique doit être pilotée délibérément |
Portabilité entre moteurs | Plus de souplesse avec Spark, Trino, Flink et d'autres | La portabilité du format ne garantit pas une gouvernance ouverte |
Meilleure planification de requêtes | Élagage de fichiers plus efficace et état de table plus propre | La maintenance des métadonnées devient partie de l'exploitation |
Chaque bénéfice crée une nouvelle responsabilité
Les écritures fiables suppriment une classe de pannes du lac, mais créent aussi une nouvelle frontière de panne autour du chemin de métadonnées et du catalogue.
Le voyage dans le temps aide quand quelqu'un publie de mauvaises données, mais les instantanés historiques ne se gèrent pas tout seuls. Si vous n'expirez jamais les anciens instantanés ni ne nettoyez les métadonnées, stockage et surcoût de planification augmentent.
L'évolution du schéma réduit les réécritures en force, mais ne supprime pas le besoin de contrats de données. Une colonne renommée peut encore casser un consommateur qui attendait l'ancien nom.
Pour les équipes qui comparent plus largement les schémas lakehouse, cette comparaison entre data lake et data mart est utile car elle met en lumière comment souplesse de stockage et consommation curatée servent des objectifs opérationnels différents.
Le coût caché, c'est le travail de maintenance
C'est la partie que beaucoup de schémas d'architecture passent sous silence. Les tables ouvertes auto-gérées ont toujours besoin de compaction, expiration d'instantanés, nettoyage de métadonnées et maintenance continue. Sans ce travail, les performances se dégradent et les coûts de stockage augmentent, comme l'expose l'analyse de CDO Magazine sur les tables ouvertes et l'interopérabilité.
Le même texte fait un autre point important. Les formats de table ouverts améliorent la portabilité, mais ne règlent pas automatiquement la fiabilité ni l'observabilité, surtout dans des environnements mouvants et multi-moteurs.
Réalité opérationnelle : les formats de table ouverts réduisent le chaos des fichiers. Ils ne suppriment pas le besoin de discipline de plateforme.
Il y a aussi un piège de gouvernance. Les équipes se félicitent souvent que le format de table soit ouvert, tout en laissant catalogue, politiques d'accès, règles de masquage et comportement d'audit sous le contrôle d'un seul éditeur. Des commentaires récents soutiennent que si ces couches restent contrôlées par l'éditeur, l'architecture n'est pas pleinement ouverte en pratique, même si les fichiers et le format le sont, comme l'explore la perspective de Onehouse sur les formats de table ouverts et l'architecture lakehouse ouverte.
Mise en œuvre pratique et considérations de migration
Les décisions de migration se passent mieux quand vous les prenez dans l'ordre où les équipes d'exploitation les rencontrent.
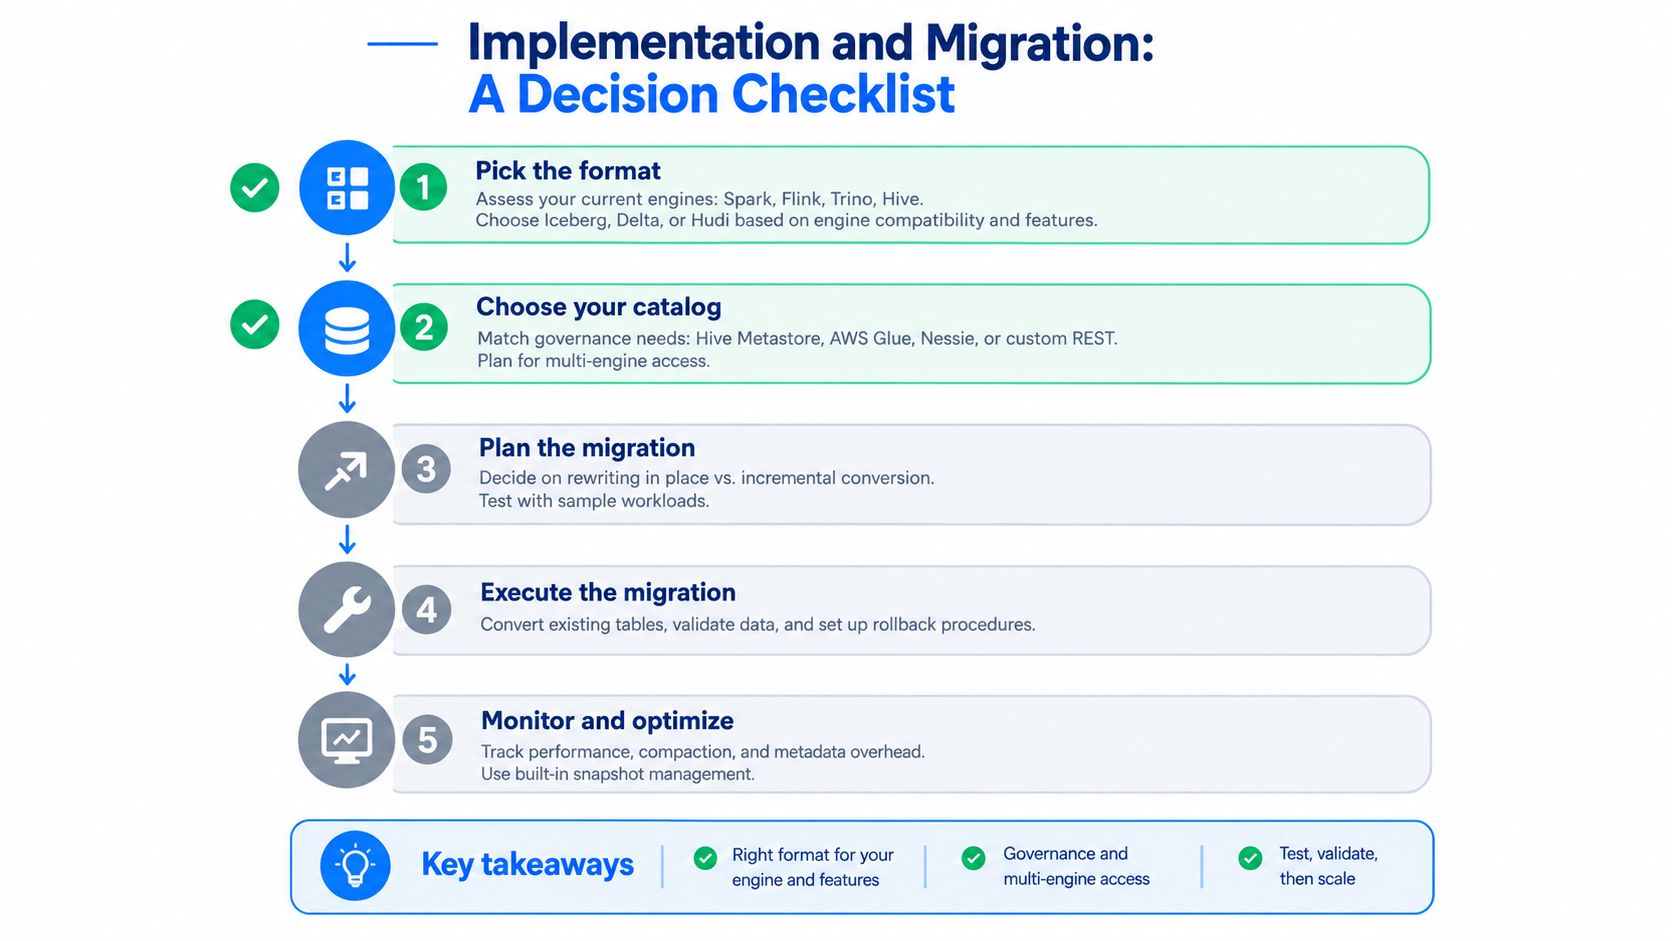
Commencez par les moteurs que vous exploitez déjà
Si Spark domine et que votre équipe dépend déjà de flux natifs Delta, Delta peut être la voie la moins perturbatrice.
Si votre environnement est multi-moteurs, Iceberg s'accorde souvent plus proprement au modèle d'exploitation.
Si votre exigence la plus dure porte sur des upserts fréquents depuis CDC et streaming, Hudi mérite une évaluation sérieuse.
Choisissez le catalogue comme une infrastructure
Beaucoup d'équipes traitent le catalogue comme un détail d'implémentation. Il ne l'est pas. Il devient partie de votre plan de contrôle.
Prenez un catalogue simple si la simplicité prime. Prenez un catalogue intégré au cloud ou gouverné par la plateforme si sécurité, lignage et politique centralisée comptent davantage. Si vous attendez plusieurs moteurs sur plusieurs clouds, choisissez une stratégie de catalogue qui n'enferme pas la gouvernance dans un seul runtime.
La migration est souvent moins brillante que l'annonce
Les schémas de migration courants comprennent :
Réécrire dans de nouvelles tables : sémantique la plus propre, déplacement initial le plus lourd
Double écriture pendant un temps : bascule plus sûre, complexité temporaire accrue
Cloner ou convertir quand c'est possible : plus rapide, mais validez soigneusement les hypothèses
Déploiement par domaines en phases : préférable pour de grands parcs aux charges variées
Le risque silencieux n'est généralement pas la conversion des fichiers. C'est d'oublier de monter la maintenance dès le premier jour.
Il vous faut des jobs ou des services gérés pour la compaction, la rétention et le nettoyage avant que la première table importante ne passe en production. Si vous sautez cela, la plateforme commence à dériver immédiatement.
Un choix par défaut pratique
Un défaut raisonnable est simple :
Choisissez Iceberg pour du SQL multi-moteurs et une conception lakehouse orientée gouvernance.
Choisissez Delta Lake si votre plateforme penche fortement vers Databricks et Spark.
Choisissez Hudi quand le chemin d'écriture est dominé par le CDC, les upserts et les corrections en streaming.
Et si vous instrumentez la santé des tables dès le premier jour, une option est digna, qui s'exécute dans l'environnement du client et surveille changements de schéma, Timeliness, anomalies et validation des enregistrements sur les lacs, entrepôts et pipelines.
Ce que les formats de table ouverts changent pour l'observabilité
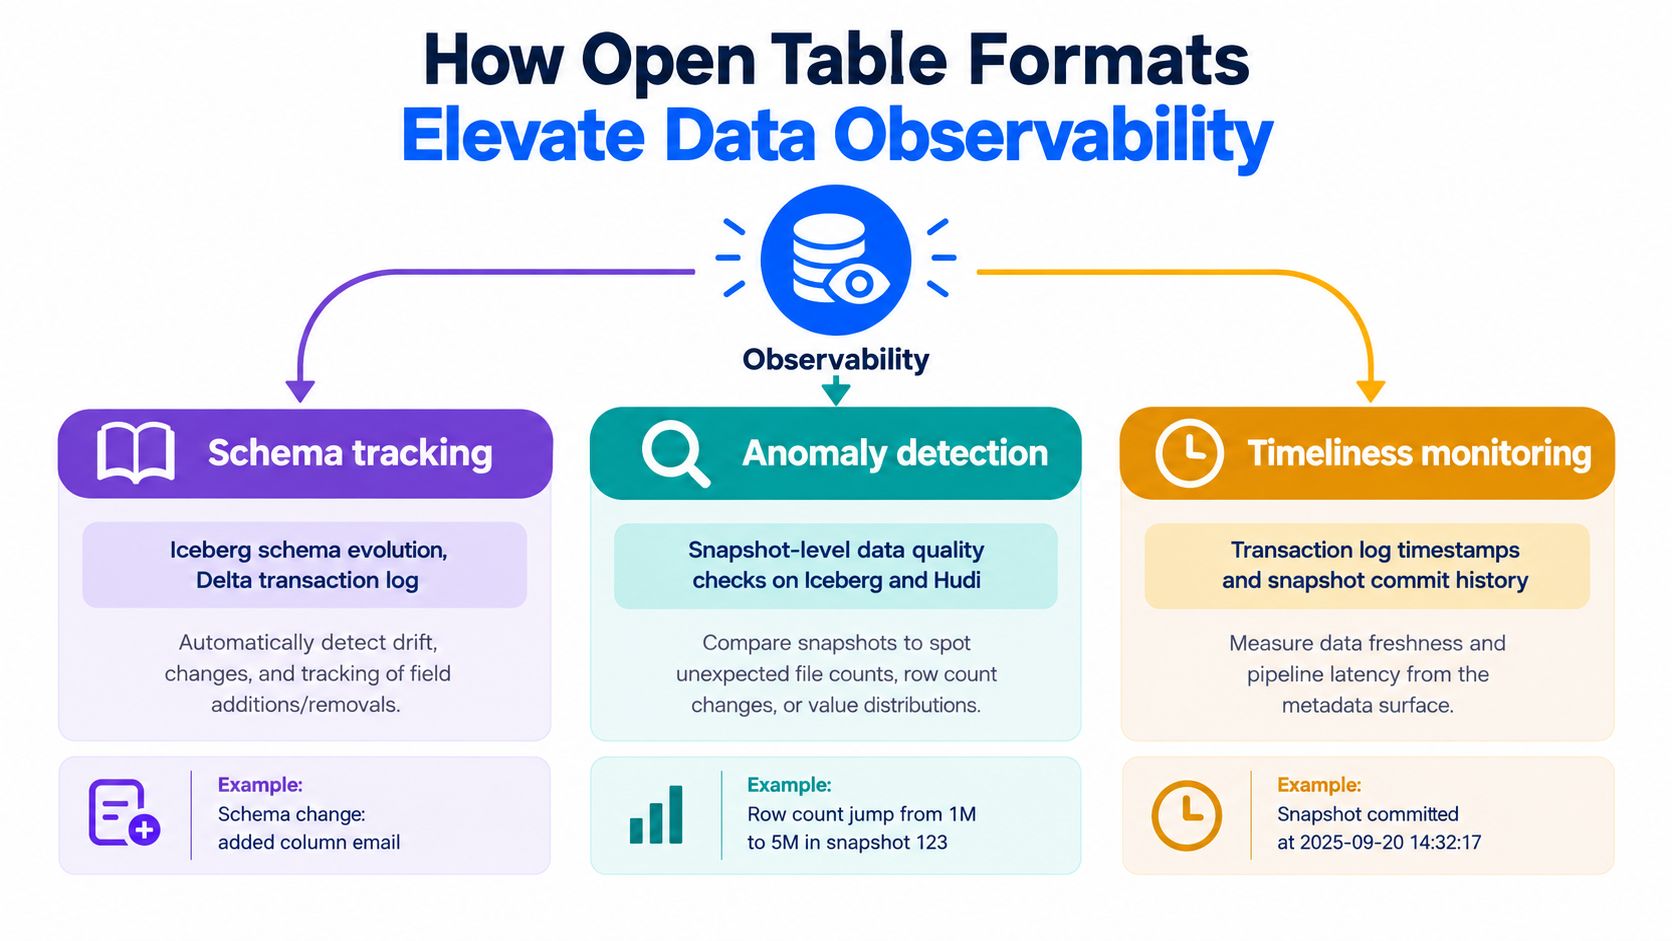
Les formats de table ouverts n'améliorent pas seulement la sémantique de stockage. Ils exposent aussi une surface de métadonnées que les outils d'observabilité peuvent lire directement.
Les métadonnées deviennent de la télémétrie
Les instantanés Iceberg, les journaux de transactions Delta et les métadonnées de commit Hudi produisent tous une preuve lisible par machine du changement de table. C'est important car beaucoup de contrôles de qualité et de fiabilité n'ont pas besoin de parcourir d'abord des jeux complets.
Une plateforme peut inspecter l'historique des commits et demander :
Un changement de schéma est-il arrivé de façon inattendue ?
La partition du jour est-elle arrivée plus tard que d'habitude ?
Une écriture a-t-elle publié bien moins de fichiers que la pipeline n'en produit d'ordinaire ?
La table a-t-elle cessé d'avancer alors que les jobs amont ont tourné ?
L'observabilité se rapproche du chemin d'écriture
Cela change le modèle d'exploitation de la supervision. Au lieu de s'en remettre aux seuls échecs de requêtes ou aux plaintes sur les tableaux de bord, les équipes peuvent détecter les problèmes là où l'état de la table change.
Quand les métadonnées vous disent que la table a changé, l'observabilité peut tester ce changement avant que les utilisateurs ne découvrent la casse.
C'est une raison pour laquelle les formats de table ouverts comptent au-delà du stockage et de la vitesse des requêtes. Ils créent une surface de contrôle partagée que moteurs, systèmes de gouvernance et outils d'observabilité peuvent tous lire.
La réserve est importante. Les métadonnées aident à exposer des signaux. Elles ne les interprètent pas pour vous. Les équipes ont toujours besoin de règles, de références et de flux d'incidents qui relient le changement de table à l'impact métier.
Comment poursuivre
Un format de table ouvert n'est pas la ligne d'arrivée. C'est le socle d'un lakehouse mieux tenu.
Avant de déclarer l'architecture prête pour la production, vérifiez quelques points :
Résilience du catalogue : assurez-vous que le catalogue est assez disponible pour devenir partie de votre plan de contrôle.
Jobs de maintenance : confirmez que compaction, expiration d'instantanés et nettoyage de métadonnées sont planifiés dès le premier jour.
Politique de rétention : alignez l'historique de voyage dans le temps sur les besoins de conformité et de retour arrière.
Comportement des moteurs : vérifiez que les moteurs lisent les métadonnées de table plutôt que de s'appuyer sur des raccourcis de listage de répertoires.
Câblage de l'observabilité : surveillez les signaux de commit et d'instantané, pas seulement les sorties de requêtes.
Si vous évaluez Iceberg sur un lac existant, commencez par une table qui souffre déjà de dérive de schéma ou d'accès multi-moteurs.
Si vous introduisez Delta dans une maison très orientée Spark, commencez là où la sécurité transactionnelle compte plus que les débats de portabilité.
Si vous testez Hudi pour des charges très CDC, choisissez une table où upserts et consommation incrémentale sont déjà la source de la douleur opérationnelle.
La question utile n'est pas seulement ce qu'est un format de table ouvert. C'est de savoir si votre équipe est prête à exploiter l'architecture de métadonnées qui l'accompagne.
digna donne aux équipes data une plateforme de qualité et d'observabilité dans leur propre environnement, ce qui s'accorde naturellement aux formats de table ouverts parce qu'une grande part du signal utile vit dans les commits, les changements de schéma et les métadonnées de fraîcheur. Si vous transformez des fichiers bruts de lac en tables gouvernées et exposées à la production, rendez-vous sur digna pour voir comment elle surveille dérive de schéma, Timeliness, anomalies et validation sans sortir vos données de votre environnement.
La couche de métadonnées facilite le travail du planificateur de requêtes ; faire répondre ces mêmes métadonnées à des questions d'exploitation, c'est ce qu'ajoute l'observabilité de plateforme de données.
Questions fréquentes
Que stocke réellement la couche de métadonnées ?
Le schéma et son historique, la liste des fichiers de données composant chaque version de la table, les définitions de partition et des statistiques par fichier comme les plages de valeurs et le nombre de valeurs nulles. C'est ce dernier point qui permet à un planificateur d'écarter des fichiers avant même de les ouvrir.
Comment une requête atteint-elle les données ?
Le moteur demande au catalogue le pointeur de métadonnées courant, lit le manifeste pour obtenir la liste des fichiers avec leurs statistiques, écarte ceux dont les statistiques ne peuvent satisfaire le filtre, puis seulement ouvre les fichiers Parquet restants. L'essentiel de la vitesse vient des fichiers qu'il n'ouvre jamais.
Un format de table ouvert améliore-t-il la qualité des données ?
Il améliore la cohérence, pas l'exactitude. Le format garantit que chaque moteur voit la même version validée de la table avec le même schéma ; il ne dit rien sur l'exactitude, la complétude ou la fraîcheur des valeurs. Ces contrôles restent séparés, posés au-dessus du format.
Que peut-on observer depuis les métadonnées de table ?
La fréquence des commits montre si les chargements arrivent à l'heure, les différences d'instantanés montrent quels fichiers un changement a touchés, et l'historique de schéma montre quand le type d'une colonne a bougé. Ces signaux attrapent une classe de problèmes plus tôt que les tests au niveau ligne, car ils apparaissent avant que quiconque interroge les données.
Y a-t-il un coût à l'adopter ?
Oui, mais opérationnel plutôt que de licence. Vous héritez de l'expiration des instantanés, de la compaction des fichiers et de la disponibilité du catalogue comme choses à maintenir, et la planification gagne un aller-retour de métadonnées. Pour de petits jeux qui changent rarement, du Parquet simple avec une disposition stable peut rester la bonne réponse.



