Le format de fichier Parquet expliqué : guide pratique 2026
|
10
minute de lecture

Vous avez probablement déjà affaire à Parquet, même si vous ne l'avez pas choisi. Un export d'entrepôt atterrit dans S3, votre job Spark lit une table du lac adossée à des fichiers Parquet, ou Athena continue d'analyser des jeux de données que quelqu'un en amont a partitionnés de trois façons différentes au cours de l'année. La plupart du temps, cela paraît assez rapide et assez invisible pour que personne ne pose de questions.
Puis quelque chose casse. Une requête qui filait se met à traîner. Un nouvel écrivain déploie une fonctionnalité qu'un moteur sait lire et un autre non. Un seul champ renommé se transforme en une semaine de valeurs nulles en aval. C'est là que le format de fichier Parquet cesse d'être une extension pour devenir un sujet d'exploitation.
Sommaire
Pourquoi Parquet est devenu le format en colonnes par défaut
À l'intérieur d'un fichier Parquet : row groups, column chunks et pages
Comment Parquet obtient sa vitesse : predicate pushdown et élagage de colonnes
Partitionnement, taille des fichiers et bonnes pratiques de stockage
Dérive de schéma, Timeliness et observabilité des pipelines Parquet
Pourquoi Parquet est devenu le format en colonnes par défaut
Un schéma analytique courant ressemble à ceci : une équipe stocke une large table de ventes aux nombreux attributs, mais la plupart des requêtes de tableau de bord ne touchent qu'une poignée de colonnes. Dans un export orienté lignes comme CSV, le moteur doit quand même mâcher chaque ligne sous forme de texte. Dans Parquet, le moteur peut se concentrer sur les colonnes utiles à la requête. C'est cette différence qui pousse à le choisir pour le stockage analytique.
Parquet n'est pas apparu par hasard. Il a commencé comme une collaboration open source entre Twitter et Cloudera, avec une première publication le 13 mars 2013, Parquet 1.0 en juillet 2013, et au 27 avril 2015 il était devenu projet de premier niveau de l'Apache Software Foundation, selon la documentation du format de fichier Apache Parquet. La description d'Apache reste la plus nette : Parquet est un format de fichier de données open source, orienté colonnes, pour un stockage et une récupération efficaces.
Pourquoi le stockage en colonnes a changé le choix par défaut
En clair, Parquet stocke les valeurs par colonne plutôt que par ligne. Toutes les valeurs order_total sont réunies. Toutes les valeurs country aussi. Cela donne deux avantages aux moteurs de requête :
Lecture sélective : ils peuvent ignorer les colonnes que votre SQL ne référence jamais.
Meilleur tassement : les valeurs similaires se compressent bien car le format peut appliquer des encodages avant la compression.
Cette combinaison convient bien aux moteurs analytiques modernes et aux formats de table lakehouse. Si vous voulez une introduction plus courte avant d'aller plus loin, digna propose un aperçu de Parquet utile.
Règle pratique : si votre charge consiste surtout en analyses, agrégations et filtres sur de grands jeux de données, Parquet correspond généralement mieux au schéma d'accès que les formats texte.
Pourquoi il s'est autant répandu
Parquet est devenu le tissu conjonctif entre les pipelines Spark, les exports d'entrepôt, les lacs de données en stockage objet et les formats de table comme Iceberg, Delta Lake et Hudi. Les équipes l'apprécient parce qu'il est ouvert, typé et largement pris en charge. Elles aiment aussi qu'il sépare le stockage physique du choix du moteur de requête. Un fichier écrit dans une partie de la pile peut souvent être lu ailleurs.
Ce « souvent » compte. La portabilité est réelle, mais elle n'est pas automatique dès que des fonctionnalités récentes et des versions de moteurs mélangées arrivent en production.
Moteur | Prise en charge native de Parquet | Usage courant |
|---|---|---|
Spark | Oui | Transformation par lots et tables lakehouse |
BigQuery | Oui | Tables externes et échange de fichiers |
Redshift Spectrum | Oui | Interrogation de données en stockage objet |
DuckDB | Oui | Analytique locale et requêtes ad hoc |
Athena | Oui | Analyses sans serveur sur des données de lac partitionnées |
À l'intérieur d'un fichier Parquet : row groups, column chunks et pages
Un fichier Parquet prend tout son sens si vous imaginez une requête d'entrepôt classique. Une analyste demande trois colonnes sur cinquante, filtrées sur la semaine dernière. Que cette requête paraisse rapide ou poussive dépend surtout de la façon dont Parquet dispose les octets dans le fichier, pas seulement du moteur SQL qui le lit.
Commencer par le row group
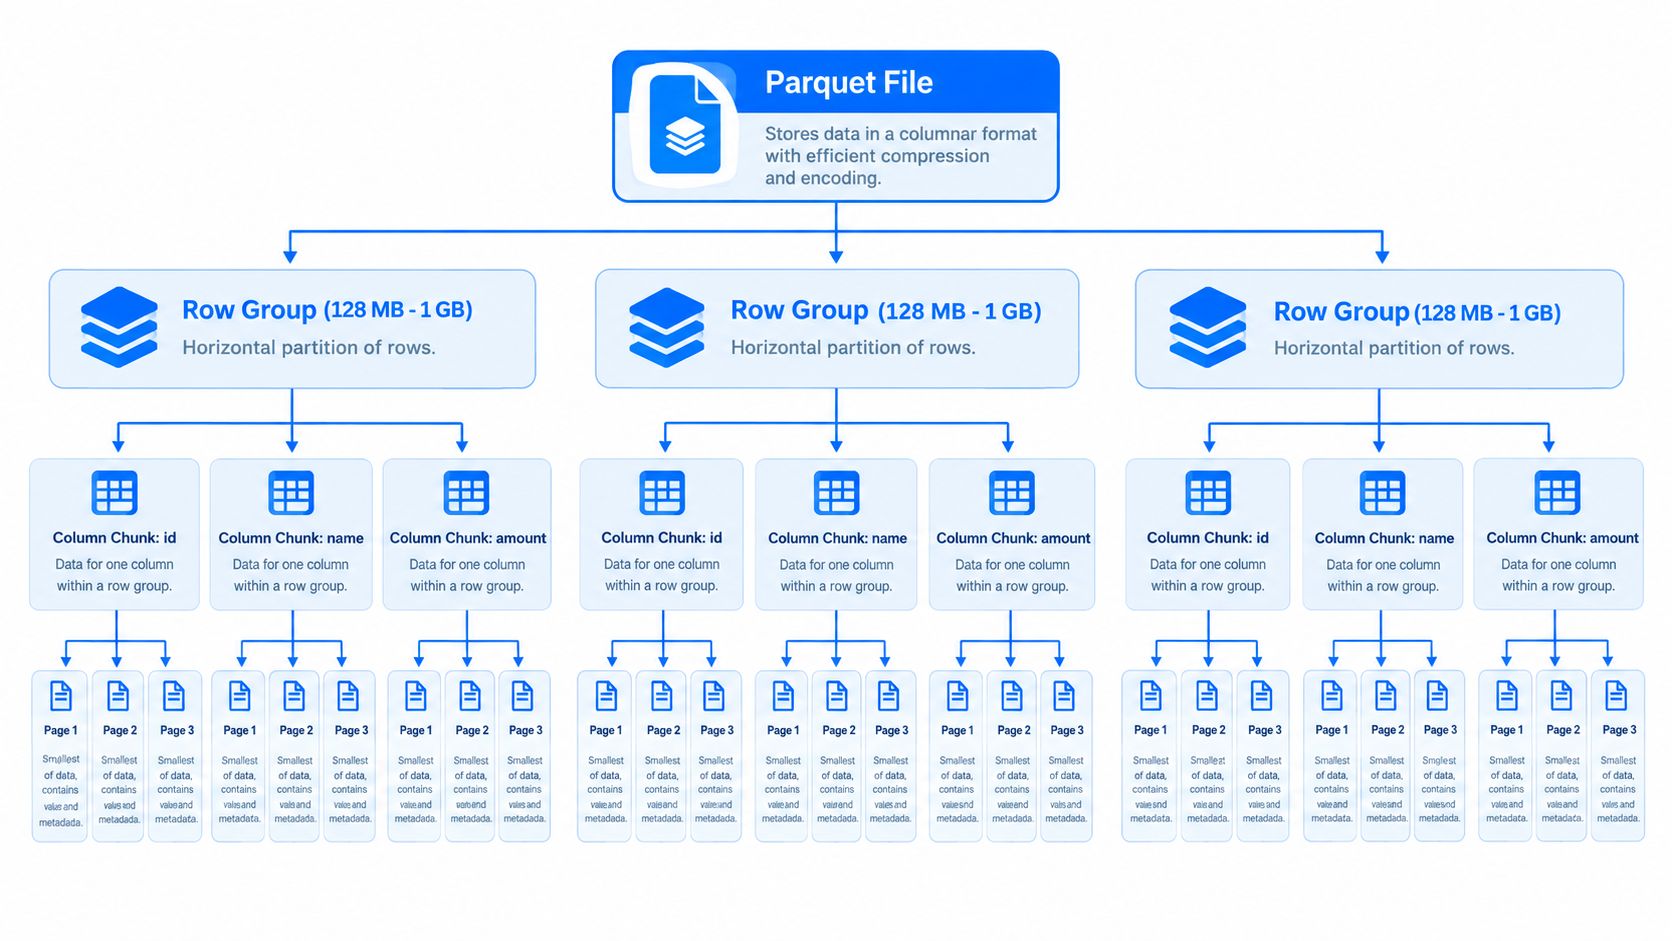
Un fichier Parquet est divisé en row groups. Chaque row group est une tranche horizontale de la table : il contient donc le même ensemble de colonnes pour un sous-ensemble de lignes.
La taille du row group façonne le comportement de lecture plus que beaucoup d'équipes ne l'imaginent. Les anciennes recommandations d'Apache Parquet préconisent de grands row groups, car des groupes plus grands créent généralement des column chunks plus grands et favorisent les E/S séquentielles. En production, cela peut aider les charges gourmandes en analyses. Cela crée aussi un arbitrage. Des row groups très grands réduisent la surcharge de métadonnées, mais peuvent rendre les lectures sélectives moins agiles, car le moteur planifie toujours au niveau du row group.
Dans chaque row group, Parquet stocke exactement un column chunk par colonne du schéma, et chaque chunk est contigu dans le fichier, comme défini dans le dépôt parquet-format. Cette disposition explique en grande partie le fonctionnement de l'élagage de colonnes. Si une requête a besoin de order_total et order_date, le moteur peut ignorer les octets de customer_notes, device_model et tout le reste.
Puis zoomer sur le column chunk et la page
Un column chunk contient les valeurs d'une colonne pour un row group. Ce chunk est ensuite découpé en pages, les unités plus petites que Parquet encode et compresse.
Les pages comptent car c'est là que les décisions de stockage deviennent concrètes. Les métadonnées de page enregistrent quel encodage et quelle compression ont été utilisés. Si une page de dictionnaire existe, elle doit apparaître en premier dans le column chunk, et il ne peut y avoir qu'une seule page de dictionnaire par column chunk, selon la documentation Apache Parquet sur les column chunks.
Un modèle mental pratique est :
Le fichier contient un objet Parquet physique.
Les row groups divisent les lignes en grands blocs.
Les column chunks stockent une colonne pour un row group.
Les pages stockent des tranches encodées et compressées de ce chunk.
L'analogie du tableur aide ici. Les row groups sont comme des bandes de lignes en travers de la feuille. Les column chunks sont les bandes verticales de chaque champ dans une bande. Les pages sont les paquets plus petits dans chaque bande, que le lecteur peut décoder morceau par morceau.
Pourquoi le pied de page détermine la planification de lecture
Le pied de page est l'endroit où Parquet garde la carte. Il stocke le schéma ainsi que les métadonnées indiquant au lecteur où se trouvent row groups et column chunks. Avant qu'un moteur puisse décider intelligemment quoi lire, il lui faut généralement ce pied de page.
Cette conception est excellente pour la planification analytique. Elle est plus faible pour l'accès ponctuel.
Si votre charge est « analyser un mois d'événements et agréger », la planification par le pied de page aide le moteur à éviter du travail. Si elle est « récupérer un enregistrement par identifiant », le lecteur doit quand même trouver et analyser le pied avant de localiser la bonne région du fichier. La documentation Parquet d'Apache Arrow note également que les données Parquet sont décodées par blocs plutôt que manipulées directement au niveau de l'octet, ce qui explique en partie pourquoi la récupération d'une seule ligne convient mal au format.
C'est l'une des lacunes de production que les explications basiques sur Parquet passent sous silence. Les équipes entendent souvent « colonnes égale rapide » puis appliquent Parquet à tous les schémas d'accès. Cela tient pour l'analytique par lots. Cela casse souvent pour les recherches pilotées par requête, les sondes de validation CDC ou les flux de débogage où un ingénieur veut une ligne tout de suite.
Le pied de page joue aussi plus tard dans les problèmes d'interopérabilité. Des moteurs différents peuvent s'accorder sur l'existence du fichier et diverger sur des métadonnées récentes, des page indexes ou des statistiques optionnelles. Quand cela arrive, le symptôme est rarement une corruption spectaculaire. Il est plus discret. Les filtres élaguent moins bien que prévu, un moteur lit plus d'octets qu'un autre, ou la latence dérive vers le haut des mois après une mise à jour de l'écrivain.
Pour l'analytique, planifier depuis le pied de page est une force. Pour les recherches ponctuelles, c'est un surcoût.
Voilà pourquoi Parquet fonctionne au mieux quand vous le traitez comme un format analytique, observez comment vos moteurs utilisent ses métadonnées et enquêtez lorsque les « octets analysés » ou le taux d'élagage des row groups se dégradent soudain.
Options d'encodage et de compression qui comptent vraiment
Les équipes confondent souvent encodage et compression, alors qu'ils résolvent des problèmes différents. L'encodage restructure les valeurs dans une page. La compression réduit ensuite le flux d'octets encodé. Dans Parquet, ces couches s'empilent.
Les encodages changent d'abord la forme des données
Parquet prend en charge des encodages au niveau page dont PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY et BYTE_STREAM_SPLIT, ainsi que des codecs de compression tels que SNAPPY, GZIP, BROTLI, ZSTD et LZ4_RAW, comme le résume la référence du format Parquet.
Ce qui compte en production, c'est la forme des données :
Les chemins de type dictionnaire aident quand les valeurs se répètent, par exemple des champs de statut, des codes pays ou des catégories de produits.
RLE fonctionne bien quand les valeurs répétées apparaissent par séries, surtout après tri.
Les encodages de type delta sont utiles quand les valeurs évoluent par incréments, comme des identifiants croissants ou des horodatages.
Byte stream split peut aider certaines charges numériques, mais la compatibilité entre outils peut être en retard.
Une évaluation empirique des formats en colonnes a constaté que l'encodage par dictionnaire agressif de Parquet offrait souvent une forte compression avec des performances de décodage raisonnables sur de nombreux types de données, et que son chemin bit-packing plus RLE décodait généralement plus vite que des approches multi-algorithmes plus complexes, selon l'article d'évaluation sur les formats en colonnes.
La compression doit correspondre à votre objectif d'exploitation
Une bonne façon de choisir un codec est de décider ce que vous optimisez :
Lectures rapides et large compatibilité : utilisez Snappy.
Stockage plus serré avec un compromis équilibré : utilisez ZSTD là où votre pile de moteurs le supporte confortablement.
Compression maximale avec lectures et écritures plus lentes : utilisez GZIP pour des jeux froids ou peu interactifs.
En bref : choisissez l'encodage selon le motif de valeurs de la colonne, puis la compression selon l'arbitrage stockage contre CPU.
Forme des données | Encodage | Compression | Pourquoi cela marche |
|---|---|---|---|
Chaînes répétées dans des journaux | Dictionary ou RLE_DICTIONARY | SNAPPY | Les valeurs répétées se compactent bien et Snappy garde un faible surcoût de décodage |
Indicateurs de statut ou codes région triés | RLE | ZSTD | Les longues séries se compressent efficacement et ZSTD équilibre en général ratio et coût de lecture |
Identifiants croissants ou horodatages ordonnés | DELTA_BINARY_PACKED | GZIP ou ZSTD | Les petits écarts s'encodent de façon compacte avant l'exécution du codec |
Colonnes de dimension mixtes à faible cardinalité | Dictionary | SNAPPY ou ZSTD | Les valeurs similaires profitent de la recherche par dictionnaire et restent portables |
Caractéristiques analytiques riches en virgule flottante | BYTE_STREAM_SPLIT là où c'est pris en charge | ZSTD | Peut améliorer la disposition numérique, mais vérifiez d'abord la prise en charge du lecteur |
La prudence porte sur la portabilité. La spécification peut autoriser un encodage que votre lecteur en aval n'implémente pas entièrement.
Comment Parquet obtient sa vitesse : predicate pushdown et élagage de colonnes
La vitesse de Parquet vient du fait de ne pas lire les données dont vous n'avez pas besoin. Cela paraît évident, mais se décompose en trois mécanismes distincts aux modes de défaillance différents.
L'élagage de colonnes fait la première coupe
Si votre table de faits compte de nombreuses colonnes et que votre SQL n'en touche que quelques-unes, le moteur peut ne lire que ces column chunks. C'est le gain le plus visible dans les systèmes analytiques. C'est aussi pourquoi les équipes qui se penchent sur l'optimisation des requêtes SQL découvrent souvent que le format de fichier et la disposition de la table comptent autant que le texte de la requête.
Concrètement, une requête comme :
n'a pas besoin des champs d'attribution marketing, des notes d'expédition ni de dizaines de dimensions inutilisées. Avec Parquet, le planificateur peut souvent éviter ces octets entièrement.
Écarter des row groups, c'est là que les choix de disposition paient
Les fichiers Parquet stockent des métadonnées qui aident les lecteurs à décider si un row group vaut la peine d'être analysé. Quand le filtre dit region = 'EMEA' et que les statistiques d'un row group ne montrent que des valeurs hors de cette plage, le moteur peut l'écarter.
L'ordre de tri compte. Si vous écrivez les lignes dans un ordre aléatoire, les statistiques min et max perdent en sélectivité. Si vous regroupez les valeurs proches, ces statistiques deviennent bien plus utiles.
Le comportement au niveau page aide, mais seulement si les données coopèrent
Les pages sont les plus petites unités pratiques dans un column chunk. Les lecteurs peuvent éviter de décoder des parties d'un chunk si les métadonnées et la logique de filtrage le permettent. Les pages encodées par dictionnaire peuvent aussi rendre les prédicats d'égalité moins coûteux, car les valeurs répétées ont déjà été normalisées en références de dictionnaire.
Cela dit, ces optimisations s'affaiblissent quand :
Les colonnes de texte libre ne se compressent ni ne s'élaguent proprement
Les champs à forte cardinalité dispersent les valeurs sur de nombreux groupes
Les recherches ponctuelles ont besoin d'une réponse minuscule issue d'un gros fichier
Les écritures non triées étalent les valeurs de filtre sur tout le jeu de données
Type de requête | Colonnes lues | Row groups analysés | Octets lus | Temps écoulé |
|---|---|---|---|---|
Analyse complète de la table | Nombreuses | La plupart ou tous | Élevé | Le plus lent |
Agrégation avec élagage de colonnes | Peu | La plupart ou tous | Plus faible | Plus rapide |
Requête analytique filtrée par prédicat | Peu | Uniquement les groupes retenus | Le plus faible des trois | Le plus rapide quand les statistiques sont sélectives |
Le piège est de supposer que Parquet est « rapide » en tout. Il est rapide pour la lecture analytique planifiée et séquentielle. Il n'est pas conçu comme un magasin de service indexé.
Parquet face à ORC, Avro, CSV et JSON
Choisir Parquet devient plus simple quand on le compare aux formats dont les équipes débattent habituellement.
Deux formats analytiques, un format ligne, deux formats d'échange
Parquet et ORC visent tous deux les analyses analytiques. Ils sont en colonnes, compressés et conçus pour des données typées. Dans la pratique générale, Parquet l'emporte plutôt sur l'ampleur de l'écosystème, moteurs et outils lakehouse confondus. ORC garde du sens dans certains environnements centrés sur Hive.
Avro est un autre animal. Il est orienté lignes et convient mieux à l'écriture enregistrement par enregistrement, à l'échange d'événements et aux pipelines riches en schéma où préserver la structure de la ligne importe plus que l'efficacité d'analyse.
CSV et JSON sont plus simples pour les humains et les outils généralistes, mais ils reportent le travail d'analyse syntaxique et de typage au moment de la lecture. Cela en fait généralement de mauvais choix à long terme pour de grands jeux analytiques.
Utilisez Parquet quand vous attendez des analyses répétées et des lectures sélectives de colonnes. Utilisez Avro quand les enregistrements transitent par des systèmes de streaming. Gardez CSV et JSON pour l'échange, le débogage ou des transmissions simples.
La vraie décision, c'est l'adéquation à la charge de travail
Beaucoup d'équipes demandent : « quel format est le plus rapide ? ». La meilleure question est : « rapide pour quoi ? ».
Analytique par lots : Parquet convient généralement le mieux.
Pile analytique très orientée Hive : ORC mérite peut-être un coup d'œil.
Enregistrements en streaming et transport d'événements : Avro est souvent plus propre.
Inspection ad hoc et large compatibilité des outils : CSV garde l'avantage.
Échange de charges utiles d'API imbriquées : JSON reste courant malgré le coût.
Format | Disposition | Efficacité de compression | Vitesse d'analyse | Évolution du schéma | Meilleure adéquation |
|---|---|---|---|---|---|
Parquet | En colonnes | Forte | Forte pour l'analytique | Bonne, avec des réserves selon les lecteurs | Lacs de données, BI, analytique par lots |
ORC | En colonnes | Forte | Forte pour l'analytique | Bonne | Environnements analytiques orientés Hive |
Avro | Orienté lignes | Modérée | Meilleur pour l'accès par ligne que pour les analyses de colonnes | Forte pour les enregistrements | Streaming, charges utiles de messages, échange |
CSV | Texte orienté lignes | Faible | Faible sur les grandes lectures analytiques | Aucune intégrée | Inspection manuelle, exports simples |
JSON | Texte semi-structuré | Faible à modérée | Faible pour les grandes analyses | Flexible mais peu contraignante | Charges utiles d'API, échange imbriqué |
Partitionnement, taille des fichiers et bonnes pratiques de stockage
Une histoire de production classique se déroule ainsi : l'équipe a choisi Parquet, les temps de requête paraissaient bons le premier mois, puis le lac s'est rempli de fichiers minuscules, de partitions inégales et de tables qu'un moteur analysait vite tandis qu'un autre peinait sur la planification. Le format a fait son travail. La disposition, non.
Choisissez des colonnes de partition sur lesquelles on filtre vraiment
Le partitionnement agit comme un sommaire grossier. Il aide les lecteurs à écarter des dossiers entiers avant même d'ouvrir des pieds de page Parquet. C'est puissant, mais seulement quand la clé de partition correspond aux vrais usages.
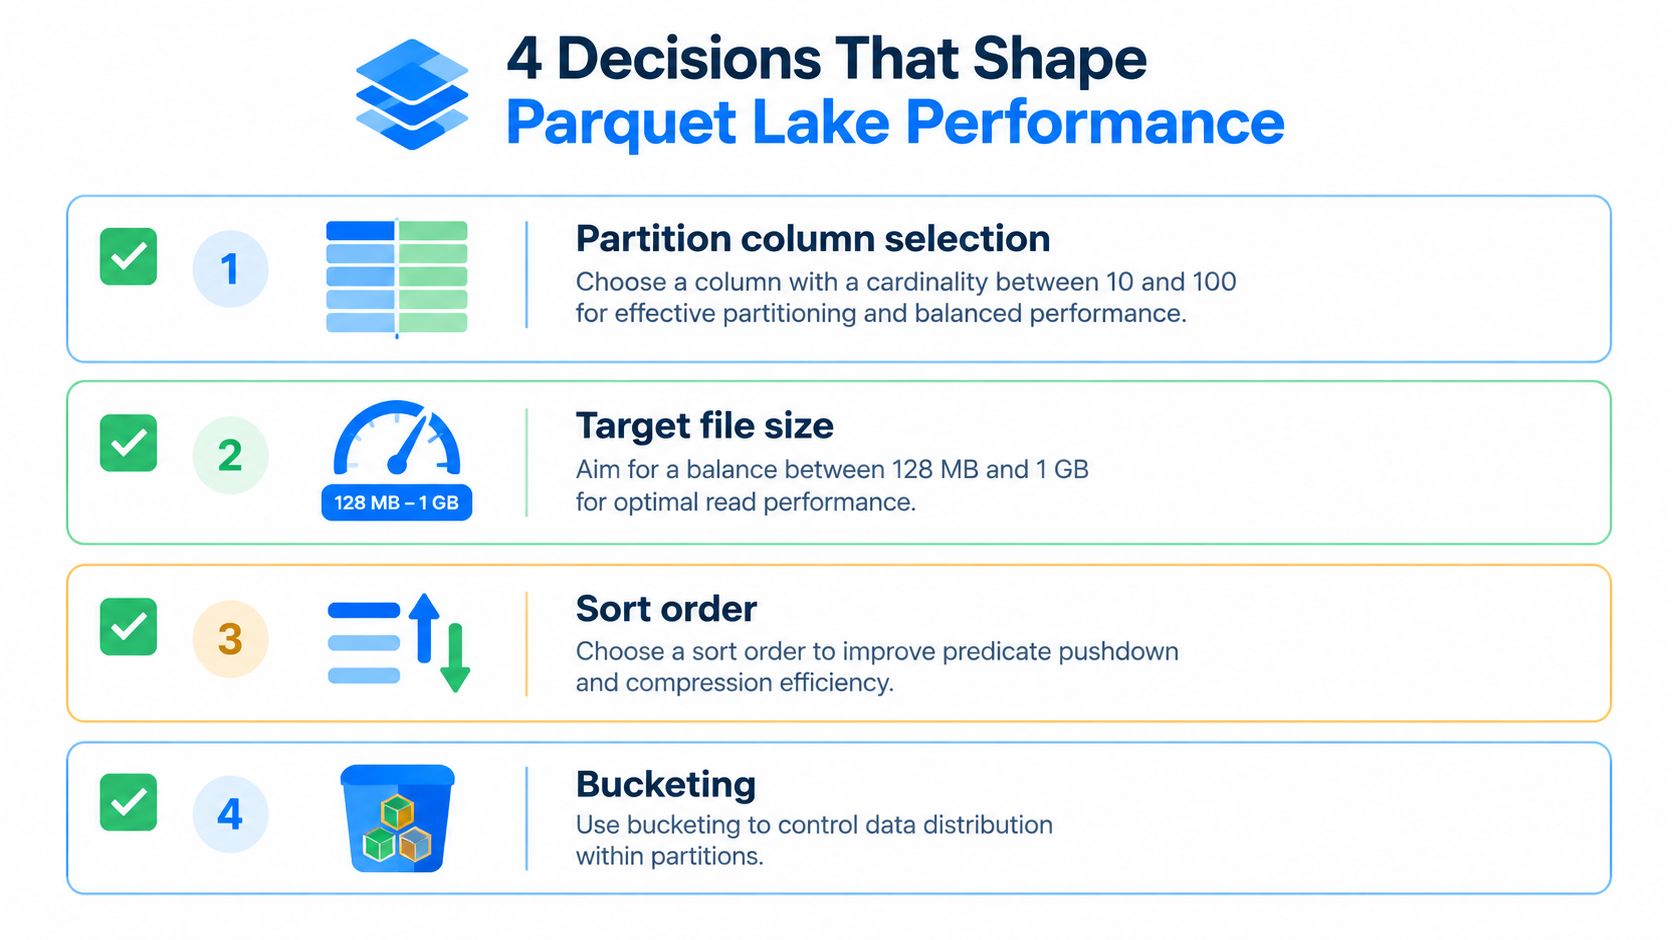
La date est le point de départ habituel, car le reporting et les reprises découpent souvent par jour, semaine ou mois. Région, environnement, palier de client ou unité métier peuvent aussi convenir si ces champs reviennent souvent dans les clauses WHERE. Une mauvaise clé présente en général l'un de deux défauts. Soit elle est trop large pour élaguer beaucoup, soit elle est si cardinale qu'elle explose en une multitude de petits dossiers et fichiers. Partitionner par identifiant utilisateur est l'erreur classique.
L'arbitrage compte plus que ne l'admettent beaucoup de guides. Un bon partitionnement accélère les lectures analytiques larges. Il fait peu pour les recherches ponctuelles, car Parquet a toujours besoin des métadonnées du pied avant de trouver le bon row group. Si votre charge comprend de fréquentes récupérations d'enregistrements, aucun schéma de partitionnement ne transformera Parquet en magasin clé-valeur.
Pour les équipes qui construisent des écrivains par lots et des travaux de compaction, ces conseils d'orchestration ETL avec Python sont un compagnon utile, car le partitionnement ne tient que si l'ordonnanceur, la logique de reprise et les sorties de l'écrivain restent cohérents dans la durée.
La taille des fichiers décide si le stockage objet paraît rapide ou pataud
La taille des fichiers est l'endroit où beaucoup de lacs se déforment. De très petits fichiers augmentent le coût de listage, les lectures de métadonnées et le temps de planification. De très gros fichiers peuvent réduire le parallélisme et rendre les reprises coûteuses. Le point idéal dépend de votre moteur, de votre réseau et de votre chemin d'écriture, mais l'objectif est d'obtenir des fichiers stables et propices à l'analyse plutôt que la taille tombée par hasard des micro-lots amont.
La taille des row groups compte aussi. De plus grands row groups améliorent souvent les lectures séquentielles et la compression, mais rendent les lectures sélectives moins précises si votre ordre de tri est mauvais. C'est pourquoi taille de fichier et ordre de tri devraient être choisis ensemble, et non comme deux réglages séparés.
Le stockage objet ajoute une couche de comportement. Un lac sur stockage compatible S3 ne se comporte pas comme un disque local aux opérations de répertoire bon marché. Les coûts apparaissent dans les appels de listage, la latence d'ouverture et l'éparpillement des petits fichiers. Cette introduction à la façon dont S3 se comporte comme système de fichiers est une référence utile pour ce modèle mental.
Surveillez quelques signaux en production : taille moyenne des fichiers par table, nombre de fichiers par partition, retard de compaction, et temps de planification par rapport au temps d'analyse. Si le temps de planification continue de grimper alors que le volume de données reste stable, la disposition des fichiers est souvent le premier endroit à examiner.
Trier et faire du bucketing aide, mais seulement aux bons endroits
Le tri est l'une des habitudes les plus rentables pour qui écrit du Parquet. Quand des valeurs proches se retrouvent ensemble, les statistiques de row group gagnent en sélectivité, la compression s'améliore et les moteurs peuvent écarter davantage de données en confiance. Si les analystes filtrent souvent sur event_date, customer_region ou un autre champ sélectif, trier sur ce champ peut rendre les métadonnées du pied bien plus utiles.
Le bucketing résout un autre problème. Il peut rendre la distribution plus prévisible dans une partition, ce qui aide certains pipelines riches en jointures. Il ajoute aussi une charge d'exploitation et n'est pas également pris en charge selon les moteurs : traitez-le comme un choix propre à la charge, pas comme un réglage par défaut.
Une checklist pratique :
Partitionnez pour les filtres courants : commencez par les champs qui reviennent systématiquement dans les prédicats.
Gardez le nombre de fichiers sous contrôle : compactez après des écritures en streaming ou très parallèles.
Triez à l'intérieur des partitions : un meilleur ordre rend les statistiques de row group dignes de confiance.
Suivez la dérive de disposition dans le temps : la multiplication des petits fichiers et le ralentissement de la planification sont des signaux précoces.
Utilisez le bucketing avec discernement : appliquez-le là où le comportement des jointures justifie le coût de maintenance.
Évolution du schéma, interopérabilité et pièges silencieux
La réputation de portabilité de Parquet n'est méritée que jusqu'à un certain point. La réalité inconfortable de la production, c'est que la spécification avance plus vite que beaucoup de piles de lecteurs.
Format ouvert ne veut pas dire prise en charge uniforme
Le matériel d'Apache sur l'état d'implémentation montre une prise en charge fragmentée par moteur et par année de publication, certaines capacités récentes n'étant pas encore largement implémentées et d'autres seulement partiellement prises en charge selon les lecteurs, d'après la page d'état d'implémentation de Parquet. Les recommandations de versions avertissent aussi que certaines fonctionnalités sont compatibles vers l'avant et d'autres non.
Cela signifie qu'un lecteur ancien pourrait encore ouvrir un fichier mais perdre des métadonnées, manquer des gains de performance ou échouer sur des encodages non pris en charge. Des travaux récents comme l'encodage adaptatif sans perte pour la virgule flottante et les nouveaux types logiques creusent l'écart entre ce que le format sait exprimer et ce que chaque moteur de votre pile consomme de façon fiable.
Le piège se révèle généralement des mois après le déploiement
Les défaillances dangereuses ne sont pas toujours bruyantes. Parfois un moteur lit un champ comme prévu, un autre renvoie des valeurs nulles, et un troisième bascule sur un chemin de décodage plus lent. Vous ne détectez pas cela dans un test rapide si tout le monde ne valide qu'avec le moteur d'écriture.
Quelques schémas de défaillance reviennent régulièrement :
Incohérences de types logiques : horodatages, décimaux et types imbriqués peuvent s'afficher différemment selon les lecteurs.
Écarts de compatibilité des encodages : les encodages récents peuvent surprendre des moteurs plus anciens.
Comportement de repli du dictionnaire : différents écrivains changent de stratégie différemment, ce qui affecte la taille des fichiers et la vitesse d'analyse.
Latence du pied de page en premier : même de toutes petites lectures paient encore le coût d'accès aux métadonnées évoqué plus haut.
Si votre équipe gère des pipelines très orientés Databricks et des consommateurs multi-moteurs, une approche dédiée de la qualité des données sur Databricks devient pertinente, car la dérive de types et le désaccord entre lecteurs apparaissent d'abord comme des incidents de qualité, pas comme des erreurs d'analyse syntaxique.
Fonctionnalité | Spark 3.5 | Trino 470 | DuckDB 1.2 | Athena |
|---|---|---|---|---|
Lecture Parquet de base | Largement prise en charge | Largement prise en charge | Largement prise en charge | Largement prise en charge |
Encodages récents | À vérifier par version | À vérifier par version | À vérifier par version | À vérifier par version |
Types logiques imbriqués | Généralement faisable, tester soigneusement | Tester soigneusement | Tester soigneusement | Tester soigneusement |
Conservation des métadonnées | Variable selon le flux | Variable selon le flux | Variable selon le flux | Variable selon le flux |
Ne demandez pas seulement « ce moteur sait-il lire Parquet ? ». Demandez « cette version précise du lecteur peut-elle lire sans risque des fichiers issus de cette configuration précise de l'écrivain ? ».
Dérive de schéma, Timeliness et observabilité des pipelines Parquet
Un pied de page Parquet n'est pas seulement une métadonnée pour le lecteur. Dans une plateforme mature, il devient une surface d'observabilité.

La dérive de schéma s'annonce d'abord dans les métadonnées
Quand un écrivain ajoute une colonne, change un type, supprime un champ ou modifie le comportement de tri, ces changements apparaissent dans les métadonnées du fichier avant que les tableaux de bord en aval n'en révèlent toute la portée. L'inspection du pied de page devient donc utile pour une détection précoce.
Les signaux de dérive courants incluent :
Champs nullable inattendus : une nouvelle colonne apparaît mais les consommateurs ne la remplissent pas de façon cohérente.
Élargissement de type : des champs de type entier deviennent des types numériques plus larges et la logique en aval change de comportement.
Champs supprimés ou renommés : les lecteurs peuvent encore réussir, mais la logique métier commence à lire des résultats plus vides.
Incohérence de partition : le nommage des répertoires et le schéma du fichier cessent de raconter la même histoire.
Timeliness et sémantique des fichiers sont liées
Les pipelines Parquet créent aussi des problèmes de fraîcheur particuliers. Une table peut sembler présente dans le stockage alors qu'une partie des fichiers est encore incomplète, en retard ou écrite avec des métadonnées incohérentes. Les écrivains en streaming peuvent laisser des sorties partielles qui égarent les consommateurs si votre plateforme marque le jeu de données « prêt » trop tôt.
C'est pourquoi les ingénieurs surveillent plus que l'heure d'arrivée. Ils inspectent aussi le nombre de fichiers, l'horodatage de modification, la cohérence de schéma entre partitions et les métadonnées de l'écrivain telles que created_by et les informations de tri.
Une façon d'opérationnaliser cela est la supervision du data lake, qui observe ensemble les signaux au niveau fichier et au niveau jeu de données plutôt que de traiter le stockage comme une boîte noire. Dans ce cadre, digna se présente comme une option pour les équipes qui veulent surveiller dans leur propre environnement les changements de schéma, la Timeliness, les anomalies et la validation sur les pipelines de lac et d'entrepôt.
Ce qu'il faut surveiller en production
Si j'accueillais une nouvelle ingénieure analytique sur un lac très orienté Parquet, je lui dirais de commencer par quatre vérifications :
Différences de pied de page entre chargements quotidiens : repérez tôt les changements silencieux de schéma.
Croissance des petits fichiers par partition : la douleur des requêtes commence souvent là.
Matrice de compatibilité lecteur-écrivain : tenez une liste explicite par version de moteur.
Timeliness liée à la disponibilité complète du jeu de données : n'alertez pas seulement sur des dossiers manquants.
Les métadonnées Parquet les plus utiles ne sont pas là pour rendre le fichier élégant. Elles sont là pour vous aider à détecter les ennuis avant que les utilisateurs ne demandent pourquoi le tableau de bord semble faux.
Parquet fonctionne bien quand votre charge correspond à sa conception, mais il exige une supervision disciplinée dès que plusieurs moteurs, écrivains et consommateurs en aval entrent en jeu. digna aide les équipes à suivre le changement de schéma, la Timeliness, la validation et le comportement des données à l'intérieur de leur propre environnement, précisément là où les problèmes de pipelines Parquet apparaissent en premier. Si votre lakehouse tourne sur Parquet et que vos incidents commencent par une dérive silencieuse plutôt que par des pannes bruyantes, cela mérite un examen.
Les métadonnées du pied rendent la dérive de schéma visible tôt, mais encore faut-il que quelqu'un la surveille : c'est le rôle d'une couche de gestion de la qualité des données posée sur le lac.
Questions fréquentes
Pourquoi Parquet est-il devenu le format en colonnes par défaut ?
Parquet est devenu le tissu conjonctif entre les pipelines Spark, les exports d'entrepôt, les lacs en stockage objet et les formats de table comme Iceberg, Delta Lake et Hudi. Les équipes l'ont adopté parce qu'il est ouvert, typé et largement pris en charge, et parce qu'il sépare le stockage physique du choix du moteur : un fichier écrit par un outil reste lisible par un autre.
Quels encodages et codecs de compression Parquet prend-il en charge ?
Parquet prend en charge des encodages au niveau page dont PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY et BYTE_STREAM_SPLIT, ainsi que des codecs comme SNAPPY, GZIP, BROTLI, ZSTD et LZ4_RAW. L'encodage restructure les valeurs dans une page ; la compression réduit ensuite le flux d'octets encodé. Choisissez le codec selon ce que vous optimisez : vitesse de lecture, coût de stockage ou débit d'écriture.
Qu'est-ce que le predicate pushdown dans Parquet ?
Le predicate pushdown permet à un lecteur d'écarter des données grâce aux métadonnées avant d'en décoder la moindre partie. Les statistiques de row group enregistrent la plage de valeurs présentes, si bien qu'un filtre sur region = 'EMEA' peut rejeter les row groups dont les statistiques prouvent l'absence de correspondance. Cela fonctionne de pair avec l'élagage de colonnes, qui retire d'abord les colonnes inutilisées.
Comment faut-il partitionner et dimensionner les fichiers Parquet ?
Partitionnez sur des colonnes sur lesquelles on filtre réellement : le partitionnement agit comme un sommaire grossier qui permet aux lecteurs d'écarter des dossiers entiers avant d'ouvrir le moindre pied de page. Côté taille, de très petits fichiers gonflent le listage et la planification tandis que de très gros réduisent le parallélisme et rendent les reprises coûteuses. Trier sur un champ sélectif affine les statistiques de row group.
L'évolution du schéma Parquet est-elle sûre d'un moteur à l'autre ?
Seulement jusqu'à un certain point. Le matériel d'Apache sur l'état d'implémentation montre une prise en charge fragmentée par moteur et par année, certaines fonctionnalités récentes n'étant que partiellement implémentées. Les défaillances dangereuses sont les silencieuses : un moteur lit un champ correctement pendant qu'un autre renvoie des valeurs nulles. Ne valider qu'avec le moteur d'écriture masque cela pendant des mois.



