Événements de Data Analytics expliqués : du suivi à la confiance
|
7
minute de lecture

Vous avez un tableau de bord qui semble calme, l'équipe continue de déployer, et pourtant, un matin, les chiffres ne correspondent pas tout à fait à ce que constatent les ventes, le produit et le support. C'est le danger invisible des data analytics events. Le code peut toujours s'exécuter, mais si le sens de l'événement dérive, le tableau de bord peut continuer à raconter une histoire qui ne correspond plus à la réalité.
C'est pourquoi des événements fiables ne sont pas seulement un problème de suivi. C'est un problème de Data Contract, et ce contrat doit être respecté par les ingénieurs, les analystes et l'entreprise. Si le modèle d'événement est vague, chaque entonnoir en aval, modèle d'attribution et pipeline de fonctionnalités hérite de cette ambiguïté. Si le modèle est clair, il devient plus facile de faire confiance au reste de l'infrastructure. Consultez l'idée connexe de données fiables en tant que données valides pour comprendre la vision globale de la qualité qui sous-tend cette confiance.
Idée clé : un événement n'est utile que lorsque sa signification reste suffisamment stable pour que les personnes et les systèmes puissent s'y fier.
La voie pratique est simple, même si les détails exigent de la discipline. Tout d'abord, comprenez ce qu'est réellement un événement. Ensuite, concevez le modèle pour qu'il s'adapte à l'évolution du produit. Après cela, éliminez les modes de défaillance courants qui corrompent les données. Enfin, continuez à valider le flux comme un contrat vivant, et non comme une simple liste de contrôle ponctuelle.
Table des matières
Introduction Pourquoi les événements analytiques renforcent ou brisent la confiance
Ce que sont réellement les Data Analytics Events et comment ils fonctionnent
Les trois parties qui comptent
De l'interaction brute au pipeline d'analyse
Concevoir un modèle d'événement qui évolue avec votre produit
Commencer par des catégories, puis nommer l'événement proprement
Décider des champs obligatoires
Les pièges courants qui corrompent les données d'événements et comment les éviter
Modèles sains versus modèles malsains
Attention aux erreurs de timing et de fuseau horaire
Valider la qualité des événements avec des contrats et des signaux observables
Cinq signaux qui révèlent différents types de problèmes
Les références de base surpassent les seuils fixes pour le trafic irrégulier
Mettre l'Observability des événements en pratique avec digna
Construire des événements analytiques fiables à long terme
Introduction Pourquoi les événements analytiques renforcent ou brisent la confiance
Un tableau de bord peut sembler sain alors que le flux d'événements sous-jacent a déjà commencé à dériver. Un chef de produit voit le graphique d'inscription. Un analyste voit le même graphique. Un ingénieur de données vérifie le pipeline et ne remarque rien d'anormal. Le piège est que le système peut être techniquement « opérationnel » alors que la signification de l'événement a glissé juste assez pour fausser les décisions.
C'est pourquoi les data analytics events constituent le fondement de presque tous les indicateurs importants. Ils alimentent les entonnoirs, les vues de rétention, les résultats d'expérimentation, l'attribution marketing, les alertes opérationnelles et les fonctionnalités de ML. Lorsque la définition de l'événement est floue, chaque équipe comble les vides différemment, et ces différences n'apparaissent souvent que lorsque quelqu'un demande pourquoi deux rapports ne concordent pas.
Le domaine lui-même a des racines profondes. La IEEE International Conference on Data Science and Advanced Analytics (IEEE DSAA) se décrit comme le premier forum de science des données, avec le soutien conjoint de l'IEEE, ACM, ASA et CCF comme décrit dans l'aperçu de l'écosystème des événements analytiques. Ce type de soutien institutionnel est un signal fort que les événements analytiques ne sont pas un sujet secondaire, ils font partie de l'infrastructure professionnelle de base du domaine.
L'autre changement est pratique. Les taux de participation aux événements dans un cadre professionnel montrent également à quel point la présence réelle diffère souvent du nombre de personnes inscrites sur la liste. Dans un benchmark de 2026, les événements en présentiel convertissent généralement environ 60 % à 70 % des invitations en participants réels, les événements virtuels en direct convertissent environ 40 % à 50 % des inscriptions en participation, et les conférences professionnelles et académiques en présentiel connaissent souvent un taux d'absence de 30 % à 40 % source. Ce même schéma s'applique au travail analytique, car les équipes doivent également planifier la déperdition entre l'intention et le comportement réel des données.
Ce que sont réellement les Data Analytics Events et comment ils fonctionnent
Une façon utile de concevoir un événement est de le voir comme un reçu pour une action. Un reçu indique ce qui s'est passé, quand cela s'est produit, avec suffisamment de contexte pour le comprendre plus tard. Sans ce contexte, un reçu n'est qu'un morceau de papier. En analyse, un simple clic, affichage, envoi ou erreur ne devient utile qu'une fois transformé en données d'événements structurées.
Les trois parties qui comptent
Chaque événement solide a besoin de trois ingrédients. L'Action vous dit ce qui s'est passé, comme un affichage de page, un clic sur un bouton ou la soumission d'un formulaire. Le Contexte vous indique où et comment cela s'est produit, comme la page, l'appareil, l'ID utilisateur ou la version de l'application. Le Temps vous indique quand cela s'est produit, ce qui importe car le moment choisi modifie souvent la signification de l'événement.
Règle pratique : si vous ne pouvez pas expliquer l'action, le contexte et le moment en langage simple, l'événement est encore trop vague pour qu'on s'y fie.
Cette structure explique pourquoi l'analyse orientée événements fonctionne pour le produit, le marketing et les opérations. Un spécialiste du marketing peut analyser le trafic d'une campagne. Un analyste produit peut inspecter un entonnoir. Un ingénieur peut tracer le parcours d'une erreur. Ils ne posent pas la même question, mais ils lisent tous le même signal sous-jacent.
De l'interaction brute au pipeline d'analyse
Le parcours commence généralement par une interaction brute dans une application ou un service. Cette interaction est capturée en tant qu'événement, envoyée via un flux ou une couche de collecte, puis stockée dans un entrepôt ou un lac de données où les analystes et les modèles peuvent l'utiliser. L'important n'est pas seulement le mouvement, c'est la cohérence de la signification à chaque étape.
Les gens confondent souvent les événements avec les entités ou les sessions. Une entité est l'élément qui vous intéresse, comme un utilisateur ou un compte. Une session est une période d'activité délimitée. Un événement est un fait unique observé. Si tout cela se mélange, les équipes commencent à surcharger les champs et le modèle devient difficile à étendre.
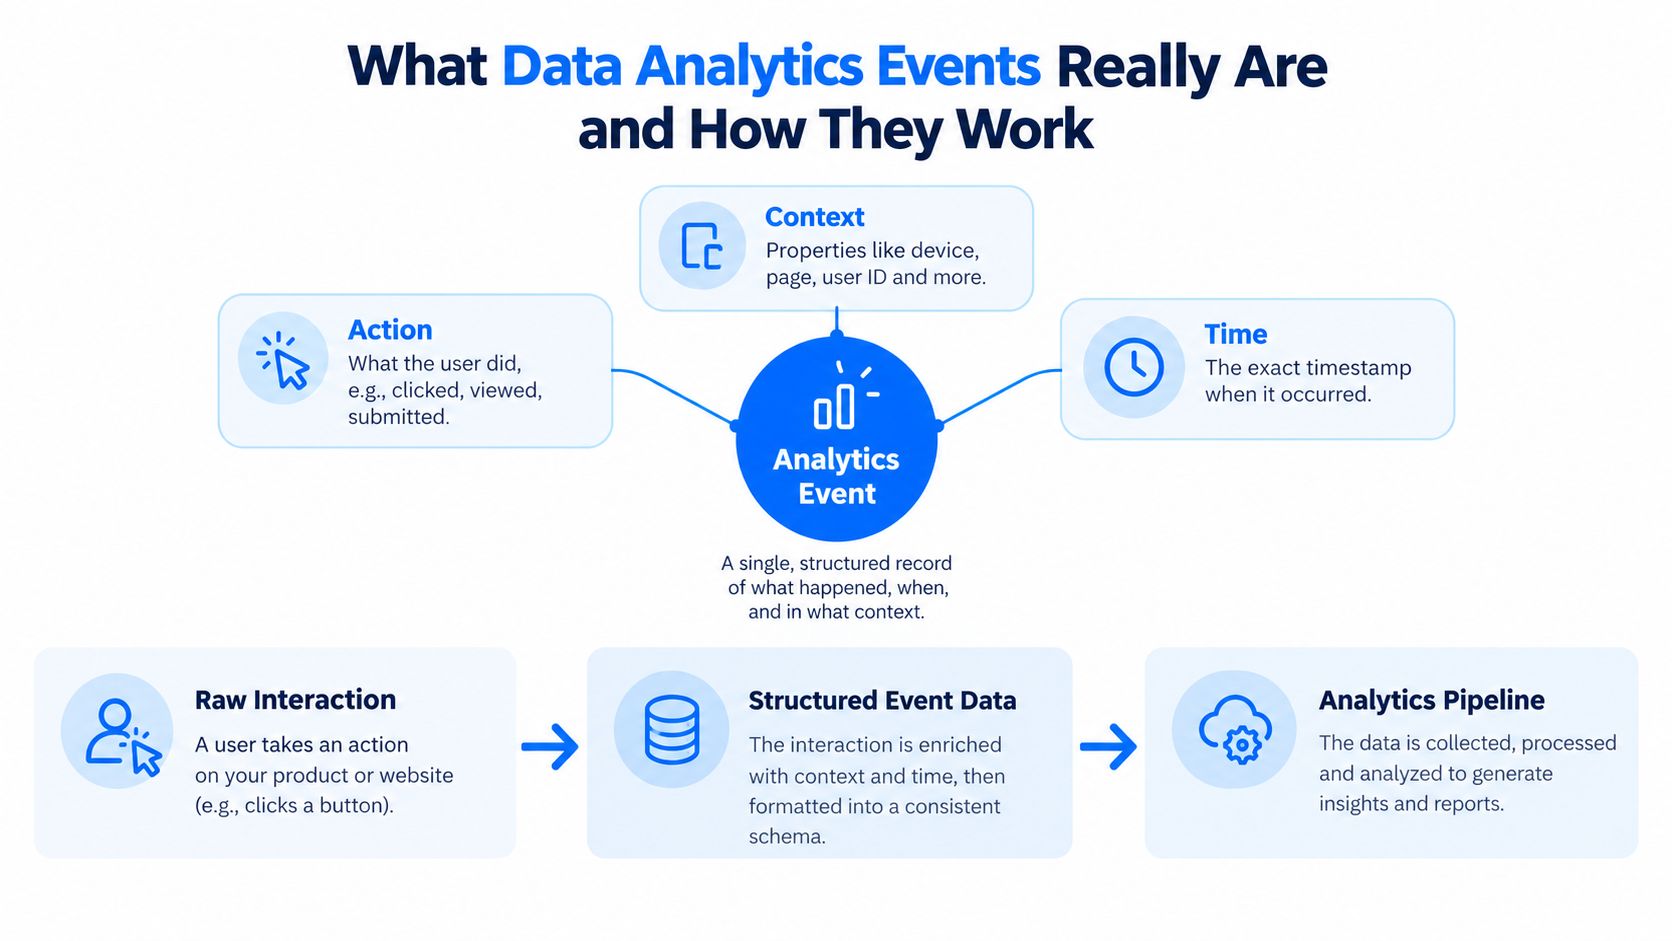
Lorsque la sémantique reste stable, le travail en aval devient plus simple. Les données d'événements peuvent alimenter les tableaux de bord, les expérimentations, les fonctionnalités de recommandation et la surveillance opérationnelle sans que chaque équipe ait à inventer sa propre version de la vérité.
Concevoir un modèle d'événement qui évolue avec votre produit
Un modèle d'événement évolutif commence par de la retenue. Les équipes veulent souvent tout instrumenter d'un coup, pour se retrouver six mois plus tard avec un catalogue encombré d'événements presque identiques que personne ne peut expliquer. Un meilleur modèle maintient une taxonomie restreinte, nomme les choses clairement et sépare ce qui s'est passé des détails environnants.
Commencer par des catégories, puis nommer l'événement proprement
Une taxonomie durable commence généralement par de larges catégories telles que les actions de l'utilisateur et les événements système. À partir de là, la convention de nommage doit rester cohérente, souvent sous la forme verbe_nom comme user_signed_up ou invoice_failed. Ce modèle aide les humains comme les machines à lire l'événement sans avoir à deviner quelle partie est l'action et quelle partie est le sujet.
La décision suivante consiste à déterminer si un détail appartient à un nouvel événement ou à une propriété. Si l'action principale est la même, mais qu'un attribut change, gardez-le comme propriété. Si l'action elle-même change de signification, créez un nouvel événement. Cette séparation évite que le modèle ne se transforme en une longue liste de cas particuliers.
Décider des champs obligatoires
Chaque événement doit comporter une liste restreinte de champs obligatoires qui rendent l'enregistrement exploitable. L'identité, l'horodatage et le contexte principal y figurent généralement. Les propriétés optionnelles peuvent apporter des précisions, mais elles ne doivent pas être requises pour l'interprétation de base, car cela fragiliserait l'instrumentation.
La résolution d'identité nécessite également une réflexion approfondie. Un utilisateur peut d'abord apparaître comme anonyme, puis authentifié plus tard. Si le modèle ne peut pas relier ces états proprement, l'analyse de l'entonnoir et les rapports sur le cycle de vie deviennent imprécis. Un même événement peut rester techniquement valide tout en étant analytiquement incomplet.
Pour les équipes qui souhaitent une structure orientée entrepôt de données, cette idée est étroitement liée à la discipline des tables de faits et de dimensions. Les événements agissent comme des faits, tandis que les champs contextuels aident les analystes à les segmenter de manière stable.

Les bons modèles d'événements facilitent les réponses aux questions futures, plutôt que d'en compliquer la formulation.
La documentation compte tout autant que le nommage. Les ingénieurs ont besoin des détails d'implémentation, et les analystes ont besoin de définitions en langage clair. Si les deux groupes lisent le même contrat, les modifications apportées aux produits cessent de générer des interprétations surprises.
Les pièges courants qui corrompent les données d'événements et comment les éviter
La plupart des problèmes d'événements ne semblent pas dramatiques au début. Le pipeline fonctionne toujours. Le tableau de bord se rafraîchit toujours. Le problème est que les données perdent de leur fiabilité au fil du temps, et la corruption tend à apparaître dans les analyses avant de se manifester dans les alertes.
Modèles sains versus modèles malsains
Modèle malsain | Pourquoi c'est néfaste | Modèle plus sain |
|---|---|---|
Nommage incohérent | Métriques divisées, jointures rompues, lecteurs confus | Nommage standardisé entre les équipes |
Propriétés manquantes | Les analystes perdent le contexte et se rabattent sur des suppositions | Champs obligatoires pour le contexte critique |
Propriétés surchargées | Un seul champ signifie trop de choses à la fois | Événements à usage unique et propriétés claires |
Double déclenchement | Les entonnoirs surcomptent, l'attribution devient confuse | Déduplication à la capture ou à l'intégration |
Valeurs par défaut implicites | La contrainte silencieuse masque le comportement réel | Valeurs explicites et règles documentées |
Le problème le plus difficile n'est généralement pas une mauvaise intention, mais la dérive. Un producteur modifie le nom d'un champ, supprime une propriété ou commence à envoyer une structure différente sans en informer l'équipe en aval. C'est pourquoi la dérive de schéma brise si souvent les pipelines de données, et pourquoi le catalogue d'événements nécessite une gestion active.
Attention aux erreurs de timing et de fuseau horaire
Les erreurs de timing sont faciles à manquer car l'événement arrive tout de même. Il arrive simplement dans la mauvaise catégorie, le mauvais jour ou avec une mauvaise interprétation du fuseau horaire. Pour les métriques opérationnelles et l'analyse de cohortes, cela peut fausser l'histoire sans pour autant bloquer la requête.
Les événements en double créent un autre type de préjudice. Un utilisateur clique une fois, mais la plateforme l'enregistre deux fois. Une étape d'entonnoir semble plus performante qu'elle ne l'est. Une fonctionnalité de modèle se retrouve gonflée. La solution ne réside généralement pas dans l'ajout de tableaux de bord, mais dans des règles de capture et une logique de validation plus claires.
Règle pratique : si un champ peut signifier deux choses différentes, divisez-le avant que l'ambiguïté ne se propage.
La méthode d'examen la plus sûre consiste à suivre chaque événement du producteur au tableau de bord et à se poser une question à chaque étape : « Cela signifie-t-il toujours la même chose ? » Si la réponse change, le contrat doit être retravaillé avant que d'autres utilisateurs ne s'y fient.
Valider la qualité des événements avec des contrats et des signaux observables
Un événement d'analyse de données doit se comporter comme un contrat dynamique. L'accord est défini avant tout déploiement, puis le pipeline vérifie en continu si les événements réels correspondent toujours à ce contrat en production. C'est autour de cette philosophie de contrat que le guide des contrats de données est construit.
Cinq signaux qui révèlent différents types de problèmes
L'observabilité moderne suit généralement la fraîcheur, la qualité, le volume, le schéma et la lignée comme indiqué dans le modèle d'observabilité. La fraîcheur vérifie si les données sont arrivées au moment prévu. La qualité demande si les valeurs et les types sont toujours cohérents. Le volume vérifie si la quantité semble normale. Le schéma contrôle si la structure a changé. La lignée montre d'où proviennent les données et comment elles ont circulé.
Chaque signal pointe vers un mode de défaillance différent. La fraîcheur détecte les livraisons tardives ou manquantes avant que les tableaux de bord ne dérivent, c'est pourquoi les fenêtres de livraison doivent correspondre à l'utilisation des données par l'entreprise comme décrit dans les conseils sur la ponctualité. La surveillance des schémas détecte les champs ajoutés, supprimés, renommés et les changements de type, ce qui est exactement ce que la surveillance de la dérive des schémas est censée mettre en évidence comme décrit dans l'aperçu de la surveillance des schémas.
Les références de base surpassent les seuils fixes pour le trafic irrégulier
Le trafic d'événements reste rarement stable. Les lancements, les campagnes et les cycles commerciaux modifient continuellement la forme du flux. Des références de base glissantes, tenant compte de la saisonnalité, fonctionnent mieux que des seuils fixes pour de nombreux flux d'événements, car elles comparent le comportement actuel à une période similaire au lieu de supposer que chaque jour devrait être identique comme recommandé dans les pratiques de détection de dérive d'événements.
La validation du contrat doit avoir lieu le plus tôt possible, idéalement lors de l'intégration. Les modifications additives peuvent être sûres lorsqu'elles préservent la compatibilité descendante. Les changements perturbateurs doivent être mis en quarantaine. Les champs bruts doivent rester disponibles lorsque la contrainte risquerait d'effacer le sens. Cette discipline réduit les ruptures silencieuses et empêche le bruit des alertes de se propager au sein de l'équipe comme décrit dans les conseils sur les contrats de flux d'événements.
Signal | Ce qu'il résout | Quelle défaillance il peut révéler |
|---|---|---|
Fraîcheur | Est-ce arrivé à temps ? | Chargements tardifs, livraisons manquées |
Qualité | Les données sont-elles valides ? | Mauvais types, valeurs invalides |
Volume | Le volume est-il conforme ? | Lots manquants, pics de doublons |
Schéma | La structure a-t-elle changé ? | Champs ajoutés, supprimés, renommés |
Lignée | D'où cela vient-il ? | Source floue, transformation masquée |
Le but n'est pas de multiplier les règles. Il s'agit de rendre le comportement des événements suffisamment visible pour que les analystes et les ingénieurs puissent faire confiance aux données sans avoir à lire chaque ligne de log.
Mettre l'Observability des événements en pratique avec digna
Rendre la qualité des événements opérationnelle signifie traiter le pipeline comme un système actif, et non comme un actif statique. Les équipes ont besoin d'un moyen de surveiller les délais de livraison, de détecter les changements de structure et de signaler les comportements inhabituels sans avoir à configurer une règle distincte pour chaque ensemble de données.
digna y parvient en s'exécutant directement dans l'environnement du client et en effectuant les validations directement dans la base de données, de sorte que les données ne bougent pas. Son ensemble de modules comprend la Timeliness, le suivi des schémas, la Data Validation et la détection des Data Anomalies, avec un tableau de bord partagé pour les ingénieurs, les analystes et les parties prenantes de la governance. Cette configuration est essentielle car un même flux d'événements doit souvent alimenter simultanément les rapports, les alertes et les entrées de modèles.
Pour les équipes qui recherchent une référence opérationnelle plus large, l'aperçu de la Data Observability montre comment ces éléments s'articulent dans les environnements de production. L'idée de base est simple. Les contrôles de ponctualité vérifient les fenêtres de livraison attendues. Le suivi des schémas détecte les champs ajoutés ou supprimés ainsi que les changements de type. La détection des anomalies peut apprendre les comportements normaux et signaler les écarts sans règles conçues manuellement.
Cette combinaison est particulièrement utile lorsque les équipes produit déploient fréquemment. Une modification qui semble anodine dans une pull request peut tout de même modifier la forme d'un événement, retarder un flux ou fausser les calculs en aval. La surveillance permet de détecter l'impact là où il est crucial, directement sur le chemin réel des données.
Si vous comparez des outils opérationnels pour des systèmes riches en événements, les outils de marché de prédiction polybacktest constituent une référence connexe utile sur la manière dont la logique d'observabilité s'applique à d'autres flux de travail orientés événements. La leçon générale s'applique parfaitement, car les données d'événements deviennent fiables lorsque la qualité est mesurée en continu, et non simplement supposée après le déploiement.
Construire des événements analytiques fiables à long terme
Les événements fiables ne se produisent pas par hasard. Ils découlent d'une succession de décisions, depuis la première définition d'une action jusqu'aux contrôles qui maintiennent cette définition intègre au fil du temps. Si un seul maillon est faible, c'est l'ensemble de la structure analytique qui en pâtit.
La façon la plus simple de prioriser est de se poser trois questions. Quels événements guident les décisions les plus importantes ? Quels sont ceux les plus susceptibles de dériver au fur et à mesure de l'évolution du produit ? Lesquels manquent d'un propriétaire clairement défini ? Corrigez ceux-là en priorité, car ce sont les événements les plus susceptibles de causer des dommages analytiques invisibles.
La responsabilisation importe tout autant que les outils. Les ingénieurs doivent savoir qui approuve les modifications de schéma. Les analystes doivent savoir quelles définitions sont stables. Les équipes de governance ont besoin de visibilité sur ce qui a changé et quand. Lorsque ces rôles sont clairs, la qualité des événements cesse d'être le problème de tout le monde pour devenir un processus managé.
Le bénéfice à long terme ne se limite pas à des tableaux de bord plus propres. C'est une analyse plus rapide, moins de retouches et une plus grande confiance lorsque les équipes utilisent l'analyse pour orienter les produits et les systèmes d'IA. Si votre catalogue d'événements vous semble encore fragile, auditez les définitions, renforcez les contrats et placez l'observabilité sur le chemin critique avant que la prochaine dérive silencieuse ne se produise en production.
Si vous recherchez un moyen pratique de renforcer la confiance dans vos données d'événements, visitez digna et découvrez comment sa validation en base de données, son suivi des schémas, sa surveillance de la ponctualité et sa détection des anomalies s'intègrent dans un flux de travail opérationnel unique. Il est conçu pour les équipes qui ont besoin que les événements analytiques fiables le restent au fur et à mesure de l'évolution des produits, des pipelines et des utilisateurs.
Questions fréquentes
Qu'est-ce qu'un événement d'analytique ?
Un reçu d'action. Tout événement solide a besoin de trois ingrédients : l'action, le contexte et le moment. Si vous ne pouvez pas expliquer ces trois éléments en langage clair, l'événement reste trop flou pour être digne de confiance, quoi qu'en dise le plan de tracking.
En quoi un événement diffère-t-il d'une entité ou d'une session ?
Un événement consigne qu'une chose s'est produite à un instant, une entité décrit une chose qui persiste, une session regroupe l'activité dans une fenêtre. Les confondre est une erreur de modélisation fréquente, et c'est pourquoi les métriques en aval cessent de concorder.
Comment nommer et structurer les événements ?
Commencez par la retenue. Bâtissez une taxonomie durable à partir de catégories larges comme les actions utilisateur et les événements système, puis décidez délibérément si un nouveau détail mérite un événement ou une propriété. Chaque événement a aussi besoin d'une courte liste de champs obligatoires qui rendent l'enregistrement exploitable.
Pourquoi les données d'événements dérivent-elles ?
Parce que le sens change plus vite que le code de tracking. Un événement reste techniquement présent pendant que sa sémantique glisse en dessous : les tableaux de bord paraissent calmes alors que les chiffres cessent de correspondre à ce que voient les ventes, le produit et le support. Un événement n'est utile que si son sens reste stable.
Pourquoi la résolution d'identité demande-t-elle de la réflexion ?
Parce qu'elle décide si les événements concernant la même personne se rejoignent réellement. Fixez les champs d'identité requis au moment de concevoir le modèle plutôt que de les rapiécer ensuite, et documentez la décision : ici, la documentation compte autant que le nommage.



