Détection des anomalies de base de données : Un guide pratique
|
9
minute de lecture

Le premier signe est rarement une défaillance spectaculaire. Un tableau de bord des revenus reste vert, le nombre de lignes semble normal et personne n'appelle l'équipe de l'entrepôt, mais un changement silencieux en amont a déjà poussé une partie des données vers un chemin de secours ou modifié la forme d'un flux. Le temps que la finance remarque que les prévisions sont fausses, les mauvaises lignes ont déjà fait leur chemin dans les modèles, les rapports et les diapositives de la direction.
C'est pourquoi la détection des anomalies de base de données fonctionne mieux lorsque vous traitez l'entrepôt lui-même comme la surface surveillée. La question utile n'est pas seulement de savoir si un graphique semble étrange, mais si la Timeliness, la forme et la distribution des données correspondent toujours à la référence dont dépendent vos utilisateurs. En pratique, cela signifie une extraction de caractéristiques native SQL, une comparaison de référence proche de la source et une alerte qui comprend le contexte au lieu de hurler à chaque pic attendu.
Table des matières
Extraction des caractéristiques de détection avec SQL en base de données
Choisir entre les références statistiques et l'apprentissage basé sur l'IA
Création de références de similarité de segments pour les charges de travail répétitives
Détecter la dérive des schémas et les retards de livraison comme un seul signal
Concevoir des alertes sensibles au contexte auxquelles les gens font vraiment confiance
Intégrer la détection des anomalies de base de données dans votre pile d'Observability
Quand la dérive silencieuse des données brise vos rapports
Une équipe financière peut faire confiance au même tableau de bord quotidien des revenus pendant des semaines et pourtant se tromper. Un seul renommage de schéma en amont, une seule branche dans une transformation ou un seul changement de type dans une table source peut faire basculer des lignes dans un chemin par défaut, de sorte que le tableau de bord s'affiche toujours et que les chiffres semblent toujours nets. Le problème est que le dénominateur est désormais partiel et que l'organisation fait des prévisions basées sur une tranche filtrée de la réalité.
Les vérifications de tableaux de bord et les assertions de type dbt ne suffisent pas. Le nombre de lignes peut rester dans une plage normale alors que les ID de clients actifs dérivent vers le bas, un pipeline peut arriver en retard sans s'interrompre complètement, ou une colonne auparavant remplie peut commencer à afficher des valeurs NULL au mauvais endroit. Aucun de ces schémas ne déclenche systématiquement une règle simple, mais tous peuvent fausser les décisions.
Une approche native de l'entrepôt détecte le problème à la source. Au lieu d'attendre que les utilisateurs en aval remarquent que quelque chose ne va pas, la détection des anomalies de base de données compare l'état actuel des données avec le comportement normal de cette table, de cette métrique ou de ce pipeline. Cela inclut la structure, la fraîcheur et la distribution des valeurs, et pas seulement la réussite du travail.
Règle pratique : si les données ont changé d'une manière qu'un tableau de bord ne peut pas expliquer seul, votre couche de détection doit se trouver là où les données sont produites, et non trois outils en aval.
La leçon historique est claire. Les premières analyses comparatives montraient déjà que la qualité de la détection des anomalies dépend fortement des données, et une analyse ultérieure à une échelle bien plus grande a confirmé ce point avec une couverture beaucoup plus large, testant 30 algorithmes sur 57 ensembles de données de référence et 98 436 expériences pour étudier le niveau de supervision, le type d'anomalie et les conditions de bruit (référence ADBench). La raison pour laquelle cela compte dans les entrepôts est simple : les charges de travail diffèrent, les schémas dérivent et les références qui fonctionnent sur un ensemble de données peuvent échouer dans des environnements de type production.
Extraction des caractéristiques de détection avec SQL en base de données
Le moyen le plus rapide de rendre la détection des anomalies utile est de conserver l'ingénierie des caractéristiques à l'intérieur de l'entrepôt. Si vous exportez d'abord les tables brutes vers un magasin de caractéristiques distinct, vous ajoutez de la latence, de la duplication et un autre endroit où la fraîcheur peut s'altérer avant même que le détecteur ne s'exécute. SQL sait déjà comment calculer les signaux dont vous avez besoin, alors utilisez-le.
Commencer par des fenêtres glissantes et des deltas
Pour la plupart des vérifications d'entrepôt, je commence par des agrégations glissantes sur des fenêtres de 7 jours et 28 jours. Les fonctions de fenêtrage comme AVG, STDDEV et COUNT vous donnent une référence locale sans quitter la base de données, et LAG plus des diffs simples montrent directement le changement d'une période à l'autre dans la requête. Cette combinaison détecte le déclin progressif, les sauts soudains et les changements qui n'apparaissent que lorsque vous comparez aujourd'hui avec le même point du cycle précédent.
Les percentiles comptent aussi. Une moyenne peut rester stable alors que la médiane se déplace, en particulier dans les données commerciales asymétriques, c'est pourquoi PERCENTILE_CONT aide à détecter la dérive que les vérifications basées sur la moyenne manquent. Les méthodes statistiques classiques telles que l'écart-type, l'écart absolu médian, l'écart interquartile, le score z et le score z modifié restent utiles car elles sont transparentes et peu coûteuses à calculer sur une table active (méthodes statistiques classiques).
Si une métrique est suffisamment importante pour faire l'objet d'une alerte, elle est suffisamment importante pour être calculée à côté des données, et non après un export par lots.
Un schéma pratique ressemble à ceci, sur une table de faits avec un grain composite :
Partitionner par jour et par métrique, afin que chaque signal ait son propre historique.
Calculer des références glissantes pour la moyenne, la dispersion et le nombre.
Ajouter des deltas décalés pour les variations d'un jour à l'autre et d'une semaine à l'autre.
Persister le résultat dans une table de caractéristiques que les tâches en aval peuvent lire sans tout recalculer.
Schéma SQL | Fonction utilisée | Signal mis en évidence |
|---|---|---|
Référence glissante | AVG, STDDEV, COUNT | Tendance locale, volatilité et volume manquant |
Delta de période | LAG, soustraction | Changements par paliers et régression soudaine |
Dérive de la médiane | PERCENTILE_CONT | Déplacement de distribution masqué par les moyennes |
C'est également là que l'exécution en base de données est payante sur le plan opérationnel. Vous évitez de copier des téraoctets vers un autre système et vous gardez la logique de détection proche du signal de fraîcheur. Pour une comparaison architecturale de ce schéma, voir la note interne sur l'exécution de la qualité des données en base de données et les pipelines externes plus sûrs.
Choisir entre les références statistiques et l'apprentissage basé sur l'IA
Les références statistiques restent le bon point de départ pour de nombreuses tables de production. Une moyenne mobile plus l'écart-type, l'écart absolu médian, l'écart interquartile et les scores z sont faciles à expliquer, faciles à auditer et faciles à exécuter en SQL. Ils fonctionnent particulièrement bien lorsqu'une métrique est stable, que la saisonnalité est faible et que l'entreprise souhaite un seuil clair plutôt qu'une boîte noire.
La faiblesse apparaît dès que la série devient désordonnée. Les cycles hebdomadaires, les effets des jours fériés et les interactions multivariées rendent les seuils fixes fragiles, et l'ajustement manuel se transforme en corvée de maintenance. C'est pourquoi les références apprises existent. Elles peuvent absorber plus de contexte, mieux gérer la saisonnalité et modéliser des relations entre des colonnes ou des tables qu'une simple règle univariée ne verrait pas.
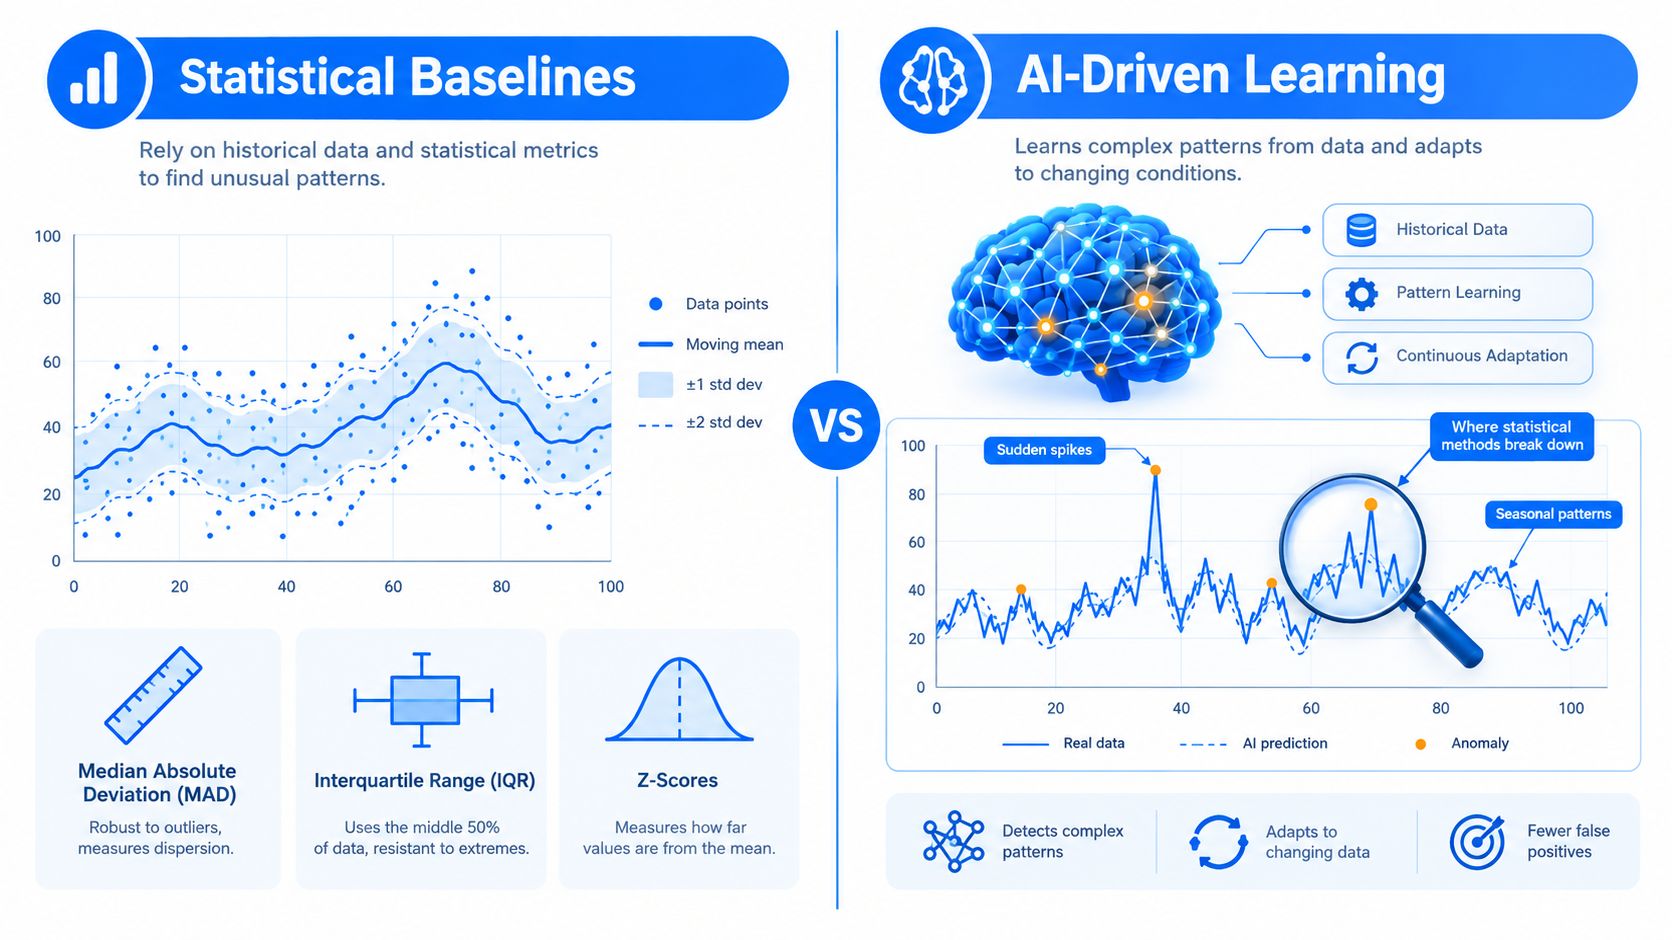
Le compromis est opérationnel, pas seulement mathématique. Les modèles appris introduisent un pipeline d'entraînement, du versioning et une dérive dans le modèle lui-même. Ils rendent également l'explicabilité plus difficile lorsque quelqu'un demande pourquoi une alerte au niveau de la ligne ou de la métrique s'est déclenchée, ce qui est un vrai problème dans les environnements réglementés où les équipes ont besoin de preuves défendables, pas seulement d'un score.
Un cadrage de référence utile est le suivant. Les méthodes statistiques capturent souvent environ 60 à 70 % des anomalies univariées avec un taux de faux positifs proche de zéro sur des métriques stables, tandis que les références apprises peuvent atteindre un rappel de 85 % mais nécessitent plus d'ajustements. Ce sont des points de référence internes, pas des promesses universelles, mais ils correspondent à ce que la plupart des praticiens constatent lorsqu'ils passent de seuils ajustés manuellement à une détection basée sur des modèles.
Si vous voulez un point de départ pratique, utilisez des références statistiques pour les seuils par métrique et des modèles appris superposés pour les séries à forte valeur et à forte variance. Cette approche s'aligne sur la division plus large de l'industrie entre règles explicables et modèles adaptatifs, et c'est aussi pourquoi des ressources comme la détection des anomalies par l'IA dans les opérations sociales sont des lectures utiles même si votre cas d'utilisation est un entrepôt plutôt qu'une file d'attente d'événements clients. Pour un cadrage statistique plus approfondi, le matériel interne sur la reconnaissance de formes statistiques est un bon compagnon.
Création de références de similarité de segments pour les charges de travail répétitives
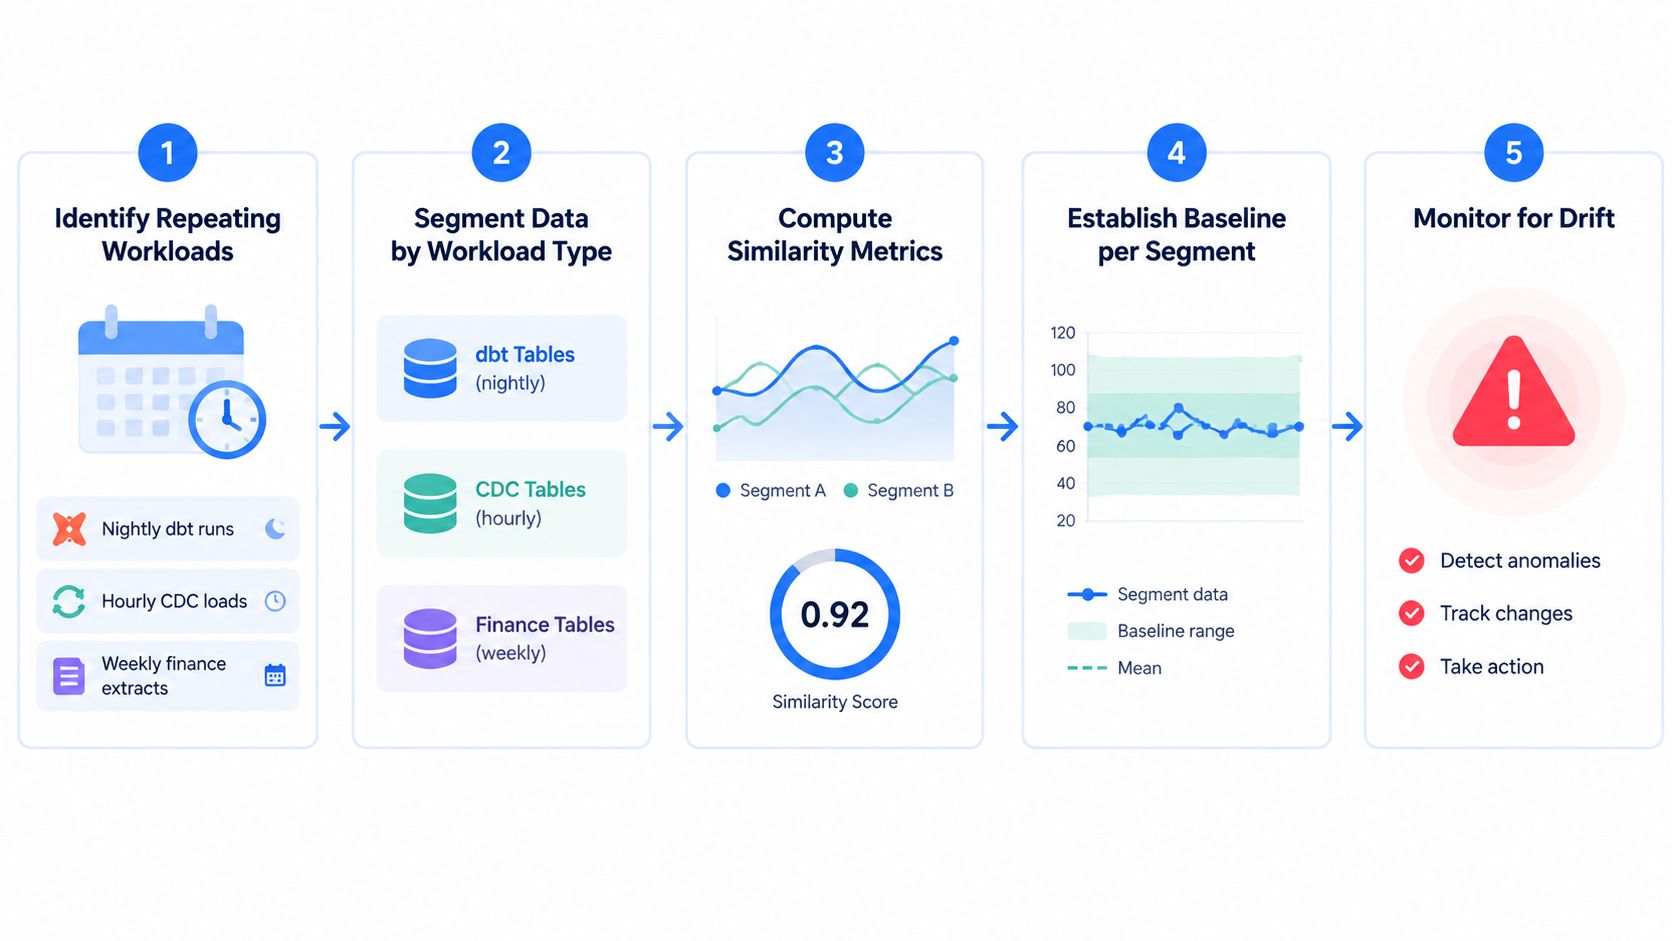
Les charges de travail répétées ont besoin d'une référence différente de celle des métriques actives en permanence. Les exécutions d'une tâche dbt nocturne, les chargements CDC horaires et les extractions financières hebdomadaires ont tous une cadence, de sorte que la bonne comparaison n'est généralement pas « aujourd'hui par rapport à une moyenne générique », mais « aujourd'hui par rapport au segment historique le plus similaire ». C'est ainsi que vous séparez une dérive réelle d'un rattrapage du lundi ou d'un pic du Black Friday.
Empreinte de chaque exécution en SQL
Commencez par générer une empreinte de chaque exécution terminée dans l'entrepôt. J'inclus généralement le nombre de lignes, un hachage des distributions des colonnes clés, les ratios de valeurs nulles et quelques résumés numériques de PERCENTILE_CONT ou d'un équivalent d'entrepôt. Ces valeurs vous donnent une représentation compacte de la charge de travail sans avoir à passer toute la table dans le détecteur.
Stockez ces empreintes dans une table baseline_segments indexée par job_id, day_of_week et hour_of_week. Comparez ensuite la fenêtre actuelle aux K segments antérieurs les plus similaires à l'aide d'une mesure de similarité sur le vecteur d'empreinte. Si la similarité tombe en dessous d'un seuil d'examen, tel que 0,85, l'exécution mérite un examen humain avant de contaminer les utilisateurs en aval.
La logique est simple, mais l'avantage est subtil. Vous ne demandez pas si la charge de travail est « normale » dans l'abstrait. Vous demandez si elle se comporte comme son propre groupe de pairs historiques, ce qui est bien plus adapté aux entrepôts où la saisonnalité fait partie du fonctionnement normal.
Une référence qui ignore la cadence générera toujours trop d'alertes sur un comportement périodique sain.
La partie difficile réside dans les références qui deviennent obsolètes. Lorsqu'une charge de travail évolue légitimement, la bibliothèque d'empreintes doit être invalidée et reconstruite, sous peine de comparer indéfiniment un nouveau comportement à un historique obsolète. C'est un problème de governance autant qu'un problème de modélisation, et il appartient au même pipeline d'observabilité que le travail lui-même.
Pour une référence pratique sur la segmentation du comportement des données reproductibles, le guide interne sur les techniques de profilage des données est pertinent ici.
Détecter la dérive des schémas et les retards de livraison comme un seul signal
La plupart des piles de surveillance séparent les changements structurels de la fraîcheur. Cette séparation est pratique, mais elle masque les ruptures. Un changement de schéma peut arriver à temps et tout de même casser le casting en aval, tandis qu'un fichier en retard peut sembler inoffensif jusqu'à ce qu'il se répercute sur un rapport obsolète et un SLA manqué.
Traiter la structure et la fraîcheur ensemble
Pour la dérive de schéma, comparez le schéma entrant d'aujourd'hui à un schéma de référence et classifiez les différences. Les ensembles concrets sont les colonnes manquantes (Β\I), les nouvelles colonnes (I\B) et les incohérences de types dans les champs partagés (modèle de détection de dérive de schéma). Si des colonnes manquantes ou des incohérences de types apparaissent, vous faites face à un changement perturbateur. Si seules de nouvelles colonnes apparaissent, le changement est additif.
La Timeliness doit se situer à côté de cette vérification, et non en dessous. Un moniteur de fraîcheur peut classer chaque livraison comme en avance, en retard, manquante ou partielle, et un calendrier peut être explicite, par exemple chaque jour de la semaine avant 7h30 (surveillance de la Timeliness des données). Lorsque l'heure d'arrivée réelle dérive trop par rapport aux prévisions, l'état de la livraison fait partie de l'alerte, et non d'un tableau de bord distinct que personne n'ouvre.
Type de signal | Ce qu'il détecte | Source SQL principale | Latence d'alerte typique |
|---|---|---|---|
Dérive de schéma | Colonnes ajoutées, supprimées ou dont le type a changé | Diffs INFORMATION_SCHEMA | Immédiat lors de l'intégration |
Retard de livraison | Chargements tardifs, manquants, en avance ou partiels | Horodatages d'arrivée et tables de fraîcheur | En cas de non-respect du calendrier |
Rupture combinée | Changement structurel et régression de la fraîcheur | Vérifications conjointes du schéma et de la fraîcheur | Près du temps réel |
Un exemple concret rend la valeur évidente. Si un fournisseur élargit une colonne de caractères à VARCHAR(500) et qu'un transtypage numérique en aval commence à échouer sur une partie des lignes, la vérification du schéma doit se déclencher avant que le rapport ne soit généré. Une vérification uniquement basée sur le volume attendrait probablement le lendemain, ce qui est trop tard pour un tri opérationnel.
C'est le genre de cas où une plateforme comme digna peut être utilisée comme une option parmi d'autres, car elle combine la Timeliness, le suivi des schémas et les vérifications en base de données dans un modèle opérationnel unique. L'explication interne sur la dérive des schémas et les changements structurels qui brisent les pipelines de données correspond bien à ce modèle.
Concevoir des alertes sensibles au contexte auxquelles les gens font vraiment confiance
Plus d'alertes ne signifie pas une meilleure détection. Cela signifie généralement une fatigue d'alerte, et une fois qu'une équipe est assaillie de notifications bruyantes, l'alerte utile est ignorée au même titre que les notifications inutiles. Une équipe qui reçoit 40 notifications Slack par jour commencera à désactiver les canaux, et c'est ainsi que les véritables pannes se cachent à la vue de tous.
La solution est l'alerte sensible au contexte. Supprimez les fenêtres de déploiement connues avec une table deploy_event, réduisez la gravité lorsqu'un écart correspond à un changement de lot planifié et exigez un deuxième signal de confirmation avant d'appeler l'astreinte. Cette confirmation peut être une autre métrique, un changement de schéma ou une régression de la fraîcheur, selon la charge de travail.
Le contenu lui-même doit expliquer l'alerte. Incluez le segment de référence utilisé, le score z ou la valeur de similarité, et les principales caractéristiques contributives afin que l'ingénieur puisse effectuer un tri rapide. Si la personne d'astreinte doit reconstituer le contexte à partir de trois tableaux de bord différents, l'alerte n'est pas prête pour la production.
Règle pratique : si un ingénieur ne peut pas comprendre l'alerte en moins d'une minute, l'alerte est trop succincte.
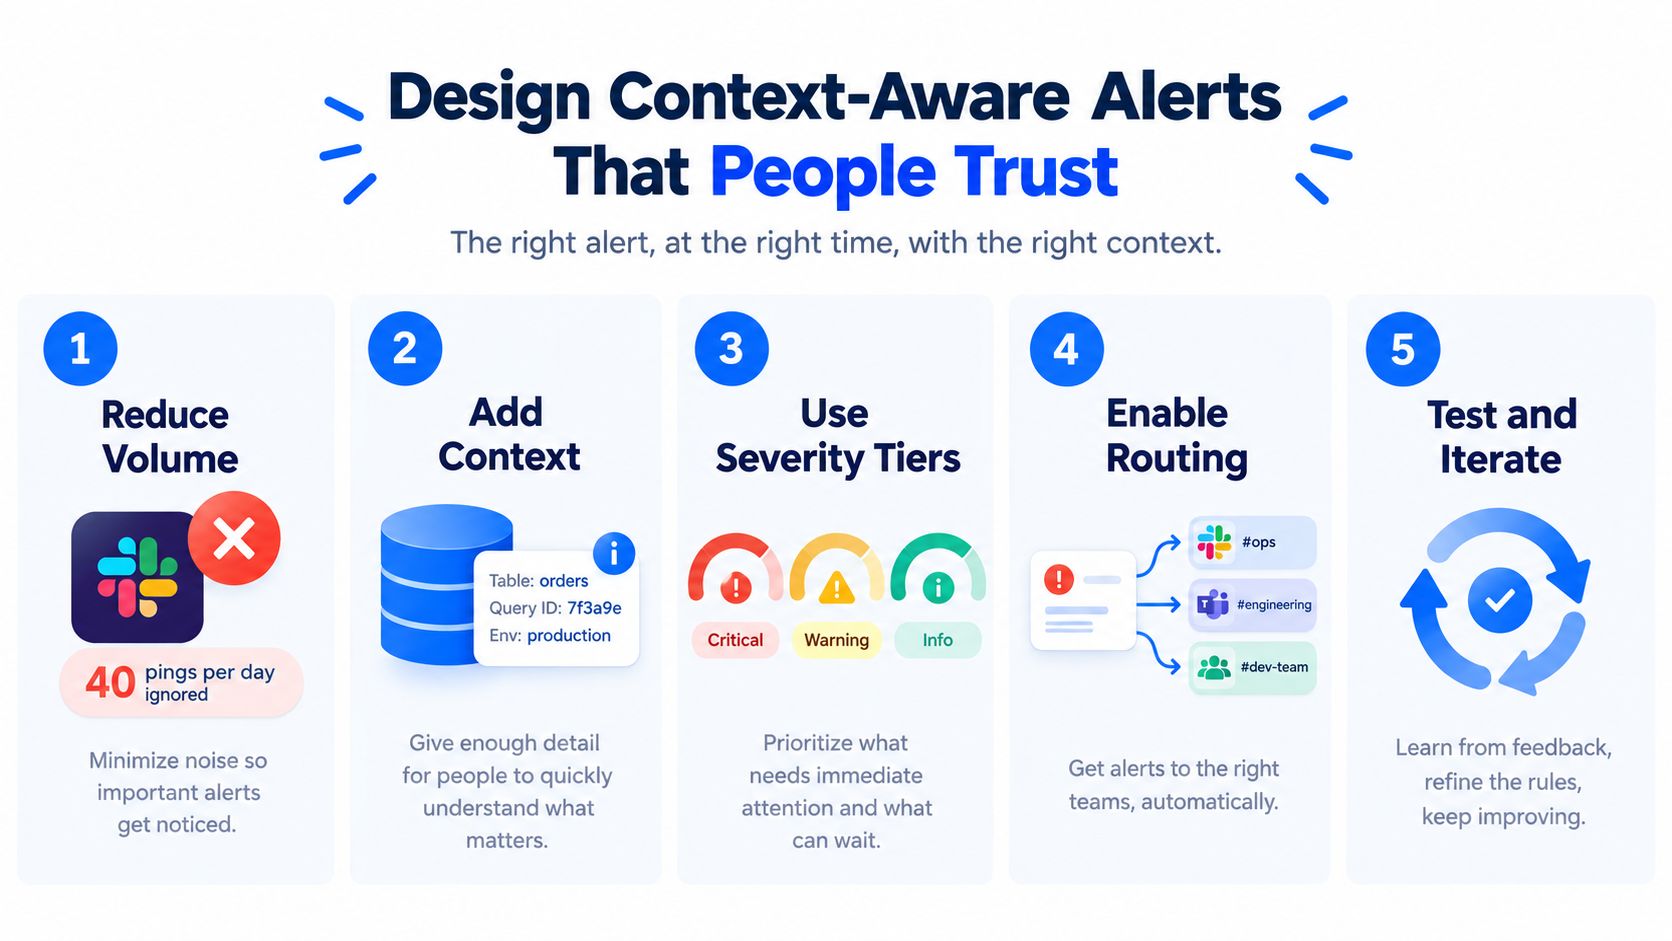
L'objectif opérationnel devrait être inférieur à 5 alertes à signal fort par semaine et par table critique, la confiance étant mesurée par le taux d'alertes ignorées plutôt que par le nombre total d'alertes. Ce cadrage déplace la conversation de « Combien d'alertes avons-nous déclenchées ? » à « Quelles alertes valaient la peine de réveiller quelqu'un ? » Pour en savoir plus sur la façon dont les équipes opérationnelles acheminent et interprètent ces signaux, l'article de Sift AI sur la détection des anomalies dans les opérations sociales est un bon point de comparaison, même si le domaine est différent.
Intégrer la détection des anomalies de base de données dans votre pile d'Observability
Les signaux d'anomalie ne devraient pas vivre sur un tableau de bord isolé. Traitez-les comme de la télémétrie, étiquetez-les avec table, schema et run_id, et poussez-les dans le même chemin d'observabilité que les métriques d'application et d'infrastructure. De cette façon, un chargement défectueux, un déploiement et un pic d'erreurs d'infrastructure se retrouvent dans la même chronologie d'incident au lieu de trois outils différents.
Connecter l'entrepôt au flux d'incidents
Les planificateurs natifs de l'entrepôt sont généralement les endroits les plus propres pour exécuter les requêtes de caractéristiques. Les tâches Snowflake, les requêtes planifiées BigQuery, les tests dbt et les capteurs Airflow correspondent tous au schéma, tant que la cadence correspond aux attentes de fraîcheur des données. L'événement d'anomalie peut ensuite transiter via OpenTelemetry ou un exportateur natif vers PagerDuty, Slack ou tout autre portail d'alerte canonique auquel l'équipe d'astreinte fait déjà confiance.
Le compromis est évident. Les collecteurs REST basés sur l'interrogation (pull) sont simples, mais ils sont lents. Les émetteurs basés sur les événements lors de la finalisation de l'écriture détectent les problèmes plus rapidement, mais ils créent un couplage entre le producteur et le chemin de surveillance, ce qui signifie qu'une plus grande discipline d'ingénierie est requise concernant les tentatives, la déduplication et la responsabilité.
Un ordre de déploiement pratique aide à garder cela gérable :
Premièrement, calculer les caractéristiques en SQL et les persister.
Deuxièmement, étiqueter chaque événement avec l'actif de données et les métadonnées d'exécution.
Troisièmement, acheminer les alertes vers un flux d'incidents unique et canonique.
Quatrièmement, corréler les anomalies avec les déploiements, les drapeaux de fonctionnalités et les tâches ETL en amont.
Enfin, affiner l'acheminement pour que seules les alertes au signal le plus fort atteignent les humains.

La présentation interne de l'Data Observability est pertinente ici car elle présente la détection des anomalies comme une partie d'un système d'exploitation plus large, et non comme un générateur d'alertes autonome. C'est le bon modèle mental pour les entrepôts de production, et c'est celui qui évite aux gens de créer un autre tableau de bord bruyant que personne ne gère.
Si vous mettez en production la détection des anomalies de base de données, commencez par les vérifications qui vivent au plus près des données, puis superposez le contexte, l'explicabilité et l'acheminement. digna prend en charge la détection des anomalies en base de données, la surveillance de la fraîcheur, le suivi des schémas et les flux de travail d'observabilité au sein de l'environnement propre du client, ce qui convient aux équipes qui souhaitent que la logique de détection se trouve là où les données résident déjà. Visitez digna pour voir comment cette approche s'applique à votre entrepôt, vos pipelines et votre pile d'alerte.
Questions fréquentes
Qu'est-ce que la détection d'anomalies en base de données ?
Traiter l'entrepôt lui-même comme la surface surveillée plutôt que d'inspecter des tableaux de bord trois outils plus loin. Si la donnée a changé d'une manière qu'un tableau de bord ne peut expliquer seul, la couche de détection doit se trouver là où la donnée est produite.
Quelles caractéristiques SQL extraire en premier ?
Des agrégats glissants sur des fenêtres de 7 et 28 jours, calculés par jour et par métrique pour que chaque signal garde son historique. Ajoutez des deltas décalés pour les variations jour à jour et semaine à semaine, utilisez les percentiles pour les glissements de distribution que les moyennes masquent, et persistez le résultat dans une table de features.
Quelle fonction SQL attrape quelle défaillance ?
Trois appariements couvrent l'essentiel. AVG, STDDEV et COUNT donnent une ligne de base glissante révélant tendance locale, volatilité et volume manquant. LAG avec soustraction donne des deltas de période révélant les ruptures. PERCENTILE_CONT donne la dérive de la médiane et attrape les glissements que les moyennes cachent.
Quand les lignes de base statistiques cèdent-elles la place aux modèles appris ?
Les lignes de base statistiques restent le bon point de départ pour beaucoup de tables en production, et leur faiblesse apparaît dès que la série devient bruitée, avec saisonnalité, cycles de livraison ou effets de segment. Les benchmarks confirment que la qualité de détection dépend fortement des données.
A-t-on la preuve que le choix d'algorithme compte ?
Oui, et il compte moins que les données. Le benchmark ADBench a testé 30 algorithmes sur 57 jeux de référence au fil de 98 436 expériences, en étudiant le niveau de supervision, le type d'anomalie et le bruit, et a confirmé que la qualité dépend fortement des données plutôt que d'un vainqueur unique.



