Des données fiables sont des données valides : un guide pratique
|
7
minute de lecture
C'est lundi matin. Le tableau de bord exécutif est vert, les revenus semblent stables et le pipeline de nuit s'est terminé sans erreur. Mardi après-midi, un chef de produit découvre que les taux de conversion sont erronés depuis trois jours parce qu'un changement de schéma en amont a modifié la gestion des valeurs nulles. Rien n'a échoué sur le plan opérationnel. Le flux de travail s'est déroulé comme prévu et a fourni les données à temps. Les données elles-mêmes n'étaient plus valides.
Cette distinction est à l'origine de certains des incidents les plus coûteux dans les plateformes de données modernes. Des données fiables sont des données valides, mais un pipeline qui fonctionne de manière cohérente ne produit pas automatiquement des enregistrements dignes de confiance. La fiabilité de la production dépend du fait que les données restent correctes, actuelles, structurellement compatibles et adaptées à la décision qu'elles soutiennent.
Table des matières
Modes de défaillance courants qui brisent la confiance dans les données
Comment la Timeliness et la stabilité des schémas complètent le tableau
Contrôles pratiques pour assurer à la fois la validité et la fiabilité
Pourquoi la Data Validation statique ne suffit pas pour les plateformes de données modernes
Quand des données fiables échouent au test de validité
La première alerte n'est généralement pas une alerte. C'est une question sur Slack.
« Pourquoi la conversion a-t-elle chuté pour un canal ? »
Le tableau de bord indique toujours une mise à jour réussie. L'orchestration des tâches ne signale aucun échec. Les volumes de lignes semblent plausibles et l'entrepôt a accepté chaque enregistrement. Une comparaison rapide révèle qu'un service en amont a modifié la représentation des valeurs manquantes. La transformation s'est tout de même exécutée, mais sa logique de jointure et d'agrégation a traité ces valeurs différemment. Un indicateur qui semblait stable a été calculé sur la base d'une signification modifiée.
C'est le fossé dangereux entre la fiabilité du pipeline et la validité des données. Un pipeline fiable peut mener à bien chaque tâche planifiée tout en fournissant des enregistrements qui violent le sens métier. Un ensemble de données valides peut également devenir opérationnellement non fiable s'il arrive trop tard, s'il arrive de manière incomplète ou s'il change de forme sans avertissement.
Un pipeline au vert peut tout de même être erroné
La surveillance de base répond souvent à des questions opérationnelles :
La tâche a-t-elle démarré ?
S'est-elle terminée ?
L'entrepôt de données a-t-il accepté la requête ?
La tâche attendue a-t-elle produit un résultat ?
Le tableau de bord s'est-il actualisé ?
Ces vérifications sont importantes, mais elles ne permettent pas de savoir si un identifiant client correspond toujours au bon client, si un horodatage appartient à la période de rapport prévue ou si un code de statut reste conforme au vocabulaire métier approuvé.
La validité est le contrôle qui relie un traitement réussi à un résultat significatif. IBM décrit la validité comme une dimension distincte de la qualité des données impliquant le format, le type, la plage et les contraintes des règles métier, tout en soulignant que des données plausibles peuvent tout de même être invalides lorsqu'elles violent les attentes structurelles ou sémantiques dans son explication des dimensions de la qualité des données.
Une adresse e-mail malformée, un âge négatif, un code inattendu ou une clé de jointure nulle peuvent passer l'ingestion car la couche de stockage le permet. Les modèles et rapports en aval héritent ensuite de ce défaut. Plus l'enregistrement voyage loin, plus il devient difficile d'en identifier la cause d'origine.
Règle pratique : Une exécution réussie prouve que le logiciel a terminé son travail. Elle ne prouve pas que le résultat mérite d'être cru.
Le risque pour l'entreprise est substantiel. Un article du MIT Sloan Management Review de 2017 citait des recherches estimant que les mauvaises données coûtent à la plupart des entreprises 15 % à 25 % de leur chiffre d'affaires en faussant les décisions, les rapports et les performances financières (référence MIT Sloan Management Review). Cette estimation aide à comprendre pourquoi la validité relève des contrôles d'entreprise, et pas seulement des listes de vérification techniques.
Comprendre la validité et la fiabilité des données
Un pipeline peut se terminer avec succès à 2 heures du matin et publier des données inutilisables à l'heure du petit-déjeuner. Un champ peut être analysé, une tâche peut passer au vert et un tableau de bord peut s'actualiser alors que les enregistrements violent les règles qui leur donnent du sens. Validité et fiabilité décrivent différents contrôles pour intercepter cette défaillance.
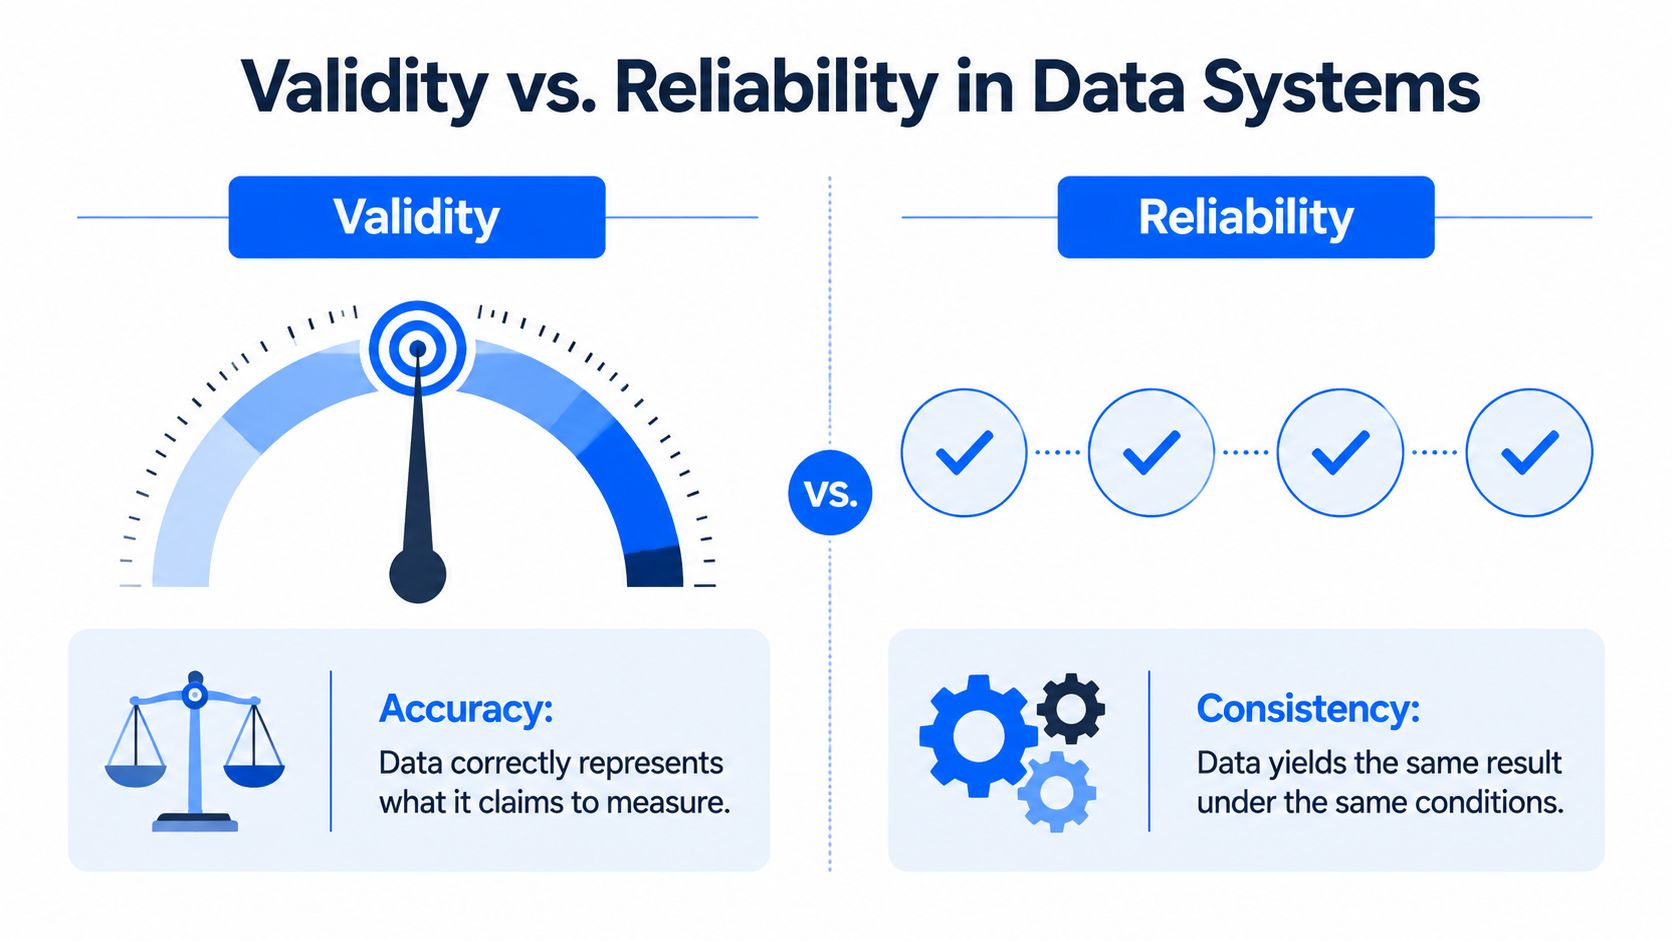
La validité consiste à se demander si un enregistrement représente bien ce qu'il prétend représenter et s'il est conforme aux règles applicables aux données acceptables. La fiabilité consiste à se demander si les résultats restent cohérents dans le temps et dans des conditions de mesure changeantes. La référence aux normes statistiques des Nations Unies traite les deux comme des propriétés liées mais distinctes.
Une balance qui indique systématiquement 2 kg de trop est fiable car elle produit des résultats reproductibles, mais elle n'est pas valide car ses mesures s'écartent du poids réel. Une balance qui fluctue de manière aléatoire n'est ni fiable ni valide.
Ce que signifie la validité en production
Dans une plateforme de données, la validité va bien au-delà de la simple plausibilité d'une valeur. Les ingénieurs vérifient généralement :
La conformité du type : Les champs numériques contiennent des nombres, les dates sont correctement analysées et les identifiants conservent leur représentation requise.
La conformité de la plage : Les valeurs restent dans des limites inférieures et supérieures cohérentes.
La conformité du format : Les e-mails, les codes, les numéros de téléphone et les horodatages correspondent aux modèles acceptés.
L'intégrité référentielle : Les clés étrangères mènent à des enregistrements dans la bonne table de dimension ou de référence.
La conformité aux règles métier : Les champs liés concordent entre eux et avec le processus qu'ils décrivent.
Un âge client de 37 ans peut être exact et valide. Un âge négatif est invalide même si la base de données l'accepte. Un horodatage peut correspondre au format requis tout en représentant le mauvais événement parce qu'un système en amont a appliqué un fuseau horaire inattendu.
La distinction entre exactitude et validité est importante en production. L'exactitude concerne la conformité d'une valeur avec la réalité. La validité concerne sa conformité avec le Data Contract et la conception de la mesure. Une valeur peut sembler raisonnable et échouer à une règle qui protège l'interprétation en aval. Le guide de validité des données explique comment les équipes peuvent évaluer cette distinction en pratique.
Pourquoi la fiabilité exige plus que de la cohérence
La fiabilité comprend une disponibilité digne de confiance, une livraison complète et une arrivée dans le délai requis pour prendre une décision. Un pipeline qui répète la même transformation défectueuse chaque nuit est cohérent, mais son résultat n'est pas une preuve fiable. Des enregistrements valides qui arrivent après une réunion de planification peuvent également être inutilisables.
Les indicateurs de gouvernance mondiale de la Banque mondiale compilent des données standardisées de sources multiples pour plus de 200 économies de 1996 à 2024, en utilisant 35 sources transnationales telles que des enquêtes auprès des ménages, des entreprises et des évaluations d'experts. Les comparaisons entre marchés nécessitent des données qui restent structurellement valides et produites de manière cohérente.
L'Observability relie ces propriétés sur le plan opérationnel. Les vérifications de fraîcheur, les alertes de changement de schéma, le suivi des volumes et les tendances d'échec des règles montrent si des enregistrements valides continuent d'arriver selon un modèle fiable. « Le pipeline est fiable » devrait décrire le comportement de livraison. « Les données sont valides » devrait décrire la conformité et la signification. La confiance dans la production exige les deux.
Modes de défaillance courants qui brisent la confiance dans les données
Un pipeline peut passer les vérifications d'ingestion et corrompre l'ensemble de données plus tard. Les défaillances apparaissent généralement lorsque les enregistrements rencontrent des transformations, des jointures, des règles métier ou des structures en amont en évolution. Les contrôles de production doivent tester ces interactions, et pas seulement des champs isolés.
Dérive de schéma silencieuse
Un service en amont ajoute, supprime, renomme ou modifie le type d'un champ. Le consommateur peut continuer à s'exécuter parce que la requête s'analyse toujours ou qu'une charge utile flexible accepte le changement. Une transformation peut alors mapper le mauvais champ, abandonner un nouveau statut ou modifier le comportement des valeurs nulles sans générer d'erreur opérationnelle. Les conseils sur la dérive de schéma de digna décrivent comment les changements structurels peuvent impacter les consommateurs sans être détectés.
Propagation de valeurs nulles
Une clé de jointure requise devient nulle dans une petite partie des enregistrements entrants. Les vérifications de schéma et de type au niveau de la source réussissent toujours, mais la jointure exclut ces enregistrements. Les tables de faits perdent les lignes associées et les agrégats sont sous-estimés sans qu'il y ait d'échec d'ingestion clair. Les vérifications de distribution et la surveillance des correspondances de jointure peuvent révéler cet écart.
Incohérences de fuseaux horaires
Un horodatage peut rester syntaxiquement valide alors que son interprétation de fuseau horaire change. Les agrégations horaires, quotidiennes ou mensuelles attribuent alors les événements à la mauvaise période. Un validateur de format approuve la valeur même si sa signification analytique a changé. La surveillance devrait comparer les hypothèses de fuseau horaire et le comportement aux limites, en particulier autour des heures limites de rapport.
Doubles livraisons
La diffusion en continu (streaming) de type « au moins une fois » peut livrer un événement plusieurs fois. La validation au niveau de la ligne approuve chaque copie car chaque enregistrement est individuellement valide. Sans idempotence ni déduplication, les agrégats de revenus, d'activité et de transactions se retrouvent gonflés. Les identifiants d'événements et les alertes de taux de doublons fournissent un contrôle au niveau des événements métier.
Dimensions périmées
Un enregistrement de fait peut contenir une clé d'apparence valide qui est absente de la table de dimension actuelle. La validation de schéma standard ne montre pas que les données de référence sont anciennes. Après la jointure, les analystes peuvent voir des catégories inconnues, des attributs manquants ou une segmentation rompue. Les vérifications d'intégrité référentielle et de fraîcheur des dimensions capturent différentes facettes du problème.
Mode de défaillance | Ce que la validation de base intercepte | Ce qui se brise en production |
|---|---|---|
Dérive de schéma silencieuse | La capacité d'analyse et les types de champs attendus | Les transformations, jointures ou mappages utilisent une structure modifiée |
Propagation de valeurs nulles | Le type de colonne et le format de base | Les jointures excluent des enregistrements et les totaux en aval deviennent incomplets |
Incohérence de fuseau horaire | La syntaxe de l'horodatage | Les fenêtres de séries chronologiques attribuent les événements à la mauvaise période |
Double livraison | La validité de la ligne individuelle | Les agrégats comptabilisent plusieurs fois le même événement métier |
Dimensions périmées | La structure de la table de faits | Les jointures de référence perdent des attributs ou créent des clés non résolues |
La leçon opérationnelle est directe : la validité des enregistrements est nécessaire mais pas suffisante. Les tests doivent également observer les relations, les distributions, le comportement de livraison et les changements structurels. L'Observability relie ces vérifications aux résultats en montrant si un ensemble de données valides continue d'arriver dans la forme, le volume et les délais attendus. Sans cette vision, les équipes valident des éléments individuels tout en passant à côté d'une défaillance du système.
Comment la Timeliness et la stabilité des schémas complètent le tableau
Un enregistrement peut passer toutes les règles de validation lors de sa création tout en étant erroné pour la décision qu'il soutient. Si l'instantané d'inventaire d'hier arrive après l'exécution de l'allocation d'aujourd'hui, ses types, ses plages et ses règles métier peuvent tous être valides. L'ensemble de données reste inadapté car il ne représente plus l'état opérationnel actuel.
La fraîcheur est donc une contrainte de validité temporelle. La surveillance doit vérifier que les données attendues sont arrivées, qu'aucun lot ne manque et que les enregistrements les plus récents restent dans la fenêtre opérationnelle convenue. Ce guide sur la timeliness des données, les métriques et la surveillance explique comment rendre cette fenêtre mesurable. Un guide pratique pour la surveillance de la fraîcheur offre la même approche opérationnelle : « les données doivent être à jour » doit devenir une condition qui peut réussir, échouer et déclencher une action.
Trois axes pour la mise en production
Évaluez chaque ensemble de données critiques selon trois axes connectés :
L'exactitude : Les valeurs respectent les exigences de type, de format, de plage, de relation et de règles métier.
La fraîcheur : Les données arrivent dans la fenêtre de livraison convenue et reflètent l'état pertinent de l'activité.
La stabilité structurelle : Les champs, les types, les tables et les relations restent compatibles avec les systèmes consommateurs.
Un ensemble de données peut satisfaire un axe tout en échouant sur un autre. Un export client peut contenir des enregistrements corrects mais arriver après le début d'une campagne. Un flux de streaming peut arriver en continu tout en dupliquant des événements. Une table peut conserver son schéma même après qu'une source a modifié la signification d'un code de statut.
La stabilité du schéma est un contrat actif
Les changements de schéma nécessitent une évaluation d'impact, pas un rejet automatique. Une nouvelle colonne pouvant être nulle peut être sans danger pour les consommateurs qui ignorent les champs inconnus. Une colonne supprimée, un champ renommé ou un changement de type peuvent briser une transformation ou modifier subtilement son résultat.
L'Observability relie la fraîcheur, la dérive de schéma, les variations de volume et les échecs de pipeline au lieu de les traiter comme des alertes isolées. La discussion d'Ataccama sur la qualité des données et l'observabilité des données décrit la fraîcheur comme la récence, la dérive de schéma comme un changement structurel et les anomalies de volume comme des changements inattendus dans la taille des ensembles de données.
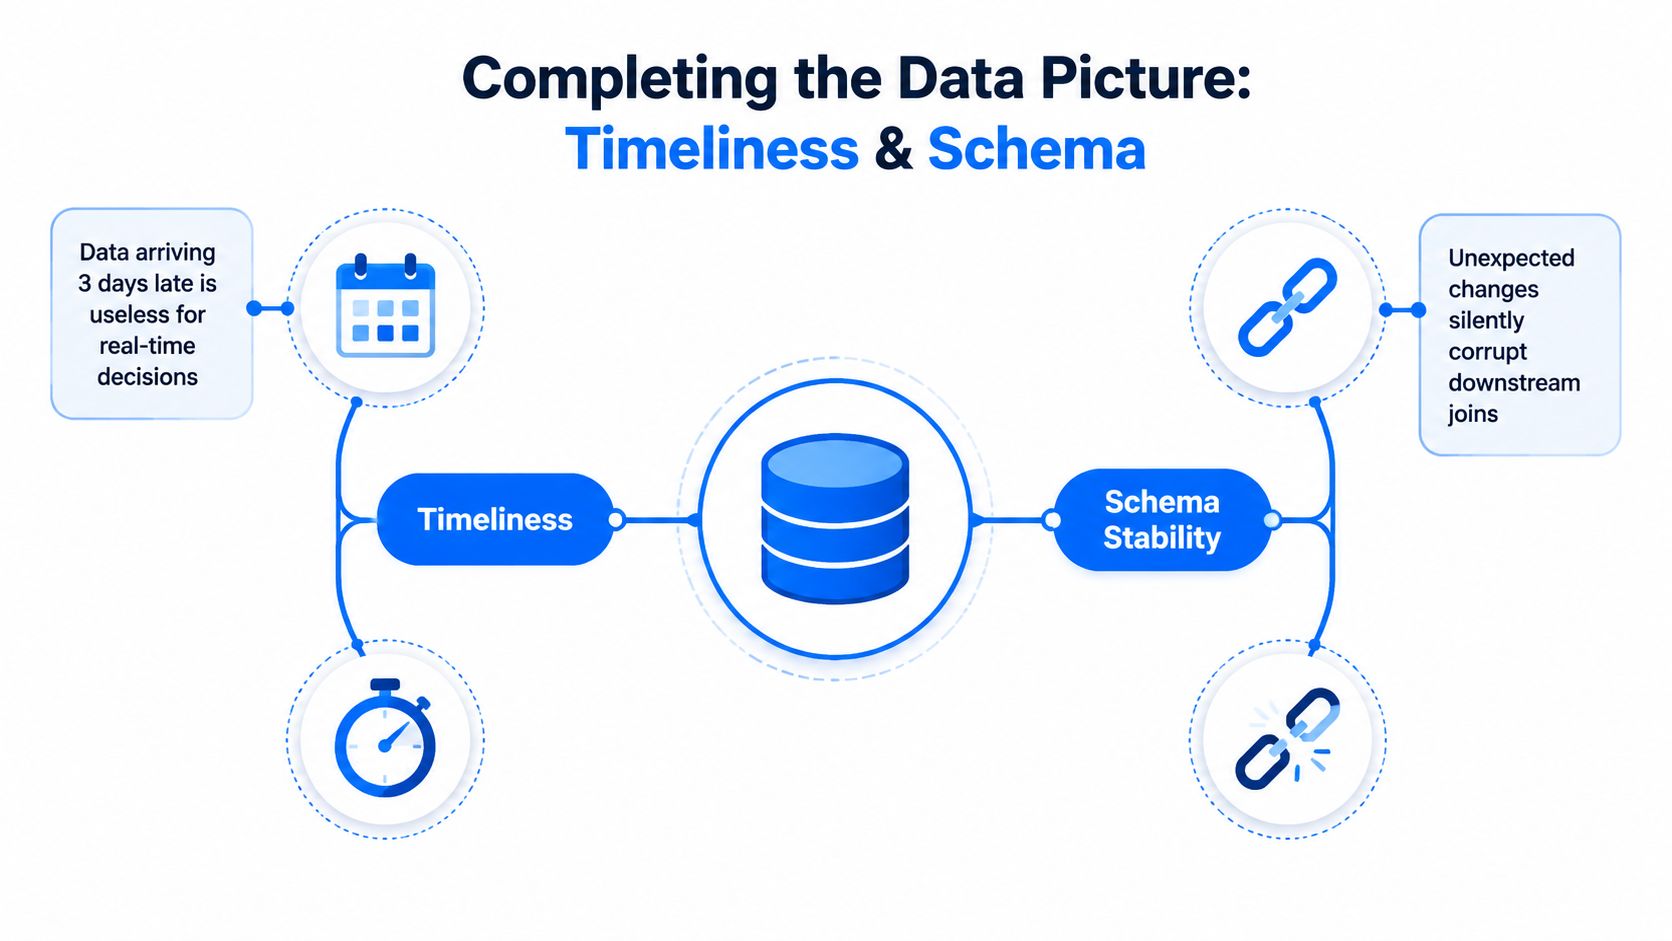
L'interaction importe plus que n'importe quel score individuel. L'exactitude sans fraîcheur produit une vérité historique au mauvais moment décisionnel. La fraîcheur sans stabilité structurelle fournit des données actuelles que les consommateurs risquent de mal interpréter. La stabilité structurelle sans exactitude préserve une forme fiable pour des valeurs défectueuses.
Des données fiables ne sont des données valides que lorsque l'exactitude, la fraîcheur et la stabilité structurelle sont réunies.
Contrôles pratiques pour assurer à la fois la validité et la fiabilité
Les contrôles fonctionnent mieux lorsqu'ils sont placés au plus près de la défaillance qu'ils doivent intercepter. Un unique test en fin de pipeline arrive trop tard pour un contrat de source rompu, tandis que des dizaines d'alertes indifférenciées créent de la fatigue et incitent les équipes à ignorer le système de surveillance.
Commencer par des vérifications par couches
À la source ou à la limite de l'étape intermédiaire (staging), appliquez des assertions au niveau des colonnes pour les champs requis, les types acceptés, le comportement des valeurs nulles, les plages et les valeurs de référence approuvées. Ajoutez des vérifications de distribution là où un enregistrement valide peut tout de même créer un ensemble de données invalide, comme une concentration soudaine dans une catégorie ou un effondrement inattendu des valeurs renseignées.
Au niveau de la couche d'intégration, testez les relations. Les vérifications d'intégrité référentielle doivent confirmer la résolution des clés. Les vérifications d'unicité doivent identifier les doublons d'événements métier. Les règles multi-colonnes doivent vérifier des combinaisons telles que le statut et la date de réalisation, plutôt que de tester chaque champ de manière isolée.
Au niveau de la couche de consommation, surveillez les indicateurs utilisés par les parties prenantes. Un tableau de bord peut rester techniquement disponible tandis que son indicateur clé de chiffre d'affaires, de client ou de risque se comporte de manière anormale. Les vérifications au niveau métier constituent un dernier rempart contre les défauts que les assertions de niveau inférieur ne comprennent pas.
Ajouter de l'observabilité opérationnelle
Les moniteurs de fraîcheur doivent surveiller les modèles d'arrivée attendus, les lots en retard, les chargements manquants et les livraisons précoces. Les détecteurs d'écarts de schéma (schema-diff) doivent signaler les champs ajoutés, supprimés, renommés ou dont le type a changé avant qu'une modification critique n'atteigne les modèles dépendants. La documentation des moniteurs d'observabilité des données de Datadog décrit la détection aux niveaux de la base de données, du schéma, de la table et des colonnes.
La détection des anomalies de volume comble une autre lacune importante. Elle permet de mettre en évidence les troncatures silencieuses, les vagues inattendues de doublons et les extractions partielles, même lorsque chaque ligne livrée passe la validation.
Contrôle | Ce qu'il intercepte | Étape du pipeline | Gravité de l'alerte |
|---|---|---|---|
Assertions de valeurs nulles et de plages | Valeurs requises manquantes et limites invalides | Source ou staging | Élevée lorsque des champs critiques échouent |
Vérifications référentielles | Clés de dimension et de référence non résolues | Intégration | Élevée pour les jointures affectées |
Surveillance de la fraîcheur | Chargements tardifs, manquants ou anormalement précoces | Source et staging | Critique pour les ensembles de données d'aide à la décision |
Détection d'écarts de schéma (schema-diff) | Champs ajoutés, supprimés, renommés ou modifiés de type | Contrat de source | Critique pour les changements perturbateurs |
Détection d'anomalies de volume | Troncature, vagues de doublons et chargements partiels | Staging et consommation | Élevée lorsque les agrégats sont affectés |
Surveillance des indicateurs métier | Comportement inattendu des KPI | Consommation | La gravité dépend de l'impact métier |
Les seuils doivent refléter un comportement normal, et non une perfection arbitraire. Une alerte qui se déclenche à chaque fluctuation du week-end apprend aux opérateurs à ignorer les alertes. Un tableau de bord de santé utile combine les signaux techniques avec la propriété, les actifs concernés, la dernière livraison réussie et la décision commerciale en jeu. Les équipes peuvent également utiliser des règles et vérifications de validation continue des données pour connecter les contrôles au niveau des enregistrements à une surveillance continue de la qualité.
Pourquoi la Data Validation statique ne suffit pas pour les plateformes de données modernes
Les règles de validation statiques sont des barrières utiles, mais elles deviennent fragiles lorsque les équipes les traitent comme une stratégie de fiabilité complète. Une règle écrite une seule fois peut confirmer qu'un champ n'est pas nul tout en passant à côté d'une nouvelle valeur d'énumération (enum), d'une sémantique modifiée, d'un modèle d'événement dupliqué ou d'une source qui a cessé de fournir des enregistrements récents.
Les plateformes modernes traitent des événements en streaming, des charges utiles semi-structurées et des réponses de tiers qui évoluent en dehors du cycle de Release de l'équipe de l'entrepôt de données. Cet environnement opérationnel nécessite une observabilité continue, et pas seulement une validation ponctuelle.
Les conséquences commerciales peuvent être graves. Un incident signalé chez un détaillant impliquait un contrôle de valeur nulle statique qui avait manqué une nouvelle valeur d'enum et avait réattribué à tort 4 millions de USD d'attribution. Un autre exemple dans la fintech impliquait une assertion de plage codée en dur qui n'a pas réussi à détecter un échange de code de devise, ce qui a gonflé les scores de risque. Ces exemples illustrent la faiblesse centrale des règles statiques : elles peuvent vérifier des conditions connues tout en passant à côté de comportements inconnus mais lourds de conséquences.
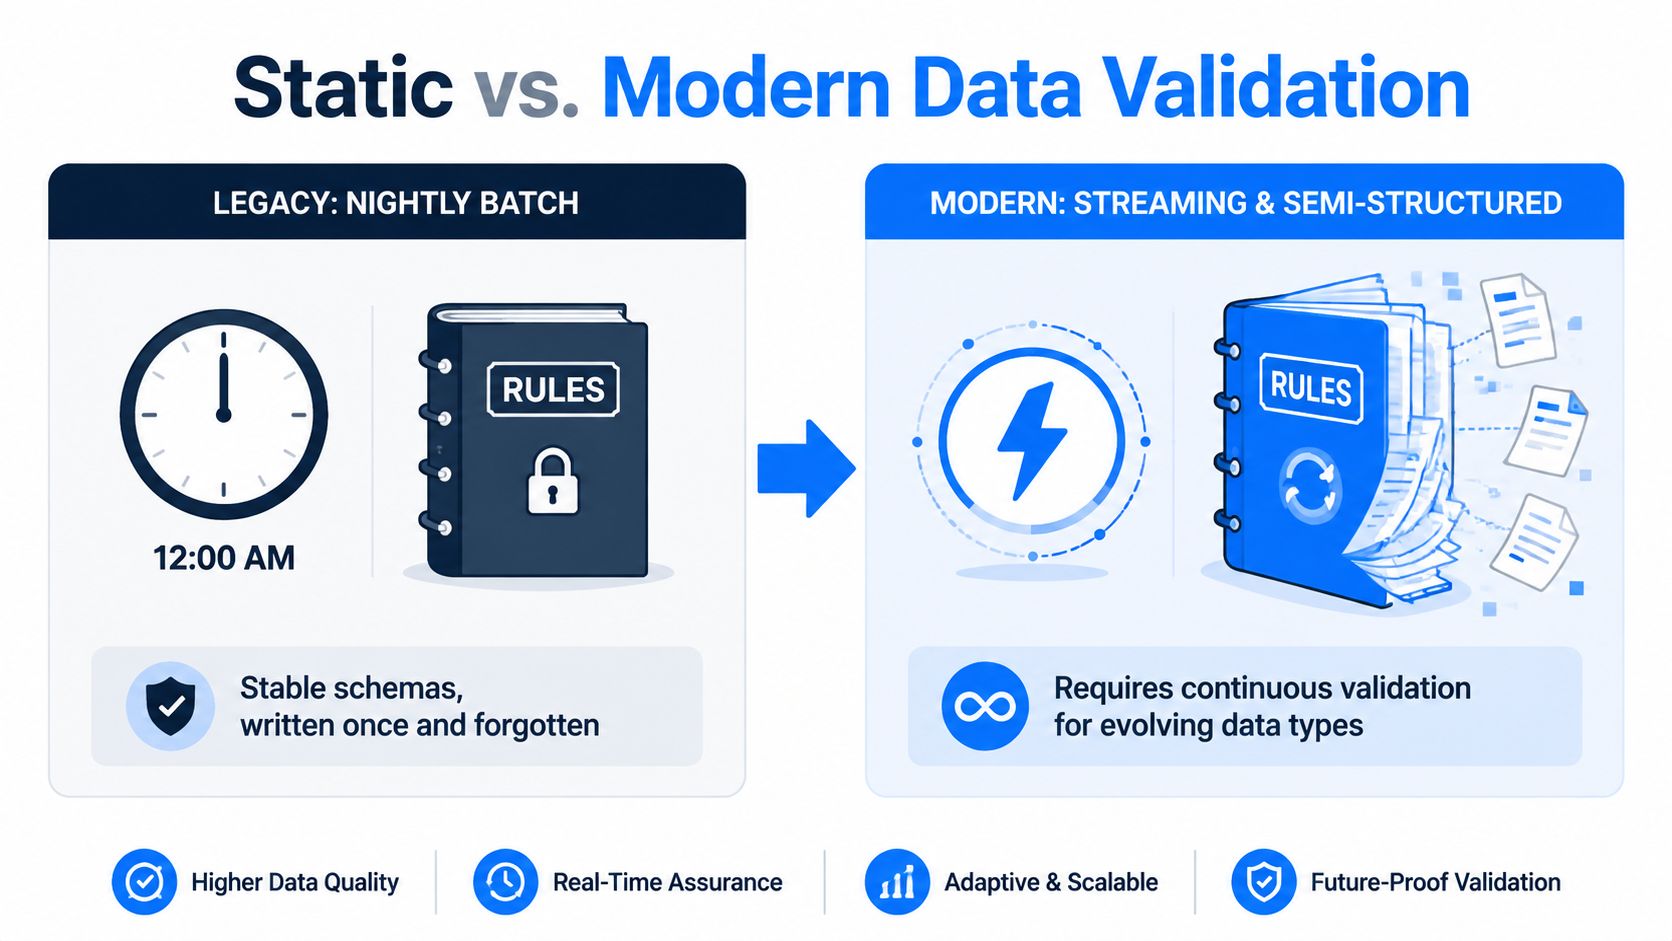
L'observability continue surveille le comportement des données au fil du temps. Elle combine des contrats explicites avec la détection d'anomalies, le suivi de la fraîcheur, l'analyse des volumes et la surveillance des changements de schéma. Ce modèle n'élimine pas les règles déterministes. Il les place au sein d'une boucle de rétroaction capable d'identifier les changements de l'environnement.
Le changement pratique consiste à passer de « cette valeur a-t-elle réussi le test ? » à « cet ensemble de données se comporte-t-il toujours comme prévu pour son usage ? ». Cette question permet de capturer les défaillances que la validation statique ne peut pas décrire à l'avance.
Bâtir une stratégie de fiabilité des données évolutive
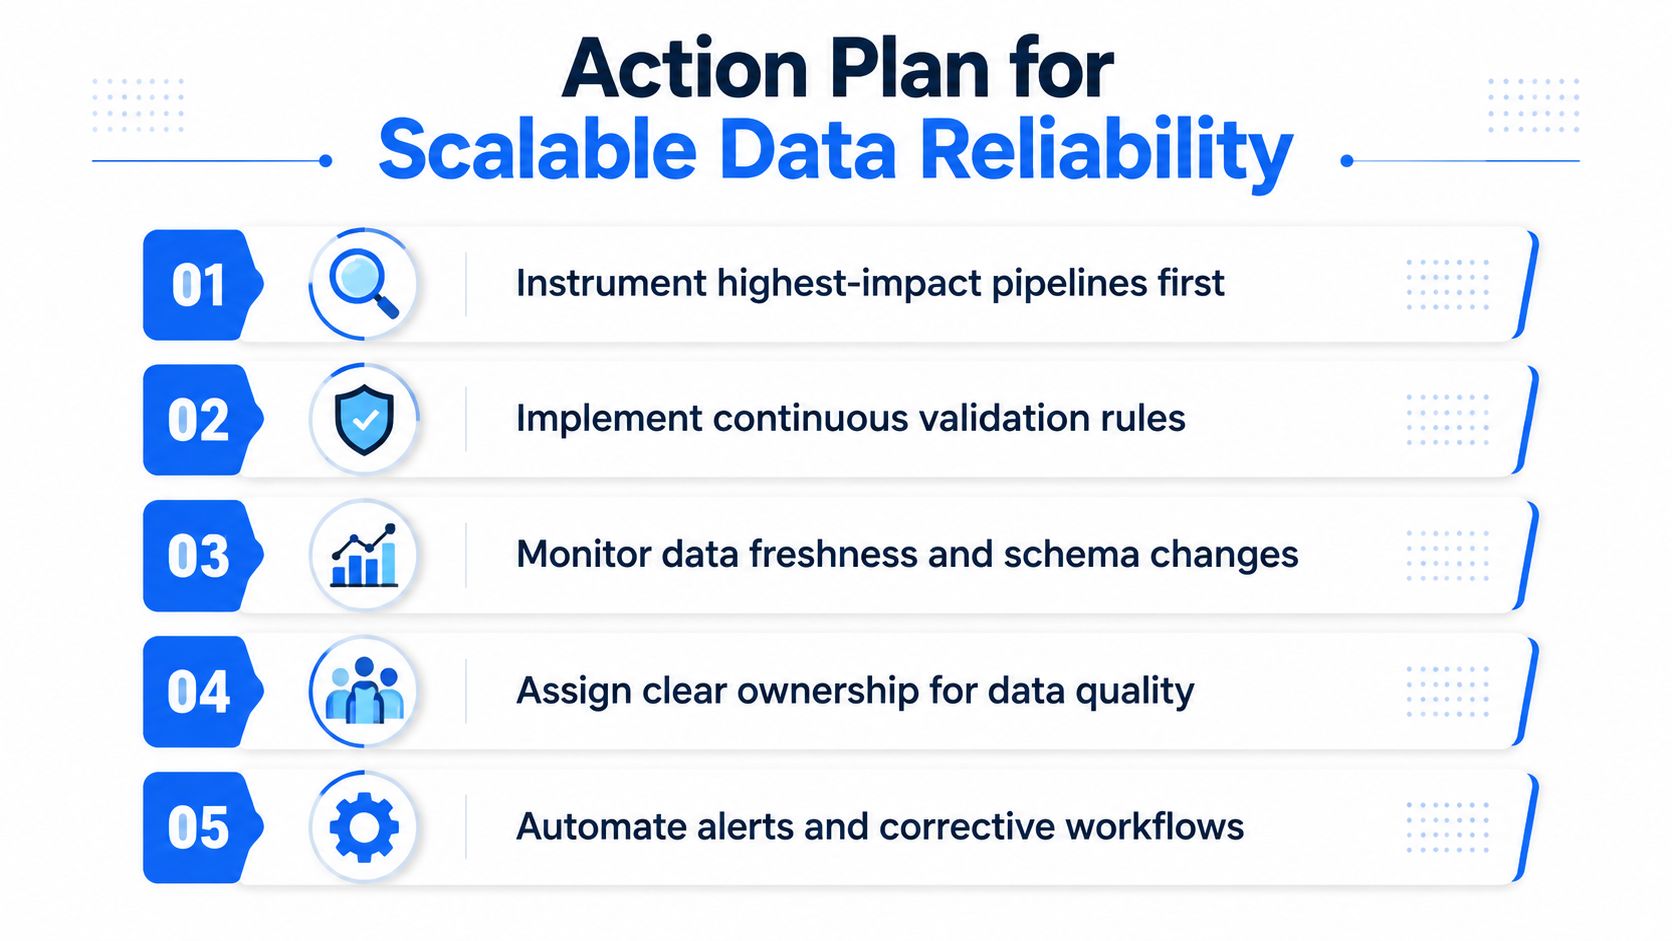
Les équipes n'ont pas besoin d'instrumenter chaque table avant d'améliorer la confiance. Commencez par les pipelines qui alimentent les rapports réglementaires, les indicateurs de direction, les opérations clients, les décisions financières ou les fonctionnalités d'IA.
Utilisez cette séquence :
Hiérarchiser l'impact : Associez les ensembles de données critiques aux décisions et aux modèles qui en dépendent.
Définir des contrats de livraison : Fixez des attentes en matière de fraîcheur, d'exhaustivité et de compatibilité des schémas.
Superposer les contrôles : Associez la validation déterministe à la surveillance des anomalies, des volumes et des structures.
Attribuer la responsabilité : Offrez aux ingénieurs, aux analystes et aux parties prenantes des processus d'escalade clairs.
Boucler la boucle : Tirez parti des incidents pour affiner les seuils, les contrats et les flux de résolution.
Pour les équipes qui analysent les communications de la direction aux côtés des données opérationnelles, les analyses linguistiques des présentations de résultats peuvent apporter du contexte sur la façon dont le langage d'entreprise et les signaux de performance sont interprétés. Ce type d'analyse contextuelle dépend toujours de données sources qui restent valides, actuelles et structurellement stables.
La norme opérationnelle est bien résumée par la perspective de digna sur la fiabilité des données : l'observabilité doit relier la santé technique à la fiabilité des données consommées. Faire évoluer la fiabilité ne consiste pas à accumuler des règles statiques. Il s'agit de concevoir des boucles de rétroaction qui aident les équipes à détecter les changements, à en comprendre l'impact et à réagir avant que des données invalides n'atteignent les processus de décision.
digna aide les équipes de données à surveiller la validité des enregistrements, la fraîcheur, les changements de schéma, les anomalies et les indicateurs métier au sein de leur propre environnement de données. Visitez digna pour découvrir comment l'observabilité continue peut vous aider à intercepter les pipelines brisés et les données invalides avant qu'ils n'atteignent les tableaux de bord, les analyses et les flux de travail d'IA.
Questions fréquentes
Une donnée peut-elle être fiable sans être valide ?
Oui, et cet écart provoque certains des incidents les plus coûteux des plateformes modernes. La fiabilité du pipeline signifie que le job a tourné et produit une sortie à l'heure ; la validité signifie que les valeurs veulent encore dire ce que le métier croit.
Que répond réellement une surveillance basique ?
Des questions opérationnelles : le job a-t-il démarré, s'est-il terminé, l'entrepôt a-t-il accepté la requête, la tâche attendue a-t-elle produit une sortie, le tableau de bord s'est-il rafraîchi. Tout cela compte, mais rien n'indique si un identifiant client désigne encore le bon client.
À quoi ressemble une défaillance de validité vue de l'extérieur ?
À une question plutôt qu'à une alerte. Quelqu'un demande pourquoi la conversion a chuté sur un canal alors que le tableau de bord affiche toujours un rafraîchissement réussi : à cet instant, un pipeline d'apparence fiable publie déjà des données invalides depuis un moment.
Quels contrôles de validité attrapent ce que la surveillance rate ?
Ceux liés au sens : un identifiant client désigne-t-il toujours le bon client, un horodatage appartient-il à la période de reporting visée, un code de statut reste-t-il dans le vocabulaire métier approuvé.
Comment Timeliness et validité se combinent-elles ?
Elles couvrent deux moitiés de la confiance. Timeliness confirme que la donnée est là quand la décision en a besoin ; la validité confirme que la donnée présente décrit bien ce qu'elle prétend. Un jeu de données a besoin des deux avant qu'on le déclare digne de confiance.



