Qu'est-ce que la dérive des données et comment l'arrêter ?
|
5
minute de lecture

Vous disposez d'un tableau de bord parfait lundi, d'un modèle ayant passé la validation le mois dernier, et d’une partie prenante vous demandant pourquoi les chiffres semblent « bizarres » aujourd'hui. C'est généralement ainsi que la dérive des données (data drift) s'annonce : par une prévision faussée, une recommandation étrange ou un rapport qui ne correspond plus à ce que constatent les équipes sur le terrain.
Le plus agaçant, c'est que rien n'a besoin de « casser » au sens strict. Le pipeline peut continuer à tourner, les tables à se remplir et le modèle à fournir des réponses avec assurance. Le problème fondamental est que le monde a évolué pendant que votre infrastructure de données est restée ancrée dans une version antérieure.
Quand les bons modèles tournent mal : la menace silencieuse du data drift
Un modèle qui fonctionnait parfaitement en phase de test peut commencer à prendre des décisions aberrantes en production, et le premier signal d'alarme est rarement un message d'erreur rouge. C'est plutôt une équipe commerciale qui remet en question un tableau de bord, une équipe financière qui tente de réconcilier des chiffres incohérents, ou un responsable des opérations qui se demande pourquoi une même entrée produit aujourd'hui une décision différente. Ce fossé entre « fonctionnait hier » et « n'a plus de sens aujourd'hui » est précisément là où réside le data drift.
En pratique, le data drift signifie que les propriétés statistiques des données d'entrée changent au fil du temps, de sorte que la distribution d'entraînement ne correspond plus aux conditions réelles. Ce décalage peut s'infiltrer dans les couches de Business Intelligence, les flux de rapports et les décisions automatisées, et pas seulement dans les résultats du Machine Learning. En Espagne, ce phénomène est devenu difficile à ignorer, le rapport DESI 2022 de la Commission européenne ayant révélé que 75 % des entreprises disposaient déjà d'un niveau d'intensité numérique au moins basique, soit plus que la moyenne de l'UE qui s'élève à 69 % (contexte DESI 2022 pour l'Espagne).
C'est pourquoi la question ne concerne pas seulement la qualité du modèle, mais sa continuité. Lorsque la majeure partie d'une entreprise repose déjà sur des données, une légère modification dans les transactions, le comportement des clients ou les structures de schémas peut rapidement se propager dans le reste de l’infrastructure. Le risque se manifeste d'abord par de la confusion, puis par de mauvaises décisions, et enfin par une perte de confiance des collaborateurs dans les chiffres.
Garantir l'intégrité du modèle grâce aux contrôles de qualité des données
Règle pratique : si les parties prenantes demandent « pourquoi cela semble faux ? » avant de demander « quelle est la précision du modèle ? », vous faites déjà face à un problème d'observabilité (Observability), et non à un problème de modélisation.
Le problème du bateau de Thésée appliqué à vos données
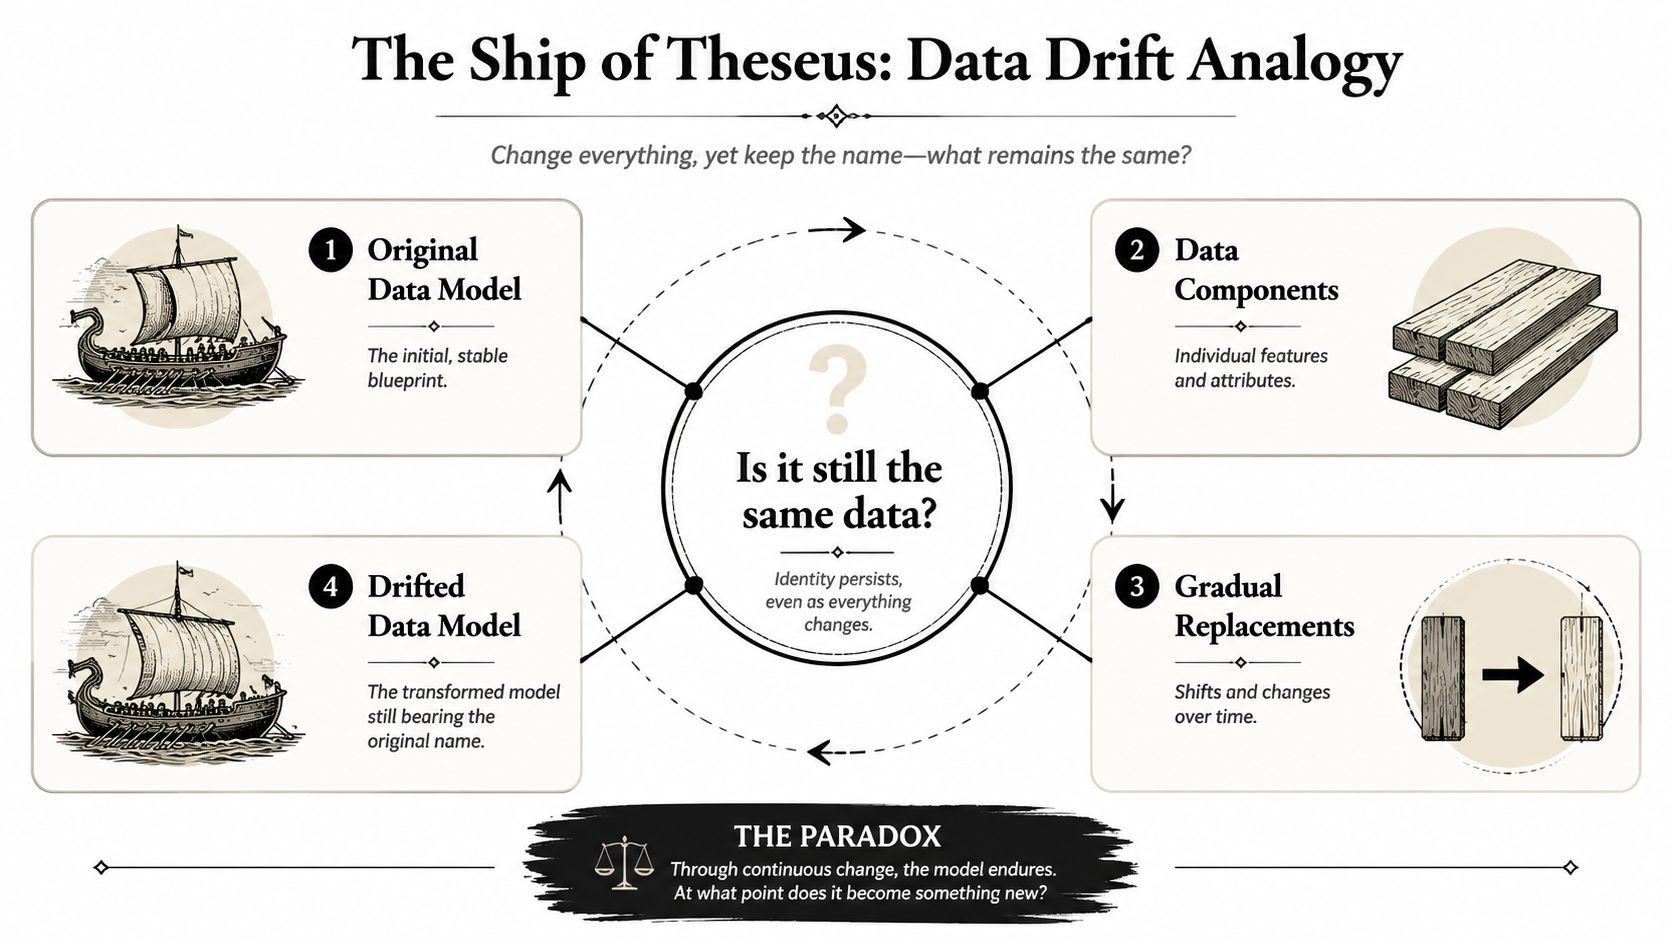
Le data drift illustre parfaitement le paradoxe du bateau de Thésée. Un pipeline peut conserver le même nom, les mêmes tables et même le même titre de tableau de bord alors que son contenu cesse progressivement de correspondre aux données sur lesquelles il a été conçu. Une variable commence à arriver avec des valeurs différentes, une autre arrive en retard, une source réutilise un libellé de catégorie pour quelque chose de légèrement différent, et le jeu de données actif devient un objet distinct, même si personne ne l'a renommé.
C'est ce qui rend la dérive difficile à détecter en production. Elle ne se présente généralement pas sous la forme d'une panne unique et évidente. Elle s'immisce par de petites substitutions d'apparence inoffensive, qui finissent par modifier suffisamment la distribution globale pour altérer le comportement des rapports, des alertes et des modèles. En pratique, les équipes ont besoin d’un suivi de la dérive et d’une comparaison des distributions, car attendre une défaillance métier visible signifie que le décalage s'est déjà propagé dans toute l’infrastructure.
La dérive lente et le changement soudain sont deux choses différentes
La dérive lente ressemble au mouvement d'un littoral sous l'effet des marées successives. Le changement est là, mais vous ne le remarquez que lorsque vous comparez les données du jour avec l'ensemble de référence du mois dernier. En revanche, un changement soudain s'apparente plutôt à une route fermée après une tempête. L'itinéraire de la veille existe toujours en mémoire, mais il n'est plus praticable en situation réelle.
La dérive lente apparaît généralement dans la répartition des clients, les habitudes de transaction et les comportements saisonniers. Les changements soudains proviennent le plus souvent d'une mise à jour logicielle, d'une modification réglementaire ou d'une mise à jour du système source. L'erreur consiste à traiter ces deux cas comme un unique problème de précision et à espérer qu'un réentraînement corrigera tout d'un coup.
Dans un environnement de reporting européen, cette distinction a de l'importance bien au-delà du modèle lui-même. Une lente modification dans un flux de revenus peut fausser les tableaux de bord financiers pendant des semaines avant que quelqu'un ne s'en aperçoive. Un changement soudain de schéma peut briser des rapports de conformité (Compliance), frustrer les auditeurs et inciter les équipes à chercher une fausse erreur dans la couche BI pendant que le système source continue d'évoluer. Un même pipeline peut sembler sain sur le papier tout en s'avérant erroné là où les décisions commerciales sont prises.
Les changements structurels peuvent briser votre pipeline
Une étiquette stable sur des données instables est l'un des moyens les plus rapides de perdre la confiance des utilisateurs.
Les suspects habituels d'un désastre de Data Drift
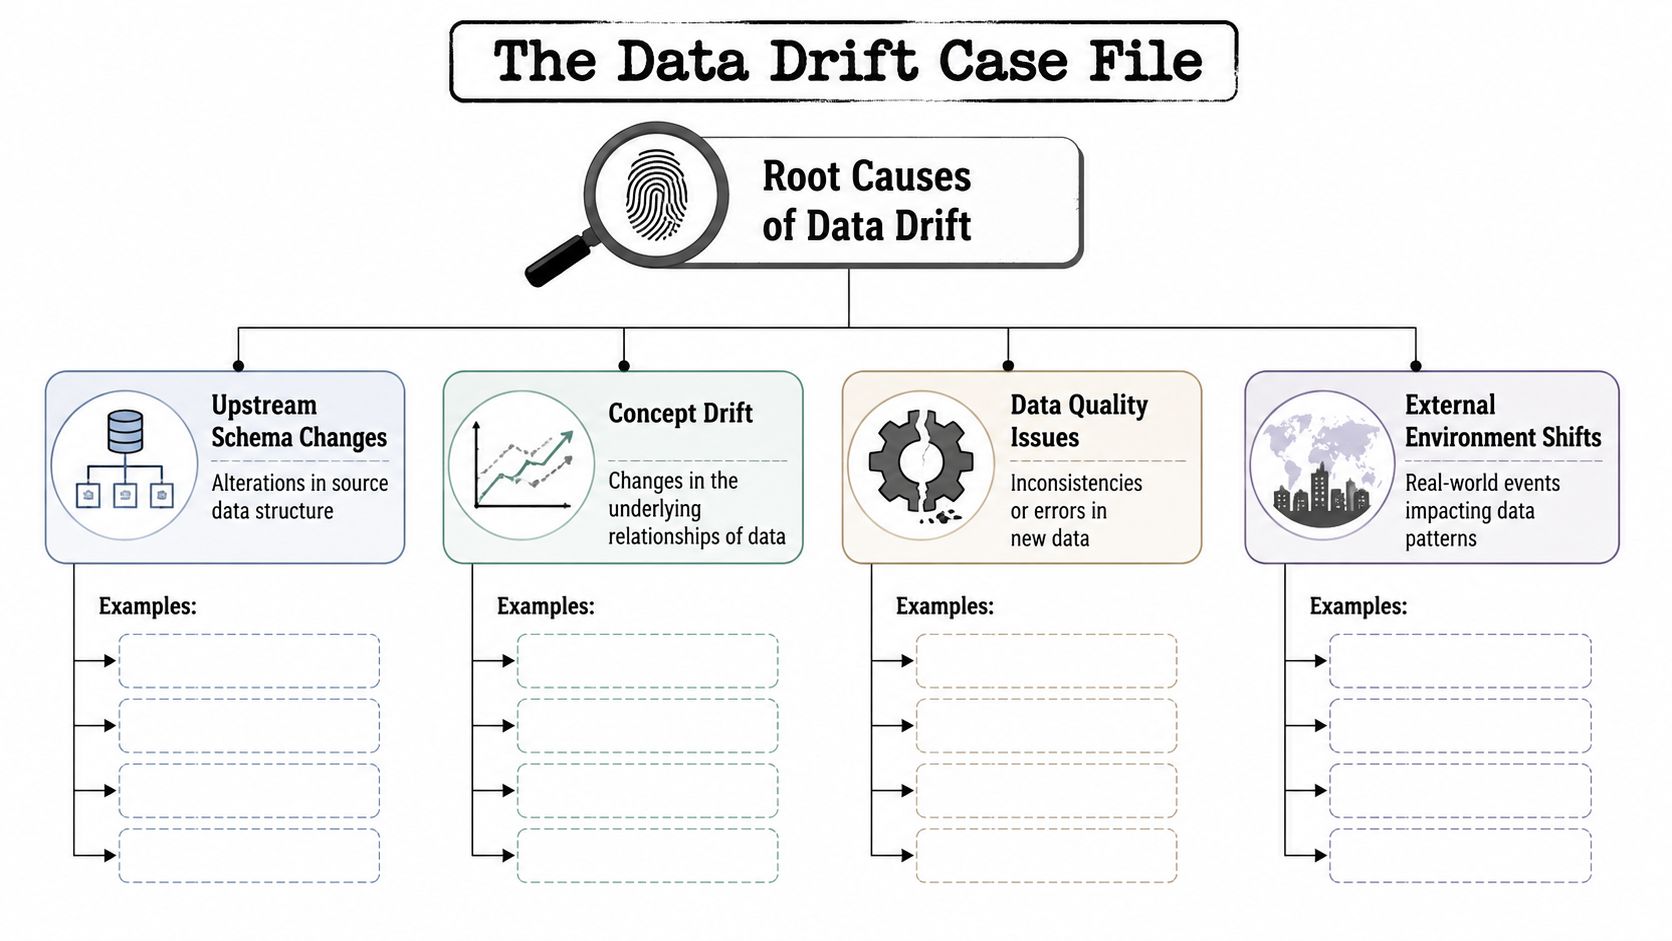
Le moyen le plus rapide de diagnostiquer une dérive est d'analyser les points d'entrée habituels du changement. Pour les entreprises espagnoles, cela importe encore plus que dans un environnement de démonstration épuré, car l'Office national des statistiques a indiqué en 2024 que 78,7 % des grandes entreprises utilisent des services de cloud computing, ce qui implique davantage de composants mobiles, de dépendances et de sources de variations comportementales (utilisation du cloud et risques de dérive en Espagne). Une infrastructure complexe ne crée pas de dérive en soi, mais elle lui offre davantage de points d'entrée.
Quatre points de départ habituels pour la dérive
Modifications de schéma en amont : une colonne renommée, un type modifié ou un champ qui disparaît. Les tableaux de bord ne s'alignent plus, les pipelines de variables analysent mal les valeurs et les rapports s'éloignent de la source de vérité.
Dérive de concept (concept drift) : la relation entre les variables d'entrée et les résultats change. Un schéma qui permettait auparavant de signaler un événement n'a plus la même signification.
Problèmes de qualité des données : des valeurs manquantes, des enregistrements doublonnés, des chargements retardés et des saisies mal formées faussent subtilement les analyses et les entrées du modèle.
Évolutions de l'environnement externe : les comportements du marché, les changements de réglementation et les perturbations opérationnelles modifient le rythme des données sans avertissement préalable.
Ces causes sont particulièrement dommageables car elles ne nuisent pas seulement à la précision du modèle. Elles peuvent interrompre le reporting réglementaire, altérer la fraîcheur de la BI et donner une apparence de fiabilité à des analyses orientées client alors qu'elles sont obsolètes. Dans les environnements fortement axés sur le cloud, la fragilité est répartie sur de multiples services, architectures et flux de données ; les équipes doivent donc raisonner en termes de chaînes de dépendance, et non de simples tables.
Une bonne pratique consiste à remonter chaque indicateur défectueux jusqu'au premier système ayant changé, et non jusqu'au dernier ayant échoué. C’est là que se trouve généralement la cause d'origine.
Votre boîte à outils de détective du Data Drift
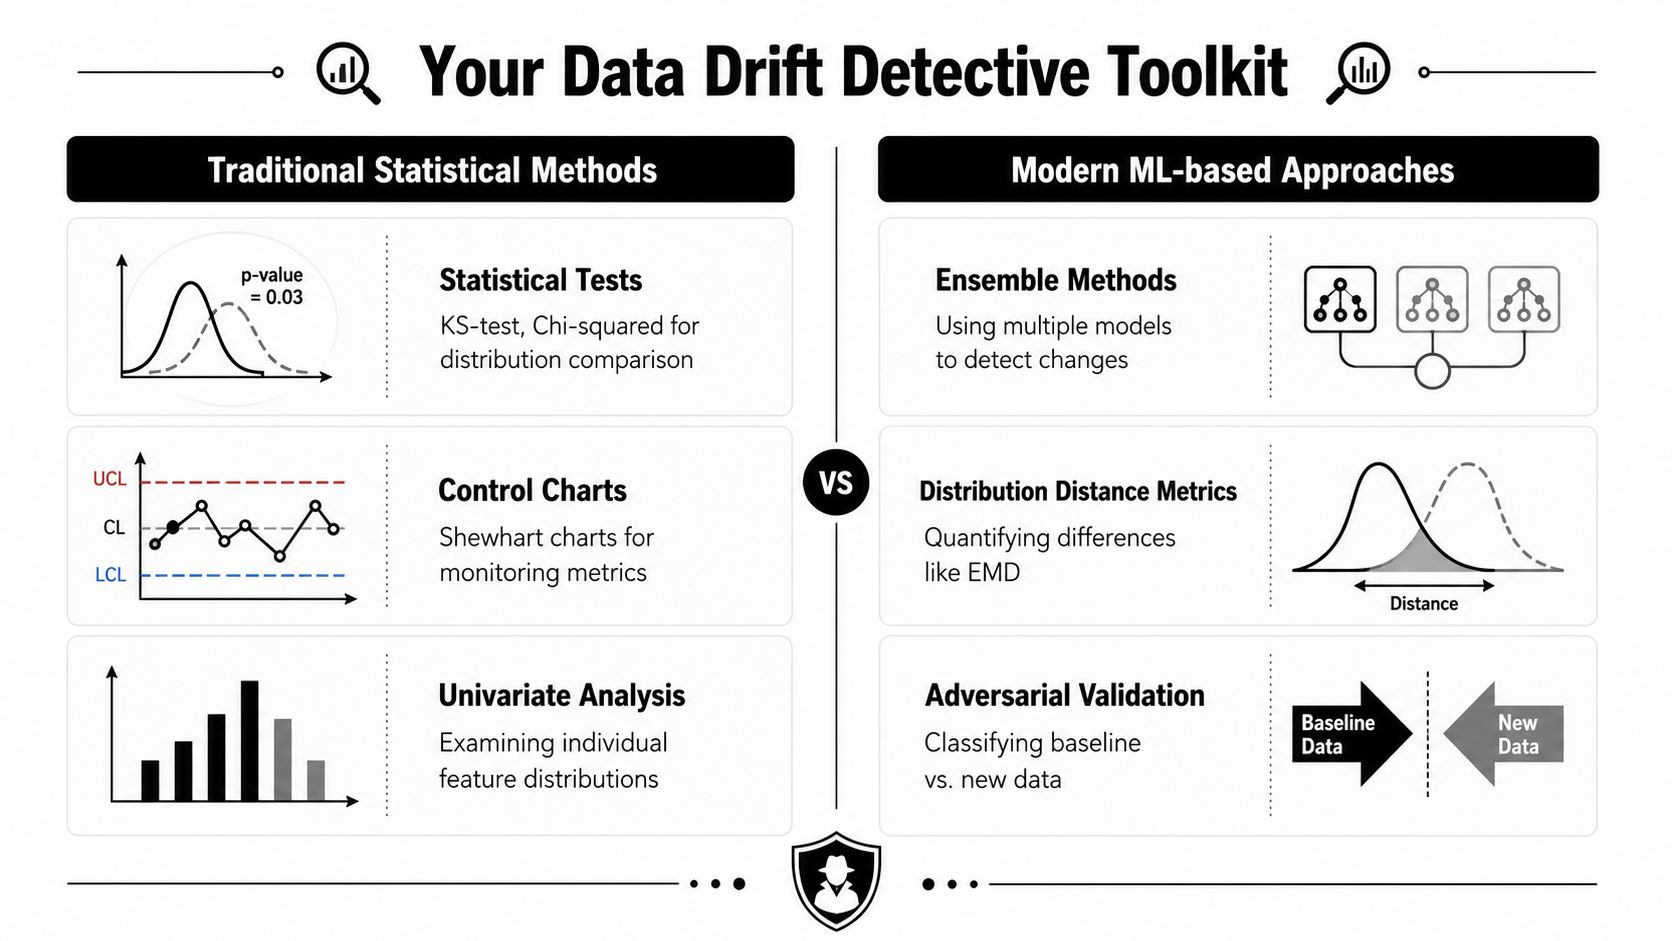
Un détecteur de dérive remplit parfaitement une tâche unique. Il détermine si les données réelles correspondent toujours aux données de référence, et ce, avant qu'un flux obsolète ne se transforme en un tableau de bord dysfonctionnel, un rapport trompeur ou un problème de conformité (Compliance). Dans une infrastructure de reporting européenne, cela est tout aussi crucial pour la fraîcheur de la BI que pour la précision du modèle.
Les méthodes statistiques traditionnelles restent indispensables car elles sont claires et justifiables. Les outils modernes d'observabilité (Observability) y ajoutent un suivi continu, évitant ainsi aux équipes d'attendre que quelqu'un remarque une anomalie sur un graphique ou qu'un utilisateur final ne se plaigne.
L'approche statistique
Ces outils classiques sont directs, ce qui explique pourquoi ils restent indispensables. Le test de Kolmogorov-Smirnov compare deux distributions et indique si elles diffèrent. Le test du chi-deux convient aux dérives catégorielles. Les mesures de distance, telles que la divergence de Jensen-Shannon et l'indice de stabilité de la population (PSI), permettent de mesurer l'écart entre le lot actuel et l'ensemble de référence (méthodes courantes de comparaison de dérive).
Ces méthodes s'avèrent très efficaces lorsque l'équipe connaît les champs essentiels et souhaite définir un seuil d'action précis. Elles sont moins utiles lorsque le problème réside au sein d'un sous-groupe, d'un fichier retardé ou d'une combinaison de micro-changements répartis sur plusieurs colonnes. Un score de synthèse unique peut passer à côté de ce type de dérive, et c'est ainsi qu'en pratique, un rapport à l'apparence propre peut être erroné.
L'approche observabilité
Une plateforme comme digna répond à l'aspect opérationnel du problème. Elle est capable d'apprendre les comportements normaux, de suivre les anomalies dans le pipeline et de faire remonter les changements structurels sans exiger qu'un analyste maintienne manuellement chaque règle. Cela s'avère précieux lorsque l'infrastructure comporte trop de tables, d'architectures et d'utilisateurs finaux pour être inspectés individuellement.
Règle pratique : utilisez les tests statistiques pour la précision, et l'observability pour la couverture. Si vous n'en utilisez qu'un seul, des anomalies passeront entre les mailles du filet.
Les équipes les plus performantes combinent ces deux approches. Elles comparent les lots par rapport à une référence, surveillent les changements de distribution au niveau des variables, et gardent également un œil sur la ponctualité et les modifications de schémas. Ainsi, un fichier en retard, une mauvaise jointure et une véritable dérive de distribution ne se traduisent pas par une seule et même alerte vague. Pour un exemple rapide de la manière dont la surveillance des anomalies peut révéler des problèmes avant qu'ils ne se propagent, consultez Détecter les problèmes tôt avant qu'ils ne se propagent.
Bâtir votre système de défense contre le Data Drift
La meilleure défense contre la dérive est rigoureuse, méthodique et continue. Elle s'appuie sur des Data Contracts clairs, des entrées versionnées, des lignes de référence surveillées et des alertes qui ne se déclenchent que pour de réels changements plutôt qu'au moindre écart sans importance. Si une équipe n'intervient qu'une fois que le modèle commence à échouer, il est déjà trop tard pour préserver la confiance envers les résultats.
Concevoir pour l'ensemble du parcours des données, pas seulement pour le modèle
Commencez par des contrats qui définissent ce qu'est une donnée d'entrée de qualité. Ensuite, versionnez conjointement les données et le modèle afin d’identifier si un changement provient de la source ou de l'algorithme. Ajoutez ensuite une surveillance qui contrôle à la fois le contenu et la ponctualité, car un fichier en retard peut nuire à un tableau de bord tout autant qu'un fichier corrompu.
La sensibilité aux segments joue ici un rôle clé. Une dérive peut survenir sur une seule gamme de produits ou un seul profil de clients, alors que les indicateurs agrégés semblent tout à fait normaux, et c'est exactement de cette façon qu'un faux sentiment de sécurité s'installe. Une surveillance segmentée réduit les faux négatifs et vous aide à orienter les corrections là où elles sont nécessaires (détection de dérive sensible aux segments).
Maintenir des alertes utiles
La fatigue des alertes nuit à l'observabilité (Observability) bien plus rapidement que la dérive elle-même. Si la moindre anomalie mineure déclenche le même niveau de gravité, les équipes finissent par ne plus y prêter attention. Une configuration optimale distingue les changements de schéma, les retards de livraison et les réelles dérives de distribution, puis attribue chaque anomalie au bon interlocuteur.
Les contrats de données (Data Contracts) transforment la qualité en attente partagée
Utilisez la surveillance pour limiter le périmètre des dégâts. Il est préférable de gérer une alerte mineure plutôt que de découvrir tardivement une défaillance passée inaperçue.
Devenir une équipe de données vigilante
Pour les organisations basées en Espagne et dans l'ensemble de l'UE, la dérive n'est pas qu'un simple désagrément technique. Elle touche à la conformité (Compliance), au reporting et à la résilience opérationnelle, car le RGPD, appliqué par des autorités telles que l'AEPD, exige des données qu'elles soient exactes et intègres (exigences du RGPD en matière d'exactitude et d'intégrité). Si des enregistrements, des schémas ou des flux de livraison dérivent sans être repérés, des données inexactes peuvent se propager dans le profilage, les rapports et les décisions automatisées avant que quiconque n'ait le temps de s'en rendre compte.
C'est pourquoi l'approche recommandée n'est pas de « surveiller le modèle », mais de « protéger l'environnement de données ». Le modèle n'est qu'un consommateur parmi d'autres de cet environnement. La finance, la BI, la conformité (Compliance) et les opérations dépendent toutes des mêmes flux, et une altération silencieuse de ces signaux peut devenir un enjeu commercial bien avant de se transformer en bug de modélisation.
Utilisez la check-list de fiabilité pour renforcer vos contrôles
Une équipe de données vigilante traite le data drift comme une question de continuité d'activité, et non comme une tâche secondaire réservée au MLOps. Elle surveille les variations de distribution, suit les versions, contrôle la fraîcheur et maintient des responsabilités claires en cas de changement. C'est ce qui fait la différence entre des systèmes qui fonctionnent simplement et des systèmes sur lesquels on peut s'appuyer, même un mauvais jour.
Demandez une démonstration personnalisée et découvrez comment digna Schema Tracker surveille en continu vos tables configurées pour détecter les ajouts, suppressions, modifications de noms de colonnes et changements de types de données.
Questions fréquentes
Qu'est-ce que le data drift ?
Le data drift est une évolution des propriétés statistiques des données d'entrée au fil du temps, si bien que la distribution d'entraînement ne correspond plus aux conditions réelles. L'article souligne que le phénomène dépasse le machine learning : l'écart peut gagner les couches BI, les flux de reporting et les décisions automatisées pendant que les pipelines continuent de tourner normalement.
Quelles sont les causes du data drift ?
La plupart des dérives proviennent de quatre sources : des changements de schéma en amont, comme une colonne renommée ou un type modifié ; le concept drift, lorsque les entrées se rapportent différemment aux résultats ; des problèmes de qualité comme des valeurs manquantes ou des chargements retardés ; et des évolutions externes des marchés, de la réglementation ou des opérations. Remontez une métrique défaillante jusqu'au premier système modifié.
Comment détecter le data drift avec des tests statistiques ?
Le test de Kolmogorov-Smirnov compare deux distributions, le test du khi-deux convient aux variations catégorielles, et des mesures de distance comme la divergence de Jensen-Shannon et le Population Stability Index (PSI) évaluent l'écart entre un lot et son jeu de référence. Ces méthodes fonctionnent le mieux lorsque vous savez quels champs comptent et voulez des seuils clairs.
Quelle est la différence entre un data drift lent et un changement soudain ?
La dérive lente s'installe progressivement, souvent dans la composition de la clientèle, les schémas de transactions ou les comportements saisonniers, et n'apparaît qu'en comparant les données du jour au jeu de référence du mois précédent. Un changement soudain suit généralement une mise en production, une évolution réglementaire ou une mise à jour du système source. L'erreur courante consiste à traiter les deux comme un seul problème de précision à corriger par réentraînement.
Réentraîner le modèle suffit-il à stopper le data drift ?
Non. L'article recommande une défense fondée sur des contrats de données, le versionnement conjoint des données et du modèle, la surveillance du contenu et des délais, ainsi que des contrôles par segment, car une dérive peut se cacher dans une ligne de produits alors que les agrégats semblent normaux. Associez tests statistiques pour la précision et observabilité pour la couverture, et adressez chaque alerte au bon responsable.



