Configurer un contrôle d'intégrité référentielle, étape par étape
|
6
minute de lecture

Une clé étrangère qui ne pointe vers rien ne déclenche aucune erreur. La ligne se charge, la jointure interne suivante l'écarte, et un rapport affiche zéro là où il devrait y en avoir 82. Un contrôle d'intégrité référentielle est une règle de validation des données qui vérifie que chaque valeur d'une colonne enfant, ou d'un ensemble de colonnes, existe dans la table parente référencée, et qui signale les lignes pour lesquelles ce n'est pas le cas.
La plupart des plateformes analytiques ne l'exécuteront pas pour vous. Snowflake traite les clés étrangères des tables standard comme facultatives et non appliquées, et BigQuery indique clairement qu'il vous incombe de les maintenir. Redshift et Databricks se comportent de la même manière. Le contrôle doit donc se faire ailleurs.
Ce guide montre comment vérifier l'intégrité référentielle en pratique : d'abord les décisions à prendre (relations, colonnes, NULL, seuils, moment d'exécution), puis la configuration dans digna : quelques champs, sans SQL. Si vous voulez d'abord comprendre le concept, commencez par notre guide sur l'intégrité référentielle et les enregistrements orphelins.
Points clés à retenir
Contrôlez d'abord les relations sur lesquelles vos rapports font leurs jointures : tables de faits vers dimensions et enregistrements enfants vers parents, classées selon ce qui casse lorsqu'elles échouent.
Utilisez exactement les colonnes de jointure des deux côtés. Une clé composite est contrôlée en tant que combinaison, et les deux listes de colonnes doivent avoir la même longueur et le même ordre.
Une clé étrangère NULL ne fait pas échouer un contrôle d'intégrité référentielle. Si la référence est obligatoire, ajoutez une règle NOT NULL distincte.
Appliquez une tolérance zéro aux données financières et cliniques, et un seuil relatif aux grandes tables qui présentent une traîne connue de références arrivant en retard.
Dans digna, le contrôle est une règle de type Referential Integrity : choisissez les colonnes, choisissez où elles doivent exister, définissez deux seuils, enregistrez. La règle s'exécute dans votre base de données à chaque inspection.
Table des matières
Qu'est-ce qu'un contrôle d'intégrité référentielle ?
Quelles relations contrôler en premier ?
Comment choisir les colonnes et les clés composites ?
Que doit signifier une clé étrangère NULL ?
Quel seuil un contrôle d'intégrité référentielle doit-il utiliser ?
Quand un contrôle d'intégrité référentielle doit-il s'exécuter ?
Comment configurer un contrôle d'intégrité référentielle dans digna ?
À quoi ressemble le SQL équivalent ?
Comment lire un contrôle d'intégrité référentielle en échec ?
Par où commencer ?
Qu'est-ce qu'un contrôle d'intégrité référentielle ?
Un contrôle d'intégrité référentielle prend une colonne, ou un ensemble de colonnes, d'une table enfant et vérifie que chaque valeur renseignée existe aussi dans la table parente référencée. Les lignes qui trouvent un parent réussissent. Celles qui n'en trouvent pas sont des orphelins et échouent. Le résultat est un nombre de lignes réussies, un nombre de lignes en échec et, si vous les demandez, les lignes en échec elles-mêmes. On parle aussi de contrôle de clé étrangère ou de validation de l'intégrité référentielle.
Une contrainte de clé étrangère agit au moment de l'écriture et rejette l'insertion. Un contrôle agit après le chargement et vous indique quelle part des données chargées ne pointe vers rien. Là où les clés déclarées sont purement informatives, le contrôle est le seul dont vous disposez réellement.
Approche | Quand il agit | Ce qui arrive à un orphelin | Fonctionne là où les clés étrangères ne sont pas appliquées | Ce que vous obtenez |
|---|---|---|---|---|
Contrainte de clé étrangère | À l'insertion ou à la mise à jour | Rejeté ; le chargement échoue | Non, la déclaration n'est qu'une indication | Un message d'erreur |
Requête SQL ad hoc | Quand quelqu'un pense à l'exécuter | Rien, tant que personne ne regarde | Oui | Un jeu de résultats dans le client SQL de quelqu'un |
Contrôle d'intégrité référentielle dans digna | À chaque inspection, planifiée ou à la demande | Chargé, compté et listé | Oui, y compris entre connexions de bases de données | Nombres de lignes réussies et en échec, un statut par rapport à votre seuil, les lignes en échec |
Quelles relations contrôler en premier ?
Contrôlez d'abord les relations sur lesquelles vos rapports et vos traitements en aval font réellement leurs jointures : les tables de faits vers leurs dimensions et les enregistrements enfants vers leurs parents. Un lien brisé à cet endroit modifie des chiffres que des gens lisent et signent. Une relation que personne n'interroge peut attendre.
Un rapide inventaire vous donne une liste classée :
Listez les jointures entre faits et dimensions. Écritures vers comptes, factures de soins vers patients, enregistrements d'appels vers abonnés, administrations de médicaments vers le référentiel produits.
Listez les jointures entre enfants et parents. Lignes de commande vers commandes, diagnostics vers séjours, garanties vers prêts.
Repérez celles qui alimentent des rapports, la facturation ou des déclarations réglementaires. Une jointure interne dans ces requêtes écarte les orphelins sans laisser de trace.
Repérez celles qui sont chargées par des traitements ou des systèmes différents. Un enfant qui arrive avant son parent est un orphelin.
Commencez par les cinq à dix premières. Ajoutez les autres dès que quelqu'un est responsable des résultats.
Si vous voulez mesurer l'ampleur du problème avant de configurer quoi que ce soit, les requêtes de notre article sur la recherche des enregistrements orphelins en SQL vous donnent un décompte ponctuel par relation.
Comment choisir les colonnes et les clés composites ?
Utilisez exactement les colonnes de la jointure, des deux côtés, dans le même ordre. Si le parent est identifié par deux colonnes, contrôlez-les ensemble comme une clé composite. Contrôler chaque colonne séparément laisse passer des combinaisons qui n'existent nulle part dans le parent.
Les codes de service en sont un bon exemple. Si chaque hôpital d'un groupe possède un service appelé ICU-1, une ligne avec l'hôpital 2 et ICU-1 réussit un contrôle portant sur la seule colonne ward_code dès lors que l'hôpital 1 possède ce service. Seule la paire (hospital_id, ward_code) la détecte. digna contrôle la combinaison lorsque vous choisissez plusieurs colonnes, et rejette les listes de colonnes de longueurs différentes plutôt que de contrôler une condition plus faible.
Deux autres points à régler d'abord :
Pointez vers la clé du parent, pas vers un libellé. Contrôlez
product_codepar rapport auproduct_codedu référentiel, pas par rapport à un nom de produit que quelqu'un pourrait modifier.Rendez les deux côtés comparables. Un code stocké en texte avec des zéros non significatifs d'un côté et en nombre de l'autre produit des orphelins qui n'en sont pas. Normalisez-le dans une vue et contrôlez la vue : dans digna, une source de données peut être une table, une vue ou une instruction SQL personnalisée.
Que doit signifier une clé étrangère NULL ?
Décidez dès le départ si une clé étrangère NULL est autorisée. Un contrôle d'intégrité référentielle vérifie si une valeur existe dans le parent, et un NULL n'a aucune valeur à rechercher ; digna ignore donc les NULL dans ce contrôle. Si la référence est obligatoire, ajoutez une règle NOT NULL distincte, afin qu'une valeur manquante et une valeur orpheline apparaissent comme des constats différents.
Certaines références sont légitimement facultatives : un médecin adresseur, un code promotionnel, un compte parent pour un client de premier niveau. D'autres ne le sont jamais : chaque écriture a un compte, chaque dose administrée a un produit. Les séparer rend la correction évidente : une référence manquante renvoie au système de saisie, une référence orpheline aux données de référence ou à l'ordre de chargement.
Ce que vous voulez détecter | Type de règle digna | Exemple |
|---|---|---|
Valeur présente mais absente du parent | Referential Integrity |
|
Valeur manquante là où elle est obligatoire | Rule |
|
Clé présente plusieurs fois dans le parent | Uniqueness |
|
La troisième ligne compte aussi : une clé parente en double ne crée aucun orphelin, mais elle double chaque ligne qui s'y joint.
Quel seuil un contrôle d'intégrité référentielle doit-il utiliser ?
Appliquez une tolérance zéro aux données financières et cliniques, où un orphelin représente un chiffre faux dans un état financier ou une dose absente du dossier d'un patient. Utilisez un seuil relatif pour les très grandes tables, où une petite traîne connue de références arrivant en retard est normale et où seul un dépassement de cette traîne mérite l'attention.
digna attribue à chaque règle un Threshold Mode (mode de seuil). Absolute compare le nombre d'enregistrements en échec. Relative compare le nombre d'enregistrements en échec divisé par le nombre d'enregistrements évalués, sous forme de fraction : 0.01 signifie donc un pour cent. Chaque mode comporte deux niveaux : au-dessus du Info threshold (seuil d'information), le statut est Uncertain ; au-dessus du Warn threshold (seuil d'avertissement), il est Failed ; sinon, il est Passed. Les deux valent zéro par défaut, si bien qu'une nouvelle règle échoue dès un seul enregistrement erroné, jusqu'à ce que vous en décidiez autrement.
Situation | Threshold Mode | Info | Warn | Effet |
|---|---|---|---|---|
Écritures vers comptes, doses vers référentiel produits | Absolute | 0 | 0 | Un seul orphelin fait échouer l'exécution |
Mêmes données, mais un enregistrement isolé doit être signalé avant de provoquer l'échec | Absolute | 0 | 1 | Un orphelin : Uncertain ; deux ou plus : Failed |
Enregistrements d'événements ou d'appels avec des dimensions connues pour arriver en retard | Relative | 0.001 | 0.01 | Au-dessus de 0,1 % : Uncertain ; au-dessus de 1 % : Failed |
Commencez strict, et n'assouplissez que pour une raison que vous pouvez mettre par écrit.
Quand un contrôle d'intégrité référentielle doit-il s'exécuter ?
Exécutez-le après chaque chargement de la table enfant, et aussi après les chargements de la table parente, car des orphelins apparaissent dès que les deux arrivent dans le désordre. Dans digna, la règle s'exécute à chaque inspection de sa source de données, planifiée ou à la demande ; alignez donc l'inspection sur le chargement plutôt que sur le calendrier de reporting.
Un contrôle de fin de mois trouve un mois entier d'orphelins d'un coup, alors que le rapport est déjà attendu. Un contrôle après chaque chargement en trouve l'équivalent d'une journée, pendant que la personne qui a chargé les données se souvient encore de ce qui a changé. Le coût est d'une jointure par exécution, effectuée dans la base de données source, sans rien copier à l'extérieur. En cas d'échec, prévenez l'équipe responsable des données.
Comment configurer un contrôle d'intégrité référentielle dans digna ?
Dans digna, un contrôle d'intégrité référentielle est une règle digna Data Validation de type Referential Integrity. Vous choisissez les colonnes de votre source de données, puis la source de données et les colonnes dans lesquelles elles doivent exister, vous définissez deux seuils et vous enregistrez. Aucun SQL à écrire, et la configuration prend moins d'une minute.
Allez dans Configuration, sélectionnez la source de données (ici
hospital_medication_administrations), ouvrez l'onglet Data Validation et cliquez sur Add Rule. La boîte de dialogue Add Data Validation Rule s'ouvre.Saisissez un Name (nom) et une Description :
hc_product_in_master, « Chaque produit administré existe dans le référentiel produits de la pharmacie ».Réglez Type sur Referential Integrity. Les autres options sont Rule et Uniqueness.
Sous Attributes (attributs), choisissez la colonne de cette source de données :
product_code.Sous must exist in (doit exister dans), choisissez la Data Source (
hospital_medications) et ses Attributes (product_code). Pour une clé composite, choisissez plusieurs colonnes des deux côtés, dans le même ordre.Choisissez le Threshold Mode et définissez l'Info threshold et le Warn threshold. L'exemple utilise Absolute, Info 0, Warn 1.
Enregistrez. Désormais, la règle s'exécute à chaque inspection de la source de données.

La règle complète : type, attributs, source de données dans laquelle ils doivent exister, et deux seuils. Données de démonstration de Danubia Kliniken, un groupe hospitalier autrichien fictif.
Avec Info 0 et Warn 1, un seul orphelin fait déjà passer le statut à Uncertain, et au-delà il passe à Failed. Laissez Warn à 0 si un seul orphelin doit faire échouer l'exécution. Le parent n'a pas non plus besoin de se trouver à côté de l'enfant : depuis la Release 2026.01, l'autre côté peut être une table ou une vue dans un autre schéma ou sur une autre connexion de base de données du même projet, ce que nous traitons dans l'article sur l'intégrité référentielle entre bases de données. La vidéo de 2 min 26 L'intégrité référentielle dans digna : configuration en moins d'une minute présente les mêmes étapes.
Lorsque vous avez beaucoup de règles de ce type, gérez-les sous forme de code : la Release 2026.06 a ajouté un SDK Python (pip install digna-sdk) ainsi que l'import et l'export des règles de validation entre environnements.
À quoi ressemble le SQL équivalent ?
Sous le capot, un contrôle d'intégrité référentielle est une jointure gauche des lignes enfants vers les clés parentes distinctes, qui compte les lignes sans correspondance et ignore les clés NULL. digna génère et exécute cette requête dans votre base de données. Écrite à la main pour l'exemple ci-dessus, la logique ressemble à ceci :
Il s'agit d'une illustration de la logique, pas de l'instruction exacte qu'envoie digna. Pour une clé composite, la condition de jointure comporte une égalité par paire de colonnes. La requête est la partie facile. Le vrai travail, c'est tout ce qui l'entoure : l'exécuter après chaque chargement, comparer le résultat à un seuil, conserver l'historique, transmettre les lignes aux bonnes personnes. La documentation de digna décrit comment chaque type de règle est traduit en SQL.
Comment lire un contrôle d'intégrité référentielle en échec ?
Lisez un échec en trois étapes : le statut vous indique que le seuil a été franchi, les nombres vous indiquent l'ampleur de l'écart, et les enregistrements en échec vous indiquent pourquoi. Des orphelins qui partagent une même clé signalent généralement des données de référence manquantes. Des orphelins répartis sur de nombreuses clés indiquent généralement un chargement parent en échec ou une incohérence de format de clé.
Revenons à l'exemple de Danubia Kliniken. Le 22 avril 2026, 82 administrations d'un nouveau produit ont été enregistrées dans les services avant que le produit n'arrive dans le référentiel produits de la pharmacie. La règle hc_product_in_master a échoué : 4 244 lignes sur 4 326 ont réussi.
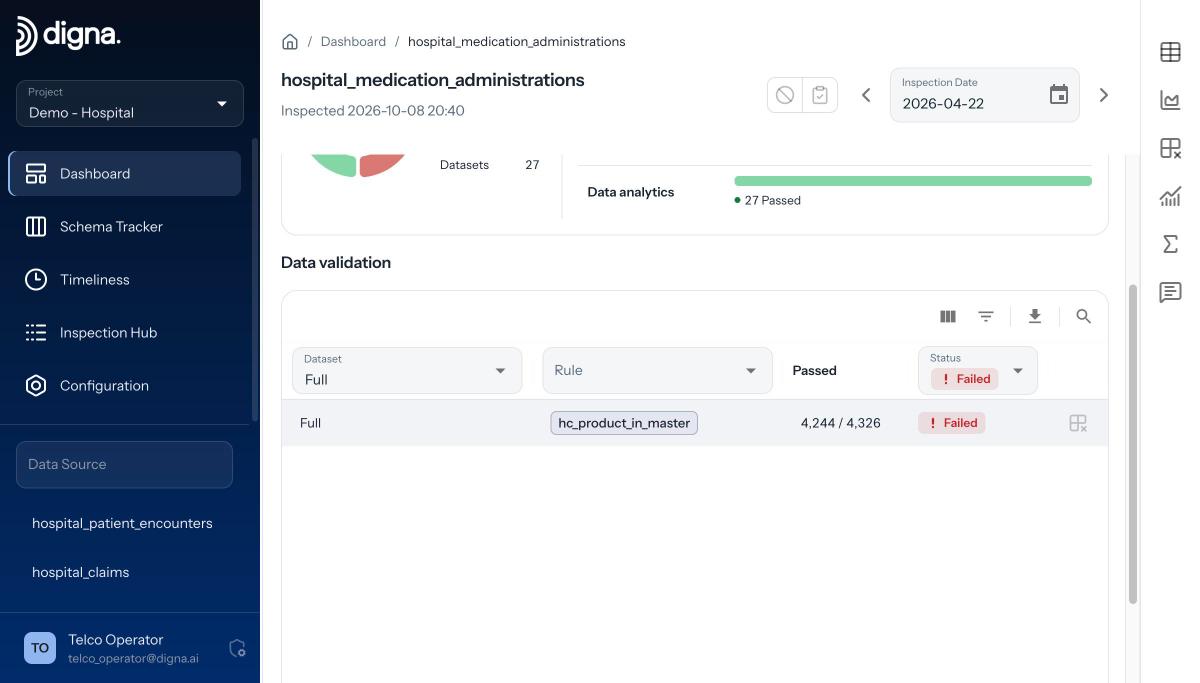
Le résultat dans le tableau de bord : 4 244 lignes réussies sur 4 326, statut Failed.
Pour comprendre pourquoi, ouvrez la vue Invalid Records (enregistrements invalides), filtrez sur Failed, choisissez le contrôle, et digna liste chaque ligne en échec. Ici, les 82 portent le même product_code, 3858646 (Coavira 2.5 mg). Il ne s'agit pas de 82 erreurs de saisie, mais d'un seul produit absent du référentiel. Chaque rapport qui joignait les doses aux produits affichait 0 dose de ce produit, alors que le personnel infirmier en avait administré 82.

Invalid Records : chaque dose en échec avec l'hôpital, le service, le code produit et le nom du médicament.
Les cas de figure courants :
Une clé, de nombreuses lignes : l'enregistrement parent n'existe pas encore. Ajoutez-le aux données de référence et relancez l'inspection.
De nombreuses clés, un seul chargement : le chargement parent a échoué ou s'est exécuté en retard. Corrigez l'ordre de chargement.
Des clés presque correctes : zéros non significatifs, casse ou espaces diffèrent d'un système à l'autre. Normalisez dans une vue.
D'anciennes clés : des enregistrements parents ont été supprimés ou archivés alors que des enfants y font encore référence.
Les lignes en échec sont exportables : l'équipe responsable reçoit les enregistrements, pas seulement un chiffre.
Par où commencer ?
Choisissez la relation dont les orphelins feraient le plus de dégâts s'ils atteignaient un rapport ce mois-ci, et placez-y un contrôle après le prochain chargement. Chaque contrôle tient en quelques champs, s'exécute dans votre base de données, et vos données ne quittent jamais votre infrastructure. Si vous voulez le voir sur vos propres tables, réservez une démo avec l'équipe digna.
Questions fréquentes
Comment vérifier l'intégrité référentielle en SQL ?
Faites une jointure gauche de la table enfant vers les valeurs de clé distinctes du parent et comptez les lignes pour lesquelles le côté parent est NULL, en ignorant celles dont la clé étrangère est elle-même NULL. Ces lignes sont des orphelins. Sélectionnez-les au lieu de les compter pour obtenir les enregistrements à corriger ; la planification, les seuils et l'historique restent à construire vous-même.
Un contrôle d'intégrité référentielle échoue-t-il sur les clés étrangères NULL ?
Non. Dans digna, les contrôles d'intégrité référentielle ignorent les valeurs NULL, car un NULL n'a rien à rechercher dans la table parente. Lorsque la référence est obligatoire, ajoutez une règle distincte de type Rule, par exemple product_code IS NOT NULL, afin qu'une valeur manquante et une valeur orpheline apparaissent comme des constats différents.
Un contrôle d'intégrité référentielle peut-il utiliser une clé composite ?
Oui. Sélectionnez plusieurs attributs sur la source de données et le même nombre sur le parent, dans le même ordre, et digna contrôle la combinaison. Les listes de colonnes de longueurs différentes sont rejetées, car comparer une clé à deux colonnes à une seule colonne laisserait passer des lignes que la clé complète aurait détectées.
Quel seuil un contrôle d'intégrité référentielle doit-il utiliser ?
Pour les données financières et cliniques, utilisez le mode Absolute avec une tolérance zéro, afin qu'un seul orphelin fasse échouer l'exécution. Les très grandes tables qui présentent une traîne connue de références arrivant en retard se prêtent plutôt à un seuil Relative ; dans digna, il s'agit d'une fraction, donc 0.01 signifie un pour cent des lignes évaluées.
Combien de temps faut-il pour configurer un contrôle d'intégrité référentielle dans digna ?
Moins d'une minute. Ouvrez la source de données dans Configuration, allez dans l'onglet Data Validation, cliquez sur Add Rule, réglez Type sur Referential Integrity, choisissez les attributs et la source de données dans laquelle ils doivent exister, définissez deux seuils et enregistrez. digna génère le SQL et l'exécute dans votre base de données.



