Intégrité référentielle entre bases de données : comment la vérifier
|
6
minute de lecture

Vos commandes résident dans l'entrepôt de données. Les clients auxquels elles renvoient résident dans le CRM, sur un autre serveur, géré par une autre équipe. L'intégrité référentielle entre bases de données signifie que chaque clé d'un système, par exemple le numéro client d'une commande, correspond à un enregistrement existant dans la table de référence d'un autre système. Une clé étrangère ne peut pas le garantir, car une clé étrangère déclarée ne fonctionne en général qu'à l'intérieur d'une seule base de données. Ainsi, lorsqu'une commande arrive avec un numéro client que le CRM n'a jamais attribué, rien n'échoue. La ligne se charge, une jointure l'écarte, et un rapport quelque part devient faux sans que personne ne s'en aperçoive.
C'est la variante la plus difficile de l'intégrité référentielle. À l'intérieur d'une base de données, vous pouvez au moins déclarer la contrainte ; au-delà d'une frontière entre bases, serveurs ou systèmes, il n'y a rien à déclarer. Le concept général est traité dans notre article de référence Vos données retrouvent-elles encore leurs parents ? Comprendre l'intégrité référentielle. Cet article traite de l'intégrité référentielle entre systèmes : où elle se rompt, ce que coûtent les contournements habituels, pourquoi les formats de clés produisent de fausses alertes, et comment la vérifier dans digna sans copier les données de référence où que ce soit.
Points clés
Une clé étrangère entre bases de données n'est en général pas possible : une contrainte déclarée référence des tables de la même base, si bien que les références entre systèmes ne sont, par construction, pas protégées.
Les contournements habituels (requêtes fédérées, tables de référence copiées, recherches pendant l'ETL, exports de rapprochement) ajoutent des déplacements de données, des pipelines ou du travail manuel.
Les différences de format de clé, comme les zéros non significatifs, la casse, le remplissage par des espaces ou les types de données, créent de faux orphelins. Convenez d'une forme canonique de la clé avant de comparer.
Depuis la Release 2026.01, digna Data Validation vérifie l'intégrité référentielle entre tables, vues, schémas et différentes connexions de base de données d'un même projet, en validant les données là où elles résident.
La configuration se résume à quelques champs : les colonnes de clé, la source de données dans laquelle elles doivent exister, deux seuils. Aucun SQL à écrire.
Table des matières
Pourquoi une clé étrangère ne peut-elle pas protéger une référence entre bases de données ?
Où les références entre systèmes se rompent-elles ?
Référentiel clients dans le CRM, transactions dans l'entrepôt
Référentiel produits dans l'ERP, commandes dans le système de commandes
Référentiel patients et venues cliniques
Core banking et entrepôt de reporting
Comment les équipes valident-elles habituellement les références entre systèmes ?
Pourquoi les différences de format de clé créent-elles de faux orphelins ?
Comment vérifier l'intégrité référentielle entre bases de données dans digna ?
Quelles références entre systèmes vérifier en premier ?
Prochaine étape
Pourquoi une clé étrangère ne peut-elle pas protéger une référence entre bases de données ?
Une clé étrangère ne peut pas protéger une référence entre bases de données, car c'est une contrainte que le moteur applique à ses propres tables : il recherche la ligne référencée dans la même base à chaque insertion, mise à jour et suppression. Une clé étrangère déclarée ne peut en général pas pointer vers une table d'une autre base, d'un autre serveur ou d'un autre produit, il n'y a donc rien contre quoi vérifier.
Certains moteurs permettent d'interroger plusieurs bases, mais interroger n'est pas contraindre. Une contrainte appliquée entre systèmes exigerait que le système distant soit disponible et cohérent à chaque écriture, alors que des systèmes séparés existent justement pour que l'un continue de tourner pendant que l'autre est arrêté, migré ou en cours de rechargement.
Côté entrepôt, c'est encore pire. De nombreuses plateformes analytiques acceptent les déclarations de clés étrangères sans les appliquer, même au sein d'une seule base : Snowflake les décrit comme optionnelles et non appliquées sur les tables standard, et BigQuery indique qu'il ne les applique pas. Et les systèmes évoluent indépendamment : l'équipe CRM fusionne des clients en double, l'ERP retire un produit. Chaque modification est valide dans son propre système et peut pourtant laisser ailleurs des enregistrements pointer vers des clés qui n'existent plus.
Où les références entre systèmes se rompent-elles ?
Les références entre systèmes se rompent partout où un système détient les données de référence et un autre enregistre l'activité : une table de transactions qui référence un client, un produit, un patient ou un compte géré ailleurs, par une autre équipe, selon son propre cycle de mise en production et avec ses propres règles de fusion et de retrait des clés. Quatre situations reviennent sans cesse.
Référentiel clients dans le CRM, transactions dans l'entrepôt
L'administration des ventes gère les clients dans le CRM ; les commandes sont chargées chaque nuit dans l'entrepôt. Lorsque deux fiches CRM sont fusionnées, un identifiant disparaît. Les commandes de l'entrepôt le portent toujours, et le chiffre d'affaires par client, par segment ou par région perd des lignes sans bruit.
Référentiel produits dans l'ERP, commandes dans le système de commandes
Un nouveau produit est mis en vente avant que sa fiche dans l'ERP ne soit publiée, ou un produit arrêté est supprimé alors que des commandes ouvertes le référencent encore. Les lignes de commande sans produit correspondant disparaissent des rapports de marge et de stock.
Référentiel patients et venues cliniques
Les hôpitaux gèrent l'identité des patients dans un référentiel patients, souvent un index patient principal (MPI), et enregistrent les admissions, les demandes d'analyses et les médicaments dans les systèmes cliniques. Lorsque des patients en double sont fusionnés, les venues qui référencent encore l'identifiant retiré perdent leur patient, ce qui affecte la facturation et le reporting clinique.
Core banking et entrepôt de reporting
Les comptes et les clients résident dans le système de core banking. Le reporting de gestion et le reporting réglementaire tournent sur un entrepôt séparé, alimenté par plusieurs systèmes sources. Une écriture qui référence un compte absent de la dimension compte du reporting est soit exclue des totaux, soit rangée dans une catégorie « inconnu ». Nous approfondissons ce cas dans l'article sur l'intégrité référentielle des données bancaires.
Comment les équipes valident-elles habituellement les références entre systèmes ?
Les équipes valident habituellement les références entre systèmes de l'une de quatre manières : interroger la table distante via un linked server, un database link ou une requête fédérée ; copier la table de référence dans le système cible ; rechercher les clés pendant l'ETL ; ou exporter les clés des deux côtés et les rapprocher périodiquement. Chacune fonctionne, et chacune a un coût.
Le contrôle sous-jacent est toujours la même anti-jointure. Si les deux tables étaient accessibles depuis un seul moteur, il ressemblerait à ceci :
Les contournements diffèrent par la façon dont ils rendent crm.customers accessible depuis le système qui contient sales_orders :
Approche | Fonctionnement | Ce que cela coûte |
|---|---|---|
Linked servers, database links, requêtes fédérées | Un moteur interroge directement la table distante et exécute la jointure | Les deux systèmes doivent être disponibles au moment de la requête ; les grosses jointures à travers le réseau sont lentes et chargent la source ; les identifiants d'accès au système distant sont stockés dans la base ; souvent bloqué entre zones réseau |
Copier la table de référence dans l'entrepôt | Un pipeline réplique la table de référence à côté des transactions | Un pipeline de plus à construire et à exploiter ; le contrôle n'est jamais plus à jour que la dernière copie ; une copie supplémentaire de données de référence, souvent personnelles, soulève des questions de protection et de localisation des données |
Recherches pendant l'ETL | Le job de chargement recherche chaque clé et rejette ou signale les lignes sans correspondance | Ne couvre que les données qui passent par ce pipeline ; ne vérifie qu'une fois, au chargement, si bien que les suppressions et fusions ultérieures dans le référentiel passent inaperçues ; les tables de rejets s'accumulent sans être lues |
Exports de rapprochement périodiques | Les listes de clés des deux systèmes sont exportées dans des fichiers et comparées | Manuel et peu fréquent ; les résultats arrivent des semaines après l'erreur ; les fichiers de clés circulent par e-mail ou sur des partages réseau |
Aucune de ces approches n'est mauvaise, mais elles partagent un problème : soit les données se déplacent, soit quelqu'un doit penser à lancer quelque chose. Ce qu'il vous faut, c'est un contrôle planifié qui lit chaque côté là où il réside et indique à l'équipe responsable quels enregistrements sont orphelins.
Pourquoi les différences de format de clé créent-elles de faux orphelins ?
Les différences de format de clé créent de faux orphelins parce que deux systèmes peuvent stocker la même clé métier sous des formes différentes : en texte dans l'un et en nombre dans l'autre, avec ou sans zéros non significatifs, dans une casse différente ou avec des espaces en fin de chaîne. Une comparaison octet par octet signale alors un parent manquant qui existe en réalité.
C'est la raison la plus fréquente pour laquelle un premier contrôle entre systèmes signale des milliers d'échecs :
Différence | Système A | Système B |
|---|---|---|
Zéros non significatifs |
|
|
Casse |
|
|
Remplissage et espaces |
|
|
Conversions de type |
|
|
Préfixes système |
|
|
Corrigez-le en trois étapes :
Convenez d'une forme canonique pour la clé, par exemple une chaîne sans espaces superflus, en majuscules, complétée à dix chiffres.
Normalisez un côté ou les deux vers cette forme dans une vue ou une instruction SQL, au plus près de la source.
Vérifiez que la clé de référence normalisée reste unique. Supprimer des zéros ou changer la casse peut fusionner deux clés différentes en une seule, ce qui masquerait de vrais orphelins.
Une requête de normalisation ressemble à ceci (les noms de fonctions varient légèrement d'une base à l'autre) :
Ne normalisez pas au point d'effacer de vraies différences. Si un préfixe indique quel système source a émis la clé, une clé composite formée du système source et du numéro est plus sûre que la suppression du préfixe.
Comment vérifier l'intégrité référentielle entre bases de données dans digna ?
Dans digna, un contrôle d'intégrité référentielle entre bases de données est une règle Data Validation de type Referential Integrity dont le côté « must exist in » pointe vers une source de données située sur une autre connexion de base de données du même projet. Depuis la Release 2026.01, elle valide les données là où elles résident, sans répliquer l'une des tables dans l'autre système.
Deux évolutions de la Release 2026.01 rendent cela possible. Les contrôles d'intégrité référentielle s'exécutent entre tables et vues, entre schémas et entre différentes connexions de base de données au sein d'un même projet. Et une source de données est une couche logique adossée à une table, une vue ou une instruction SQL personnalisée, ce qui vous donne un endroit pour gérer les formats de clé : une source de données en SQL personnalisé peut supprimer les espaces, convertir ou compléter la clé avant la comparaison, à la manière de la requête ci-dessus. Testez cette normalisation sur des données réelles avant de vous y fier. Les connexions de base de données sont globales, si bien qu'une connexion CRM configurée une fois peut être réutilisée par tous les projets.
La règle elle-même se configure dans une seule boîte de dialogue :
Allez dans Configuration, sélectionnez la source de données qui contient les lignes référençantes, ouvrez l'onglet Data Validation et cliquez sur Add Rule. La boîte de dialogue Add Data Validation Rule s'ouvre.
Saisissez un Name (nom) et une Description qui énonce ce qui doit être vrai, par exemple « Chaque commande référence un client du référentiel CRM ».
Réglez Type sur Referential Integrity.
Sous Attributes (attributs), choisissez la ou les colonnes de clé de cette source de données.
Sous must exist in (doit exister dans), choisissez la Data Source cible, qui peut se trouver sur une autre connexion, et ses Attributes correspondants. Pour une clé composite, choisissez les colonnes des deux côtés dans le même ordre.
Choisissez un Threshold Mode (mode de seuil : Absolute ou Relative) et définissez l'Info threshold et le Warn threshold.
Enregistrez. La règle s'exécute à chaque inspection de la source de données, planifiée ou à la demande.

La règle d'intégrité référentielle dans digna : product_code doit exister dans la source de données hospital_medications.
Les captures d'écran proviennent de notre projet de démonstration, dans lequel les deux sources de données se trouvent sur la même connexion. La boîte de dialogue est identique lorsque la source de données cible se trouve sur une autre connexion : vous la choisissez sous « must exist in » comme n'importe quelle autre source de données. La démo utilise des données fictives de Danubia Kliniken, un groupe hospitalier autrichien inventé.
La règle hc_product_in_master stipule que chaque produit administré doit exister dans le référentiel produits de la pharmacie. Le 22 avril 2026, les services ont enregistré 82 administrations de « Coavira 2.5 mg » (code produit 3858646) avant que le produit n'ait été ajouté au référentiel. Tous les rapports qui joignaient les doses aux produits affichaient zéro dose du nouveau produit, alors que le personnel infirmier en avait administré 82.
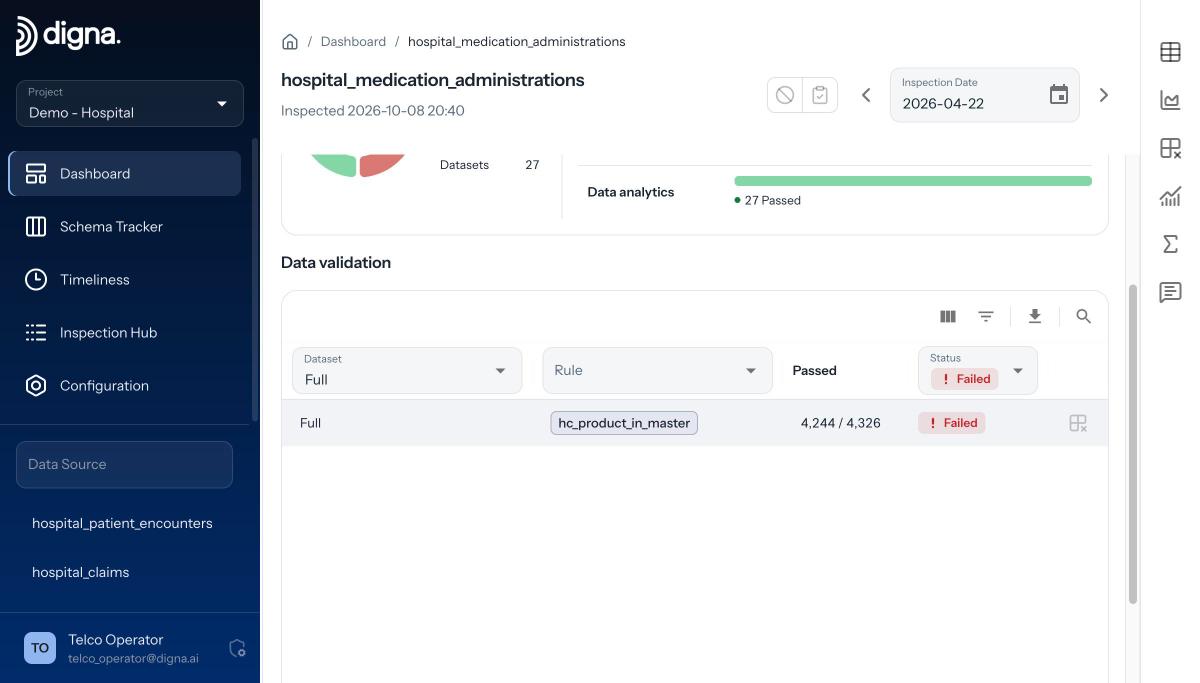
Le résultat du 22 avril 2026 : 4 244 lignes sur 4 326 réussies, 82 en échec, statut Failed.
digna indique pour chaque règle le nombre de lignes réussies et en échec, et renvoie les enregistrements en échec eux-mêmes : la même requête avec la condition de réussite inversée. Dans la vue Invalid Records, vous filtrez sur Passed, Uncertain ou Failed, choisissez le contrôle et voyez les lignes, ici avec l'hôpital, le service, le code produit et le nom du médicament. Vous pouvez les exporter et prévenir l'équipe responsable des données.
Quelques comportements comptent pour les contrôles entre systèmes :
Les seuils valent zéro par défaut, de sorte qu'une nouvelle règle échoue dès le premier orphelin. Si l'on sait que le référentiel a quelques heures de retard sur les transactions, relevez l'Info threshold pour qu'un petit nombre apparaisse en Uncertain plutôt qu'en Failed, ou utilisez le mode Relative.
Les clés NULL sont ignorées. Un numéro client manquant ne fait pas échouer le contrôle référentiel. Si la clé est obligatoire, ajoutez une règle distincte de type Rule, par exemple
customer_no IS NOT NULL.Les listes de colonnes doivent avoir la même longueur. Une différence est rejetée au lieu de vérifier silencieusement une condition plus faible.
Les contrôles s'exécutent dans les bases de données sources. digna envoie du SQL et reçoit des comptages, ainsi que les lignes en échec lorsque vous les demandez. Vos données ne quittent jamais votre infrastructure.
Pour le pas-à-pas complet avec chaque champ, consultez l'article Comment configurer un contrôle d'intégrité référentielle. Les types de règles, les seuils et les vues de résultats sont décrits sur la page digna Data Validation et dans la documentation.
Quelles références entre systèmes vérifier en premier ?
Vérifiez d'abord les références entre systèmes qui alimentent des rapports sur lesquels des décisions sont prises, et celles dont les données de référence sont régulièrement fusionnées, renumérotées ou retirées, car c'est là qu'un orphelin se transforme directement en chiffre faux. Commencez par quelques règles et élargissez le périmètre une fois les faux orphelins liés aux formats de clé traités.
Un ordre pratique pour valider les données de référence entre systèmes :
Les transactions par rapport au référentiel clients, comptes ou patients, car les fusions et clôtures y sont permanentes.
Les lignes de commande et les mouvements de stock par rapport au référentiel produits, car les nouveaux produits sont souvent vendus avant que leur fiche ne soit complète.
Les codes de référence (pays, devise, centre de coûts) par rapport au système qui détient la liste de codes.
Associez chaque règle référentielle à une règle Uniqueness sur la clé de référence : un contrôle de référence portant sur un référentiel contenant des clés en double peut réussir alors que les données restent fausses.
Prochaine étape
Les clés étrangères s'arrêtent à la frontière de la base de données, et une grande partie des données qui comptent la franchit. Vous n'avez pas besoin d'un pipeline de plus pour valider les références entre systèmes : une règle Referential Integrity par relation, exécutée là où résident les données, montre après chaque inspection quels enregistrements ont perdu leur parent. Si vous souhaitez le voir sur votre propre environnement, réservez une démo avec l'équipe digna.
Questions fréquentes
Peut-on créer une clé étrangère entre bases de données ?
En général, non. Une clé étrangère déclarée référence une table de la même base, car le moteur la vérifie à chaque insertion, mise à jour et suppression. Entre bases, serveurs ou produits, il n'y a rien à déclarer : les références entre systèmes doivent donc être validées par un contrôle planifié, comme une anti-jointure ou une règle d'intégrité référentielle.
Comment vérifier l'intégrité référentielle entre deux bases de données différentes ?
Exécutez une anti-jointure qui renvoie les clés de la table référençante sans correspondance dans la table de référence. Les équipes rendent généralement les deux tables accessibles via des requêtes fédérées, des tables de référence copiées, des recherches pendant l'ETL ou des exports de rapprochement. Dans digna, une règle Referential Integrity peut pointer vers une source de données d'une autre connexion, sans répliquer de données.
Pourquoi un contrôle entre systèmes signale-t-il des orphelins qui existent en réalité ?
Le plus souvent, les formats de clé diffèrent. Un système stocke '0004711' en texte, l'autre 4711 en entier, et la casse, les espaces en fin de chaîne ou les préfixes système provoquent les mêmes faux orphelins. Convenez d'une forme canonique, normalisez la clé dans une vue ou une instruction SQL, et vérifiez que la clé de référence normalisée reste unique.
digna copie-t-il la table de référence pour comparer les clés entre connexions ?
Non. Depuis la Release 2026.01, digna vérifie l'intégrité référentielle entre tables, vues, schémas et connexions de base de données d'un même projet sans répliquer de données. Les contrôles s'exécutent dans vos bases : digna envoie du SQL et reçoit des comptages, ainsi que les lignes en échec lorsque vous les demandez. Vos données ne quittent jamais votre infrastructure.
Les clés étrangères NULL font-elles échouer un contrôle d'intégrité référentielle dans digna ?
Non. Les règles Referential Integrity ignorent les NULL : une ligne avec un numéro client vide n'est pas comptée comme orpheline. Lorsque la clé est obligatoire, ajoutez une règle distincte de type Rule avec une condition comme customer_no IS NOT NULL, afin que les clés manquantes et les clés sans correspondance soient signalées comme deux problèmes distincts.



