Complétude des données : ce que dit le DAMA et comment la mesurer
|
6
minute de lecture

Le conseil le plus populaire concernant la complétude des données est aussi le plus trompeur : compter les valeurs NULL et considérer que le travail est terminé. Qu'est-ce que la complétude des données ? C'est le degré auquel toutes les données requises pour un usage particulier sont présentes. Cette définition déplace la question de « Y a-t-il des cellules vides ? » à « Ce jeu de données contient-il ce dont le processus métier, le rapport, le modèle ou le contrôle a besoin ? »
Un champ renseigné peut toujours contenir une valeur erronée, tandis qu'un NULL dans un champ facultatif peut n'avoir aucun impact pratique. La complétude est donc une question d'adéquation à l'usage, et non une exigence de perfection abstraite. Les directives des Nations Unies sur la couverture et la complétude établissent la même distinction conceptuelle dans les statistiques officielles, où la complétude compare les événements enregistrés avec le total mondial qu'ils sont censés représenter.
Table des matières
En quoi la complétude diffère de l'exactitude et de la validité
Ce que signifie réellement la complétude des données
La complétude des données est le degré auquel toutes les données requises pour un usage particulier sont présentes. Dans un jeu de données d'entreprise, cela peut signifier des attributs obligatoires renseignés, des enregistrements métiers complets, des populations d'enregistrements attendues, des périodes de rapport requises ou l'ensemble des jeux de données sources nécessaires à un processus en aval.
C'est pourquoi la complétude ne se résume pas à l'absence de valeurs NULL. Supposons qu'une table client contienne un identifiant client manquant. Il s'agit d'un défaut de complétude lorsque l'identifiant est requis pour des jointures, des rapprochements ou des rapports. Une préférence marketing secondaire manquante peut être acceptable si l'usage prévu n'en dépend pas.
Cette distinction sépare également la complétude des autres dimensions de la qualité des données. Si une adresse est présente mais incorrecte, le problème concerne l'exactitude. Si un numéro de téléphone est présent mais ne respecte pas le format requis, le problème concerne la validité. La complétude demande uniquement si l'information requise existe dans le périmètre défini.
Commencer par l'objectif métier
Avant de choisir une métrique, identifiez ce que les données doivent soutenir :
Le reporting réglementaire peut exiger chaque entité déclarable et chaque attribut obligatoire.
Le traitement opérationnel peut dépendre des identifiants, des dates et des champs de statut.
L'analyse peut tolérer des attributs d'enrichissement manquants si la population principale reste disponible.
Le développement de l'IA nécessite suffisamment de champs, d'enregistrements et de périodes temporelles pour l'analyse visée, car les données manquantes peuvent réduire la taille de l'échantillon analysable et produire des estimations biaisées ou imprécises, comme décrit dans cette étude hébergée par le NIH sur les données manquantes.
Règle pratique : Définissez ce que signifie « assez complet » avant de le mesurer. Sinon, un tableau de bord affiche un chiffre sans dire à quiconque si ce chiffre permet de prendre la décision.
Une définition de travail utile est la suivante : les enregistrements, champs, relations et périodes de livraison requis sont présents dans le périmètre et la cadence attendus pour un cas d'usage défini. Cette définition donne aux propriétaires de données des éléments qu'ils peuvent transformer en contrôles.
Les Clinical types de complétude qui méritent d'être mesurés
Les organisations ont besoin de plusieurs perspectives de complétude, car les valeurs manquantes et les populations manquantes constituent des défaillances différentes. Les cinq types ci-dessous couvrent les besoins courants de surveillance en entreprise, bien que les équipes doivent sélectionner la combinaison qui correspond aux exigences métiers.
Complétude des attributs
La complétude des attributs demande si les champs requis sont renseignés. Les exemples typiques incluent :
Identifiants clients manquants
Dates de transaction manquantes
Numéros de compte manquants
Attributs métiers
NULLrequis par un rapport ou un processus
Un enregistrement client peut exister, mais si son identifiant est absent, l'enregistrement peut être inutilisable pour le dédoublonnage ou les jointures. La mesure pertinente est la part des enregistrements attendus contenant une valeur dans l'attribut spécifié.
Complétude des enregistrements
La complétude des enregistrements demande si chaque enregistrement disponible contient l'ensemble des champs obligatoires. Une transaction peut avoir un identifiant et un montant mais manquer de son identifiant client, de sa devise ou de sa date de transaction. Compter la ligne comme présente masquerait le fait que l'enregistrement n'est pas opérationnellement complet.
Complétude du nombre d'enregistrements
La complétude du nombre d'enregistrements compare la population livrée avec la population attendue. Par exemple, une table de transactions quotidiennes qui contient habituellement 10 millions d'enregistrements mais n'en contient soudainement que 7 millions présente un problème de complétude de population, même si chaque ligne livrée possède des champs parfaitement renseignés.
L'article de recherche de DAMA sur la qualité des données soutient cette vision élargie en abordant la complétude à travers les enregistrements, les fichiers, les attributs et les métadonnées.
Complétude temporelle
La complétude temporelle vérifie si toutes les dates ou périodes de reporting attendues sont présentes. Un pipeline financier peut se charger avec succès tout en omettant un jour, un mois ou une partition de reporting. La table peut contenir des lignes valides, mais la série temporelle est incomplète.
Complétude du jeu de données
La complétude du jeu de données demande si chaque jeu de données requis par un processus en aval est disponible. Un flux de travail de reporting mensuel peut nécessiter des jeux de données sur les clients, les transactions, les produits et les taux de change. Si une source n'arrive pas, les entrées du flux de travail sont incomplètes même si les autres tables sont renseignées.
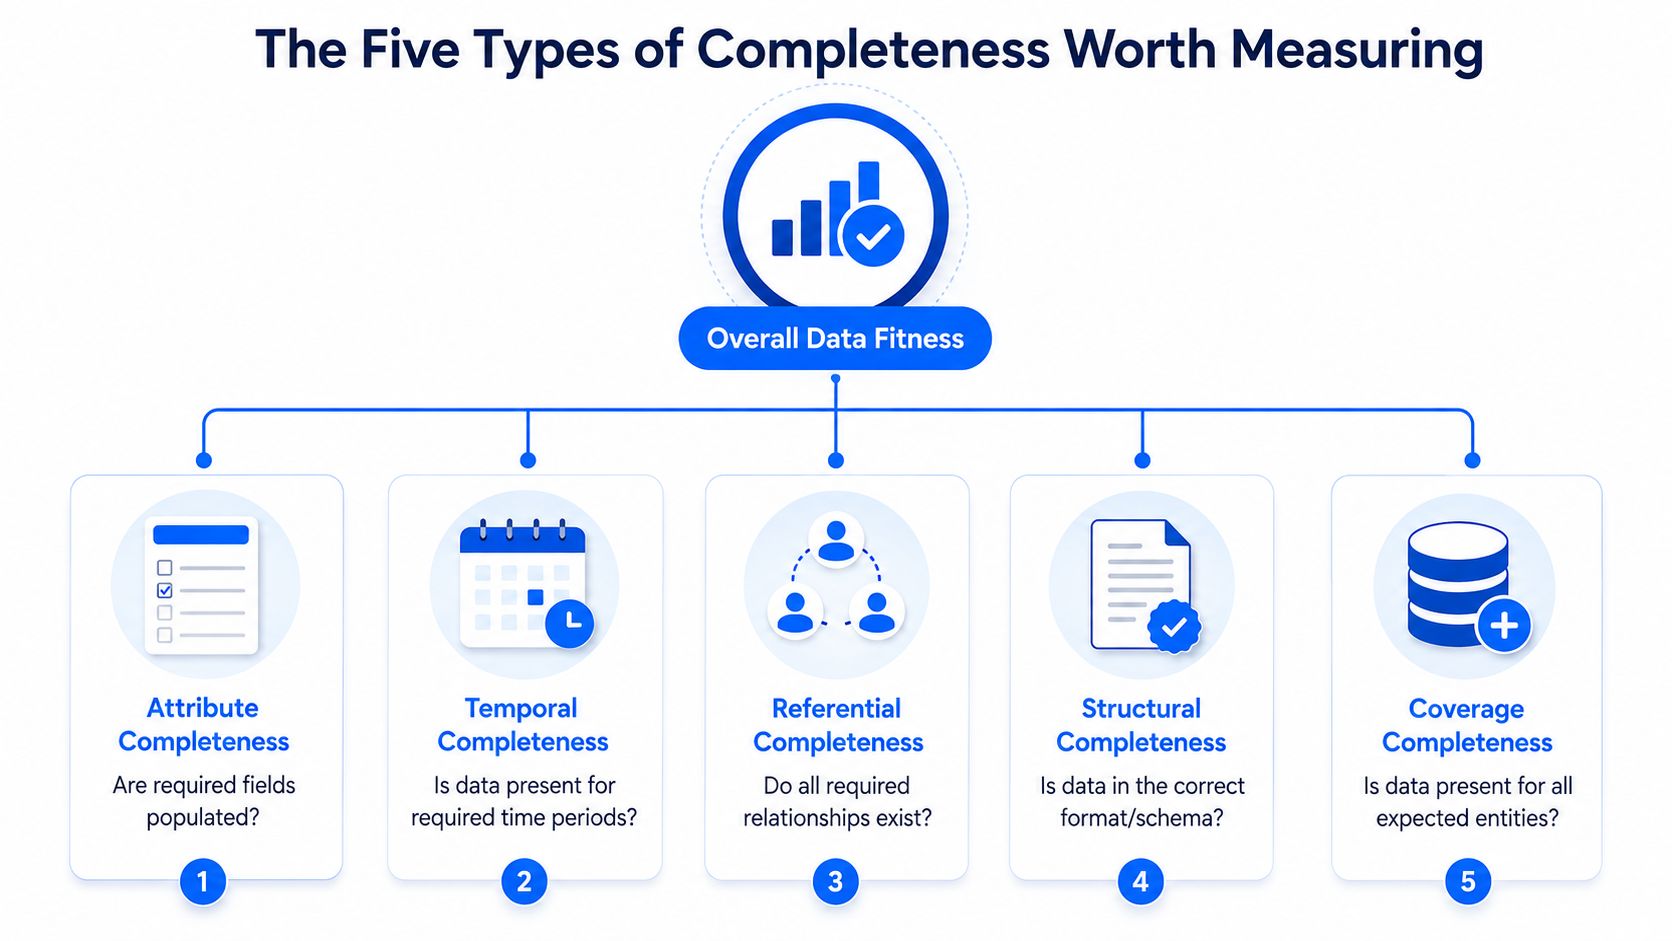
Ces contrôles ne sont pas interchangeables. Une équipe peut avoir besoin de la complétude des attributs et des enregistrements pour un référentiel client, de la complétude temporelle et du nombre d'enregistrements pour les transactions, et de la complétude du jeu de données pour une dépendance d'orchestration.
Comment DAMA et DMBOK abordent la complétude
DAMA International et l'édition révisée DAMA-DMBOK® 2.0 traitent la complétude comme une dimension de la qualité des données. Le cadre est particulièrement utile lorsque les équipes appliquent la complétude en relation avec les exigences métiers et l'adéquation à l'usage, plutôt que de la traiter comme un score technique universel. L'aperçu des cadres de gestion des données et DAMA fournit un contexte connexe pour positionner la qualité des données au sein de pratiques de gestion plus larges.
La formulation de DAMA s'aligne sur une question pratique : que doit-on savoir pour que cette donnée remplisse le rôle prévu ? Le guide sur la qualité des données du gouvernement britannique stipule que les données sont complètes lorsque toutes les données requises pour un usage particulier sont présentes, et conseille de mesurer la complétude pour les données critiques plutôt que pour chaque champ de chaque jeu de données.
Cela signifie qu'une complétude à 100 % n'est pas automatiquement l'exigence appropriée pour chaque jeu de données. Un taux de complétude de 98 % peut être acceptable pour un cas d'usage analytique, mais inacceptable pour un reporting réglementaire. Ces valeurs illustrent une décision de governance, et non des seuils universels.
Définir les exigences par impact
Une politique utile relie la complétude aux conséquences :
Identifier le rapport, le modèle, le processus ou le contrôle qui consomme les données.
Définir les enregistrements et les attributs sans lesquels il ne peut fonctionner.
Établir un seuil de complétude acceptable avec le propriétaire des données.
Documenter ce qui se passe lorsque le seuil n'est pas atteint.
Réviser l'exigence lorsque le cas d'usage change.
Une clé primaire, un attribut réglementaire ou un identifiant de transaction méritent généralement un traitement plus strict qu'un enrichissement descriptif facultatif. La contribution de DAMA réside dans le vocabulaire et la discipline nécessaires pour rendre cette distinction explicite. Elle ne remplace pas les décisions des propriétaires locaux.
Métriques et formules pour mesurer la complétude
Les métriques de complétude des données doivent mesurer le manque d'informations susceptible d'affecter un cas d'usage défini. Un modèle de mesure solide combine des indicateurs au niveau des champs, des enregistrements, de la population, du temps et du jeu de données, plutôt que de s'appuyer sur un simple décompte de valeurs nulles.
La formule de base est :
Taux de complétude = valeurs requises renseignées / valeurs requises attendues × 100
Pour la complétude des attributs, les « valeurs requises renseignées » correspondent au nombre d'enregistrements ayant une valeur dans le champ sélectionné. Pour la complétude des enregistrements, le numérateur compte les enregistrements contenant tous les attributs obligatoires. Pour la complétude de la population, comparez les enregistrements livrés avec la population d'enregistrements attendue. Le dénominateur doit refléter la définition métier des données attendues, et pas simplement le nombre de lignes qui se trouvent être arrivées.
Mesures clés
Taux de NULL : La part des enregistrements où un champ sélectionné est manquant. Cela aide à localiser les lacunes au niveau des champs mais ne révèle pas les enregistrements ou les jeux de données manquants.
Couverture des champs requis : La part des valeurs attendues renseignées pour les attributs obligatoires.
Nombre d'enregistrements : Le nombre d'enregistrements livrés pour un chargement, une partition, une entité ou une période définis.
Variance du nombre d'enregistrements : La différence entre le volume observé et attendu, en utilisant une référence documentée ou un rapprochement des sources.
Disponibilité du jeu de données : Vérifier si chaque source, table, fichier ou partition requis est présent.
Couverture temporelle : Vérifier si toutes les dates et périodes de reporting requises sont représentées.
Tendances de complétude : L'évolution de chaque mesure dans le temps, ce qui aide à distinguer un incident ponctuel d'une détérioration progressive.
Métrique | Ce qu'elle mesure | Usage typique |
|---|---|---|
Taux de NULL | Valeurs manquantes dans un attribut sélectionné | Identifiant client ou numéro de compte requis |
Couverture des champs requis | Valeurs obligatoires renseignées par rapport aux valeurs attendues | Contrôles opérationnels et réglementaires |
Nombre d'enregistrements | Population de lignes livrées | Surveillance des lots (batch) et des flux d'événements |
Variance du nombre d'enregistrements | Différence par rapport au volume attendu | Détection de perte de lignes ou de chargements incomplets |
Couverture temporelle | Présence des périodes requises | Finance, opérations et analyse de séries temporelles |
Disponibilité du jeu de données | Présence des sources de données requises | Vérification des dépendances en aval |
Tendance de complétude | Évolution de la complétude dans le temps | Analyse des problèmes récurrents et de la dérive des processus |
Le guide des métriques de qualité des données de digna offre un contexte supplémentaire pour sélectionner les mesures. La décision importante de governance consiste à donner la priorité aux attributs et populations critiques. Mesurer chaque champ de la même manière crée du bruit et peut rendre un écart grave plus difficile à détecter.
En quoi la complétude diffère de l'exactitude et de la validité
La complétude demande si les données requises sont présentes. L'exactitude demande si elles sont correctes. La validité demande si elles respectent les règles ou le format requis. Ces dimensions peuvent échouer indépendamment, de sorte que les équipes doivent éviter d'attribuer une étiquette générique de « problème de qualité » à ces trois notions.
Considérons le numéro de téléphone d'un client :
Complétude : Un numéro de téléphone est-il présent lorsque l'entreprise l'exige ?
Validité : La valeur respecte-t-elle le format de numéro de téléphone accepté ?
Exactitude : La valeur correspond-elle au véritable numéro de téléphone du client ?

Complétude et exactitude
Un numéro de téléphone manquant est un problème de complétude. Un numéro de téléphone correctement formaté mais appartenant à un autre client est un problème d'exactitude. Le champ est présent dans les deux cas, mais une seule valeur représente correctement l'entité du monde réel.
L'explication de Dataversity sur les dimensions de la qualité des données décrit la complétude comme la mesure des informations manquantes, et non de l'exactitude ou de la validité des informations stockées. Cette distinction est importante car la correction diffère. Les données manquantes peuvent nécessiter une saisie dans le système source ou un retraitement, tandis que les données inexactes peuvent nécessiter une vérification, une correction ou une intendance des données de référence (data stewardship).
Complétude et validité
Un numéro de téléphone manquant est incomplet. Un numéro de téléphone contenant des lettres alors que le schéma requiert un modèle numérique est invalide. Un numéro de téléphone correctement formaté mais erroné est inexact.
Question | Dimension | Exemple |
|---|---|---|
La valeur requise est-elle présente ? | Complétude | Le numéro de téléphone est manquant |
Est-elle conforme à la règle ? | Validité | Le numéro de téléphone a un format invalide |
Correspond-elle à la réalité ? | Exactitude | Le numéro appartient à quelqu'un d'autre |
La distinction d'IBM entre complétude, exactitude et validité renforce ce modèle à trois questions. Utilisez-le pour attribuer des propriétaires, concevoir des tests et expliquer des incidents aux parties prenantes métiers.
Surveiller la complétude dans les pipelines modernes
Un pipeline techniquement réussi ne produit pas nécessairement des données complètes. Prenons l'exemple d'un entrepôt de données recevant quotidiennement des données clients et de transactions : le travail ETL se termine, l'orchestration signale un succès, et la table cible est disponible, mais le volume des transactions est nettement inférieur à la normale et les identifiants clients requis affichent une forte augmentation des valeurs NULL.
Le simple statut d'un pipeline ne peut pas détecter ces deux conditions. La première est un problème de nombre d'enregistrements ou de population. La seconde concerne la complétude des attributs. Une architecture de surveillance doit examiner les données après leur livraison, et pas seulement vérifier si le code s'est exécuté sans erreur.

Utiliser des contrôles multicouches
La validation déterministe vérifie les exigences connues, comme le fait qu'un identifiant client obligatoire ne soit pas
NULL.La détection d'anomalies identifie les changements inattendus dans le volume d'enregistrements, les taux de valeurs nulles, les distributions ou le comportement de livraison.
L'analyse historique montre si l'écart est isolé, saisonnier, récurrent ou s'il s'inscrit dans une détérioration à plus long terme.
La surveillance de la ponctualité vérifie si les données attendues sont arrivées à l'heure et à la cadence requises.
Dans ce scénario, les vérifications de complétude des données pour les pipelines d'entreprise peuvent être organisées autour de la perte de lignes, de la perte de champs, d'enregistrements manquants et de champs manquants. Le contrôle doit également identifier la partition source ou la livraison responsable de l'écart, afin que les ingénieurs puissent enquêter plutôt que de simplement observer un statut rouge.
Une exécution ETL réussie prouve que le processus s'est exécuté. Elle ne prouve pas que les données métiers requises sont arrivées.
La continuité est importante car la complétude évolue dans le temps. Un jeu de données propre aujourd'hui peut devenir incomplet après la mise à jour d'un système source, la modification d'un filtre d'extraction, une partition en retard ou le transfert d'un flux de travail. Une surveillance continue rend cette situation visible au moment le plus proche de son changement.
Comment digna peut-il soutenir la complétude des données ?
digna soutient la complétude des données grâce à des fonctionnalités distinctes pour les règles explicites, les comportements inhabituels et le contexte historique. Chaque fonctionnalité s'adresse à une couche différente, de sorte qu'une équipe ne doit pas traiter un module comme un substitut complet à l'ensemble des contrôles de complétude.
digna Data Validation
digna Data Validation prend en charge les exigences connues basées sur des règles, notamment :
Les champs requis ne doivent pas être
NULL.Chaque transaction doit avoir un identifiant requis.
Les attributs métiers obligatoires doivent être renseignés.
Les règles de complétude définies doivent être respectées.
C'est la fonctionnalité principale pour les exigences qui peuvent être énoncées directement et évaluées enregistrement par enregistrement.
digna Data Anomalies
digna Data Anomalies peut identifier les changements inattendus dans le comportement lié à la complétude, tels que des augmentations soudaines des taux de NULL, des baisses inattendues du nombre d'enregistrements, des changements importants de distribution et des écarts inhabituels par rapport aux volumes de données historiques.
La détection d'anomalies identifie un comportement inhabituel. Elle ne prouve pas automatiquement que les données sont incomplètes. Un changement saisonnier légitime peut sembler inhabituel, tandis qu'une subtile défaillance de complétude peut rester dans les limites d'un modèle historique large. Les équipes ont toujours besoin du contexte métier et, le cas échéant, de règles de validation explicites.
digna Data Analytics
digna Data Analytics fournit un contexte historique pour les métriques de complétude. Les équipes peuvent examiner les tendances du nombre d'enregistrements, les tendances du taux de NULL, la complétude historique, les modèles récurrents de données manquantes et les changements entre les périodes de reporting.
Exigence de complétude | Exemple | Fonctionnalité digna |
|---|---|---|
Valeurs requises | Le champ requis ne doit pas être | digna Data Validation |
Volume d'enregistrements | Nombre attendu d'enregistrements | digna Data Anomalies |
Complétude historique | Détecter la détérioration au fil du temps | digna Data Analytics |
Disponibilité du jeu de données | La source de données attendue est présente | digna Data Validation / digna Data Anomalies |
Cette mise en correspondance est délibérée. La validation applique des conditions connues, les anomalies font surface aux comportements inattendus, et l'analytique aide à déterminer si un problème est isolé ou récurrent.
Points clés à retenir et questions fréquemment posées
La complétude des données est une condition métier mouvante, et non une vérification statique des valeurs nulles. Définissez les données requises pour chaque cas d'usage, mesurez la couche pertinente et surveillez si les enregistrements, attributs, périodes et jeux de données continuent d'arriver comme prévu.
Qu'est-ce que la complétude des données ?
C'est le degré auquel toutes les données requises pour un usage particulier sont présentes. Le périmètre dépend de l'adéquation à l'usage.
Quels sont les types de complétude des données ?
Les types courants incluent la complétude des attributs, des enregistrements, du nombre d'enregistrements, temporelle et du jeu de données. Chacun répond à un risque différent lié aux données manquantes.
Comment mesure-t-on la complétude des données ?
Utilisez des mesures telles que le taux de NULL, la couverture des champs requis, le nombre d'enregistrements, la variance du nombre d'enregistrements, la disponibilité du jeu de données, la couverture temporelle et les tendances de complétude.
Que dit DAMA à propos de la complétude des données ?
Le DAMA-DMBOK traite la complétude comme une dimension de la qualité des données et relie les exigences aux besoins métiers et à l'adéquation à l'usage.
Une complétude des données à 100 % est-elle toujours requise ?
Non. Un taux de 100 % n'est pas universellement approprié. Une exigence doit refléter les conséquences des données manquantes pour l'usage prévu.
Quelle est la différence entre complétude et exactitude ?
La complétude demande si la valeur requise est présente. L'exactitude demande si cette valeur est correcte.
Quelle est la différence entre complétude et validité ?
La complétude concerne la présence. La validité concerne la conformité aux formats, règles ou standards définis.
Comment surveiller la complétude des données en continu ?
Combinez la validation basée sur des règles, la surveillance des enregistrements et des livraisons, la détection d'anomalies et l'analyse historique sur les pipelines de traitement par lots, de streaming et inter-systèmes.
Quels modules digna soutiennent la complétude des données ?
digna Data Validation, digna Data Anomalies, et digna Data Analytics soutiennent différents besoins de complétude. Ils doivent être mis en correspondance avec le contrôle spécifique plutôt que traités comme interchangeables.
digna fournit des fonctionnalités de digna Data Validation, de digna Data Anomalies et de digna Data Analytics pour vérifier les valeurs requises, identifier les comportements inhabituels de taux de valeurs nulles et d'enregistrements, et analyser la complétude au fil du temps. Visitez digna pour voir comment ces contrôles peuvent s'intégrer dans votre approche de surveillance de la qualité des données.
Questions fréquentes
Que signifie réellement la complétude des données ?
Le degré auquel toutes les données nécessaires à un usage donné sont présentes. L'usage est le mot décisif, car la complétude ne peut se juger sans savoir ce que la donnée doit soutenir.
Pourquoi compter les NULL induit-il en erreur ?
Parce que cela répond à une autre question. Un champ rempli peut contenir la mauvaise valeur, tandis qu'un NULL dans un champ facultatif peut n'avoir aucun impact pratique : compter les nuls mesure la présence, pas la suffisance.
Par où commencer avant de choisir une métrique ?
Par la finalité métier. Un reporting réglementaire peut exiger chaque entité déclarable et chaque attribut obligatoire, tandis qu'un jeu exploratoire peut tolérer des trous inacceptables ailleurs, et la métrique doit suivre cette exigence.
Comment DAMA cadre-t-elle la complétude ?
Comme une présence relative à une exigence, et non comme une propriété absolue d'une table. Ce cadrage distingue la complétude des autres dimensions, qui demandent si les valeurs présentes sont exactes, cohérentes ou à jour.
Une table peut-elle être complète et inutilisable ?
Oui. La complétude établit seulement que la donnée requise est là ; elle ne dit rien de l'exactitude de ces valeurs, de leur arrivée à temps, ni de leur accord avec la même entité enregistrée dans un autre système.



