Los 9 tipos de pipeline de datos: cómo elegir el mejor en 2026
|
10
minuto de lectura

Más allá de ETL: cómo elegir la arquitectura de pipeline de datos adecuada
Sus dashboards están desactualizados. Sus modelos de ML están sufriendo drift. Sus partes interesadas están perdiendo la confianza en los datos. Son síntomas habituales de un desajuste arquitectónico: un pipeline de datos que ya no puede seguir el ritmo de las exigencias del negocio. Elegir el pipeline adecuado no es solo una decisión técnica. Es una decisión estratégica que afecta a la actualidad de los datos, a la fiabilidad, al esfuerzo operativo y al grado de confianza que las personas depositan en cada métrica que utilizan.
Los pipelines rara vez fallan por una elección de herramienta inadecuada. El fallo se debe, más bien, a combinar la arquitectura equivocada con el trabajo que debe realizar. Una carga nocturna del data warehouse no puede dar soporte a la prevención del fraude. Un stack de streaming es excesivo para una conciliación financiera semanal. Esta guía se centra en la realidad operativa que hay detrás de los principales tipos de pipeline de datos, incluido dónde falla cada patrón, qué suelen subestimar los equipos y cómo hacer que cada uno sea observable desde el primer día.
Si está formando su equipo mientras define esa arquitectura, esta guía sobre puestos de ingeniero de datos en LATAM ofrece un contexto útil sobre el tipo de habilidades que exigen estos sistemas.
Índice
1. Pipelines de procesamiento por lotes
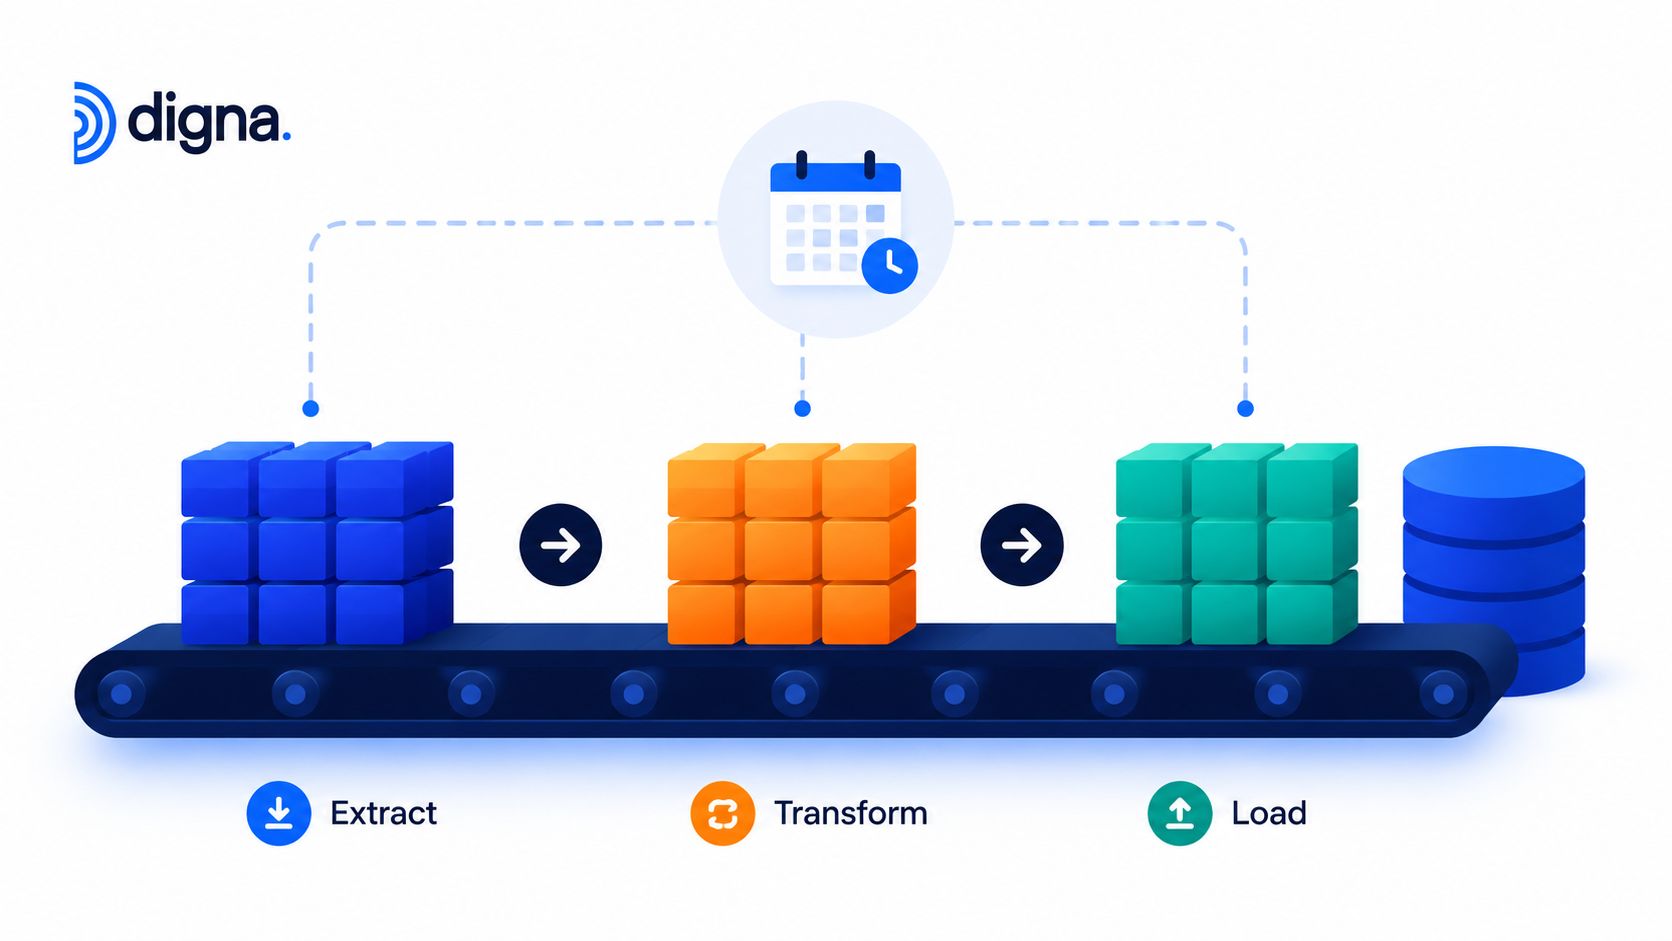
Los pipelines por lotes (batch) siguen siendo la columna vertebral de la analítica empresarial. IBM señala que los pipelines de procesamiento por lotes continúan siendo la arquitectura dominante para la analítica tradicional y la toma de decisiones basada en datos históricos, y que procesan los datos según calendarios fijos, como intervalos horarios, diarios o semanales, al tiempo que dan servicio a informes, facturación y análisis históricos a gran escala mediante patrones ETL consolidados en data warehouses y data marts empresariales (IBM sobre arquitecturas de pipelines de datos).
Esto coincide con lo que se observa habitualmente en producción. Las cargas nocturnas del data warehouse en Snowflake, la segmentación diaria de clientes en sistemas de marketing, la conciliación semanal de inventario en retail y los informes financieros de cierre de jornada encajan bien con el procesamiento por lotes. Si la decisión de negocio se toma mañana por la mañana y no en los próximos segundos, el procesamiento por lotes suele ser el diseño más sencillo y económico.
Para los equipos que diseñan la base, una referencia clara de digna sobre arquitectura de pipelines de datos ayuda a delimitar dónde encaja el procesamiento por lotes y dónde no.
Dónde el procesamiento por lotes sigue siendo la mejor opción
El procesamiento por lotes ofrece puntos de control claros. Se sabe cuándo comienza una ejecución, cuándo termina y qué partición o conjunto de archivos ha procesado. Esa estructura facilita mucho los backfills, la conciliación y las conversaciones de auditoría en comparación con los sistemas que funcionan de forma continua.
También funciona bien cuando las reglas de negocio son complejas. Si está normalizando datos financieros de varios libros contables o calculando modelos dimensionales de nivel data warehouse, suele ser mejor procesar un segmento completo que perseguir la exactitud evento por evento.
Regla práctica: si el consumidor pide una completitud histórica fiable en lugar de una reacción inmediata, el procesamiento por lotes suele ser la mejor opción por defecto.
Qué suele salir mal
El principal modo de fallo no es que el procesamiento por lotes sea antiguo. Es que los equipos monitorizan la infraestructura en lugar de los datos. El DAG de Airflow puede completarse correctamente mientras una tabla de origen llega tarde, un archivo llega vacío o una nueva columna rompe de forma sutil un modelo downstream.
Utilice digna Timeliness para detectar lotes retrasados o ausentes antes de que un dashboard quede desactualizado. Utilice digna Data Validation para aplicar reglas de negocio a nivel de registro durante las cargas, y Schema Tracker para detectar cambios de columnas o de tipos antes de que se propaguen en forma de fallos de BI. También recomiendo segmentar los lotes por dominio lógico, de modo que una extracción de marketing defectuosa no bloquee la recuperación de nóminas o finanzas.
2. Pipelines de streaming en tiempo real
El streaming es la opción a la que recurren los equipos cuando la actualidad de los datos afecta a la acción, no solo al análisis. Hevo describe los pipelines de streaming como sistemas de ingesta continua que actualizan métricas, informes y estadísticas de resumen en segundos o incluso milisegundos, lo que los hace críticos para la detección de fraude, los dashboards en vivo, los motores de recomendación y otras cargas de trabajo sensibles al tiempo en sectores como las finanzas y las telecomunicaciones (Hevo sobre los tipos de pipeline batch frente a streaming).
Suena atractivo, pero la pregunta clave es si necesita esa velocidad lo suficiente como para asumir el coste de la complejidad. La monitorización de pagos, las alertas de IoT, la visibilidad del inventario en vivo y las recomendaciones de producto basadas en clickstream suelen justificarlo. Un informe semanal de KPI comerciales, no.
Lo que realmente le aporta el streaming
El streaming reduce el intervalo entre la creación de un evento y la toma de decisiones. Las comprobaciones de pagos al estilo de Stripe, las actualizaciones logísticas alimentadas por Kinesis o los dashboards operativos respaldados por Kafka dependen de esa propiedad.
La arquitectura también cambia el comportamiento dentro de la empresa. Los equipos de operaciones dejan de esperar el resumen del día anterior y empiezan a responder a lo que está ocurriendo en este momento.
Los problemas operativos
Los sistemas de streaming fallan de forma distinta a los de procesamiento por lotes. No se obtiene simplemente un "job fallido". Se obtienen consumidores con retraso, eventos desordenados, duplicados, registros que llegan tarde y schema drift en un topic del que dependen muchos servicios downstream.
Una configuración práctica con digna tiene este aspecto:
Detectar pronto los cambios de tasa: digna Data Anomalies puede aprender el comportamiento normal de los eventos y señalar caídas o picos inesperados sin necesidad de ajustar umbrales constantemente.
Vigilar la actualidad de los datos de forma continua: el cálculo de métricas dentro de la base de datos de digna resulta útil para hacer seguimiento de las señales de retraso y actualidad que los operadores necesitan a diario.
Protegerse frente a la evolución de los topics: digna Schema Tracker ayuda a detectar cambios en el esquema de los eventos antes de que rompan las transformaciones del stream o las capas de servicio.
Los sistemas de streaming no suelen fallar de forma estrepitosa al principio. Se degradan en silencio, y luego alguien se da cuenta de que el dashboard ya no se corresponde con la realidad.
Si su stream contiene eventos operativos sensibles, el despliegue en nube privada es importante. Los equipos de finanzas, sanidad y telecomunicaciones suelen necesitar la observabilidad dentro de su propio entorno, no como una copia de los datos enviada a otro lugar.
3. Arquitectura lambda
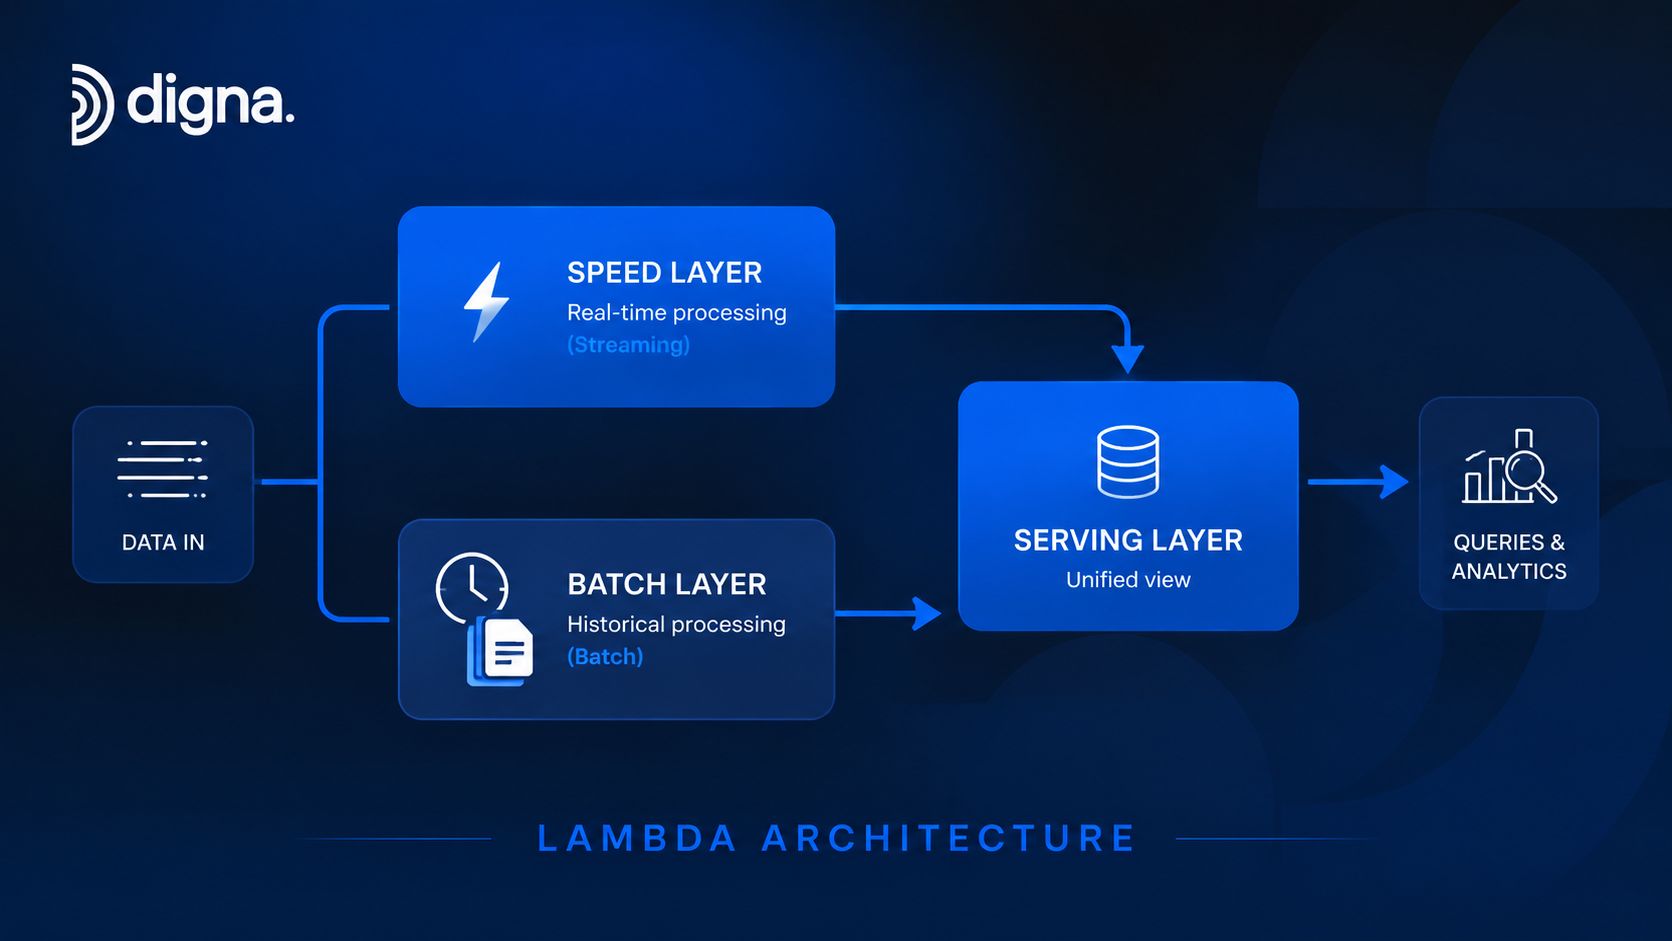
La arquitectura lambda existe porque algunas organizaciones necesitan dos cosas a la vez. Necesitan respuestas rápidas ahora y respuestas exactas después. Por eso combinan una capa de velocidad de streaming con una capa por lotes que recalcula la verdad completa, y después fusionan ambas en una capa de servicio.
Este patrón sigue apareciendo en la analítica de riesgos, los sistemas de recomendación y las grandes plataformas analíticas, donde las cifras intradía pueden ser aproximadas pero las de cierre de jornada deben corregirse. El atractivo es evidente. No es necesario elegir entre latencia y completitud.
Por qué los equipos eligen lambda
Lambda es útil cuando el negocio puede tolerar una aproximación temporal, pero no aceptará una inconsistencia permanente. Una mesa de riesgos puede necesitar estimaciones de exposición intradía de inmediato y, después, basarse en un recálculo por lotes más completo para los informes oficiales. Un equipo de e-commerce puede enviar actualizaciones de comportamiento en vivo mientras reentrena o recalcula por lotes señales de recomendación más amplias.
Esa división puede reducir la presión sobre un único motor. La ruta de streaming se ocupa de la inmediatez. La ruta por lotes se ocupa de la verdad histórica pesada.
Dónde lambda resulta costosa
El coste oculto es la lógica duplicada. Los equipos a menudo acaban implementando dos veces reglas de negocio similares y luego descubren que lo "suficientemente aproximado" en la capa de velocidad no coincide con lo "correcto" en la capa por lotes. Cuando esos resultados divergen, la confianza se erosiona rápidamente.
Utilice digna para comparar los resultados de ambas rutas, no solo para comprobar si cada una está en verde por separado. Schema Tracker debe vigilar ambas capas, porque el drift en cualquiera de ellas genera discrepancias sutiles. Data Validation también debe estar presente en ambos flujos para que las reglas clave sobre divisas, identificadores, valores de estado o semántica contable no se bifurquen con el tiempo.
Una buena configuración lambda trata la divergencia como una señal de primer nivel. digna Data Analytics es útil en este caso porque ayuda a los operadores a examinar dónde las aproximaciones de streaming difieren sistemáticamente de las correcciones por lotes posteriores.
4. Arquitectura kappa
Kappa reduce lambda a un único modelo de procesamiento. Todo es un stream. Los nuevos eventos pasan por el mismo procesador de streams y, si necesita reprocesar el histórico, se vuelve a reproducir el log con la misma lógica en lugar de mantener una capa por lotes independiente.
A los ingenieros les gusta porque la ruta del código es más sencilla. La forma habitual es Kafka con Kafka Streams o Flink. La telemetría móvil, las plataformas SaaS basadas en eventos y los sistemas de IoT suelen encajar bien cuando el log de eventos es duradero y el replay es viable.
Por qué a los ingenieros les gusta kappa
La mayor ventaja es la coherencia. Una única ruta de transformación significa menos posibilidades de que la lógica de negocio se desvíe. Si confía en su log de eventos, el replay se convierte en su estrategia de recuperación y de backfill.
Esto funciona especialmente bien en organizaciones que ya piensan en términos de eventos. La analítica de producto, los streams de interacción de usuarios y los feeds de actividad de microservicios suelen ser más fáciles de gestionar con un modelo kappa que con un diseño dividido entre procesamiento por lotes y streaming.
Qué puede romper los sistemas basados en replay
El replay parece limpio hasta que se enfrenta a la realidad operativa. Los eventos históricos pueden dejar de coincidir con el esquema actual. Los consumidores downstream pueden no ser idempotentes. El reprocesamiento puede saturar sistemas que se dimensionaron solo para el tráfico en vivo.
digna resulta más útil cuando se trata el replay como un modo de operación observable y no como una emergencia poco frecuente. Establezca baselines de puntualidad tanto para el flujo en vivo como para las ventanas de replay. Utilice Schema Tracker sobre el log de eventos antes de que un cambio de versión convierta el reprocesamiento histórico en una cascada de fallos. Aplique a los eventos reproducidos las mismas reglas de Data Validation que aplica a los eventos en vivo; de lo contrario, certificará una ruta y debilitará la otra sin darse cuenta.
Reprocesar no es simplemente "volver a ejecutarlo". Es un escenario de fiabilidad independiente que necesita sus propias expectativas.
5. Pipelines de Change Data Capture
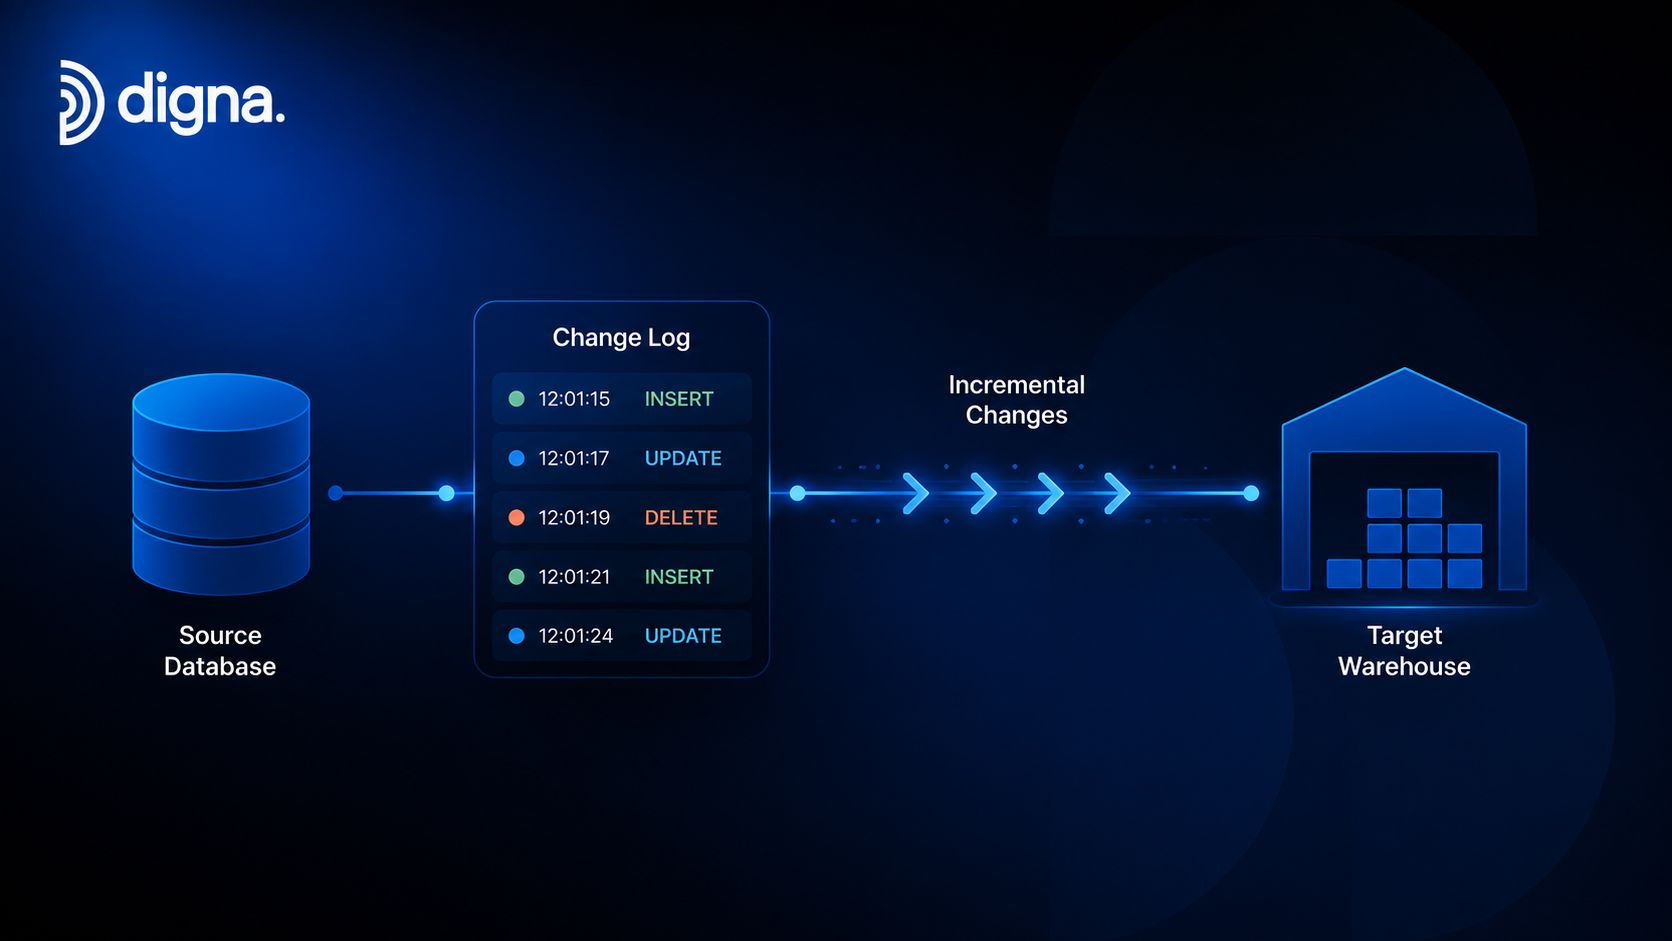
Los pipelines de CDC solo mueven lo que ha cambiado. En lugar de escanear tablas completas en cada ejecución, capturan las inserciones, actualizaciones y eliminaciones de las bases de datos operativas y propagan esos cambios downstream. Debezium, AWS DMS y los mecanismos de replicación nativos son opciones habituales.
Es uno de los tipos de pipeline de datos más prácticos, porque reduce los recálculos innecesarios y permite una sincronización de menor latencia entre sistemas. Los data marts de informes, las sincronizaciones con data warehouses en la nube y la analítica operativa suelen obtener resultados mucho mejores con CDC que con extracciones completas repetidas.
Por qué CDC está creciendo rápidamente
Research and Markets prevé que los pipelines de CDC sean el segundo segmento de más rápido crecimiento entre los tipos de pipeline de datos, con una CAGR prevista del 18 % al 20 % hasta 2030, a medida que las empresas avanzan hacia una sincronización de baja latencia para casos de uso como las actualizaciones de inventario y de libros contables sin recalcular tablas completas (Research and Markets sobre los segmentos de herramientas de pipelines).
Ese crecimiento tiene sentido. Las cargas de tablas completas son un desperdicio cuando solo ha cambiado una pequeña parte, y son arriesgadas desde el punto de vista operativo cuando los sistemas de origen son sensibles a la carga de extracción.
Lo difícil no es la captura
Lo difícil es preservar el significado. Las eliminaciones deben seguir siendo visibles downstream. El orden de las actualizaciones debe mantenerse correcto. Las mutaciones de claves primarias y los cambios de esquema pueden generar duplicados o registros huérfanos si el pipeline los trata como simples eventos de anexado.
Un modelo operativo de CDC sólido incluye:
Validar las eliminaciones de forma explícita: digna Data Validation puede confirmar que los sistemas downstream representan las eliminaciones tal como esperan sus consumidores.
Medir el retraso de replicación: digna Timeliness ayuda a los operadores a ver cuándo los cambios del origen llegan demasiado lentamente para dar soporte al proceso de negocio.
Hacer seguimiento de la evolución del origen: digna Schema Tracker es importante para CDC porque los cambios en la base de datos de origen suelen producirse fuera del control del equipo de analítica.
También conviene señalar con digna Data Anomalies las ráfagas de eliminaciones sospechosas o los patrones de actualización anómalos. En producción, esos patrones suelen revelar errores de la aplicación antes de que los desarrolladores los detecten.
6. Pipelines de virtualización de datos
No todos los pipelines tienen que mover los datos físicamente. La virtualización de datos crea una capa lógica que presenta una vista unificada de varios sistemas mientras deja los datos en su lugar. Denodo, las consultas federadas de data warehouses, las tablas externas de Snowflake y la federación de BigQuery son ejemplos conocidos.
Este patrón es útil cuando copiar datos es lento, políticamente complicado o está restringido por la gobernanza. Las organizaciones sanitarias pueden necesitar una vista unificada del paciente entre distintos sistemas hospitalarios. Las entidades financieras pueden necesitar una vista del cliente entre plataformas sin obligar primero a que todas las fuentes heredadas se integren en un único data warehouse.
Cuándo la virtualización es la decisión correcta
La virtualización funciona bien cuando el acceso importa más que una transformación intensiva. Proporciona rápidamente a los equipos una interfaz semántica común y puede favorecer la autonomía de los dominios cuando la consolidación central llevaría demasiado tiempo o provocaría disputas sobre la propiedad de los datos.
También reduce el movimiento de datos. Esto resulta atractivo cuando los sistemas son grandes, están regulados o cambian con frecuencia.
Dónde fallan las capas virtuales en la práctica
El mayor error es dar por hecho que la capa virtual elimina los problemas de los sistemas de origen. No lo hace. Los expone más rápido. Si una fuente llega tarde, es lenta o es estructuralmente incoherente, el resultado federado hereda esa debilidad.
Por ese motivo, la monitorización de la calidad tiene que empezar en el extremo de las fuentes, no solo en la capa semántica. digna en una configuración de nube privada es útil en este caso, porque los equipos pueden monitorizar la calidad y los cambios de esquema en las fuentes federadas sin mover registros sensibles. La monitorización de la puntualidad también ayuda a identificar qué fuente está degradando el rendimiento de las consultas o la actualidad de los datos antes de que el resultado virtualizado se vuelva inutilizable.
Una capa virtual puede unificar el acceso. No puede unificar la fiabilidad a menos que observe cada fuente por separado.
7. Event streaming con event sourcing
El event sourcing cambia la idea de registro del sistema. En lugar de almacenar solo el estado actual, el sistema almacena cada cambio de estado como un evento inmutable. A partir de ese histórico, los suscriptores construyen proyecciones, vistas materializadas y modelos de lectura downstream.
Esto hace que esta arquitectura resulte atractiva para la gestión de pedidos, las pistas de auditoría bancarias, el seguimiento del ciclo de vida de los trayectos y los sistemas CQRS, donde el histórico temporal importa tanto como el estado actual. Si alguien pregunta "¿qué sabíamos en ese momento?", el event sourcing puede responder con claridad.
Lo que se gana con los eventos inmutables
La auditabilidad es la ventaja principal, pero la ganancia práctica es la posibilidad de reconstrucción. Los equipos pueden reconstruir proyecciones, examinar transiciones y entender exactamente qué eventos produjeron un estado final.
Esto es importante en entornos regulados y en sistemas transaccionales complejos. Cuando un pedido pasa de realizado a empaquetado, a enviado y a reembolsado, cada transición tiene un significado operativo.
Por qué aquí la observabilidad importa más
Un sistema basado en event sourcing no perdona los eventos mal formados. Si un evento erróneo entra en el log, las proyecciones downstream pueden interpretarlo de forma distinta o fallar en lugares diferentes. El versionado también es difícil, porque los consumidores antiguos y nuevos pueden coexistir durante mucho tiempo.
Utilice digna Data Validation para aplicar la estructura de los eventos y los campos obligatorios antes de que el daño se propague por las cadenas de suscriptores. Utilice Timeliness para detectar suscriptores con retraso, y Schema Tracker para monitorizar las transiciones de versión de los eventos, de modo que los productores no rompan proyecciones más antiguas sin previo aviso. Data Anomalies también es útil para detectar secuencias de eventos sospechosas que pueden indicar fraude, abuso o errores de la aplicación.
En estos sistemas, la "calidad del pipeline" y la "corrección de la aplicación" se solapan. Por eso no basta con una monitorización genérica de la infraestructura.
8. Data mesh con pipelines descentralizados
Más que un único patrón de pipeline, el data mesh es un modelo operativo para muchos pipelines. Los equipos de dominio son propietarios de sus productos de datos y de los pipelines que hay detrás, mientras que una capa de gobernanza establece estándares compartidos de descubrimiento, calidad, contratos y acceso.
Este enfoque resulta atractivo para las grandes organizaciones en las que un único equipo central de plataforma de datos se ha convertido en un cuello de botella. Los equipos de producto, finanzas, riesgos, marketing y operaciones pueden avanzar más rápido cuando son propietarios de sus propios resultados de datos.
Qué resuelve la descentralización
Resuelve la pérdida de contexto local. El equipo de dominio suele entender el significado de las cancelaciones, los usuarios activos, las renovaciones de pólizas o los pagos fallidos mejor que un equipo central lejano. Eso mejora las decisiones de modelado y el tiempo de respuesta cuando algo cambia.
También escala la entrega. No existe un único backlog central para cada extracción, actualización de esquema y solicitud de los consumidores.
Un análisis más detallado de la arquitectura data mesh y su impacto actual resulta útil si su organización está abandonando la propiedad centralizada.
Qué convierte el data mesh en un caos
Sin una observabilidad compartida, el data mesh se convierte en un conjunto de fallos aislados. Un equipo define la actualidad de los datos de una manera, otro ignora los contratos de esquema y los consumidores se encuentran con cinco estándares de calidad distintos según el dominio que consulten.
digna funciona bien en este caso como capa unificadora. Cada dominio puede mantener la autonomía sobre sus pipelines mientras utiliza los mismos patrones de Data Validation, el mismo marco de Timeliness y la misma disciplina de Schema Tracker. El despliegue en nube privada u on-premises también es importante, porque los equipos descentralizados suelen trabajar en áreas de negocio sensibles que no pueden enviar datos de producción fuera de entornos controlados.
No se trata de volver a centralizar la propiedad. Se trata de estandarizar la fiabilidad sin diluir el conocimiento experto de cada dominio.
9. Pipelines de features de machine learning
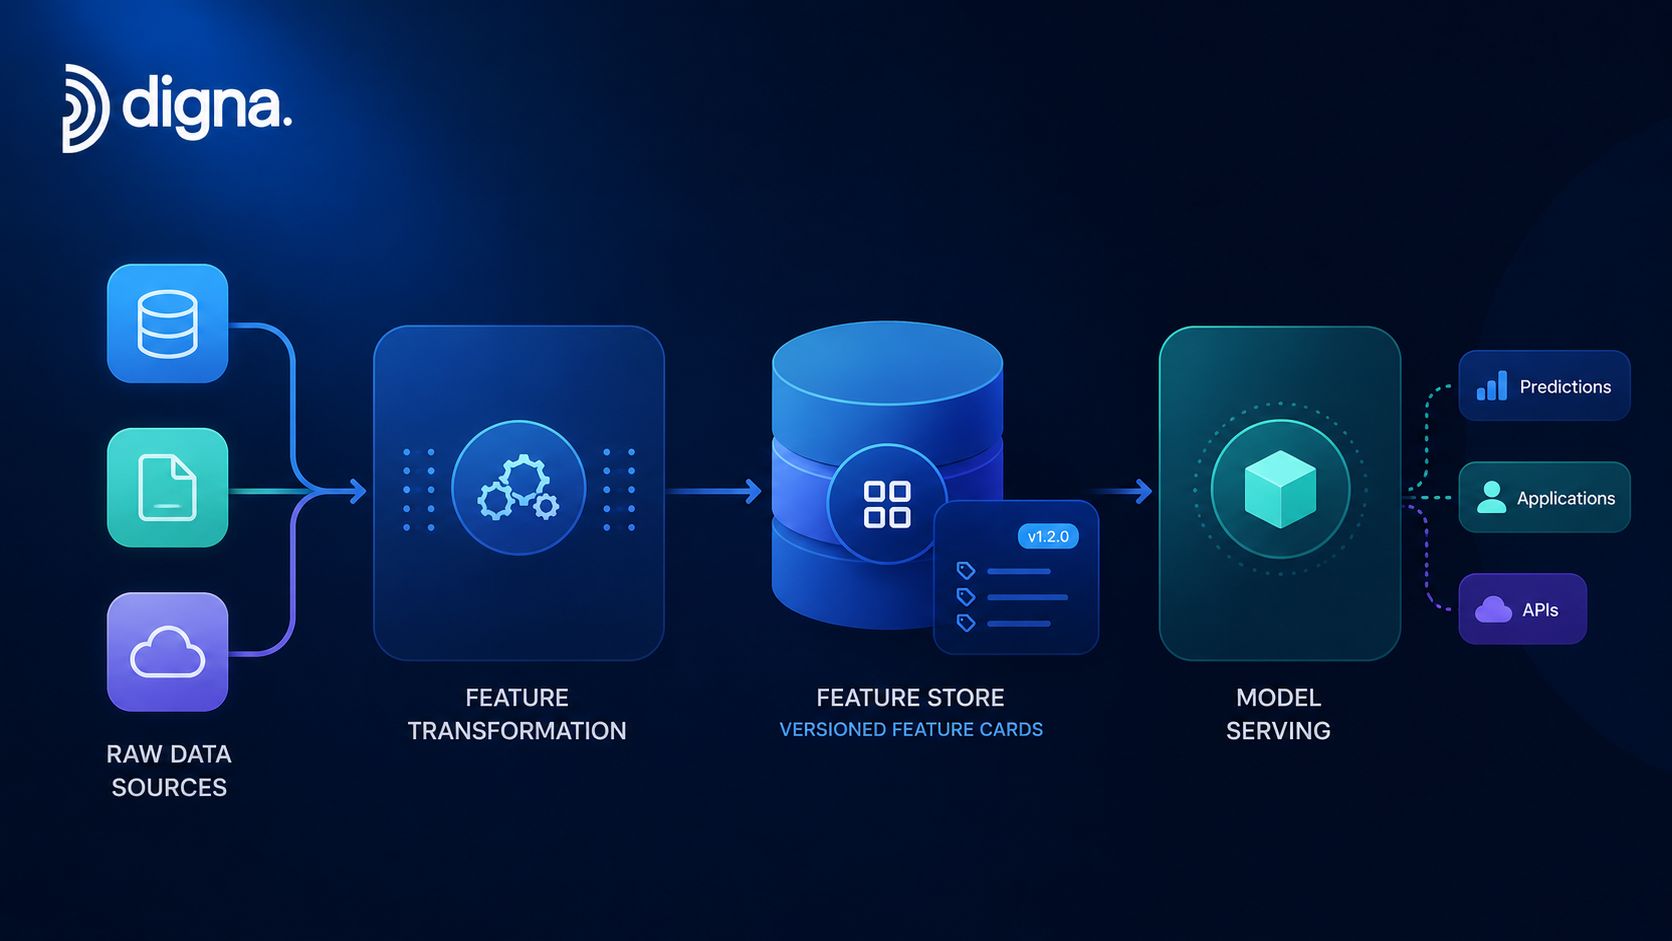
Los pipelines de features se sitúan entre la ingeniería de datos y las operaciones de ML. Calculan, versionan, almacenan y sirven las variables de entrada diseñadas que los modelos utilizan para el entrenamiento y la inferencia. Feast, Databricks Feature Store y Tecton son ejemplos habituales.
Vistos de lejos, se parecen a otros tipos de pipeline de datos, pero el estándar operativo es más exigente. Un dashboard puede tolerar una métrica desactualizada durante un tiempo. Un modelo en producción puede degradarse sin que nadie lo note si cambian la actualidad de las features, el tratamiento de los valores nulos o la distribución de los valores y nadie lo detecta.
Por qué los pipelines de features son diferentes
Tienen dos consumidores con necesidades distintas. Los sistemas de entrenamiento necesitan reproducibilidad y coherencia histórica. La inferencia online necesita valores actuales y una baja latencia de servicio.
La arquitectura también cambia en función del enfoque de transformación. GII Research señala que ELT ha superado ampliamente al ETL tradicional en los entornos cloud-native, porque la capacidad de cómputo escalable de los data warehouses permite transformar los datos de forma eficiente después de cargarlos, mientras que ETL sigue predominando cuando se requiere una limpieza estricta y la aplicación del esquema antes de la carga; además, el despliegue en la nube es el modo dominante, y los enfoques híbridos que utilizan procesos serverless como AWS Glue y Azure Data Factory se están convirtiendo en el estándar para las organizaciones que buscan equilibrar escala e integración de sistemas heredados (GII Research sobre despliegue y ETL frente a ELT).
El modo de fallo que los equipos detectan demasiado tarde
El error habitual es monitorizar el modelo e ignorar el pipeline de features. Cuando el rendimiento del modelo empieza a caer, el problema subyacente en las features puede llevar días presente.
Una configuración práctica de observabilidad incluye:
Vigilar comportamientos similares al drift en las entradas: digna Data Anomalies puede señalar cambios inesperados en las distribuciones de las features antes de que se manifiesten como malos resultados del modelo.
Monitorizar la actualidad en el servicio: digna Timeliness ayuda a detectar features desactualizadas antes de que el online store sirva valores obsoletos.
Hacer seguimiento de los cambios estructurales: digna Schema Tracker es útil cuando evolucionan las definiciones de las features, aparecen o desaparecen columnas o cambia la forma de los resultados de las transformaciones.
Los pipelines de features también necesitan restricciones de negocio estrictas. Si una feature derivada del precio pasa a ser negativa o un campo de categoría llega vacío, Data Validation debe detener el problema en el límite del pipeline. Para los equipos que construyen sistemas de personalización orientados al cliente, esto importa tanto como la propia selección del modelo. Esa misma disciplina operativa afecta también a los sistemas adyacentes que configuran la experiencia, incluidas las iniciativas para optimizar los elementos visuales de e-commerce con IA.
Comparativa de los 9 tipos de pipeline de datos
Pipeline / arquitectura | Complejidad de implementación 🔄 | Requisitos de recursos y carga operativa ⚡ | Resultados esperados (actualidad / exactitud) ⭐📊 | Casos de uso ideales 📊 | Ventajas clave y consejo rápido 💡 |
|---|---|---|---|---|---|
Pipelines de procesamiento por lotes | Baja → moderada (jobs programados, operación más sencilla) 🔄 | Eficientes para grandes volúmenes; picos de contención de recursos durante las ventanas ⚡ | Alta exactitud ⭐⭐⭐, alta latencia (horas→días) 📊 | Informes nocturnos, ETL a gran escala, analítica periódica | Fiabilidad probada; consejo: monitorice la puntualidad para detectar ventanas incumplidas 💡 |
Pipelines de streaming en tiempo real | Alta (procesadores de streams y brokers distribuidos) 🔄 | Altos costes continuos de cómputo y operación; requiere personal especializado ⚡ | Latencia muy baja, actualidad casi en tiempo real ⭐⭐📊 (la exactitud depende de las garantías) | Detección de fraude, dashboards operativos, analítica en vivo | Permite la detección instantánea; consejo: utilice la detección de anomalías para los patrones de streaming 💡 |
Arquitectura lambda | Muy alta (doble ruta de código + capa de servicio) 🔄 | Muy altos (mantener infraestructura batch + streaming) ⚡ | Aproximaciones de baja latencia + correcciones exactas por lotes ⭐⭐⭐📊 | Cargas de trabajo que necesitan tanto una vista inmediata como un recálculo histórico exacto | Combina velocidad y exactitud; consejo: valide la coherencia entre capas mediante monitorización 💡 |
Arquitectura kappa | Alta (solo streaming, capacidad de replay) 🔄 | Altos (almacenamiento en el broker para el histórico y picos de reprocesamiento) ⚡ | Lógica coherente, actualidad en tiempo real; reprocesamiento posible ⭐⭐📊 | Sistemas basados en eventos en los que el stream puede gestionar el reprocesamiento (Kafka/Flink) | Simplicidad operativa frente a lambda; consejo: garantice la retención del log de eventos y monitorice los replays 💡 |
Pipelines de Change Data Capture (CDC) | Moderada → alta (acceso a logs, mapeo) 🔄 | Baja transferencia de red; infraestructura moderada para el procesamiento y la ordenación ⚡ | Actualizaciones incrementales de baja latencia, alta fidelidad ⭐⭐⭐📊 | Sincronizaciones incrementales, data warehouses en tiempo real, data marts de informes | Minimiza el movimiento de datos; consejo: haga un seguimiento cuidadoso de los cambios de esquema y del tratamiento de las eliminaciones 💡 |
Pipelines de virtualización de datos | Moderada (capa semántica y conectores) 🔄 | Bajo almacenamiento, pero la ejecución depende del rendimiento de las fuentes; costes variables ⚡ | Actualidad en tiempo real, pero rendimiento de consulta variable ⭐⭐📊 | Analítica ad hoc, consultas federadas, demostraciones rápidas de gobernanza | Rápida de desplegar con un movimiento mínimo; consejo: monitorice los SLA de las fuentes y el rendimiento de los joins 💡 |
Event streaming con event sourcing | Alta (log inmutable, proyecciones, versionado) 🔄 | Alto almacenamiento para el histórico completo; complejidad operativa de las proyecciones ⚡ | Auditabilidad y reconstrucción completas, análisis temporal ⭐⭐⭐📊 | Pistas de auditoría, CQRS, sistemas que necesitan histórico completo y replay | Excelente para el cumplimiento normativo y la depuración; consejo: valide los esquemas de eventos y la puntualidad de su llegada 💡 |
Data mesh con pipelines descentralizados | Alta (complejidad organizativa + técnica) 🔄 | Mayor infraestructura total entre dominios; costes de herramientas federadas ⚡ | Resultados alineados con los dominios y escalables; la calidad varía según el dominio ⭐⭐📊 | Grandes organizaciones que buscan autonomía de los dominios y datos como producto | Escala mediante la autonomía; consejo: imponga una observabilidad federada y contratos comunes 💡 |
Pipelines de features de machine learning | Alta (versionado de features, corrección point-in-time) 🔄 | Almacenamiento y cómputo moderados→altos; operación del feature store ⚡ | Features coherentes entre entrenamiento y servicio, reduce el drift del modelo ⭐⭐⭐📊 | Feature stores, servicio de modelos, flujos de trabajo de ML reproducibles | Mejora la fiabilidad del ML; consejo: monitorice de forma continua la actualidad y el drift de las features 💡 |
De la arquitectura a la operación: cómo hacer fiable su pipeline
Elegir la arquitectura adecuada es la primera decisión importante. No es la última. Los pipelines por lotes, de streaming, de CDC, basados en event sourcing y orientados a ML resuelven problemas de entrega distintos, pero cada arquitectura introduce también sus propios riesgos de calidad y fiabilidad.
Los pipelines por lotes ocultan los retrasos hasta que una ejecución programada incumple su ventana. Los sistemas de streaming siguen funcionando mientras se alejan de forma imperceptible del comportamiento esperado. Lambda crea problemas de coherencia entre rutas. Kappa convierte la corrección del replay en una preocupación de primer nivel. CDC puede replicar cambios con rapidez y, aun así, gestionar mal las eliminaciones o el orden de las actualizaciones. La virtualización puede unificar el acceso mientras enmascara las debilidades de los sistemas subyacentes. El data mesh puede aumentar la velocidad de los dominios mientras fragmenta los estándares. Los pipelines de features pueden seguir sirviendo datos mucho después de que las entradas del modelo se hayan deteriorado.
Esa realidad operativa es la razón por la que los diagramas de arquitectura no bastan. Todo pipeline en producción necesita una capa de control que indique si los datos llegan a tiempo, si los registros siguen cumpliendo las reglas de negocio, si los esquemas han cambiado y si los patrones de los datos siguen pareciendo normales. Si solo vigila los jobs, los contenedores o el gasto del data warehouse, pasará por alto los fallos que dañan la confianza.
Los equipos más sólidos integran la observabilidad y la validación en el pipeline desde el primer día. No esperan al primer fallo de un dashboard ejecutivo ni al primer incidente de un modelo. Definen el comportamiento de llegada esperado. Hacen seguimiento de los cambios de esquema antes de que se rompan los sistemas downstream. Validan los registros clave en el punto de movimiento, no después de que los analistas abran tickets. Examinan las anomalías en su contexto en lugar de depender únicamente de umbrales frágiles ajustados a mano.
Ahí es donde digna encaja bien en todos los principales tipos de pipeline de datos. Su combinación de Timeliness, Data Validation, Schema Tracker, Data Anomalies y Data Analytics aborda los patrones de fallo a los que los ingenieros se enfrentan en la práctica. Como calcula las métricas dentro de la base de datos del cliente y admite el despliegue en nube privada u on-premises, los equipos pueden monitorizar entornos sensibles sin entregar datos de producción a un proveedor externo.
También hay una ventaja estratégica. Cuando las partes interesadas pueden confiar en que la actualidad, la estructura y la validez de los registros se monitorizan de forma activa, los debates sobre arquitectura mejoran. Los equipos dejan de discutir estilos de pipeline en abstracto y empiezan a elegir el diseño que se ajusta a la necesidad del negocio, con un plan claro sobre cómo operarlo de forma segura.
Los pipelines de datos fiables no consisten solo en mover datos de un punto A a un punto B. Consisten en entregar datos sobre los que las personas puedan actuar sin cuestionarlos. Ese es el estándar para el que merece la pena diseñar.
Si desea ese nivel de control en pipelines por lotes, de streaming, de CDC, de features y en productos de datos descentralizados, digna está diseñado para ello. Ofrece a los equipos de datos una única plataforma para la detección de anomalías, la validación a nivel de registro, la monitorización de la puntualidad, el seguimiento de cambios de esquema y el análisis histórico de observabilidad, todo ello manteniendo los datos dentro de entornos controlados por el cliente.
Las ejecuciones por lotes que incumplen su ventana y los feeds de CDC con un retraso de replicación creciente comparten un síntoma: datos que llegan más tarde de lo que el negocio espera, que es precisamente lo que digna Timeliness aprende y sobre lo que alerta.
Preguntas frecuentes
¿Cuáles son los principales tipos de pipeline de datos?
El artículo aborda nueve: procesamiento por lotes, streaming en tiempo real, lambda, kappa, change data capture, virtualización de datos, event streaming con event sourcing, data mesh con pipelines descentralizados y pipelines de features de machine learning. Cada uno resuelve un problema de entrega distinto y cada uno conlleva sus propios riesgos de calidad y fiabilidad que deben monitorizarse desde el primer día.
¿Cuándo debo usar el procesamiento por lotes en lugar del streaming?
Elija el procesamiento por lotes cuando la decisión de negocio se tome mañana por la mañana y no en los próximos segundos. Las cargas nocturnas del data warehouse en Snowflake, la conciliación semanal de inventario en retail y los informes financieros de cierre de jornada encajan bien con el procesamiento por lotes, mientras que la detección de fraude, las alertas de IoT y los dashboards en vivo suelen justificar el coste y la complejidad adicionales del streaming.
¿Cuál es la diferencia entre la arquitectura lambda y la kappa?
Lambda utiliza dos rutas, una capa de velocidad de streaming para obtener respuestas aproximadas rápidas y una capa por lotes que recalcula la verdad completa, que se fusionan en una capa de servicio. Kappa trata todo como un stream y reprocesa el histórico volviendo a reproducir el log de eventos con la misma lógica, normalmente con Kafka y Kafka Streams o Flink.
¿Qué suele salir mal en los pipelines de change data capture?
La captura rara vez es el problema; lo es preservar el significado. Las eliminaciones deben seguir siendo visibles downstream, el orden de las actualizaciones debe mantenerse correcto, y las mutaciones de claves primarias o los cambios de esquema pueden generar duplicados o registros huérfanos cuando se tratan como simples anexados. Research and Markets prevé que los pipelines de CDC crezcan a una CAGR del 18 % al 20 % hasta 2030.
¿Cómo se monitorizan los pipelines de features de machine learning?
Monitorice el propio pipeline de features, no solo el modelo, porque los problemas en las features pueden pasar desapercibidos durante días antes de que caiga el rendimiento. El artículo recomienda vigilar el drift en las distribuciones de las features, comprobar la actualidad en el servicio para que el online store nunca sirva valores obsoletos, hacer seguimiento de los cambios de esquema y validar restricciones estrictas, como que las features de precio no sean negativas.



