Problemas de calidad de datos: su guía de detección y remediación
|
5
minuto de lectura

La mala calidad de los datos cuesta a las empresas una media de 12,9 millones de dólares al año, según Gartner (Resumen de Gartner por Revefi). Ese número cambia el sentido de la conversación. Los problemas de calidad de los datos no son solo un molesto trabajo de limpieza para los analistas o una tarea pendiente para la ingeniería de datos. Son un riesgo empresarial directo.
A menudo, el problema se nota primero de formas pequeñas. Un cuadro de mando deja de actualizarse antes de una reunión semanal. Un informe financiero no coincide con el sistema de origen. Un modelo que funcionaba el mes pasado empieza a hacer predicciones extrañas. Alguien abre un ticket, otra persona ejecuta SQL ad hoc, y el equipo pasa el día tratando de demostrar si los datos son erróneos o si la definición de la métrica ha cambiado. En entornos regulados, ese mismo patrón añade otro problema: muchas herramientas de Observability esperan que muevas datos sensibles a la nube de un proveedor para inspeccionarlos.
Esa compensación es a menudo inaceptable. Si perteneces al sector financiero, sanitario, de telecomunicaciones o al sector público, la pregunta práctica no es solo cómo detectar problemas de calidad de datos. Es cómo detectarlos sin enviar datos de producción a un tercero. Es ahí donde un enfoque de Observability en base de datos es importante. Mantienes los datos residentes, calculas las métricas donde ya residen los datos y sigues obteniendo detección de anomalías, seguimiento de esquemas, supervisión de Data Timeliness y validación a nivel de registro.
Índice de contenidos
Por qué la calidad de los datos es un riesgo empresarial silencioso
Las ocho categorías comunes de problemas de calidad de datos
El verdadero coste de la inacción: impactos comerciales y de ML
Un flujo de trabajo moderno para la remediación y el monitoreo con digna
Por qué la calidad de los datos es un riesgo empresarial silencioso
La parte costosa de los datos incorrectos no suele ser el primer error. Es la demora antes de que alguien confíe en que existe un error. Los equipos pierden tiempo debatiendo sobre el cuadro de mando, volviendo a ejecutar procesos, comparando sistemas y verificando si un campo cambió upstream. Mientras tanto, los usuarios de negocio todavía necesitan actuar.
Los datos incorrectos permanecen silenciosos porque a menudo no provocan una caída estrepitosa. Un pipeline de datos puede completarse mientras produce un resultado sutilmente erróneo. Una tabla puede cargarse a tiempo mientras que los valores clave se desvían de los patrones normales. Un registro de cliente puede seguir siendo estructuralmente válido mientras disminuye su utilidad cada mes.
Dónde lo sienten realmente los equipos
En las operaciones diarias, los problemas de calidad de datos se presentan como:
Cuadros de mando rotos: Los ejecutivos ven gráficos vacíos o números que no cuadran.
Informes desactualizados: Los equipos de negocio trabajan a partir de la realidad de ayer cuando necesitan la de hoy.
Bucles de verificación manual: Los analistas dedican tiempo a revisar los datos antes de poder responder a la pregunta.
Pérdida de confianza: Una vez que la gente duda del conjunto de datos, crean hojas de cálculo paralelas y lógicas de soporte.
Regla práctica: Si los usuarios preguntan si el cuadro de mando es seguro de usar antes de preguntar qué significa, tienes un problema de calidad de datos.
Por qué se trata de un problema empresarial, no solo de ingeniería
Un equipo de plataforma de datos puede parchear incidentes individuales por un tiempo. Pero eso no es escalable. El problema de fondo es que las organizaciones modernas dependen de los datos para la planificación, la automatización, el Compliance y la IA. Una vez que cae la confianza, cae también la velocidad de decisión.
Por eso trato los problemas de calidad de datos como un problema de confiabilidad operativa. Afectan a las operaciones de ingresos, los informes financieros, la atención al cliente y el rendimiento de los modelos al mismo tiempo. El síntoma técnico puede ser una carga tardía o un cambio de esquema. El síntoma empresarial es la toma de decisiones más lenta y un mayor riesgo.
Las ocho categorías comunes de problemas de calidad de datos
La mayoría de los incidentes se encuadran en un pequeño conjunto de patrones repetibles. Nombrarlos claramente es importante porque la solución para un registro duplicado no es la misma que para un pipeline retrasado, y la solución para la desviación del esquema no sirve para corregir una entrada de cliente incompleta.
Una taxonomía práctica
Este es el vocabulario que utilizo con los nuevos miembros del equipo.
Categoría del problema | Impacto empresarial | Ejemplo de solución digna |
|---|---|---|
Integridad | Los campos faltantes rompen la segmentación, los informes o los flujos de trabajo de downstream | Validación de datos |
Precisión | Los equipos actúan sobre valores que no coinciden con la realidad | Validación de datos |
Puntualidad | Los usuarios toman decisiones basadas en datos desactualizados | Data Timeliness |
Consistencia | Las representaciones en conflicto crean problemas de conciliación | Validación de datos |
Desviación del esquema | Los cambios estructurales rompen consultas, modelos y cuadros de mando | Seguimiento de esquemas |
Duplicados | Los recuentos se inflan y las vistas de clientes se fragmentan | Validación de datos |
Valores atípicos | Picos o caídas inusuales ocultan defectos o eventos reales | Anomalías de datos |
Fallos del pipeline | Las cargas se realizan parcialmente o fallan de forma silenciosa e indirecta | Anomalías de datos y Data Timeliness |
Cómo se ve cada categoría en la práctica
Integridad
Un registro está incompleto cuando falta un campo requerido o es nulo de manera que hace que la fila sea menos útil. Piensa en una tabla de clientes con ID válidos pero sin el estado de consentimiento o la región.
Precisión
Los datos son inexactos cuando no reflejan el estado real que intentas modelar. Un pedido enviado marcado como pendiente es estructuralmente exacto y, sin embargo, incorrecto para las operaciones.
Puntualidad
La puntualidad tiene que ver con si los datos llegaron cuando el negocio los esperaba. Un cuadro de mando de ventas generado a partir de una salida antigua del pipeline de datos puede ser internamente coherente y, aun así, inseguro para su uso.
Consistencia
Los problemas de consistencia aparecen cuando dos sistemas representan la misma entidad de negocio de manera diferente. Finanzas y CRM pueden tener ambos al mismo cliente, pero no con la misma lógica de estado o formato.
Muchos incidentes dolorosos ocurren porque un conjunto de datos es válido de forma aislada pero engañoso en su contexto.
Desviación del esquema
La desviación del esquema es el cambio estructural silencioso que pilla a los equipos desprevenidos. Una columna cambia de nombre, se elimina o cambia de tipo. El productor de upstream puede pensar que se trata de una actualización inofensiva. La transformación en downstream no estará de acuerdo.
Duplicados
Los duplicados crean ruido operativo oculto. Los correos electrónicos de marketing se envían dos veces. La atención al cliente detecta múltiples registros para la misma persona. Los recuentos de KPIs se desvían de forma ascendente por razones que nadie pretendía.
Valores atípicos
Los valores atípicos no siempre son errores. A veces son la señal más temprana de que un origen cambió, un feed duplicó filas o ocurrió un evento empresarial que ninguna regla de umbral anticipó.
Fallos del pipeline
Los fallos del pipeline de datos no se limitan a colapsos graves. La versión más peligrosa es el éxito parcial. Un proceso se ejecuta, algunas tablas se actualizan, otras no, y el cuadro de mando aún se renderiza.
Por qué importa la categorización
Una vez que clasificas el problema, puedes elegir el control correcto:
Reglas a nivel de registro para valores no válidos y campos faltantes
Monitoreo de esquemas para cambios estructurales
Monitoreo de frescura para entregas retrasadas o faltantes
Detección estadística de anomalías para desviaciones silenciosas y comportamientos inusuales
Sin esa separación, los equipos terminan acumulando más controles SQL en cada tabla. Eso crea ruido operativo y sigue obviando los problemas que realmente importan.
Descifrando las causas originales de los datos incorrectos
La mayoría de los problemas recurrentes de calidad de datos provienen del diseño del sistema y de los hábitos operativos, no de una única fila incorrecta. Necesitas mirar upstream, a través de los procesos y a lo largo del tiempo.
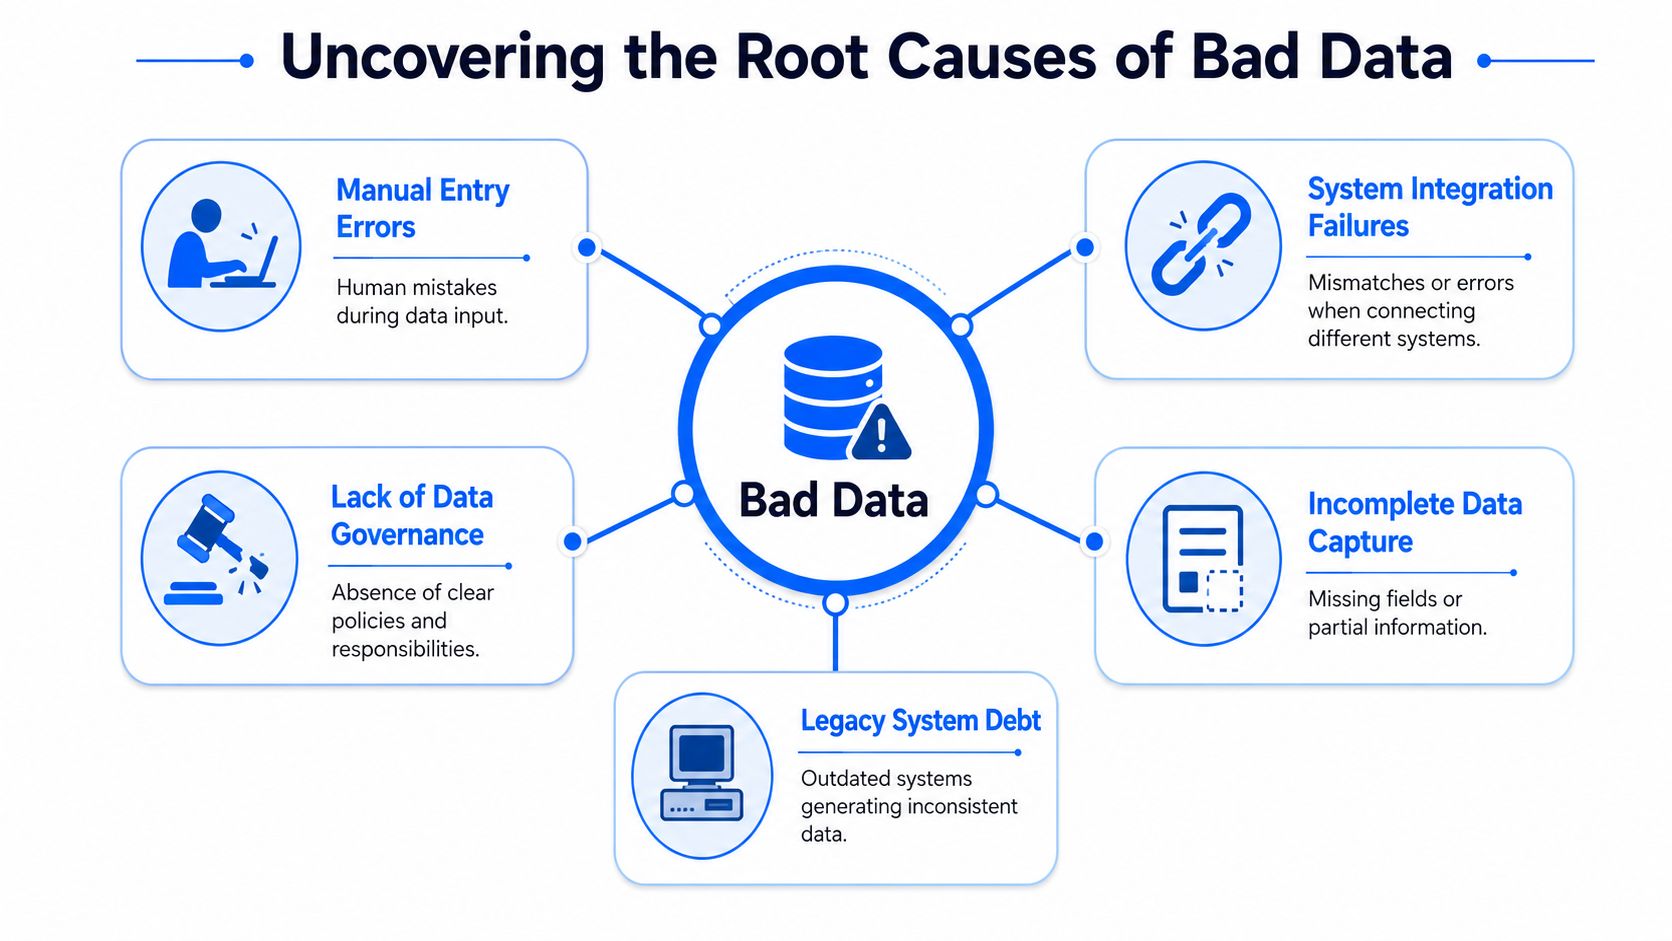
Las causas suelen esconderse a plena vista
La entrada manual sigue siendo una de las mayores fuentes de defectos. Los equipos copian valores de correos electrónicos, PDFs y formularios bajo la presión del tiempo, por lo que esos pequeños errores se propagan por el CRM, la facturación y la analítica. Si tu flujo de trabajo todavía depende de personas que vuelven a escribir datos comerciales, vale la pena buscar formas de evitar errores de entrada de datos en las propuestas antes de que lleguen al almacén.
Los fallos de integración de sistemas se muestran cuando dos aplicaciones no coinciden en el significado, formato o sincronización de un campo. Ves un síntoma en un cuadro de mando, pero el defecto real comenzó cuando el origen A envió un valor que el origen B interpretó de manera diferente.
Las brechas de gobernanza empeoran todo esto. Si nadie es propietario de un dominio de datos, la gestión de incidentes se convierte en un juego de adivinanzas. Los ingenieros pueden restaurar un pipeline, pero no pueden decidir si cambió una regla de negocio a menos que alguien sea responsable de los datos.
Los datos empeoran incluso cuando nadie rompe nada
Los datos no son estáticos. El deterioro de los datos se produce a una tasa global de aproximadamente el 3% mensual, lo que significa que los registros se desfasan de forma natural a menos que los equipos los mantengan (lakeFS sobre problemas de calidad de datos). Los datos de contacto cambian. Los catálogos de productos evolucionan. El estado de la cuenta, las condiciones de precio y las relaciones con los clientes no se quedan quietos.
Ese deterioro es importante porque muchos equipos solo monitorizan el éxito del pipeline. No supervisan si el conjunto de datos sigue reflejando la realidad actual.
Una carga exitosa aún puede entregar información desactualizada
Un esquema válido aún puede contener valores desfasados
Una fila completa aún puede ser incorrecta para la decisión de hoy
El flujo de trabajo para la causa original que realmente ayuda
Cuando aparece un incidente, lo rastreo en este orden:
Comenzar por el síntoma. ¿Qué informe, tabla o modelo se volvió poco confiable?
Revisar la puntualidad de entrega. ¿La carga esperada se retrasó, fue parcial o faltó?
Inspeccionar la estructura. ¿Cambió una columna, un tipo o una interfaz de upstream?
Revisar el comportamiento de los valores. ¿Se desplazaron las distribuciones a pesar de que el esquema se mantuvo estable?
Confirmar propiedad. ¿Quién puede decir si se trata de un defecto o de un cambio real de negocio?
Para los equipos que están formalizando ese proceso, una guía estructurada para analizar las causas originales de los problemas de datos mediante IA puede agilizar significativamente el paso de la alerta al diagnóstico.
El trabajo de causa original se vuelve más fácil cuando tu monitoreo refleja cómo ocurren realmente los fallos: tiempo, estructura, valores y luego la propiedad.
El verdadero coste de la inacción: impactos comerciales y de ML
El daño operativo derivado de una mala calidad de los datos no se limita al retrabajo. Cambia la forma en que se comportan los equipos. Dejan de confiar en la automatización, duplican las comprobaciones manualmente y retrasan las decisiones hasta que alguien valida los números.
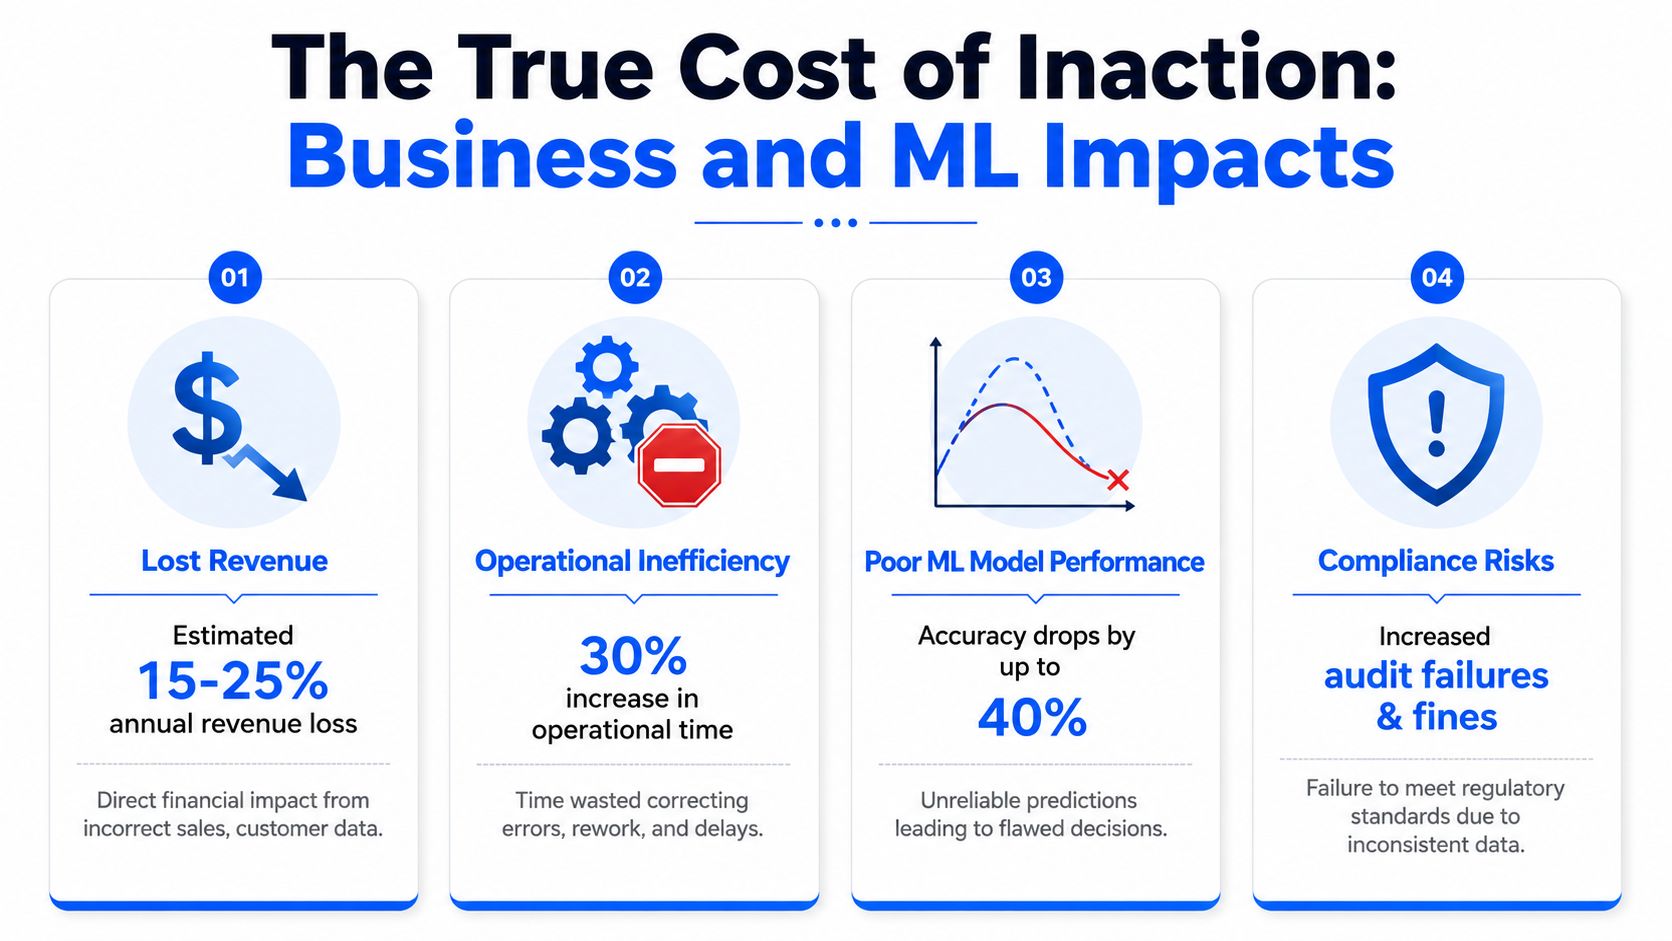
Los sistemas empresariales pagan primero
Cuando cae la confianza en los datos, la primera víctima es la velocidad. Los equipos de ingresos cuestionan los informes del pipeline. Finanzas concilia más cosas a mano. Los equipos de Compliance solicitan pruebas que nadie puede producir de forma limpia porque el linaje es confuso o la fuente cambió sin que nadie se diera cuenta.
En los flujos de trabajo de previsión, esto es especialmente visible. Si intentas conectar la confiabilidad de las fuentes con la planificación comercial, esta guía sobre cómo diagnosticar y mejorar la previsión de ventas es útil porque muestra cómo los defectos de los datos distorsionan la planificación antes de que los líderes se den cuenta de que el modelo no es el único problema.
Los sistemas de ML fallan de manera diferente
Los flujos de trabajo de machine learning son menos indulgentes de lo que muchos equipos esperan. Un cuadro de mando puede parecer extraño y activar una revisión humana. Sin embargo, un modelo puede continuar sirviendo predicciones mientras la calidad de la entrada se deteriora.
La validación tradicional basada en reglas a menudo pasa por alto hasta el 90% de las anomalías relevantes para ML porque se basa en umbrales estáticos en lugar de un aprendizaje de referencia dinámico, y el coste de un solo evento de desviación no detectado puede superar el millón de dólares en pérdida de ingresos debido a malas decisiones automatizadas (Atlan sobre problemas de calidad de datos).
Eso tiene dos implicaciones prácticas:
Los controles estáticos no son suficientes para las entradas del modelo. Los controles de nulos y de rango detectan defectos obvios, pero no desviaciones sutiles en la distribución.
La desviación silenciosa es costosa. Para cuando los usuarios notan los resultados degradados, el modelo ya ha influido en las decisiones.
Si un pipeline de características es lo suficientemente importante como para alimentar un modelo, es lo suficientemente importante como para monitorear su desviación, no solo su validez.
El coste oculto es el enfoque de ingeniería
El trabajo reactivo con datos consume una atención que debería dedicarse a mejoras de la plataforma. En lugar de crear productos de datos reutilizables, los equipos persiguen incidentes, responden a preguntas sobre la confianza y repiten procesos de ejecución. Eso es un impuesto a la capacidad de ingeniería y a la confianza de las partes interesadas.
Cómo detectar y medir la calidad de los datos
Existen dos enfoques generales para la detección. El enfoque antiguo pide a los ingenieros definir reglas de antemano para todo lo que puedan imaginar. El enfoque más nuevo combina reglas explícitas con un Observability continuo que aprende el comportamiento normal y alerta sobre las desviaciones.
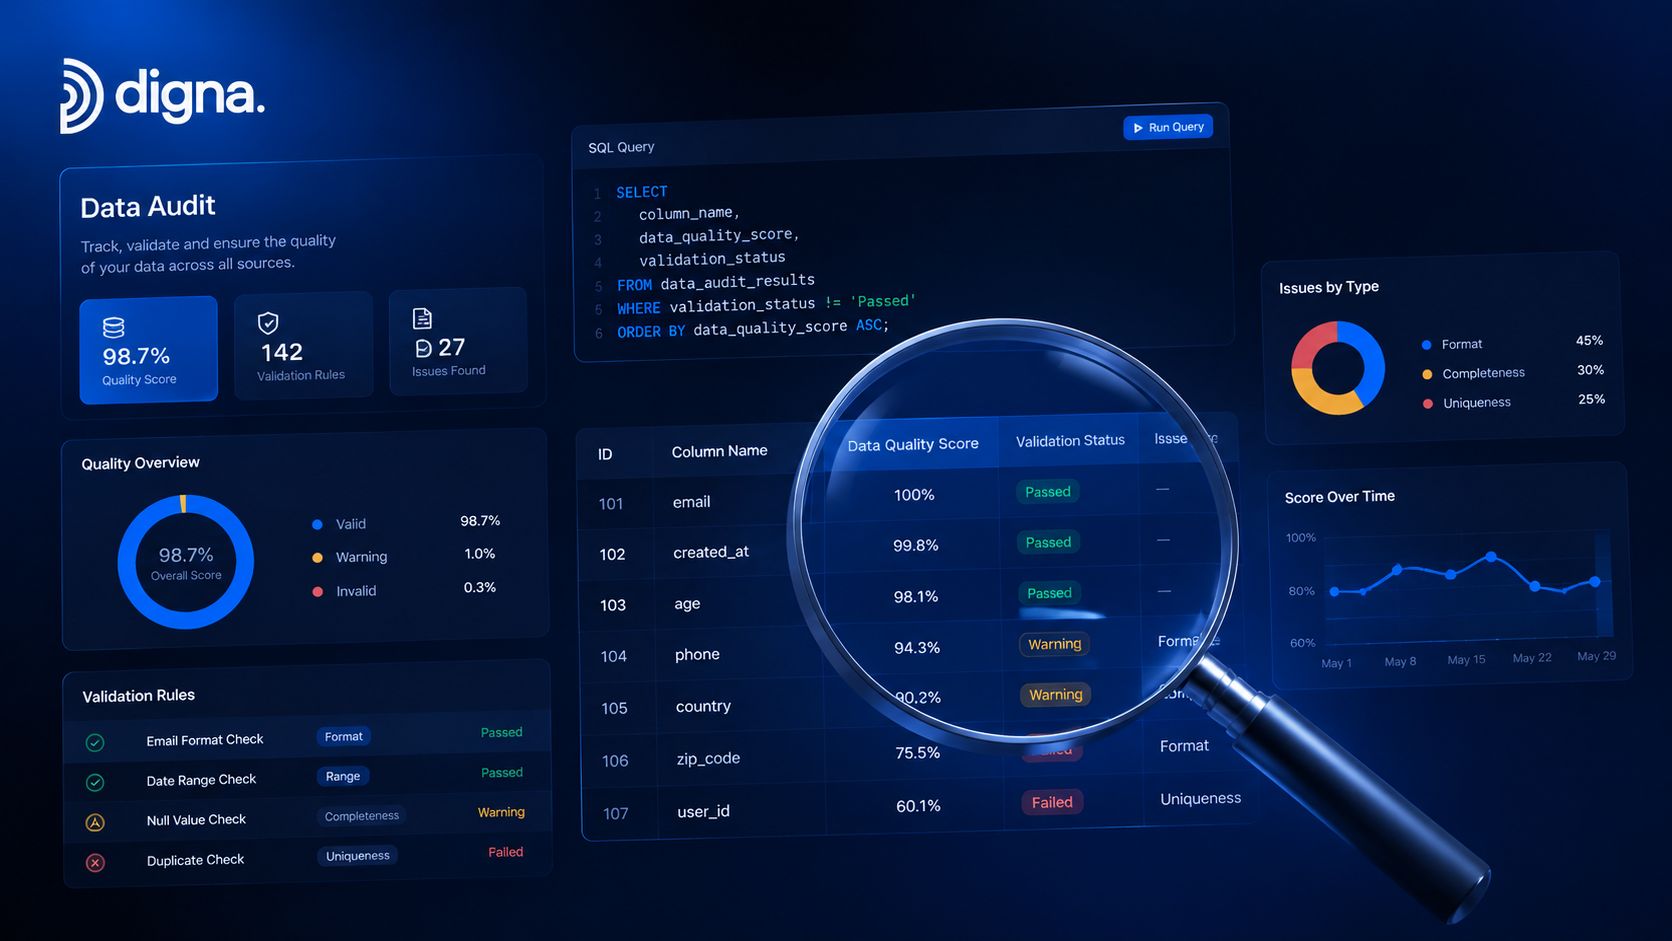
Qué hacen bien los controles tradicionales
Las comprobaciones SQL manuales y las pruebas basadas en reglas conservan su utilidad. Son idóneas para requisitos estrictos:
Campos requeridos
Listas de valores aceptados
Integridad referencial
Lógica de negocio, como límites de estado o de importe
Estos controles son auditables y predecibles. Para los conjuntos de datos sensibles al Compliance, son indispensables.
Dónde fallan los controles tradicionales
El problema es la cobertura. Los estudios indican que el 85% de los pipelines de datos sufren modificaciones estructurales inesperadas, como columnas añadidas o eliminadas, que eluden los sistemas de monitoreo tradicionales basados en reglas (Atlan sobre software de calidad de datos). Si tus comprobaciones solo comprueban supuestos conocidos, no detectarán nuevos modos de fallo.
Una regla estática también tiene dificultades con comportamientos cambiantes en el tiempo. Una tabla suele mantener el mismo esquema mientras una métrica clave se desvía lentamente. Esto llega a degradar la calidad de los informes o de los modelos sin llegar a violar un solo umbral codificado de forma estricta.
Qué aporta la Observability moderna
Las herramientas modernas de Observability miden patrones, no solo el cumplimiento de reglas. Monitorean líneas de referencia históricas, comportamientos estacionales, cambios de esquema y plazos de entrega previstos. El cambio clave es este: en lugar de pedir a los ingenieros que adivinen cada problema futuro, la plataforma observa comportamientos anormales en relación con el pasado.
Una pila de medición práctica suele incluir:
Método de detección | Ideal para | Limitación |
|---|---|---|
Pruebas SQL | Reglas de negocio estrictas | Pasa por alto desviaciones sutiles |
Monitoreo de esquemas | Cambios en columnas y tipos | No explica anomalías en valores |
Monitoreo de puntualidad | Cargas tardías o ausentes | No valida la corrección de registros |
Detección de anomalías | Cambios silenciosos y patrones inusuales | Requiere un buen aprendizaje de referencia |
Qué medir primero
Si vas a poner en marcha un programa de línea de referencia, empieza por un conjunto reducido de métricas visibles y dales operatividad. Una referencia muy útil es esta descripción general de las métricas de calidad de datos, en particular si necesitas alinear a ingenieros y partes interesadas sobre qué medir y por qué.
Mi orden básico es sencillo:
Puntualidad de tablas críticas
Cambios de esquema en conjuntos de datos compartidos
Reglas a nivel de registro para campos regulados o de alto impacto
Anomalías de comportamiento en métricas de negocio centrales
La configuración de detección más sólida combina controles deterministas con referencias aprendidas de forma automática. Unos detectan lo que nunca debe ocurrir; lo otro capta aquello que nadie pensó en codificar.
Un flujo de trabajo moderno para la remediación y el monitoreo con digna
Un flujo de remediación viable necesita realizar cuatro acciones en secuencia: detectar el problema, localizarlo, validar su impacto y notificar al propietario pertinente sin mover datos confidenciales fuera del entorno del cliente.
Comienza con la detección dentro de la base de datos
En los entornos regulados, la decisión arquitectónica importa tanto como el conjunto de funciones. Muchos equipos no pueden enviar datos de producción a la nube de un tercero para su análisis, sobre todo si esas tablas contienen registros operativos, identificadores de clientes o eventos de negocio confidenciales.
Un flujo de trabajo integrado en la base de datos mantiene la residencia de los datos y calcula las métricas allí donde ya reside el almacén o el lago de datos. digna es un ejemplo de este enfoque. Realiza la detección de anomalías, el control de puntualidad, el seguimiento de esquemas, los análisis históricos y la validación a nivel de registro dentro de entornos controlados por el cliente, como nubes privadas o despliegues locales.
Eso cambia la balanza. No es necesario elegir entre la Observability y la residencia de los datos.
Un flujo de incidentes práctico
He aquí una muestra de la secuencia que funciona bien en producción:
Aparece una anomalía. Se detecta una caída de volumen, un cambio de distribución o un pico inusual en una tabla crítica.
Se comprueba la puntualidad. ¿La carga ha sido tardía o incompleta?
Se inspecciona el esquema. ¿Modificó alguna columna añadida, eliminada o alterada el comportamiento de downstream?
Se validan los registros. ¿Están fallando las reglas de negocio a nivel de fila?
Los propietarios obtienen contexto. La alerta incluye la tabla, la métrica, el intervalo de tiempo y el área de origen más probable.
Los fallos de puntualidad son causantes del 62% de los informes desactualizados y los cuadros de mando rotos, y los retrasos en los datos aumentan en 3,2 veces el tiempo de análisis de causa original frente a la detección inmediata de anomalías (d data sobre monitoreo de puntualidad). Si el sistema detecta el retraso al ocurrir, los ingenieros investigan un único paso del pipeline. De lo contrario, tardan mucho más en reconstruir la cadena de acontecimientos.
Qué funciona mejor que apagar fuegos ad hoc
El viejo patrón de remediación nos resulta familiar: alguien avisa de que un gráfico falla, un ingeniero ejecuta SQL, un analista revisa los datos de upstream y el equipo parchea el síntoma. Eso soluciona el incidente actual, pero deja vía libre para el siguiente.
Una mejor estrategia combina:
Monitoreo de envíos previstos para interceptar datos desfasados antes de que lleguen a reuniones e informes
Alertas de cambio de esquema a fin de evitar que los fallos estructurales pasen desapercibidos tras ejecuciones exitosas
Validación a nivel de registro en campos relacionados con Compliance, facturación o comunicación con el cliente
Vistas de tendencias históricas que ayuden a distinguir si una desviación es nueva, estacional o persistente
Si el problema en downstream afecta a la calidad de la relación con el cliente y no tanto a la integridad del almacén de datos, conviene aplicar también prácticas de higiene complementarias. Por ejemplo, los equipos empeñados en depurar los datos de salida para potenciar el retorno de inversión del correo electrónico abordan una capa distinta del mismo dilema de confianza: los registros defectuosos conducen a resultados desfavorables.
Por qué importa la Observability basada en la privacidad primero
El argumento de mayor peso para implantar la Observability en la propia base de datos es la viabilidad operativa. En gran parte de las empresas, los departamentos jurídicos y de seguridad vetarán arquitecturas que requieran que un proveedor disponga de acceso amplio a datos de producción. Un diseño de monitoreo que respete esta premisa tiene más probabilidades de lograr aprobación, desplegarse con éxito y mantenerse en activo.
Construir una cultura proactiva de calidad de datos
Las herramientas resultan útiles, pero la cultura determina si las alertas sirven para afianzar mejores procesos o solo para acumular más incidencias sin resolver.

Los equipos que gestionan con eficacia la calidad de los datos hacen cosas constantes y lógicas:
Asignar responsabilidades: Cada conjunto de datos vital debe vincularse a un responsable o equipo capaz de validar si un cambio es intencionado.
Automatizar lo evidente: Evita malgastar el tiempo de los analistas en revisiones que un sistema puede efectuar de continuo.
Diferenciar los fallos normativos de los desvíos funcionales: El incumplimiento de reglas, los cambios de esquema y las anomalías de comportamiento precisan respuestas específicas.
Visibilizar la calidad: Ingenieros, analistas y usuarios de negocio deben observar los mismos indicadores de salud de la información.
Analizar problemas para prevenirlos: Cada resolución debe traducirse en un control más robusto, lejos de quedar en un mero parche temporal.
Las culturas de datos maduras no se sientan a esperar que un ejecutivo halle un fallo en su cuadro de mando. Lo identifican con antelación, dotándolo de contexto y asignándole un responsable determinado.
Una lista de verificación ágil para un equipo nuevo puede ser breve:
Identificar las tablas e informes de mayor importancia
Señalar propietarios para cada propiedad de datos
Monitorear la actualización y los esquemas en recursos de uso compartido
Validar campos sometidos a normativas o críticos para el negocio
Hacer seguimiento de tendencias para que resalten los incidentes recurrentes
Si te replanteas el uso de metodologías enfocadas en la privacidad para hallar y mitigar problemas de calidad en los datos, merece la pena conocer digna. Su foco se sitúa en la Observability en base de datos, la detección de anomalías, la validación de registros, el control de puntualidad y el seguimiento de esquemas dentro de entornos de control del propio cliente, una alternativa clave para equipos necesitados de un sólido monitoreo sin precisar exportar datos protegidos hacia nubes de terceros.


