La completitud como dimensión de la calidad de datos: Una guía para 2026
|
8
minuto de lectura

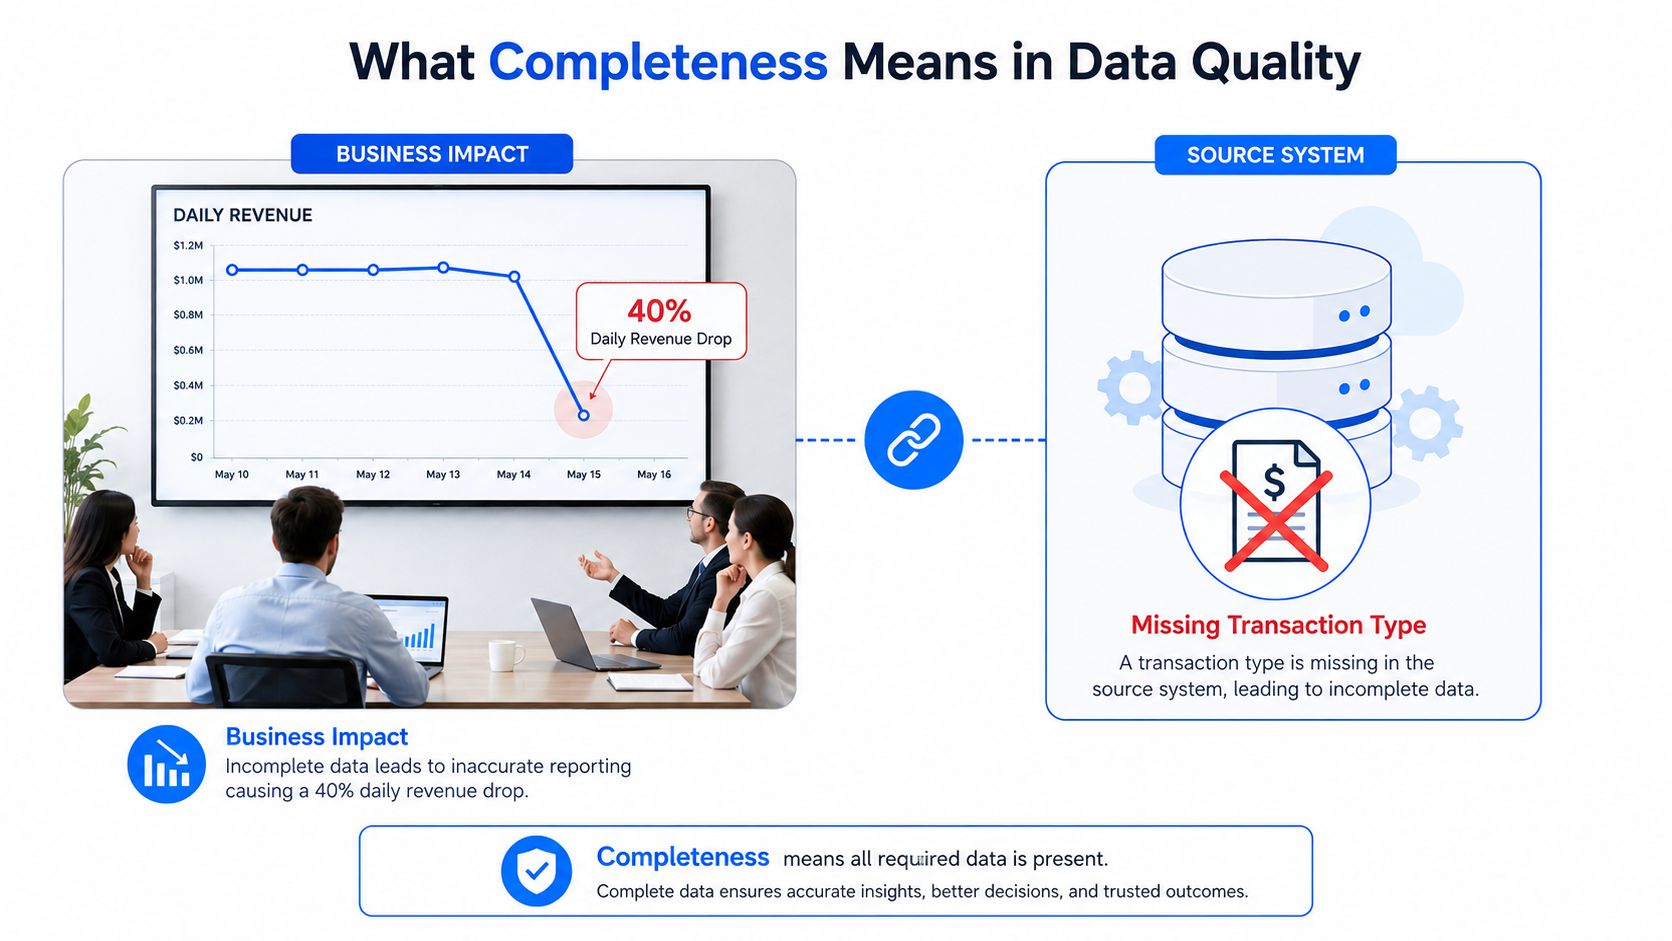
Su panel de ingresos diarios parece normal hasta que una mañana el total cae bruscamente. El sistema de origen está en línea, la canalización informa un éxito y la mayoría de las columnas están completas. El problema es que un tipo de transacción nunca llegó, o un identificador de cliente desapareció durante una exportación. Este es el tipo de fallo que la completitud de la calidad de los datos está diseñada para exponer.
La completitud en la calidad de los datos significa si todos los datos necesarios para un propósito previsto están presentes. Eso incluye los valores requeridos dentro de los registros, los registros que deberían existir pero faltan y los volúmenes de datos esperados a través de archivos o períodos de tiempo. Un conjunto de datos puede no contener espacios en blanco obvios y, aun así, estar incompleto si se ha excluido a un grupo entero de clientes, transacciones o eventos.
La norma práctica es la adecuación para el propósito. Un conjunto de datos puede ser lo suficientemente completo para un análisis e incompleto para otro, porque cada caso de uso requiere campos, registros, cobertura y patrones de entrega diferentes. La explicación del gobierno del Reino Unido sobre las dimensiones de la calidad de los datos hace esta distinción directamente, definiendo la completitud en relación con los datos requeridos para un uso particular en lugar de la población de cada campo posible.
Tabla de contenidos
Qué significa la completitud en la calidad de los datos
Supongamos que el panel de un equipo de finanzas muestra una caída inesperada de los ingresos. Un analista revisa la tabla de transacciones y encuentra que la mayoría de las filas tienen ID de cliente, fechas, montos y estados de pago. La tabla parece saludable a primera vista. Una comparación posterior revela que las transacciones móviles no estaban presentes en la última carga, por lo que al informe le faltaban registros válidos en lugar de contener simplemente celdas en blanco.
Esa distinción define la completitud como una dimensión de la calidad de los datos. Pregunta si el conjunto de datos contiene todo lo necesario para respaldar su propósito establecido. La pregunta no es "¿Están llenas todas las columnas?", sino "¿Incluyen estos datos los valores, registros y cobertura requeridos para la decisión que alguien tiene la intención de tomar?".
Por qué los valores no nulos no son suficientes
Una tabla de clientes puede tener una tasa de nulos baja y, al mismo tiempo, omitir a todos los clientes creados a través de un canal en particular. Una tabla de transacciones puede contener filas bien formadas mientras le falta un tipo de evento completo. Un archivo diario puede tener registros completos pero representar solo una parte de la actividad comercial esperada.
Por lo tanto, la completitud opera a un nivel superior al de la celda:
La completitud de campo pregunta si los atributos requeridos están poblados.
La completitud de registro pregunta si aparece cada entidad o evento requerido.
La completitud de archivo pregunta si llegó el archivo, partición o carga esperados.
La completitud de la población pregunta si el conjunto de datos representa a la población relevante del mundo real, incluidos grupos, fechas y tipos de transacciones.
La historia del concepto refleja esta visión más amplia. Las investigaciones han tratado la completitud como un atributo de calidad de datos designado desde al menos 1983, cuando Bailey y Pearson lo incluyeron entre los atributos principales de la calidad de la información de salida. Trabajos posteriores resumieron la completitud como el hecho de si se registran todos los datos relevantes, mientras que las pautas modernas la enmarcan en torno a las necesidades de un uso particular. Una descripción general útil de los conceptos de cobertura de datos de Wine Labs puede ayudar a los equipos a pensar más allá de las columnas pobladas y examinar si la población prevista está representada.
Regla práctica: Defina qué debe estar presente antes de calcular si los datos están completos.
Una definición de trabajo clara es: La completitud es la presencia de todos los datos requeridos para un propósito comercial definido, incluidos los valores, registros, archivos y cobertura de población requeridos. Los equipos que establezcan un marco más amplio también pueden revisar cómo se definen y miden las dimensiones de la calidad de los datos.
Las tres capas de la completitud
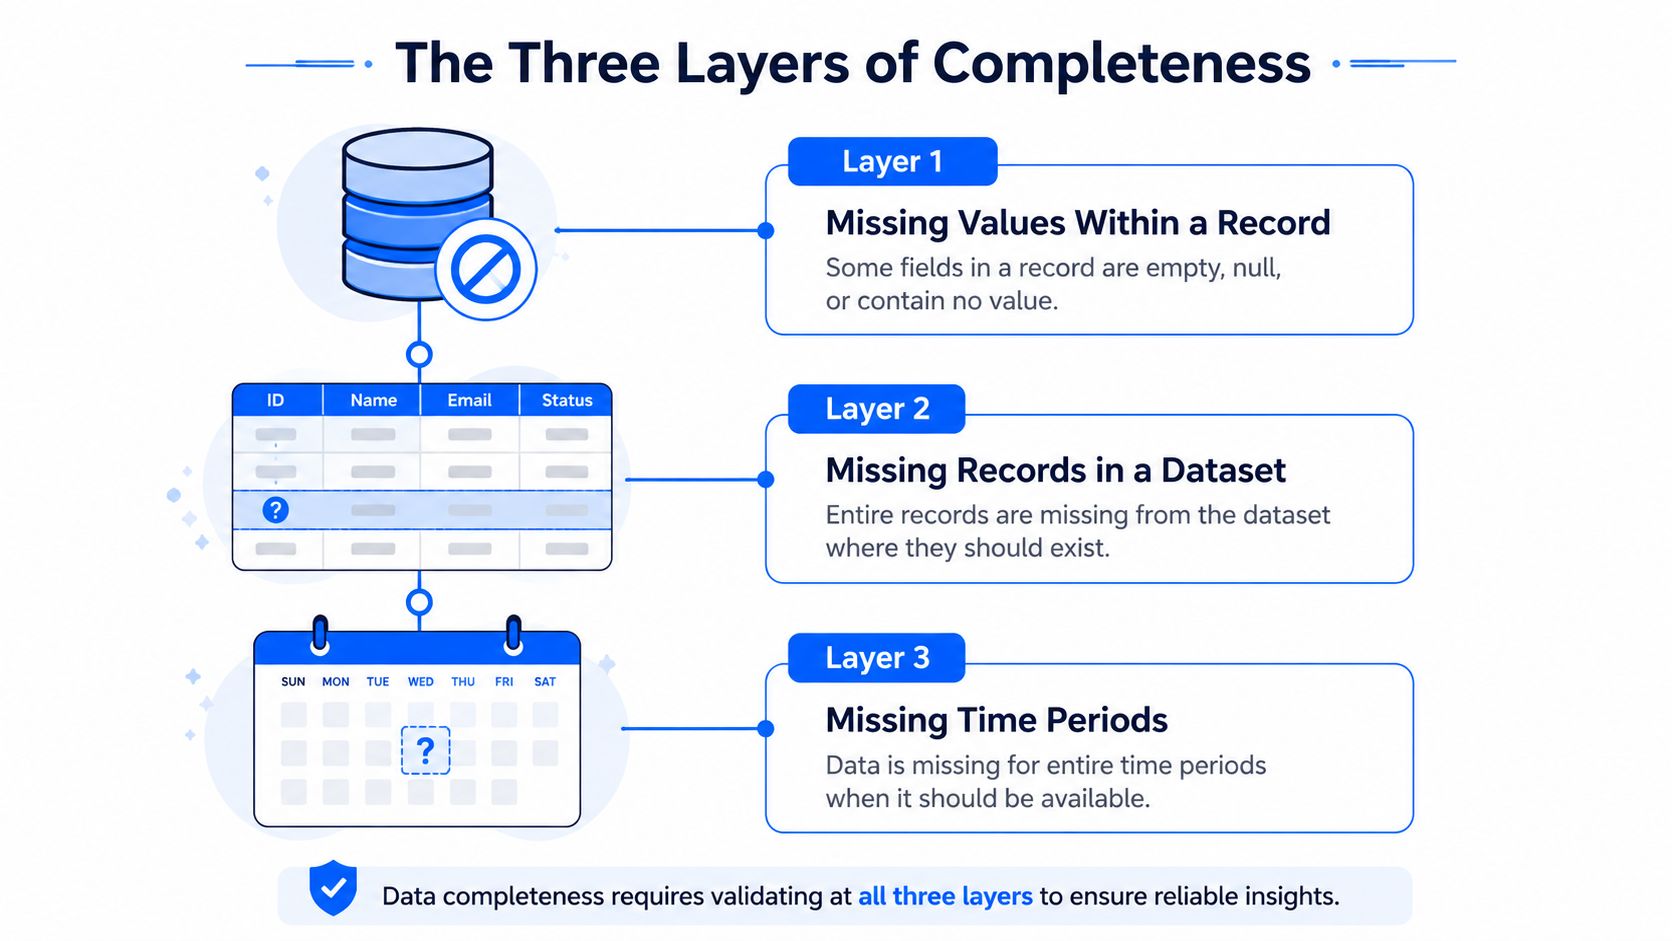
Los equipos a menudo tratan la completitud como un ejercicio de verificación de nulos. Eso solo detecta una capa del problema. Un programa confiable de completitud de datos separa las brechas dentro de los registros de los registros faltantes y la falta de cobertura a lo largo del tiempo o de los volúmenes esperados.
Piense en una biblioteca. A un libro le pueden faltar páginas, un libro requerido puede estar ausente del estante, o la biblioteca puede haber dejado de catalogar las nuevas llegadas durante varios días. Cada situación representa incompletitud, pero cada una requiere una prueba diferente.
La capa uno son los valores faltantes
La primera capa se refiere a los atributos dentro de un registro. Puede existir una fila de cliente, pero su ID de cliente, código postal, estado de consentimiento o marca de tiempo de creación pueden ser nulos, estar en blanco o ser reemplazados por un valor predeterminado.
Las comprobaciones de campos requeridos funcionan bien aquí. El equipo identifica los campos necesarios para una tarea, cuenta los registros donde esos campos están ausentes y monitorea el resultado a lo largo del tiempo. Un código postal faltante podría limitar el análisis regional, mientras que un identificador principal ausente puede impedir las uniones por completo.
No todo espacio en blanco es automáticamente un defecto. La información de perfil opcional puede estar legítimamente no disponible, mientras que un identificador requerido para la resolución de identidad no suele ser opcional. La definición comercial debe preceder al umbral.
La capa dos son los registros faltantes
La segunda capa se refiere a filas enteras. Un cliente, pedido, pago o evento esperado nunca llega a la tabla de destino. La validación a nivel de fila no lo encontrará porque no hay ninguna fila que inspeccionar.
Los equipos pueden detectar esto mediante la conciliación con una fuente autorizada, rangos de claves esperados, inventarios de eventos, totales de control o comparaciones entre sistemas ascendentes y descendentes. Por ejemplo, si un sistema de gestión de pedidos registra un ID de pedido pero la tabla del almacén de datos no lo hace, el almacén está incompleto incluso si cada fila que llegó supera sus comprobaciones de campo.
La capa tres es la falta de volumen o cobertura
La tercera capa se refiere a la forma del conjunto de datos a través del tiempo, archivos, particiones o poblaciones comerciales. Una tabla de eventos diarios puede contener filas válidas, pero la carga puede ser sustancialmente menor que el volumen esperado. Una partición puede estar ausente, un archivo de origen puede estar vacío o un nuevo tipo de evento puede dejar de fluir después de un cambio de esquema.
Esta capa conecta la completitud con la oportunidad (timeliness). Un archivo tardío está incompleto para un panel que debe reflejar el último período de informe, incluso si el archivo finalmente llega. También se conecta con la desviación del esquema (schema drift). Si un origen elimina una columna o cambia la estructura de un evento, los procesos descendentes pueden perder los hechos necesarios para un caso de uso.
Completitud vs. Exactitud y cómo divergen
La completitud y la exactitud responden a preguntas diferentes.
Completitud: ¿Están presentes los datos requeridos?
Exactitud: ¿Representan los datos correctamente la entidad, evento o valor del mundo real?
Un registro puede estar presente pero ser incorrecto. También puede ser correcto dondequiera que exista pero faltar en el conjunto de datos.
Considere una tabla de clientes utilizada para unir clientes con pedidos. Cada dirección de correo electrónico completada sigue el formato esperado y los detalles del cliente existente coinciden con el sistema de origen. Sin embargo, algunos ID de clientes son nulos. Las valores que existen pueden ser exactos, pero la tabla está incompleta para las uniones basadas en identidad porque faltan los identificadores requeridos.
Ahora invierta el problema. Cada fila de cliente contiene un ID de cliente, por lo que la tabla parece completa. Pero algunos ID apuntan a las personas equivocadas porque un proceso de mapeo ascendente los asignó incorrectamente. El conjunto de datos está completo en términos de presencia, pero es inexacto en términos de significado.
Dimensión | Pregunta central | Fallo típico | Comprobación útil |
|---|---|---|---|
Completitud | ¿Están presentes todos los datos requeridos? | Falta de ID de clientes o transacciones ausentes | Comprobaciones de campos obligatorios, conciliación y volumen |
Exactitud | ¿Reflejan los datos la realidad? | Un ID vinculado al cliente equivocado | Comparación con una fuente autorizada |
Ambas | ¿Están presentes y correctos los datos requeridos? | Una cuenta faltante o mal asignada | Controles separados de completitud y exactitud |
Los equipos confunden las dimensiones porque un espacio en blanco visible es fácil de identificar, mientras que un valor incorrecto puede parecer perfectamente plausible. Un campo poblado no es evidencia de que sea exacto, y un subconjunto exacto no es evidencia de que toda la población esté presente.
La respuesta operativa debe mantener los controles separados. Las comprobaciones de completitud buscan nulos, claves faltantes, eventos ausentes, archivos faltantes y volúmenes inesperados. Las comprobaciones de exactitud comparan valores con referencias confiables, validan relaciones de identidad o comprueban si los hechos comerciales coinciden con la realidad. Una explicación más amplia de la Observability de datos en comparación con la calidad de los datos ayuda a ubicar estos controles dentro de un modelo operativo más amplio.
Métricas, ratios y comprobaciones de campos obligatorios
La medición comienza con una expectativa explícita. Antes de calcular una puntuación de completitud, defina los campos requeridos, los registros requeridos, la población relevante, el cronograma de entrega y la variación aceptable para el caso de uso.
La métrica más simple a nivel de campo es un ratio de completitud:
Ratio de completitud = valores requeridos presentes ÷ valores requeridos esperados
Si una tabla contiene registros para los cuales debería estar presente un ID de cliente requerido, cuente los ID poblados y divida ese recuento por la cantidad de registros que se espera que los contengan. El resultado puede expresarse como una relación o porcentaje. La misma lógica se aplica a los registros, archivos, particiones o eventos esperados.
Una medida complementaria es la tasa de nulos:
Tasa de nulos = valores faltantes ÷ valores esperados
Una tasa de nulos que podría ser tolerable para un atributo de marketing opcional puede ser inaceptable para una clave primaria. Los umbrales deben reflejar las consecuencias comerciales, no un objetivo universal. Un correo electrónico faltante puede reducir el alcance de la campaña, mientras que un identificador de cuenta faltante puede impedir la conciliación, el linaje y las uniones descendentes.
Elegir umbrales fijos y adaptativos
Utilice un umbral fijo cuando la regla sea inherente al Data Contract. Es posible que se requiera una clave primaria para cada registro aceptado, y un valor faltante debería desencadenar un fallo independientemente del comportamiento histórico.
Utilice un umbral adaptativo cuando el valor esperado varíe según el cronograma, la temporada, el día, el comportamiento del origen o la actividad comercial. Los puntos de referencia históricos pueden identificar una caída inusual en los registros diarios sin obligar a los ingenieros a mantener un número separado para cada período.
Un diseño de monitoreo práctico combina ambos enfoques:
Las comprobaciones de campos obligatorios identifican valores faltantes en columnas críticas.
La conciliación de registros identifica entidades o eventos esperados que nunca llegaron.
Las comprobaciones de volumen comparan los recuentos observados con los rangos esperados.
Las comprobaciones de distribución identifican cambios que pueden indicar una población parcial o una categoría omitida.
El monitoreo de tendencias muestra si un problema de completitud es estable, está mejorando o empeorando.
La siguiente tabla mapea los controles comunes con las capacidades de implementación.
Dimensión | Métrica | Ejemplo de comprobación | Capacidad de digna |
|---|---|---|---|
Completitud de campo | Tasa de nulos por campo requerido | El ID de cliente está presente para cada registro de cliente requerido | Data Validation |
Completitud de registro | Recuento de claves faltantes | Los ID de pedido en el origen están ausentes en el almacén | Data Validation |
Completitud de archivo | Estado de llegada o carga | Falta la partición de transacción programada | Data Anomalies |
Completitud de volumen | Recuento de registros observado frente al esperado | El volumen diario de eventos es inesperadamente bajo | Data Anomalies |
Completitud de distribución | Cobertura de categorías o eventos | Un tipo de transacción desaparece de la última carga | Data Anomalies |
Completitud de tendencia | Ratio de completitud a lo largo del tiempo | La cobertura de campos obligatorios disminuye en cargas sucesivas | Data Analytics |
Los equipos pueden ampliar este modelo con métricas de calidad de datos y prácticas de medición. Lo importante es medir el nivel en el que ocurre el fallo. Una sola puntuación global puede ocultar una población faltante, por lo que se deben informar por separado las métricas de campo, registro, archivo y volumen.
Ejemplos reales de datos empresariales incompletos
Los fallos de completitud suelen aparecer primero como un síntoma comercial. Un modelo pierde poder predictivo, un total de ingresos parece bajo o un panel de operaciones informa una caída inverosímil. La causa técnica a menudo se encuentra en una etapa anterior de la canalización.
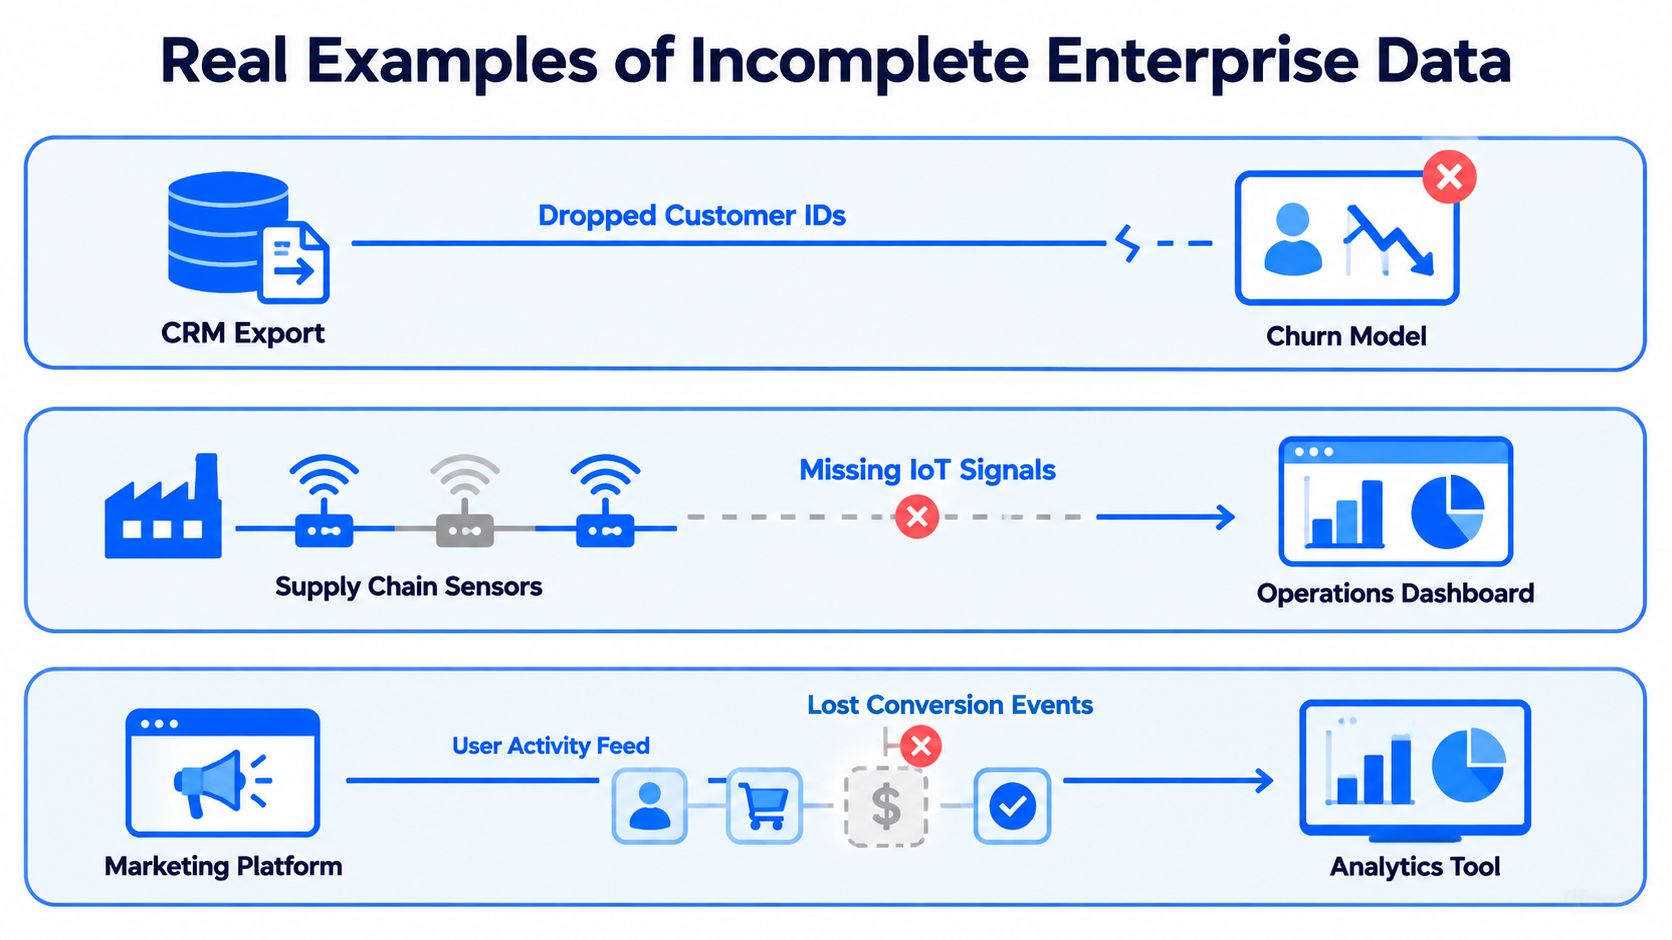
Una exportación de CRM pierde identificadores de clientes
Una exportación de CRM contiene nuevos registros móviles, pero el campo ID de cliente está en blanco para ese grupo. Las filas están presentes, y los nombres y direcciones de correo electrónico pueden parecer válidos, pero el proceso de resolución de identidad no puede conectar de manera confiable a esos clientes con los pedidos, el historial de soporte o la actividad anterior.
La empresa nota una interrupción en el análisis de abandono o un aumento inexplicable de clientes no identificados. Una regla de campo requerido en el ID de cliente detectaría el defecto a nivel de registro. Una comparación de población por canal de adquisición revelaría que el problema afecta a un grupo específico en lugar de a toda la exportación.
Un flujo de pagos deja transacciones sin finalizar
Un procesador de pagos continúa enviando filas de transacciones, pero algunos pagos permanecen marcados como pendientes indefinidamente. La tabla parece poblada, mientras que el proceso de ingresos de fin de mes no puede tratar esas transacciones como liquidadas ni incluirlas en el resultado financiero esperado.
La brecha de completitud no es solo un valor nulo. El ciclo de vida de la transacción requerido está incompleto para el propósito del informe. Los controles deben comparar los estados de transacción esperados y los totales de conciliación, mientras que el monitoreo de la oportunidad debe identificar los registros que no logran avanzar dentro de la ventana operativa definida.
Una carga de eventos particionada escribe muchas menos filas
Un lote diario normalmente produce una gran tabla de eventos. Un día, falla una carga particionada y solo un pequeño subconjunto de filas llega al almacén de datos. Las filas que sobreviven superan las comprobaciones de esquema y de campos obligatorios, por lo que una prueba a nivel de fila por sí sola informa un éxito.
El primer síntoma visible puede ser un panel de actividad bajo o un segmento faltante en un modelo analítico. Una comprobación de volumen que tenga en cuenta el cronograma compararía el recuento observado con el comportamiento histórico y marcaría la carga para su investigación. El monitoreo de la distribución podría mostrar qué origen, fecha o tipo de evento desapareció.
Estos ejemplos comparten una lección: los datos incompletos no siempre parecen rotos dentro de las filas que llegaron. El monitoreo debe probar lo que debería haber llegado, no solo lo que está almacenado actualmente.
Cómo digna respalda la completitud de los datos
Un programa de completitud necesita tanto reglas deterministas como un monitoreo del comportamiento. La elección correcta depende de si la expectativa es explícita, como "se requiere el ID de cliente", o si se aprende del comportamiento recurrente de los datos, como un cambio inusual en el volumen diario.
digna Data Validation
digna Data Validation aplica comprobaciones a nivel de registro contra las reglas comerciales. Un equipo puede definir controles de campos obligatorios para ID de clientes, fechas de transacciones, claves de cuentas u otros atributos necesarios para un flujo de trabajo específico. El módulo también puede admitir comprobaciones dirigidas para valores vacíos y condiciones comerciales que determinan si un registro es utilizable.
Este es el control más claro para la primera capa de completitud, los valores faltantes dentro de los registros. También puede admitir la lógica de completitud a nivel de registro, donde una fila debe contener una combinación definida de valores antes de ser aceptada para su uso descendente.
digna Data Anomalies
digna Data Anomalies monitorea cambios inesperados en los recuentos de registros, tasas de nulos y distribuciones. Su enfoque de aprendizaje de línea base es adecuado para datos que varían de forma natural, donde un único límite fijo crearía alertas innecesarias.
Esto ayuda a abordar los registros faltantes y la falta de volumen. Una reducción inesperada en las filas diarias, la desaparición de una categoría de transacción o un aumento repentino de nulos se pueden investigar como una posible carga parcial, interrupción del origen o cambio en la canalización. El módulo también ayuda a descubrir patrones que no estaban cubiertos por reglas escritas manualmente.
digna Data Analytics
digna Data Analytics proporciona un análisis histórico de las métricas de completitud. Una tasa de nulos actual tiene un significado limitado sin contexto. Las vistas históricas ayudan a los equipos a distinguir una característica estable de un deterioro reciente e identificar si un problema de carga recurrente se está volviendo más frecuente.
Los módulos se pueden mapear en las tres capas:
Valores faltantes: Data Validation comprueba los campos obligatorios y las condiciones de los registros.
Registros faltantes: la validación y el monitoreo de anomalías comparan la cobertura esperada y la observada.
Falta de volumen o períodos: digna Data Anomalies monitorea los recuentos, las distribuciones y el comportamiento de la carga, mientras que digna Data Analytics muestra la tendencia.
digna realiza el cálculo y análisis de métricas en el entorno de la base de datos del cliente, por lo que los datos permanecen en su lugar. La implementación puede llevarse a cabo dentro de una nube privada, VPC o centro de datos, lo que respalda a los equipos que necesitan un monitoreo de completitud sin mover los datos de producción a un servicio externo.
El diseño práctico es modular. Un equipo puede comenzar con reglas explícitas de campos obligatorios, agregar detección de anomalías para cambios inesperados y usar análisis históricos para regir los umbrales y la remediación. El seguimiento del esquema y los controles de oportunidad pueden complementar esta configuración cuando las columnas eliminadas o las cargas que llegan tarde crean fallos de completitud de forma indirecta.
Cadencia de monitoreo, gobernanza y preguntas frecuentes
El monitoreo de completitud funciona mejor cuando cada control se ejecuta en el punto donde su falla es importante. Las comprobaciones de campos obligatorios deben ejecutarse en cada carga relevante. Las comprobaciones de volumen deben ejecutarse de acuerdo con el cronograma de entrega del conjunto de datos. La detección de anomalías debe evaluar el comportamiento de forma continua o cada vez que lleguen nuevos datos.
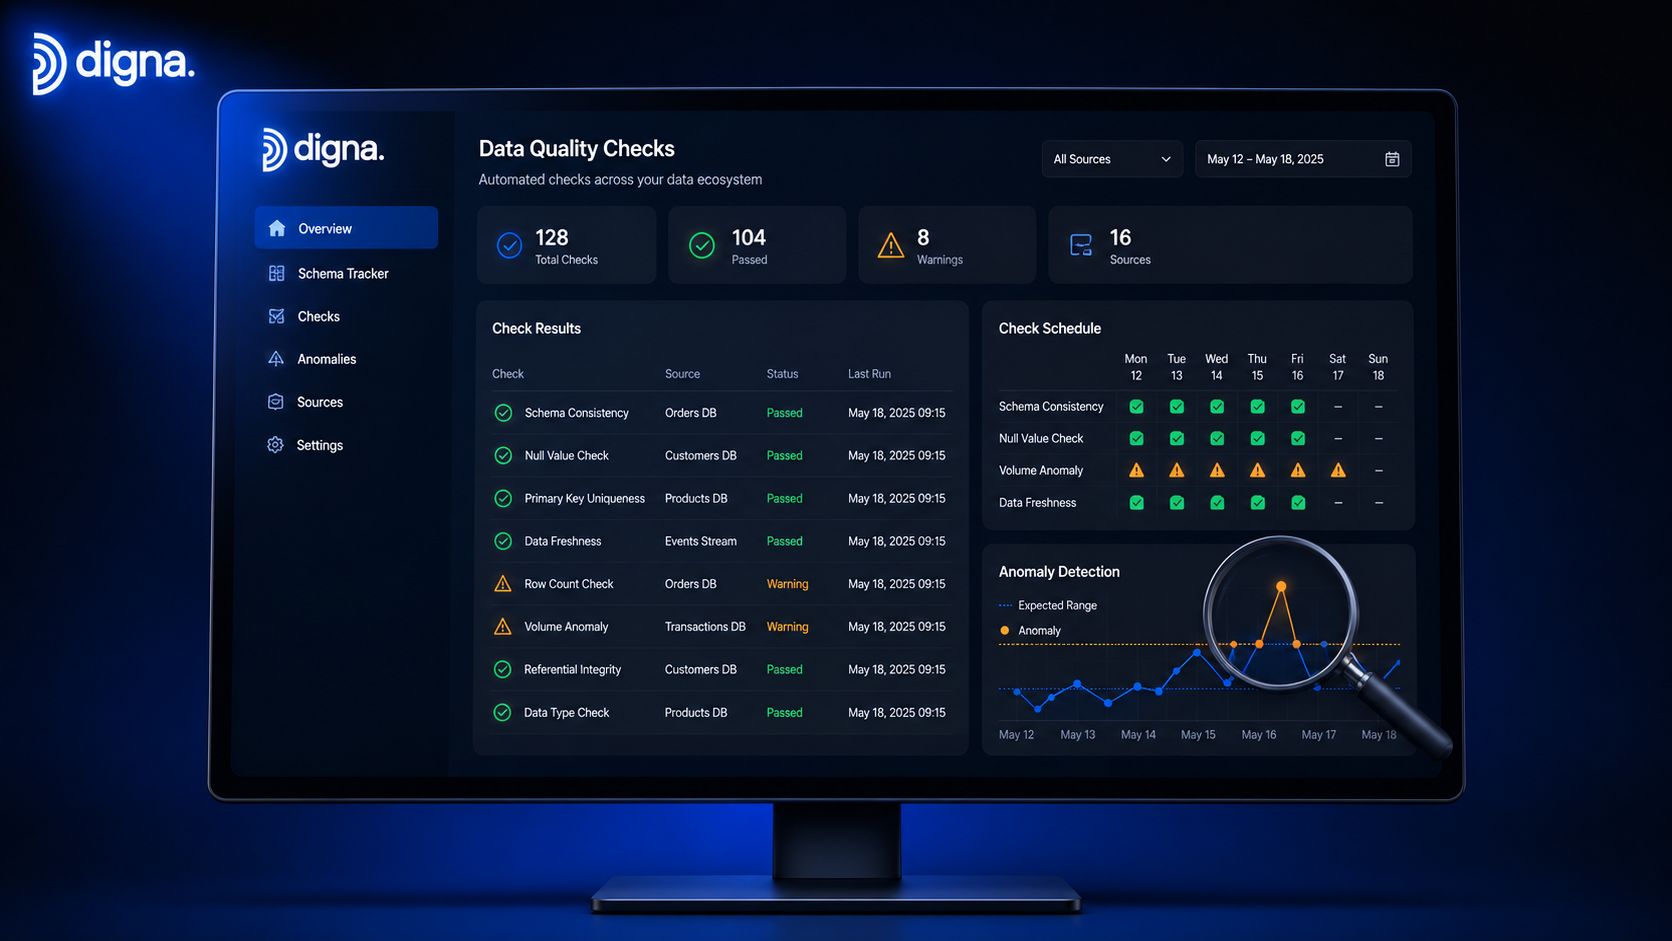
Asigne la propiedad antes de que comiencen las alertas. Los ingenieros de datos pueden investigar las cargas fallidas, los administradores de datos pueden definir qué campos y poblaciones se requieren, y los propietarios comerciales pueden decidir si una brecha bloquea un informe o requiere una advertencia. Utilice reglas de gravedad y enrutamiento para que los equipos no reciban alertas por cada variación inofensiva.
Preguntas frecuentes
¿Qué es la completitud en la calidad de los datos?
La completitud es si todos los datos necesarios para un propósito previsto están presentes. Incluye valores requeridos, registros esperados, archivos relevantes, períodos de tiempo y cobertura de población.
¿Cómo se mide la completitud de los datos?
Mida los valores requeridos presentes frente a los valores requeridos esperados, calcule las tasas de nulos por campo, concilie los registros de origen y destino, y compare los volúmenes observados con los rangos esperados. Utilice métricas separadas para campos, registros, archivos y poblaciones.
¿Cuáles son métricas de completitud útiles?
Las métricas útiles incluyen la tasa de nulos en campos obligatorios, el ratio de completitud, el recuento de claves faltantes, la conciliación de origen a destino, el estado de llegada de archivos, la varianza del volumen de registros y la cobertura de categorías o eventos.
¿Qué es un buen umbral de completitud?
No existe un único umbral universal. Establezca el límite de acuerdo con la función del campo, el uso previsto y la consecuencia de la falta de datos. Un identificador principal generalmente requiere un tratamiento más estricto que un atributo descriptivo opcional.
¿Cómo se monitorea la completitud de forma continua sin fatiga de alertas?
Combine reglas fijas para los requisitos esenciales con líneas base adaptativas para volúmenes cambiantes. Agrupe alertas relacionadas, asigne propietarios, documente las excepciones esperadas y revise las tendencias históricas antes de ajustar los umbrales.
¿En qué se diferencia la completitud de la exactitud?
La completitud pregunta si los datos requeridos existen. La exactitud pregunta si los datos reflejan la realidad. Un conjunto de datos puede estar completo pero ser incorrecto, o ser exacto dondequiera que esté poblado pero carecer de registros importantes.
Un breve recorrido visual puede ayudar a los equipos a conectar estas prácticas con el monitoreo diario:
Comience enumerando los datos que requiere su informe, modelo o proceso operativo más importante. Luego, agregue comprobaciones de campo, conciliación de registros, monitoreo de volumen y revisión histórica con la cadencia adecuada, en lugar de depender de una única puntuación de completitud.
digna proporciona Data Validation, Data Anomalies y Data Analytics para ayudar a los equipos a hacer cumplir las reglas de campos obligatorios, detectar cambios inesperados en los recuentos y tasas de nulos, y monitorear las tendencias de completitud a lo largo del tiempo dentro de su propio entorno. Visite digna para explorar un enfoque modular para la calidad y la Observability de los datos.


