Integridad referencial entre bases de datos: cómo comprobarla
|
6
minuto de lectura

Sus pedidos están en el almacén de datos (data warehouse). Los clientes a los que apuntan están en el CRM, en otro servidor, gestionado por otro equipo. La integridad referencial entre bases de datos significa que cada clave de un sistema, como el número de cliente de un pedido, coincide con un registro existente en la tabla maestra de otro sistema. Una clave foránea no puede garantizarlo, porque una clave foránea declarada solo funciona, por lo general, dentro de una misma base de datos. Así que, cuando llega un pedido con un número de cliente que el CRM nunca emitió, nada falla. La fila se carga, un join la descarta y algún informe queda mal sin que nadie lo note.
Esta es la variante más difícil de la integridad referencial. Dentro de una base de datos, al menos puede declarar la restricción; al cruzar el límite de una base de datos, un servidor o un sistema no hay nada que declarar. El concepto general se explica en nuestro artículo principal ¿Pueden sus datos seguir encontrando a sus padres? Entender la integridad referencial. Este artículo trata la integridad referencial entre sistemas: dónde se rompe, qué cuestan las soluciones habituales, por qué los formatos de clave generan falsas alarmas y cómo comprobarla en digna sin copiar datos maestros a ningún sitio.
Puntos clave
Una clave foránea entre bases de datos no es posible en general: una restricción declarada hace referencia a tablas de la misma base de datos, por lo que las referencias entre sistemas quedan sin protección por diseño.
Las soluciones habituales (consultas federadas, tablas de referencia copiadas, búsquedas durante el ETL, exportaciones para conciliación) añaden movimiento de datos, pipelines o trabajo manual.
Las diferencias de formato de clave, como ceros a la izquierda, mayúsculas y minúsculas, relleno y tipos de datos, generan falsos huérfanos. Acuerde una forma canónica de la clave antes de comparar.
Desde Release 2026.01, digna Data Validation comprueba la integridad referencial entre tablas, vistas, esquemas y distintas conexiones de base de datos del mismo proyecto, validando los datos allí donde residen.
La configuración son unos pocos campos: las columnas clave, la fuente de datos en la que deben existir y dos umbrales. Sin escribir SQL.
Índice de contenidos
¿Por qué una clave foránea no puede proteger una referencia entre bases de datos?
¿Dónde se rompen las referencias entre sistemas?
Maestro de clientes en el CRM, transacciones en el almacén de datos
Maestro de productos en el ERP, pedidos en el sistema de pedidos
Maestro de pacientes y episodios clínicos
Core bancario y el almacén de datos de reporting
¿Cómo suelen validar los equipos las referencias entre sistemas?
¿Por qué las diferencias de formato de clave generan falsos huérfanos?
¿Cómo se comprueba la integridad referencial entre bases de datos en digna?
¿Qué referencias entre sistemas debería comprobar primero?
Siguiente paso
¿Por qué una clave foránea no puede proteger una referencia entre bases de datos?
Una clave foránea no puede proteger una referencia entre bases de datos porque es una restricción que el motor aplica sobre sus propias tablas, buscando la fila referenciada en la misma base de datos en cada inserción, actualización y borrado. Por lo general, una clave foránea declarada no puede apuntar a una tabla de otra base de datos, otro servidor u otro producto, de modo que no hay nada contra lo que comprobar.
Algunos motores permiten consultar entre bases de datos, pero consultar no es restringir. Una restricción aplicada entre sistemas exigiría que el sistema remoto estuviera disponible y fuera consistente en cada escritura, y los sistemas separados existen precisamente para que uno siga funcionando mientras el otro está caído, en migración o recargándose.
El lado del almacén de datos lo empeora. Muchas plataformas analíticas aceptan declaraciones de clave foránea sin aplicarlas, incluso dentro de una misma base de datos: Snowflake las describe como opcionales y no aplicadas en tablas estándar, y BigQuery indica que no las aplica. Además, los sistemas cambian de forma independiente: el equipo del CRM fusiona clientes duplicados, el ERP da de baja un producto. Cada cambio es válido en su propio sistema y aun así puede dejar registros en otro lugar apuntando a claves que ya no existen.
¿Dónde se rompen las referencias entre sistemas?
Las referencias entre sistemas se rompen allí donde un sistema es dueño de los datos maestros y otro registra la actividad: una tabla de transacciones que hace referencia a un cliente, producto, paciente o cuenta mantenido en otro lugar, por otro equipo, con su propio ciclo de versiones y sus propias reglas para fusionar y dar de baja claves. Hay cuatro situaciones que se repiten una y otra vez.
Maestro de clientes en el CRM, transacciones en el almacén de datos
El equipo de operaciones de ventas mantiene los clientes en el CRM; los pedidos se cargan en el almacén de datos cada noche. Cuando se fusionan dos registros del CRM, un ID desaparece. Los pedidos del almacén de datos todavía lo llevan, y los ingresos por cliente, segmento o región pierden filas sin que nadie lo note.
Maestro de productos en el ERP, pedidos en el sistema de pedidos
Un producto nuevo sale a la venta antes de que se publique el registro maestro en el ERP, o se elimina un producto descatalogado mientras todavía hay pedidos abiertos que lo referencian. Las líneas de pedido sin un producto coincidente desaparecen de los informes de margen y de stock.
Maestro de pacientes y episodios clínicos
Los hospitales mantienen la identidad del paciente en un maestro de pacientes, a menudo un índice maestro de pacientes (MPI), y registran ingresos, peticiones de laboratorio y medicación en los sistemas clínicos. Cuando se fusionan pacientes duplicados, los episodios que todavía hacen referencia al ID dado de baja pierden a su paciente, lo que afecta a la facturación y a los informes clínicos.
Core bancario y el almacén de datos de reporting
Las cuentas y los clientes residen en el sistema de core bancario. El reporting de gestión y regulatorio se ejecuta en un almacén de datos independiente alimentado por varios sistemas de origen. Un apunte que hace referencia a una cuenta ausente de la dimensión de cuentas de reporting o bien se descarta de los totales o bien acaba en un cajón de "desconocido". Profundizamos en este caso en integridad referencial en datos bancarios.
¿Cómo suelen validar los equipos las referencias entre sistemas?
Los equipos suelen validar las referencias entre sistemas de una de estas cuatro formas: consultar la tabla remota mediante un servidor vinculado, un database link o una consulta federada; copiar la tabla de referencia en el sistema de destino; buscar las claves durante el ETL; o exportar las claves de ambos lados y conciliarlas periódicamente. Todas funcionan, y todas tienen un coste.
La comprobación subyacente es siempre el mismo anti-join. Si ambas tablas fueran accesibles desde un mismo motor, tendría este aspecto:
Las soluciones se diferencian en cómo hacen que crm.customers sea accesible desde el sistema que contiene sales_orders:
Enfoque | Cómo funciona | Qué cuesta |
|---|---|---|
Servidores vinculados, database links, consultas federadas | Un motor consulta directamente la tabla remota y ejecuta el join | Ambos sistemas deben estar disponibles en el momento de la consulta; los joins grandes a través de la red son lentos y cargan el origen; las credenciales del sistema remoto se guardan en la base de datos; a menudo está bloqueado entre zonas de red |
Copiar la tabla de referencia en el almacén de datos | Un pipeline replica la tabla maestra junto a las transacciones | Un pipeline adicional que construir y operar; la comprobación es tan reciente como la última copia; otra copia de datos maestros, a menudo datos personales, plantea cuestiones de protección y residencia de datos |
Búsquedas durante el ETL | El proceso de carga busca cada clave y rechaza o marca las filas sin coincidencia | Solo cubre los datos que pasan por ese pipeline; comprueba una única vez, en la carga, así que los borrados y fusiones posteriores en el maestro pasan desapercibidos; las tablas de rechazos se acumulan sin que nadie las lea |
Exportaciones periódicas para conciliación | Las listas de claves de ambos sistemas se exportan a ficheros y se comparan | Manual y poco frecuente; los resultados llegan semanas después del error; los ficheros de claves circulan por correo o unidades compartidas |
Ninguna de ellas es incorrecta, pero comparten un problema: o se mueven datos, o alguien tiene que acordarse de ejecutar algo. Lo que usted necesita es una comprobación programada que lea cada lado allí donde reside y le diga al equipo responsable qué registros han quedado huérfanos.
¿Por qué las diferencias de formato de clave generan falsos huérfanos?
Las diferencias de formato de clave generan falsos huérfanos porque dos sistemas pueden almacenar la misma clave de negocio de formas distintas: como texto en uno y como número en el otro, con o sin ceros a la izquierda, con distinto uso de mayúsculas o con espacios al final. Una comparación byte a byte informa entonces de que falta un padre que en realidad existe.
Es el motivo más habitual por el que una primera comprobación entre sistemas informa de miles de fallos:
Diferencia | Sistema A | Sistema B |
|---|---|---|
Ceros a la izquierda |
|
|
Mayúsculas y minúsculas |
|
|
Relleno y espacios en blanco |
|
|
Conversiones de tipo |
|
|
Prefijos de sistema |
|
|
Corríjalo en tres pasos:
Acuerde una forma canónica para la clave, por ejemplo una cadena sin espacios, en mayúsculas y rellenada hasta diez dígitos.
Normalice uno o ambos lados a esa forma en una vista o en una sentencia SQL, cerca del origen.
Compruebe que la clave maestra normalizada sigue siendo única. Eliminar ceros o unificar mayúsculas puede fusionar dos claves distintas en una, lo que ocultaría huérfanos reales.
Una consulta de normalización tiene este aspecto (los nombres de las funciones varían ligeramente entre bases de datos):
No elimine con la normalización diferencias reales. Si un prefijo le indica qué sistema de origen emitió la clave, una clave compuesta de sistema de origen y número es más segura que quitar el prefijo.
¿Cómo se comprueba la integridad referencial entre bases de datos en digna?
En digna, una comprobación de integridad referencial entre bases de datos es una regla de Data Validation de tipo Referential Integrity cuyo lado "must exist in" apunta a una fuente de datos en otra conexión de base de datos del mismo proyecto. Desde Release 2026.01 valida los datos allí donde residen, sin replicar ninguna de las dos tablas en el otro sistema.
Dos cambios de la versión 2026.01 lo hacen posible. Las comprobaciones de integridad referencial se ejecutan entre tablas y vistas, entre esquemas y entre distintas conexiones de base de datos dentro de un proyecto. Y una fuente de datos es una capa lógica respaldada por una tabla, una vista o una sentencia SQL personalizada, lo que le da un lugar donde tratar los formatos de clave: una fuente de datos con SQL personalizado puede recortar, convertir o rellenar la clave antes de la comparación, de forma muy parecida a la consulta anterior. Pruebe esa normalización con datos reales antes de confiar en ella. Las conexiones de base de datos son globales, así que una conexión al CRM configurada una vez puede reutilizarse en todos los proyectos.
La regla se configura en un único cuadro de diálogo:
Vaya a Configuration, seleccione la fuente de datos que contiene las filas que hacen la referencia, abra la pestaña Data Validation y haga clic en Add Rule. Se abre el cuadro de diálogo Add Data Validation Rule.
Introduzca un Name (nombre) y una Description (descripción) que indique qué debe cumplirse, por ejemplo "Cada pedido hace referencia a un cliente del maestro del CRM".
Establezca Type (tipo) en Referential Integrity.
En Attributes (atributos), elija la columna o columnas clave de esta fuente de datos.
En must exist in (debe existir en), elija la Data Source (fuente de datos) de destino, que puede estar en otra conexión, y sus Attributes correspondientes. Para una clave compuesta, elija las columnas de ambos lados en el mismo orden.
Elija un Threshold Mode (modo de umbral), Absolute o Relative, y establezca el Info threshold y el Warn threshold.
Guarde. La regla se ejecuta con cada inspección de la fuente de datos, programada o bajo demanda.

La regla de integridad referencial en digna: product_code debe existir en la fuente de datos hospital_medications.
Las capturas de pantalla proceden de nuestro proyecto de demostración, donde ambas fuentes de datos están en la misma conexión. El cuadro de diálogo es el mismo cuando la fuente de datos de destino está en otra conexión: la elige en "must exist in" como cualquier otra fuente de datos. La demostración utiliza datos ficticios de Danubia Kliniken, un grupo hospitalario austriaco inventado.
La regla hc_product_in_master establece que todo producto administrado debe existir en el maestro de productos de farmacia. El 2026-04-22, las plantas registraron 82 administraciones de "Coavira 2.5 mg" (código de producto 3858646) antes de que el producto se hubiera dado de alta en el maestro. Todos los informes que unían dosis con productos mostraban cero dosis del nuevo producto, mientras que el personal de enfermería había administrado 82.
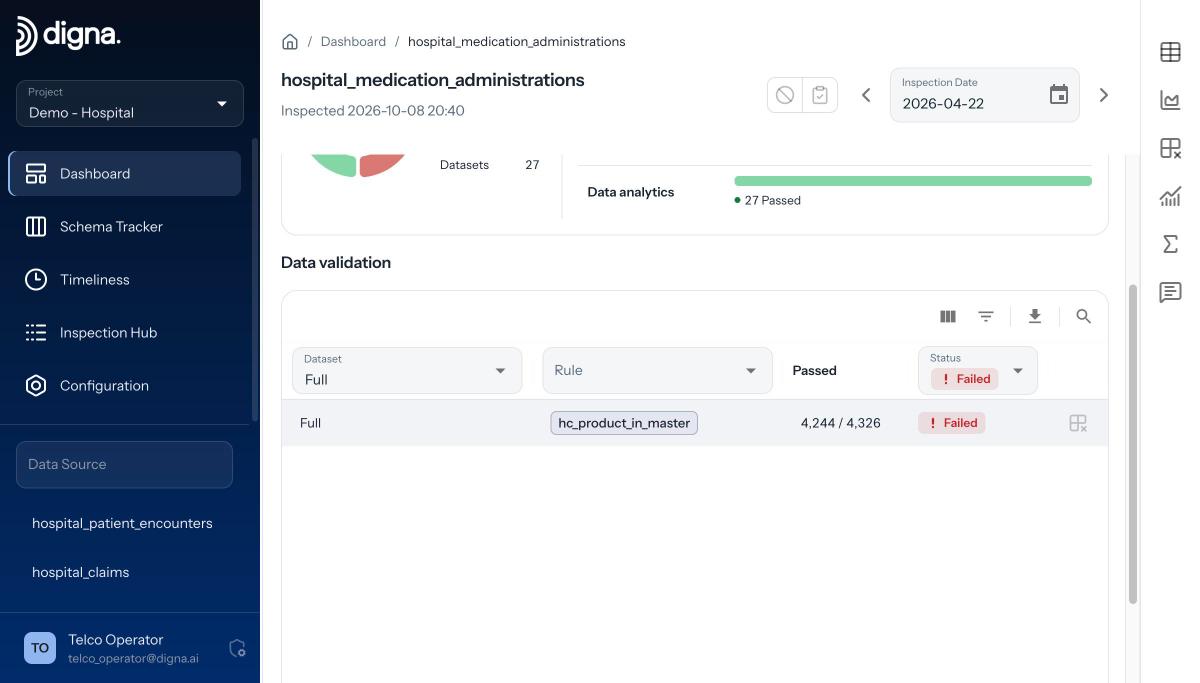
El resultado del 2026-04-22: 4244 de 4326 filas superadas, 82 fallidas, estado Failed.
digna informa del número de registros superados y fallidos por regla, y devuelve los propios registros fallidos: la misma consulta con la condición de aprobación negada. En la vista Invalid Records (registros no válidos) filtra por Passed, Uncertain o Failed, elige la comprobación y ve las filas, en este caso con hospital, planta, código de producto y nombre del medicamento. Puede exportarlas y notificar al equipo responsable de los datos.
Hay algunos comportamientos que importan en las comprobaciones entre sistemas:
Los umbrales son cero por defecto, así que una regla nueva falla con un solo huérfano. Si se sabe que el maestro va unas horas por detrás de las transacciones, suba el Info threshold para que un recuento pequeño aparezca como Uncertain en lugar de Failed, o utilice el modo Relative.
Las claves NULL se omiten. Un número de cliente vacío no hace fallar la comprobación referencial. Si la clave es obligatoria, añada una Rule independiente, como
customer_no IS NOT NULL.Las listas de columnas deben tener la misma longitud. Una discrepancia se rechaza en lugar de comprobar en silencio una condición más débil.
Las comprobaciones se ejecutan dentro de las bases de datos de origen. digna envía SQL y recibe recuentos, más las filas fallidas cuando usted las solicita. Sus datos nunca salen de su infraestructura.
Para ver el recorrido completo con cada campo, consulte cómo configurar una comprobación de integridad referencial. Los tipos de regla, los umbrales y las vistas de resultados se describen en la página de digna Data Validation y en la documentación.
¿Qué referencias entre sistemas debería comprobar primero?
Compruebe primero las referencias entre sistemas que alimentan informes sobre los que se toman decisiones, y aquellas cuyos datos maestros se fusionan, renumeran o dan de baja con regularidad, porque ahí es donde un huérfano se convierte directamente en una cifra errónea. Empiece con unas pocas reglas y amplíe el alcance cuando haya resuelto los falsos huérfanos debidos al formato de clave.
Un orden práctico para la validación de datos maestros entre sistemas:
Transacciones frente al maestro de clientes, cuentas o pacientes, porque ahí se producen fusiones y cierres constantemente.
Líneas de pedido y movimientos de stock frente al maestro de productos, porque los productos nuevos suelen venderse antes de que el registro maestro esté completo.
Códigos de referencia (país, divisa, centro de coste) frente al sistema propietario de la lista de códigos.
Combine cada regla referencial con una regla de Uniqueness sobre la clave maestra: una comprobación de referencias contra un maestro con claves duplicadas puede superarse aunque los datos sigan siendo incorrectos.
Siguiente paso
Las claves foráneas se detienen en el límite de la base de datos, y gran parte de los datos importantes lo cruzan. No necesita otro pipeline para validar referencias entre sistemas: una regla Referential Integrity por relación, ejecutándose donde residen los datos, muestra después de cada inspección qué registros han perdido a su padre. Si quiere verlo en su propio entorno, reserve una demostración con el equipo de digna.
Preguntas frecuentes
¿Se puede crear una clave foránea entre bases de datos?
Por lo general, no. Una clave foránea declarada hace referencia a una tabla de la misma base de datos, porque el motor la comprueba en cada inserción, actualización y borrado. Entre bases de datos, servidores o productos no hay nada que declarar, así que las referencias entre sistemas deben validarse con una comprobación programada, como un anti-join o una regla de integridad referencial.
¿Cómo se comprueba la integridad referencial entre dos bases de datos distintas?
Ejecute un anti-join que devuelva las claves de la tabla que hace la referencia sin coincidencia en la tabla maestra. Los equipos suelen hacer accesibles ambas tablas mediante consultas federadas, tablas de referencia copiadas, búsquedas durante el ETL o exportaciones para conciliación. En digna, una regla Referential Integrity puede apuntar a una fuente de datos en otra conexión, sin replicar datos.
¿Por qué una comprobación entre sistemas informa de huérfanos que en realidad existen?
Normalmente, porque los formatos de clave difieren. Un sistema almacena '0004711' como texto y el otro 4711 como entero, y las mayúsculas y minúsculas, los espacios al final o los prefijos de sistema provocan los mismos falsos huérfanos. Acuerde una forma canónica, normalice la clave en una vista o sentencia SQL y confirme que la clave maestra normalizada sigue siendo única.
¿Copia digna la tabla maestra para comparar claves entre conexiones?
No. Desde Release 2026.01, digna comprueba la integridad referencial entre tablas, vistas, esquemas y conexiones de base de datos de un proyecto sin replicar datos. Las comprobaciones se ejecutan dentro de sus bases de datos: digna envía SQL y recibe recuentos, más las filas fallidas cuando usted las solicita. Sus datos nunca salen de su infraestructura.
¿Hacen fallar las claves foráneas NULL una comprobación de integridad referencial en digna?
No. Las reglas Referential Integrity omiten los NULL, así que una fila con el número de cliente vacío no se cuenta como huérfana. Cuando la clave es obligatoria, añada una Rule independiente con una condición como customer_no IS NOT NULL, para que las claves ausentes y las claves sin coincidencia se notifiquen como dos problemas distintos.



