Cómo configurar una comprobación de integridad referencial paso a paso
|
6
minuto de lectura

Una clave foránea que no apunta a nada no genera ningún error. La fila se carga, el siguiente inner join la descarta y un informe muestra cero donde debería haber 82. Una comprobación de integridad referencial es una regla de validación de datos que confirma que cada valor de una columna hija, o de un conjunto de columnas, existe en la tabla padre referenciada, e informa de las filas que no cumplen.
La mayoría de las plataformas analíticas no la ejecutan por usted. Snowflake trata las claves foráneas de las tablas estándar como opcionales y no las aplica, y BigQuery indica claramente que mantenerlas es responsabilidad suya. Redshift y Databricks se comportan igual. La comprobación tiene que estar en otro sitio.
Esta guía explica cómo comprobar la integridad referencial en la práctica: primero las decisiones que hay que tomar (relaciones, columnas, NULL, umbrales, momento de ejecución) y después la configuración en digna: unos pocos campos, sin SQL. Si prefiere empezar por el concepto, lea primero nuestra guía sobre integridad referencial y registros huérfanos.
Puntos clave
Compruebe primero las relaciones sobre las que se unen sus informes: tablas de hechos con dimensiones y registros hijos con sus padres, ordenadas según lo que se rompe cuando fallan.
Use exactamente las columnas del join en ambos lados. Una clave compuesta se comprueba como combinación, y ambas listas de columnas deben tener la misma longitud y el mismo orden.
Una clave foránea NULL no hace fallar una comprobación de integridad referencial. Si la referencia es obligatoria, añada una regla not-null aparte.
Use tolerancia cero para datos financieros y clínicos, y un umbral relativo para tablas grandes con una cola conocida de referencias que llegan tarde.
En digna, la comprobación es una regla de tipo Referential Integrity: elija las columnas, elija dónde deben existir, fije dos umbrales y guarde. Se ejecuta dentro de su base de datos con cada inspección.
Índice de contenidos
¿Qué es una comprobación de integridad referencial?
¿Qué relaciones debería comprobar primero?
¿Cómo se eligen las columnas y las claves compuestas?
¿Qué debería significar una clave foránea NULL?
¿Qué umbral debería usar una comprobación de integridad referencial?
¿Cuándo debería ejecutarse una comprobación de integridad referencial?
¿Cómo se configura una comprobación de integridad referencial en digna?
¿Cómo es el SQL equivalente?
¿Cómo se interpreta una comprobación de integridad referencial fallida?
¿Por dónde empezar?
¿Qué es una comprobación de integridad referencial?
Una comprobación de integridad referencial toma una columna, o un conjunto de columnas, de una tabla hija y confirma que cada valor informado existe también en la tabla padre referenciada. Las filas que encuentran a su padre pasan. Las que no lo encuentran son huérfanas y fallan. El resultado es un recuento de filas correctas, un recuento de filas fallidas y, si lo solicita, las filas fallidas. También se la conoce como comprobación de clave foránea o validación de integridad referencial.
Una restricción de clave foránea actúa en el momento de la escritura y rechaza la inserción. Una comprobación actúa después de la carga y le indica qué parte de los datos cargados no apunta a ningún sitio. Donde las claves declaradas son solo informativas, la comprobación es lo único que realmente tiene.
Enfoque | Cuándo actúa | Qué ocurre con un huérfano | Funciona donde las FK no se aplican | Qué obtiene |
|---|---|---|---|---|
Restricción de clave foránea | Al insertar o actualizar | Rechazado; la carga falla | No, la declaración es una indicación | Un mensaje de error |
Consulta SQL ad hoc | Cuando alguien se acuerda de ejecutarla | Nada hasta que alguien mira | Sí | Un conjunto de resultados en el cliente SQL de alguien |
Comprobación de integridad referencial en digna | Con cada inspección, programada o bajo demanda | Cargado, contado y listado | Sí, también entre conexiones de bases de datos | Recuentos de correctas/fallidas, un estado según su umbral, las filas fallidas |
¿Qué relaciones debería comprobar primero?
Compruebe primero las relaciones sobre las que realmente se unen sus informes y procesos posteriores: tablas de hechos con sus dimensiones y registros hijos con sus padres. Un enlace roto ahí cambia cifras que la gente lee y firma. Una relación que nadie consulta puede esperar.
Un inventario rápido le da una lista priorizada:
Enumere los joins de hechos a dimensiones. Apuntes contables a cuentas, reclamaciones a pacientes, registros de llamadas a abonados, administraciones de medicamentos al maestro de productos.
Enumere los joins de hijos a padres. Líneas de pedido a pedidos, diagnósticos a episodios asistenciales, garantías a préstamos.
Marque los que alimentan informes, facturación o reportes regulatorios. Un inner join en esas consultas descarta los huérfanos sin dejar rastro.
Marque los que cargan procesos o sistemas distintos. Un hijo que llega antes que su padre es un huérfano.
Empiece por los cinco a diez primeros. Añada el resto cuando alguien se haga cargo de los resultados.
Si quiere dimensionar el problema antes de configurar nada, las consultas de cómo encontrar registros huérfanos con SQL le dan un recuento puntual por relación.
¿Cómo se eligen las columnas y las claves compuestas?
Use exactamente las columnas que usa el join, en ambos lados y en el mismo orden. Si el padre se identifica con dos columnas, compruébelas juntas como clave compuesta. Comprobar cada columna por separado deja pasar combinaciones que no existen en ningún lugar del padre.
Los códigos de unidad hospitalaria son un buen ejemplo. Si todos los hospitales de un grupo tienen una unidad llamada ICU-1, una fila con el hospital 2 y ICU-1 pasa una comprobación de una sola columna sobre ward_code siempre que el hospital 1 tenga esa unidad. Solo el par (hospital_id, ward_code) lo detecta. digna comprueba la combinación cuando usted elige varias columnas, y rechaza listas de columnas de distinta longitud en lugar de comprobar una condición más débil.
Dos cosas más que conviene decidir antes:
Apunte a la clave del padre, no a una etiqueta. Compruebe
product_codecontra elproduct_codedel maestro, no contra un nombre de producto que alguien puede editar.Haga comparables ambos lados. Un código guardado como texto con ceros a la izquierda en un lado y como número en el otro produce huérfanos que no son reales. Normalícelo en una vista y compruebe la vista: en digna, una fuente de datos puede ser una tabla, una vista o una sentencia SQL personalizada.
¿Qué debería significar una clave foránea NULL?
Decida de antemano si se permite una clave foránea NULL. Una comprobación de integridad referencial pregunta si un valor existe en el padre, y un NULL no tiene valor que buscar, así que digna omite los NULL en esta comprobación. Si la referencia es obligatoria, añada una regla not-null aparte, para que un valor ausente y un valor colgante aparezcan como hallazgos distintos.
Algunas referencias son legítimamente opcionales: un médico remitente, un código de promoción, una cuenta padre para un cliente de primer nivel. Otras nunca lo son: todo apunte tiene una cuenta, toda dosis administrada tiene un producto. Mantenerlas separadas hace evidente la corrección: una referencia ausente vuelve al sistema que la capturó, una colgante a los datos maestros o al orden de carga.
Qué quiere detectar | Tipo de regla en digna | Ejemplo |
|---|---|---|
Valor presente pero no en el padre | Referential Integrity |
|
Valor ausente donde es obligatorio | Rule |
|
La clave aparece más de una vez en el padre | Uniqueness |
|
La tercera fila también importa: una clave padre duplicada no crea huérfanos, pero duplica cada fila que se une a ella.
¿Qué umbral debería usar una comprobación de integridad referencial?
Use tolerancia cero para datos financieros y clínicos, donde un huérfano es una cifra errónea en un estado financiero o una dosis que falta en el historial de un paciente. Use un umbral relativo para tablas muy grandes en las que una cola pequeña y conocida de referencias que llegan tarde es normal y solo un salto por encima de esa cola merece atención.
digna asigna a cada regla un Threshold Mode (modo de umbral). Absolute compara el número de registros fallidos. Relative compara los registros fallidos divididos entre los registros evaluados, como fracción, de modo que 0.01 significa un uno por ciento. Cada modo tiene dos niveles: por encima del Info threshold el estado es Uncertain, por encima del Warn threshold es Failed, y en caso contrario Passed. Ambos valen cero por defecto, así que una regla nueva falla con un solo registro erróneo hasta que usted decida otra cosa.
Situación | Threshold Mode | Info | Warn | Efecto |
|---|---|---|---|---|
Apuntes a cuentas, dosis al maestro de productos | Absolute | 0 | 0 | Un huérfano hace fallar la ejecución |
Mismos datos, un registro suelto debería avisar antes de fallar | Absolute | 0 | 1 | Un huérfano da Uncertain, dos o más Failed |
Registros de eventos o llamadas con dimensiones que llegan tarde de forma conocida | Relative | 0.001 | 0.01 | Por encima del 0,1 % Uncertain, por encima del 1 % Failed |
Empiece de forma estricta y relaje solo por un motivo que pueda poner por escrito.
¿Cuándo debería ejecutarse una comprobación de integridad referencial?
Ejecútela después de cada carga de la tabla hija, y también después de las cargas del padre, porque los huérfanos aparecen cada vez que ambas llegan desordenadas. En digna, la regla se ejecuta con cada inspección de su fuente de datos, programada o bajo demanda, así que alinee la inspección con la carga y no con el calendario de informes.
Una comprobación a fin de mes encuentra de golpe un mes entero de huérfanos, con el informe ya a punto de entregarse. Una comprobación después de cada carga encuentra los de un día, mientras quien hizo la carga aún recuerda qué cambió. El coste es un join por ejecución, ejecutado dentro de la base de datos de origen, sin copiar nada fuera. Cuando falle, notifique al equipo responsable de los datos.
¿Cómo se configura una comprobación de integridad referencial en digna?
En digna, una comprobación de integridad referencial es una regla de digna Data Validation de tipo Referential Integrity. Usted elige las columnas de su fuente de datos, elige la fuente de datos y las columnas en las que deben existir, fija dos umbrales y guarda. No hay que escribir SQL, y la configuración lleva menos de un minuto.
Vaya a Configuration, seleccione la fuente de datos (aquí
hospital_medication_administrations), abra la pestaña Data Validation y haga clic en Add Rule. Se abre el diálogo Add Data Validation Rule.Introduzca un Name (nombre) y una Description (descripción):
hc_product_in_master, "Every administered product exists in the pharmacy product master".Establezca Type (tipo) en Referential Integrity. Las otras opciones son Rule y Uniqueness.
En Attributes (atributos), elija la columna de esta fuente de datos:
product_code.En must exist in (debe existir en), elija la Data Source (
hospital_medications) y sus Attributes (product_code). Para una clave compuesta, elija varias columnas en ambos lados en el mismo orden.Elija el Threshold Mode y fije el Info threshold y el Warn threshold. El ejemplo usa Absolute, Info 0, Warn 1.
Guarde. A partir de ahora, la regla se ejecuta con cada inspección de la fuente de datos.

La regla completa: tipo, atributos, la fuente de datos en la que deben existir y dos umbrales. Datos de demostración de Danubia Kliniken, un grupo hospitalario austriaco ficticio.
Con Info 0 y Warn 1, un solo huérfano ya pone el estado en Uncertain y cualquier cantidad mayor lo pone en Failed. Deje Warn en 0 si un único huérfano debe hacer fallar la ejecución. El padre tampoco tiene que estar junto al hijo: desde Release 2026.01, el otro lado puede ser una tabla o vista de otro esquema o de otra conexión de base de datos del mismo proyecto, algo que se trata en integridad referencial entre bases de datos. El vídeo de 2:26 Integridad referencial en digna: configuración en menos de un minuto recorre los mismos pasos.
Cuando tenga muchas de estas reglas, gestiónelas como código: Release 2026.06 añadió un SDK de Python (pip install digna-sdk) y la importación y exportación de reglas de validación entre entornos.
¿Cómo es el SQL equivalente?
En el fondo, una comprobación de integridad referencial es un left join de las filas hijas a las claves padre distintas, que cuenta las filas sin coincidencia e ignora las claves NULL. digna genera y ejecuta esto dentro de su base de datos. Escrita a mano para el ejemplo anterior, la lógica es esta:
Esto ilustra la lógica, no es la sentencia literal que envía digna. Para una clave compuesta, la condición del join tiene una igualdad por cada par de columnas. La consulta es la parte fácil. El trabajo está en todo lo demás: ejecutarla después de cada carga, compararla con un umbral, guardar el historial y hacer llegar las filas a las personas adecuadas. La documentación de digna describe cómo cada tipo de regla se convierte en SQL.
¿Cómo se interpreta una comprobación de integridad referencial fallida?
Interprete un fallo en tres pasos: el estado le dice que se ha superado el umbral, los recuentos le dicen el tamaño del problema y los registros fallidos le dicen por qué. Los huérfanos que comparten una misma clave suelen indicar datos maestros ausentes. Los huérfanos repartidos entre muchas claves suelen apuntar a una carga fallida del padre o a una discrepancia de formato de clave.
Volvamos al ejemplo de Danubia Kliniken. El 2026-04-22 se registraron en las unidades 82 administraciones de un producto nuevo antes de que el producto llegara al maestro de productos de farmacia. La regla hc_product_in_master falló: pasaron 4.244 de 4.326 filas.
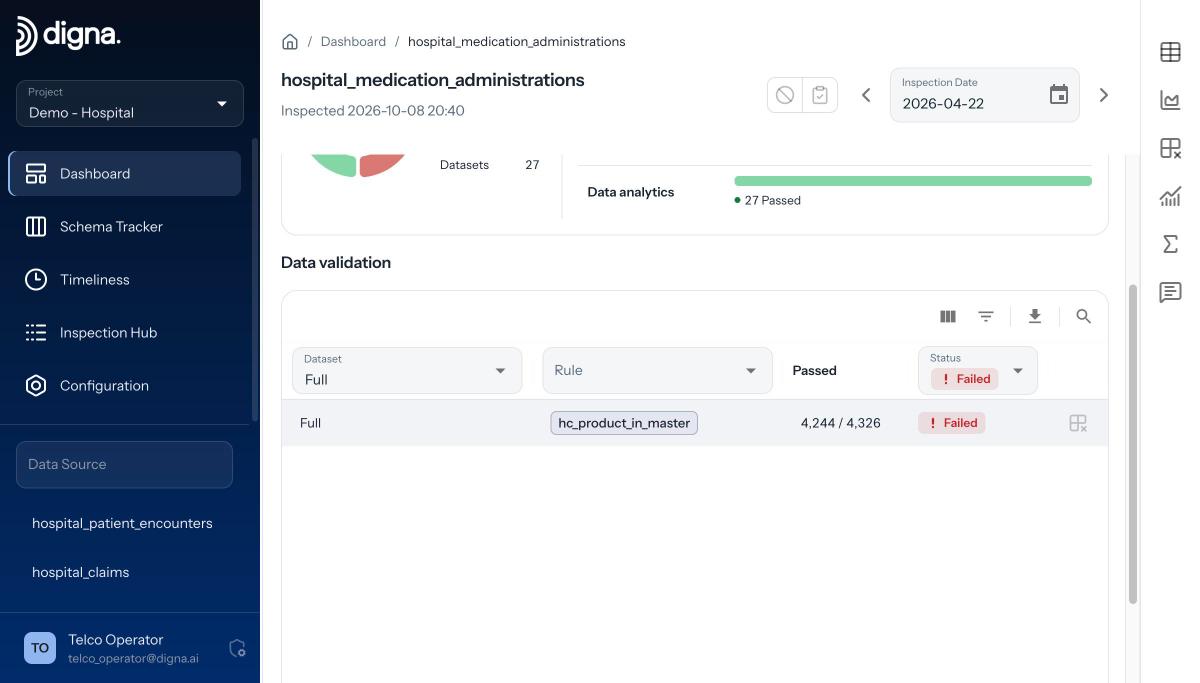
El resultado en el panel: pasaron 4.244 de 4.326, estado Failed.
Para ver por qué, abra la vista Invalid Records (registros no válidos), filtre por Failed, elija la comprobación y digna lista todas las filas fallidas. Aquí las 82 tienen el mismo product_code, 3858646 (Coavira 2.5 mg). No son 82 errores de registro, sino un producto que falta en el maestro. Todos los informes que unían dosis con productos mostraban 0 dosis de él, mientras el personal de enfermería había administrado 82.

Invalid Records: cada dosis fallida con hospital, unidad, código de producto y nombre del medicamento.
Los patrones habituales:
Una clave, muchas filas: el registro padre aún no existe. Añádalo a los datos maestros y vuelva a ejecutar la inspección.
Muchas claves, una carga: la carga del padre falló o se ejecutó tarde. Corrija el orden de carga.
Claves casi correctas: ceros a la izquierda, mayúsculas/minúsculas o espacios en blanco difieren entre sistemas. Normalice en una vista.
Claves antiguas: se eliminaron o archivaron registros padre mientras los hijos todavía los referencian.
Las filas fallidas se pueden exportar, así que el equipo responsable recibe los registros, no solo una cifra.
¿Por dónde empezar?
Elija la relación cuyos huérfanos más daño harían si llegaran a un informe este mes y póngale una comprobación después de la próxima carga. Cada comprobación son unos pocos campos, se ejecuta dentro de su base de datos y sus datos nunca salen de su infraestructura. Si quiere verlo con sus propias tablas, solicite una demo con el equipo de digna.
Preguntas frecuentes
¿Cómo compruebo la integridad referencial con SQL?
Haga un left join de la tabla hija a los valores de clave distintos del padre y cuente las filas en las que el lado del padre es NULL, omitiendo las filas cuya propia clave foránea es NULL. Esas filas son huérfanas. Selecciónelas en lugar de contarlas para obtener los registros que hay que corregir; la programación, los umbrales y el historial los construye usted.
¿Falla una comprobación de integridad referencial con claves foráneas NULL?
No. En digna, las comprobaciones de integridad referencial omiten los valores NULL, porque un NULL no tiene nada que buscar en la tabla padre. Cuando la referencia es obligatoria, añada una Rule aparte, como product_code IS NOT NULL, para que un valor ausente y un valor huérfano aparezcan como hallazgos distintos.
¿Puede una comprobación de integridad referencial usar una clave compuesta?
Sí. Seleccione varios atributos en la fuente de datos y el mismo número en el padre, en el mismo orden, y digna comprueba la combinación. Las listas de columnas de distinta longitud se rechazan, porque comparar una clave de dos columnas con una sola columna dejaría pasar filas que la clave completa detectaría.
¿Qué umbral debería usar una comprobación de integridad referencial?
Para datos financieros y clínicos, use el modo Absolute con tolerancia cero, de modo que un solo huérfano haga fallar la ejecución. Las tablas muy grandes con una cola conocida de referencias que llegan tarde se adaptan mejor a un umbral Relative; en digna es una fracción, así que 0.01 significa un uno por ciento de las filas evaluadas.
¿Cuánto se tarda en configurar una comprobación de integridad referencial en digna?
Menos de un minuto. Abra la fuente de datos en Configuration, vaya a la pestaña Data Validation, haga clic en Add Rule, establezca Type en Referential Integrity, elija los atributos y la fuente de datos en la que deben existir, fije dos umbrales y guarde. digna genera el SQL y lo ejecuta dentro de su base de datos.



