Calidad de datos en tiempo real: una guía práctica para 2026
|
7
minuto de lectura

Ya conoce la sensación. El panel de control se veía bien por la mañana, el sistema de origen había cambiado para el almuerzo y, para cuando alguien se dio cuenta, el almacén de datos había estado contando una historia que no era cierta. En entornos regulados, ese tipo de brecha no es un problema estético. Es la forma en que una fuente desactualizada se convierte en una mala decisión, un informe roto o un incidente que nadie puede explicar con claridad.
Calidad de Datos en Tiempo Real es la disciplina de capturar esos fallos mientras los datos aún se están moviendo. Eso significa que las comprobaciones de calidad ya no son un trabajo de limpieza nocturno, sino que forman parte de la ruta de operación en vivo, ligadas a la frescura, la latencia, los cambios de esquema y los conteos de nulos como señales observables de salud IBM observability metrics. También significa que la arquitectura debe respetar una dura verdad: la validación en streaming tiene que ejecutarse de forma continua sin arruinar la latencia de extremo a extremo de la investigación de calidad en streaming de IJERET.
Índice de contenidos
Calidad en tiempo real frente a calidad por lotes y dónde se rompe cada una
Cómo encajan la ejecución en base de datos, la detección de anomalías y el seguimiento de esquemas
Una lista de verificación para un despliegue por fases para comenzar
El momento en que la calidad por lotes deja de funcionar
El modo de fallo es familiar. Un panel de finanzas parece consistente el martes, un modelo está puntuando normalmente y luego el viernes los números se desvían, pero nadie puede señalar el momento exacto en que los datos se dañaron. Las comprobaciones por lotes pueden decir que la carga de ayer pasó, mientras que el problema principal comenzó entre trabajos y se propagó río abajo antes de que nadie tuviera la oportunidad de detenerlo.
Por eso la calidad en tiempo real no es solo un "lote más rápido". Es un modelo operativo diferente. La investigación sobre la calidad del streaming describe que las métricas de calidad se calculan continuamente para que los equipos puedan detectar problemas a medida que llegan los datos en lugar de después de los trabajos de procesamiento nocturnos, lo que representa un cambio significativo en la forma en que los ingenieros piensan sobre el control, no solo sobre las herramientas ACM streaming analytics paper.
La frescura cambia la definición de calidad
En la práctica, la dimensión que suele faltar es la oportunidad. Un conjunto de datos puede ser técnicamente válido y, aun así, ser operativamente incorrecto si llega tarde, falta o llega fuera de ritmo. Es por eso que la frescura, la latencia y el comportamiento del flujo de trabajo ahora importan tanto como las dimensiones clásicas de precisión e integridad.
Regla práctica: si el panel depende de datos sensibles al tiempo, trate el retraso como un defecto de calidad, no solo como una molestia del flujo de trabajo.
La validación por lotes todavía tiene su lugar, especialmente para auditorías retrospectivas y perfiles profundos. Pero para el fraude, las operaciones y los flujos de trabajo de cara al cliente, esperar al próximo trabajo programado es cómo se propagan los registros defectuosos. La calidad en tiempo real existe porque el costo comercial de llegar tarde aparece antes de que se cierre la ventana de procesamiento por lotes.
Qué significa realmente la calidad de datos en tiempo real
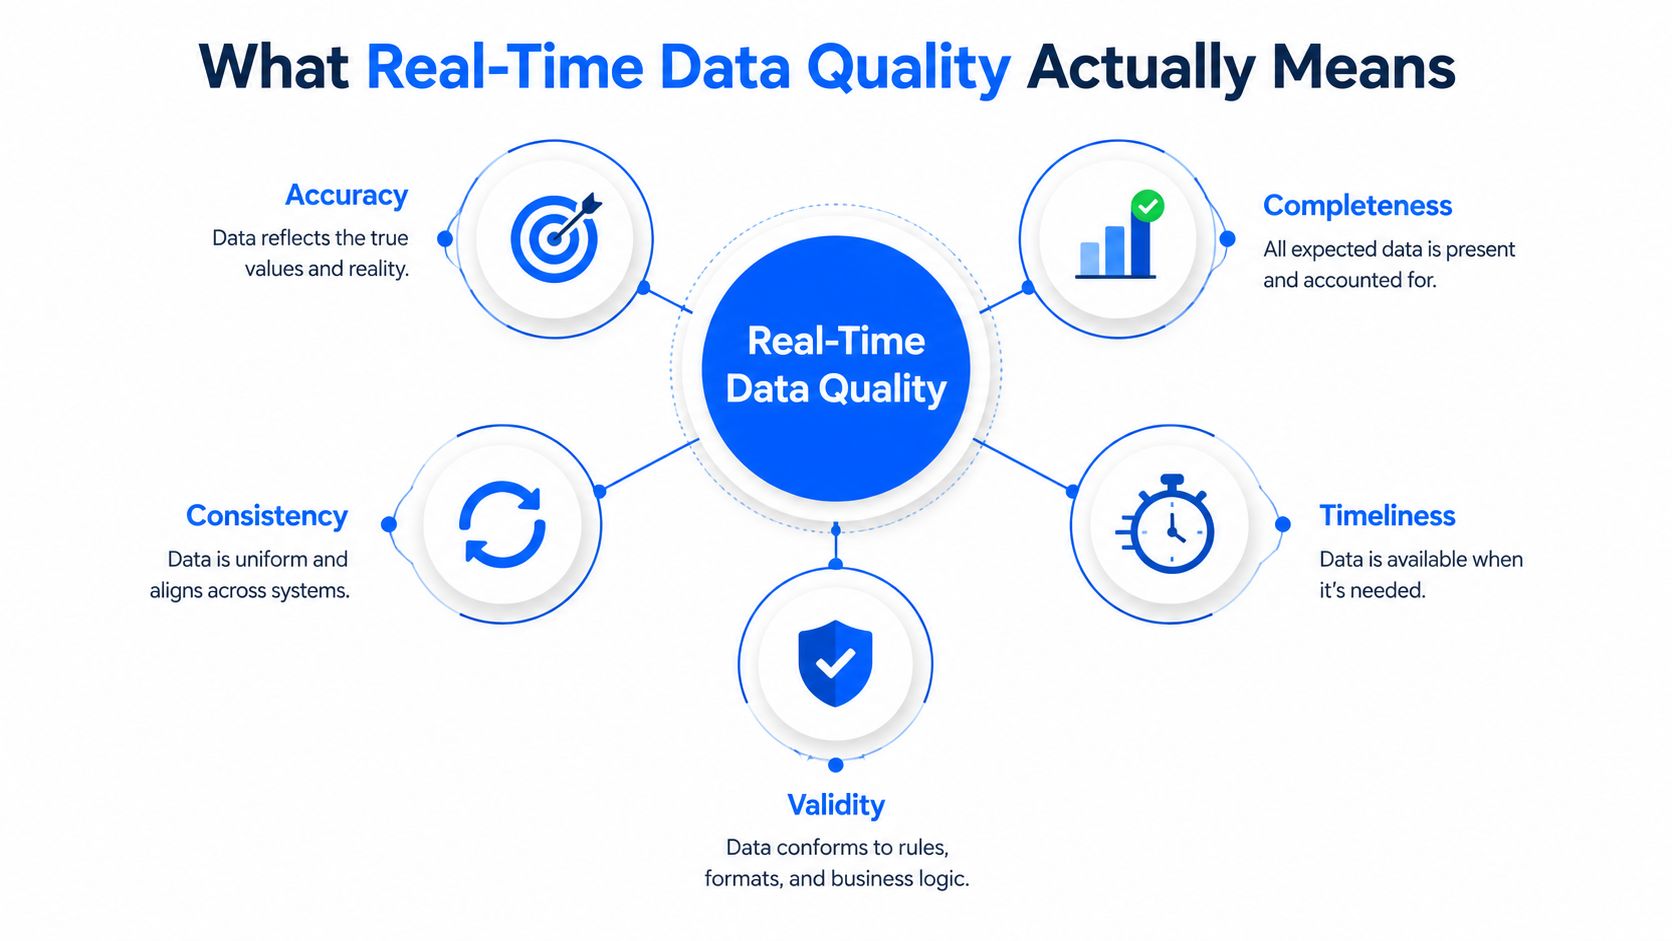
Una definición útil es simple. Calidad de Datos en Tiempo Real es la comprobación continua de los datos a medida que se mueven a través del flujo de trabajo, con controles que juzgan si cada registro es apto para su uso posterior en el momento en que llega. El objetivo no es construir un segundo almacén de reglas, sino evitar que los problemas estructurales y de comportamiento crucen la frontera hacia los sistemas de producción.
La frescura se sitúa en el centro
Para los sistemas en tiempo real, la frescura suele ser la primera métrica que revela problemas. Una forma estándar de definirla es el tiempo transcurrido desde que se escribió el registro más reciente en un conjunto de datos, medido contra un SLA Soda freshness metric guidance. Eso hace que la frescura sea operativa, no filosófica.
El resto de las dimensiones se vuelven más fáciles de razonar una vez que la frescura está establecida:
La integridad le indica si llegaron los campos y las fuentes esperados.
La validez le indica si los valores coinciden con el formato, tipo y rango esperados.
La consistencia le indica si la misma entidad coincide entre sistemas.
La unicidad le indica si se están filtrando duplicados en el flujo de datos.
Las dimensiones estándar de IBM incluyen precisión, integridad, consistencia, oportunidad, validez y unicidad, y la definición de validez del gobierno del Reino Unido mantiene el enfoque en el formato, el tipo y el rango IBM data quality dimensions.
Un solo registro se puede evaluar contra todos ellos en el momento de la ingesta. Si un evento de pedido llega a tiempo, con el esquema correcto, una moneda aceptada, sin ID duplicado y con datos de referencia de clientes coincidentes, pasa. Si llega tarde o con un cambio de tipo, el sistema debe marcar la dimensión específica que falló, no solo marcarlo como "malo".
La oportunidad no es una métrica secundaria. En los sistemas en vivo, forma parte de la definición misma de calidad.
Calidad en tiempo real frente a calidad por lotes y dónde se rompe cada una
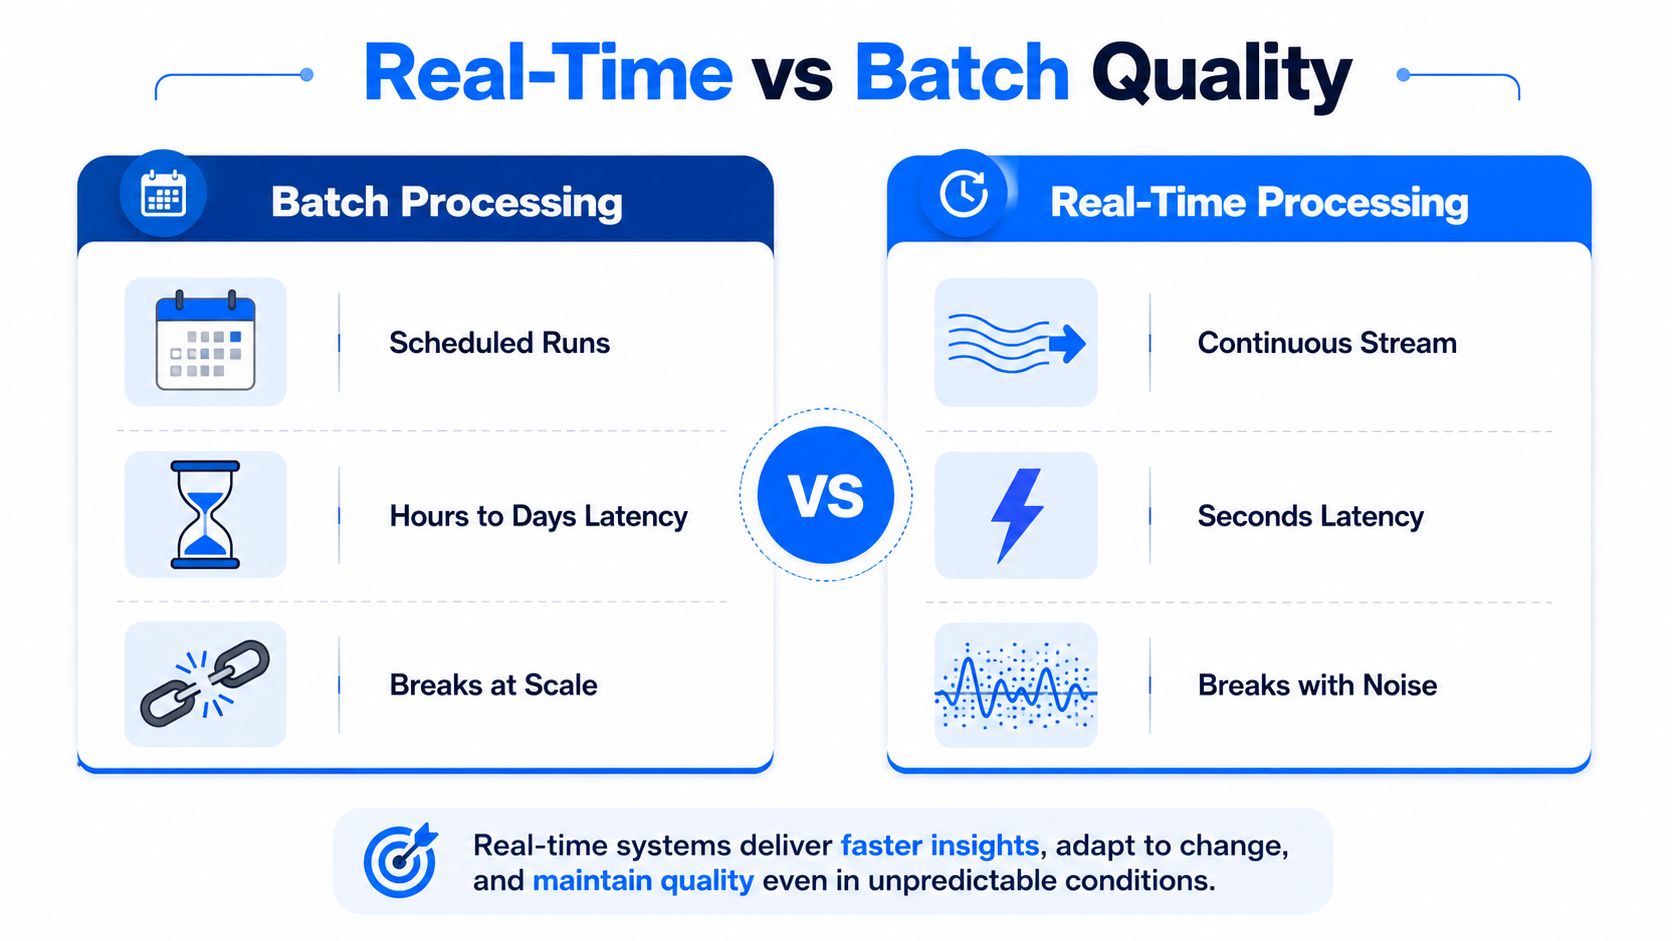
La calidad por lotes y la calidad en tiempo real no son rivales. Son diferentes superficies de control. El lote le brinda amplitud, contexto histórico y un análisis retrospectivo más económico. El tiempo real le brinda la oportunidad de bloquear eventos dañinos antes de que contaminen los paneles de control, los modelos o los flujos de trabajo de los clientes.
La distinción es importante porque el mismo conjunto de datos se comporta de manera diferente bajo cada régimen. Un trabajo nocturno puede capturar filas mal formadas después de la carga, mientras que una comprobación de streaming puede detenerlas en la ingesta. Los micro-lotes programados reducen la brecha, pero aún dejan puntos ciegos entre ejecuciones. El streaming continuo cierra esa brecha al validar mientras los datos aún están en movimiento Confluent streaming architecture guidance.
Dónde sigue perteneciendo el lote
La calidad por lotes sigue ganándose su lugar en los programas que necesitan un perfilado más profundo, una investigación posterior a un incidente o evidencia lista para auditorías. Es útil cuando desea escanear grandes historiales, comparar distribuciones o demostrar que un control se ejecutó en un horario específico. En otras palabras, el lote es bueno para el análisis.
Dónde falla estrepitosamente
Falla cuando al negocio le importa el estado actual del mundo. Los paneles de ingresos, la detección de fraudes, las alertas clínicas y los SLAs operativos dependen de datos que sean lo suficientemente actuales como para actuar sobre ellos. Si un proveedor no realiza una ejecución nocturna, el informe aún puede verse limpio mientras que el almacén de datos ya tiene horas de retraso. Ese es el peor tipo de fallo, porque los números parecen confiables.
El lote dice que el trabajo terminó. El tiempo real dice que los datos siguen siendo aptos para su uso.
La respuesta práctica suele ser mixta. Deje que el lote haga el trabajo retrospectivo profundo, pero mueva las comprobaciones de ingesta, las comprobaciones de oportunidad y la validación crítica para el negocio a la ruta del streaming. De esa manera, el informe nocturno se convierte en una confirmación, no en la primera línea de defensa.
Dentro del flujo de calidad en tiempo real
Un flujo de trabajo de streaming práctico sigue cinco pasos. Primero, ingesta los eventos en una capa de streaming. Luego valida el esquema en el límite, aplica las reglas de negocio a la carga útil y dirige los registros no válidos a la cuarentena en lugar de descartarlos. Después de eso, calcula los KPIs de calidad de manera continua y alerta cuando se superan los umbrales. Un Confluent pipeline flow es una referencia útil para esa secuencia.
Por qué es importante la ubicación de la ejecución
El mayor error que cometen los equipos es mover los datos a un motor de calidad independiente cuando el sistema de origen ya tiene suficiente contexto para evaluarlos. Un estudio de Cambridge sobre sistemas de big data en tiempo real descubrió que la sobrecarga de las comprobaciones de calidad depende de las transferencias entre módulos, la sincronización de mensajes y la complejidad del algoritmo, razón por la cual los saltos adicionales pueden ralentizar todo el flujo de trabajo Cambridge real-time big-data study. En la práctica, eso empuja a los equipos hacia comprobaciones en el flujo (in-stream) y en la base de datos (in-database).
La aplicación del esquema pertenece a la ingesta porque es el lugar más económico para capturar la desviación estructural. Las reglas de negocio pertenecen justo después, mientras el evento aún es accionable. La cuarentena no es un estado de fallo, es un punto de control. Los registros defectuosos deben aislarse, etiquetarse y mantenerse disponibles para su revisión sin permitir que contaminen los sistemas posteriores.
La arquitectura también necesita un lugar compartido para que los ingenieros y analistas vean los incidentes. Una única interfaz de usuario para anomalías, fallos de validación e incumplimientos de oportunidad reduce las transferencias, especialmente cuando los equipos de plataforma y de negocio necesitan mirar el mismo registro en la misma ventana. Eso importa aún más cuando el modelo operativo incluye el real-time data monitoring, porque las personas que vigilan el flujo de trabajo necesitan separar rápidamente el ruido de las roturas reales.
Para los equipos que evalúan herramientas, la lista de verificación práctica es simple: aplicación de esquemas, reglas de streaming, cuarentena y métricas visibles. La configuración correcta es la que mantiene las comprobaciones cerca de los datos, mantiene los fallos observables y mantiene la latencia dentro de la ventana que el negocio puede tolerar.
Cómo encajan la ejecución en base de datos, la detección de anomalías y el seguimiento de esquemas
Los sistemas más eficaces no tratan los módulos de monitoreo como características aisladas. Funcionan como un plano de control. La ejecución en base de datos mantiene los datos en su lugar para que las comprobaciones ocurran dentro del propio entorno del cliente, lo que reduce el movimiento y alinea la capa de calidad con la governance existente. La detección de anomalías añade aprendizaje de línea base para que el sistema pueda marcar desviaciones sin obligar a los ingenieros a escribir a mano cada umbral.
Tres capacidades, tres modos de fallo diferentes
La detección de anomalías es más fuerte cuando el comportamiento cambia pero el esquema se mantiene estable. Aprende la forma normal de un conjunto de datos y marca patrones inusuales, picos o caídas. El seguimiento de esquemas cubre una clase diferente de fallo: columnas añadidas, columnas eliminadas y cambios de tipo de datos que pueden romper a los consumidores posteriores antes de que se ejecute la lógica de negocio.
El monitoreo de la oportunidad cierra la brecha que los otros dos pierden. Un conjunto de datos puede parecer estadísticamente normal y, aun así, llegar tarde, temprano o faltar. Es por eso que los patrones de llegada, los tiempos de entrega esperados y la detección de retrasos pertenecen al mismo cerebro operativo que la detección de anomalías y la validación.
Los buenos sistemas de calidad no piden a un solo módulo que resuelva cada problema. Apilan módulos para que cada uno capture un modo de fallo diferente.
Para una perspectiva práctica sobre la selección de modelos, la guía para choose the right anomaly detection solution es útil cuando está decidiendo si confiar en comprobaciones deterministas, líneas base aprendidas o ambas. Y si está mapeando este enfoque en una pila centrada en el almacén de datos, el marco interno sobre Databricks data quality framework es un punto de referencia de ayuda.
digna encaja en este patrón como una opción en el mercado, porque ejecuta comprobaciones en el propio entorno del cliente, admite la ejecución en la base de datos y combina la detección de anomalías, la oportunidad, la validación y el seguimiento de esquemas en una sola plataforma. Esa combinación importa más que cualquier característica individual.
KPIs que realmente debería seguir
Un programa en tiempo real no necesita un panel de control gigante. Necesita una lista corta de métricas que se mapeen directamente con el riesgo operativo. Comience con la frescura, la latencia, la cantidad de registros desactualizados, el porcentaje de valores fuera de los rangos aceptados, la proporción de registros que fallan las reglas de validación y los errores de sintaxis o formato, como direcciones de correo electrónico no válidas Alation data quality metrics.
La métrica correcta depende del fallo que intente detener. La frescura le indica si la última carga es utilizable. La latencia le indica qué parte del conjunto de datos cumplió con la ventana del SLA. La tasa de fallos de validación le indica si las reglas son demasiado laxas o si los datos de origen cambiaron. Los valores fuera de rango capturan eventos comerciales incorrectos que aún parecen sintácticamente válidos.
KPIs principales de calidad de datos en tiempo real
Dimensión | Métrica | Cómo medir | Umbral de referencia |
|---|---|---|---|
Frescura | Tiempo desde el registro más reciente | Comparar la última hora de escritura con la ventana del SLA | Definido por conjunto de datos crítico |
Latencia | Porcentaje de registros actualizados dentro del SLA | Medir registros que llegan dentro de la ventana esperada | Definido por flujo de trabajo |
Integridad | Campos requeridos faltantes | Contar campos requeridos presentes por registro | Definido por nivel de conjunto de datos |
Validez | Registros fuera del rango aceptado | Validar tipo, formato y rango en la ingesta | Definido por regla de negocio |
Validación | Registros que fallan las reglas | Contar registros rechazados o en cuarentena | Definido por control |
La regla general es vincular cada métrica técnica a una consecuencia comercial. Si una tabla de ingresos no cumple con su SLA de frescura, el problema no es un icono amarillo, es una ventana de informe perdida. Así es como el monitoreo se mantiene útil en lugar de decorativo.
Para mantener el programa fundamentado, defina la métrica, establezca el umbral, automatice la comprobación y realice un seguimiento del resultado a lo largo del tiempo. La página interna sobre data quality metrics es un buen punto de partida para convertir esa disciplina en un patrón operativo repetible.
Desafíos comunes y consideraciones de seguridad
La mayoría de los programas de calidad en tiempo real fallan debido a la gobernanza, no a la lógica de detección. Los umbrales se vuelven demasiado agresivos y se produce fatiga por alertas. La propiedad se vuelve borrosa cuando un incidente afecta al equipo de origen, al equipo de la plataforma y al propietario del negocio al mismo tiempo. Luego alguien compra otra herramienta y la pila se vuelve más difícil de administrar.
La seguridad se decide en la arquitectura, no en el documento de políticas
A los equipos regulados les importa dónde se ejecutan las comprobaciones. Si un proveedor requiere que los datos salgan del entorno del cliente, eso crea una carga de revisión y, a menudo, un bloqueo. Ejecutar comprobaciones en la base de datos, dentro de la nube del cliente, VPC o entorno local, mantiene la capa de calidad bajo los mismos controles de acceso que el propio almacén de datos.
Eso también cambia la economía del monitoreo. Un precio transparente y estable según el uso facilita la expansión de la cobertura sin preocuparse de que cada nueva alerta o escaneo se convierta en un costo sorpresa. Una única interfaz de usuario compartida también ayuda, porque los ingenieros, analistas y equipos de gobernanza pueden revisar la misma anomalía, problema de oportunidad, fallo de validación o cambio de esquema sin tener que pasarse capturas de pantalla.
El principal error es tratar la calidad en tiempo real como una utilidad de nicho. En la práctica, forma parte de la Observability de la plataforma, el monitoreo comercial y la aplicación de controles al mismo tiempo. Los equipos que centralizan esas necesidades suelen pasar menos tiempo conciliando herramientas y más tiempo solucionando el problema de datos real.
Una lista de verificación para un despliegue por fases para comenzar
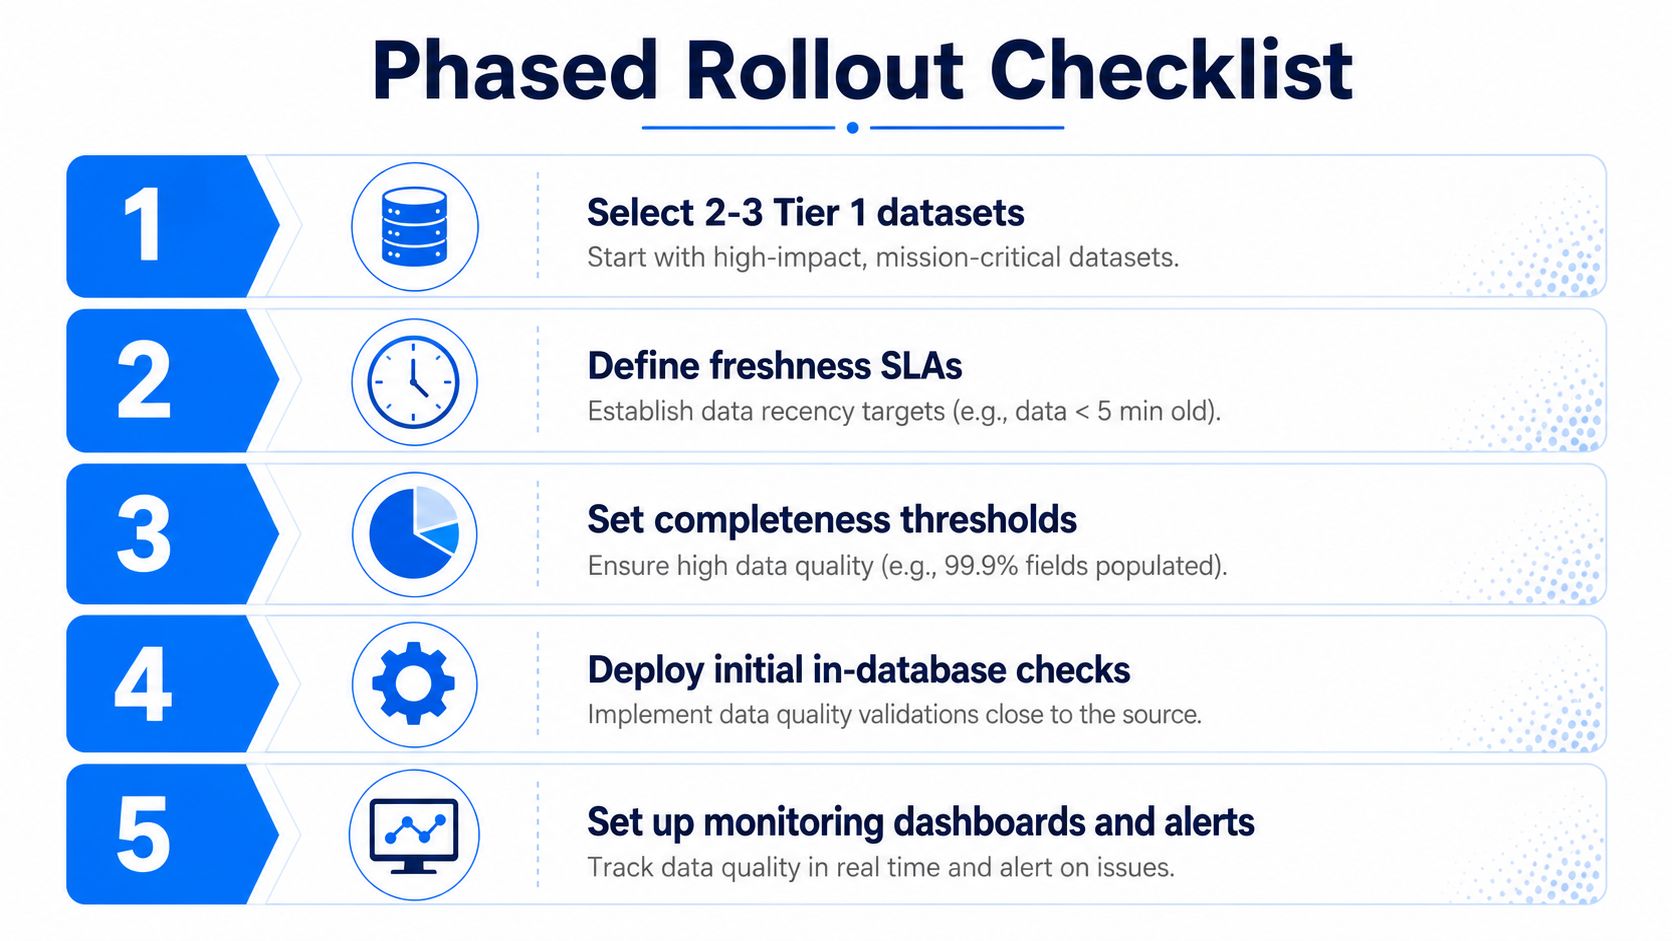
Comience con algo pequeño. Elija dos o tres conjuntos de datos de Nivel 1 donde los datos obsoletos o no válidos creen un riesgo comercial obvio. Defina primero los SLAs de frescura e integridad, luego habilite la ejecución en la base de datos para que las comprobaciones se ejecuten donde ya viven los datos.
Un despliegue que no se colapse bajo su propio peso
Seleccione los conjuntos de datos correctos. Comience con tablas que afecten directamente a los informes, el Compliance o los flujos de trabajo de los clientes.
Defina SLAs de frescura. Haga explícita la antigüedad aceptable de los datos.
Establezca umbrales de integridad. Decida qué significa "utilizable" antes de que se active la primera alerta.
Implemente comprobaciones iniciales en la base de datos. Capture defectos estructurales y basados en reglas sin añadir movimiento adicional.
Active el monitoreo y las alertas. Conecte los incidentes a los canales que su equipo ya utiliza.
El error a evitar es una cobertura amplia antes de haber ajustado la propiedad y los umbrales. Un piloto ruidoso se ignora. Un piloto enfocado enseña al equipo cómo se comportan los controles, que es el objetivo.
Si trabaja en finanzas, atención médica, telecomunicaciones o el sector público, se aplica el mismo patrón, solo que con diferentes controles y obligaciones de informes. El objetivo es hacer que los datos confiables sean el estado predeterminado de la plataforma, no un simulacro de incendio semanal.
Si está construyendo ese modelo operativo y desea una plataforma que mantenga las comprobaciones dentro de su propio entorno, admita la ejecución en la base de datos y unifique la oportunidad, la validación, la detección de anomalías y el seguimiento de esquemas en un solo flujo de trabajo, visite digna. Está diseñada para equipos que necesitan que la calidad de los datos en tiempo real se comporte como una disciplina operativa, no como un trabajo por lotes con un intervalo más corto.


