Vollständigkeit als Dimension der Datenqualität: Ein Leitfaden für 2026
|
8
min. Lesezeit

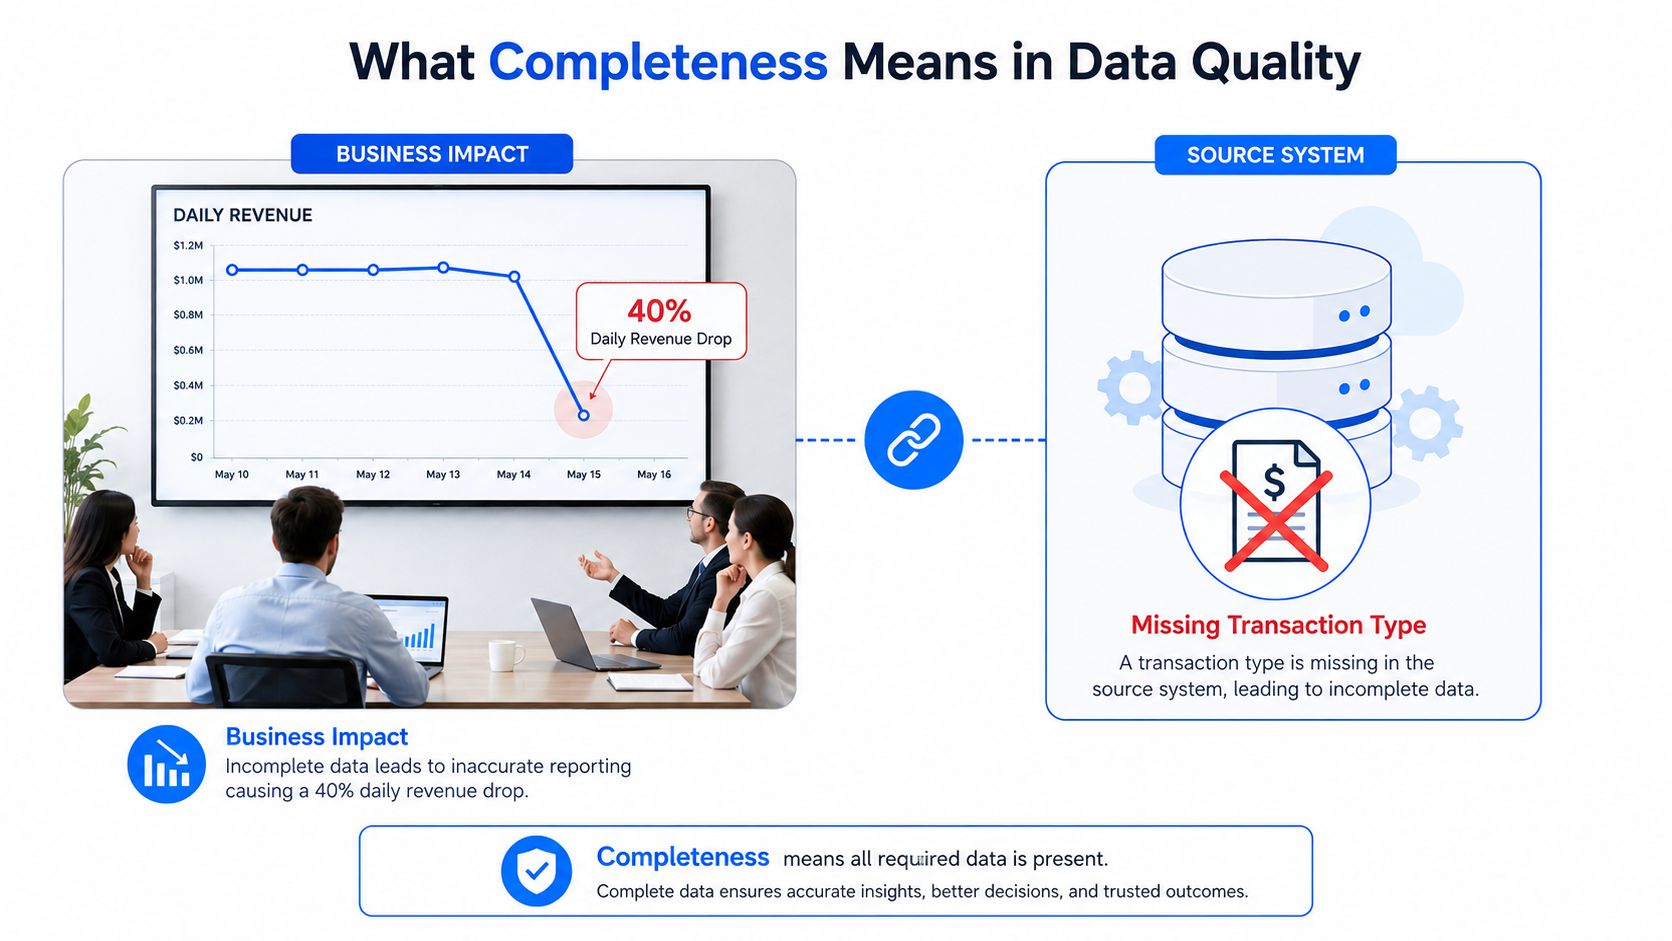
Ihr tägliches Umsatz-Dashboard sieht ganz normal aus, bis an einem Morgen die Gesamtsumme drastisch einbricht. Das Quellsystem ist online, die Pipeline meldet Erfolg und die meisten Spalten sind ausgefüllt. Das Problem ist, dass ein bestimmter Transaktionstyp nie eingetroffen ist oder ein Kunden-Identifikator bei einem Export verschwunden ist. Dies ist genau die Art von Fehler, die durch die Vollständigkeit der Datenqualität aufgedeckt werden soll.
Vollständigkeit in der Datenqualität bedeutet, ob alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. Dazu gehören erforderliche Werte innerhalb von Datensätzen, Datensätze, die existieren sollten, aber fehlen, sowie erwartete Datenmengen über Dateien oder Zeiträume hinweg. Ein Datensatz kann keine offensichtlichen Lücken aufweisen und dennoch unvollständig sein, wenn eine gesamte Gruppe von Kunden, Transaktionen oder Ereignissen ausgeschlossen wurde.
Der praktische Maßstab ist die Eignung für den jeweiligen Zweck. Ein Datensatz kann für eine Analyse vollständig genug sein und für eine andere unvollständig, da jeder Anwendungsfall andere Felder, Datensätze, Abdeckungen und Bereitstellungsmuster erfordert. Die Erklärung der britischen Regierung zu Datenqualitätsdimensionen macht diesen Unterschied direkt deutlich und definiert Vollständigkeit in Bezug auf die für eine bestimmte Nutzung erforderlichen Daten und nicht auf die Befüllung jedes erdenklichen Feldes.
Inhaltsverzeichnis
Was Vollständigkeit in der Datenqualität bedeutet
Angenommen, das Dashboard eines Finanzteams zeigt einen unerwarteten Umsatzrückgang. Ein Analyst überprüft die Transaktionstabelle und stellt fest, dass die meisten Zeilen Kunden-IDs, Daten, Beträge und Zahlungsstati enthalten. Die Tabelle sieht auf den ersten Blick gesund aus. Ein späterer Vergleich zeigt, dass mobile Transaktionen im letzten Import fehlten. Dem Bericht fehlten also gültige Datensätze und nicht nur leere Zellen.
Dieser Unterschied definiert Vollständigkeit als Dimension der Datenqualität. Sie stellt die Frage, ob der Datensatz alles enthält, was zur Unterstützung des angegebenen Zwecks erforderlich ist. Die Frage lautet nicht „Sind alle Spalten gefüllt?“, sondern „Enthalten diese Daten die erforderlichen Werte, Datensätze und die Abdeckung, die für die geplante Entscheidung benötigt werden?“
Warum Nicht-Null-Werte nicht ausreichen
Eine Kundentabelle kann eine niedrige Null-Quote aufweisen, während dennoch alle Kunden fehlen, die über einen bestimmten Kanal erstellt wurden. Eine Transaktionstabelle kann wohlgeformte Zeilen enthalten, während ein ganzer Ereignistyp fehlt. Eine tägliche Datei kann vollständige Datensätze aufweisen, aber nur einen Teil der erwarteten Geschäftsaktivität darstellen.
Vollständigkeit greift daher auf mehr als nur der Zellebene:
Feldvollständigkeit fragt, ob erforderliche Attribute ausgefüllt sind.
Datensatzvollständigkeit fragt, ob jedes erforderliche Objekt oder Ereignis vorhanden ist.
Dateivollständigkeit fragt, ob die erwartete Datei, Partition oder der Import eingetroffen ist.
Grundgesamtheitsvollständigkeit fragt, ob der Datensatz die relevante reale Grundgesamtheit repräsentiert, einschließlich Gruppen, Daten und Transaktionstypen.
Die Geschichte des Konzepts spiegelt diese breitere Sichtweise wider. Die Forschung behandelt Vollständigkeit mindestens seit 1983 als eigenständiges Datenqualitätsmerkmal, als Bailey und Pearson sie zu den Kernattributen der Qualität von Ausgabeinformationen zählten. Spätere Arbeiten fassten Vollständigkeit so zusammen, ob alle relevanten Daten erfasst sind, während moderne Leitlinien sie am Bedarf einer bestimmten Nutzung ausrichten. Eine nützliche Übersicht über Datenabdeckungskonzepte von Wine Labs kann Teams dabei helfen, über gefüllte Spalten hinauszudenken und zu prüfen, ob die beabsichtigte Zielgruppe repräsentiert ist.
Praktische Regel: Definieren Sie, was vorhanden sein muss, bevor Sie berechnen, ob die Daten vollständig sind.
Eine klare Arbeitsdefinition lautet: Vollständigkeit ist das Vorhandensein aller erforderlichen Daten für einen definierten Geschäftszweck, einschließlich erforderlicher Werte, Datensätze, Dateien und Abdeckung der Grundgesamtheit. Teams, die ein umfassenderes Rahmenwerk etablieren, können auch überprüfen, wie Datenqualitätsdimensionen definiert und gemessen werden.
Die drei Ebenen der Vollständigkeit
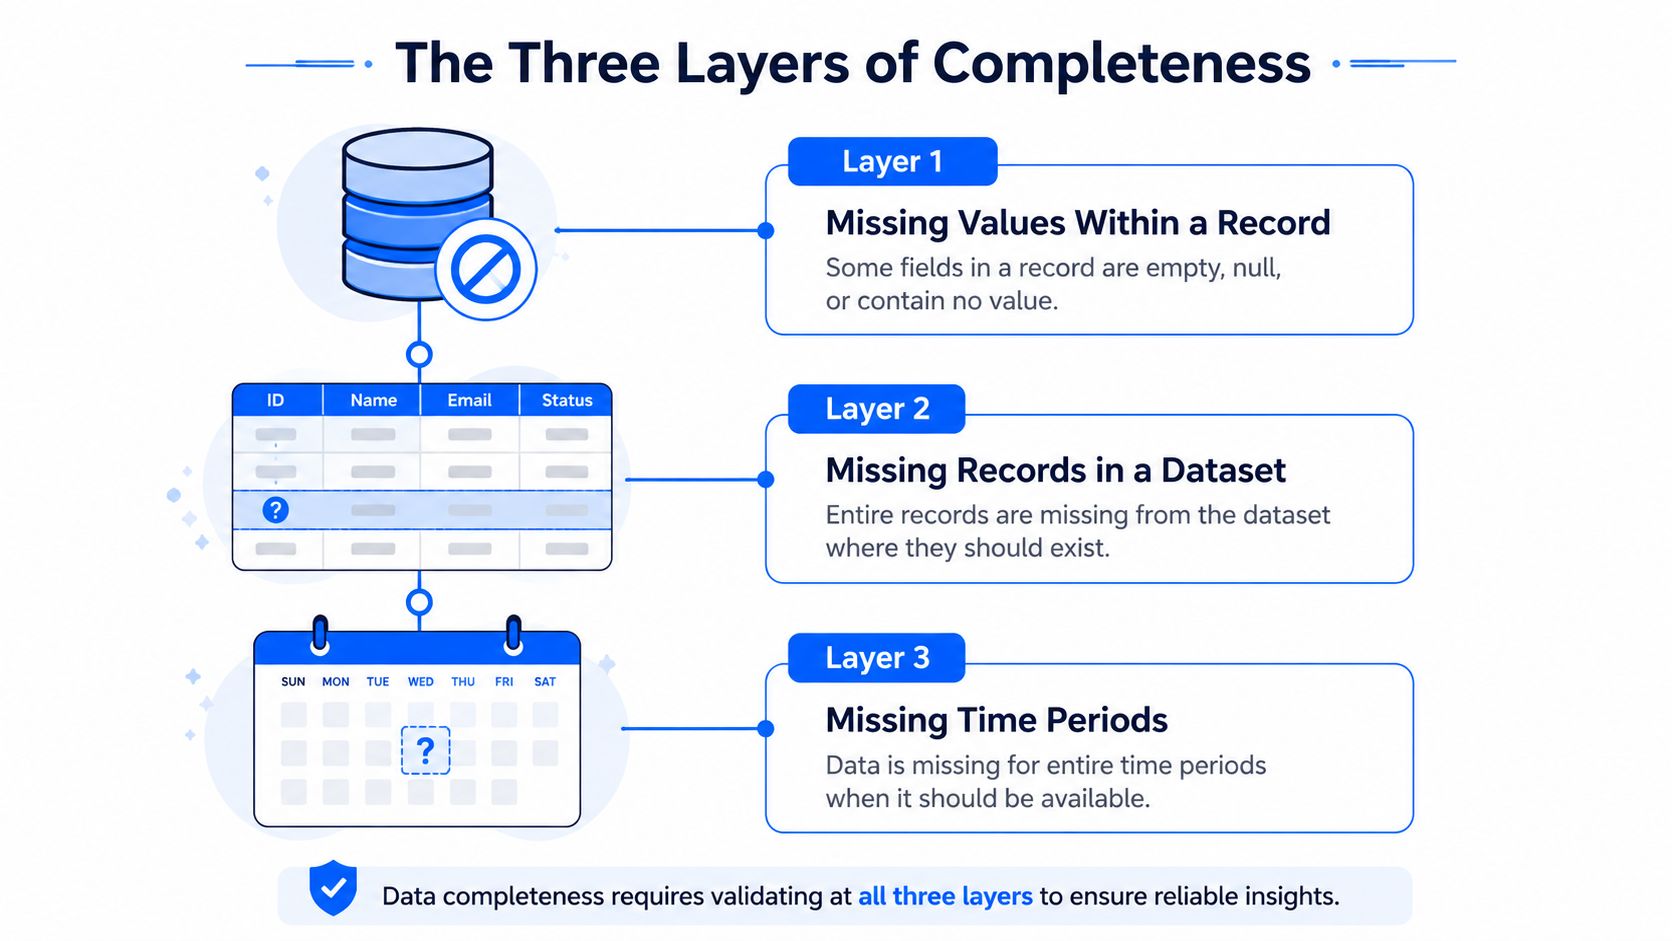
Teams behandeln Vollständigkeit oft als reine Null-Wert-Prüfung. Das erfasst jedoch nur eine Ebene des Problems. Ein zuverlässiges Programm zur Datenvollständigkeit unterscheidet Lücken innerhalb von Datensätzen von fehlenden Datensätzen und fehlender Abdeckung über Zeiträume oder erwartete Mengen hinweg.
Stellen Sie sich eine Bibliothek vor. In einem Buch können Seiten fehlen, ein benötigtes Buch kann im Regal fehlen oder die Bibliothek hat über mehrere Tage hinweg keine Neuzugänge mehr katalogisiert. Jede Situation stellt eine Unvollständigkeit dar, erfordert aber jeweils einen anderen Test.
Ebene eins sind fehlende Werte
Die erste Ebene betrifft Attribute innerhalb eines Datensatzes. Eine Kundenzeile ist zwar vorhanden, aber die Kunden-ID, die Postleitzahl, der Einwilligungsstatus oder der Erstellungszeitstempel sind null, leer oder durch einen Standardwert ersetzt.
Prüfungen auf Pflichtfelder funktionieren hier gut. Das Team identifiziert die für eine Aufgabe benötigten Felder, zählt die Datensätze, in denen diese Felder fehlen, und überwacht das Ergebnis im Zeitverlauf. Eine fehlende Postleitzahl kann regionale Analysen einschränken, während ein fehlender Primärschlüssel Verknüpfungen (Joins) gänzlich verhindern kann.
Nicht jede Lücke ist automatisch ein Fehler. Optionale Profilinformationen sind möglicherweise berechtigterweise nicht verfügbar, während ein Identifikator, der für den Abgleich von Identitäten erforderlich ist, in der Regel nicht optional ist. Die geschäftliche Definition muss vor dem Schwellenwert stehen.
Ebene zwei sind fehlende Datensätze
Die zweite Ebene betrifft ganze Zeilen. Ein erwarteter Kunde, eine Bestellung, eine Zahlung oder ein Ereignis erreicht die Zieltabelle nie. Eine Validierung auf Zeilenebene findet dies nicht, da keine Zeile zum Prüfen vorhanden ist.
Teams können dies durch einen Abgleich mit einer autoritativen Quelle, erwarteten Schlüsselbereichen, Ereignisbeständen, Kontrollsummen oder Vergleichen zwischen Upstream- und Downstream-Systemen erkennen. Wenn beispielsweise ein Auftragsabwicklungssystem eine Bestell-ID erfasst, diese aber in der Warehouse-Tabelle fehlt, ist das Warehouse unvollständig – selbst wenn jede eingetroffene Zeile ihre Feldprüfungen besteht.
Ebene drei sind fehlende Mengen oder Abdeckungen
Die dritte Ebene betrifft die Form des Datensatzes über Zeiträume, Dateien, Partitionen oder Geschäftspopulationen hinweg. Eine tägliche Ereignistabelle kann gültige Zeilen enthalten, aber der Import kann wesentlich kleiner sein als das erwartete Volumen. Eine Partition kann fehlen, eine Quelldatei kann leer sein oder ein neuer Ereignistyp wird nach einer Schemaänderung nicht mehr übertragen.
Diese Ebene verbindet Vollständigkeit mit Aktualität. Eine verspätete Datei ist unvollständig für ein Dashboard, das den neuesten Berichtszeitraum widerspiegeln muss, selbst wenn die Datei schließlich eintrifft. Sie verbindet sich auch mit Schema-Drift. Wenn eine Quelle eine Spalte entfernt oder eine Ereignisstruktur ändert, können nachgelagerte Prozesse die für einen Anwendungsfall erforderlichen Fakten verlieren.
Vollständigkeit vs. Genauigkeit und wie sie sich unterscheiden
Vollständigkeit und Genauigkeit beantworten unterschiedliche Fragen.
Vollständigkeit: Sind die erforderlichen Daten vorhanden?
Genauigkeit: Repräsentieren die Daten das reale Objekt, das Ereignis oder den Wert korrekt?
Ein Datensatz kann vorhanden, aber falsch sein. Er kann auch überall dort korrekt sein, wo er existiert, aber im Datensatz fehlen.
Stellen Sie sich eine Kundentabelle vor, mit der Kunden und Bestellungen verknüpft werden. Jede ausgefüllte E-Mail-Adresse entspricht dem erwarteten Format, und die vorhandenen Kundendaten stimmen mit dem Quellsystem überein. Einige Kunden-IDs sind jedoch null. Die vorhandenen Werte sind zwar genau, aber die Tabelle ist für identitätsbasierte Verknüpfungen unvollständig, da erforderliche Identifikatoren fehlen.
Nun kehren wir das Problem um. Jede Kundenzeile enthält eine Kunden-ID, sodass die Tabelle vollständig erscheint. Einige IDs verweisen jedoch auf die falschen Personen, weil ein vorgelagerter Mapping-Prozess sie fehlerhaft zugewiesen hat. Der Datensatz ist hinsichtlich des Vorhandenseins vollständig, aber hinsichtlich der Bedeutung ungenau.
Dimension | Kernfrage | Typischer Fehler | Nützliche Prüfung |
|---|---|---|---|
Vollständigkeit | Sind alle erforderlichen Daten vorhanden? | Fehlende Kunden-IDs oder ausbleibende Transaktionen | Pflichtfeld-, Abstimmungs- und Volumenprüfungen |
Genauigkeit | Spiegeln die Daten die Realität wider? | Eine ID, die mit dem falschen Kunden verknüpft ist | Vergleich mit einer autoritativen Quelle |
Beide | Sind die erforderlichen Daten vorhanden und korrekt? | Ein fehlendes oder falsch zugewiesenes Konto | Getrennte Kontrollen für Vollständigkeit und Genauigkeit |
Teams verwechseln diese Dimensionen oft, weil eine sichtbare Lücke leicht zu erkennen ist, während ein falscher Wert völlig plausibel aussehen kann. Ein ausgefülltes Feld ist kein Beweis für seine Richtigkeit, und eine genaue Teilmenge ist kein Beweis dafür, dass die gesamte Grundgesamtheit vorhanden ist.
Die operative Reaktion sollte die Kontrollen trennen. Vollständigkeitsprüfungen suchen nach Null-Werten, fehlenden Schlüsseln, ausbleibenden Ereignissen, fehlenden Dateien und unerwarteten Mengen. Genauigkeitsprüfungen vergleichen Werte mit vertrauenswürdigen Referenzen, validieren Identitätsbeziehungen oder testen, ob geschäftliche Fakten mit der Realität übereinstimmen. Eine umfassendere Erklärung zu Data Observability im Vergleich zu Datenqualität hilft, diese Kontrollen in ein größeres Betriebsmodell einzuordnen.
Metriken, Verhältnisse und Prüfungen auf Pflichtfelder
Die Messung beginnt mit einer expliziten Erwartung. Bevor Sie einen Vollständigkeits-Score berechnen, definieren Sie die erforderlichen Felder, die erforderlichen Datensätze, die relevante Grundgesamtheit, den Bereitstellungsplan und die akzeptable Abweichung für den Anwendungsfall.
Die einfachste Metrik auf Feldebene ist die Vollständigkeitsquote:
Vollständigkeitsquote = vorhandene erforderliche Werte ÷ erwartete erforderliche Werte
Wenn eine Tabelle Datensätze enthält, für die eine Kunden-ID erforderlich ist, zählen Sie die ausgefüllten IDs und teilen Sie diese Zahl durch die Anzahl der Datensätze, die diese ID enthalten sollten. Das Ergebnis kann als Verhältnis oder Prozentsatz ausgedrückt werden. Dieselbe Logik gilt für erwartete Datensätze, Dateien, Partitionen oder Ereignisse.
Ein ergänzendes Maß ist die Null-Quote:
Null-Quote = fehlende Werte ÷ erwartete Werte
Eine Null-Quote, die für ein optionales Marketing-Attribut tolerierbar sein mag, kann für einen Primärschlüssel inakzeptabel sein. Schwellenwerte müssen die geschäftlichen Konsequenzen widerspiegeln, nicht ein universelles Ziel. Eine fehlende E-Mail-Adresse kann die Reichweite einer Kampagne verringern, während ein fehlender Konto-Identifikator den Abgleich, die Lineage und nachgelagerte Verknüpfungen verhindern kann.
Auswahl fester und adaptiver Schwellenwerte
Verwenden Sie einen festen Schwellenwert, wenn die Regel im Data Contract verankert ist. Ein Primärschlüssel muss für jeden akzeptierten Datensatz vorhanden sein, und ein fehlender Wert sollte unabhängig vom historischen Verhalten zu einem Fehler führen.
Verwenden Sie einen adaptiven Schwellenwert, wenn der erwartete Wert je nach Zeitplan, Saison, Tag, Quellverhalten oder Geschäftsaktivität variiert. Historische Baselines können einen ungewöhnlichen Rückgang der täglichen Datensätze identifizieren, ohne dass Ingenieure für jeden Zeitraum einen separaten Wert pflegen müssen.
Ein praktisches Überwachungsdesign kombiniert beide Ansätze:
Pflichtfeldprüfungen identifizieren fehlende Werte in kritischen Spalten.
Datensatzabgleiche identifizieren erwartete Objekte oder Ereignisse, die nie eingetroffen sind.
Volumenprüfungen vergleichen beobachtete Mengen mit erwarteten Bereichen.
Verteilungsprüfungen identifizieren Änderungen, die auf eine unvollständige Grundgesamtheit oder eine weggefallene Kategorie hinweisen können.
Trendüberwachung zeigt, ob ein Vollständigkeitsproblem stabil bleibt, sich verbessert oder verschlechtert.
Die folgende Tabelle ordnet gängige Kontrollen den Implementierungsfunktionen zu.
Dimension | Metrik | Beispielprüfung | digna Funktion |
|---|---|---|---|
Feldvollständigkeit | Null-Quote nach Pflichtfeld | Kunden-ID ist für jeden erforderlichen Kundendatensatz vorhanden | Data Validation |
Datensatzvollständigkeit | Anzahl fehlender Schlüssel | Bestell-IDs in der Quelle fehlen im Warehouse | Data Validation |
Dateivollständigkeit | Eingangs- oder Ladestatus | Die geplante Transaktionspartition fehlt | Data Anomalies |
Volumenvollständigkeit | Beobachtete versus erwartete Datensatzanzahl | Das tägliche Ereignisvolumen ist unerwartet niedrig | Data Anomalies |
Verteilungsvollständigkeit | Kategorie- oder Ereignisabdeckung | Ein Transaktionstyp verschwindet aus dem neuesten Import | Data Anomalies |
Trendvollständigkeit | Vollständigkeitsquote im Zeitverlauf | Die Pflichtfeldabdeckung nimmt bei aufeinanderfolgenden Importen ab | Data Analytics |
Teams können dieses Modell durch Datenqualitätsmetriken und Messpraktiken erweitern. Der wichtige Punkt ist, auf der Ebene zu messen, auf der der Fehler auftritt. Da ein einzelner Gesamtwert eine fehlende Grundgesamtheit verschleiern kann, sollten Feld-, Datensatz-, Datei- und Volumenmetriken separat ausgewiesen werden.
Praxisbeispiele für unvollständige Unternehmensdaten
Vollständigkeitsfehler äußern sich meist zuerst als geschäftliches Symptom. Ein Modell verliert an Vorhersagekraft, ein Gesamtumsatz erscheint zu niedrig oder ein Betriebs-Dashboard meldet einen unplausiblen Rückgang. Die technische Ursache liegt oft weiter oben in der Pipeline.
Ein CRM-Export verliert Kunden-Identifikatoren
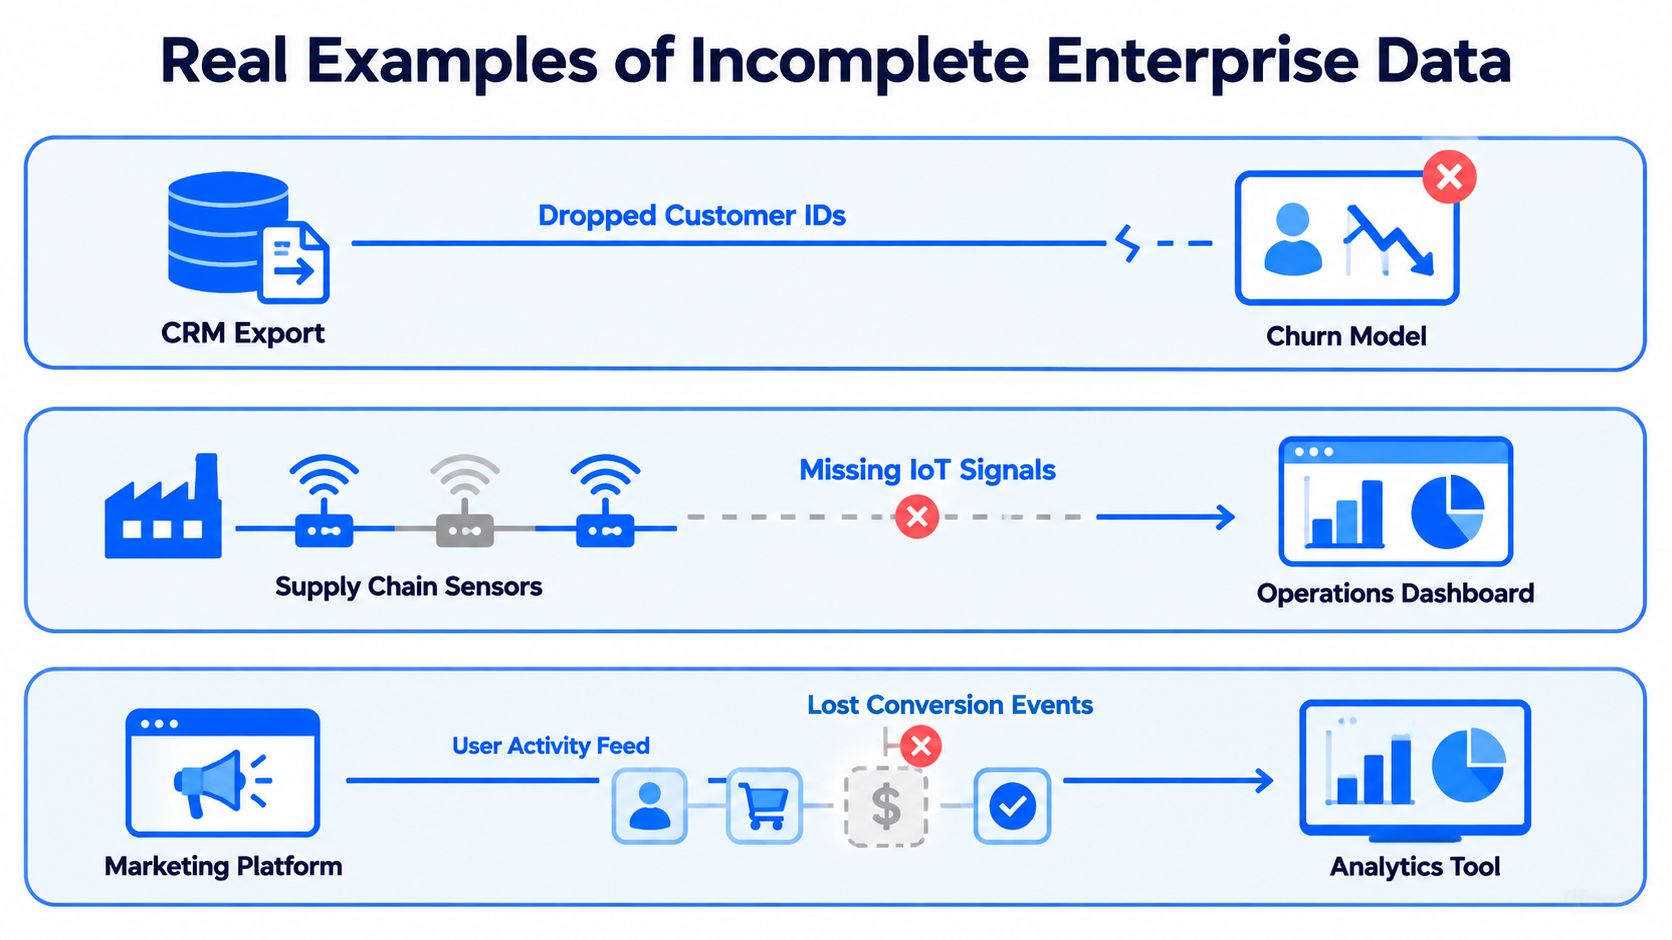
Ein CRM-Export enthält neue mobile Registrierungen, aber das Feld für die Kunden-ID ist für diese Gruppe leer. Die Zeilen sind vorhanden, und Namen sowie E-Mail-Adressen sehen gültig aus, aber der Prozess zum Abgleich der Identitäten kann diese Kunden nicht zuverlässig mit Bestellungen, dem Support-Verlauf oder früheren Aktivitäten verknüpfen.
Das Unternehmen bemerkt einen Einbruch bei der Churn-Analyse oder einen ungeklärten Anstieg nicht identifizierter Kunden. Eine Pflichtfeldregel für die Kunden-ID würde den Fehler auf Datensatzebene abfangen. Ein Vergleich der Grundgesamtheit nach Akquisitionskanal würde zeigen, dass das Problem eine bestimmte Gruppe und nicht den gesamten Export betrifft.
Ein Zahlungs-Feed lässt Transaktionen unvollendet
Ein Zahlungsabwickler sendet weiterhin Transaktionszeilen, einige Zahlungen bleiben jedoch unbegrenzt als „ausstehend“ markiert. Die Tabelle erscheint gefüllt, aber der Monatsabschluss kann diese Transaktionen nicht als abgerechnet behandeln oder in das erwartete Finanzergebnis einbeziehen.
Die Vollständigkeitslücke ist nicht nur ein Null-Wert. Der erforderliche Transaktionslebenszyklus ist für den Berichtszweck unvollständig. Kontrollen sollten die erwarteten Transaktionszustände und Abstimmsummen vergleichen, während die Aktualitätsüberwachung Datensätze identifizieren sollte, die sich nicht innerhalb des definierten operativen Zeitfensters weiterentwickeln.
Ein partitionierter Ereignis-Load schreibt deutlich weniger Zeilen
Ein täglicher Batch erzeugt normalerweise eine große Ereignistabelle. Eines Tages schlägt ein partitionierter Import fehl, und nur eine kleine Teilmenge der Zeilen erreicht das Warehouse. Die verbliebenen Zeilen bestehen die Schema- und Pflichtfeldprüfungen, sodass ein Test auf Zeilenebene allein Erfolg meldet.
Das erste sichtbare Symptom kann ein Dashboard mit geringer Aktivität oder ein fehlendes Segment in einem Analysemodell sein. Eine zeitplangesteuerte Volumenprüfung würde die beobachtete Anzahl mit dem historischen Verhalten vergleichen und den Import zur Untersuchung markieren. Die Verteilungsüberwachung könnte dann zeigen, welche Quelle, welches Datum oder welcher Ereignistyp verschwunden ist.
Diese Beispiele zeigen eine gemeinsame Lektion: Unvollständige Daten sehen in den eingetroffenen Zeilen nicht immer fehlerhaft aus. Die Überwachung muss prüfen, was hätte eintreffen sollen, und nicht nur, was derzeit gespeichert ist.
Wie digna die Datenvollständigkeit unterstützt
Ein Programm zur Gewährleistung der Vollständigkeit benötigt sowohl deterministische Regeln als auch Verhaltensüberwachung. Die richtige Wahl hängt davon ab, ob die Erwartung explizit ist, wie z. B. „Kunden-ID ist erforderlich“, oder ob sie aus wiederkehrendem Datenverhalten gelernt wird, wie z. B. eine ungewöhnliche Änderung des täglichen Volumens.
digna Data Validation
digna Data Validation wendet Prüfungen auf Datensatzebene gegen Geschäftsregeln an. Ein Team kann Pflichtfeldkontrollen für Kunden-IDs, Transaktionsdaten, Kontoschlüssel oder andere Attribute definieren, die für einen bestimmten Workflow benötigt werden. Das Modul kann auch gezielte Prüfungen auf leere Werte und Geschäftsbedingungen unterstützen, die bestimmen, ob ein Datensatz verwendbar ist.
Dies ist die klarste Kontrolle für die erste Ebene der Vollständigkeit, nämlich fehlende Werte innerhalb von Datensätzen. Sie kann auch eine Vollständigkeitslogik auf Datensatzebene unterstützen, bei der eine Zeile eine definierte Kombination von Werten enthalten muss, bevor sie für die nachgelagerte Verwendung akzeptiert wird.
digna Data Anomalies
digna Data Anomalies überwacht unerwartete Änderungen bei Datensatzanzahlen, Null-Quoten und Verteilungen. Der auf dem Lernen von Baselines basierende Ansatz eignet sich für Daten, die naturgemäß variieren, wo ein einzelner fester Grenzwert unnötige Warnmeldungen erzeugen würde.
Dies hilft, fehlende Datensätze und fehlende Mengen zu erkennen. Eine unerwartete Verringerung der täglichen Zeilen, das Verschwinden einer Transaktionskategorie oder ein plötzlicher Anstieg von Null-Werten können als möglicher Teilimport, Quellenunterbrechung oder Pipeline-Änderung untersucht werden. Das Modul hilft auch dabei, Muster aufzudecken, die von manuell geschriebenen Regeln nicht abgedeckt wurden.
digna Data Analytics
digna Data Analytics bietet eine historische Analyse von Vollständigkeitsmetriken. Eine aktuelle Null-Quote hat ohne Kontext nur eine begrenzte Aussagekraft. Historische Ansichten helfen Teams, eine stabile Eigenschaft von einer kürzlichen Verschlechterung zu unterscheiden und zu erkennen, ob ein wiederkehrendes Ladeproblem häufiger auftritt.
Die Module lassen sich den drei Ebenen zuordnen:
Fehlende Werte: Data Validation prüft Pflichtfelder und Datensatzbedingungen.
Fehlende Datensätze: Validierungs- und Anomalieüberwachung vergleichen die erwartete mit der beobachteten Abdeckung.
Fehlende Mengen oder Zeiträume: Data Anomalies überwacht Mengen, Verteilungen und das Ladeverhalten, während Data Analytics den Trend aufzeigt.
digna führt die Berechnung und Analyse der Metriken in der Datenbankumgebung des Kunden durch, sodass die Daten vor Ort verbleiben. Die Bereitstellung kann in einer Private Cloud, VPC oder einem Rechenzentrum erfolgen. Dies unterstützt Teams, die eine Vollständigkeitsüberwachung benötigen, ohne Produktionsdaten an einen externen Dienst übertragen zu müssen.
Das praktische Design ist modular aufgebaut. Ein Team kann mit expliziten Pflichtfeldregeln beginnen, eine Anomalieerkennung für unerwartete Änderungen hinzufügen und historische Analysen nutzen, um Schwellenwerte und Behebungsmaßnahmen zu steuern. Schema-Tracking und Aktualitätskontrollen können dieses Setup ergänzen, wenn entfernte Spalten oder verspätet eintreffende Daten indirekt zu Vollständigkeitsfehlern führen.
Überwachungstakt, Governance und häufige Fragen
Die Vollständigkeitsüberwachung funktioniert am besten, wenn jede Kontrolle an dem Punkt ausgeführt wird, an dem ihr Ausfall eine Rolle spielt. Pflichtfeldprüfungen sollten bei jedem relevanten Import durchgeführt werden. Volumenprüfungen sollten sich nach dem Bereitstellungszeitplan des Datensatzes richten. Die Anomalieerkennung sollte das Verhalten kontinuierlich oder bei jedem Eintreffen neuer Daten bewerten.
Weisen Sie Verantwortlichkeiten zu, bevor Warnmeldungen ausgegeben werden. Dateningenieure können fehlerhafte Importe untersuchen, Data Stewards können definieren, welche Felder und Grundgesamtheiten erforderlich sind, und Geschäftsinhaber können entscheiden, ob eine Lücke einen Bericht blockiert oder eine Warnung erfordert. Nutzen Sie Schweregrade und Routing-Regeln, damit Teams nicht bei jeder harmlosen Abweichung alarmiert werden.
Häufig gestellte Fragen
Was ist Vollständigkeit in der Datenqualität?
Vollständigkeit gibt an, ob alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. Dazu gehören erforderliche Werte, erwartete Datensätze, relevante Dateien, Zeiträume und die Abdeckung der Grundgesamtheit.
Wie wird die Datenvollständigkeit gemessen?
Messen Sie die vorhandenen erforderlichen Werte im Vergleich zu den erwarteten erforderlichen Werten, berechnen Sie die Null-Quoten pro Feld, gleichen Sie Quell- und Zieldatensätze ab und vergleichen Sie die beobachteten Mengen mit den erwarteten Bereichen. Verwenden Sie separate Metriken für Felder, Datensätze, Dateien und Grundgesamtheiten.
Was sind nützliche Metriken für die Vollständigkeit?
Zu den nützlichen Metriken gehören die Null-Quote von Pflichtfeldern, die Vollständigkeitsquote, die Anzahl fehlender Schlüssel, der Abgleich von Quelle und Ziel, der Dateieingangsstatus, die Abweichung des Datensatzvolumens sowie die Kategorie- oder Ereignisabdeckung.
Was ist ein guter Schwellenwert für die Vollständigkeit?
Es gibt keinen universellen Schwellenwert. Legen Sie den Grenzwert basierend auf der Rolle des Feldes, der beabsichtigten Verwendung und den Folgen fehlender Daten fest. Ein Primärschlüssel erfordert im Allgemeinen eine strengere Behandlung als ein optionales beschreibendes Attribut.
Wie überwacht man die Vollständigkeit kontinuierlich ohne Alarmmüdigkeit?
Kombinieren Sie feste Regeln für wesentliche Anforderungen mit adaptiven Baselines für schwankende Mengen. Gruppieren Sie zusammenhängende Warnmeldungen, weisen Sie Verantwortliche zu, dokumentieren Sie erwartete Ausnahmen und überprüfen Sie historische Trends, bevor Sie Schwellenwerte verschärfen.
Wie unterscheidet sich Vollständigkeit von Genauigkeit?
Vollständigkeit fragt, ob die erforderlichen Daten vorhanden sind. Genauigkeit fragt, ob die Daten die Realität widerspiegeln. Ein Datensatz kann vollständig, aber falsch sein, oder überall dort, wo er ausgefüllt ist, genau sein, während wichtige Datensätze fehlen.
Eine kurze visuelle Einführung kann Teams dabei helfen, diese Praktiken mit der täglichen Überwachung zu verknüpfen:
Erstellen Sie zunächst eine Liste der Daten, die Ihr wichtigster Bericht, Ihr Modell oder Ihr operativer Prozess benötigt. Fügen Sie dann Feldprüfungen, Datensatzabgleiche, Volumenüberwachung und historische Überprüfungen im passenden Rhythmus hinzu, anstatt sich auf einen einzigen Vollständigkeits-Score zu verlassen.
digna bietet Data Validation, Data Anomalies und Data Analytics, um Teams dabei zu unterstützen, Pflichtfeldregeln durchzusetzen, unerwartete Änderungen bei Anzahlen und Null-Quoten zu erkennen und Trends bei der Vollständigkeit im Zeitverlauf in ihrer eigenen Umgebung zu überwachen. Besuchen Sie digna, um einen modularen Ansatz für Datenqualität und Observability zu entdecken.