Die 10 besten Datenqualitätstools für 2026: Ein Expertenleitfaden
|
7
min. Lesezeit

Ein Vorstands-Paket ist für 8:00 Uhr morgens fällig. Um 7:15 Uhr verschiebt sich das Umsatz-Dashboard. Ein Pipeline-Job zeigt immer noch grün, aber eine vorgelagerte Schema-Änderung hat ein Feld gelöscht, auf das die Finanzabteilung angewiesen ist. Bis jemand das Problem zurückverfolgt, haben die Führungskräfte bereits widersprüchliche Zahlen in ihren Posteingängen.
Dieses Muster ist üblich. Ein KI-Modell driftet nach einer unbemerkten Quelländerung ab. Ein Kundenberichts-Tool zieht doppelte Konten. Analysten vertrauen dem Warehouse nicht mehr und beginnen, Ergebnisse manuell zu validieren. Dies sind keine isolierten Berichtsfehler. Es sind betriebliche Ausfälle, die durch Daten verursacht werden, die zu spät eintrafen, unbemerkt kaputtgingen oder nicht mehr zur nachgelagerten Geschäftslogik passten.
Daten-Ausfallzeiten sind teuer, weil sie sich schneller durch Systeme verbreiten, als Teams sie manuell überprüfen können. Die Planungs-Insights von Precisely für 2025, wie sie in Alations Überprüfung der Ergebnisse zusammengefasst sind, zeigen, wie hoch die Datenqualität unter den Datenintegritäts-Bedenken für Organisationen eingestuft wird, die das kommende Jahr planen.
Der Tool-Markt hat reagiert, aber Feature-Listen allein helfen bei der Bewertung nicht viel. Die Passgenauigkeit ist die wichtigste Überlegung. Einige Plattformen sind am stärksten bei Wallet-nativem Monitoring und In-Database-Checks. Andere eignen sich besser für Enterprise-Governance, MDM-lastige Umgebungen oder eine breite Observability über Pipelines, BI und Machine-Learning-Systeme hinweg. Kompromisse zeigen sich schnell bei der Implementierung. Alarmqualität, Lineage-Tiefe, Regelpflege, Datenschutzbeschränkungen und wie viele Metadaten ein Anbieter aufnehmen muss, spielen alle eine größere Rolle als eine polierte Demo.
Die besten Tools für Datenqualität sind heute näher am Produktionsbetrieb angesiedelt als die traditionelle, nachträgliche Qualitätsprüfung. Sie überwachen Aktualität, Schema, Volumen, Verteilungen, Lineage und Geschäftsregeln früh genug, damit Teams handeln können, bevor ein Vorstandsmitglied, ein Analyst oder ein Kunde das Problem zuerst findet.
Dieser Leitfaden wurde für diesen Entscheidungsprozess erstellt. Er geht über Anbieter-Zusammenfassungen hinaus und bietet Ihnen einen praktischen Bewertungsrahmen, eine Vergleichsmatrix, anwendungsspezifische Empfehlungen wie Privacy-First- versus Startup-freundliche Optionen sowie eine Integrations-Checkliste, die Sie mit Engineering-, Analytics- und Governance-Stakeholdern verwenden können. Für einen breiteren Überblick über die Entwicklung von Plattformen siehe diesen Vergleich von Plattformen für Automatisierungs- und Datenqualitätstools.
Inhaltsverzeichnis
1. digna
Warum digna herausragt
Wo es am besten passt
2. Monte Carlo
Was Monte Carlo gut macht
3. Anomalo
Wo Anomalo seinen Platz verdient
4. Soda
Warum Soda in technisch geführten Stacks gut funktioniert
5. Metaplane
6. Acceldata
Wo Acceldata sinnvoll ist
7. IBM Data Observability by Databand
Wo Databand hineinpasst
8. Ataccama ONE
Warum Ataccama anders ist
9. Informatica Data Quality
Wann Informatica die richtige Wahl ist
10. Qlik Talend Data Quality
Wo Qlik Talend am besten hinpasst
Top 10 Datenqualitäts-Tools, Feature-Vergleich
Die richtige Wahl treffen – von der Bewertung zur Aktion
1. digna

digna ist eines der wenigen Tools in dieser Kategorie, das eine Privacy-First-Architektur ernst nimmt, ohne auf moderne Observability zu verzichten. Es kombiniert Anomalieerkennung, Aktualitätsüberwachung, Schemanachverfolgung, Validierung auf Datensatzebene und historische Metrik-Analysen in einer Plattform, während es innerhalb der Kundenumgebung ausgeführt wird, anstatt auf eine breite Datenbewegung in einen vom Anbieter kontrollierten SaaS-Stack angewiesen zu sein.
Das ist wichtiger, als die meisten Vergleichsseiten zugeben. Eine der größten Lücken im Markt ist die Unterstützung für die In-Database-Ausführung in regulierten Umgebungen, insbesondere dort, wo Teams Observability und Qualitätskontrollen benötigen, ohne Produktionsdaten einem externen Anbieter offenzulegen, wie von lakeFS bezüglich der Sicherheitslücke bei Datenqualitäts-Tools hervorgehoben wird. Wenn Sie im Finanzwesen, im Gesundheitswesen, in der Telekommunikation oder im öffentlichen Sektor arbeiten, ist dies kein Nice-to-have. Es entscheidet oft darüber, ob ein Tool überhaupt einsetzbar ist.
Warum digna herausragt
Der stärkste Teil des Designs von digna ist, dass es keine falsche Wahl zwischen Observability und klassischer Datenqualität erzwingt. Viele Teams basteln am Ende ein Produkt für die Anomalieerkennung, ein anderes für Regeln und ein drittes für das Berichtswesen zusammen. digna hält diese Workflows in einer einzigen Benutzeroberfläche, was Reibungsverluste bei der Übergabe verringert, wenn eine Metrik schlecht läuft und jemand schnell drei Fragen beantworten muss: Was hat sich geändert, wann hat es angefangen und welche Datensätze sind betroffen.
Seine In-Database-Metrikberechnung und das Erlernen von Baselines lassen sich zudem effektiver mit Enterprise-Datenplattformen vereinbaren als reine SaaS-Ansätze. Ihre Daten bleiben vor Ort. Sie reduzieren Datenbewegungen. Sie können Private-Cloud- oder On-Premise-Bereitstellungen unterstützen. Für Teams, die strengen Datenresidenz- oder Compliance-Vorgaben unterliegen, ist diese architektonische Entscheidung oft wichtiger als glänzende KI-Versprechen.
Ein detaillierter Anbietervergleich ist im digna-eigenen Leitfaden für Automatisierungs-Datenqualitäts-Tools und -Plattformen im Jahr 2026 verfügbar.
Praktische Regel: Wenn die Sicherheitsüberprüfung voraussichtlich Ihren Kaufzyklus dominiert, spart die frühzeitige Auswahl von In-Database-Plattformen Monate an verschwendeter Bewertungszeit.
Where it fits best
digna eignet sich hervorragend für Teams, die eine betriebliche Ebene für stille Fehler wie verspätete Ladevorgänge, Schema-Drift, volatile Metriken und Verstöße gegen Geschäftsregeln auf Datensatzebene benötigen. Es eignet sich auch hervorragend, wenn das Datenplattform-Team benutzerfreundliche Dashboards für Ingenieure und geschäftliche Stakeholder gleichermaßen wünscht, anstatt einer weiteren Spezialisten-Konsole.
Vor- und Nachteile sehen in der Praxis wie folgt aus:
Bestens geeignet für private Umgebungen: Es läuft in einer vom Kunden kontrollierten Infrastruktur, was Teams hilft, die keinen Datenzugriff durch Anbieter akzeptieren können.
Breite funktionale Abdeckung: Aktualität, Validierung, Anomalieerkennung, Schema-Tracking und Analytics wohnen in einem Produkt.
Gut für regulierte Betriebe: Es eignet sich für Organisationen, die starke Datenschutzkontrollen benötigen, ohne an Observability-Tiefe zu verlieren.
Keine öffentliche Preisgestaltung: Sie benötigen ein Verkaufsgespräch, um die Pakete zu verstehen.
Weniger ideal für reine SaaS-Käufer: Teams, die ein rein öffentliches, vollständig verwaltetes Tool wünschen, bevorzugen möglicherweise ein anderes Modell.
2. Monte Carlo
Monte Carlo ist nach wie vor einer der bekanntesten Namen im Bereich der Data Observability, und das aus gutem Grund. Es ist für Teams konzipiert, die eine breite, automatisierte Überwachung über Warehouses, ETL, BI und zunehmend KI-Workflows hinweg wünschen, wobei Lineage und Vorfalls-Triage im Mittelpunkt des Produkt-Erlebnisses stehen.
Seine größte Stärke ist die betriebliche Breite. Monte Carlo funktioniert gut, wenn das Problem nicht eine einzelne fehlerhafte Tabelle ist, sondern ein komplexes Geflecht aus Pipelines, Dashboards und nachgelagerten Abhängigkeiten, bei denen die Analyse des Explosionsradius genauso wichtig ist wie die anfängliche Erkennung.
What Monte Carlo does well
Monte Carlo ist meist in größeren Datenorganisationen am besten aufgehoben, die bereits über genügend Komplexität verfügen, um zentralisierte Incident-Workflows zu rechtfertigen. Aktualitäts-, Schema-, Volumen- und Verteilungsmonitore gehören mittlerweile zum Standard, aber der praktische Wert von Monte Carlo liegt im lineage-gestützten Debugging und der koordinierten Reaktion über Teams hinweg.
Der Kompromiss ist das Gewicht. Kleinere Teams empfinden Enterprise-Pakete, Implementierungskoordination und verkaufsorientierte Beschaffung oft schwergängiger, als ihnen lieb ist. Wenn Sie nur leichtgewichtige Überprüfungen für einen kleinen Teil Ihres Warehouses benötigen, kann sich Monte Carlo anfühlen, als würden Sie eine Kommandozentrale kaufen, obwohl Sie eigentlich nur einen Rauchmelder bräuchten.
Nutzen Sie Monte Carlo, wenn die Kosten, die durch Unkenntnis der nachgelagerten Auswirkungen entstehen, höher sind als die Betriebskosten einer Enterprise-Plattform.
Einige praktische Erwägungen:
Starke Eignung für das Incident-Management im Unternehmen: Es hilft Teams, Überwachung und Eskalation zu standardisieren.
Lineage ist ein echtes Unterscheidungsmerkmal: Sie verbessert die Ursachenanalyse, wenn Dashboards und Modelle von vielen vorgelagerten Assets abhängen.
Weniger geeignet für schlanke Teams: Startups und kompakte Analytics-Teams empfinden den Umfang möglicherweise als zu breit.
Erwarten Sie einen formellen Verkaufszyklus: Die Preisgestaltung ist nicht öffentlich.
3. Anomalo
Anomalo basiert auf einem einfachen Versprechen, das überlastete Datenteams anspricht: fehlerhafte Daten erkennen, ohne dass Mitarbeiter endlos Regeln von Hand erstellen müssen. Aus diesem Grund sticht es in Umgebungen hervor, in denen die Anzahl der Tabellen hoch ist, ständige Veränderungen stattfinden und die Zeit der Ingenieure ohnehin bereits anderweitig verplant ist.
Dies ist die Kategorie von Tools, die ich in die engere Wahl ziehen würde, wenn ein Team sagt: „Wir wissen, dass wir eine bessere Überwachung brauchen, aber wir haben einfach nicht die Kapazität, Schwellenwerte für alles zu definieren.“
Where Anomalo earns its place
Anomalo setzt auf unüberwachtes Monitoring, automatisierte Ursachenanalyse und Integrationen mit modernen Komponenten des Data Stacks. In der Praxis bedeutet dies, dass es den Pflegeaufwand verringern kann, der mit regelintensiven Programmen einhergeht, insbesondere wenn sich Datensätze schneller entwickeln als Dokumentation oder governance.
Dennoch ist selbstständig lernendes Monitoring kein Hexenwerk. Teams benötigen weiterhin klare Zuständigkeiten, Disziplin bei der Triage und Klarheit darüber, welche Anomalien für das Geschäft von Bedeutung sind. Ein Tool kann Probleme aufzeigen. Es kann nicht entscheiden, ob ein verspätet eintreffender Einzelhandels-Feed in einer Quartalsabschlusswoche dringend, akzeptabel oder ganz normal ist. Sie benötigen weiterhin den betrieblichen Kontext.
Was bei Anomalo gut funktioniert:
Geringer Aufwand bei der Regelerstellung: Nützlich, wenn Teams die Prüfungen nicht Tabelle für Tabelle pflegen wollen.
Enterprise-freundliche Integrationen: Es ist auf größere moderne Data Stacks ausgerichtet.
Gute Eignung für sich schnell ändernde Daten: Die automatisierte Erkennung hilft dort, wo statische Schwellenwerte versagen.
Preisgestaltung erfordert Kontaktaufnahme mit dem Anbieter: Budgetklarheit ergibt sich erst im Laufe des Prozesses.
Nicht die leichteste Option: Kleine Teams bevorzugen möglicherweise einfachere oder Open-Source-Wege.
4. Soda

Soda eignet sich für Teams, die möchten, dass sich die Datenqualität wie ein Teil des Engineering-Systems verhält und nicht wie eine separate Kontrollinstanz. Es ist eine starke Option, wenn die Bewertungskriterien In-Database-Prüfungen, versionierte Regeln und klare Zuständigkeiten innerhalb des Data Engineerings oder Analytics Engineerings bevorzugen.
Diese Unterscheidung spielt bei der Tool-Auswahl eine große Rolle. Einige Plattformen optimieren für eine breite Anomalieerkennung mit weniger Einrichtungsaufwand. Soda geht den umgekehrten Weg. Teams definieren die Prüfungen, entscheiden, wo sie laufen, und verwalten sie auf dieselbe Weise, wie sie dbt-Modelle, Tests und Deployment-Änderungen verwalten.
Why Soda works well in engineering-led stacks
Der Hauptreiz von Soda liegt in der Kontrolle.
Soda Core und SodaCL bieten Teams ein Checks-as-Code-Modell, das sich natürlich in Pull-Requests, CI-Pipelines und Release-Workflows einfügt. Für Organisationen, die Transformationen bereits über Git prüfen und Änderungen über Umgebungen hinweg bereitstellen, ist diese architektonische Passgenauigkeit meist wichtiger als eine lange Feature-Liste. Der Vorteil ist die Reproduzierbarkeit. Der Kompromiss ist die Instandhaltung.
Dieser Kompromiss wird deutlicher, je größer der Umfang wird. Eine kleine Anzahl geschäftskritischer Datensätze lässt sich meist problemlos abdecken. Hunderte von Tabellen über verschiedene Domänen hinweg können jedoch zu einem unübersichtlichen Wildwuchs an Regeln, Zuständigkeitslücken und fehlerhaften Alarmen führen, wenn Teams nicht frühzeitig Vorlagen, Schweregrade und Überprüfungsprozesse standardisieren.
Soda ist in der Regel eine gute Wahl, wenn das Team Folgendes wünscht:
In Code definierte Prüfungen: Hervorragend geeignet für dbt-zentrierte Workflows und die Durchsetzung von CI/CD.
Optionen für die Ausführung in der Datenbank: Nützlich für Teams, die die Validierung nahe am Warehouse halten möchten.
Ein schrittweiser Einführungspfad: Erst Open Source, dann verwaltete Zusammenarbeit, wenn das Programm reift.
Klare betriebliche Zuständigkeit: Bestens geeignet, wenn Ingenieure bereit sind, Regeln im Laufe der Zeit zu pflegen.
Angebotsbasierte Preise für verwaltete Services: Die Budgetbewertung erfordert mehr Arbeit, sobald das Team die Open-Source-Ebene verlässt.
Teams mit ausgereifter Engineering-Disziplin ziehen oft schnell Nutzen aus Soda. Teams, die nach einer wartungsarmen Überwachung suchen, bevorzugen in der Regel ein Tool mit mehr Automatisierung und weniger eigener Regelerstellung.
In einer Vergleichsmatrix schneidet Soda bei Transparenz, Workflow-Passung und Implementierungskontrolle meist gut ab. Bei der vollautomatischen Abdeckung schneidet es schlechter ab. Das ist kein Mangel. Es ist eine Designentscheidung, und für das richtige Team ist es genau die richtige.
5. Metaplane
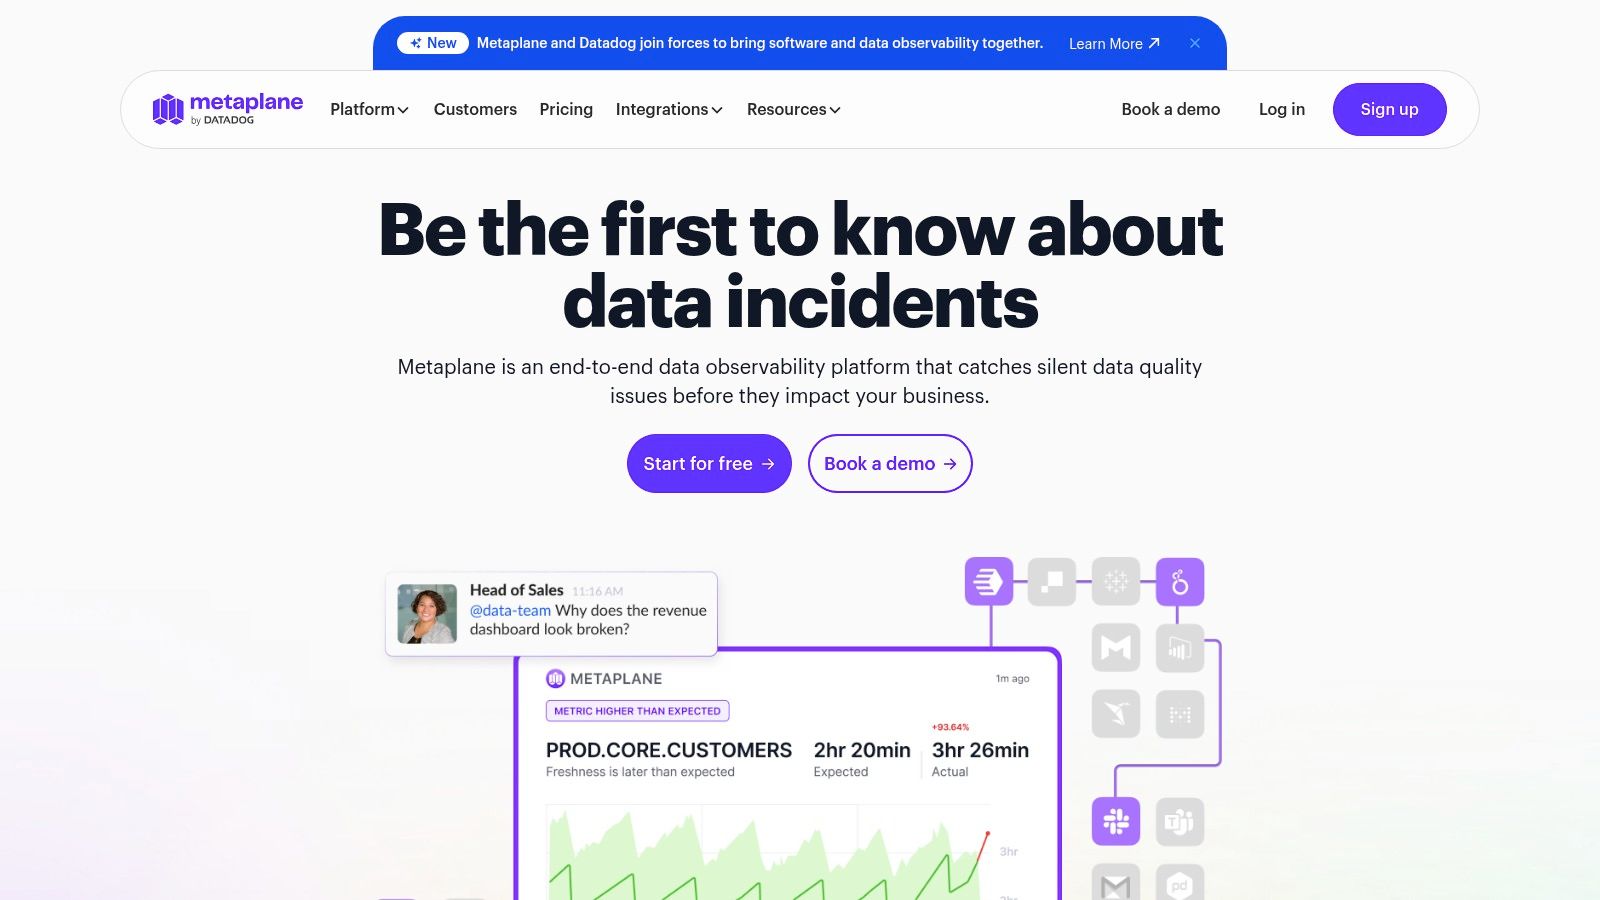
Ein typisches Szenario sieht so aus: Das Warehouse ist stabil genug, um Berichte zu unterstützen, aber das Vertrauen schwindet, weil Tabellen unbemerkt kaputtgehen, die Aktualität über Nacht abweicht und niemand das Problem bemerkt, bis ein Dashboard vor den Augen der geschäftlichen Anwender rot leuchtet. Teams in dieser Lage fordern in der Regel nicht zuerst ein vollständiges Governance-Programm. Sie wollen eine frühzeitige Warnung, eine schnelle Einrichtung und genügend Kontext, um Vorfälle an den richtigen Besitzer weiterzuleiten.
Metaplane bedient genau dieses Bedürfnis. Es ist ein Observability-First-Produkt, das sich an moderne Datenteams richtet, die schnell eine Abdeckung erreichen möchten, insbesondere in Warehouse- und dbt-lastigen Umgebungen. Dieser Fokus ist entscheidend. Metaplane versucht, die Zeit bis zum Signal zu verkürzen, und nicht, jede umliegende Funktion im Datenmanagement-Stack zu ersetzen.
Diese Unterscheidung prägt die Bewertung. Wenn das Ziel eine breite Verwaltung, Richtlinienmanagement und unternehmensweite Data Governance ist, wird sich Metaplane zu eng anfühlen. Wenn das Ziel darin besteht, Probleme mit Aktualität, Schema, Volumen oder Verteilung zu erkennen, bevor die Stakeholder sie bemerken, kann der engere Fokus ein Vorteil sein, da die Implementierung in der Regel schneller und die Zuständigkeiten klarer sind.
Teams entscheiden sich oft aus einigen praktischen Gründen für Metaplane:
Schnelles Onboarding: Perfekt für Teams, die ohne lange Plattform-Einführung eine Überwachung etablieren müssen.
Observability vor Governance: Stark bei der Erkennung von Problemen in Produktionsdaten, weniger geeignet für Katalogisierung, Lineage-Governance oder verwaltungsintensive Programme.
Ausrichtung an modernen Stacks: Funktioniert gut in Analytics-Umgebungen, die auf Cloud Warehouses and dbt-Workflows aufbauen.
Schrittweise Einführung: Unterstützt einen sinnvollen Einführungspfad, bei dem Teams mit umsatzkritischen oder für die Geschäftsführung relevanten Assets beginnen.
Kompromiss bei der Tiefe: Sie gewinnen an Geschwindigkeit und Fokus, aber größere Unternehmen benötigen möglicherweise dennoch separate Tools für breitere Datenmanagement-Funktionen.
In einer Vergleichsmatrix schneidet Metaplane in der Regel bei Implementierungsgeschwindigkeit, Benutzerfreundlichkeit und moderner Observability-Abdeckung sehr gut ab. Es schneidet schlechter ab, wenn die Bewertungskriterien eine All-in-One-Governance-Breite oder eine tiefe, regelgesteuerte Kontrolle bevorzugen. Für viele mittelständische Teams ist das ein akzeptabler Kompromiss. Die richtige Frage ist nicht, ob Metaplane alles kann. Es ist die Frage, ob Ihr Team eine schnelle Störungserkennung im Warehouse benötigt oder ein breiteres System, das Qualität, Governance und Datenverwaltung von Anfang an umspannt.
6. Acceldata
Acceldata ist das, was ich als breite Betriebsplattform und nicht als enge Einzellösung für Datenqualität bezeichnen würde. Es deckt Datenzuverlässigkeit, Pipeline-Observability, Infrastruktur-Sichtbarkeit sowie Kosten- und Performance-Überwachung ab. Das ist eine Menge Fläche, was in großen Umgebungen genau richtig und in kleineren völlig falsch sein kann.
Die entscheidende Frage ist nicht, ob Acceldata genügend Funktionen hat. Es ist die Frage, ob Ihr Unternehmen ein einziges Produkt benötigt, um Qualität, Recheneffizienz und Service-Level-Erwartungen miteinander zu verbinden.
Where Acceldata makes sense
Acceldata funktioniert am besten in großen Hybrid- oder Cloud-Umgebungen, in denen Vorfälle oft sowohl Datensymptome als auch Infrastrukturursachen haben. In solchen Umgebungen kann die Aufteilung der Tools auf Datenqualität, Plattform-Observability und Cost-Governance zu blinden Flecken und unklaren Zuständigkeiten führen. Der breitere Ansatz von Acceldata hilft, diese Lücke zu schließen.
Die Kehrseite ist die Komplexität. Teams mit einem relativ sauberen, modernen Warehouse-Stack benötigen möglicherweise nicht so viel Plattformfläche. Sie sind mit einem fokussierteren Observability- oder Validierungstool oft besser bedient.
Praktische Abwägungen:
Nützlich bei hybrider Komplexität: Es eignet sich für Unternehmen mit vielschichtigen Infrastruktur-Anforderungen.
Gut für SLA-orientierte Betriebe: Zuverlässigkeit und Leistung liegen im Produkt eng beieinander.
Kann Tool-Wildwuchs reduzieren: Wenn Sie Daten- und Infrastruktur-Observability zusammen benötigen.
Für kleine Teams meist zu schwerfällig: Umfang und Beschaffung sind stark auf Großunternehmen ausgerichtet.
Verkaufsorientierter Einkaufsprozess: Stellen Sie sich auf formelle Bewertungen und die Beteiligung verschiedener Stakeholder ein.
7. IBM Data Observability by Databand
IBM Data Observability by Databand ist eine starke Option für Unternehmen, die das Daten-Incident-Management unter einem großen Enterprise-Dach bündeln möchten. Es konzentriert sich auf Pipeline-Zuverlässigkeit, Anomalieerkennung, Alarmierung und metadatenbasiertes Baseline-Management – mit dem zusätzlichen Komfort von IBM-Dokumentationen, Onboarding-Strukturen und Support-Kanälen.
Dieser letzte Punkt ist wichtiger, als Produktmarketer normalerweise zugeben würden. Einige Teams kaufen nicht das technisch coolste Tool. Sie kaufen dasjenige, das von Beschaffung, Sicherheit und Betrieb unterstützt werden kann.
Where Databand fits
Databand ist in Enterprise-Umgebungen am sinnvollsten, die bereits auf IBM ausgerichtet sind oder eine starke Vorliebe für etablierte Anbieter haben. Es ist besonders relevant, wenn Pipeline-Zustand, Job-Orchestrierung und betriebliche Alarmierung ebenso wichtig sind wie Qualitätsprüfungen auf Tabellenebene.
Für Teams, die ein flinkes, entwicklerorientiertes Produkt suchen, das sie mit minimalem Aufwand testen und skalieren können, ist es weniger attraktiv. Die Stärken von IBM liegen in Governance, Support und Enterprise-Bereitschaft. Das ist wertvoll, bringt aber auch einen schwerfälligeren Prozess mit sich.
Eine realistische Einschätzung:
Gute Eignung für die betriebliche Kontrolle im Unternehmen: Stark bei der Vermeidung von Vorfällen und beim Managed Support.
Funktioniert gut in formellen IT-Umgebungen: Hilfreich dort, wo Prozesse und Dokumentation zählen.
Integriert sich in codebasierte Workflows: Nützlich für Engineering-Teams in großen Unternehmen.
Kann sich für kleine Gruppen schwerfällig anfühlen: Besser geeignet für breite organisatorische Einführungen.
Kommerzielle Details sind nicht vollständig öffentlich: Planen Sie einen anbietergeführten Verkaufsprozess ein.
8. Ataccama ONE
Ataccama ONE ist nicht nur ein Datenqualitäts-Tool. Es ist eine umfassendere Data-Trust-Plattform, die Profiling, Regeln, Scorecards, Observability, Katalogfunktionen, Lineage und MDM-bezogene Anliegen zusammenführt. Diese Positionierung macht es für Unternehmen attraktiv, die es leid sind, separate Initiativen für Governance und Qualität zu betreiben.
Dies ist ein völlig anderer Kaufprozess als bei Tools wie Metaplane oder Soda. Sie lösen hier nicht nur das Monitoring. Sie entscheiden sich für ein breiteres Betriebsmodell.
Why Ataccama is different
Ataccama ist am stärksten, wenn die Organisation möchte, dass Qualität eng mit Katalogisierung, Datenverwaltung (Stewardship) und Referenzdatenmanagement verknüpft ist. Wenn sowohl Ihr Governance-Team als auch Ihr Engineering-Team Stakeholder sind, kann eine einheitliche Suite Überschneidungen reduzieren und das Übergabeproblem vermeiden, bei dem ein Team Probleme sieht und ein anderes die Definitionen besitzt.
Der Kompromiss ist das Gewicht der Implementierung. Breite Suiten benötigen in der Regel länger für die Einführung und erfordern mehr Abstimmung bei Zuständigkeiten, Metadaten und Workflow-Design. In regulierten oder domänenübergreifenden Unternehmen zahlen sie sich oft aus. Teams, die eigentlich nur eine schnelle Anomalieerkennung wollten, werden dagegen oft enttäuscht.
Was Sie bei Ataccama erwartet:
Breite Plattform-Abdeckung: Qualität, Governance, Lineage und verwandte Disziplinen greifen ineinander.
Gut für regulierte Sektoren: Insbesondere dort, wo Zuständigkeit und Revisionsfähigkeit wichtig sind.
Flexible Bereitstellungsoptionen: Nützlich für Cloud-, Hybrid- und On-Prem-Strukturen.
Längere Implementierungsphase: Die Breite erhöht den Aufwand für Einrichtung und Change-Management.
Enterprise-Preismodell: Kommerzielle Angebote basieren auf individuellen Angeboten.
9. Informatica Data Quality
Informatica Data Quality bleibt einer der etabliertesten Namen im Bereich der Enterprise-Datenqualität. Es bietet Profiling, Regelerstellung, Scorecards, Ausnahmebehandlung und Cloud-Ausführung innerhalb des breiteren Informatica-Ökosystems.
Für viele Unternehmen liegt der Reiz nicht in der Neuheit. Es sind die Vertrautheit, die Tiefe und die Möglichkeit zur Abstimmung mit bestehenden Investitionen in Informatica-Integration, -Governance oder -Masterdaten.
When Informatica is the right call
Informatica ist in der Regel die sichere Wahl, wenn ein Unternehmen eine tiefe Funktionsabdeckung, breiten Enterprise-Support und die Integration in einen ausgereiften Datenmanagement-Stack benötigt. Es ist besonders relevant, wenn die Qualitätsarbeit mit Compliance, Data Stewardship und Ausnahmemanagement verknüpft ist, statt nur mit Anomalie-Warnungen.
Die Einschränkung liegt auf der Hand. Informatica kann sowohl operativ als auch kommerziell ein schwereres Unterfangen sein als fokussiertere Tools. Verbrauchsbasierte Pakete und Enterprise-Lizenzierungen können das Kostenmodell für Teams, die an einfache Preise pro Benutzer oder pro Tabelle gewöhnt sind, zudem weniger intuitiv machen.
Wenn Ihr Unternehmen Informatica bereits bei angrenzenden Workflows vertraut, ist der Kauf von Informatica Data Quality oft einfacher, als eine völlig neue Plattformkategorie einzuführen.
Hier ist die praktische Sicht:
Tiefe Enterprise-Funktionalität: Stark beim Profiling, beim Regelmanagement und bei Ausnahme-Workflows.
Gute Passung ins Ökosystem: Bestens geeignet, wenn Informatica bereits Teil des Stacks ist.
Nützliche Cloud-Skalierungsoptionen: Serverlose Ausführung kann bei elastischen Workloads helfen.
Komplexe Paketierung: Preisgestaltungs- und Verbrauchsmodelle erfordern eine genaue Prüfung.
Nicht ideal für schlanke Teams: Es gibt einfachere Tools, die man aufsetzen kann, wenn die Anforderungen begrenzt sind.
10. Qlik Talend Data Quality
Qlik Talend Cloud bringt Datenqualität in eine breitere Integrations- und Analyseplattform. Das ist der entscheidende Blickwinkel für die Bewertung. Wenn Sie ein eigenständiges Spezialwerkzeug suchen, ist dies wahrscheinlich nicht Ihre erste Anlaufstelle. Wenn Sie bereits Qlik oder Talend nutzen, wird es weitaus interessanter.
Diese Art von Plattform-Passung ist wichtig, da viele Unternehmen nicht noch einen weiteren Anbieter für Qualität ins Boot holen wollen, wenn sie eine bestehende Integrationslandschaft sinnvoll erweitern können.
Where Qlik Talend fits best
Qlik Talend Data Quality ist dann am überzeugendsten, wenn Profiling, Regeln, Stewardship und Integrations-Workflows zusammenlaufen müssen. Teams, die sich bei ihren Pipelines bereits auf Talend verlassen, können oft schneller agieren, indem sie das erweitern, was sie bereits haben, anstatt eine separate Observability-Ebene mit eigener Verwaltung und Beschaffung aufzusetzen.
Der Nachteil ist die modulare Unabhängigkeit. Da die Qualität innerhalb der breiteren Plattform angesiedelt ist, fühlt sie sich möglicherweise nicht so spezialisiert oder leichtgewichtig an wie dedizierte Produkte für Data Observability. Für einige Käufer ist das völlig in Ordnung. Für andere bedeutet es, dass sie für eine Plattformstruktur zahlen, die sie eigentlich gar nicht kaufen wollten.
Eine realistische Zusammenfassung:
Am besten für bestehende Qlik- oder Talend-Kunden: Die Ausrichtung auf die Plattform ist der Hauptgrund für die engere Auswahl.
Starke Kombination aus DI und DQ: Nützlich, wenn Integration (DI) und Qualität (DQ) operativ zusammengehören.
Gute Befähigung von Unternehmen: Dokumentation und breiterer Herstellersupport sind ausgereift.
Kein rein eigenständiges Qualitätstool: Käufer sollten die breitere Plattform anstreben.
Die Preisgestaltung ist gebündelt und unternehmensorientiert: Rechnen Sie mit Vertriebsbeteiligung.
Top 10 Datenqualitäts-Tools, Feature-Vergleich
Produkt | ✨ Wichtigstes Unterscheidungsmerkmal | 🏆 Stärken | ★ Qualität/UX | 💰 Preise / Wert | 👥 Bestens geeignet für |
|---|---|---|---|---|---|
digna | In-Database-KI-Anomalieerkennung + On-Prem/Private Cloud | Privacy-first, einheitliche DQ+Observability, schnelle Installation | ★★★★☆ | 💰Angebot; hoher Wert für sichere Umgebungen | 👥 Sicherheitsbewusste Unternehmen, Data Engineers & Analysten |
Monte Carlo | End-to-End-Lineage + KI-Observability (inkl. Agenten/LLMs) | Kategorieführer; starke Vorfalls-Triage & Explosionsradius-Analyse | ★★★★★ | 💰Angebot; Fokus auf Großunternehmen | 👥 Große Unternehmen, die ihre Vorfallsabläufe standardisieren |
Anomalo | Unüberwachte / „selbstfahrende“ Anomalieerkennung | Reduziert die Regelpflege; bewährt im großen Stil (Finanzen/Handel) | ★★★★☆ | 💰Angebot; Enterprise-Vertrieb | 👥 Unternehmen, die eine automatisierte Anomalie-Abdeckung benötigen |
Soda | Open-Source-Kern (SodaCL) + verwaltete Cloud | Checks-as-Code, CI/CD-freundlich, passend für Governance | ★★★★ | 💰Kern kostenlos; Cloud auf Anfrage | 👥 Data Engineers, DevOps- & Governance-Teams |
Metaplane | dbt-native, Abrechnung pro Tabelle & schnelles Onboarding | Einfache Einrichtung; transparente Preise; Überwachung pro Tabelle | ★★★★ | 💰Nutzungsbasiert; kostenlose Stufe verfügbar | 👥 Kleine/mittlere Teams und dbt-Anwender |
Acceldata | Observability + Optimierung von Compute/Kosten/Perf | Breite Pipeline- + Infrastrukturabdeckung; SLA- & Ausgabenkontrolle | ★★★★ | 💰Enterprise-Angebot; hoher Wert bei großem Umfang | 👥 Große, komplexe hybride Datenlandschaften |
IBM Data Observability (Databand) | Von IBM unterstütztes SaaS für Pipelinestabilität | Enterprise-Support, Dokumentation, Pipeline-Integrationen | ★★★★ | 💰SaaS/Angebot; IBM Enterprise-Vertriebsprozess | 👥 IBM-Kunden und Enterprise-Betriebsteams |
Ataccama ONE | Einheitlicher „Data Trust“ (DQ + Katalog + MDM) | Umfassende Governance, Katalog- & MDM-Integration | ★★★★ | 💰Angebot; höhere Gesamtbetriebskosten für die Gesamtsuite | 👥 Regulierte Branchen, die eine integrierte Governance benötigen |
Informatica Data Quality | Ausgereifte DQ mit Profiling- & serverlosen Optionen | Tiefe Enterprise-Funktionen; skalierbare Ausführungsmodelle | ★★★★ | 💰Verbrauchsabhängig; komplexe Paketierung | 👥 Große regulierte Unternehmen mit hohem DQ-Bedarf |
Qlik Talend Data Quality | DQ eingebettet in Datenintegration (Talend) | Integrierte DI+DQ; Stewardship- & Behebungsfunktionen | ★★★★ | 💰Paket/Angebot über Qlik Talend Cloud | 👥 Teams, die in Qlik/Talend-Integrations-Stacks investieren |
Die richtige Wahl treffen – von der Bewertung zur Aktion
Eine echte Bewertung beginnt meist auf die gleiche Weise. Ein Dashboard bricht ab, das Business fragt, ob die Zahl falsch oder die Pipeline verspätet ist, und das Team stellt fest, dass drei verschiedene Tools jeweils einen Teil des Problems abfangen können, aber keines sauber in das Betriebsmodell passt.
Deshalb sollte die Tool-Auswahl bei den Rahmenbedingungen beginnen, nicht bei den Feature-Tabellen. Die erste Frage ist, wo die Prüfungen laufen und wer Zugriff auf die Produktionsdaten hat. Für regulierte Teams schließt diese Entscheidung einen großen Teil des Marktes sofort aus. Wenn Daten Ihre Umgebung nicht verlassen dürfen, sind die Ausführung in der Datenbank und eine vom Kunden kontrollierte Bereitstellung Grundvoraussetzungen. digna passt in dieses Modell mit Anomalieerkennung, Validierung, Aktualitätsüberwachung und Schema-Tracking, die ausgeführt werden können, ohne Produktionsdaten an eine vom Anbieter kontrollierte Umgebung zu senden.
Die nächste Frage betrifft die Zuständigkeit. Teams mit starker Analytics-Engineering-Praxis bevorzugen oft Checks-as-Code, Versionskontrolle und die Ausrichtung auf CI/CD. Observability-gesteuerte Teams legen meist mehr Wert auf automatisierte Erkennung, Lineage-Kontext, Alarm-Tuning und Incident-Response. Keines der Modelle ist im Abstrakten besser. Das falsche Modell führt zu toten Monitoren, ignorierten Alarmen und Regeln, die nach der Testphase niemand mehr pflegt.
Die Bereitschaft zur Implementierung ist ebenso wichtig. Große Suiten wie Ataccama ONE, Informatica und IBM Data Observability by Databand können für Organisationen geeignet sein, in denen Datenqualität mit Stewardship, Compliance und formellen Betriebsprozessen verknüpft ist. Sie bringen jedoch auch längere Einführungszyklen, mehr Abstimmung unter den Stakeholdern und höhere Gesamtkosten mit sich. Kleinere Teams ziehen oft mehr Nutzen aus Produkten, die ein enger begrenztes Problem gut lösen, insbesondere wenn der unmittelbare Schmerz in fehlerhafter Aktualität, Schema-Drifts oder defekten nachgelagerten Dashboards liegt.
Anwendungsfälle sollten die engere Auswahl bestimmen.
Wenn die Sicherheitsprüfung das größte Hindernis darstellt, priorisieren Sie Tools, die in Ihrem Warehouse oder Ihrer Infrastruktur laufen. Wenn die Geschwindigkeit eines Startups wichtiger ist als die Breite der Governance, bevorzugen Sie Produkte mit schneller Einrichtung, klarer Preisgestaltung und geringem Aufwand für das Regelmanagement. Wenn die Umgebung bereits auf dbt, Airflow, Databricks, Snowflake oder einen großen Enterprise-Integrations-Stack standardisiert ist, gewichten Sie native Integrationen stark. Reibungsverluste bei der Integration sind einer der schnellsten Wege, ein vielversprechendes Proof-of-Concept in ungenutzte Software-Leichen zu verwandeln.
Benchmarks können dennoch hilfreich sein. Die 6Sigma-Übersicht von Datenqualitäts-Benchmarks ist eine nützliche Erinnerung daran, dass Qualität messbare Ziele für Genauigkeit, Vollständigkeit, Konsistenz und Dublettenkontrolle benötigt. Die genauen Schwellenwerte variieren je nach Domäne. Eine Finanz-Pipeline und ein Event-Stream für Produktanalysen sollten nicht an denselben Toleranzen gemessen werden. Wichtig ist, dass das Tool Überwachung, Alarmierung, Behebung und Trendberichte anhand von Standards unterstützt, die Ihr Unternehmen akzeptiert.
Moderne Erkennung verändert auch den Evaluierungsprozess. Automatische Anomalieerkennung fängt heute Fehlerklassen ab, die statische Regeln übersehen, insbesondere schleichende Abweichungen und unerwartete Veränderungen in Verteilung oder Timing. Das ersetzt deterministische Prüfungen nicht. Die Geschäftslogik muss weiterhin explizit validiert werden. In der Praxis kombinieren die stärksten Setups beides: feste Regeln für bekannte Fehlerzustände und adaptive Überwachung für Probleme, an deren Codierung niemand gedacht hat.
Führen Sie ein Proof-of-Concept wie eine praktische Betriebsübung durch, nicht wie ein Verkaufsgespräch. Wählen Sie eine kleine Gruppe geschäftskritischer Tabellen und testen Sie sechs Dinge: Aktualität, Erkennung von Schemaänderungen, Volumenverschiebungen, Gültigkeit auf Feldebene, Alarm-Routing und den Workflow zur Ursachenanalyse. Beziehen Sie die IT-Sicherheit, Plattform-Eigentümer und die Personen ein, die nach dem Start für Vorfälle zuständig sein werden. Wenn die Freigabe an Datenzugriff, Bereitstellungsmuster oder Instandhaltungsaufwand scheitert, ist das kein Randthema. Es ist das Ergebnis.
Die richtige Wahl ist das Tool, das Ihr Team jede Woche ohne heroische Anstrengungen betreiben kann. Manchmal ist das eine Enterprise-Suite. Manchmal ist es eine leichtere Observability-Ebene. Manchmal ist es ein datenschutzorientiertes Produkt, das für die Ausführung in der Datenbank entwickelt wurde.
Als separater operativer Hinweis für Teams, die Kundenkommunikations-Workflows parallel zur Datenhygiene verwalten, lohnt es sich auch zu lernen, wie man Bounce-E-Mails verhindert.
Wenn Ihr Team einen datenschutzorientierten Ansatz für Datenqualität und Observability benötigt, lohnt sich ein genauer Blick auf digna – Forum – Englisch. Es wurde für Teams entwickelt, die Anomalieerkennung, Datensatzvalidierung, Aktualitätsüberwachung und Schema-Tracking in vom Kunden kontrollierten Umgebungen benötigen, ohne dass Anbieter Zugriff auf Produktionsdaten erhalten.
Wenn Ihre Shortlist von nativer Unterstützung für Ihr Warehouse und Ihren Pipeline-Stack abhängt, zeigt die Übersicht der digna-Integrationen, mit welchen Datenplattformen sich digna verbindet, bevor Sie sich auf einen Proof of Concept festlegen.
Häufig gestellte Fragen
Welche Data-Quality-Tools sind 2026 die besten?
Der Leitfaden vergleicht zehn Plattformen: digna, Monte Carlo, Anomalo, Soda, Metaplane, Acceldata, IBM Data Observability by Databand, Ataccama ONE, Informatica Data Quality und Qlik Talend Data Quality. Einen klaren Sieger gibt es nicht; die richtige Wahl hängt davon ab, wo Prüfungen laufen, wem sie gehören und wie viel Implementierungsaufwand Ihr Team tragen kann.
Welches Data-Quality-Tool eignet sich für regulierte oder datenschutzsensible Umgebungen?
Achten Sie auf Tools, die in Ihrer eigenen Infrastruktur laufen. Der Leitfaden positioniert digna als Privacy-First-Option, weil es Metriken direkt in der Datenbank berechnet und Baselines lernt, on-premises oder in der Private Cloud, ohne Produktionsdaten an einen Anbieter zu senden. In Finanzwesen, Gesundheitswesen, Telekommunikation oder im öffentlichen Sektor entscheidet das oft darüber, ob ein Tool überhaupt einsetzbar ist.
Worin unterscheidet sich Soda von Monte Carlo?
Soda folgt einem Checks-as-Code-Modell: Teams schreiben SodaCL-Checks, versionieren sie in Git und führen sie in CI/CD aus. Das bietet Kontrolle, erfordert aber Pflege, wenn die Zahl der Tabellen wächst. Monte Carlo setzt auf breites automatisiertes Monitoring mit Lineage-gestützter Incident-Triage und Blast-Radius-Analyse und passt zu großen Organisationen mit komplexen Pipeline-Landschaften.
Wie führe ich einen Proof of Concept für ein Data-Quality-Tool durch?
Behandeln Sie ihn als Betriebsübung, nicht als Verkaufsübung. Wählen Sie wenige geschäftskritische Tabellen und testen Sie sechs Dinge: Aktualität, Erkennung von Schemaänderungen, Volumenverschiebungen, Gültigkeit auf Feldebene, Alert-Routing und Root-Cause-Workflow. Beziehen Sie Security, Plattformteam und die Personen ein, die nach dem Start für Incidents verantwortlich sind.
Sollte ich regelbasierte Prüfungen oder automatische Anomalieerkennung nutzen?
Beides, so der Leitfaden: Die stärksten Setups kombinieren feste Regeln für bekannte Fehlerbilder mit adaptivem Monitoring für Probleme, an die niemand gedacht hat. Anomalieerkennung erfasst schleichenden Drift und unerwartete Änderungen bei Verteilung oder Timing, während explizite Validierung für Geschäftslogik nötig bleibt, die für jeden Datensatz gelten muss.



