Tests d'intégrité des bases de données : Un guide pratique pour 2026
|
7
minute de lecture

Vous pouvez avoir un pipeline techniquement vert et produire quand même un tableau de bord financier auquel personne ne fait confiance. Les tâches se terminent, les tests réussissent et les lignes sont bien là, mais le grand livre ne concorde pas avec le chiffre d'affaires affiché à l'écran. C'est dans cet écart que le test d'intégrité de base de données gagne ses galons, car il vérifie si les données sont toujours correctes après le stockage, les jointures, les migrations, les transformations et le temps.
Table des matières
Quand les tests au vert livrent tout de même des données corrompues
Ce que signifie réellement le test d'intégrité de base de données
Les cinq dimensions que tout test d'intégrité devrait couvrir
Concevoir des cas de test d'intégrité qui poussent à la rupture
Intégrer les tests d'intégrité dans le CI/CD et les migrations
Des tests ponctuels à l'Observability continue de l'intégrité
Quand les tests au vert livrent tout de même des données corrompues
L'alerte est venue de la finance, pas de l'ingénierie. Un tableau de bord affichait un chiffre d'affaires qui ne correspondait pas au grand livre, alors que chaque vérification de pipeline avait réussi et que l'entrepôt de données semblait sain sur le papier. Un ingénieur analytics a remonté le flux à travers les couches de staging, de transformation et de reporting, pour découvrir une vérité dérangeante : la base de données ne présentait aucune violation d'intégrité évidente, et pourtant la réponse métier était fausse.
C'est le piège des vérifications ordinaires. Le nombre de lignes peut sembler correct, un DAG peut passer au vert et un test de fraîcheur basique peut réussir alors qu'une relation clé étrangère est rompue, qu'une clé en double a été introduite lors d'un backfill ou qu'une transformation a modifié les totaux historiques. En pratique, l'intégrité dépend de la stratégie de validation mise en place autour de la base de données, et non de la simple présence de la base elle-même. Les tests de mutation ont d'ailleurs montré l'ampleur de cet écart, les critères de couverture les plus faibles n'éliminant que 12 % des mutants, tandis que les plus robustes en éliminaient jusqu'à 96 % dans une analyse de 2015 (McMinn 2015).
Une façon plus claire de poser le problème est de distinguer la qualité des données de l'intégrité des données, que l'équipe de digna traite comme des préoccupations liées mais distinctes.
Pourquoi cela mérite sa propre discipline
Le test d'intégrité des bases de données se positionne aux côtés des travaux généraux sur la qualité des données. Il vérifie que les enregistrements restent exacts, cohérents, valides et non corrompus lorsqu'ils transitent par le stockage et subissent des modifications. Pour cela, il nécessite des tests négatifs qui tentent de violer les règles plutôt que de simplement valider le cas nominal. C'est indispensable, car un système peut tout à fait être alimenté, interrogeable, et pourtant erroné.
Les recommandations du secteur structurent désormais l'intégrité autour de cinq dimensions clés : l'exactitude, la complétude, la cohérence, la ponctualité et la validité (Matillion). On retrouve ce même point dans les recommandations d'IBM sur les tests d'intégrité des données, qui insistent sur la vérification de l'application effective des règles par la base de données lors du stockage et de l'extraction. Ce modèle est utile car il éloigne les équipes d'une logique binaire de réussite/échec pour les orienter vers des contrôles multicouches adaptés aux modes de défaillance des entrepôts, lacs et pipelines modernes.
Ce que signifie réellement le test d'intégrité de base de données

Une base de données peut sembler saine en surface tout en contenant des enregistrements erronés. Le test d'intégrité de base de données vérifie si les données restent correctes et non corrompues lorsqu'elles sont stockées, récupérées, répliquées et transformées, et si la base applique bien les règles dont dépend le système. Situé à la frontière entre le respect du schéma et le comportement au runtime, sa surface de test doit couvrir ces deux aspects.
Un système simple de clients et de commandes permet de l'illustrer rapidement. Chaque commande doit pointer vers un client réel, chaque identifiant client doit rester unique, et les champs comme le statut ou la quantité de la commande doivent respecter l'ensemble des valeurs autorisées. Si l'une de ces promesses n'est pas tenue, la base de données peut tout de même accepter la ligne, à moins que la règle n'ait été encodée et testée.
Les types d'intégrité classiques
L'intégrité de l'entité signifie que chaque ligne possède un identifiant unique et que cet identifiant n'est pas nul. Une clé primaire doit jouer son rôle, sinon les enregistrements commencent à se confondre et les jointures en aval deviennent peu fiables.
L'intégrité référentielle signifie que les lignes enfants pointent vers des lignes parents réelles. Si une commande fait référence à un client inexistant, le système crée un orphelin, et les rapports risquent de fausser les comptages ou les classifications d'enregistrements.
L'intégrité du domaine maintient les valeurs dans les limites de la plage, du type ou de la liste autorisés. Il peut s'agir d'une contrainte CHECK, d'un type de données ou d'une règle bloquant les codes de statut invalides avant qu'ils ne se propagent.
L'intégrité sémantique correspond à la couche métier que le schéma seul ne peut pas exprimer. Une valeur updated_at ne devrait pas être antérieure à created_at, et une commande ne devrait pas être marquée comme payée si la table des paiements ne présente aucune transaction.
Règle pratique : si une contrainte de schéma peut exprimer la règle, testez directement la contrainte. Si la logique métier détient la règle, testez le comportement qui la valide.
Cette séparation entre vérifications structurelles et contrôles qualité plus larges montre tout l'intérêt de distinguer qualité et intégrité des données, car elle permet de clarifier quelles défaillances relèvent de la base de données elle-même et lesquelles proviennent du pipeline ou de la logique applicative environnante.
Les Elasticités que tout test d'intégrité devrait couvrir

Une table peut respecter ses contraintes de base tout en conduisant à de mauvaises décisions. La ligne existe, le type est correct, la jointure fonctionne, et pourtant le chiffre peut être obsolète, incomplet ou contredit par un autre système. C'est pourquoi les tests d'intégrité doivent aller au-delà des clés primaires et des clés étrangères. Ils doivent traquer les manières spécifiques dont les données peuvent paraître valides tout en étant suspectes.
Le modèle des cinq dimensions aide les équipes à éviter de se focaliser sur un seul mode de défaillance. Chaque table critique devrait être associée à la dimension la plus susceptible d'y faire défaut, car le test adapté à une clé client n'est pas le même que celui destiné à un instantané de chiffre d'affaires. Les contraintes classiques détectent les violations structurelles, tandis que les vérifications continues identifient les dérives de comportement, de fraîcheur et de cohérence intersystèmes. Pour les modifications de schéma qui altèrent ces règles, reportez-vous à l'article sur la dérive de schéma et pourquoi les changements structurels brisent les pipelines.
Ce que chaque dimension permet de détecter
L'exactitude cherche à savoir si la valeur est juste. Un total de chiffre d'affaires peut être faux même si la ligne est présente et que le type est correct. Le test doit donc comparer le résultat au calcul attendu ou à la source de vérité.
La complétude vérifie si les enregistrements ou les champs attendus sont bien présents. L'absence d'un mois de transactions est une défaillance différente d'une valeur erronée, et elle nécessite généralement des contrôles de volume, de présence ou des vérifications au niveau des partitions. Si un travail d'ingestion omet une partie des données, c'est la complétude qui doit révéler cette anomalie en premier.
La cohérence recherche les contradictions entre différents systèmes ou différentes couches. Un client marqué comme actif dans une table et clôturé dans une autre indique une dérive du modèle, et cette anomalie ne peut souvent être détectée qu'en comparant les deux tables face à face.
La ponctualité contrôle la fraîcheur des données. Un chargement qui arrive à 23h55 mais est traité comme à jour à 9h00 devrait échouer à une règle de ponctualité, même si chaque ligne est valide. La fraîcheur est essentielle, car des données retardées peuvent être exactes tout en induisant en erreur quiconque les consulte en les pensant actuelles.
La validité s'assure que les données respectent le format ou le jeu de règles autorisé. C'est ici que l'on traite les adresses e-mail mal formées, les statuts impossibles et les dates erronées, ainsi que tout champ qui violerait les règles métiers associées à son type.
Une bonne pratique de test consiste à concevoir le test en fonction du mode de défaillance, et non pour la facilité d'écriture du SQL. Si une table stocke des dates, des volumes, des identifiants clients et des états métiers, une seule requête pourra valider une partie de l'ensemble, mais prouvera rarement les cinq dimensions à la fois. La méthode la plus propre consiste à identifier ce qui peut échouer, puis à choisir le contrôle qui exposera cette défaillance de la manière la plus directe.
Vision opérationnelle : une suite de tests au vert qui vérifie uniquement la complétude peut tout de même passer à côté d'un calcul de revenus erroné, d'un lot obsolète ou d'un enregistrement valide individuellement mais incohérent avec le reste du modèle.
C'est pourquoi ces cinq dimensions sont devenues une référence pour la governance d'entreprise dans les environnements réglementés, en particulier là où l'auditabilité et la fraîcheur importent autant que l'exactitude.
Concevoir des cas de test d'intégrité qui poussent à la rupture
Les meilleurs tests d'intégrité ne se contentent pas de célébrer le cas nominal, ils cherchent à mettre le modèle en défaut. Si une règle est réelle, le test doit être capable de la violer intentionnellement pour prouver que la base de données rejette l'entrée incorrecte ou expose le comportement anormal. C'est ainsi que l'on découvre les cas où une migration a supprimé une contrainte ou qu'un refactoring d'ETL a cessé d'appliquer une logique.
Cas négatifs mettant en évidence des contrôles faibles
L'insertion d'une clé primaire en double devrait échouer immédiatement si l'intégrité de l'entité est effective. Une ligne enfant orpheline devrait échouer si l'intégrité référentielle est appliquée. Une valeur d'énumération invalide, un enfant inséré avant son parent, ou une quantité négative dans une table qui ne devrait jamais en accepter sont autant d'indicateurs qui vous révèlent si la règle existe réellement dans la base de données ou seulement dans la documentation.
La même approche s'applique aux contrôles sémantiques. Une commande payée sans aucune transaction de paiement associée devrait bloquer une requête de validation. Il en va de même pour une ligne où updated_at est antérieur à created_at. Ce sont ces types de tests qui permettent de détecter les problèmes silencieux après une mise en production, en particulier lorsque la base de données « semble correcte » en apparence.
Cas de tests d'intégrité courants et ce qu'ils décrivent
Cas de test | Type d'intégrité | Ce qu'il détecte | Exemple d'assertion |
|---|---|---|---|
Insertion d'une clé primaire en double | Entité | Absence d'application de l'unicité | Échoue si la clé en double est acceptée |
Ligne enfant orpheline | Référentielle | Relation parent-enfant rompue | Échoue si l'enfant n'a pas de parent |
Énumération ou statut invalide | Domaine | Contraintes de valeurs faibles | Échoue si une valeur non autorisée est stockée |
Insertion de l'enfant avant le parent | Référentielle | Absence de contrôle de séquencement | Échoue si la règle de clé étrangère est contournée |
Commande payée sans ligne de paiement | Sémantique | Processus métier défaillant | Échoue si l'état du paiement est incohérent |
Quantité négative | Domaine | Valeurs métiers impossibles | Échoue si une valeur négative est stockée |
| Sémantique | Mauvaise logique de cycle de vie | Échoue si les horodatages violent l'ordre logique |
Pour une vision au niveau du schéma de la façon dont ces défaillances débutent souvent, la note interne expliquant la dérive de schéma constitue un complément utile. La dérive structurelle peut affaiblir les contraintes, et le symptôme peut ne pas apparaître avant qu'un contrôle en aval ne compare enfin le comportement attendu avec ce que fait réellement la base de données.
Le message d'assertion doit être direct et explicite. « L'identifiant client en double a été accepté », « ligne de commande orpheline détectée » et « l'état du paiement ne correspond pas aux enregistrements de transaction » sont bien plus utiles que de vagues messages de réussite ou d'échec, car ils indiquent précisément à l'ingénieur suivant ce qui s'est cassé.
Une approche efficace consiste à associer ces défaillances ponctuelles aux mêmes règles surveillées au fil du temps au sein de la base de données. Le test statique prouve que la contrainte existe. L'observabilité continue montre si les données réelles continuent de se heurter aux cas limites critiques, comme la création répétée d'orphelins après un déploiement ou un champ de statut qui dévie de l'ensemble autorisé. Cette combinaison offre à la fois le garde-fou et le signal d'alarme.
Si vous recherchez une plateforme pour formuler ces contrôles directement au sein de la base de données au lieu d'exporter les données pour validation, digna est une option intéressante. Son modèle d'exécution en base de données et sa validation basée sur des règles s'adaptent parfaitement à ce style de test, où l'objectif est d'intercepter les relations rompues là où résident déjà les données.
Intégrer les tests d'intégrité dans le CI/CD et les migrations
Une modification de schéma déployée sans réexécuter les tests d'intégrité crée une zone d'ombre, et c'est généralement par là que s'infiltrent les données corrompues. Un processus de déploiement fiable maintient les migrations et les assertions d'intégrité unies, de sorte que les règles protégeant les clés, les relations et les valeurs autorisées voyagent avec le code qui les modifie.
À quoi devrait ressembler le flux de déploiement
Tout commence par le contrôle de version. Un développeur modifie le schéma, la logique de transformation ou une règle métier, et le pipeline CI exécute des tests unitaires ainsi que des tests d'intégrité sur un clone de la base de données. La migration doit être appliquée à deux endroits : une base de données vierge et une base de données alimentée, car une modification qui fonctionne sur des tables vides peut très bien échouer en présence de lignes réelles, de clés étrangères et de cas particuliers.
Après le déploiement, exécutez à nouveau les mêmes assertions. Ce second passage est indispensable car une migration peut s'appliquer correctement tout en modifiant le comportement des contraintes, les plans de requête ou les résultats des validations. Les équipes doivent également décider dès le départ si la migration est réversible ou formellement acceptée comme irréversible, plutôt que de laisser cette question en suspens après la mise en production (bug0).
Où se situent les outils
Des frameworks comme pgTAP pour PostgreSQL et tSQLt pour SQL Server permettent aux équipes d'exprimer les contrôles d'intégrité sous forme de code, ce qui rend les vérifications révisables et reproductibles. La validation au niveau des requêtes fait partie du même workflow, en particulier pour les parcours critiques, et un EXPLAIN ANALYZE peut mettre en évidence des régressions de performance avant qu'une modification n'impacte les rapports ou les analyses en aval. Cette rigueur se retrouve également dans la validation des données d'entreprise en base de données, où les contrôles restent au plus près des tables qu'ils protègent.
Les instantanés de production constituent une autre méthode robuste. Ils vous permettent de vérifier qu'une modification se comporte de la même manière sur des données réelles sans impacter le système de production lui-même. C'est particulièrement important lorsque la table est volumineuse, critique pour l'activité ou soumise à des réglementations, car les tests sur tables vides peuvent masquer des problèmes qui n'apparaissent qu'à grande échelle ou avec un historique de données.
De la même manière que l'anomaly detection for dealers surveille les changements de comportement inhabituels au fil du temps, les tests d'intégrité en base de données surveillent les règles qui réussissent sur le papier mais échouent face aux mouvements réels des données. Les assertions statiques interceptent la contrainte rompue. Les contrôles au moment de la mise en production et post-déploiement révèlent si la migration préserve la cohérence de la base de données une fois le nouveau code déployé.
Des tests ponctuels à l'Observability continue de l'intégrité
Une suite de tests peut réussir alors que le tableau de bord reste faux. Cela se produit généralement lorsque le problème n'est pas une contrainte brisée, mais une dérive temporelle, un retard de livraison, un changement de schéma ou une transformation qui a altéré l'historique sans déclencher d'erreur bloquante. L'observability continue de l'intégrité comble le vide laissé par les validations ponctuelles.
Pourquoi les tests statiques ne suffisent pas
Les tests d'intégrité traditionnels excellent pour détecter les violations explicites, comme les lignes orphelines ou les valeurs invalides. Ils se révèlent moins efficaces face aux dérives lentes des pipelines, car un résultat correct hier peut devenir erroné aujourd'hui sans qu'aucune panne franche ne survienne. Les retraitements, les backfills et les refactorisations de code sont des sources fréquentes de ces dysfonctionnements discrets, et les recommandations publiques traitent de plus en plus ce point comme un enjeu opérationnel distinct plutôt que comme un pur problème de base de données (Soda).
C'est pourquoi les équipes ajoutent de la détection d'anomalies, du suivi des modifications de schéma et de la surveillance des schémas de livraison en plus des contrôles déterministes. Ces signaux permettent d'appréhender la structure globale des données, et pas seulement de savoir si elles violent une règle précise. Si une table arrive habituellement à une certaine heure et commence à accuser du retard, ou si une métrique dévie d'une manière incohérente avec l'historique, vous voulez recevoir l'alerte avant qu'un utilisateur métier n'ouvre son tableau de bord.
Comment l'observability prolonge l'intégrité
Une configuration efficace surveille simultanément trois aspects. Premièrement, la validation au niveau des enregistrements prouve que les règles strictes restent respectées. Deuxièmement, la surveillance de la ponctualité signale les chargements tardifs ou manquants en fonction des schémas de livraison attendus. Troisièmement, le suivi des schémas détecte les modifications structurelles avant que les tâches en aval ne plantent à cause du renommage inattendu d'une colonne ou d'un changement de type.
La référence sur l'anomaly detection for dealers est un guide précieux, car elle montre comment une détection basée sur l'historique de référence peut faire émerger des comportements inhabituels sans imposer à chaque équipe de rédiger manuellement une règle pour chaque cas particulier.
Règle pratique : si un contrôle se contente de vous signaler l'arrivée de données corrompues, ajoutez un indicateur d'observability pour savoir quand le système a commencé à dériver vers ces données corrompues.
L'observability continue ne remplace pas les tests d'intégrité. Elle détecte les défaillances pour lesquelles les tests ne peuvent pas être planifiés, notamment dans les pipelines qui retraitent l'historique ou qui dépendent de systèmes en amont que vous ne maîtrisez pas.
Mesurer la couverture, les SLA et le ROI réel
Multiplier les tests ne garantit pas automatiquement une meilleure protection. Une longue liste de contrôles peut sembler rassurante et pourtant ignorer les tables les plus stratégiques. La véritable question est de savoir si la suite de tests couvre les données dont la corruption pourrait nuire à l'entreprise.
La couverture doit suivre le risque
Les tables critiques méritent une couverture plus approfondie que les données de référence, et les pipelines soumis à de fréquentes modifications requièrent plus d'attention que ceux qui restent stables. Les modèles en aval, les jeux de données réglementaires et les tables d'indicateurs clés de performance (KPI) figurent en tête de liste, car des lignes manquantes, des retards de chargement ou des jointures rompues peuvent fausser le reporting et les éléments de conformité réglementaire. De nombreux guides abordent la documentation et les audits, mais définissent rarement ce qu'est une « bonne couverture » dans un environnement mixte d'entrepôts, de lacs et de pipelines (VirtuosoQA).
Définissez des SLA alignés sur le rôle des données. Si un jeu de données alimente le reporting matinal, l'équipe doit définir une exigence de fraîcheur bien plus stricte que pour l'archivage de lots. Si un schéma évolue fréquemment, le contrôle clé n'est pas le nombre de vérifications en place, mais la capacité à détecter le changement avant que les utilisateurs n'en subissent les conséquences.
Une logique de réduction des risques
Le test d'intégrité est une démarche de réduction des risques, pas une course au volume de tests.
Cette approche permet de justifier plus facilement l'investissement dans des secteurs réglementés, où le coût d'une ligne manquante, d'un retard de chargement ou d'un KPI corrompu se traduit par des difficultés d'audit, des décisions erronées ou des corrections complexes au niveau de l'analyse et des opérations. Le ROI réside dans la prévention de ces défaillances, et non dans la recherche d'une validation exhaustive de chaque table.
Un bon moyen de démarrer consiste à classer les jeux de données selon leur impact sur l'activité, puis à définir la profondeur de surveillance en conséquence. Vous obtiendrez ainsi un meilleur équilibre qu'en tentant de tout tester avec la même intensité.
Rassembler le tout dans une architecture de données fiable
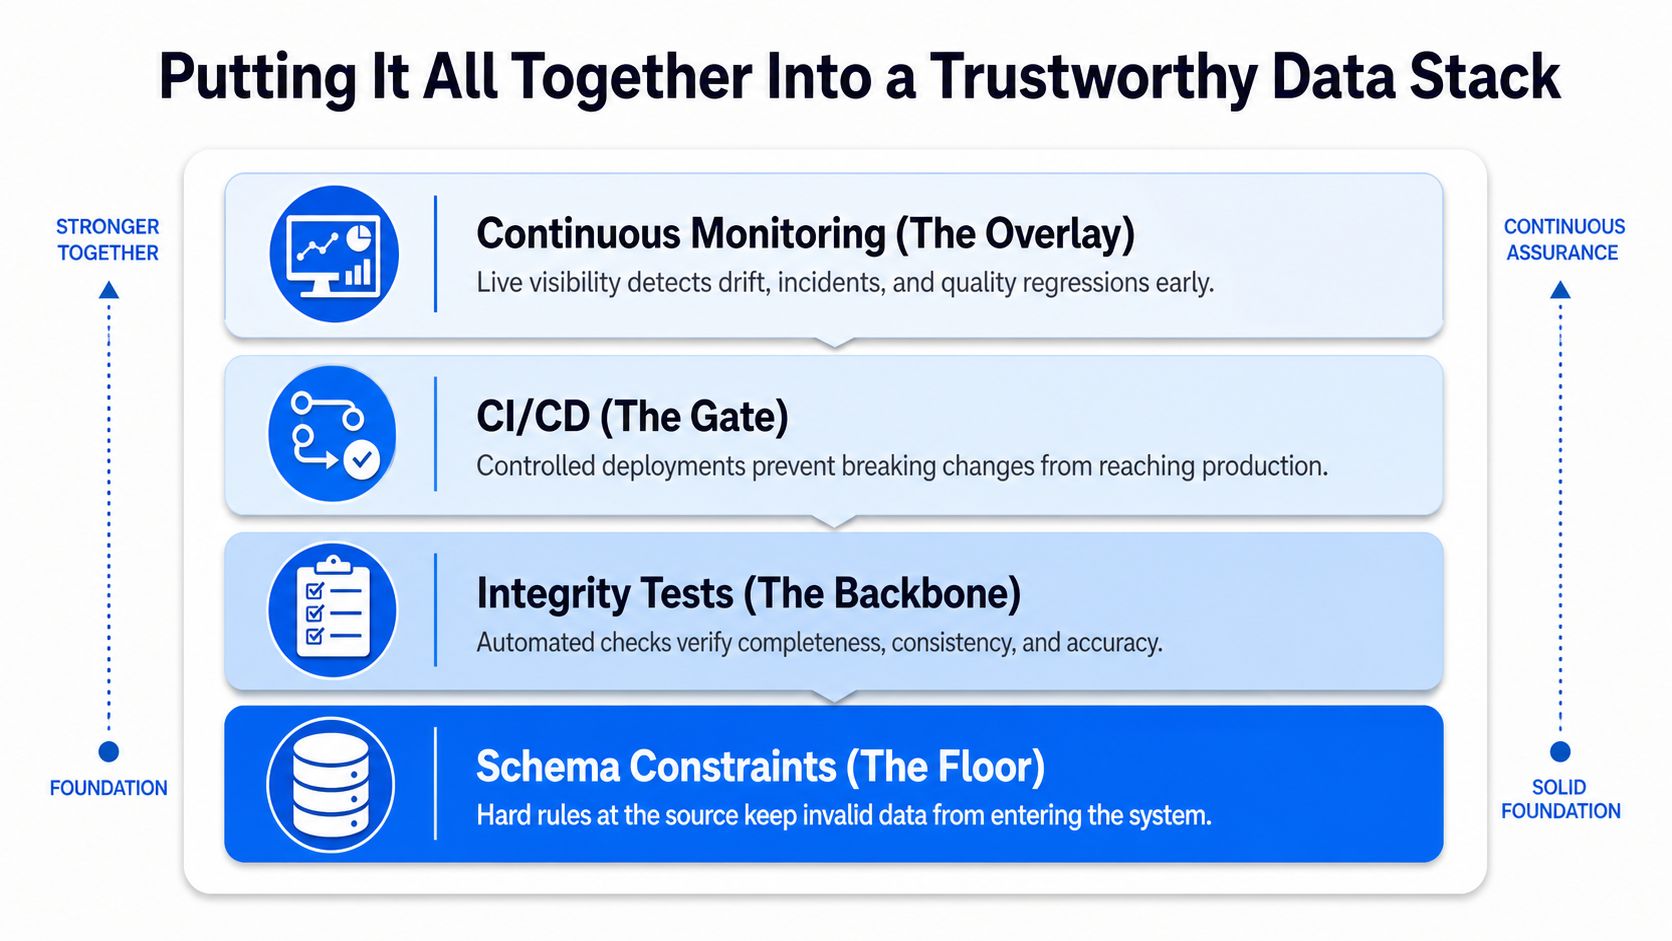
Une architecture de confiance repose sur plusieurs niveaux, chacun traitant un type de défaillance spécifique. Les contraintes de schéma constituent le socle : elles bloquent les violations évidentes aux frontières de la base de données. Les tests d'intégrité forment la structure : ils valident la pérennité des règles après les modifications de code, les chargements et les migrations. Le CI/CD joue le rôle de garde-barrière pour les déploiements : il bloque les modifications susceptibles de briser ces règles. Enfin, la surveillance continue assure le suivi global : elle détecte les dérives, les retards et les modifications structurelles après la mise en production.
Un modèle opérationnel simple
Aux limites de l'entrepôt ou du lac de données, les contraintes bloquent les enregistrements invalides. Au sein du pipeline, des cas de test vérifient l'intégrité des entités, référentielle, de domaine et sémantique avant que les données n'atteignent les utilisateurs. Lors de la gestion des versions, les migrations et les assertions évoluent de concert afin de prouver qu'une modification n'a pas altéré les comportements. Après le déploiement, l'observability scrute le système en production pour identifier les arrivées tardives, la dérive de schéma et les anomalies statistiques.
Cette approche structurée répond également aux exigences de governance. L'exécution des contrôles directement au sein de la base maintient les données sur place, ce qui renforce la sécurité et limite les mouvements de données inutiles. C'est l'association d'une validation déterministe et d'une surveillance comportementale qui permet aux équipes de détecter à la fois les violations franches et les dérives silencieuses.
Une équipe data expérimentée résumerait ce modèle en une phrase : Le test d'intégrité de base de données n'est pas un outil unique, c'est une démarche structurée qui associe la rigueur classique des bases de données à l'observability moderne afin que les utilisateurs finaux puissent faire pleinement confiance aux données.
Si vous souhaitez mettre en œuvre ce modèle à plusieurs niveaux au sein de votre propre infrastructure, digna propose de la validation en base de données, du suivi de schéma, de la surveillance de ponctualité et de la détection d'anomalies pour vos entrepôts, lacs de données et pipelines. Visitez digna pour découvrir comment intégrer ces contrôles dans votre architecture de données et déployer les vérifications d'intégrité indispensables à vos équipes.



