Qualité des données en temps réel : Un guide pratique pour 2026
|
7
minute de lecture

Vous connaissez déjà cette sensation. Le tableau de bord semblait correct le matin, le système source a changé au déjeuner, et le temps que quelqu'un s'en rende compte, l'entrepôt de données racontait une histoire erronée. Dans les environnements réglementés, ce type d'écart n'est pas un problème cosmétique. C'est ainsi qu'un flux obsolète se transforme en une mauvaise décision, un rapport erroné ou un incident que personne ne peut expliquer clairement.
La qualité des données en temps réel est la discipline qui consiste à intercepter ces défaillances pendant que les données sont encore en mouvement. Cela signifie que les contrôles de qualité ne sont plus un travail de nettoyage nocturne, ils font partie du parcours opérationnel en direct, liés à la fraîcheur, à la latence, aux changements de schéma et aux comptages de valeurs nulles en tant que signaux observables de santé IBM Observability metrics. Cela signifie également que l'architecture doit respecter une vérité absolue : la validation des flux doit s'exécuter en continu sans détruire la latence de bout en bout (recherche sur la qualité du streaming IJERET).
Table des matières
Ce que signifie réellement la qualité des données en temps réel
Qualité en temps réel vs par lots et points de rupture respectifs
Les indicateurs clés de performance que vous devriez réellement suivre
Une liste de contrôle de déploiement progressif pour commencer
Le moment où la qualité par lots cesse de fonctionner
Le mode de défaillance est familier. Un tableau de bord financier semble cohérent le mardi, un modèle de score fonctionne normalement, puis le vendredi, les chiffres dérivent, mais personne ne peut situer le moment exact où les données sont devenues incorrectes. Les contrôles par lots peuvent indiquer que le chargement d'hier a réussi, alors que le problème principal a commencé entre deux tâches et s'est propagé en aval avant que quiconque n'ait eu la possibilité de l'arrêter.
C'est pourquoi la qualité en temps réel n'est pas simplement un « traitement par lots plus rapide ». C'est un modèle opérationnel différent. La recherche sur la qualité du streaming décrit des métriques de qualité calculées en continu afin que les équipes puissent détecter les problèmes dès l'arrivée des données plutôt qu'après les tâches de traitement nocturnes, ce qui représente un changement significatif dans la manière dont les ingénieurs conçoivent le contrôle, et pas seulement l'outillage ACM streaming analytics paper.
La fraîcheur modifie la définition de la qualité
En pratique, la dimension manquante est souvent la ponctualité. Un ensemble de données peut être techniquement valide et opérationnellement incorrect s'il est en retard, manquant ou s'il arrive hors cadence. C'est pourquoi la fraîcheur, la latence et le comportement du pipeline importent désormais autant que les dimensions classiques d'exactitude et d'exhaustivité.
Règle pratique : si le tableau de bord dépend de données sensibles au facteur temps, traitez le retard comme un défaut de qualité, et non comme un simple désagrément de pipeline.
La validation par lots a toujours sa place, en particulier pour les audits rétrospectifs et le profilage approfondi. Mais pour la fraude, les opérations et les flux de travail orientés client, attendre la prochaine tâche planifiée est le meilleur moyen de propager des enregistrements erronés. La qualité en temps réel existe parce que le coût commercial du retard se manifeste avant la fermeture de la fenêtre de traitement par lots.
Ce que signifie réellement la qualité des données en temps réel
Une définition utile est simple. La qualité des données en temps réel est la vérification continue des données au fur et à mesure de leur progression dans le pipeline, avec des contrôles qui évaluent si chaque enregistrement est adapté à l'utilisation en aval au moment même où il arrive. Le but n'est pas de construire un second entrepôt de règles, mais d'empêcher les problèmes structurels et comportementaux de franchir la frontière vers les systèmes de production.
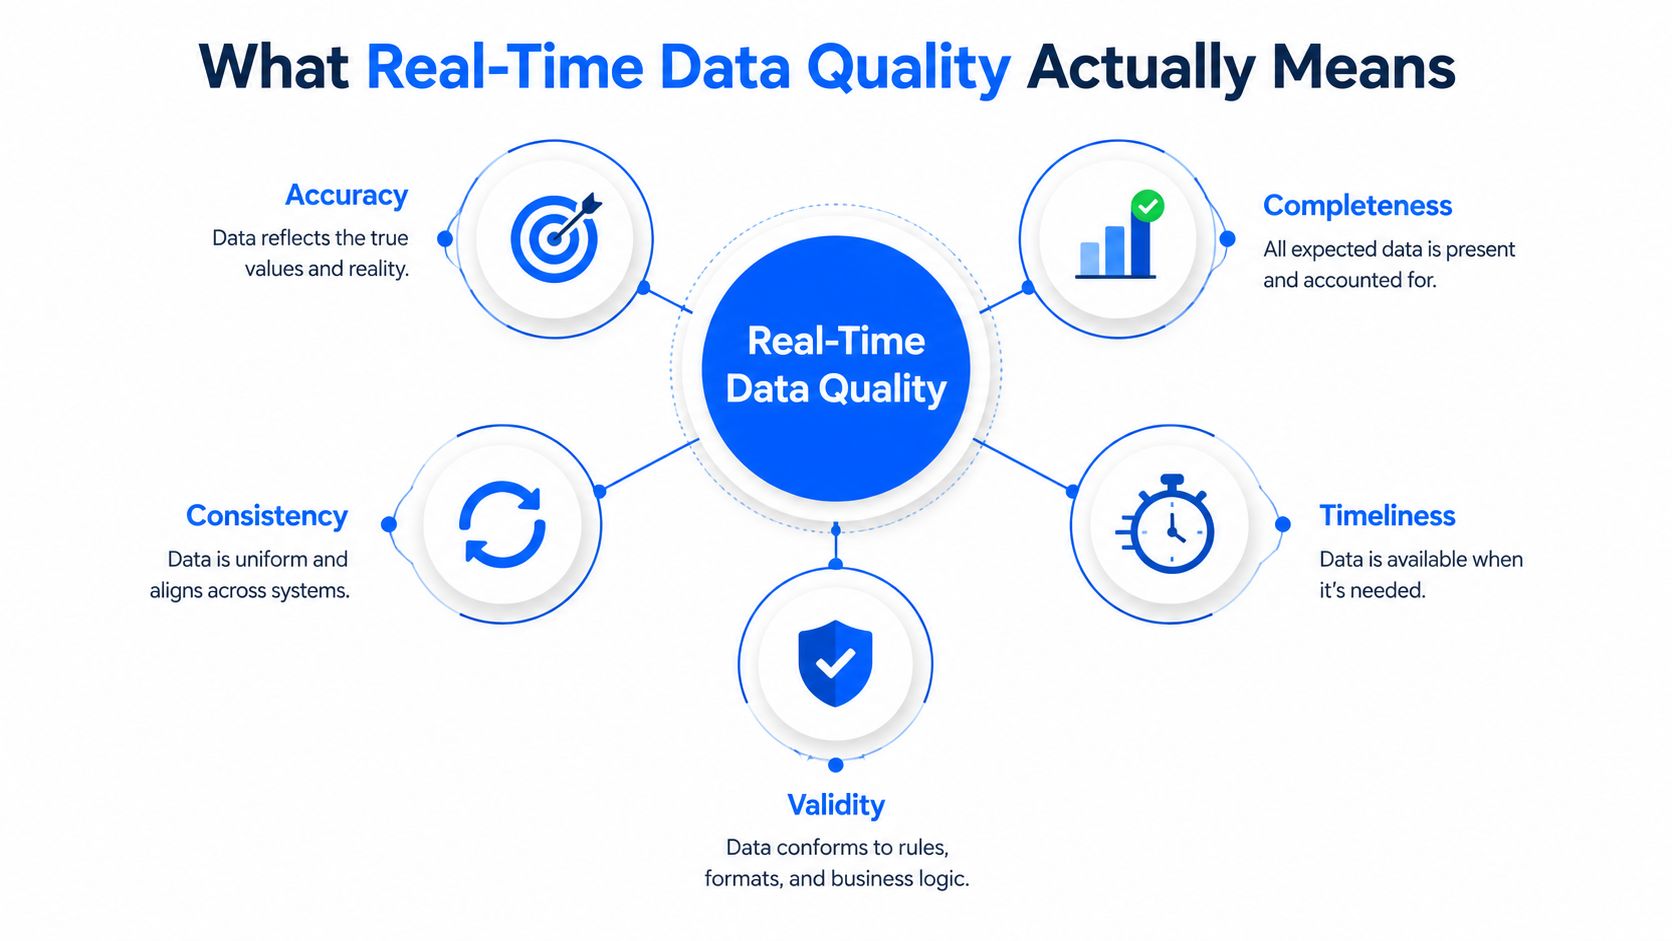
La fraîcheur est au centre
Pour les systèmes en temps réel, la fraîcheur est généralement la première métrique qui révèle un problème. Une façon standard de la définir est le temps écoulé depuis le dernier enregistrement écrit dans un ensemble de données, mesuré par rapport à un SLA Soda freshness metric guidance. Cela rend la fraîcheur opérationnelle, et non philosophique.
Le reste des dimensions devient plus facile à appréhender une fois la fraîcheur en place :
L'exhaustivité vous indique si les champs et sources attendus sont arrivés.
La validité vous indique si les valeurs correspondent au format, au type et à la plage attendus.
La cohérence vous indique si la même entité concorde entre les systèmes.
L'unicité vous indique si des doublons s'infiltrent dans le flux.
Les dimensions standard d'IBM incluent l'exactitude, l'exhaustivité, la cohérence, la ponctualité, la validité et l'unicité, et la définition de la validité du gouvernement britannique met l'accent sur le format, le type et la plage IBM data quality dimensions.
Un seul enregistrement peut être évalué par rapport à toutes ces dimensions lors de l'intégration. Si un événement de commande arrive à temps, avec le bon schéma, une devise acceptée, aucun identifiant en double et des données de référence client correspondantes, il est validé. S'il arrive en retard ou avec un changement de type, le système doit signaler la dimension spécifique qui a échoué, et non pas simplement le marquer comme « mauvais ».
La ponctualité n'est pas une métrique secondaire. Dans les systèmes en direct, elle fait partie de la définition même de la qualité.
Qualité en temps réel vs par lots et points de rupture respectifs
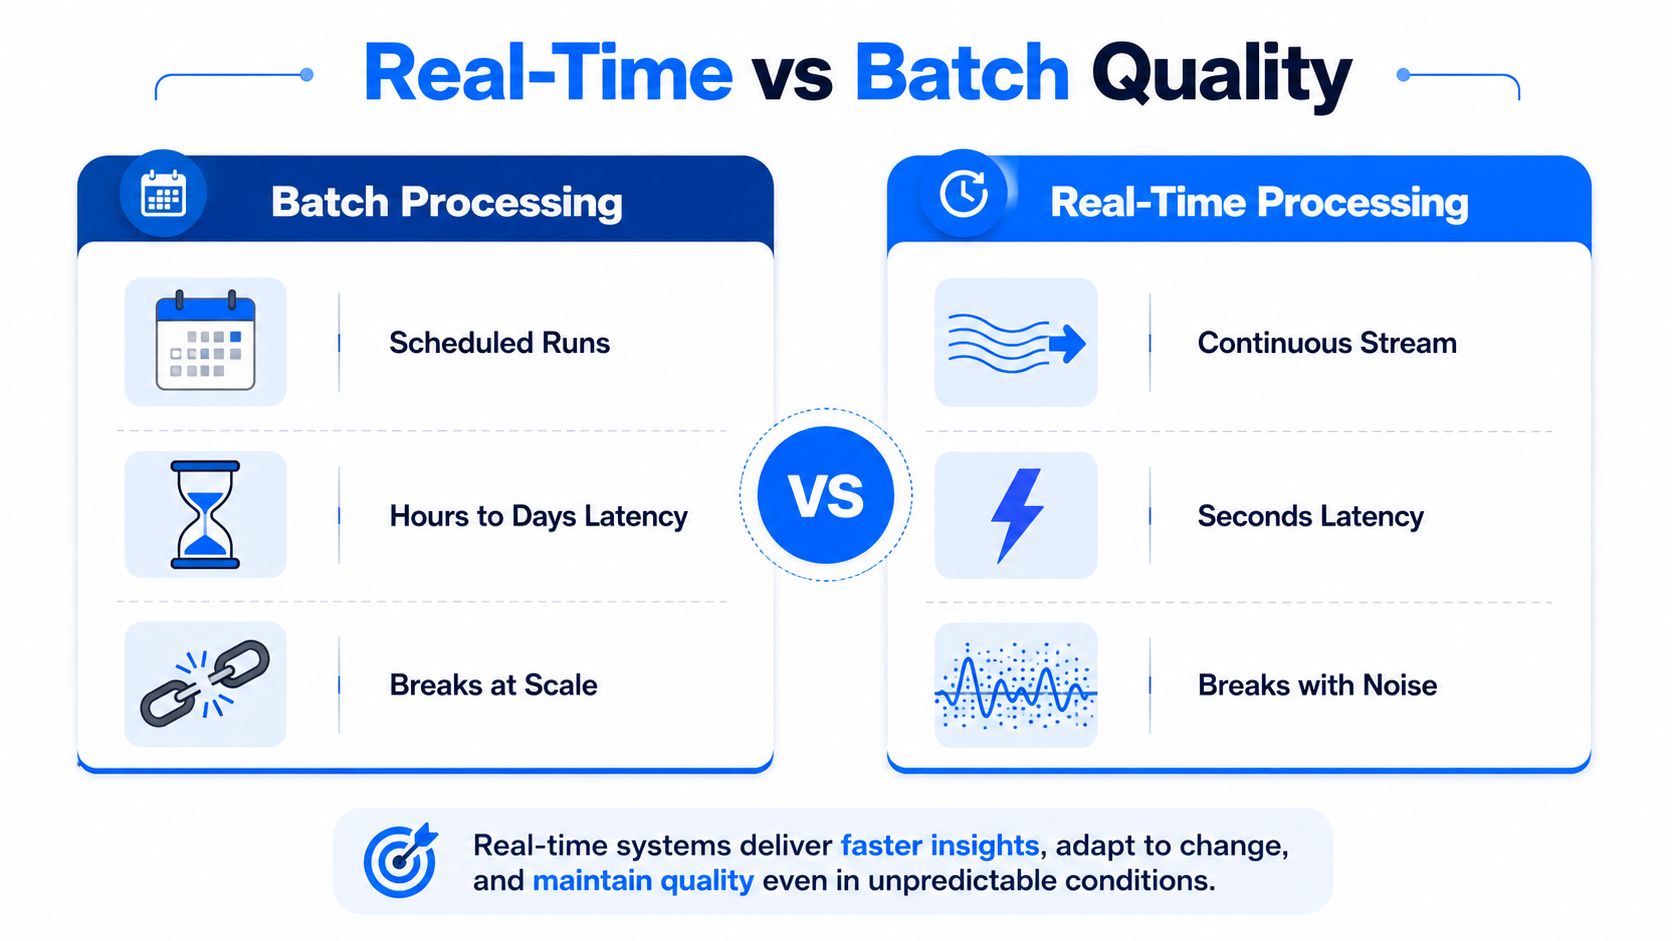
La qualité par lots et la qualité en temps réel ne sont pas rivales. Ce sont des surfaces de contrôle différentes. Le traitement par lots offre une vue d'ensemble, un contexte historique et une analyse rétrospective moins coûteuse. Le temps réel permet de bloquer les événements erronés avant qu'ils ne contaminent les tableaux de bord, les modèles ou les flux de travail des clients.
La distinction est importante car un même ensemble de données se comporte différemment selon le régime appliqué. Une tâche nocturne peut détecter des lignes mal formées après le chargement, tandis qu'un contrôle en continu peut les arrêter dès l'intégration. Les micro-lots planifiés réduisent l'écart, mais laissent toujours des zones d'ombre entre les exécutions. Le streaming continu comble cet écart en validant les données pendant qu'elles sont encore en mouvement Confluent streaming architecture guidance.
Là où le traitement par lots a encore sa place
La qualité par lots conserve sa place dans les programmes qui nécessitent un profilage plus approfondi, des enquêtes post-incident ou des preuves prêtes pour l'audit. Elle est utile lorsque vous souhaitez analyser de longs historiques, comparer des distributions ou prouver qu'un contrôle a été exécuté selon un calendrier précis. En d'autres termes, le traitement par lots est adapté à l'analyse.
Là où il échoue lamentablement
Il échoue lorsque l'entreprise s'intéresse à l'état actuel du monde. Les tableaux de bord des revenus, la détection des fraudes, les alertes cliniques et les SLA opérationnels dépendent tous de données suffisamment récentes pour être exploitables. Si un fournisseur manque une exécution nocturne, le rapport peut toujours sembler correct alors que l'entrepôt est déjà obsolète depuis des heures. C'est le pire type de défaillance, car les chiffres semblent dignes de confiance.
Le traitement par lots indique que le travail est terminé. Le temps réel indique si les données sont toujours prêtes à l'emploi.
La réponse pratique est généralement mixte. Laissez le traitement par lots s'occuper du travail rétrospectif approfondi, mais déplacez les contrôles d'intégration, de ponctualité et les validations critiques pour l'entreprise vers le flux de streaming. De cette façon, le rapport nocturne devient une confirmation, et non la première ligne de défense.
Au cœur du pipeline de qualité en temps réel
Un pipeline de streaming pratique suit cinq étapes. Tout d'abord, intégrez les événements dans une couche de streaming. Ensuite, validez le schéma à la frontière, appliquez les règles métier à la charge utile et dirigez les enregistrements non valides vers une mise en quarantaine au lieu de les rejeter. Après cela, calculez les indicateurs clés de performance de qualité en continu et générez des alertes lorsque les seuils sont dépassés. Un Confluent pipeline flow est une référence utile pour cette séquence.
Pourquoi le lieu d'exécution est important
La plus grande erreur commise par les équipes est de déplacer les données vers un moteur de qualité distinct alors que le système source dispose déjà d'un contexte suffisant pour les évaluer. Une étude de Cambridge sur les systèmes Big Data en temps réel a révélé que la surcharge des contrôles de qualité dépend des transferts entre modules, de la synchronisation des messages et de la complexité des algorithmes, c'est pourquoi les étapes supplémentaires peuvent ralentir l'ensemble du pipeline Cambridge real-time big-data study. En pratique, cela pousse les équipes vers des contrôles in-stream (dans le flux) et in-database (en base de données).
L'application des schémas doit se faire au moment de l'intégration, car c'est l'endroit le plus économique pour intercepter les dérives structurelles. Les règles métier doivent être appliquées immédiatement après, tant que l'événement est encore exploitable. La quarantaine n'est pas un état d'échec, c'est un point de contrôle. Les enregistrements non valides doivent être isolés, étiquetés et conservés pour examen sans polluer les systèmes en aval.
L'architecture nécessite également un espace partagé où ingénieurs et analystes peuvent visualiser les incidents. Une interface utilisateur unique pour les anomalies, les échecs de validation et les retards réduit les intermédiaires, en particulier lorsque les équipes de plateforme et les équipes métier doivent analyser le même enregistrement dans la même fenêtre. Cela est encore plus important lorsque le modèle opérationnel intègre la surveillance des données en temps réel, car les personnes qui surveillent le pipeline doivent rapidement distinguer le bruit d'une véritable panne.
Pour les équipes qui évaluent les outils, la liste de contrôle pratique est simple : application des schémas, règles de streaming, quarantaine et métriques visibles. La configuration idéale est celle qui maintient les contrôles au plus près des données, assure la visibilité des défaillances et maintient la latence dans des limites tolérables pour l'entreprise.
Comment l'exécution en base de données, la détection des anomalies et le suivi des schémas s'articulent
Les systèmes les plus efficaces ne traitent pas les modules de surveillance comme des fonctionnalités isolées. Ils fonctionnent comme un plan de contrôle. L'exécution en base de données maintient les données en place afin que les contrôles s'effectuent au sein même de l'environnement du client, ce qui limite les déplacements et aligne la couche de qualité avec la governance existante. La détection des anomalies ajoute un apprentissage de référence pour que le système puisse signaler les écarts sans obliger les ingénieurs à définir manuellement chaque seuil.
Trois fonctionnalités, trois modes de défaillance différents
La détection des anomalies est particulièrement efficace lorsque les comportements changent alors que le schéma reste stable. Elle apprend la forme normale d'un ensemble de données et signale les schémas inhabituels, les pics ou les baisses. Le suivi des schémas couvre une autre catégorie de défaillances : les colonnes ajoutées, supprimées et les changements de types de données qui peuvent bloquer les utilisateurs en aval avant même que la logique métier ne s'exécute.
La surveillance de la ponctualité comble le vide que les deux autres laissent de côté. Un ensemble de données peut sembler statistiquement normal tout en étant en retard, en avance ou manquant. C'est pourquoi les modèles d'arrivée, les heures de livraison prévues et la détection des retards ont leur place dans le même outil opérationnel que la détection des anomalies et la validation.
Les bons systèmes de qualité ne demandent pas à un seul module de résoudre tous les problèmes. Ils superposent les modules afin que chacun intercepte un mode de défaillance différent.
Pour une approche pratique du choix des modèles, le guide pour choisir la bonne solution de détection d'anomalies est utile pour décider s'il faut s'appuyer sur des contrôles déterministes, des références apprises, ou les deux. Et si vous intégrez cette approche dans une infrastructure centrée sur l'entrepôt de données, le cadre interne sur Databricks data quality framework est un point de référence utile.
digna s'inscrit dans ce schéma comme une option sur le marché, car elle exécute des contrôles dans l'environnement propre du client, prend en charge l'exécution en base de données et combine la détection d'anomalies, la ponctualité, la validation et le suivi des schémas sur une plateforme unique. Cette combinaison importe plus que n'importe quelle fonctionnalité isolée.
Les indicateurs clés de performance que vous devriez réellement suivre
Un programme en temps réel n'a pas besoin d'un tableau de bord géant. Il nécessite une liste restreinte de métriques directement associées aux risques opérationnels. Commencez par la fraîcheur, la latence, le nombre d'enregistrements obsolètes, le pourcentage de valeurs en dehors des plages acceptées, le ratio d'enregistrements rejetés par les règles de validation, ainsi que les erreurs de syntaxe ou de format comme des adresses e-mail invalides Alation data quality metrics.
La bonne métrique dépend de la défaillance que vous essayez d'empêcher. La fraîcheur vous indique si le dernier chargement est exploitable. La latence vous indique quelle proportion de l'ensemble de données a respecté la fenêtre SLA. Le taux d'échec de validation vous indique si les règles sont trop souples ou si les données en amont ont changé. Les valeurs hors plage détectent les anomalies métier qui semblent pourtant syntaxiquement valides.
Indicateurs clés de performance fondamentaux de la qualité des données en temps réel
Dimension | Métrique | Comment mesurer | Seuil de référence |
|---|---|---|---|
Fraîcheur | Temps écoulé depuis le dernier enregistrement | Comparer l'heure de dernière écriture à la fenêtre SLA | Défini par ensemble de données critique |
Latence | Pourcentage d'enregistrements mis à jour dans le cadre du SLA | Mesurer les enregistrements arrivant dans la fenêtre attendue | Défini par pipeline |
Exhaustivité | Champs obligatoires manquants | Compter les champs obligatoires présents par enregistrement | Défini par niveau d'ensemble de données |
Validité | Enregistrements hors plage acceptée | Valider le type, le format et la plage à l'intégration | Défini par règle métier |
Validation | Enregistrements rejetés par les règles | Compter les enregistrements rejetés ou mis en quarantaine | Défini par contrôle |
La règle générale est d'associer chaque métrique technique à une conséquence métier. Si une table de revenus ne respecte pas son SLA de fraîcheur, le problème n'est pas une icône jaune, c'est une fenêtre d'édition de rapports manquée. C'est ainsi que la surveillance reste utile et non purement décorative.
Pour garder le programme pragmatique, définissez la métrique, configurez le seuil, automatisez le contrôle et suivez le résultat au fil du temps. La page interne sur les data quality metrics constitue un excellent point de départ pour transformer cette discipline en un modèle opérationnel reproductible.
Défis courants et considérations de sécurité
La plupart des programmes de qualité en temps réel échouent en raison de la gouvernance, et non de la logique de détection. Les seuils deviennent trop stricts, entraînant une lassitude face aux alertes. La responsabilité devient floue lorsqu'un incident touche simultanément l'équipe source, l'équipe plateforme et le responsable métier. De plus, l'achat de nouveaux outils complexifie la gestion de l'infrastructure.
La sécurité se décide dans l'architecture, pas dans le document de politique
Les équipes soumises à des réglementations veillent à l'endroit où s'exécutent les contrôles. Si un fournisseur exige que les données quittent l'environnement client, cela crée une contrainte d'examen et souvent un point de blocage. L'exécution des contrôles en base de données, au sein du cloud du client, de son VPC ou de son environnement sur site, maintient la couche de qualité sous les mêmes contrôles d'accès que l'entrepôt lui-même.
Cela modifie également l'aspect économique de la surveillance. Une tarification transparente et stable en fonction de l'usage facilite l'extension de la couverture sans craindre que chaque nouvelle alerte ou analyse ne se transforme en un coût imprévu. Une interface utilisateur partagée est également bénéfique, car les ingénieurs, les analystes et les équipes de gouvernance peuvent examiner la même anomalie, le même problème de ponctualité, le même échec de validation ou le même changement de schéma sans avoir à s'échanger des captures d'écran.
La principale erreur est de traiter la qualité en temps réel comme un outil de niche. En pratique, elle fait partie intégrante à la fois de l'observabilité de la plateforme, de la surveillance de l'activité et de l'application des contrôles. Les équipes qui centralisent ces besoins passent généralement moins de temps à harmoniser les outils et plus de temps à résoudre les réels problèmes de données.
Une liste de contrôle de déploiement progressif pour commencer
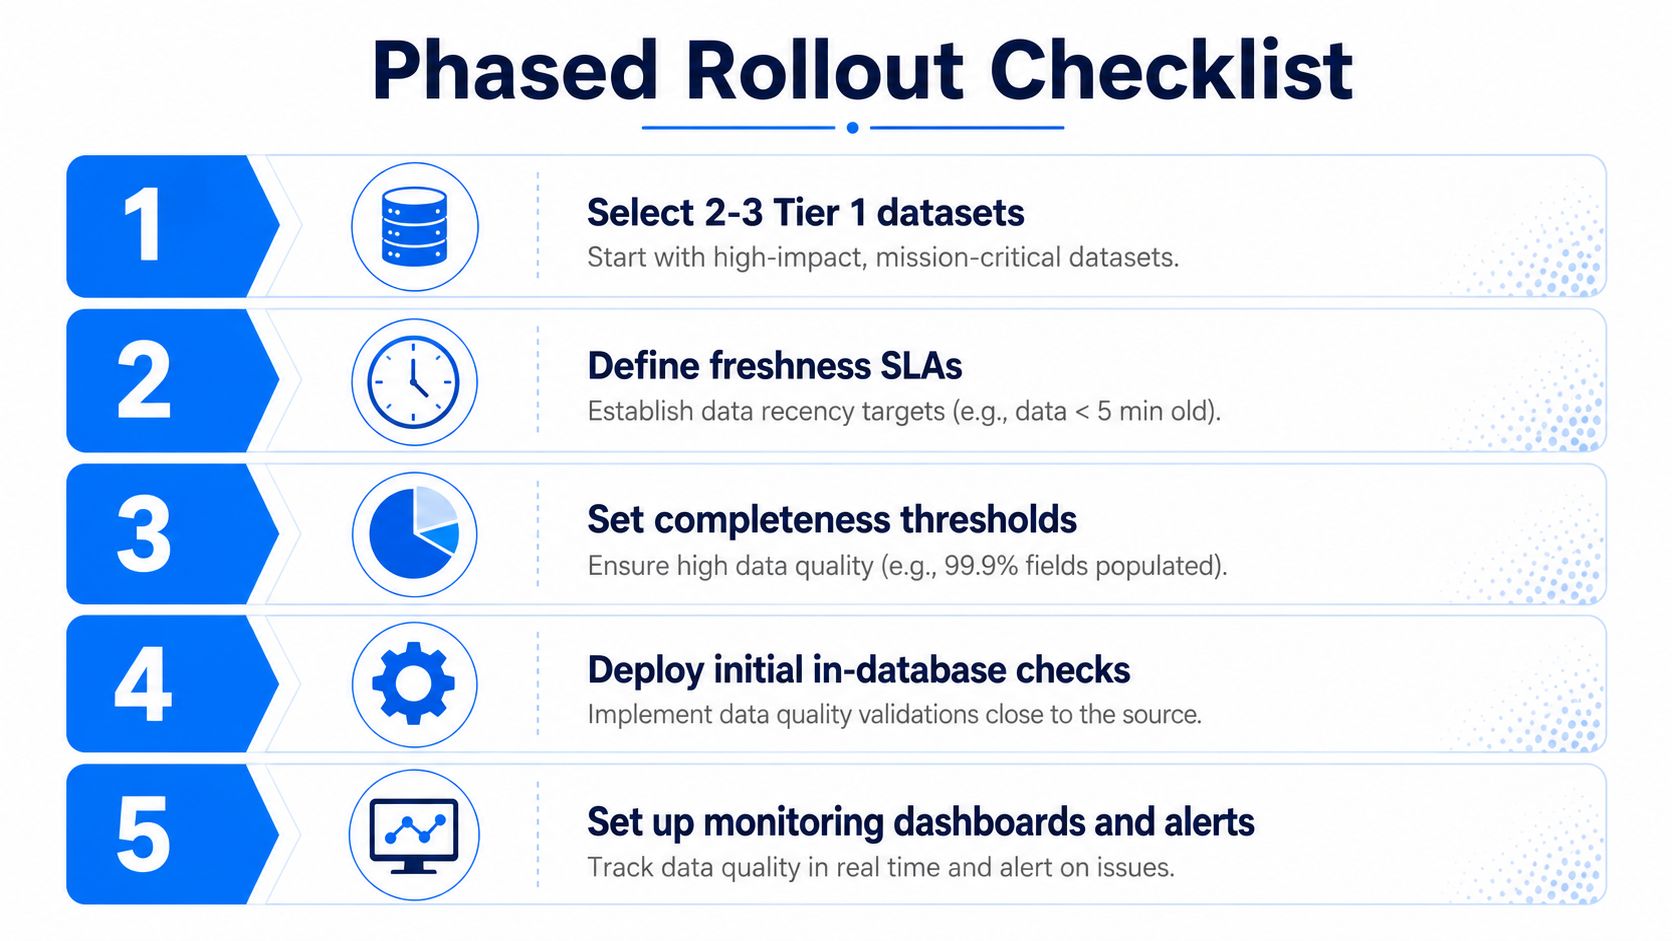
Commencez modestement. Choisissez deux ou trois ensembles de données de niveau 1 pour lesquels des données obsolètes ou invalides génèrent un risque métier évident. Définissez d'abord les SLA de fraîcheur et d'exhaustivité, puis activez l'exécution en base de données afin que les contrôles s'exécutent là où résident déjà les données.
Un déploiement qui ne s'effondre pas sous son propre poids
Sélectionner les bons ensembles de données. Commencez par les tables qui affectent directement les rapports, la conformité ou les flux de travail des clients.
Définir les SLA de fraîcheur. Rendre explicite l'ancienneté acceptable des données.
Définir des seuils d'exhaustivité. Décider de ce que signifie « exploitable » avant le déclenchement de la première alerte.
Déployer les premiers contrôles en base de données. Intercepter les défauts structurels et basés sur des règles sans ajouter de mouvements superflus.
Activer la surveillance et les alertes. Intégrer les incidents dans les canaux déjà utilisés par votre équipe.
L'erreur à éviter est de viser une couverture large avant d'avoir ajusté les responsabilités et les seuils. Un projet pilote trop bruyant sera ignoré. Un pilote ciblé permet à l'équipe de comprendre le comportement des contrôles, ce qui est l'objectif recherché.
Si vous travaillez dans la finance, la santé, les télécommunications ou le secteur public, le même modèle s'applique, avec simplement des contrôles et des obligations de reporting différents. Le but est de faire des données fiables l'état par défaut de la plateforme, et non une urgence hebdomadaire.
Si vous construisez ce modèle opérationnel et recherchez une plateforme qui maintient les contrôles au sein de votre propre environnement, prend en charge l'exécution en base de données et rassemble la ponctualité, la validation, la détection des anomalies et le suivi des schémas dans un flux de travail unique, visitez digna. Elle est conçue pour les équipes qui souhaitent que la qualité des données en temps réel fonctionne comme une discipline opérationnelle, et non comme un traitement par lots à intervalle réduit.


